
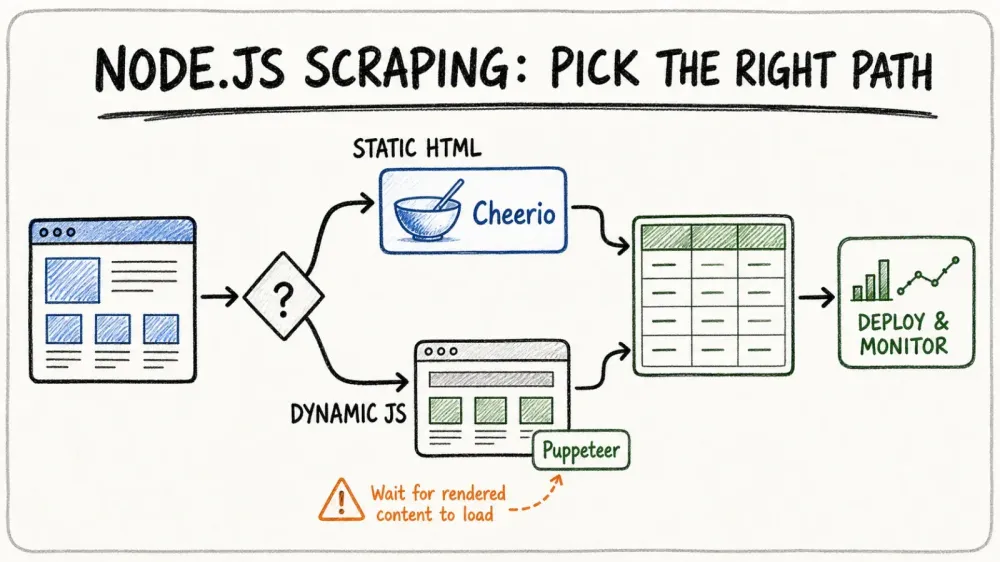
Het web snakt in 2026 harder dan ooit naar data, en Node.js loopt voorop voor teams die slimmer willen scrapen in plaats van alleen maar harder te werken. Of je nu in sales zit, e-commerce doet of gewoon een data-nerd bent zoals ik: je hebt vast al gezien dat scraping al lang niet meer alleen draait om “de buit binnenhalen”. Het gaat om snelheid, schaalbaarheid en ervoor zorgen dat je IP niet digitaal wordt vastgezet. Ook de vraag neemt niet af — publieke webdata is stilletjes uitgegroeid tot de basis waarop moderne teams bouwen, van prijsintelligence tot LLM-trainingspijplijnen, en de lat ligt hoger dan ooit.
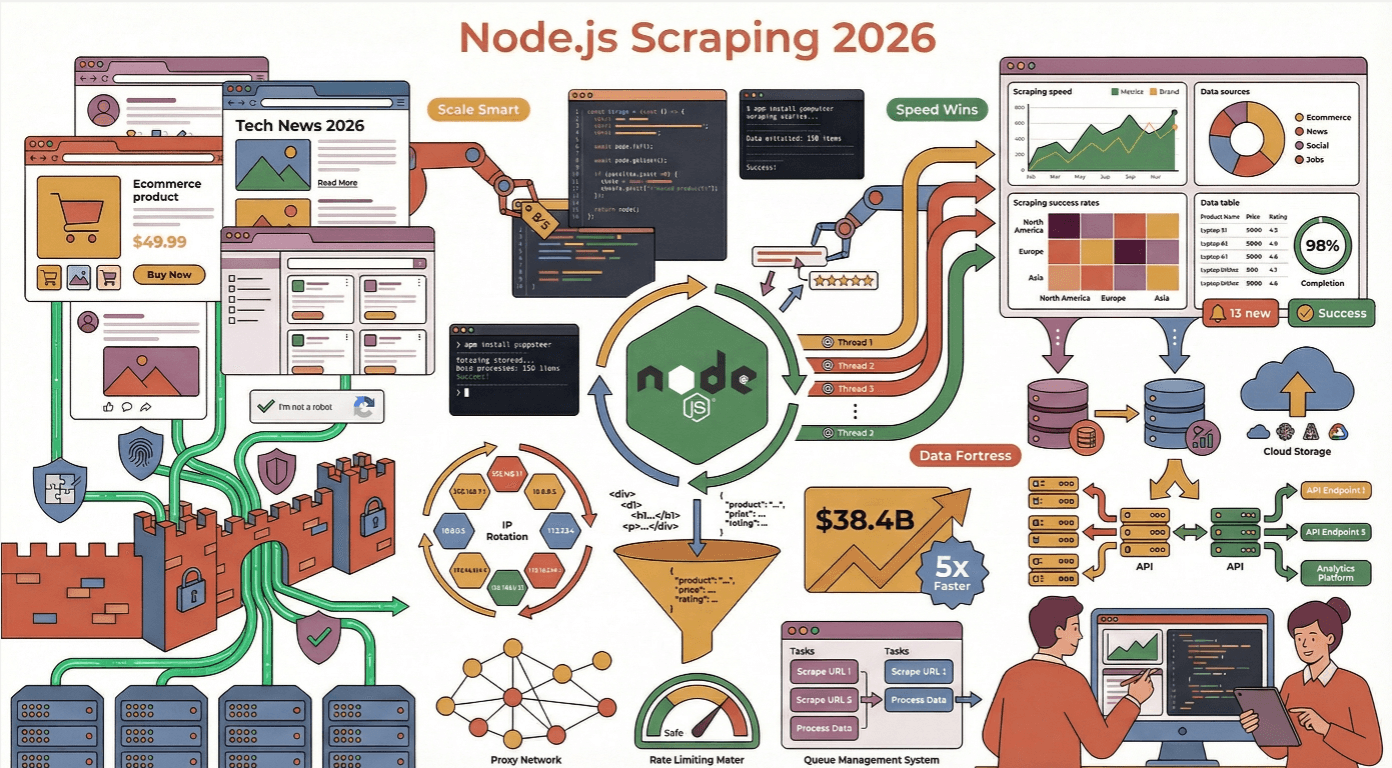
Maar hier zit de adder onder het gras: het moderne web is een vesting vol dynamische content, anti-botvalkuilen en steeds veranderende layouts. Ik heb meer scrapers zien crashen en verbranden dan me lief is — meestal omdat ze best practices negeerden of onderschatten hoe slim anti-scrapingmaatregelen inmiddels zijn. Laten we dus ingaan op de beste praktijken uit de praktijk voor efficiënte Node.js-webscraping, met een paar verhalen, een snufje humor en vooral veel bruikbaar advies.
Waarom kiezen voor Node.js voor efficiënte webscraping?
Als je ooit honderden (of duizenden) pagina’s tegelijk hebt geprobeerd te scrapen, weet je dat snelheid en gelijktijdigheid allesbepalend zijn. Daar blinkt Node.js in uit. Het asynchrone, niet-blokkerende I/O-model is gemaakt om enorme hoeveelheden gelijktijdige netwerkverzoeken af te handelen—zie het als de ultieme multitasker voor het web (Node.js Docs). Terwijl andere talen vastlopen op het wachten tot elke aanvraag klaar is, blijft Node.js gewoon zijn event loop draaien en verzoeken jongleren als een met cafeïne volgepompte circusartiest.
Ik heb Node.js Python en Java zien overtreffen in scenario’s waarin realtime updates en grootschalige extractie nodig zijn, vooral wanneer de doelwebsites vol JavaScript zitten. Sterker nog, ongeveer 40% van de ontwikkelaars gebruikt Node.js inmiddels voor backend- en automatiseringstaken, waarmee het de populairste webtechnologie ter wereld is.
Node.js versus andere webscrapingframeworks
Laten we even nerdy worden. Zo verhoudt Node.js zich tot de concurrentie:
| Framework | Sterke punten | Zwakke punten | Beste gebruiksscenario’s |
|---|---|---|---|
| Node.js | Asynchroon, sterk in gelijktijdigheid, enorm npm-ecosysteem, native JS voor dynamische sites | Kan veel geheugen verbruiken, callback hell (als je geen async/await gebruikt) | Realtime scraping, sites met veel JavaScript, schaalbare microservices |
| Python | Veel scrapingbibliotheken (BeautifulSoup, Scrapy), eenvoudige syntax | Langzamer bij veel gelijktijdigheid, moeite met JS-gerenderde sites | Statische HTML, onderzoek, prototyping |
| Java | Sterke typing, robuust voor enterprise | Veel boilerplate, minder flexibel voor snelle scripts | Grootschalige, enterprise-grade scraping |
| Go | Snel, efficiënte gelijktijdigheid | Kleiner ecosysteem, steilere leercurve | High-performance scraping met lage latency |
Voor de meeste zakelijke gebruikers zit Node.js precies in de sweet spot: snel, flexibel en perfect afgestemd op het moderne web vol JavaScript (Thunderbit Blog).
Een robuuste Node.js-webscrapingomgeving opzetten
Een goede scraper begint met een stevige basis. Dit is mijn vaste setup:
- Projectstructuur: Houd het modulair. Gebruik mappen zoals
/src,/libsen/config. Bewaar gevoelige informatie (API-sleutels, proxies) in omgevingsvariabelen metdotenv(Thunderbit Guide). - HTTP-client: Gebruik axios, got of node-fetch voor requests.
- HTML-parsing: Cheerio voor statische HTML, Puppeteer of Playwright voor dynamische content.
- Hulpmiddelen: Gebruik Lodash voor dataverwerking, en validator.js of Joi voor datavalidatie.
- Testen en linten: Mocha voor tests, ESLint voor codekwaliteit (LogRocket).
Essentiële Node.js-bibliotheken voor webscraping
- HTTP-clients (axios / got / ingebouwde
fetch): Voor het versturen van verzoeken. Goed om meteen te vermelden: sinds Node.js v18 kun jefetchnative gebruiken zonder iets te installeren, en in Node.js v22 is het stabiel geworden. Voor een nieuw project op een recente Node-versie heb je hetnode-fetch-pakket waarschijnlijk helemaal niet nodig — je kunt gewoon directfetchaanroepen. Ik pak nog steeds vaak axios als ik interceptors, automatische JSON-afhandeling en een vertrouwde promise-API wil die zowel in Node als in de browser werkt, en got kies ik wanneer ik retries, streams of HTTP/2 direct uit de doos nodig heb. Kies wat past bij je stack; voor een snel script is nativefetchprima. - Cheerio: Snelle HTML-parser met jQuery-achtige syntax. Ideaal voor statische pagina’s—parset in ongeveer 0,5 seconde (Oxylabs).
- Playwright / Puppeteer: Headless browserautomatisering voor dynamische sites met veel JavaScript. Langzamer (~4 seconden per pagina), maar onmisbaar voor sites die content pas na het laden inladen (Bright Data). Als je in 2026 vanaf nul begint, is Playwright de standaard — cross-browser direct beschikbaar (Chromium / Firefox / WebKit), ingebouwde trace viewer, en het team dat Puppeteer oorspronkelijk bouwde werkt er nu aan bij Microsoft. Puppeteer wordt nog steeds onderhouden voor Chrome-only scenario’s, maar de release notes gaan al een tijd vooral over Chrome-compatibiliteit in plaats van nieuwe functies.
- dotenv: Voor het beheren van omgevingsvariabelen.
- csv-writer/jsonfile: Voor het exporteren van data.
Veelvoorkomende valkuilen bij Node.js-webscraping vermijden
Ik ben de tel kwijtgeraakt van hoeveel scrapers ik heb zien worden geblokkeerd, crashen of simpelweg een berg rommelige data dumpen. Hier moet je op letten:
- robots.txt en de gebruiksvoorwaarden negeren: Controleer dit altijd vóór je gaat scrapen. Als je hiertegen ingaat, kan je IP worden geblokkeerd — of erger, kun je juridisch in de problemen komen (ScraperAPI).
- Servers overbelasten: Bestook servers niet met verzoeken. Tem je scraper met willekeurige vertragingen (1–3 seconden), gebruik concurrency-controles en gedraag je niet als een hyperactieve robot (ScrapeGraphAI).
- Foutafhandeling vergeten: Gebruik altijd try/catch rond requests, handel HTTP-fouten af en log mislukte pogingen. Probeer tijdelijke fouten opnieuw met exponentiële backoff (ScrapeGraphAI).
- Request-headers vergeten: Gebruik realistische User-Agent-strings en roteer ze. Voeg ook Accept-Language, Referer en andere headers toe om echte browsers na te bootsen (ScrapeGraphAI).
Hoe je anti-scrapingmechanismen omzeilt
Moderne websites zijn tot de tanden bewapend met anti-bottechnologie. Zo ontwijk ik de digitale mijnenvelden:
- Proxy’s/IP’s roteren: Gebruik een proxy-pool en roteer IP’s om blokkades te vermijden (Medium).
- Headers randomiseren: Roteer per verzoek User-Agent, Accept-Language en andere headers.
- Stealth in headless browsers: Gebruik plugins zoals
puppeteer-extra-plugin-stealthom automatiseringssporen te verbergen. - Menselijk gedrag simuleren: Voeg willekeurige vertragingen, muisbewegingen, scrollgedrag en zelfs typfouten toe (ZenRows).
Menselijk gedrag simuleren in Node.js-scrapers
Dit is waar het leuk wordt — en een beetje vreemd. In plaats van direct te klikken en te scrollen, laat je je scraper bijvoorbeeld:
- Willekeurige pauzes nemen tussen acties (
await page.waitForTimeout(randomDelay)) - De muis in kleine, schokkerige stapjes bewegen (
page.mouse.move(x, y)) - Typen met willekeurige vertragingen en af en toe een typo (
page.type(selector, text, {delay: random(100,200)})) - Onregelmatig scrollen, niet alleen naar beneden
Deze trucs kunnen je succeskans op afgeschermde sites flink verhogen (ScraperAPI).
Complexe data-extractie vereenvoudigen met Thunderbit
Gegevens van elke website scrapen met AI Sla de boilerplate over: Thunderbit's agentische webscraper leest elke pagina en haalt data in één klik eruit, zonder Node.js-code die je moet onderhouden. Get Started Free
Laten we het hebben over de olifant in de kamer: scrapen is lastig. Maar dat hoeft niet zo te zijn. Daarom hebben we Thunderbit gebouwd.
Thunderbit is een agentische webscraper Chrome-extensie waarmee je data van elke website kunt extraheren in gewone taal. Klik gewoon op “One Click Extract”, laat de AI uitzoeken wat er op de pagina staat en druk op “Scrape”. Het is alsof je een junior developer hebt die nooit slaapt en nooit om opslag vraagt.
Nog beter: Thunderbit biedt een API, zodat je het direct in je Node.js-workflows kunt inpluggen. In plaats van duizenden regels scrapingcode te schrijven, laat je Thunderbit het zware werk doen—dynamische content, subpagina’s, paginering en alles daaromheen. Jij haalt gewoon de gestructureerde data op (CSV, JSON of direct naar Google Sheets, Airtable, Notion) en kunt verder met je dag (Thunderbit Blog).
Probeer de Thunderbit Chrome-extensie gratis Installeer de gratis Chrome-extensie en extraheer gestructureerde data in één klik — of roep Thunderbit's API aan vanuit je Node.js-app. Get Started Free
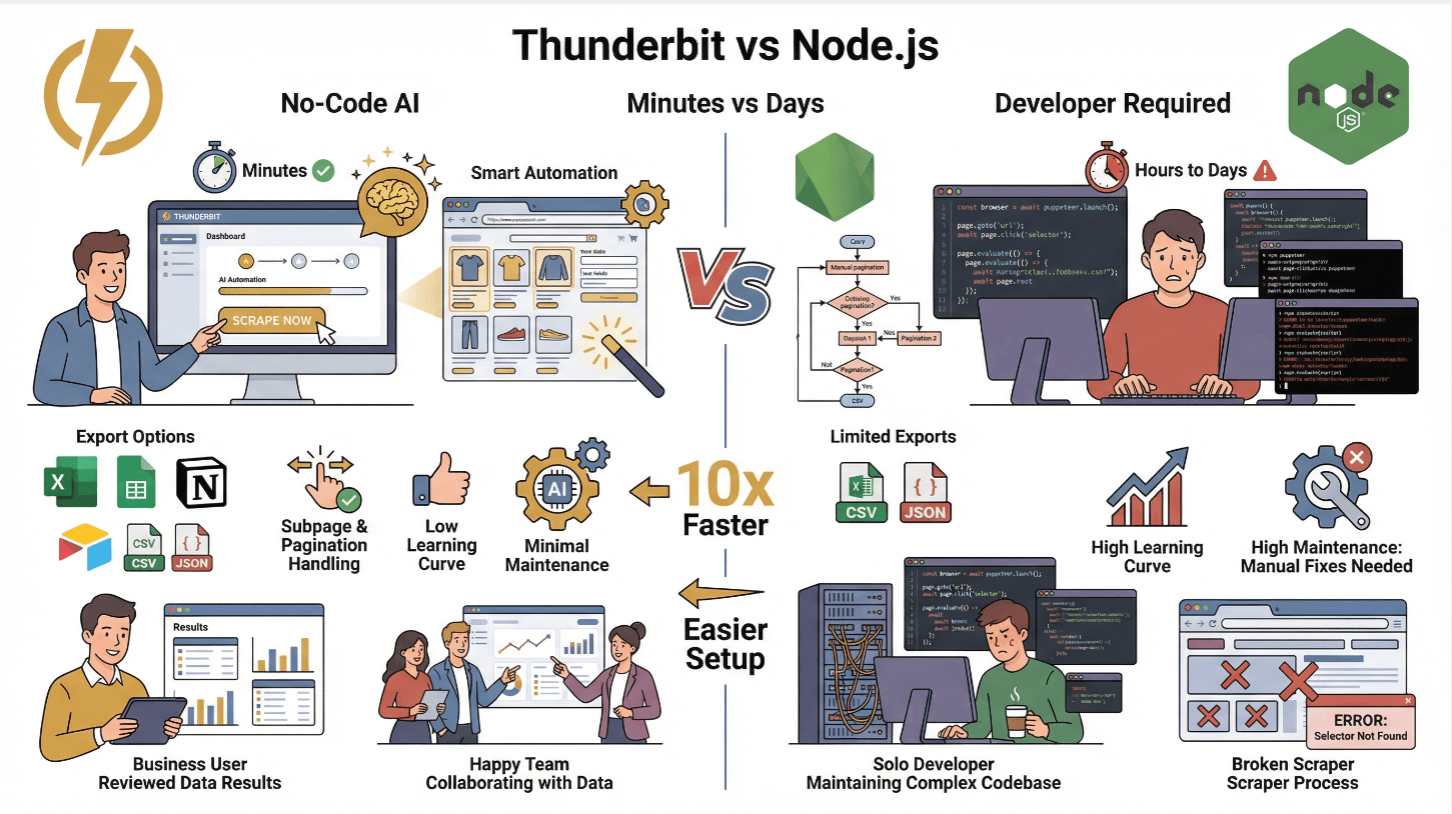
Thunderbit versus traditionele Node.js-scraping
| Functie | Thunderbit | Traditionele Node.js-scraper |
|---|---|---|
| Insteltijd | Minuten (geen code) | Uren tot dagen (coderen, testen) |
| Omgaan met dynamische content | Ja (AI + browser) | Ja (met Puppeteer/Playwright) |
| Subpagina’s & paginering | 1 klik | Handmatige code vereist |
| Data-export | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (maatwerkcode) |
| Leercurve | Laag (zakelijke gebruikers) | Hoog (ontwikkelaars) |
| Onderhoud | Minimaal (AI past zich aan) | Hoog (handmatige fixes bij sitewijzigingen) |
Thunderbit is ideaal voor niet-technische teams of voor iedereen die het saaie werk wil overslaan en zich wil richten op inzichten. Voor gevorderde gebruikers kun je Thunderbit’s API nog steeds inzetten om scraping op schaal te automatiseren (Thunderbit Docs).
Cheerio en Puppeteer combineren voor dynamische content
Dit is mijn favoriete power-combinatie voor Node.js-scraping. Zo werkt het:
- Gebruik Puppeteer om de pagina te laden en JavaScript uit te voeren (wacht op
networkidlezodat alle content geladen is). - Haal de HTML op met
await page.content(). - Parse met Cheerio: geef de HTML door aan Cheerio voor ultrasnelle parsing in jQuery-stijl en data-extractie.
Deze hybride aanpak geeft je het beste van twee werelden: de kracht van Puppeteer voor dynamische content, en de snelheid van Cheerio voor parsing (Browserless).
Performance-tip: Selecteer alleen de elementen die je echt nodig hebt. Cheerio laadt de hele DOM in het geheugen, dus vermijd brede selectors en cache resultaten als je dezelfde pagina’s vaker scrapt (Oxylabs).
HTML-parsing en data-extractie optimaliseren
- Gebruik specifieke selectors: Vermijd
$('body *')—richt je alleen op wat je nodig hebt. - Stream grote pagina’s: Overweeg streaming of het opdelen van de taak bij enorme HTML-bestanden.
- Gegerenderde HTML cachen: Als je URL’s opnieuw bezoekt, cache de HTML om onnodige requests te voorkomen.
- Data valideren en opschonen: Gebruik validatiebibliotheken om te voorkomen dat je database vol rommel raakt (ScrapeGraphAI).
Schaalbare uitrol van een Node.js-webscraper in de cloud
Scrapen op schaal? Dan is het tijd voor cloud-native.
- Dockeriseer je scraper: Schrijf een
Dockerfile, kopieer je code, installeer dependencies en stel de entrypoint in. - Deploy naar de cloud: Gebruik AWS EC2, Google Cloud Compute of Azure VM’s voor eenvoudige taken. Voor serieuze schaal kies je Kubernetes of beheerde services zoals AWS ECS/EKS, Google Cloud Run of Azure Kubernetes Service (DigitalOcean).
- Orkestreer met Kubernetes: Draai meerdere pods, schaal automatisch op basis van vraag en gebruik load balancers om URL’s te verdelen.
- Plan taken in: Gebruik cloud schedulers (CloudWatch Events, Cloud Scheduler) of cronjobs om scrapes periodiek te starten.
In een praktijkvoorbeeld zorgde opschalen van 5 naar 10 Kubernetes-pods ervoor dat een scrape van 400 pagina’s daalde van minuten naar minder dan een minuut (DigitalOcean).
Je scrapinginfrastructuur monitoren en automatisch schalen
- Logging: Stream logs naar CloudWatch, Stackdriver of Datadog. Stel alerts in voor fouten of vertragingen.
- Health checks: Gebruik Prometheus en Grafana voor statistieken zoals pagina’s per minuut, foutpercentages en pod-gezondheid.
- Auto-scaling: Stel Kubernetes HPA (Horizontal Pod Autoscaler) in om pods op basis van CPU of aantal requests op te schalen.
Implementeer altijd retries met exponentiële backoff om netwerkstoringen of tijdelijke blokkades te herstellen.
Beste praktijken voor dataopslag en nabewerking
Zodra je de data hebt gescrapt, moet je die opslaan en opschonen:
- Kleine jobs: Exporteer naar CSV, JSON of push naar Google Sheets, Airtable of Notion (Thunderbit doet dit standaard).
- Grote jobs: Gebruik SQL (MySQL/PostgreSQL) voor gestructureerde data, of NoSQL (MongoDB, DynamoDB) voor halfgestructureerde of veranderende schema’s (ScrapeHero).
- Cloudopslag: S3 of Google Cloud Storage voor ruwe bestanden en back-ups.
- Datacleaning: Valideer velden altijd, normaliseer formaten (datums, nummers) en dedupliceer records. Gebruik schema-validators om datakwaliteit af te dwingen (ScrapeGraphAI).
Bewaar zowel de ruwe als de opgeschoonde data — je weet nooit wanneer je iets opnieuw moet verwerken of debuggen.
Conclusie: belangrijkste inzichten voor efficiënte Node.js-webscraping
Sla de scraper-code over Bekijk hoe Thunderbit's agentische webscraper zich verhoudt tot het zelf schrijven en onderhouden van scraping-scripts. Get Started Free
Laten we afsluiten met de kern:
- Benut de asynchrone kracht van Node.js voor grootschalige, gelijktijdige scraping — vooral op sites vol JavaScript.
- Combineer de juiste tools: Gebruik axios/got voor requests, Cheerio voor statische HTML, Puppeteer voor dynamische content, en mix ze voor snelheid en flexibiliteit.
- Vermijd anti-botvallen: Roteer proxies en headers, simuleer menselijk gedrag en respecteer robots.txt.
- Maak het eenvoudiger met Thunderbit: Voor zakelijke gebruikers of snelle prototypes laat Thunderbit je complexe data extraheren met AI en via API in je Node.js-stack koppelen.
- Schaal slim uit: Dockeriseer, orkestreer met Kubernetes en monitor alles voor betrouwbaarheid.
- Sla je data op en maak ze schoon: Kies de juiste opslag voor je behoefte en valideer altijd vóór gebruik.
Het web wordt er niet eenvoudiger op, maar met deze best practices blijven je Node.js-scrapers snel, betrouwbaar en telkens een stap voor op de anti-bot-wapenwedloop. En als je ooit genoeg hebt van selectors debuggen om 2 uur ’s nachts, onthoud dan: Thunderbit’s AI is altijd wakker.
Wil je verder leren? Bekijk de Thunderbit Blog voor meer deep-dives, of probeer Thunderbit’s Chrome-extensie om te zien hoe eenvoudig scrapen kan zijn.
Scrapen met Thunderbit Agentic Web Scraper Thunderbit's Web Scraper API laat je extractie starten vanuit je eigen Node.js-code, met een gratis startpakket. Get Started Free
Veelgestelde vragen
1. Waarom is Node.js in 2025 bijzonder geschikt voor webscraping?
Het asynchrone, event-driven model van Node.js maakt het mogelijk om duizenden gelijktijdige requests af te handelen, waardoor het ideaal is voor het scrapen van grote hoeveelheden data of realtime updates. Het enorme npm-ecosysteem en de native JavaScript-ondersteuning zijn perfect voor moderne websites met veel JavaScript (Node.js Docs).
2. Hoe voorkom ik blokkades bij scrapen met Node.js?
Gebruik roterende proxy’s, randomiseer request-headers, tem je requests met willekeurige vertragingen en simuleer menselijk gedrag (muisbewegingen, scrollen, typen) met tools zoals Puppeteer. Respecteer altijd robots.txt en de voorwaarden van de site (Medium).
3. Wanneer gebruik ik Cheerio versus Puppeteer in mijn Node.js-scraper?
Gebruik Cheerio voor snelle parsing van statische HTML (wanneer de data al in de ruwe HTML staat). Gebruik Puppeteer voor sites die content dynamisch met JavaScript laden. Voor het beste resultaat laat je eerst Puppeteer de pagina renderen en gebruik je daarna Cheerio om de HTML te parsen (Bright Data).
4. Hoe vereenvoudigt Thunderbit Node.js-webscraping?
Thunderbit laat je gestructureerde data van elke website extraheren met AI en natuurlijke taalprompts — zonder code. Het handelt dynamische content, subpagina’s en paginering af en biedt een API voor integratie met Node.js. Data kan direct worden geëxporteerd naar Excel, Google Sheets, Airtable of Notion (Thunderbit Blog).
5. Wat is de beste manier om Node.js-scrapers in de cloud op te schalen en te monitoren?
Dockeriseer je scraper, deploy op Kubernetes of beheerde cloudservices en gebruik autoscaling om pieken in vraag op te vangen. Monitor logs en statistieken met tools zoals CloudWatch of Prometheus en stel alerts in voor fouten of vertragingen (DigitalOcean).
Klaar om je webscraping naar een hoger niveau te tillen? Probeer Thunderbit en moge je scrapers snel, onzichtbaar en altijd een stap voor blijven.
Probeer Agentic Web Scraper Get Started Free
Meer lezen
- Hoe je Node-webscraping onder de knie krijgt voor beginners: een stapsgewijze handleiding
- Hoe je websitegegevens efficiënt scrapt met de beste tools
- Hoe je een website efficiënt crawlt: stapsgewijze handleiding
- Hoe je JavaScript-crawling onder de knie krijgt: een beginnersgids
- Hoe je webscraping voor prijsvergelijking onder de knie krijgt in 2026




