
Het web groeit sneller dan ooit, en als je in business, tech of gewoon een datafanaat bent zoals ik, is je dit vast al opgevallen: de echte waarde zit in de data die je kunt verzamelen — niet alleen in de data die je kunt zien. Bedrijven racen tegenwoordig om webdataverzameling te automatiseren, en de wereldwijde webscrapingmarkt zal naar verwachting $2 miljard in 2030 bereiken. En hier is een leuk feitje: meer dan 65% van de organisaties gebruikt inmiddels webcrawlers of scrapers om hun AI, analytics en bedrijfsprocessen te voeden.
Dus hoe doe je mee aan deze trend? Voor de meeste mensen is het antwoord Python. Het is dé taal voor het bouwen van websitecrawlers — eenvoudig, krachtig en boordevol libraries die crawlen en scrapen een stuk makkelijker maken. In deze gids leg ik uit wat een websitecrawler is, waarom Python de beste keuze is, hoe je stap voor stap zelf een crawler bouwt, en hoe tools zoals Thunderbit het hele proces nóg eenvoudiger maken (vooral als je liever klikt dan code schrijft). Of je nu ontwikkelaar bent, data-gedreven marketeer of gewoon iemand die saaie taken wil automatiseren: hier vind je handvatten om je webdata-skills naar een hoger niveau te tillen.
Wat is een websitecrawler? (En waarom zou je erom geven?)
Laten we het simpel houden: een websitecrawler is een programma dat automatisch over het web navigeert, pagina’s bezoekt, links volgt en onderweg eventueel data verzamelt. Zie het als een bovenmenselijke websufter — eentje die nooit slaapt, zich nooit verveelt en nooit per ongeluk het verkeerde tabblad sluit. Crawlers vormen de ruggengraat van zoekmachines (zoals Googlebot), maar bedrijven gebruiken ze ook voor alles van prijsmonitoring tot marktonderzoek.
Maar wacht — wat is eigenlijk het verschil tussen crawlen en scrapen? Crawlen draait om het vinden en navigeren van pagina’s (zoals een stad in kaart brengen), terwijl scrapen draait om het onttrekken van specifieke data uit die pagina’s (zoals alle menukaarten van restaurants in een stad verzamelen). In de praktijk doen de meeste projecten beide: crawlen om de pagina’s te vinden, scrapen om de benodigde data op te halen (Baeldung).
Praktische zakelijke toepassingen van crawlers:
- Leadgeneratie: automatisch contactgegevens verzamelen uit directories of social media.
- Prijstracking: prijzen en voorraad van concurrenten volgen over duizenden producten.
- Contentmonitoring: meldingen krijgen wanneer je merk wordt genoemd in nieuws, blogs of forums.
- SEO-audits: je eigen site scannen op kapotte links of ontbrekende metadata.
- Marktonderzoek: vastgoedaanbod, vacatures of productreviews bundelen voor analyse.
Als je ooit hebt gewenst dat je jezelf kon klonen om webonderzoek bij te houden, dan is een crawler het beste alternatief.
Waarom websitecrawlers belangrijk zijn voor bedrijfsautomatisering
Laten we praktisch worden. Waarom investeren bedrijven in crawlers en scrapers? Omdat de ROI enorm is. Hier zie je in één oogopslag hoe verschillende teams crawlers gebruiken — en wat ze ermee winnen:
| Use Case | Key Benefit | Who Uses It |
|---|---|---|
| Lead Generation | Automates prospect list building, saves hours | Sales, Recruiting |
| Price Tracking | Real-time competitor insights, dynamic pricing | E-commerce, Product Teams |
| Content Monitoring | Brand protection, trend spotting | Marketing, PR |
| SEO Site Audit | Site health, improved rankings | SEO, Webmasters |
| Market Research | Up-to-date, large-scale datasets for analysis | Analysts, Research Teams |
Uit een case study bleek dat het automatiseren van een wekelijkse dataverzameltaak (scrapen van 5–7 websites) een medewerker meer dan 50 uur per jaar bespaarde — vermenigvuldig dat met een team, en je snapt waarom bedrijven “nooit meer terug willen” zodra ze crawlers gaan gebruiken.
Python: de beste keuze voor het bouwen van een websitecrawler
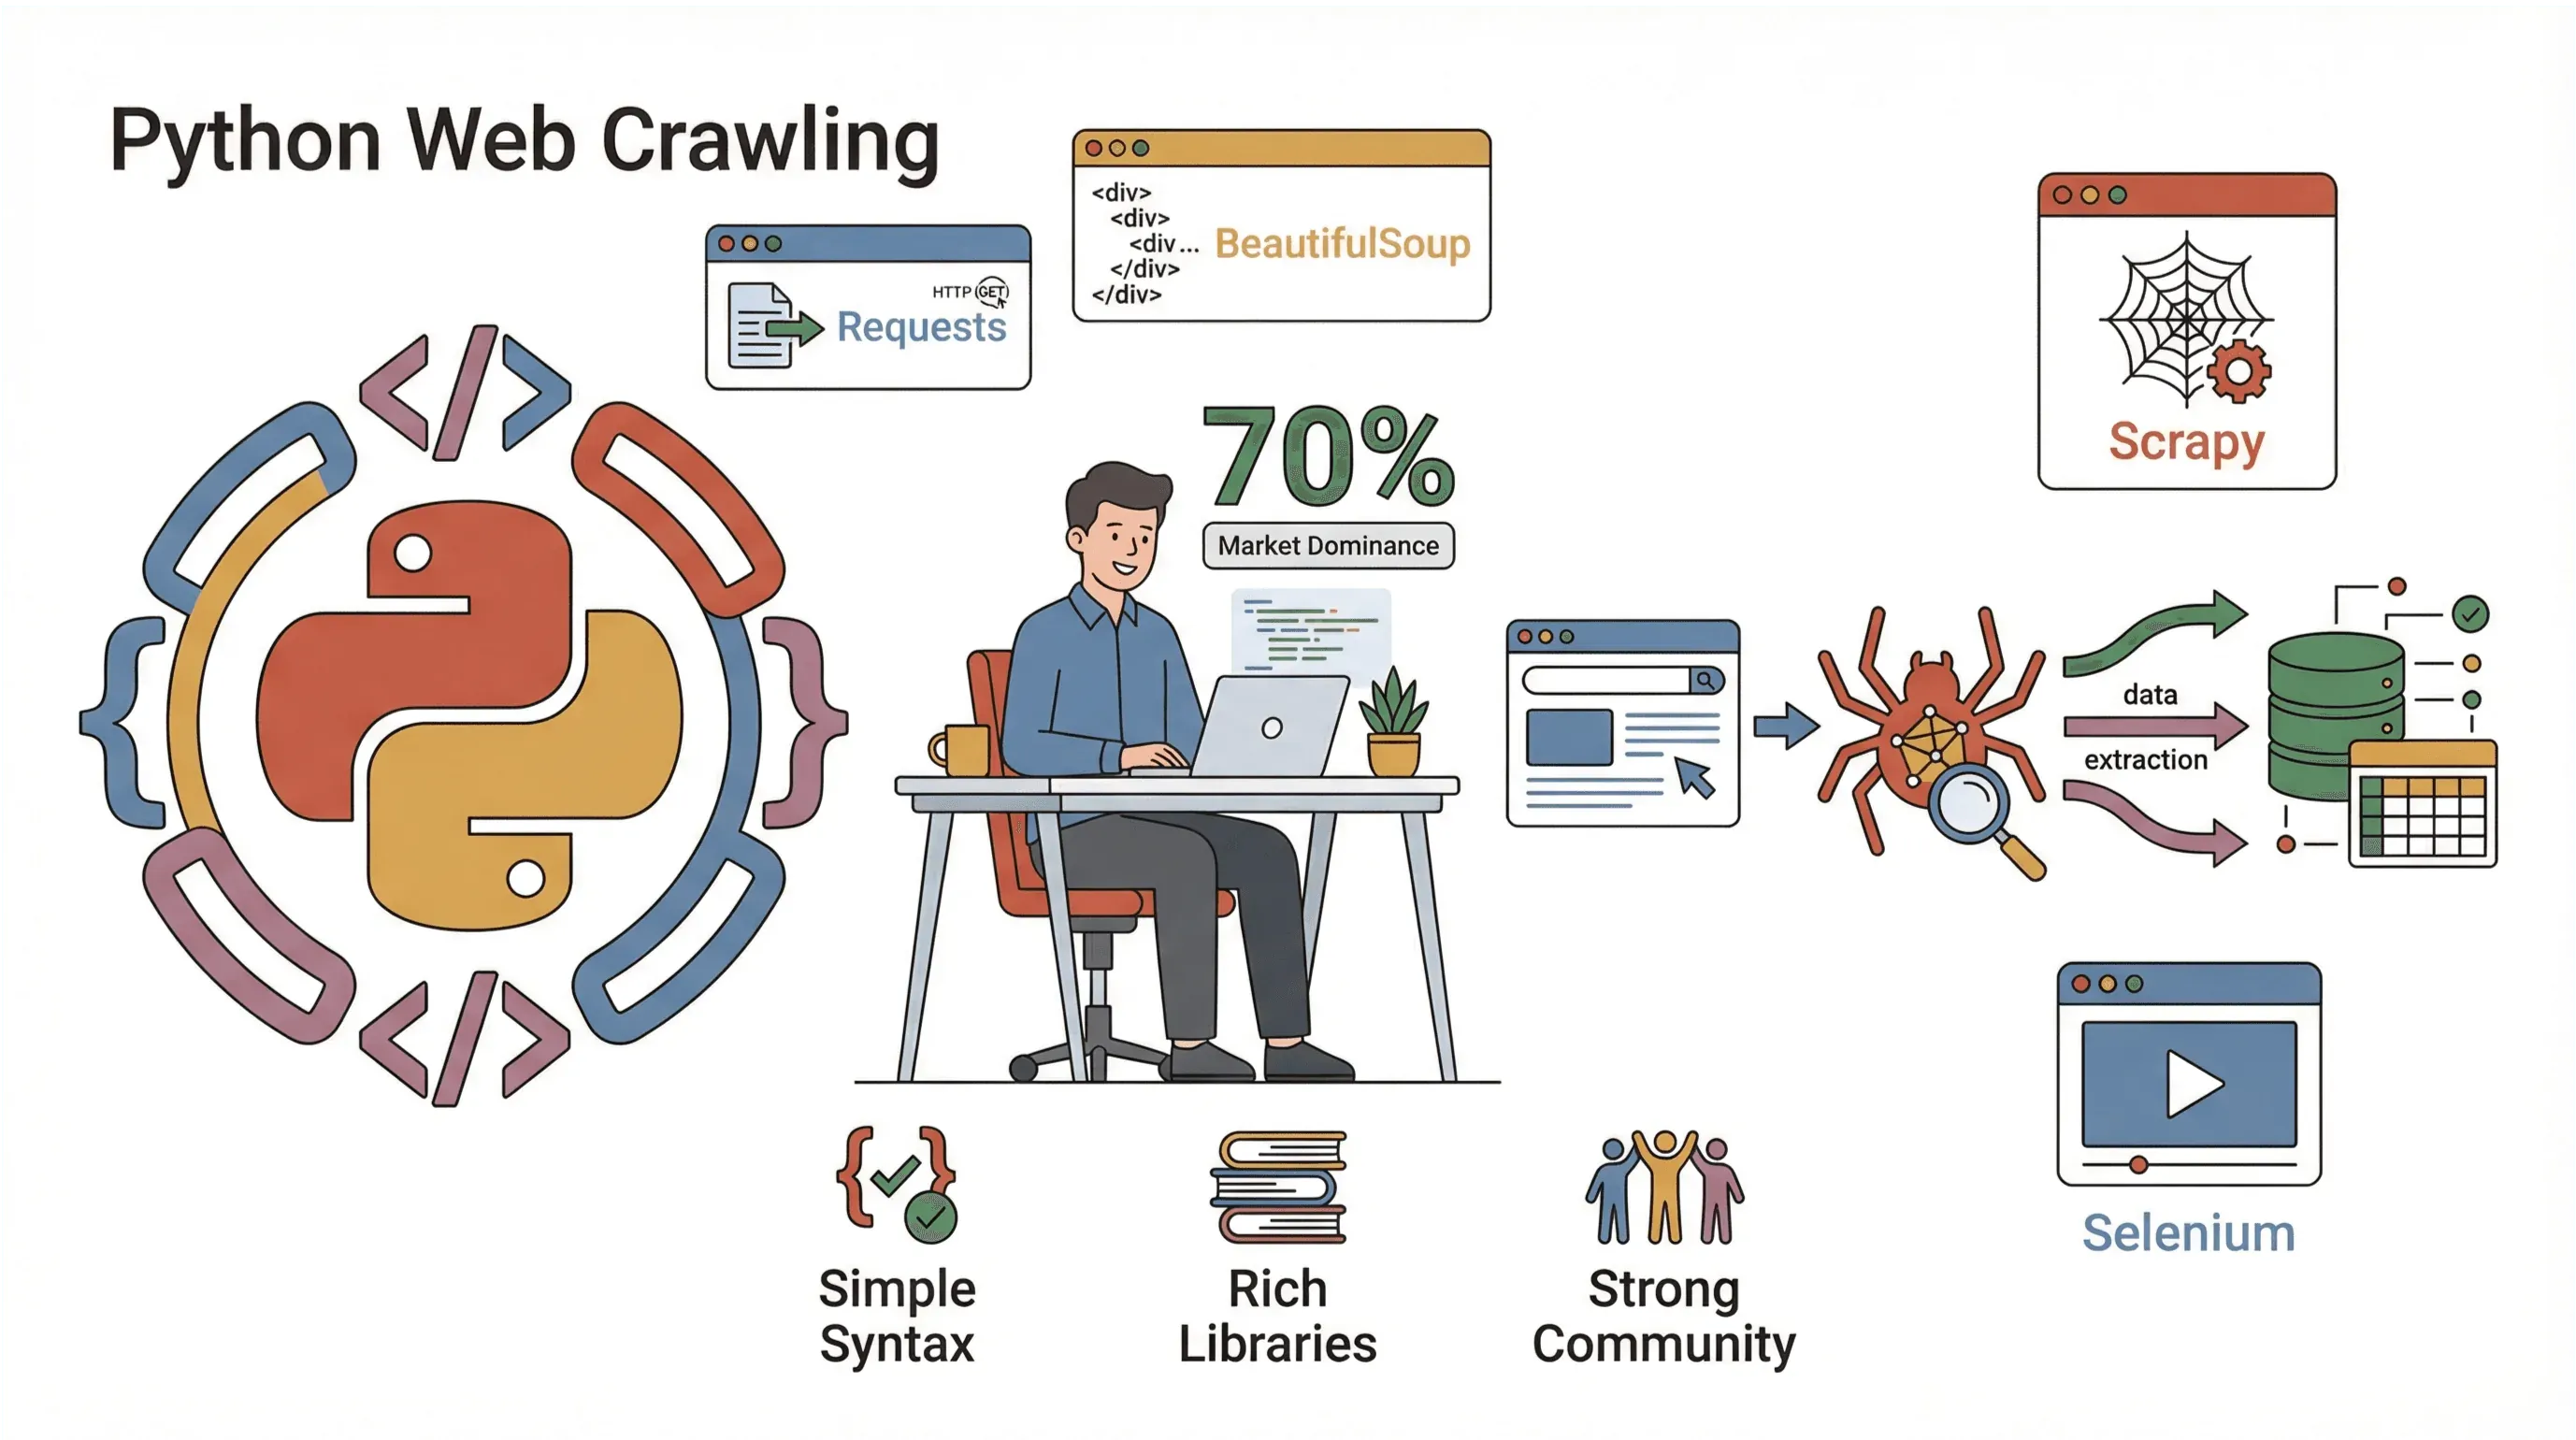 Waarom is Python de koning van webcrawling? Drie belangrijke redenen:
- Eenvoud: Python heeft leesbare, beginnersvriendelijke syntax en laat je in slechts een paar regels werkende crawlers schrijven.
- Library-ecosysteem: Python heeft een rijk aanbod aan libraries voor elk onderdeel van crawlen — pagina’s ophalen, HTML parsen, JavaScript afhandelen en meer.
- Community: Met bijna 70% van de webscrapingprojecten gebouwd op Python, profiteer je van een enorme community, talloze tutorials en antwoorden op bijna elk probleem waar je tegenaan loopt.
Top Python-libraries voor webcrawling:
- Requests: de makkelijkste manier om webpagina’s op te halen (HTTP GET/POST).
- BeautifulSoup: de standaard voor HTML-parsing en het vinden van elementen.
- Scrapy: een compleet crawling framework voor grootschalige projecten.
- Selenium: automatiseert browsers voor het scrapen van sites met veel JavaScript.
Vergeleken met andere talen (zoals Java of C#) kun je met Python veel sneller van idee naar werkende crawler gaan. En als je met data werkt, kun je de output van je crawler direct in Pandas stoppen voor analyse — zonder gedoe met exporteren en importeren.
Parse-methoden vergelijken: Regex vs. BeautifulSoup vs. Scrapy
Als het gaat om het extraheren van data uit webpagina’s, heb je opties. Zo verhouden de belangrijkste methoden zich tot elkaar:
| Method | How It Works | Pros 🟢 | Cons 🔴 | Best For |
|---|---|---|---|---|
| Regex | Pattern-match raw HTML | Fast for simple, known patterns | Brittle, breaks on HTML changes | Quick hacks, extracting URLs |
| BeautifulSoup | Parses HTML into a tree, search by tags | Easy, flexible, handles messy HTML | Slower on huge pages, manual crawl logic | Most small/medium scraping scripts |
| Scrapy | Full crawling framework, CSS/XPath parsing | Fast, scalable, handles crawling & parsing | Steeper learning curve, more setup | Large-scale, production crawlers |
- Regex is als een metaaldetector op het strand — snel, maar je mist dingen als het zand verschuift.
- BeautifulSoup is als een kaart en een schep — je kunt overal graven, maar je moet zelf over het strand lopen.
- Scrapy is alsof je een heel team met vrachtwagens en GPS meebrengt — overdreven voor een zandbak, maar onverslaanbaar voor grote klussen.
Voor de meeste beginners raad ik aan te starten met Requests + BeautifulSoup. Je leert de basisprincipes en kunt later altijd doorgroeien naar Scrapy wanneer je wilt opschalen.
Stap voor stap: zo bouw je een eenvoudige websitecrawler in Python
Klaar om zelf aan de slag te gaan? Laten we een basiscrawler bouwen die pagina’s bezoekt, links volgt en data verzamelt. Ik loop je door elke stap heen, met code die je zo kunt kopiëren en aanpassen.
Stap 1: je Python-omgeving instellen
Zorg eerst dat je Python 3.10+ hebt geïnstalleerd. (Controleer dat met python --version.) Ik raad aan om voor je project een virtuele omgeving te maken:
python -m venv venv
source venv/bin/activate  # On Windows: venv\Scripts\activate
Installeer daarna de libraries die je nodig hebt:
pip install requests beautifulsoup4
Dat is alles! Open je favoriete code-editor en maak je klaar om je crawler te schrijven.
Stap 2: je eerste crawler-script schrijven
Laten we beginnen met het ophalen van één pagina. Hier is een eenvoudig script:
import requests

def crawl_page(url):
    response = requests.get(url)
    response.raise_for_status()  # Throws error if not 200 OK
    print(response.text[:500])   # Print first 500 chars for preview

crawl_page("https://www.scrapingcourse.com/ecommerce/")
Je zou nu een blok HTML in je console moeten zien — bewijs dat je verbinding hebt met het web.
Stap 3: links volgen en meer data verzamelen
Nu laten we onze crawler links volgen en meerdere pagina’s bezoeken. We houden een lijst bij met URL’s die nog bezocht moeten worden, en een set met URL’s die we al gezien hebben (om loops te voorkomen):
from bs4 import BeautifulSoup

start_url = "https://www.scrapingcourse.com/ecommerce/"
urls_to_visit = [start_url]
visited_urls = set()
max_pages = 20  # Safety limit

while urls_to_visit and len(visited_urls) < max_pages:
    current_url = urls_to_visit.pop(0)
    try:
        resp = requests.get(current_url)
        resp.raise_for_status()
    except Exception as e:
        print(f"Failed to retrieve {current_url}: {e}")
        continue

    soup = BeautifulSoup(resp.text, "html.parser")
    print(f"Crawled: {current_url}")

    for link_tag in soup.find_all("a", href=True):
        url = link_tag['href']
        if not url.startswith("http"):
            url = requests.compat.urljoin(current_url, url)
        if url.startswith(start_url) and url not in visited_urls:
            urls_to_visit.append(url)
    visited_urls.add(current_url)
Dit script crawlt tot 20 pagina’s en volgt alleen links binnen dezelfde site. Je ziet elke URL verschijnen zodra die is gecrawld.
Stap 4: data uit pagina’s halen
Stel dat je productnamen en prijzen van elke pagina wilt verzamelen. Dan zou je het zo kunnen aanpakken:
product_data = []

while urls_to_visit and len(visited_urls) < max_pages:
    # ... (same as above)
    soup = BeautifulSoup(resp.text, "html.parser")
    if "/page/" in current_url or current_url == start_url:
        items = soup.find_all("li", class_="product")
        for item in items:
            name = item.find("h2", class_="product-name")
            price = item.find("span", class_="price")
            link = item.find("a", class_="woocommerce-LoopProduct-link")
            if name and price and link:
                product_data.append({
                    "name": name.get_text(),
                    "price": price.get_text(),
                    "url": link['href']
                })
    # ... (rest of crawl logic)

# Save to CSV
import csv
with open("products.csv", "w", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price", "url"])
    writer.writeheader()
    writer.writerows(product_data)
print(f"Scraped {len(product_data)} products.")
Nu heb je een CSV-bestand met al je gescrapete producten — klaar voor analyse, upload of om mee te pronken bij vrienden.
Stap 5: je crawler debuggen en optimaliseren
Een crawler bouwen is één ding; hem robuust maken is iets anders. Hier zijn een paar tips uit eigen ervaring (en een paar hard bevochten lessen):
- Stel een User-Agent header in: sommige sites blokkeren standaard “Python-requests”. Doe alsof je een browser bent:
headers = {"User-Agent": "Mozilla/5.0"} requests.get(url, headers=headers) - Ga netjes om met fouten: gebruik try/except om kapotte of geblokkeerde pagina’s over te slaan.
- Voorkom eindeloze loops: houd altijd bij welke URL’s al bezocht zijn en stel een limiet in op het aantal pagina’s.
- Beperk je requests: voeg
time.sleep(1)toe tussen requests om blokkades te voorkomen. - Controleer robots.txt: respecteer altijd de crawlregels van een site (meer hierover hieronder).
- Log je voortgang: print of log elke URL terwijl je crawlt — onmisbaar bij debugging.
Als je crawler geblokkeerd raakt, vreemde content teruggeeft of data mist, controleer dan je headers, vertraag je tempo en zorg dat je geen anti-botmaatregelen triggert.
Thunderbit: websitecrawling eenvoudiger maken met AI
Data van elke website halen met AI Get Started Free
Laten we het hebben over de “makkelijke knop” voor webcrawling: Thunderbit. Hoe graag ik ook met Python werk, soms wil je gewoon de data — zonder setup, debugging of onderhoud. Thunderbit is een AI-gedreven webscraper Chrome-extensie waarmee je in slechts een paar klikken data van elke website kunt halen.
Waarom is Thunderbit bijzonder?
- AI stelt velden voor: Thunderbit’s AI scant de pagina en adviseert welke data je kunt extraheren — je hoeft geen HTML te inspecteren of selectors te schrijven.
- No-code, browser-based: draait in je browser, dus werkt ook op ingelogde sites en pagina’s met veel JavaScript.
- Subpage Scraping: meer details nodig? Thunderbit kan automatisch elke subpagina bezoeken (zoals productdetails) en je tabel verrijken.
- Direct exporteren: exporteer naar Excel, Google Sheets, Airtable of Notion — zonder CSV-gedoe.
- Cloud- of lokale scraping: kies tussen snelle cloud scraping (voor publieke sites) of browsermodus (voor ingelogde of lastige sites).
- Planning: stel scrapes in om automatisch te draaien — zonder cronjobs of servers.
Voor zakelijke gebruikers is Thunderbit een echte gamechanger. Je gaat van “ik heb deze data nodig” naar “hier is mijn spreadsheet” in minuten in plaats van uren. En als je developer bent, kan Thunderbit je scripts aanvullen — gebruik het voor snelle taken of als back-up wanneer je code even pauze nodig heeft.
Wil je zien hoe het werkt? Download de Chrome-extensie en probeer je favoriete site te scrapen. De gratis versie laat je een handvol pagina’s scrapen, en betaalde plannen beginnen al vanaf $15 per maand voor 500 credits.
Probeer Thunderbit AI Web Scraper gratis
Belangrijke aandachtspunten bij het bouwen van een websitecrawler in Python
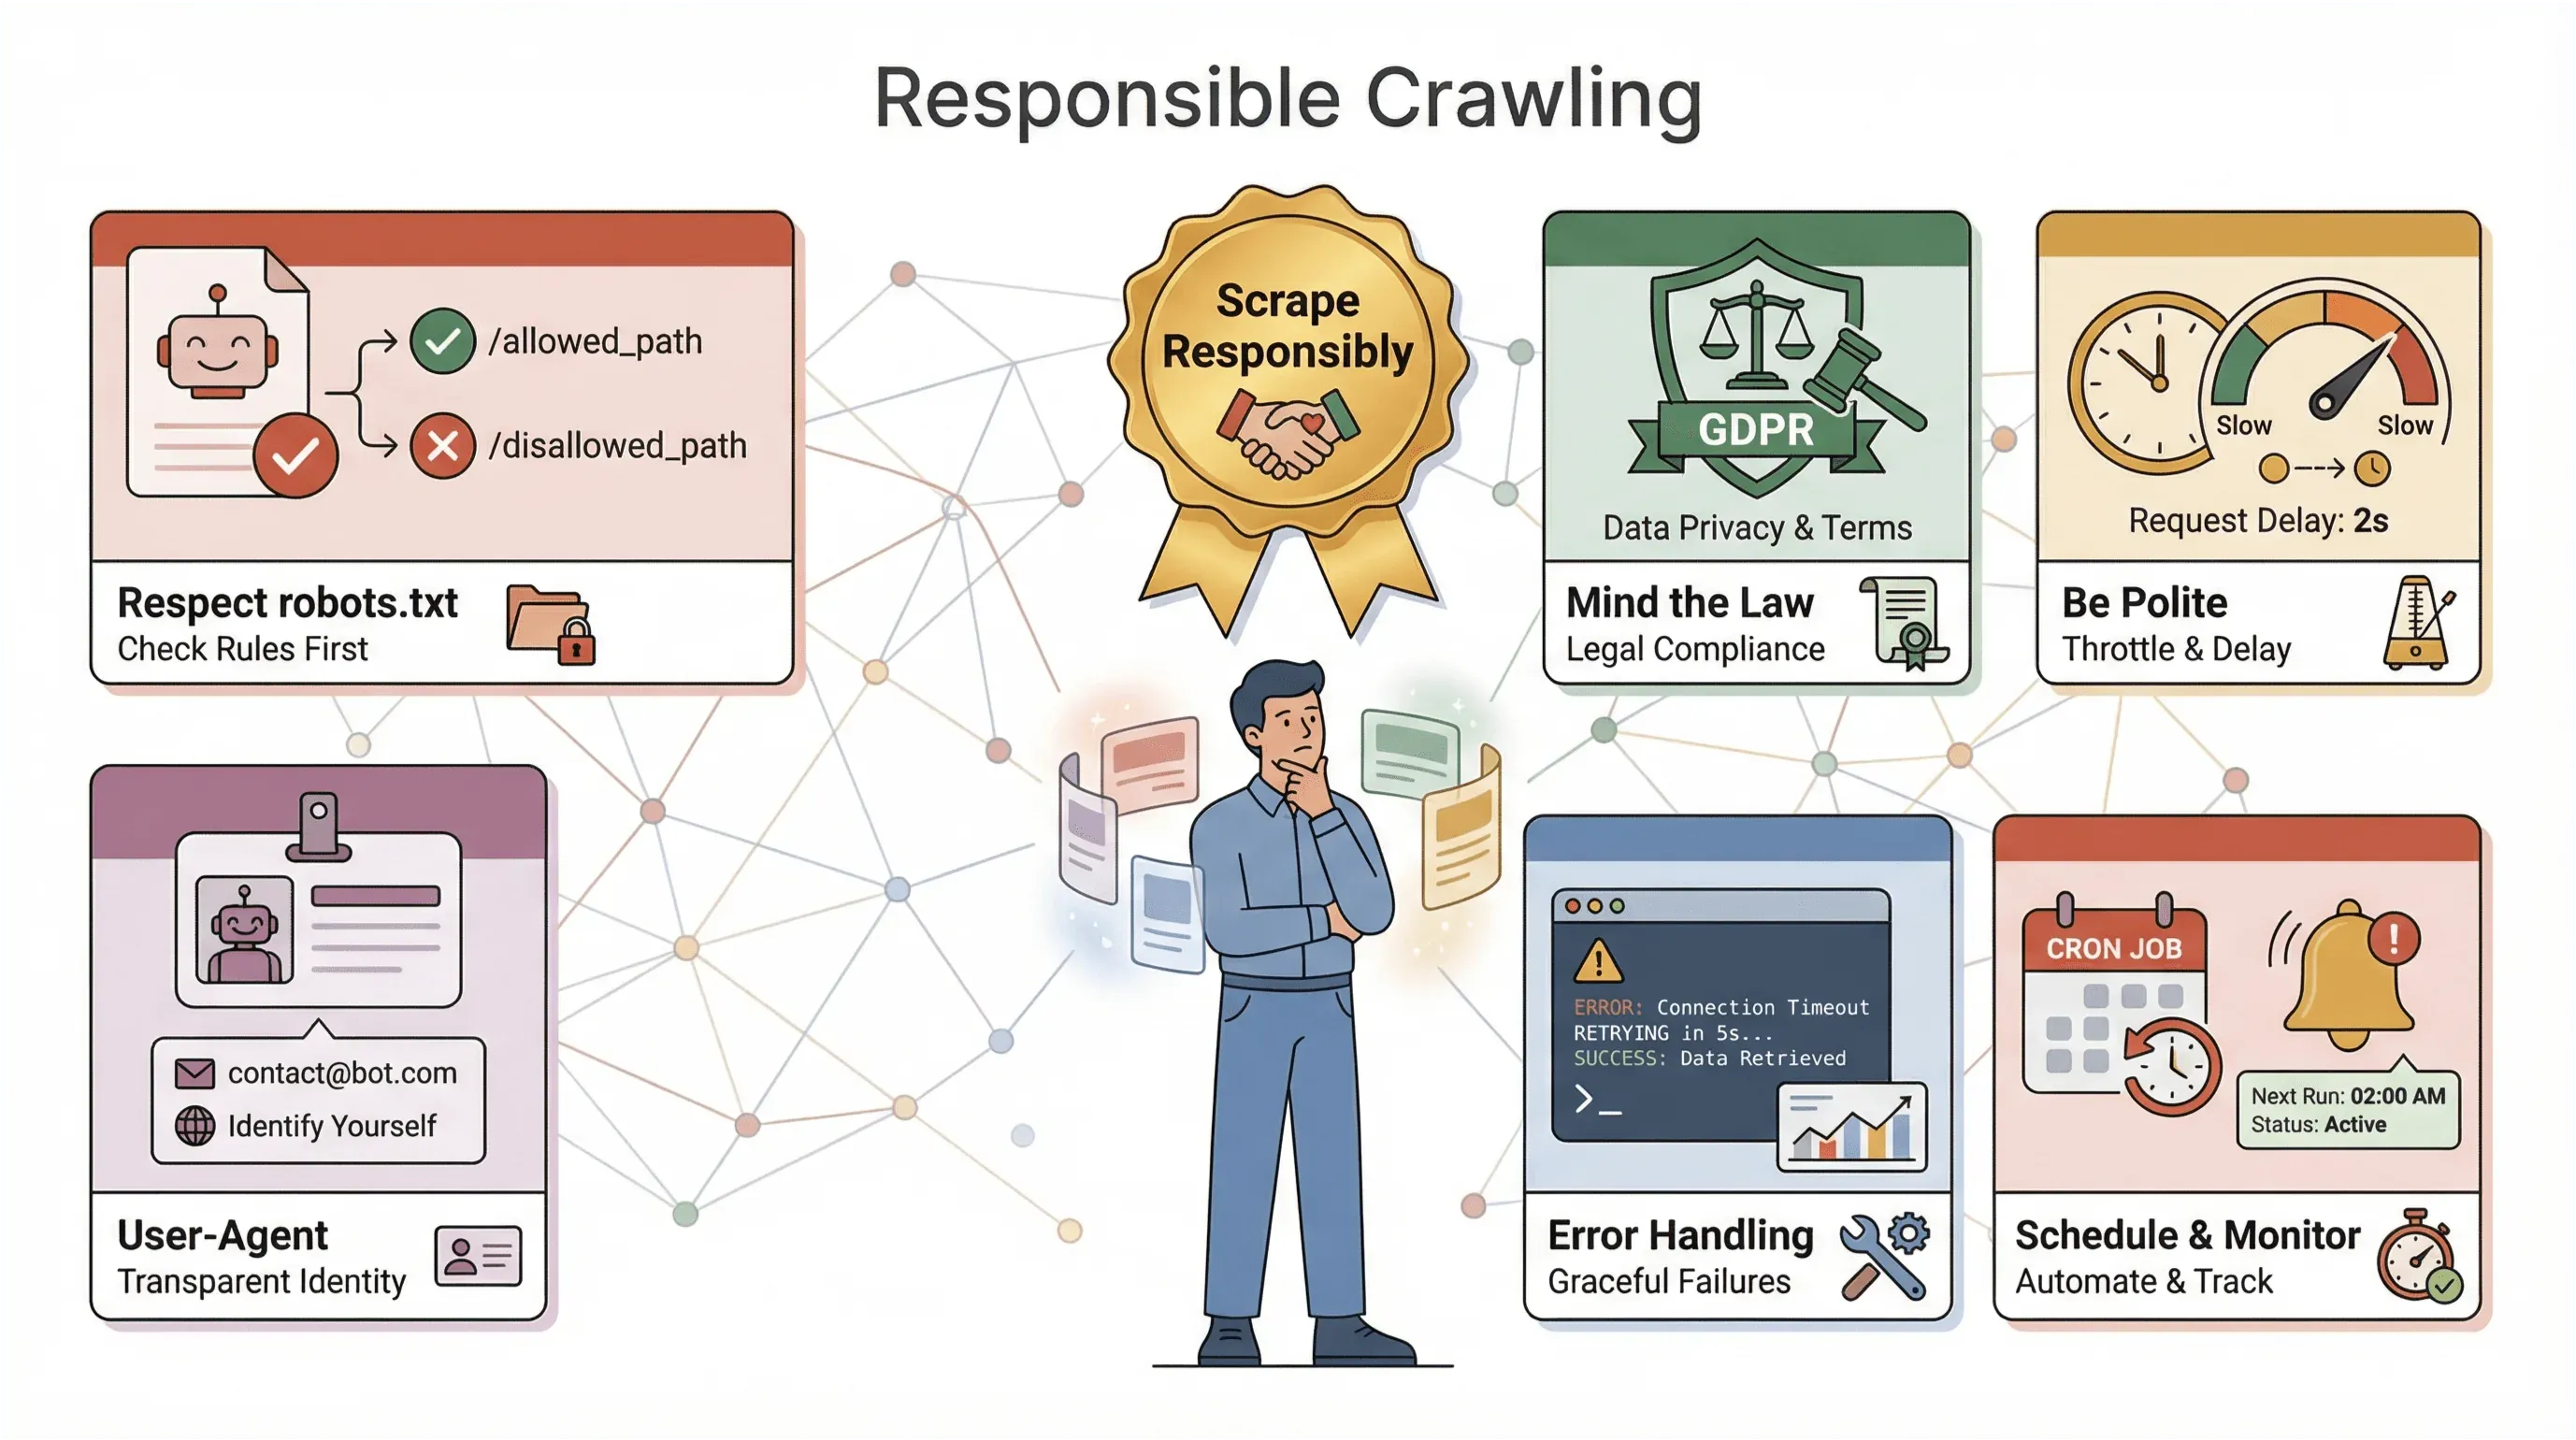 Voordat je je crawler op de wereld loslaat, nog een paar waarschuwingen — en een beetje wijsheid:
- Respecteer robots.txt: de meeste sites publiceren een
robots.txt-bestand dat aangeeft wat crawlers wel en niet mogen. Negeer je dat, dan kun je geblokkeerd raken — of erger, juridische problemen krijgen. Controleer en volg deze regels altijd (meer hier). - Let op de wet: de gebruiksvoorwaarden van sommige sites verbieden scrapen. En als je persoonsgegevens verzamelt, kunnen privacywetten zoals GDPR en CCPA van toepassing zijn (dataprixa.com). Kies bij twijfel voor openbare, niet-gevoelige data.
- Wees beleefd: bestook sites niet met verzoeken — throttle je crawler, randomiseer vertragingen en vermijd scrapen tijdens piekuren.
- Geef aan wie je bent: gebruik een aangepaste User-Agent-string en overweeg contactgegevens mee te sturen als je op grote schaal scraped.
- Fouten en logging: verwacht dat sites veranderen, pagina’s breken en data rommelig wordt. Bouw foutafhandeling, logging en monitoring in zodat je problemen snel kunt oplossen.
- Plannen en monitoren: voor terugkerende crawls kun je planningshulpmiddelen gebruiken (zoals cron of Thunderbit’s ingebouwde planner) en alerts instellen als je crawler foutmeldingen geeft of ineens nul data ophaalt.
De gouden regel: scrape verantwoord. Het web is een gedeelde bron — wees niet die bot die het voor iedereen verpest.
Geavanceerde tips: je Python-websitecrawler opschalen en verbeteren
Zodra je de basis beheerst, wil je misschien je crawler naar een hoger niveau tillen. Hier zijn een paar geavanceerde stappen:
- JavaScript verwerken: gebruik Selenium of Playwright om sites te scrapen die data dynamisch laden.
- Opschalen: voor grote projecten kun je overstappen op Scrapy of async libraries gebruiken (zoals
aiohttp) voor gelijktijdige requests. - Proxies gebruiken: roteer IP-adressen om blokkades bij grote crawls te vermijden.
- Datapijplijnen automatiseren: schrijf direct naar databases of koppel cloudopslag voor grote datasets.
- Monitoren en alerts: stel logging, health checks en notificaties in voor crawlers die lang draaien.
Als je crawler bedrijfskritisch wordt, overweeg dan managed services of API’s om het zware werk uit handen te geven. En als je meerdere sites met verschillende layouts scrape, maak je code dan modulair zodat je parsers makkelijk kunt aanpassen.
Conclusie en belangrijkste inzichten
Wat is data scraping en hoe doe je het in 2025 Get Started Free
Een websitecrawler bouwen in Python is een van de meest waardevolle vaardigheden die je kunt oppikken in de huidige datagedreven wereld. Dit hebben we behandeld:
- Websitecrawlers automatiseren het bezoeken en extraheren van data uit webpagina’s — onmisbaar voor bedrijfsautomatisering, onderzoek en concurrentieanalyse.
- Python is de beste keuze voor crawlers dankzij de eenvoudige syntax, krachtige libraries en enorme community.
- Parse-methoden doen ertoe: gebruik regex voor snelle hacks, BeautifulSoup voor de meeste scripts en Scrapy voor grote klussen.
- Stap voor stap kun je van een enkele pagina ophalen doorgroeien naar een hele site crawlen en gestructureerde data opslaan — zonder PhD.
- Thunderbit gaat nog een stap verder en laat je data scrapen met AI, zonder code en met directe export — ideaal voor zakelijke gebruikers of iedereen die snel resultaat wil.
- Verantwoord crawlen is essentieel: respecteer site-regels, handel fouten goed af en zet ethiek altijd op de eerste plaats.
- Opschalen is mogelijk met de juiste tools — of dat nu Selenium is voor JavaScript, Scrapy voor concurrency of Thunderbit voor no-code automatisering.
De beste manier om te leren is klein beginnen — schrijf een script, probeer Thunderbit en ontdek welke data je kunt ontsluiten. Het web ligt voor het grijpen (of beter: het data-buffet ligt voor het opscheppen, als je net zo’n honger hebt als ik).
Wil je dieper duiken? Bekijk deze bronnen:
- Wat is data scraping en hoe doe je het in 2025
- Hoe je websitegegevens naar Excel scrapt met AI
- Thunderbit Blog voor meer tips, handleidingen en geavanceerde technieken.
Veel succes met crawlen — en moge je scrapers snel zijn, je data schoon en je koffievoorraad eindeloos.
Probeer Thunderbit AI Web Scraper nu
FAQ’s
1. Wat is het verschil tussen een websitecrawler en een webscraper?
Een crawler bezoekt systematisch webpagina’s en ontdekt nieuwe pagina’s (zoals een site in kaart brengen), terwijl een scraper specifieke data uit die pagina’s haalt. In de praktijk gebruiken de meeste projecten beide: crawlen om pagina’s te vinden, scrapen om de data op te halen.
2. Waarom is Python zo populair voor het bouwen van websitecrawlers?
Python is makkelijk te leren, heeft krachtige libraries (zoals Requests, BeautifulSoup, Scrapy en Selenium) en een enorme community. Bijna 70% van de webscrapingprojecten gebruikt Python, waardoor het de industriestandaard is.
3. Wanneer moet ik regex, BeautifulSoup of Scrapy gebruiken voor parsing?
Gebruik regex voor simpele, voorspelbare patronen. BeautifulSoup is het beste voor de meeste scripts — makkelijk en flexibel. Scrapy is ideaal voor crawlers op grote schaal of productieomgevingen die snelheid, concurrency en robuuste features nodig hebben.
4. Hoe verhoudt Thunderbit zich tot het coderen van een crawler in Python?
Met Thunderbit scrape je data met AI en zonder code — gewoon klikken, velden kiezen en exporteren. Ideaal voor zakelijke gebruikers of snelle klussen. Python geeft je meer controle en maatwerk, maar vereist wel code en onderhoud.
5. Op welke juridische of ethische punten moet ik letten bij het crawlen van websites?
Controleer en respecteer altijd robots.txt, volg de gebruiksvoorwaarden van de site, verzamel geen gevoelige of persoonlijke data zonder toestemming en beperk je requests om servers niet te overbelasten. Verantwoord scrapen houdt het web open voor iedereen.
Klaar om het zelf te proberen? Download Thunderbit of open je favoriete Python-editor en begin met crawlen. De data is er — ga ervoor!
Probeer AI Web Scraper Get Started Free
Meer weten



