
Het web groeit sneller dan mijn ochtendkoffie — en geloof me, ik drink die stevig door. In 2026 is webdata extraheren allang niet meer alleen iets “handigs” voor techneuten; het is de motor achter sales prospecting, prijsmonitoring voor e-commerce, marktonderzoek en zelfs vastgoedanalyses. Nu meer dan 49% van de bedrijven webscraping tools wekelijks gebruikt, kan de juiste library of tool het verschil maken tussen uren saai handwerk en een spreadsheet vol bruikbare inzichten — nog voordat je concurrent zijn lunch op heeft.
Maar hier wordt het interessant: webscraping libraries in 2026 zijn er in alle soorten en maten, van AI-Chrome-extensies zonder code tot serieuze developer frameworks. Of je nu een salesmedewerker bent die gewoon leads in Excel wil, een operations manager die 500 SKU’s volgt, of een Python-expert die een eigen crawler bouwt — er is altijd een tool die past. Ik werk al jaren in SaaS en automatisering (en ik heb er meer nachtelijke sessies op zitten dan ik wil toegeven) en heb deze libraries uitgebreid getest. Laten we daarom de top 10 webscraping libraries van dit jaar doornemen, en kijken hoe je de juiste kiest om je werk makkelijker te maken.
Wat maakt een webscraping library krachtig in 2026?
Data van elke website halen met AI Get Started Free
Voordat we in de lijst duiken, is het slim om even stil te staan bij wat écht telt bij het kiezen van een webscraping library. In mijn ervaring hebben de beste tools in 2026 een paar dingen gemeen:
- Gebruiksgemak: Kan iemand zonder programmeerkennis binnen een paar minuten resultaat krijgen? Of heb je een doctoraat in Python nodig?
- Omgaan met dynamische content: Kan de tool moderne sites met veel JavaScript scrapen? Of struikelt hij al bij iets ingewikkelders dan statische HTML?
- Taal- en platformondersteuning: Werkt hij in jouw favoriete taal — Python, JavaScript, Java — of zelfs rechtstreeks in je browser?
- Schaalbaarheid: Kan hij zonder moeite honderden of duizenden pagina’s aan?
- Integratie en export: Werkt hij soepel samen met Excel, Google Sheets, Notion of je datapipe?
- AI en automatisering: In 2026 zijn AI-tools die gewoon werken met natuurlijke taalprompts een enorme plus — vooral voor zakelijke gebruikers die liever geen code aanraken.
De realiteit is dat business teams vooral snelheid, nauwkeurigheid en zo min mogelijk instelwerk willen. Hoe minder tijd je kwijt bent aan kapotte scrapers repareren of code uitpluizen, hoe meer tijd je hebt om iets met de data te doen. En door de opkomst van AI en browserautomatisering kunnen ook niet-technische gebruikers nu data scrapen waarvoor vroeger een developer nodig was (PromptCloud).
Goed — nu naar het echte werk.
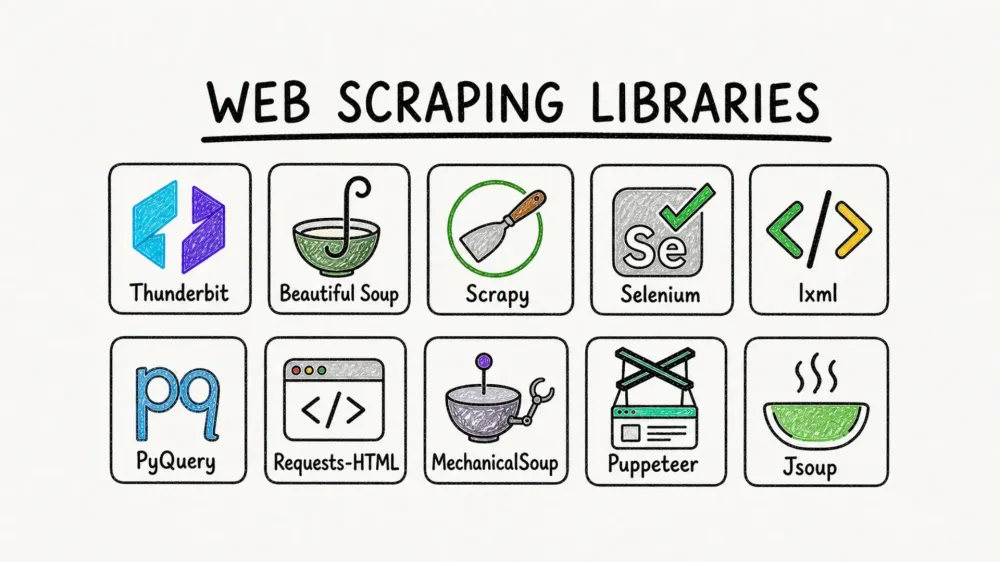
De 10 krachtigste webscraping libraries om te gebruiken in 2026
- Thunderbit voor no-code, AI-gestuurde webscraping in je browser
- Beautiful Soup voor eenvoudige HTML-parse en datacleaning in Python
- Scrapy voor grootschalig, snel crawlen en pipelines
- Selenium voor browserautomatisering en het scrapen van dynamische, JavaScript-zware sites
- lxml voor razendsnelle XML/HTML-parse in Python
- PyQuery voor jQuery-stijl HTML-selectie in Python
- Requests-HTML voor alles-in-één HTTP, HTML-parse en JS-rendering in Python
- MechanicalSoup voor formulieren en eenvoudige browsertaken automatiseren in Python
- Puppeteer voor headless Chrome-automatisering in Node.js
- Jsoup voor robuuste HTML-parse in Java
1. Thunderbit

Thunderbit is mijn vaste aanrader voor iedereen die webdata wil scrapen zonder ook maar één regel code te schrijven. Deze AI-aangedreven Chrome-extensie laat je gewoon beschrijven wat je wilt (“Haal alle productnamen, prijzen en afbeeldingen van deze pagina”), en de AI regelt de rest. Geen templates, geen setup — gewoon één klik, eventueel even kolommen aanpassen als je wilt, en de extractie loopt verder zonder dat je ernaar om hoeft te kijken.
Waarom Thunderbit in 2026 opvalt:
- No-code, natuurlijke taal: Iedereen kan ermee werken — sales, operations, marketing, vastgoed. Geen Python nodig.
- Automatische veldherkenning: De AI haalt de kolommen direct uit de paginastructuur.
- Subpagina-scraping: Meer details nodig? Thunderbit kan elke subpagina bezoeken (zoals product- of profielpagina’s) en je tabel automatisch verrijken (Thunderbit Blog).
- Directe templates voor populaire sites: Amazon, Zillow, Shopify en meer — scrape met één klik.
- Export naar Excel, Google Sheets, Notion, Airtable: Je data komt meteen op de plek waar je team werkt.
- Ondersteunt 34 talen: Ideaal voor internationale teams.
- Cloud- of browser-scraping: Kies wat past bij je workflow — cloud is razendsnel voor publieke sites, browsermodus is handig voor logins.
Thunderbit wordt vertrouwd door meer dan 200.000 gebruikers wereldwijd, en met de gratis versie kun je tot 6 pagina’s scrapen (of 10 met een proefboost). Als je wilt zien hoe moderne webscraping eruitziet, zou ik hier beginnen.
Probeer Thunderbit AI Web Scraper gratis
2. Beautiful Soup
Beautiful Soup is een klassieke Python-library die geliefd is bij data scientists en analisten vanwege de eenvoud en kracht bij het parsen van rommelige HTML. Heb je ooit geprobeerd data te halen uit een pagina met kapotte tags of rare opmaak? Dan is Beautiful Soup precies wat je nodig hebt.
Waarom Beautiful Soup zo sterk is:
- Kan overweg met onregelmatige HTML: Perfect om “lelijke” webpagina’s op te schonen en data eruit te halen (Beautiful Soup Docs).
- Makkelijk te leren: Ook Python-beginners kunnen er snel mee aan de slag.
- Flexibel: Werkt goed samen met HTTP-clients zoals Requests, en kan gecombineerd worden met lxml voor extra snelheid.
- Typische toepassingen: Snelle data-extractie, webdata opschonen, en integratie in kleine scripts.
Werk je met statische pagina’s of moet je rommelige markup verwerken? Dan is Beautiful Soup een solide keuze.
3. Scrapy
Scrapy is de zwaargewicht onder de Python-webscraping tools. Het is een compleet framework voor het bouwen van schaalbare crawlers en datapielines. Als je duizenden pagina’s moet scrapen, links moet volgen en data op grote schaal wilt verwerken, dan is Scrapy precies gemaakt voor dat soort werk.
Waarom Scrapy een topkeuze is:
- Sterk modulair: Bouw complexe spiders, pipelines en middlewares (Scrapy Docs).
- Geschikt voor grote projecten: Ideaal voor marktonderzoek, concurrentieanalyse of elke taak waarbij je veel sites moet crawlen en extraheren.
- Asynchroon en snel: Ontworpen voor snelheid en efficiëntie.
- Grote community: Veel plugins, tutorials en support.
Scrapy heeft wel een leercurve, maar voor grote klussen is het een krachtpatser.
4. Selenium
Selenium is dé standaard voor browserautomatisering. Het wordt gebruikt voor alles van het testen van webapplicaties tot het scrapen van sites waarvoor je moet inloggen, klikken of pop-ups afhandelen. Als je interactie moet hebben met JavaScript-zware of sterk dynamische sites, kan Selenium zich gedragen als een echte gebruiker (ScrapingBee Selenium Guide).
Sterktes van Selenium:
- Automatiseert echte browsers: Chrome, Firefox, Safari, Edge — noem maar op.
- Kan omgaan met logins, pop-ups en gebruikersacties: Ideaal voor scraping na authenticatie of voor workflows met meerdere stappen.
- Ondersteunt meerdere talen: Python, Java, C# en meer.
- Het beste voor: Sites die eenvoudige scrapers blokkeren, of situaties waarin je echt gebruikersgedrag moet nabootsen.
Het is wat zwaarder dan HTTP-gebaseerde libraries, maar soms heb je gewoon een echte browser nodig.
5. lxml
lxml is een hoogwaardige XML- en HTML-parser voor Python. Als snelheid je absolute prioriteit is (denk aan duizenden grote documenten verwerken), is lxml moeilijk te verslaan (Python HTML Parser Performance).
Waarom lxml favoriet is:
- Razendsnel: Presteert beter dan de meeste andere Python-parsers, zeker bij grote bestanden.
- Robuust: Kan zowel XML als HTML aan en integreert goed met andere tools.
- Sterk voor: Grote datasets verwerken en combineren met Beautiful Soup of Scrapy voor extra mogelijkheden.
Scrape je op schaal of moet je enorme bestanden verwerken? Dan hoort lxml zeker in je toolkit.
6. PyQuery
PyQuery brengt de selector-syntax van jQuery naar Python. Vind je het handig hoe simpel het is om met $('.class') elementen te selecteren in jQuery? Dan laat PyQuery je datzelfde doen in je scraping scripts (PyQuery Docs).
Hoogtepunten van PyQuery:
- jQuery-achtige selectors: Intuïtief voor iedereen met front-end ervaring.
- Bondige, leesbare code: Maakt complexe selecties eenvoudig.
- Werkt samen met lxml: Onder de motorkap snel en efficiënt.
- Het beste voor: Projecten waar je snelle, jQuery-achtige HTML-manipulatie in Python wilt.
Het is een mooie brug voor mensen die van webdevelopment naar data-extractie overstappen.
7. Requests-HTML
Requests-HTML is een Python-library die het gemak van Requests (voor HTTP) combineert met ingebouwde HTML-parse en zelfs JavaScript-rendering.
Wat Requests-HTML bijzonder maakt:
- Alles-in-één: Pagina’s ophalen, HTML parsen en zelfs JavaScript renderen in één pakket.
- Gebruiksvriendelijk voor beginners: Perfect voor kleine tot middelgrote scrapingprojecten.
- Sterk voor: Snelle scripts, sites met enige dynamische content en gebruikers die eenvoud willen.
Ben je net begonnen of zoek je een flexibele tool voor kleinere taken? Dan is Requests-HTML een goede keuze.
8. MechanicalSoup
MechanicalSoup is een Python-library voor het automatiseren van webformulieren en eenvoudige browserinteracties. Het is gebouwd bovenop Beautiful Soup en Requests, waardoor je makkelijk kunt inloggen, formulieren invullen en basisworkflows doorlopen (ScrapingBee MechanicalSoup Guide).
Waarom MechanicalSoup handig is:
- Automatiseert formulieren en logins: Ideaal voor data achter een login.
- Eenvoudige API: Makkelijk op te pakken voor beginners.
- Het beste voor: Repeterende browsertaken, simpele workflows en sites waarvoor volledige browserautomatisering overdreven is.
Het is niet zo krachtig als Selenium voor complexe sites, maar wel veel lichter en eenvoudiger voor basisbehoeften.
9. Puppeteer
Puppeteer is een Node.js-library voor het aansturen van headless Chrome of Chromium. Het is favoriet voor het scrapen van JavaScript-zware, zeer interactieve websites (Scrape.do Puppeteer Guide).
Kracht van Puppeteer:
- Volledige browserautomatisering: Klikken, scrollen, formulieren invullen en interactie alsof je een gebruiker bent.
- Kan dynamische content aan: Perfect voor sites die data via JavaScript laden.
- Sterk voor: E-commerce, sociale media of andere sites waar traditionele scrapers tekortschieten.
Ben je JavaScript-developer of moet je de “moderne web”-laag scrapen? Dan is Puppeteer onmisbaar.
10. Jsoup
Jsoup is de gouden standaard voor HTML-parsing in Java. Het is eigenlijk de Java-variant van Beautiful Soup (Baeldung Jsoup Guide).
Waarom Java-teams Jsoup waarderen:
- Eenvoudige, krachtige API: Data extraheren en bewerken met maar een paar regels code.
- Kan omgaan met rommelige HTML: Schoont slecht opgemaakte pagina’s op en parseert ze toch goed.
- Het beste voor: Scraping integreren in Java-gebaseerde business apps of backendworkflows.
Gebruik je Java? Dan is Jsoup de logische keuze.
Vergelijkingstabel van webscraping libraries
Hier is een snelle vergelijking van alle 10 libraries:
| Library | Taal | Gebruiksgemak | Dynamische content | AI/No-code | Typische toepassingen | Beste voor |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome-ext. | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Ja | Sales, ops, research, vastgoed | Niet-programmeurs, zakelijke gebruikers |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Nee | HTML-parse, datacleaning | Python-beginners, analisten |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Nee | Grootschalig crawlen, pipelines | Developers, big-data projecten |
| Selenium | Multi | ⭐⭐ | ⭐⭐⭐⭐⭐ | Nee | Browserautomatisering, logins | QA, dynamische sites scrapen |
| lxml | Python | ⭐⭐⭐ | ⭐ | Nee | Snelle parse, grote bestanden | Power users, grote datasets |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Nee | jQuery-stijl selectie | Webdevs, compacte scripts |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nee | Snelle scripts, JS-rendering | Beginners, kleine projecten |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nee | Formulierautomatisering, logins | Simpele browsertaken |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Nee | JavaScript-zware sites, automatisering | JS-developers, dynamische webscraping |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Nee | HTML-parsing in Java | Java-teams, backendworkflows |
Hoe kies je de juiste webscraping library voor je bedrijf?
Wat is data scraping en hoe doe je het in 2025 Get Started Free
Dus, welke library moet je gebruiken? Dit is mijn advies, gebaseerd op jaren van proberen, fouten maken en net iets te veel nachtelijke debug-sessies:
- Niet-programmeurs of zakelijke gebruikers: Begin met Thunderbit. Dankzij de AI/no-code-aanpak krijg je in minuten resultaat, niet in dagen. Als je team gewoon data in Excel of Sheets wil, maak het dan niet ingewikkelder dan nodig.
- Python-developers: Beautiful Soup en Requests-HTML zijn ideaal voor kleinere taken. Scrapy is je vriend voor grote projecten. Combineer ze met lxml of PyQuery voor extra power.
- Logins of dynamische content nodig? Selenium (multi-language) of Puppeteer (Node.js) zijn dan je beste opties.
- Java-teams: Jsoup is de duidelijke winnaar als je scraping wilt integreren in Java-apps.
- Formulieren of simpele workflows automatiseren? MechanicalSoup is licht en makkelijk in gebruik.
Belangrijke factoren om mee te nemen:
- Technisch niveau: No-code tools zoals Thunderbit zijn perfect voor niet-technische teams. Developers geven misschien de voorkeur aan de flexibiliteit van code-gebaseerde libraries.
- Complexiteit van data: Voor simpele, statische pagina’s zijn Beautiful Soup of Jsoup sterk. Voor dynamische, JavaScript-zware sites kies je beter Selenium of Puppeteer.
- Schaal: Scrapy en lxml komen het best tot hun recht bij grote, snelle jobs.
- Integratie: Thunderbit’s directe export naar Sheets, Notion en Airtable bespaart enorm veel tijd in zakelijke workflows.
Voor meer tips over het kiezen van de juiste tool, bekijk de gids van PromptCloud.
Bekijk de prijzen en gratis versie van Thunderbit
Conclusie: webdata ontsluiten met de juiste tools
Webscraping in 2026 is allang niet meer alleen voor programmeurs of data scientists. Dankzij de explosie van AI-gedreven en no-code tools kan elk team — van sales tot research — gebruikmaken van de data die het web te bieden heeft. De juiste library kan je honderden uren per jaar besparen (Browsercat), je nauwkeurigheid verhogen en je bedrijf een serieus voordeel geven.
Mijn advies? Begin bij je eigen behoeften — snelheid, schaal, technische comfortzone — en probeer een paar opties uit. Thunderbit’s gratis versie is een prima manier om laagdrempelig te starten, en open-source libraries zoals Beautiful Soup of Scrapy zijn er altijd als je zelf de diepte in wilt.
Wil je verder lezen? Bekijk de Thunderbit Blog voor meer gidsen, of abonneer je op ons YouTube-kanaal voor praktische tutorials.
Veel succes met scrapen — en moge je data altijd schoon, gestructureerd en direct inzetbaar zijn.
Probeer Thunderbit AI Web Scraper gratis Get Started Free
Veelgestelde vragen
1. Wat is in 2026 de makkelijkste webscraping library voor niet-programmeurs?
Thunderbit is de beste keuze voor niet-programmeurs. Met de AI-gestuurde Chrome-extensie kun je data scrapen via natuurlijke taalprompts — zonder te coderen.
2. Welke library is het beste voor JavaScript-zware of dynamische websites?
Puppeteer (Node.js) en Selenium (multi-language) zijn het beste voor dynamische sites die JavaScript renderen. Ze automatiseren echte browsers en kunnen complexe interacties aan.
3. Wat is het verschil tussen Beautiful Soup en Scrapy?
Beautiful Soup is ideaal voor het parsen en extraheren van data van losse pagina’s of kleine projecten, zeker bij rommelige HTML. Scrapy is een compleet framework voor schaalbare crawlers en grote datasets.
4. Kan ik gescrapete data direct exporteren naar Google Sheets of Notion?
Ja — Thunderbit biedt directe export naar Google Sheets, Notion, Airtable en Excel. Bij de meeste code-libraries moet je de exportlogica zelf bouwen.
5. Hoe kies ik de juiste webscraping library voor mijn bedrijf?
Kijk naar je technische vaardigheden, de complexiteit van de sites die je wilt scrapen, de hoeveelheid data en je integratiebehoeften. No-code tools zoals Thunderbit zijn ideaal voor zakelijke teams, terwijl developers vaak liever werken met libraries zoals Scrapy, Beautiful Soup of Puppeteer voor meer controle.
Meer lezen



