
Trustpilot bevat 361 miljoen actieve reviews bij 1,27 miljoen bedrijven — en de meeste scrapers die ooit zijn gebouwd om die data op te halen, zijn maanden geleden al vastgelopen. Als je recent geprobeerd hebt om reviews te verzamelen, ben je waarschijnlijk ook tegen die beruchte inlogmuur na pagina 10 aangelopen en kreeg je tool alleen nog maar een foutmelding terug.
De afgelopen weken heb ik tools getest, onderzocht en vergeleken die Trustpilot-reviewdata in 2026 nog wél betrouwbaar kunnen ophalen. Het speelveld is flink veranderd: de anti-botbeveiliging van Trustpilot is agressiever geworden, de Next.js-frontend genereert class-namen die bij elke deployment verschuiven, en — het belangrijkste — zonder inlog kom je nu nog maar tot 10 reviewpagina’s. Een Reddit-draadje uit eind 2025 vatte de frustratie perfect samen: “none of the actors on the store work.”
Welke tools werken dan wél? Ik heb er vijf beoordeeld op hoe goed ze omgaan met de inlogmuur, anti-botmaatregelen, onderhoudslast en de praktische behoeften van zowel marketeers als developers.
Waarom Trustpilot-reviews scrapen in 2026 lastiger is dan het lijkt
Trustpilot is geen simpele statische website waar je even een basis-HTTP-request op loslaat en daarna met BeautifulSoup de HTML uitleest. Het is een modern, dynamisch gerenderd platform op basis van Next.js, en de beveiliging is het afgelopen jaar duidelijk strenger geworden.
Waar je in de praktijk tegenaan loopt:
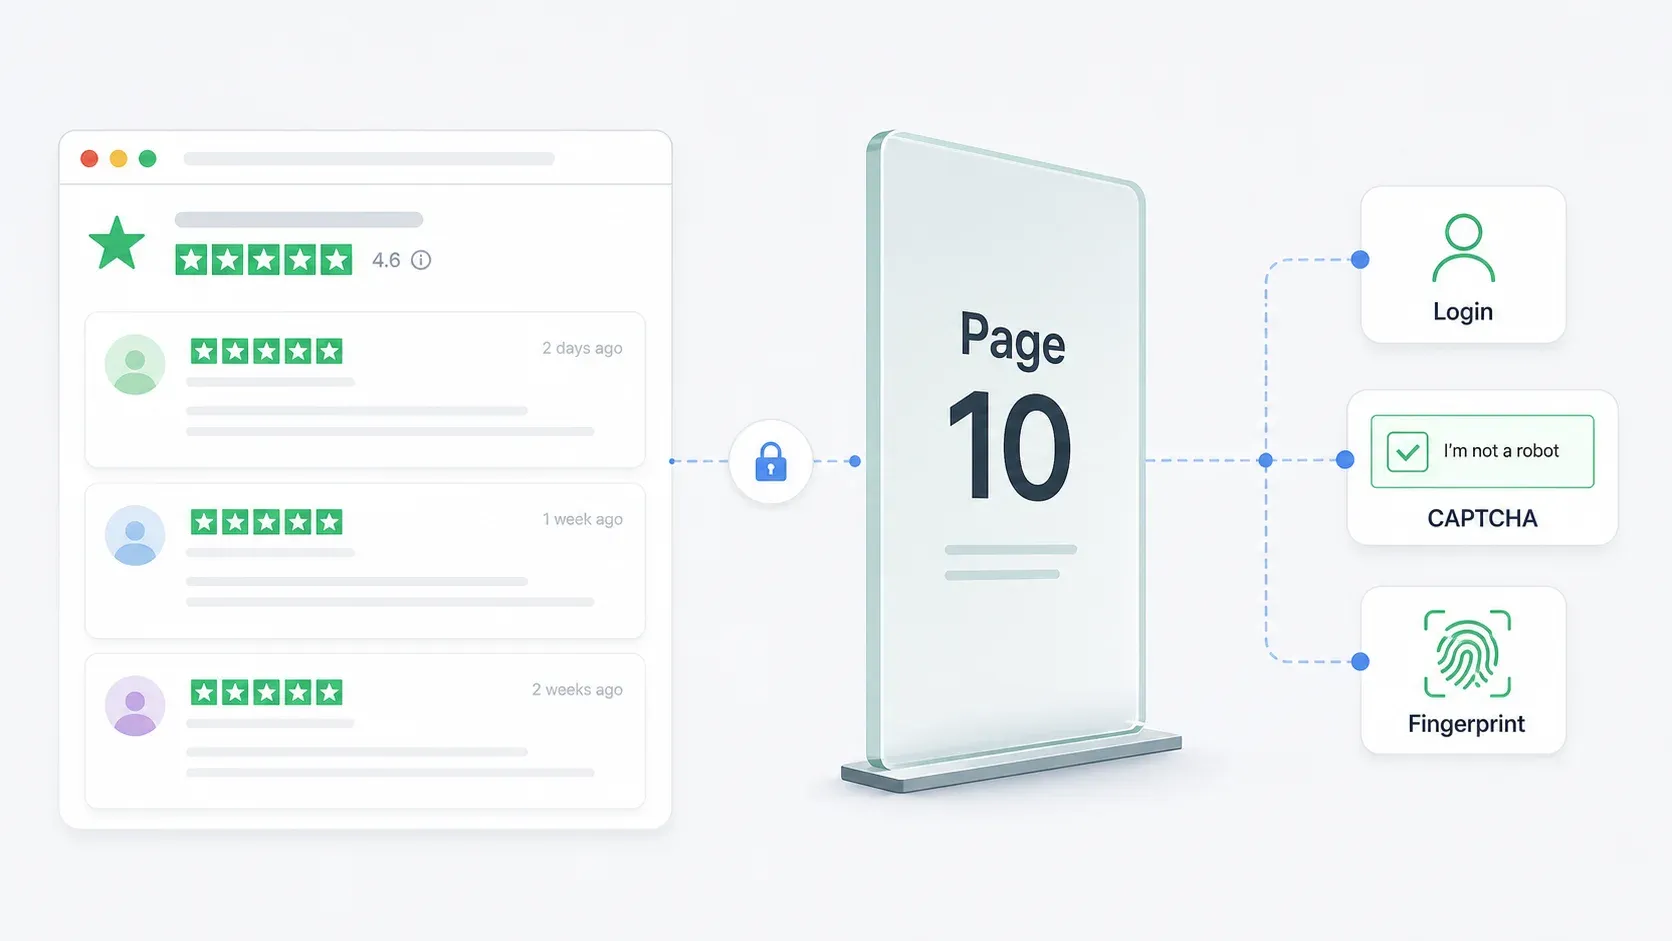
De inlogmuur na pagina 10. Dit is veruit de grootste frustratie. De eigen Trustpilot-gids van Web Scraper uit maart 2026 bevestigt dat Trustpilot alleen de eerste 10 reviewpagina’s toestaat voordat er een inlogmelding verschijnt. Voor een bedrijf met 2.000 reviews (ongeveer 100 pagina’s met 20 reviews per pagina) kom je zonder geauthenticeerde sessie dus niet verder dan 10% van de data.
Anti-botbeveiliging. Trustpilot gebruikt reCAPTCHA, blokkades op sessieniveau, filtering op CDN-niveau en browser fingerprinting. Op de Over-ons-pagina staat expliciet dat de site “protected by reCAPTCHA” is en dat apparaatsignalen en interactiesignalen worden verzameld.
Dynamische CSS-class-namen. Omdat Trustpilot Next.js met CSS-modules gebruikt, worden class-namen zoals styles_reviewCardInner__EwDq2 tijdens de build gegenereerd en veranderen ze telkens wanneer Trustpilot een update uitrolt. De eigen ScraperAPI-tutorial leunt op precies deze selectors — wat betekent dat code die deze tutorial volgt bij de volgende frontendwijziging van Trustpilot al stuk kan gaan.
Veranderingen in de DOM-structuur. Niet alleen class-namen verschuiven; ook de HTML-hiërarchie zelf kan wijzigen. Elementen worden anders genest, er komen extra wrappers bij en paginatiecomponenten worden heringericht.
Scrapers die op CSS-selectors vertrouwen — of dat nu Apify Actors, Octoparse-workflows of eigen Python-scripts zijn — zijn op Trustpilot structureel kwetsbaar. Ze werken totdat ze dat niet meer doen. En dat “totdat” wordt vaak in weken gemeten, niet in maanden.
Waar we op hebben gelet bij de beste Trustpilot-recensiescrapers
Ik heb deze tools niet beoordeeld op een generieke “kan het een webpagina scrapen?”-vraag. Elke tool op deze lijst kan data uit een simpele HTML-pagina halen.
De echte vraag is: kan hij specifiek met Trustpilot omgaan, inclusief alle eigenaardigheden, in 2026?
Hier lag voor mij de focus:
| Criteria | Waarom dit telt voor Trustpilot |
|---|---|
| Omgaan met de inlogmuur (pagina 10+) | De meeste bedrijven hebben veel meer dan 200 reviews. Een limiet van 10 pagina’s betekent dat je het grootste deel van de historische data mist. |
| Aanpak voor het omzeilen van anti-bot | reCAPTCHA, sessieblokkades en CDN-filtering stoppen naïeve scrapers direct. |
| Robuustheid van selectors / onderhoud | Gegeneerde CSS-class-namen breken selector-gebaseerde tools regelmatig. Heelt de tool zichzelf? |
| Ondersteuning voor paginering | Reviews staan verspreid over honderden pagina’s. Handmatig pagina voor pagina ophalen is niet haalbaar. |
| No-code versus codevereiste | Marketeers willen klikken en klaar; developers willen volledige controle. |
| Prijs / gratis laag | Budgetbewuste teams willen vooraf duidelijkheid. |
| Exportopties | Zakelijke gebruikers hebben Google Sheets, Airtable, Notion nodig — niet alleen ruwe JSON. |
De inlogmuur is hier de doorslaggevende factor.
Als een tool pagina 10 niet kan passeren — of op z’n minst een duidelijke route biedt voor geauthenticeerde toegang — dan is het in 2026 geen bruikbare Trustpilot-scraper.
Beste Trustpilot-recensiescrapers in één oogopslag
De volledige vergelijking:
| Tool | Niveau | Omgaan met inlogmuur | Aanpak tegen anti-bot | Paginering | Gratis laag | Exportopties |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Browsermodus (gebruikt je ingelogde Chrome-sessie) | AI-semantic extractie past zich aan layoutwijzigingen aan | Automatische detectie, meerdere pagina’s | 6 pagina’s gratis/maand | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Hangt af van de Actor; sommige vereisen cookieconfiguratie voor pagina’s >10 | Ingebouwde proxyrotatie, per Actor verschillend | Configureerbaar per Actor | $5/maand aan gratis platformcredits | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (visueel) | Handmatige cookie-/sessieconfiguratie | IP-rotatie, residential proxies, CAPTCHA-oplossing (betaald) | Klik-/scroll-workflow | Gratis plan + 14-daagse premium trial | CSV, Excel, JSON, HTML, XML, databases |
| Web Scraper | No-code (sitemap) | Beperkt — eigen gids documenteert limiet van 10 reviewpagina’s | Cloud + proxy op betaalde plannen | Configureerbaar; JS-klik aanbevolen | Gratis Chrome-extensie | CSV, XLSX |
| ScraperAPI | Developer (Python) | Sessies/cookies op codeniveau beheren | 40M+ residential proxies, JS-rendering, CAPTCHA-afhandeling | Codegebaseerd | 7-daagse trial, 5.000 API-credits | Door developer bepaald (CSV, JSON, enz.) |
1. Thunderbit

Thunderbit is een AI-gestuurde Chrome-extensie voor zakelijke teams die gestructureerde data van websites nodig hebben zonder code te schrijven. Voor Trustpilot biedt het een speciaal review-scrapingtemplate dat reviewernaam, beoordeling, reviewtitel, reviewtekst, datum en bedrijfsreactie in één klik ophaalt.
Ik ben hier niet neutraal over — ik werk hier — maar de reden dat Thunderbit op deze manier is gebouwd, hangt direct samen met waarom Trustpilot-scraping lastig is. Onze AI leest pagina’s semantisch in plaats van te leunen op CSS-selectors. Als Trustpilot class-namen wijzigt of de DOM herstructureert, past Thunderbit zich aan omdat het kijkt naar de betekenis van pagina-elementen, niet naar hun specifieke HTML-adres.
Probeer Thunderbit voor Trustpilot-scraping
Hoe Thunderbit de inlogmuur na pagina 10 aanpakt
Hier maakt browsermodus het verschil. Thunderbit werkt in je Chrome-browser — dezelfde browser waarin je al bent ingelogd bij Trustpilot. Wanneer je overschakelt naar browser-scrapingmodus, leest de extensie pagina’s die zichtbaar zijn binnen je geauthenticeerde sessie. Geen proxy-acrobatiek. Geen cookie-injectie. Geen Playwright-sessiepools.
De praktische workflow: log in op Trustpilot in Chrome, ga naar de reviewpagina die je wilt ophalen en open de extensie. Eén klik, en de AI herkent welke reviewvelden de pagina bevat en voert de extractie uit. Wil je een andere selectie van data? Beschrijf het gewoon, en de AI volgt die instructie. Paginering verloopt daarna automatisch — Thunderbit werkt door alle pagina’s heen die je browsersessie kan bereiken.
Waarom Thunderbit niet stukgaat als Trustpilot verandert
Onze Trustpilot-templatepagina laat dat direct zien: traditionele scrapers breken wanneer lay-outs veranderen en CSS-selectors moeten worden bijgewerkt. Thunderbit gebruikt semantische AI die content begrijpt zonder afhankelijk te zijn van specifieke CSS, dynamische content aankan en automatische paginering beheert.
Vergelijk dat met de tutorialcode van ScraperAPI, die op class-namen zoals styles_reviewCardInner__EwDq2 parsed. Die selector breekt zodra Trustpilot weer een update uitrolt. Thunderbit’s AI vraagt: “waar staat de reviewtekst op deze pagina?” in plaats van: “wat zit er in deze specifieke div-class?”
Belangrijkste functies voor Trustpilot-scraping
- AI-gedetecteerde velden: de extensie herkent reviewvelden zelf (naam, beoordeling, datum, titel, tekst, bedrijfsreactie) zonder handmatige configuratie — of je kunt een specifieke set opgeven
- Workflow in één klik: één klik → de complete tabel. Klaar.
- Browsermodus voor pagina’s waarvoor je moet inloggen: werkt binnen je geauthenticeerde Chrome-sessie voor toegang tot pagina 10+
- Automatische paginering: verwerkt reviewreeksen over meerdere pagina’s zonder handmatige tussenkomst
- Subpages scrapen: kan afzonderlijke reviewerprofielen openen voor verrijkingsdata
- Gepland scrapen: stel wekelijkse of maandelijkse reviewmonitoring in voor reputatiebewaking
- Exports: Google Sheets, Airtable, Notion, CSV, JSON — allemaal gratis inbegrepen
Prijzen
- Gratis plan: 6 pagina’s/maand, geen creditcard nodig
- Creditsysteem: 1 credit = 1 outputrij
- Betaalde plannen: $15/maand, of ongeveer $9/maand bij jaarlijkse facturering (prijspagina)
Beste keuze voor: marketingteams, operations-teams en zakelijke gebruikers die Trustpilot-reviews nodig hebben zonder code aan te raken — en die geen scraper willen onderhouden die elke paar weken breekt.
2. Apify
Apify is een cloudgebaseerd scrapingplatform met een marktplaats van vooraf gebouwde “Actors” — scrapingtemplates die andere gebruikers en het Apify-team hebben gemaakt. Voor Trustpilot bevat de store meerdere community-onderhouden Actors met wisselende betrouwbaarheid.
De afweging bij Apify: het kan krachtig zijn, maar ook versnipperd. Sommige Actors werken. Sommige zijn verouderd. Sommige vereisen cookies voor pagina 10+. En de Reddit-klachten over “none of the actors on the store work” zijn terecht — ze laten zien hoe snel veranderingen op Trustpilot Actor-specifieke logica kunnen breken.
Trustpilot Actors en bekende beperkingen
De Apify Store bevat meerdere Trustpilot Actors. Minstens één daarvan (van ontwikkelaar “burbn”) vermeldt expliciet dat cookie-input vereist is voor pagina’s voorbij 10. Andere hebben 0,0-sterrenbeoordelingen, heel weinig gebruikers of zeer recente aanpassingsdata — signalen dat onderhoud gaande is en de betrouwbaarheid per Actor verschilt.
Ook de verouderde Actors zijn interessant. Een oudere Actor las Trustpilot’s ingebedde __NEXT_DATA__-JSON rechtstreeks uit — een slimme aanpak die sneller was dan DOM-parsing, maar alsnog stukliep zodra Trustpilot zijn datastructuur aanpaste.
Omgaan met inlogmuur en anti-bot
- Inlogmuur: hangt volledig af van de gekozen Actor. Sommige ondersteunen cookie-injectie voor pagina 10+; andere niet.
- Anti-bot: het platform van Apify bevat proxyrotatie en infrastructuur op basis van compute units. Residential proxies zijn beschikbaar vanaf $8/GB op Free/Starter-plannen.
- Onderhoud: als een Actor stukloopt, wacht je op de onderhoudsverantwoordelijke, stap je over op een andere Actor of laat je een privé-Actor op maat bouwen.
Prijzen
- Gratis plan: $5/maand vooraf betaald gebruik, geen creditcard nodig
- Starter: $9/maand + pay-as-you-go
- Scale: $99/maand + pay-as-you-go
- Exports: JSON, CSV, Excel, XML, RSS (afhankelijk van de Actor)
Beste keuze voor: technisch vaardige gebruikers die meerdere Actors kunnen beoordelen, cookies kunnen configureren en problemen kunnen oplossen wanneer iets kapotgaat. Minder geschikt voor teams die een set-and-forget-oplossing willen.
3. Octoparse
Octoparse is een desktopgebaseerde no-code scraper met een visuele point-and-click workflow builder. Het zit qua positionering tussen Thunderbit’s eenvoud met één klik en de volledige ontwikkelaarscontrole van ScraperAPI — je krijgt visuele configuratie zonder code, maar je bouwt en onderhoudt nog steeds een workflow.
Een Trustpilot-scrape instellen in Octoparse
De workflow is overzichtelijk maar handmatig:
- Plak een Trustpilot-review-URL van een bedrijf
- Selecteer review-elementen visueel (titel, inhoud, beoordeling, datum, reviewernaam)
- Stel een paginatie-loop in via de knop voor de volgende pagina
- Configureer wachttijden (2–5 seconden aanbevolen om reCAPTCHA te vermijden)
- Draai lokaal voor kleine samples of in de cloud voor grotere jobs
Voor iemand die de tool kent, kost de setup ongeveer 10–15 minuten. Het addertje onder het gras: omdat Octoparse visuele selectors gebruikt die aan DOM-elementen vastzitten, moet je je workflow bijwerken zodra Trustpilot de paginastuctuur wijzigt.
Omgaan met inlogmuur en anti-bot
- Inlogmuur: vereist handmatige login/cookie/sessieconfiguratie. Niet automatisch afgehandeld.
- Anti-bot: betaalde plannen bevatten IP-rotatie, residential proxies ($3/GB) en automatische CAPTCHA-oplossing ($1–1,5 per duizend).
- Onderhoud: gemiddeld. Reken erop dat je je workflow opnieuw moet bouwen of aanpassen wanneer Trustpilot zijn frontend bijwerkt.
Prijzen
- Gratis plan: gratis voor altijd, 10 taken, 1 apparaat, lokale extractie, tot 50.000 rijen/maand
- Standard: $69/maand (jaarlijks gefactureerd)
- Professional: $149/maand
- 14-daagse premium trial: inclusief cloud-extractie, planning, API en templates
- Exports: Excel, CSV, JSON, HTML, XML; databases en Google Sheets op hogere niveaus
Beste keuze voor: gebruikers die visuele workflowcontrole willen, setup-tijd geen probleem vinden en workflows willen onderhouden wanneer pagina’s veranderen. Goed voor teams die meer maatwerk willen dan een one-click tool, maar minder complexiteit dan Python schrijven.
4. Web Scraper
Web Scraper is een Chrome-extensie en cloudplatform met een sitemap-gebaseerde aanpak. De sterkste Trustpilot-optie is een vooraf gebouwde template voor bedrijfspagina’s waarmee bedrijfsniveau-data wordt opgehaald: bedrijfsnaam, categorie, adres, beoordeling, aantal reviews, TrustScore en website-URL.
Voor het scrapen van reviews zelf heeft Web Scraper een gedocumenteerde beperking die je echt moet kennen.
Vooraf gebouwde template versus custom setup
De marketplace-template werkt goed voor bedrijfsverkenning — dus het scrapen van bedrijfsprofielen binnen Trustpilot-categorieën. Voor aangepaste reviewextractie laat de Sitemap Wizard je in de Chrome-extensie een scraper visueel opbouwen.
De eigen gids van Web Scraper uit maart 2026 raadt JavaScript-klikpaginering aan in plaats van URL-gebaseerde paginering, omdat Trustpilot content dynamisch kan herschikken tussen pagina’s, waardoor resultaten verschuiven.
Omgaan met inlogmuur en anti-bot
Hier is eerlijkheid belangrijk: de officiële gids van Web Scraper stelt expliciet dat Trustpilot alleen de eerste 10 reviewpagina’s toestaat voordat een inlogprompt verschijnt. De gids noemt dit een bekende beperking en biedt geen workaround.
- Inlogmuur: beperkte afhandeling. De limiet van 10 reviewpagina’s staat in hun eigen gids.
- Anti-bot: cloudplannen bevatten proxyondersteuning; de gids adviseert 2–5 seconden vertraging en lagere concurrency.
- Paginering: configureerbaar, maar in de praktijk beperkt tot de eerste 10 reviewpagina’s voor toegang zonder login.
Prijzen
- Gratis Chrome-extensie: lokale scraping, beperkte functionaliteit
- Project: $50/maand (5.000 URL-credits)
- Professional: $100/maand (20.000 URL-credits)
- Scale: vanaf $200/maand (onbeperkte URL-credits onder voorwaarden)
- 7-daagse gratis trial op betaalde cloudplannen
- Exports: CSV, XLSX
Beste keuze voor: gebruikers die een kant-en-klare template willen voor het scrapen van Trustpilot-bedrijfsprofielen, of die alleen reviews van de eerste 10 pagina’s nodig hebben. Niet geschikt als je de volledige reviewhistorie van bedrijven met veel reviews wilt.
5. ScraperAPI
ScraperAPI is scraping-infrastructuur voor developers — geen point-and-click tool, maar een proxy/renderinglaag die anti-botmaatregelen afhandelt terwijl jij de parsinglogica schrijft. De Trustpilot-oplossingspagina promoot JS-rendering, CAPTCHA-afhandeling en meer dan 40 miljoen proxies.
Als je een Python-developer bent die volledige controle wil over de extractielogica, levert ScraperAPI de basisvoorzieningen.
Maar het onderhoud blijft wel voor jou.
Een eigen Trustpilot-scraper bouwen met ScraperAPI
De ScraperAPI-tutorial uit januari 2026 laat een workflow zien in Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
In de uitgewerkte code wordt pages_to_scrape = 10 ingesteld — een impliciete erkenning van de publieke paginalimiet. Voor pagina 10+ moeten developers zelf geauthenticeerde sessies, cookies en tokens beheren.
Omgaan met inlogmuur en anti-bot
- Inlogmuur: sessie- en cookiebeheer op codeniveau vereist. ScraperAPI regelt proxies en rendering; jij regelt de authenticatielogica.
- Anti-bot: residential proxy-pool met automatische IP-rotatie, JS-rendering via
render=true, CAPTCHA-afhandeling via slimme proxyrotatie. Beschikbaar op alle plannen. - Onderhoud: als Trustpilot class-namen wijzigt (wat regelmatig gebeurt), moet je je parsingcode bijwerken. De selector
styles_reviewCardInner__EwDq2uit de tutorial is al een tikkende tijdbom.
Prijzen
- 7-daagse trial: 5.000 gratis API-credits, geen creditcard nodig
- Hobby: $49/maand (100.000 API-credits)
- Startup: $149/maand (1.000.000 credits)
- Business: $299/maand (3.000.000 credits)
- Exports: wat je code oplevert (meestal CSV, JSON, databasewrites)
Beste keuze voor: developers die volledige maatwerkcontrole willen, hun eigen parsing-scripts kunnen onderhouden en programmeerbare controle nodig hebben over sessiebeheer, pagineringslogica en datastructuur. Niet voor niet-technische gebruikers.
Waarom Trustpilot-scrapers steeds stukgaan (en hoe je er één kiest die het niet doet)
Dit is waarschijnlijk de meest onderschatte factor bij het kiezen van een Trustpilot-scraper. De vraag is niet: “werkt deze tool vandaag?” De echte vraag is: “werkt deze tool over drie weken nog steeds?”
Scrapers breken op Trustpilot om vier terugkerende redenen:
-
Veranderingen in gegenereerde CSS-class-namen. Next.js CSS-modules produceren class-namen zoals
styles_reviewCardInner__EwDq2. Die veranderen bij elke frontend-deployment. Elke scraper die op deze classes mikt, breekt. -
Veranderingen in de DOM-structuur. Trustpilot kan de HTML-hiërarchie herinrichten — reviewkaarten anders nesten, wrapper-elementen wijzigen, metadata verplaatsen.
-
Wijzigingen in anti-bottriggers. De drempel voor reCAPTCHA verschuift. Sessietoken-rotatie wordt agressiever. CDN-filterregels worden aangepast.
-
Wijzigingen in authenticatie/sessies. De inlogmuur na pagina 10 werd eind 2025 geïntroduceerd (of strenger afgedwongen). Toekomstige toegangsbeperkingen kunnen op elk moment verschijnen.
Het fundamentele architectuurverschil zit tussen selector-gebaseerde en semantische extractie:
-
Selector-gebaseerde tools (Apify Actors, Octoparse-workflows, ScraperAPI-scripts, Web Scraper-sitemaps) vragen: “Vind het element op dit exacte CSS-pad.” Als dat pad verandert, falen ze stilzwijgend of leveren ze lege data.
-
Semantische/AI-tools (Thunderbit) vragen: “Vind op deze pagina de reviewtekst, beoordeling en datum.” De AI interpreteert pagina-inhoud op betekenis, niet op adres. Layoutwijzigingen breken het niet, omdat de betekenis niet is veranderd.
Mijn aanbeveling:
- Geen onderhoud willen? → AI-gebaseerd (Thunderbit)
- Enig onderhoud oké, cloudautomatisering gewenst? → Apify (met Actor-selectie en monitoring)
- Visuele controle, gemiddeld onderhoud? → Octoparse
- Template-gebaseerd, beperkte scope? → Web Scraper
- Volledige controle, alles zelf beheren? → ScraperAPI
Wat je kunt doen met gescrapete Trustpilot-reviews
Reviews ophalen is stap één. De vraag die ik voortdurend op forums zie: “Ik heb de data — en nu?”
Sentimentanalyse
De simpelste workflow: exporteer reviews naar Google Sheets en gebruik vervolgens een AI-tool (ChatGPT, Claude of een AI-functie in Sheets) om elke review te labelen als positief, neutraal of negatief. Voeg kolommen toe voor klachtcategorie, urgentie en voorgestelde actieprioriteit.
Voor grotere datasets kun je de CSV uploaden in ChatGPT en vragen: “Classificeer deze reviews op sentiment en identificeer de 5 belangrijkste klachtenthema’s met representatieve citaten.”
Concurrentiemonitoring
Gebruik Thunderbit’s geplande scraping om wekelijks of maandelijks reviews van concurrenten op te halen. Volg:
- De ontwikkeling van de gemiddelde beoordeling in de tijd
- Het aandeel 1- en 2-sterrenreviews
- Veranderingen in reviewvolume (krijgen ze meer of minder reviews?)
- De meest voorkomende klachtenthema’s
- Reactiepercentage en responssnelheid van het bedrijf
Een simpel Google Sheets-dashboard met draaitabellen op basis van beoordeling en datum geeft je een automatisch geüpdatete bron voor competitive intelligence.
Thema-extractie
Gropeer reviews op veelvoorkomende categorieën: verzending/levering, klantenservice, terugbetalingen, productkwaliteit, facturatie, gebruiksgemak van de app, prijs/waarde en fraudeverdachte signalen. De output moet een tabel zijn met: thema, aantal, gemiddelde beoordeling, representatieve citaten en voorgestelde bedrijfsactie.
Dat is nuttiger dan een wordcloud. Het laat zien wat nu echt tevredenheid of ontevredenheid veroorzaakt.
Bulk-analyse over meerdere bedrijven
Voor onderzoek op categorieniveau kun je reviews scrapen van meerdere bedrijven binnen dezelfde Trustpilot-categorie. Vergelijk reviewvolumes, beoordelingen, sterverdeling en themafrequentie over een hele marktsegment. De bedrijfsvermeldingstemplate van Web Scraper is handig om bedrijven te ontdekken; Thunderbit of ScraperAPI kan vervolgens de reviewdata per bedrijf verwerken.
Juridische en ethische aandachtspunten bij het scrapen van Trustpilot
Ik ben geen advocaat, en dit is geen juridisch advies. Maar compliance is hier wel degelijk belangrijk.
De gebruiksvoorwaarden van Trustpilot zijn duidelijk. Ze verbieden gebruikers om content te benaderen of te verzamelen “by any means other than as provided or specifically approved by Trustpilot,” en noemen expliciet tekstmining, datamining en webscraping zonder uitdrukkelijke toestemming.
Het risicospectrum ziet er zo uit:
- Lager risico: reviews van je eigen bedrijf exporteren voor interne analyse, zeker via de officiële zakelijke tools of API van Trustpilot.
- Gemiddeld risico: publieke concurrentenpagina’s op beperkte schaal scrapen voor marktonderzoek. Nog steeds onderhevig aan de gebruiksvoorwaarden en privacyverplichtingen.
- Hoger risico: content scrapen achter de inlogmuur na pagina 10, technische beschermingen omzeilen, reviewdata herdistribueren of gescrapete reviews gebruiken om AI-modellen te trainen.
GDPR-overwegingen: namen van reviewers, profillinks, reviewtekst en locatiegegevens kunnen onder EU-privacywetgeving als persoonsgegevens gelden. Praktische waarborgen zijn onder meer alleen de benodigde velden verzamelen, reviewer-namen hashen voor interne analytics, bewaartermijnen instellen en ruwe reviewtekst niet op grote schaal opnieuw publiceren.
Publieke versus geauthenticeerde data: er is een duidelijk juridisch en ethisch verschil tussen pagina’s die iedereen kan zien (de eerste 10 reviewpagina’s) en data achter een authenticatiemuur. Tools die alleen met publieke data werken brengen minder compliance-risico met zich mee dan tools die inloggegevens vereisen.
Ook dit hoort mee te wegen in je toolkeuze. Thunderbit’s browsermodus werkt met pagina’s die zichtbaar zijn in je eigen sessie — het omzeilt authenticatie niet zelfstandig. ScraperAPI geeft developers volledige controle, maar ook volledige verantwoordelijkheid voor de legaliteit van sessiebeheer.
Hoe kies je de juiste Trustpilot-recensiescraper?
Besluitvormingskader per profiel:
- Niet-technische marketeer die reviews nodig heeft zonder code? → Thunderbit. Eén klik, AI doet de rest, export naar Sheets/Notion/Airtable.
- Low-code gebruiker die comfortabel is met configuratie en debugging? → Apify. Kies een Actor, configureer cookies voor pagina 10+, monitor op fouten.
- Visuele bouwer die workflowcontrole wil? → Octoparse. Point-and-click setup, maar reken op onderhoud wanneer Trustpilot verandert.
- Bedrijfsdata of alleen reviews van de eerste 10 pagina’s nodig? → Web Scraper. Sterke vooraf gebouwde templates voor bedrijfsprofielen.
- Developer die volledige maatwerkcontrole wil? → ScraperAPI. Beheer je eigen parsinglogica, sessiebeheer en datapipeline.
Als onderhoudsarm werken je belangrijkste eis is, loopt het spectrum van Thunderbit (bijna geen onderhoud) tot ScraperAPI (je onderhoudt alles zelf). Qua budget heeft elke tool op deze lijst een gratis instapoptie — begin daar voordat je vastlegt.
Conclusie
Trustpilot-reviewdata is echt waardevol voor concurrentieanalyse, reputatiemonitoring en klantinzichten.
Maar in 2026 heb je om die data betrouwbaar te kunnen halen een tool nodig die de inlogmuur na pagina 10 aankan, kan omgaan met DOM-wijzigingen en anti-botbeveiliging verwerkt zonder voortdurend handmatig ingrijpen.
Voor de meeste zakelijke gebruikers is Thunderbit de minst lastige route — één klik, AI-gestuurde veldherkenning, browsermodus voor geauthenticeerde pagina’s en geen onderhoud wanneer Trustpilot de frontend wijzigt. Je kunt het gratis proberen met 6 pagina’s per maand en zonder creditcard.
Voor developers die volledige controle willen, biedt ScraperAPI de infrastructuur. Voor iedereen daartussenin bedienen Apify, Octoparse en Web Scraper elk een eigen niche. De sleutel is om de tool af te stemmen op je technische comfort, je tolerantie voor onderhoud en je compliance-eisen.
Als je wilt zien hoe Thunderbit specifiek met Trustpilot omgaat, hebben we een uitleg op ons YouTube-kanaal. En voor bredere context over webscraping zonder code of wat webscraping eigenlijk is, dekken die gidsen de basis.
FAQ
1. Kun je Trustpilot-reviews scrapen voorbij pagina 10?
Ja, maar alleen via een geauthenticeerde route. Trustpilot blokkeert toegang zonder login na de eerste 10 reviewpagina’s. Thunderbit’s browsermodus werkt binnen je ingelogde Chrome-sessie, dus die kan pagina’s openen die jij zelf kunt zien. ScraperAPI vereist sessie- en cookiebeheer op codeniveau. Apify Actors hebben cookieconfiguratie nodig. Octoparse vereist handmatige login-/cookie-instelling. De eigen documentatie van Web Scraper erkent de beperking van 10 pagina’s zonder ingebouwde workaround.
2. Is het legaal om Trustpilot-reviews te scrapen?
De gebruiksvoorwaarden van Trustpilot verbieden geautomatiseerde dataverzameling zonder uitdrukkelijke toestemming. Het juridische risico verschilt per methode en gebruik: je eigen publieke reviews scrapen brengt minder risico met zich mee dan authenticatiemuren omzeilen om concurrenten te scrapen. GDPR is van toepassing op reviewdata van EU-gebruikers. Dit is geen juridisch advies — overleg met een jurist bij grootschalige of commerciële scrapingprojecten.
3. Welke data kun je uit Trustpilot halen?
Veelvoorkomende velden zijn: reviewernaam, sterbeoordeling, reviewtitel, reviewtekst, publicatiedatum, ervaringsdatum, status van geverifieerde aankoop, locatie van de reviewer, tekst van bedrijfsreacties, bedrijfsnaam, TrustScore, totaal aantal reviews, sterverdeling en review-URL.
4. Hoe vaak gaan Trustpilot-scrapers stuk?
Selector-gebaseerde tools (Apify Actors, Octoparse-workflows, eigen Python-scripts) kunnen breken zodra Trustpilot zijn CSS-class-namen of DOM-structuur wijzigt — en dat kan meerdere keren per maand gebeuren. AI-semantic tools zoals Thunderbit passen zich automatisch aan omdat ze de betekenis van de pagina interpreteren in plaats van op specifieke selectors te mikken. Geen enkele tool is echter immuun voor grote toegangsveranderingen zoals de inlogmuur na pagina 10.
5. Kan ik Trustpilot-reviews gratis scrapen?
Elke tool op deze lijst heeft een gratis instapoptie: Thunderbit biedt 6 gratis pagina’s per maand, ScraperAPI geeft 5.000 proefcredits voor 7 dagen, Web Scraper heeft een gratis Chrome-extensie voor lokaal gebruik, Octoparse heeft een gratis-voor-altijd plan (10 taken, 50.000 rijen/maand) en Apify bevat $5/maand aan gratis platformcredits. Voor kleine samples of testen werken deze allemaal zonder betaling.
Probeer Thunderbit voor Trustpilot-recensiescraping Get Started Free
Meer lezen



