
Vorige maand begon de Stripe-koppeling van een vriend op een vrijdag om 23:00 uur stilletjes 503-fouten terug te geven. Niemand merkte iets tot zaterdagochtend — toen de support-inbox ineens meer dan 200 boze e-mails bevatte van klanten bij wie het afrekenen was mislukt.
Dat soort verhalen is echt niet zeldzaam. Een veel aangehaalde benchmark schat de gemiddelde downtime op $5.600 per minuut, terwijl grote storingen kunnen oplopen tot miljoenen per uur. Het precieze bedrag hangt af van verkeer, conversieratio, orderwaarde, SLA-risico en herstelkosten — maar de richting is duidelijk: API’s die je niet monitort zijn een zakelijk risico, niet alleen iets dat engineering irritant vindt. En nu organisaties gemiddeld 131 third-party API’s draaien en slechts 16% aangeeft een hoge mate van beheersing te hebben om third-party API-risico’s te beperken, is monitoring allang geen nice-to-have meer. Wat ik met deze gids wilde doen en elders niet vaak zie, is tools indelen op jouw use-case, de kwaliteit van alerts beoordelen (niet alleen of er alerts zijn), echte prijzen voor 2026 laten zien en meten hoe snel je echt live kunt gaan. Dus niet weer een vlakke lijst met logo’s.
Nog iets: als jouw API-werk draait om webdata verzamelen, LLM’s voeden, RAG-systemen bouwen, concurrentenpagina’s monitoren of prijs-/productdata uit websites halen, dan mag het gesprek over "API-tools" niet stoppen bij uptime-monitoring. Je hebt dan ook een betrouwbare manier nodig om rommelige webpagina’s om te zetten naar gestructureerde data. Daar past Thunderbit Open API in deze gids: het is geen uptime-monitor, maar wel een van de snelste manieren om websites via een API om te zetten naar nette Markdown of schema-gebaseerde JSON.
Wat is API-monitoring (en waarom zou je team dit serieus nemen)?
API-monitoring betekent dat je continu checkt of je API-endpoints bereikbaar zijn, snel reageren en de juiste data teruggeven. Dus niet alleen: "staat de server aan?" Een goede monitor valideert HTTP-statuscodes, response payloads, latency, SSL-certificaten, meerstaps-workflows (zoals login → search → checkout) en zelfs of het schema klopt.
Dat is iets anders dan algemene website-monitoring (die checkt of een pagina laadt) en ook anders dan APM (Application Performance Monitoring), dat dieper kijkt naar code-traces, database queries en runtime-details. API-monitoring zit precies op de grens: het test wat je gebruikers, partners en integraties echt ervaren wanneer ze jouw endpoints aanroepen.
Er is ook een verwante categorie die het benoemen waard is: web data API’s. Die monitoren niet of je eigen API gezond is; ze helpen je product of workflow juist om extern webdata betrouwbaar op te halen. Thunderbit Open API kan bijvoorbeeld een webpagina omzetten naar schone Markdown, gestructureerde velden als JSON extraheren en batchtaken over veel URL’s uitvoeren. Als jouw "API"-project afhangt van verse leveranciersdata, productpagina’s, openbare listings, documentatiepagina’s of onderzoeksbronnen, dan kan zo’n data-extractie-API net zo operationeel belangrijk zijn als uptime-checks.
Waarom zouden niet-engineers hierom geven? Omdat API’s 71% van het dynamische webverkeer uitmaken en 62% van de API-professionals zegt dat API’s direct inkomsten genereren. Als een payment gateway, authenticatieservice of shipping API uitvalt, is dat geen abstract infrastructuurprobleem — het betekent omzetverlies, kapotte partnerafspraken, meer supporttickets en minder vertrouwen. Productmanagers, sales, operations en customer success hebben hier allemaal belang bij.
Belangrijkste metrics om te volgen:
- Uptime-percentage: deel van de tijd dat een endpoint beschikbaar is
- Responstijd / latency: hoe lang het endpoint nodig heeft om te reageren (gemiddelde, p95, p99)
- Foutpercentage: aandeel requests dat 5xx, time-outs of assertion failures oplevert
- Throughput: requests per seconde/minuut
- Correctheid: of de API verwachte data teruggeeft, niet alleen een 200 OK
Hoe we de beste API-monitoring tools voor 2026 beoordeelden
De meeste artikelen over de "beste API-monitoring tools" gooien simpelweg vendor-namen en features op één hoop. Ik wilde selectiever te werk gaan — deels omdat ik veel tijd heb besteed aan ontwikkelaarsforums, en deels omdat het Thunderbit-team me hielp om prijs- en featuredata in bulk te extraheren van vendor-sites voor een echte vergelijking (daarover later meer).
Hier is hoe we hebben gewogen:
| Criteria | Waarom dit belangrijk is |
|---|---|
| Gemak van opzetten / time-to-first-alert | Kleine teams hebben vandaag dekking nodig, niet pas na een platformproject |
| Alert-intelligentie & noise reduction | Als alerts lawaaierig zijn, negeren teams ze en missen ze echte incidenten |
| Vrijgevigheid van de gratis tier | Side projects en vroege startups beginnen vaak gratis |
| Prijstransparantie | Observability-kosten kunnen exploderen door hosts, seats, logs, synthetics en data-ingest |
| Breedte van integraties | Alerts moeten landen waar teams al werken (Slack, PagerDuty, enz.) |
| Schaalbaarheid & diepte van data | Volwassen teams hebben traces, logs, APM, RBAC, SSO en retentie nodig |
| Community- & supportkwaliteit | Open-source teams hebben een stabiel release-tempo nodig; enterprise teams SLA’s |
| Mogelijkheid tot webdata-extractie | AI-apps, RAG-workflows en market-research tools hebben vaak schone externe data nodig, niet alleen endpoint-uptime |
We hebben aanbevelingen ook uitgesplitst per use-case — solo developer, startup, e-commerce/SaaS, enterprise, open-source purist, API-productteam en webdata/AI-app-team — zodat je direct naar jouw context kunt springen in plaats van 14 tools te moeten lezen en gokken welke bij je past. Grafana’s survey uit 2025 vond dat 46% van de respondenten interoperabiliteit en 35% de mogelijkheid om later eenvoudig te wisselen als selectiecriterium noemde, wat bevestigt dat dit geen nice-to-haves zijn.
Beste API-monitoring tools per use-case: de snelle keuzetabel
Dit is de shortcut. Vind je rij en spring daarna naar de tool-secties hieronder voor de volledige uitleg.
| Use-case | Aanbevolen tools | Belangrijkste onderscheid |
|---|---|---|
| Webdata / AI-app teams | Thunderbit Open API, Moesif, Apitally | Zet websites om in schone Markdown of gestructureerde JSON voor LLM’s, RAG, pricing en research-workflows |
| Solo developer / side project | UptimeRobot, Uptime Kuma, Gatus | Gratis of self-hosted, minimale configuratie, snel live |
| Startup (team van 5–15 personen) | Checkly, Better Stack, Postman | Slimme alerts, snelle setup, betaalbaar, statuspagina’s |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Business metrics, APM/tracing, SDK-diepte, meerstaps synthetics |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, hybrid, RBAC/SSO |
| Open-source puristen | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Volledige controle, OTel-native, geen vendor lock-in |
| API-productteams | Moesif, Apitally, New Relic | Gebruik per klant, endpoint-trends, anomaly alerts |
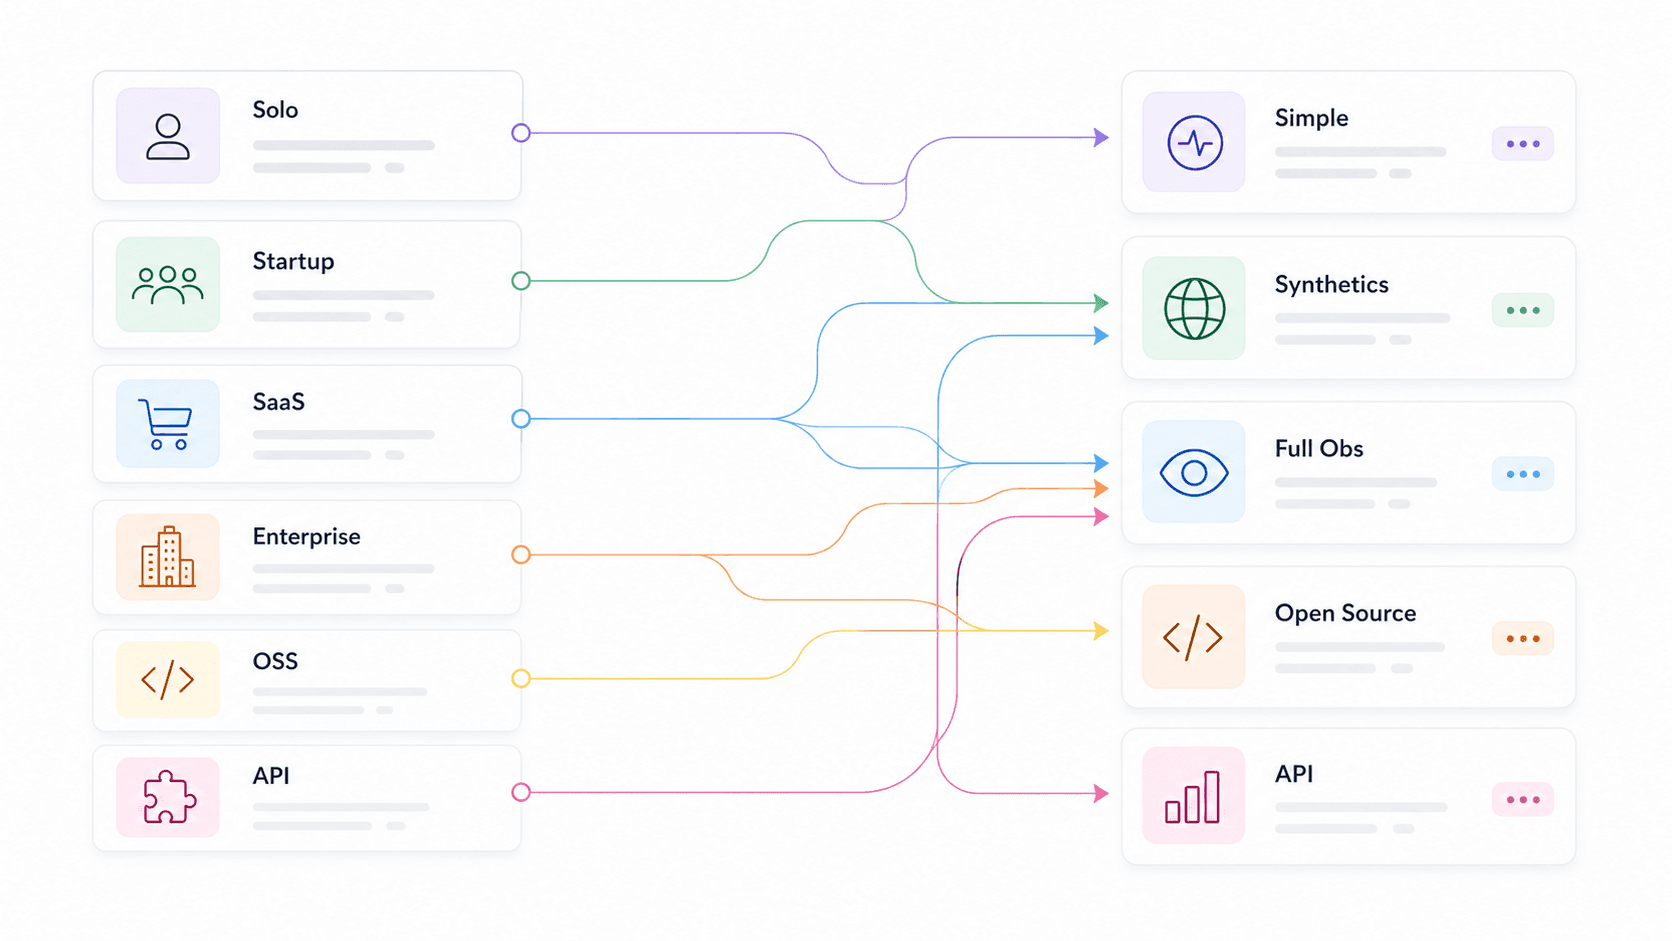
Het grootste patroon: tools die snel op te zetten zijn, zijn vaak lichter in analytics, terwijl diepere platformen meer configuratie en kostenbewaking vragen. Dat is geen fout — het is een trade-off waar je je bewust van moet zijn. Thunderbit zit in een iets andere hoek: het is het snelst wanneer de taak is om webpagina’s om te zetten naar API-klare data, niet om engineers te alarmeren bij downtime.
Thunderbit Open API: het beste voor websites omzetten naar gestructureerde API-data
Begin met bouwen met Thunderbit Open API Zet pagina’s om naar Markdown, extraheer gestructureerde JSON en verwerk URL’s in bulk zonder scraping-infrastructuur te onderhouden. Get Started Free
Thunderbit Open API is de API die ik op één zou zetten voor teams waarvan de "monitoring"- of research-workflow afhangt van externe webdata. Het is geen traditionele uptime-monitor zoals Checkly of UptimeRobot. In plaats daarvan zet Thunderbit elke webpagina om in schone, gestructureerde data die je apps, agents, dashboards en LLM-pipelines echt kunnen gebruiken.
De API heeft drie kernworkflows. Distill zet een pagina om naar schone, LLM-klare Markdown. Extract neemt een schema en geeft gestructureerde JSON-velden terug zoals productnaam, prijs, beschikbaarheid, bedrijfsgrootte, financieringsfase of reviewscore. Batch laat je tot 100 URL’s asynchroon verwerken met webhooks, wat handig is voor het monitoren van prijspagina’s, concurrentencatalogi, vendor-documentatie, nieuwsbronnen of grote researchlijsten.
Waarom het in een gids over API-tools thuishoort: teams onderschatten vaak hoeveel infrastructuur "haal deze pagina gewoon even op" eigenlijk vraagt. Sites met veel JavaScript vereisen rendering. Sommige pagina’s hebben geo-routing nodig. HTML moet worden ontdaan van navigatie, advertenties, modals en standaardtekst voordat het bruikbaar is voor een LLM. Selectors breken als layouts veranderen. Proxy-rotatie, anti-bot-afhandeling, retries, queues en resultaatpolling kunnen van een kleine dataworkflow zomaar een onderhoudsproject maken. Thunderbit neemt een groot deel van dat werk op zich achter één API.
Beste voor: AI-appbouwers, RAG-teams, e-commerce operations, sales operations, growth teams, marktonderzoekers en developers die website-data via een API nodig hebben zonder een scraping-stack te bouwen en te onderhouden.
Prijzen: Gratis: 600 eenmalige API-units, inclusief tot 600 Distill-pagina’s of 30 Extract-pagina’s, met 2 gelijktijdige requests. Starter staat vermeld vanaf $16/maand bij jaarlijkse betaling voor 60.000 API-units/jaar en 30 gelijktijdige requests. Pro staat vermeld vanaf $40/maand bij jaarlijkse betaling voor 600.000 API-units/jaar en 50 gelijktijdige requests.
Setup-snelheid: ongeveer 5–15 minuten om een API-key te krijgen en je eerste Distill- of Extract-request te draaien met cURL, SDK’s of de Thunderbit CLI.
Nadelen: Thunderbit vervangt Datadog, New Relic, Better Stack of Checkly niet voor uptime-checks, incident-escalatie, traces, logs of on-call routing. Zie het als de API die je gebruikt om webdata te verzamelen en structureren — inclusief vendorprijzen, docs, concurrentenpagina’s, productoverzichten of openbare datasets — niet als het systeem dat je on-call engineer uit bed belt.
Datadog: het beste voor full-stack visibility
Datadog is de tool die ik steeds weer zie in enterprise- en mid-market SaaS-stacks, en met goede reden. Het is niet alleen API-monitoring — het is een volledig observability-platform dat synthetische API-tests verbindt met distributed traces, logs, infrastructuurmetrics en real user monitoring in één overzicht.
Voor API-monitoring ondersteunt Datadog specifiek HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC en meerstaps API-tests. De anomaly-detection monitors leren verwachte patronen en alarmeren op afwijkingen in plaats van op statische drempels — een duidelijke stap vooruit ten opzichte van "alert bij latency > 500ms". Het biedt ook forecast monitors die voorspellen wanneer een metric een drempel gaat overschrijden, plus composite monitors die meerdere voorwaarden combineren.
Beste voor: e-commerce-, SaaS- en enterprise-teams die één beeld willen over API’s, infrastructuur, logs en traces.
Prijzen: details van de gratis tier verschillen per product. Infrastructure Pro begint bij $15/host/maand; API synthetic tests kosten $5 per 10.000 runs. Meer dan 800 integraties.
Setup-snelheid: ongeveer 15–30 minuten voor agent-installatie plus een basis synthetic test.
Nadelen: Kan op schaal duur worden — "bill shock" is een terugkerend thema op Hacker News en Reddit. Het grote aantal SKU’s (hosts, logs, custom metrics, synthetics, users) betekent dat iemand op de rekening moet letten, niet alleen op de dashboards. De leercurve is serieus voor het volledige platform.
Checkly: het beste voor developer-first synthetic checks
Checkly is de tool die ik aan een startup-engineeringteam zou geven dat API-checks dicht bij de code wil houden. Het kernidee is "monitoring as code": definieer API- en browser-checks programmatisch, draai ze vanuit wereldwijde locaties, integreer met CI/CD-pipelines en beheer alles via Git.
De kwaliteit van alerts is hier sterk. Checkly’s retry-logic wordt expliciet gezien als de "eerste verdedigingslinie" tegen false positives — je kunt vaste, lineaire of exponentiële retries instellen, retries vanaf dezelfde of een andere locatie, en maximale retry-duur voordat een alert afgaat. Het maakt ook onderscheid tussen degraded, failed en recovered states, wat helpt om lawaaierige meldingen te verminderen.
Beste voor: startups en dev-teams die programmeerbare API-checks, Playwright-gebaseerde browser checks, CI/CD-integratie en snelle setup willen.
Prijzen: recente publieke data laat een gratis plan zien met 10 uptime monitors, 1.000 browser checks en 10.000 API checks. Starter rond $24/maand bij jaarlijkse betaling — controleer de officiële prijspagina voordat je koopt.
Setup-snelheid: ongeveer 10–20 minuten voor een eerste API-check en alertkanaal.
Nadelen: Gericht op synthetische checks. Geen vervanging voor diepe APM, log analytics of distributed tracing. Als je een API-fout wilt koppelen aan een database-bottleneck, heb je daar een andere tool naast nodig.
UptimeRobot: het beste voor eenvoudige, betaalbare uptime-tracking
UptimeRobot is de Honda Civic onder de API-monitoring tools. Het doet één ding goed: je maakt een HTTP-, keyword-, ping-, port-, SSL- of heartbeat-monitor aan, kiest een interval en krijgt een melding als het misgaat. Dat is alles.
Beste voor: solo developers, kleine teams, bureaus of iedereen die basis uptime- en latencymonitoring wil zonder complexiteit.
Prijzen: Gratis: 50 monitors, intervallen van 5 minuten. Betaalde Solo-variant ongeveer $7/maand bij jaarlijkse betaling. Voor de gratis versie is geen creditcard nodig. Setup-snelheid: ongeveer 2–5 minuten — de snelste van deze lijst.
Nadelen: Beperkte alert-intelligentie. Basis drempel-alerts, geen anomaly detection, geen distributed tracing, geen diepe analytics. Als je wilt weten waarom een endpoint traag is (en niet alleen dat het traag is), kom je met UptimeRobot niet ver genoeg.
Uptime Kuma: de beste gratis, self-hosted API-monitoring tool
Uptime Kuma is een favoriet van de self-hosting-community, en de GitHub-cijfers bevestigen dat: 86.637 sterren, 7.831 forks, 1.060 contributors, en release 2.3.2 per mei 2026. Het is MIT-licensed, ondersteunt HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, meerdere statuspagina’s en meer dan 90 notificatieservices.
Beste voor: solo developers en teams die volledige controle, privacy en geen terugkerende SaaS-kosten willen — mits je een server hebt.
Prijzen: gratis. De echte kosten zitten in je VM/container, backups, updates en het zorgen dat de monitor zelf online blijft. Setup-snelheid: ongeveer 5–15 minuten met Docker voor een basischeck; 15–30 minuten met notificaties en statuspagina-afwerking.
Nadelen: Je bent zelf verantwoordelijk voor onderhoud. En hier zit de belangrijke valkuil: als je Uptime Kuma op dezelfde infrastructuur host als de systemen die je monitort, kan een cloud- of DNS-storing zowel je app als je monitor platleggen. Host het extern of combineer het met een SaaS-check.
Better Stack: het beste voor snelle incidentrespons
Better Stack (vaak nog steeds Better Uptime genoemd door gebruikers) combineert uptime-monitoring met incidentmanagement, on-call planning, escalatiebeleid en statuspagina’s in één platform. Het is vooral sterk niet als analytics-tool, maar als incident-workflowtool rond monitoring.
Escalatiebeleid bepaalt wie wanneer alert krijgt, in welke volgorde en met welke vertraging, totdat iemand bevestigt. Routing op basis van metadata stuurt incidenten door op severity of ownership. Het integreert met Slack, Teams, webhooks en Zapier.
Beste voor: startups en middelgrote teams die monitoring + incidentrespons + statuspagina’s willen zonder drie losse tools aan elkaar te knopen.
Prijzen: gratis tier: 10 monitors/heartbeats, 1 statuspagina. Team rond $29/maand bij jaarlijkse betaling. Setup-snelheid: ongeveer 5–10 minuten via de GUI-wizard.
Nadelen: Minder diepgang in API-payload-analytics, distributed tracing of business KPI-analyse dan Datadog, New Relic of Moesif.
Prometheus + Grafana: de beste open-source API-monitoring stack
Dit is de industriestandaard open-source combinatie. Prometheus scrape’t en bewaart time-series metrics. Grafana (73.705 GitHub-sterren, 3.010 contributors) levert dashboards en alerting. Alertmanager regelt routing, grouping, deduplicatie, silencing en inhibition. Voor endpoint-checks voegen teams Blackbox Exporter toe voor HTTP, HTTPS, DNS, TCP, ICMP en gRPC-probing.
Beste voor: open-source puristen, Kubernetes/SRE-teams en organisaties die al standaard op Prometheus-metrics draaien.
Prijzen: gratis self-hosted. Grafana Cloud heeft een gratis tier (100k API test-uitvoeringen/maand) en betaalde gebruiksgebaseerde plannen.
Setup-snelheid: 1–4 uur voor een basisopzet met Blackbox + Prometheus + Grafana + Alertmanager. Dagen voor productie-HA en fine-tuning van alerts.
Nadelen: PromQL, YAML, relabeling, dashboardontwerp, retentie, storage, HA en alert-tuning zijn echte operationele werkzaamheden. De terugkerende trade-off is "minder UI, meer YAML". Dit is de stack voor teams die al in metrics denken en één control plane willen — niet voor teams die monitoring voor de lunch live willen hebben.
New Relic: het beste voor SaaS application performance
New Relic combineert APM, infrastructuurmonitoring, logs, distributed tracing, synthetische monitoring, alerts, dashboards en AI-ondersteunde incidentanalyse. De gratis tier — 100 GB/maand data-ingest en 1 full platform user — is echt royaal voor kleine teams.
De kracht van New Relic zit vooral in de alert-intelligentie. De functies voor incident intelligence omvatten event-correlation, anomaly detection, predictive alerts, root-cause analysis en flapping suppression. New Relic publiceerde een voorbeeld waarin 97,2% flapping-effectiviteit betekent dat slechts 28 zichtbare issues per 1.000 flapping-incidenten overblijven — dat is een concreet cijfer voor noise reduction.
Beste voor: SaaS-teams en e-commerceplatformen die API-monitoring strak willen koppelen aan applicatietraces, fouten, throughput en user impact.
Prijzen: gratis: 100 GB/maand, 1 full user. Betaald werkt met prijsstelling per gebruiker en op basis van data.
Setup-snelheid: ongeveer 15–30 minuten voor agent-installatie en begeleide setup.
Nadelen: Prijzen kunnen op schaal complex worden. De alertconfiguratie heeft een leercurve — het platform is krachtig maar niet meteen intuïtief.
Moesif: het beste voor API analytics en business metrics
Moesif is geen traditionele uptime-monitor. Het is API-analytics en product intelligence: inzicht in API-gebruik per klant, endpoint, cohort, bedrijf, geografie, SDK, plan en gedrag. Als je vraag is "welke klant wordt geraakt?" in plaats van "is het endpoint live?", dan is Moesif daarvoor gebouwd.
Het ondersteunt statische drempelalerts en dynamische anomaly alerts voor API-metrics zoals verkeerpieken/-dalingen, latency en gedragsveranderingen. De dynamische alerts hebben een paar dagen API-gedrag nodig om een model op te bouwen, maar zodra dat getraind is, pakken ze veranderingen op die statische regels missen.
Beste voor: API-productteams, SaaS-bedrijven en e-commerceplatformen die API-prestaties willen koppelen aan omzet, engagement en retentie.
Prijzen: gratis/proefversie beschikbaar; betaalde plannen schalen mee met API-eventvolume. Zelfbedieningsbedragen waren niet volledig te crawlen in mijn onderzoek — controleer de huidige pagina.
Setup-snelheid: ongeveer 20–45 minuten (SDK/proxy/gateway-integratie is dieper dan een externe ping).
Nadelen: Meer analytics-gericht dan traditionele uptime-monitoring. Je wilt Moesif waarschijnlijk combineren met Checkly, UptimeRobot of Datadog synthetics voor externe beschikbaarheidschecks.
Splunk: het beste voor enterprise log-analyse en compliance
Splunk is de tool die je pakt wanneer log-aggregatie, search, correlatie, compliance-klare auditability en hybride/multi-cloud support niet onderhandelbaar zijn. Splunk Observability Cloud dekt infrastructuur, APM, synthetics, real user monitoring, logs en incidentrespons. ITSI/Event Analytics kan opvallende events bundelen tot episodes en noise over monitoring-silo’s heen verminderen.
Splunk’s eigen observability-onderzoek uit 2025 is confronterend: 73% van de ITOps-/engineeringrespondenten rapporteerde outages door genegeerde of onderdrukte alerts, 59% had moeite met te veel losse tools, en 52% worstelde met false alerts.
Beste voor: enterprise- en multi-cloud-teams met strikte compliance-, security-, audit- en log-searchvereisten.
Prijzen: gebruiksgebaseerd en meestal via offerte. Geen eenvoudige gratis productietier.
Setup-snelheid: cloud-onboarding kan sneller zijn, maar enterprise-implementatie duurt vaak dagen tot weken.
Nadelen: Duur op schaal. Complexe inrichting. Overkill voor solo developers en kleine startups.
Postman: het beste voor teams die al API’s testen
Postman is in de eerste plaats een platform voor API-development en -testing, maar het monitoring-product laat teams Postman-collections inplannen en uitvoeren vanaf cloudlocaties. Het sterkste argument is hergebruik: als je QA- of dev-team al Postman-collections met assertions heeft, is het logisch om die om te zetten in monitors.
Beste voor: dev- en QA-teams die Postman-collections al gebruiken en geplande checks willen zonder een aparte synthetic tool te kopen.
Prijzen: er is een gratis tier. Monitoring-overage kost $0,75 per 1.000 calls; extra bundel van 50.000 calls voor $20/maand. Controleer de huidige plan-pagina — de bundels van Postman veranderen regelmatig.
Setup-snelheid: ongeveer 10 minuten als collections al bestaan.
Nadelen: Monitoring is lichter dan bij gespecialiseerde tools zoals Checkly, Datadog of New Relic. De alertopties zijn basis.
Andere API-monitoring tools die het bekijken waard zijn
Gatus: lichtgewicht, self-hosted, configuratie-gedreven health dashboard. 10.906 GitHub-sterren, ondersteunt HTTP, ICMP, TCP, DNS, Prometheus-vriendelijke metrics en uptime-badges. Goed voor solo developers die iets simpelers willen dan Prometheus maar liever YAML/config-as-code gebruiken dan de UI van Uptime Kuma.
Apitally: nieuwer hulpmiddel gericht op API-traffic analytics en kwaliteitsbewaking voor startups. Claimt setup in minder dan 5 minuten met aangepaste alerts over 14 metrics. Sterk voor lichte API-analytics zonder een compleet observability-platform te moeten adopteren.
Sematext: full-stack monitoring met logs, synthetics en infrastructuurzichtbaarheid. Synthetics rond $2 per HTTP-monitor, $7 per browser-monitor, $5 minimale maandafname. Een goedkoper alternatief voor Datadog voor mid-market teams.
Uptrace: OpenTelemetry-native backend voor APM, tracing, metrics en logs. 4.198 GitHub-sterren. Geen pure uptime-checker, maar ideaal voor teams die standaardiseren op OTel en een open-sourcevriendelijke tracing-backend willen.
Build vs. buy: moet je je API-monitoring zelf bouwen?
"Moet ik niet gewoon een script schrijven dat mijn endpoints pingt, of gebruik ik beter een gespecialiseerde tool?"
Deze vraag komt steeds weer terug in ontwikkelaarsforums. Ik heb genoeg Reddit-threads gelezen om het patroon duidelijk te zien: teams beginnen met curl + cron, dat werkt een tijd prima, en daarna stappen ze over zodra ze dashboards, historische data, checks in meerdere regio’s, betrouwbare alert-routing of zichtbaarheid over teams heen nodig hebben.
Een eerlijke beslismatrix:
| Factor | Eigen script | Gespecialiseerde tool |
|---|---|---|
| Setup-tijd | 1–4 uur (basis); dagen (robuust) | 5–30 minuten |
| Onderhoud | Jij blijft er eeuwig verantwoordelijk voor | Provider regelt updates |
| Alertkwaliteit | Basis (up/down) | Slim (latency-trends, anomalies, retries) |
| Kosten | Gratis (je tijd) | $0–$500+/maand |
| Dashboard | Zelf vanaf nul bouwen | Vooraf gebouwd, aanpasbaar |
| Beste wanneer… | ≤3 endpoints, dev-zwaar team, hobbyproject | 5+ endpoints, ops/product-team, omzet staat op het spel |
De belangrijkste les uit forums: mensen die zelf bouwen hebben daar later vaak spijt van zodra ze dashboards, historische data of zichtbaarheid over teams heen nodig hebben. En er is nog een meta-probleem — "je hebt monitoring nodig voor je monitoring". Ook een self-hosted monitor, database, backup, netwerkpad en alert-provider moeten betrouwbaar zijn.
Bouw zelf als je 2 endpoints hebt en graag sleutelt. Koop als je een product moet leveren.
Dezelfde logica geldt voor webdata-extractie. Je kunt een scraper schrijven, headless browsers draaien, proxies roteren, selectors onderhouden, HTML opschonen en een queue bouwen. Maar als het doel is om webdata betrouwbaar aan een API-product, AI-agent of research-workflow te leveren, dan is Thunderbit Open API meestal sneller dan zelf scraping-infrastructuur bouwen.
Alert fatigue: waarom alertkwaliteit belangrijker is dan alertkwantiteit
Dit is misschien wel het meest onderschatte criterium bij het kiezen van een API-monitoring tool. Alert fatigue ontstaat wanneer teams zó veel lawaaierige, dubbele of niet-actiegerichte alerts krijgen dat ze ze allemaal gaan negeren — en vervolgens echte incidenten missen.
De cijfers zijn opvallend. BigPanda’s rapport uit 2025 liet zien dat de mediane organisatie 2.350 alerts per dag en 803.406 alerts per jaar genereerde. De mediane incident-actionability was slechts 18% — minder dan één op de vijf alerts leidde dus tot iets waar je echt iets mee kon. NeuBird’s survey uit 2026 vond dat 77% van de on-call teams minstens 10 alerts per dag krijgt en dat 80% zegt dat de helft of minder van die alerts echt actie oplevert.
De beste monitoring tool is degene waarvan je alerts daadwerkelijk vertrouwt. Een vergelijking van hoe tools met alert-intelligentie omgaan:
| Tool | Alerttype | Methode voor noise reduction | Alertkanalen |
|---|---|---|---|
| Datadog | ML-anomaly, forecast, composite | Historische anomaly-banden, dynamische baselines, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + degradation-based | Retry vóór fire, retries op dezelfde/andere locatie | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI issue grouping, anomaly, predictive | Event-correlation, flapping suppression, root-cause context | Slack, PagerDuty, Teams, webhooks |
| Moesif | Gedrags-anomaly | Dynamische modellen na meerdere dagen gedrag | Slack, PagerDuty, e-mail, sms |
| Better Stack | Uptime/incident/on-call | Escalatiebeleid, ownership-routing, vertragingen | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | PromQL rule alerts | Groepering, deduplicatie, silencing, inhibition | E-mail, PagerDuty, Opsgenie, webhooks |
| Splunk | Events, episodes, service health | ITSI Event Analytics, episode grouping, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Geen alerting-platform | Gebruik met je eigen scheduler, workflowtool of monitoring-stack | Webhooks voor batchjobs; alerts extern afgehandeld |
Praktisch advies: begin met minder alerts, maar wel met hogere betrouwbaarheid. Gebruik retries vóór fire, bevestiging vanuit meerdere regio’s, SLO burn-rate alerts, deduplicatie en routing op ownership. Alarmeer op impact voor de gebruiker en bedrijfskritische flows (checkout failure, auth failure, payment 5xx), niet op elk intern symptoom.
Gratis tiers en prijzen in 2026: wat betaal je echt?
Prijs-pagina’s veranderen. Gratis tiers schuiven. Verborgen kosten (hosts, seats, logs, synthetische runs, data-ingest) kunnen verrassen. Dit is het stuk dat ik op elke "beste tools"-pagina had willen zien. De snapshot voor 2026:
| Tool | Gratis tier | Vanaf | Creditcard vereist? | Beste gratis use-case |
|---|---|---|---|---|
| Thunderbit Open API | 600 eenmalige API-units | ~ $16/maand jaarlijks | Nee | Webdata-extractie voor LLM’s, RAG, pricing en research |
| Uptime Kuma | Onbeperkt (self-host) | — | Nee | Volledige monitoring, eigen server |
| UptimeRobot | 50 monitors, intervallen van 5 min | ~ $7/maand | Nee | Basis uptime-checks |
| Better Stack | 10 monitors, 1 statuspagina | ~ $29/maand | Nee | Startup uptime + statuspagina |
| Checkly | 10 uptime, 10k API checks | ~ $24/maand | Ja | Synthetic API-checks |
| Postman | Gratis account + monitoring allowance | ~ $14/gebruiker/maand | Nee | Bestaande collections hergebruiken |
| Prometheus + Grafana | Onbeperkt (self-host) | — | Nee | Metrics + visualisatie |
| Grafana Cloud | 100k API test-uitvoeringen/maand | $29/maand platform + gebruik | Verifiëren | Beheerde synthetics-proef |
| New Relic | 100 GB/maand, 1 full user | Per gebruiker + data | Voor sommige plannen | APM + basisobservability |
| Datadog | Trial/verschilt per product | $15/host/maand (Infra Pro) | Vaak wel | Full-stack evaluatie |
| Moesif | Gratis/proefversie beschikbaar | Op volume gebaseerd | Verifiëren | Evaluatie van API-analytics |
| Splunk | Trials beschikbaar | Offerte-gebaseerd | Verkoopproces | Enterprise proof of concept |
| Gatus | Onbeperkt (self-host) | — | Nee | YAML-gedreven statusdashboard |
| Apitally | Gratis/proefversie beschikbaar | Verifiëren | Verifiëren | Lichtgewicht API-analytics |
| Sematext | Trial/gratis verschilt | ~ $2/HTTP-monitor | Verifiëren | Goedkopere synthetics/logs |
| Uptrace | Gratis self-hosted | Cloud-tiers verschillen | Verifiëren | OTel APM-evaluatie |
Opmerking over verborgen kosten: self-hosted tools (Uptime Kuma, Prometheus, Gatus) zijn qua licentie "gratis", maar een kleine VM, backups, onderhoudstijd en externe failover kunnen uiteindelijk de echte kosten worden. Bij webdata-API’s zit de verborgen kostenpost meestal elders: headless browsers onderhouden, gebroken selectors, proxy pools, anti-bot-workarounds en HTML-opruiming.
Schatting voor kleine teams: voor 10 API-endpoints en 3 teamleden is het goedkoopste SaaS-pad meestal UptimeRobot gratis of goedkoop betaald, Better Stack gratis/Team, of Checkly als het aantal runs past. Datadog en New Relic kunnen betaalbaar zijn voor evaluatie, maar de echte rekening hangt af van hosts, users, logs, traces en synthetische run-volumes. Als je project website-data als API nodig heeft, zijn de gratis API-units van Thunderbit genoeg om de workflow te testen voordat je op een betaald plan overstapt.
Scorekaart voor setup-complexiteit: hoe snel tot je eerste alert?
Geen enkel vergelijkingsartikel dat ik vond beoordeelt time-to-value — dus hoe lang het duurt van signup tot je eerste zinvolle alert. Voor kleinere teams is dat vaak belangrijker dan feature-diepte.
| Tool | Tijd tot eerste alert | Benodigde technische kennis | Configuratie-aanpak |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minuten | Laag–middel | API-key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minuten | Laag | GUI, klikken om toe te voegen |
| Better Stack | ~5–10 minuten | Laag | GUI-wizard |
| Checkly | ~10–20 minuten | Laag–middel | Code of GUI |
| Postman | ~10 minuten (met collections) | Laag–middel | Collection scheduler |
| Uptime Kuma | ~5–30 minuten | Middel | Docker + GUI |
| Gatus | ~15–45 minuten | Middel | YAML + Docker |
| Datadog | ~15–30 minuten | Middel | Agent-installatie + GUI |
| New Relic | ~15–30 minuten | Middel | Agent + guided setup |
| Moesif | ~20–45 minuten | Middel | SDK/proxy-integratie |
| Grafana Cloud Synthetics | ~15–45 minuten | Middel | GUI, Terraform optioneel |
| Prometheus + Grafana | 1–4 uur | Middel–hoog | YAML, PromQL |
| Uptrace | 30–90 minuten | Middel–hoog | OTel SDK-integratie |
| Splunk | Uren tot weken | Hoog | Enterprise onboarding |
Als monitoring nog dezelfde dag live moet zijn, begin dan in de bovenste helft van die tabel. Als het doel duurzame platform-observability is, plan daar dan een apart project voor. En als je eerste mijlpaal is: "haal schone data van deze 100 webpagina’s naar een app," begin dan met Thunderbit voordat je zelf scraping-infrastructuur bouwt.
Beste API-monitoring tools vergeleken: de volledige zij-aan-zij
Eén tabel om te scannen vóór je beslist:
| Tool | Beste use-case | Gratis tier | Alert-intelligentie | Setup-tijd | Hosting | Opvallende functie |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Webdata-extractie/API-data pipelines | 600 API-units | Geen alerting tool | 5–15 min | Cloud | Zet pagina’s om naar Markdown of extraheer schema-gebaseerde JSON |
| Datadog | Full-stack enterprise/SaaS | Trial/verschilt | Anomaly, forecast, AI | 15–30 min | Cloud | Correlatie tussen synthetics, logs/traces/infra |
| Checkly | Dev-first synthetics | Ruim op checks gebaseerd | Retries, degradation | 10–20 min | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Simpele uptime | 50 monitors | Basisdrempels | 2–5 min | Cloud | Snelste goedkope basismonitor |
| Uptime Kuma | Gratis self-hosted | Onbeperkt | Basis status/drempel | 5–30 min | Self-hosted | Schone UI, geen SaaS-fee |
| Better Stack | Incidentrespons/statuspagina’s | 10 monitors | Escalaties, routing | 5–10 min | Cloud | Monitoring + on-call + statuspagina |
| Prometheus + Grafana | Open-source metrics stack | Onbeperkt (self-host) | Alertmanager grouping | 1–4 uur | Self-hosted/cloud | Diepte van het PromQL-ecosysteem |
| New Relic | SaaS APM + API checks | 100 GB/maand, 1 user | AI grouping, flapping suppression | 15–30 min | Cloud | Sterke APM + synthetics samen |
| Moesif | API analytics/business metrics | Gratis/proefversie | Gedrags-anomalieën | 20–45 min | Cloud | Analytics van API-gedrag per klant |
| Splunk | Enterprise logs/compliance | Trial | ITSI-episodes, AIOps | Dagen+ | Cloud/self-managed | Enterprise log search en governance |
| Postman | Teams die al API’s testen | Gratis account | Basis monitor-alerts | 10 min | Cloud | Hergebruik van API-testcollections |
Hoe Thunderbit je evaluatie van API-tools sneller kan maken
Volledige transparantie: Thunderbit is geen API-monitoring tool — het is een agentic web scraper en Open API om webpagina’s om te zetten naar schone Markdown of gestructureerde JSON. Daardoor is het juist nuttig in een ander deel van het beslissingsproces rond monitoringtools: vendorprijzen, planlimieten, featureclaims, documentatiedetails en integratielijsten verzamelen vóór je een platform kiest.
In plaats van handmatig 10+ prijspagina’s van vendors te openen en plan-namen, monitorlimieten, check-intervallen, integraties en creditcardvereisten in een spreadsheet te zetten, gebruikten we de Thunderbit Chrome Extension om gestructureerde data uit de prijs- en featurepagina’s van elke tool te halen. Thunderbit’s AI leest elke pagina en stelt velden voor — plannaam, gratis-tierdetails, betaalde prijs, ondersteunde integraties — en structureert de output vervolgens naar een exporteerbaar spreadsheet.
Voor developer-workflows geeft Thunderbit Open API je hetzelfde idee programmatisch. Gebruik Distill wanneer je schone Markdown nodig hebt voor LLM’s of RAG. Gebruik Extract wanneer je specifieke velden als JSON terug wilt. Gebruik Batch wanneer je een lijst met prijspagina’s, documentatie-URL’s, productpagina’s of concurrentenpagina’s wilt verwerken en resultaten asynchroon wilt ontvangen.
De workflow:
- Open de prijspagina van een vendor (Datadog, Checkly, UptimeRobot, enz.)
- Klik op "One Click Extract" — Thunderbit’s AI leest de pagina, bepaalt de structuur en vult in één keer een tabel
- Gebruik subpage scraping om elke vendorpagina met prijzen, features en docs te bereiken
- Exporteer naar Google Sheets, Excel, Airtable, Notion of CSV
Voor API-first teams is de API-workflow net zo direct:
- Vraag een gratis API-key aan bij Thunderbit
- Roep het Distill-endpoint aan voor schone Markdown van elke openbare pagina
- Roep het Extract-endpoint aan met schemabeschrijvingen voor gestructureerde JSON
- Gebruik Batch-endpoints en webhooks voor grotere URL-lijsten
- Stuur de output naar je app, spreadsheet, datawarehouse, vector database of monitoring-workflow
Voor een vergelijking over 10+ vendors kan handmatig copy-pasten al snel 2–3 uur kosten, zeker als je prijssubpagina’s, docs en integratiepagina’s meeneemt. Thunderbit verkortte onze eerste extractieronde tot ongeveer 15–30 minuten, waarbij de rest van de tijd naar verificatie en inhoudelijke keuzes ging. Als je operations-, procurement-, research- of AI-productteam onder tijdsdruk tools evalueert, is het een praktische shortcut. Je kunt meer lezen over dit soort workflow in onze gids over web scraping zonder coderen, Thunderbit API-prijzen bekijken of ons YouTube-kanaal openen voor walkthroughs.
Hoe kies je de beste API-monitoring tool voor jouw team?
De "beste" API-monitoring tool hangt af van je teamgrootte, technische diepgang, budget en wat falen betekent voor jouw product.
Een solo developer heeft geen Splunk nodig. Een gereguleerd enterprise-bedrijf moet niet leunen op een cron job. Een API-productteam heeft misschien meer aan Moesif-achtige klantanalytics dan aan simpele uptime-pings. Een e-commerce-team moet kritieke paden prioriteren zoals login, search, add-to-cart, checkout en payment authorization. Een AI- of dataproductteam heeft mogelijk eerst Thunderbit-achtige webdata-extractie nodig voordat het volledige observability nodig heeft.
Drie principes die in al mijn onderzoek overeind bleven:
- Koppel de tool aan je use-case. De snelle keuzetabel staat er niet voor niets — begin daar.
- Geef prioriteit aan alertkwaliteit boven alertkwantiteit. Als je team alerts negeert, heb je geen monitoring. Dan heb je ruis.
- Onderschat setup-snelheid niet. Een monitor die vandaag live gaat en betrouwbare alerts geeft, is beter dan een perfect platformplan dat checkout nog een maand onbewaakt laat.
Als je meerdere tools tegelijk vergelijkt en het onderzoek wilt versnellen, probeer Thunderbit dan voor bulk-extractie van vendor-data naar één spreadsheet. Als je een API-product, RAG-pipeline, AI-agent of market-intelligence workflow bouwt die schone webdata nodig heeft, begin dan met Thunderbit Open API. Het kiest de monitoringtool niet voor je — maar het helpt je wel sneller tot een beslissing te komen, en het kan je eigen product van een betrouwbare webdatalaag voorzien.
Veelgestelde vragen over de beste API-monitoring tools
Wat is de beste gratis API-monitoring tool in 2026?
Voor SaaS-eenvoud biedt UptimeRobot 50 gratis monitors met intervallen van 5 minuten en geen creditcardvereiste. Voor self-hosted controle is Uptime Kuma open-source, onbeperkt en voorzien van een nette UI met meer dan 90 notificatieservices. Voor teams die diepere metrics willen en al technische ervaring hebben, is Prometheus + Grafana + Alertmanager de beste open-source stack — al kost de setup uren in plaats van minuten.
Als je doel niet uptime-monitoring is maar webdata via een API extraheren, heeft Thunderbit Open API een gratis tier met 600 eenmalige API-units, genoeg om page-to-Markdown-distillatie of schema-gebaseerde JSON-extractie te testen voordat je opschaalt.
Wat is het verschil tussen API-monitoring en APM?
API-monitoring controleert endpoint-beschikbaarheid, responstijd, fouten en correctheid van buitenaf — het simuleert wat een gebruiker of integratie ervaart. APM (Application Performance Monitoring) kijkt dieper in de applicatie: code-level traces, database queries, runtime-fouten, queue-latency en afhankelijkheden tussen services. Tools zoals Datadog en New Relic bieden beide; UptimeRobot en Uptime Kuma richten zich op externe uptime-checks.
Thunderbit Open API is anders dan beide: het is een webdata-extractie-API. Het helpt je externe websites om te zetten naar Markdown of gestructureerde JSON, wat handig is voor LLM-apps, research-workflows, pricing intelligence en datapipelines.
Hoe vaak moet ik mijn API’s monitoren?
Productie-API’s die omzet raken (checkout, auth, payments) worden doorgaans elke 1 minuut gecontroleerd. Interne of minder kritieke API’s kunnen vaak elke 5 minuten worden gecheckt. Maar frequentie alleen is niet het hele verhaal — gebruik retries, meerdere regio’s en betekenisvolle assertions zodat elke check zowel snel als betrouwbaar is. Een 1-minuut-check die false alarms geeft, is slechter dan een 5-minuten-check die je kunt vertrouwen.
Voor webdata-extractie hangt de frequentie af van hoe vaak de bron wijzigt. Prijspagina’s hebben mogelijk dagelijkse of wekelijkse extractie nodig. Snel veranderende inventory-, travel- of marketplace-data kan uurlijkse of nog frequentere verversing vereisen. Thunderbit’s batch-API en webhooks zijn handig wanneer je veel URL’s volgens een schema wilt verwerken.
Kan ik API’s monitoren zonder code te schrijven?
Ja. UptimeRobot, Better Stack en Uptime Kuma kun je volledig via GUI’s gebruiken. Checkly ondersteunt zowel GUI- als code-gebaseerde setup. Postman werkt via een collection-gebaseerde interface. Prometheus/Grafana vereist meestal YAML en PromQL. Datadog en New Relic kunnen starten via begeleide setup, maar worden krachtiger met diepere instrumentatie.
Als je website-data wilt extraheren zonder code te schrijven, is Thunderbit’s Chrome Extension de no-code-route. Wil je dezelfde workflow vanuit een applicatie automatiseren, dan biedt Thunderbit Open API ontwikkelaars Distill-, Extract- en Batch-endpoints.
Hoe verminder ik alert fatigue bij API-monitoring?
Kies tools met slimme alerting: anomaly detection (Datadog, New Relic), retry-before-firing (Checkly), behavioral anomalies (Moesif) of grouping/silencing (Prometheus Alertmanager). Begin met minder alerts, maar wel met hogere betrouwbaarheid, en focus op impact voor de gebruiker. Gebruik SLO burn-rate alerts in plaats van statische drempels, dedupliceer over services heen, route op ownership en meet actionability — als minder dan 20% van je alerts tot echte actie leidt, moet je eerst noise verminderen.
Probeer Thunderbit Open API voor webdata-extractie Get Started Free
Meer lezen



