Estrattore Goodreads













Estrai dati da Goodreads in pochi secondi, non in ore
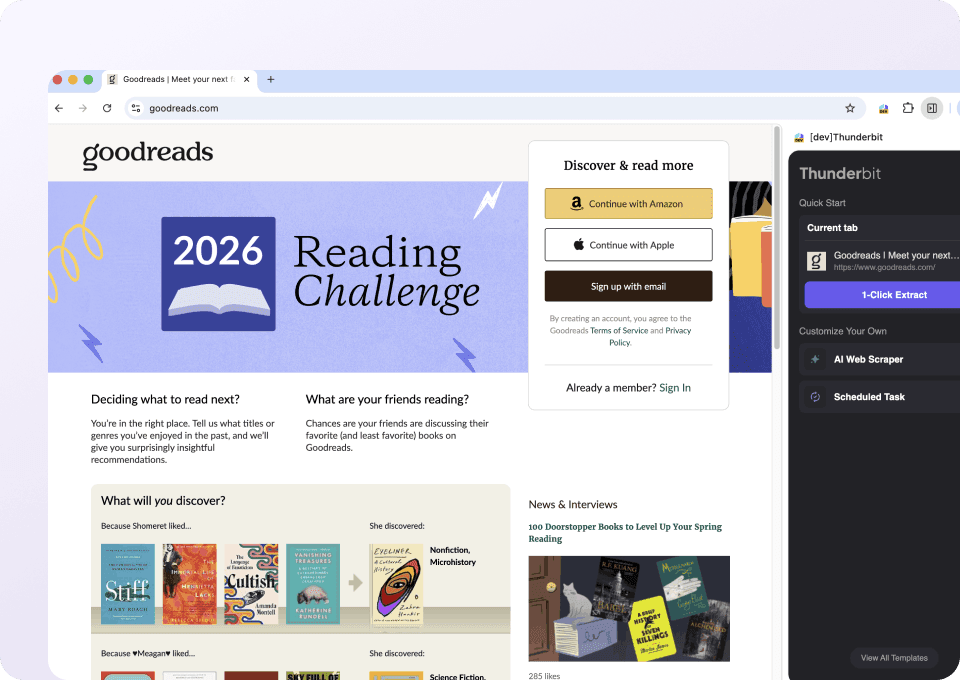
Due clic per estrarre i dati di Goodreads
Stanco di copiare a mano titoli, nomi degli autori, valutazioni e numero di pagine da Goodreads? Thunderbit ti permette di estrarre i dati che ti servono in soli due clic — senza codice e senza configurazioni. Ti basta selezionare i campi desiderati e l’IA li riconosce e li cattura automaticamente.
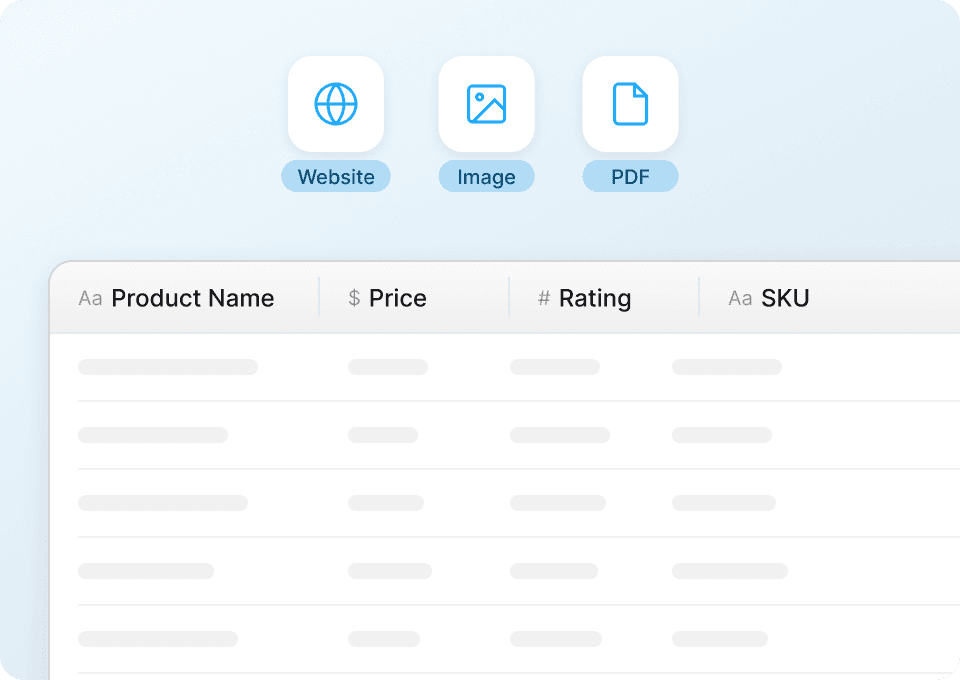
Dati di Goodreads puliti e pronti all’uso
I dati di Goodreads possono essere disordinati e incoerenti. Thunderbit li pulisce e li struttura automaticamente durante l’estrazione — così ottieni un foglio perfettamente formattato con titoli dei libri, autori, valutazioni medie, numero di recensioni e numero di pagine, tutto pronto per l’analisi. Nessuna pulizia manuale richiesta.
Estrai centinaia di pagine di Goodreads
Visitare Goodreads manualmente, una pagina alla volta, è lento e soggetto a errori. Thunderbit gestisce lo scraping in massa in automatico — ti basta fornire un elenco di URL e lui estrae titoli dei libri, autori, valutazioni e altro ancora da centinaia di pagine in una sola volta, in modo rapido e senza interruzioni.
Lo scraping di Goodreads ti sta mettendo in difficoltà?
Scopri come Thunderbit semplifica l’estrazione dei dati da Goodreads.
Scraper tradizionali
Il vecchio modo di fare le coseThunderbit
L’approccio più intelligente


Domande frequenti
Correlati casi d'uso
Esplora altri casi d'uso del web scraper di Thunderbit.
Estrattore Flixster
L'Estrattore Flixster di Thunderbit ti permette di raccogliere dati dalle classifiche box office e dai cinema nelle vicinanze su Flixster. Grazie ai suggerimenti AI per i campi, puoi velocemente ottenere titoli dei film, incassi, valutazioni, date di uscita, nomi dei cinema, indirizzi e film disponibili per analisi o ricerche.
Scopri di più ->
Estrattore olympustaff.com
L’Estrattore Web olympustaff.com di Thunderbit ti permette di raccogliere dati da elenchi di fumetti e commenti su olympustaff.com. Grazie ai suggerimenti intelligenti basati su AI, puoi estrarre rapidamente titoli, autori, date di pubblicazione e feedback dei lettori per analisi o ricerche. Perfetto per marketer, ricercatori e content creator che desiderano dati strutturati da olympustaff.com.
Scopri di più ->
Estrattore Hatena
L'Estrattore Hatena di Thunderbit ti permette di raccogliere dati da blog e liste di argomenti su Hatena grazie ai suggerimenti intelligenti dei campi basati su AI. Puoi ottenere titoli dei blog, nomi degli autori, date di pubblicazione, riassunti dei contenuti e argomenti di tendenza, utili per ricerche, marketing o analisi dei contenuti. Perfetto per marketer, ricercatori e content creator che desiderano dati strutturati da Hatena.
Scopri di più ->
Estrattore namu.wiki
L'Estrattore Web namu.wiki di Thunderbit ti permette di raccogliere dati da namu.wiki, comprese le pagine richieste e le discussioni più recenti. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle pagine, URL, date dell’ultima modifica, argomenti delle discussioni e nomi dei partecipanti, ideali per ricerche, creazione di contenuti o analisi delle community.
Scopri di più ->
Estrattore NetEase Music
L'Estrattore NetEase Music di Thunderbit ti permette di raccogliere dati dai risultati di ricerca e dalle pagine degli artisti su NetEase Music. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle canzoni, nomi degli artisti, dettagli sugli album, durate e URL dei brani per analisi o ricerche. Perfetto per analisti musicali, marketer e appassionati che desiderano dati strutturati da NetEase Music.
Scopri di più ->
Estrattore QQ Music
L’Estrattore QQ Music di Thunderbit ti permette di raccogliere dati dai risultati di ricerca e dalle liste delle opere degli artisti su QQ Music. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle canzoni, nomi degli artisti, dettagli sugli album, date di pubblicazione e molto altro, perfetto per analisi o ricerche. Ideale per analisti musicali, marketer e appassionati che desiderano dati strutturati da QQ Music.
Scopri di più ->Pronto a dare una spinta all'estrazione dati?
Unisciti a oltre 200.000 professionisti che già usano Thunderbit per automatizzare i loro flussi di web scraping.
La prova gratuita offre crediti illimitati per 8 pagine web.



