Il traffico bot automatizzato oggi rappresenta oltre il 53% di tutto il traffico web—più di quanto generino gli esseri umani. Se fai scraping di dati, gestisci account o verifichi annunci in più regioni, ti muovi dentro un contesto in cui i sistemi anti-bot sono fatti apposta per intercettarti.
Eppure, la maggior parte delle guide su "proxy statici vs proxy rotanti" riduce tutto a una tabella con due colonne e finisce lì. Salta il terzo concetto (le sticky session), ignora i meccanismi reali di rilevamento e non fa mai i conti dei costi su larga scala. Ho dedicato molto tempo a studiare provider di proxy e API di scraping AI per il lavoro che facciamo in Thunderbit, e la realtà è molto più complessa—e più interessante—di quanto facciano credere i soliti articoli elenco. Questa guida spiega la vera distinzione a tre vie che molti articoli sbagliano, come i sistemi anti-bot rilevano davvero il traffico proxy, quanto costa gestire 50K pagine al giorno con diversi tipi di proxy e 9 strumenti che prenderei seriamente in considerazione. Alcuni sono provider di proxy puri, altri sono API di scraping, e uno (il nostro) elimina del tutto la gestione dei proxy.
Prova Thunderbit per lo scraping AI
Proxy statici, rotanti e sticky: la distinzione a tre che molte guide ignorano
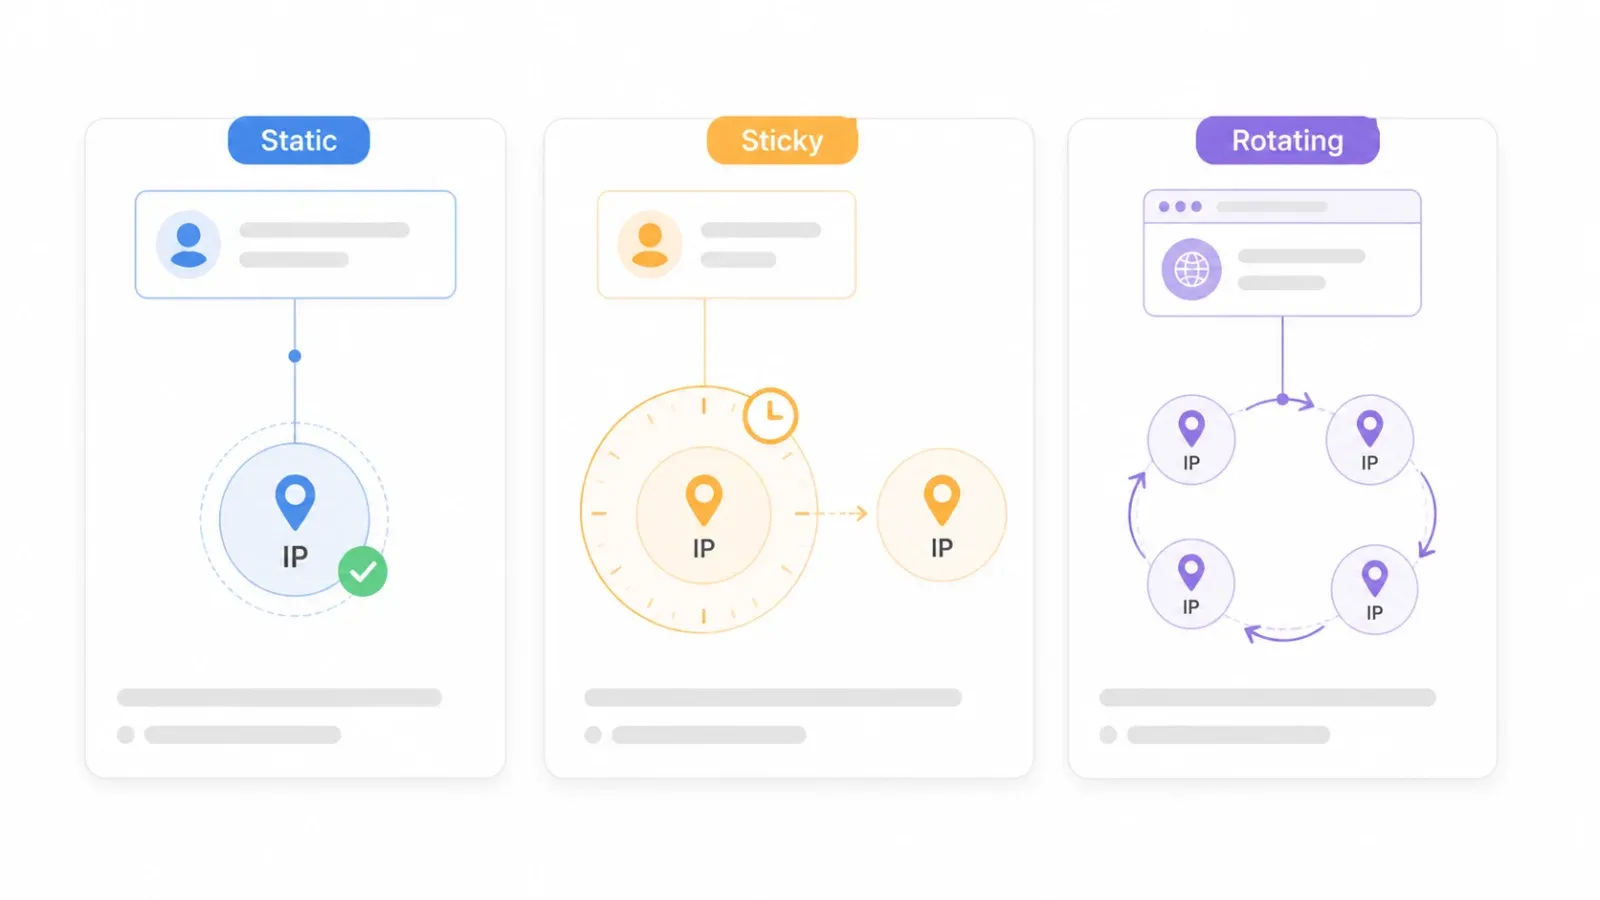
La maggior parte degli articoli di confronto tra proxy li tratta come una scelta binaria: statici o rotanti. È un’impostazione incompleta, che porta a decisioni d’acquisto sbagliate. In realtà esistono tre comportamenti distinti dei proxy, e servono a scopi diversi.
Proxy statico: lo stesso indirizzo IP, senza limiti di tempo, finché non lo cambi manualmente o scade il leasing. Pensalo come la tua connessione di casa: stesso indirizzo ogni giorno. Utile quando una piattaforma si aspetta di vedere la stessa identità nel tempo (gestione account, contenuti geo-bloccati, monitoraggio posizionamenti).
Sticky session: lo stesso IP per una finestra di tempo configurabile—magari 10 minuti, magari 30, magari fino a 24 ore a seconda del provider—poi passa a uno nuovo. Una sticky session dà continuità temporanea; un proxy statico dà continuità permanente. Decodo (ex Smartproxy) descrive le sticky session come un IP mantenuto per 1, 10, 30, 60 minuti, o intervalli personalizzati fino a 24 ore.
Proxy rotante: un IP nuovo a ogni richiesta, oppure ogni pochi secondi. Massima anonimizzazione per lavori ad alto volume, ma nessuna continuità di sessione, a meno di aggiungere sopra una sticky session.
La distinzione in forma di tabella:
| Attributo | Proxy statico | Sticky session | Proxy rotante |
|---|---|---|---|
| L’IP cambia? | Mai (stesso IP senza limiti di tempo) | Dopo una durata impostata (es. 10–30 min) | A ogni richiesta o ogni pochi secondi |
| Persistenza della sessione | Permanente | Temporanea (TTL configurabile) | Nessuna |
| Caso d’uso tipico | Gestione account, contenuti geo-bloccati | Scraping multi-step (login → navigazione → estrazione) | Scraping ad alto volume, verifica annunci |
| Rischio di rilevamento | Più alto nel tempo (lo stesso fingerprint accumula storico) | Moderato | Più basso per il rilevamento basato su IP (se residenziale) |
| Modello di costo | Di solito per IP/mese | Incluso nei piani residenziali/mobile fatturati a GB | Per GB, per richiesta o tariffa fissa |
Perché è importante nella scelta dello strumento? Se devi fare login su una piattaforma, aggiungere articoli a un carrello o compilare un form in più passaggi, ti serve una sticky session—not una rotazione pura (che romperebbe la sessione) e non necessariamente un IP statico permanente (che sarebbe eccessivo e costoso). Gli utenti dei forum su r/proxies confondono spesso queste categorie, chiedendo se le sticky session si comportino come i “normali proxy residenziali rotanti” o come gli IP statici. La risposta: nessuno dei due. Sono una terza cosa.
Come i sistemi anti-bot rilevano davvero i proxy statici e rotanti
Ogni articolo di confronto tra proxy cita il “rischio di rilevamento” in una cella di tabella. Quasi nessuno spiega come avvenga davvero il rilevamento. Questo conta, perché il metodo di detection determina se ruotare gli IP serve davvero.
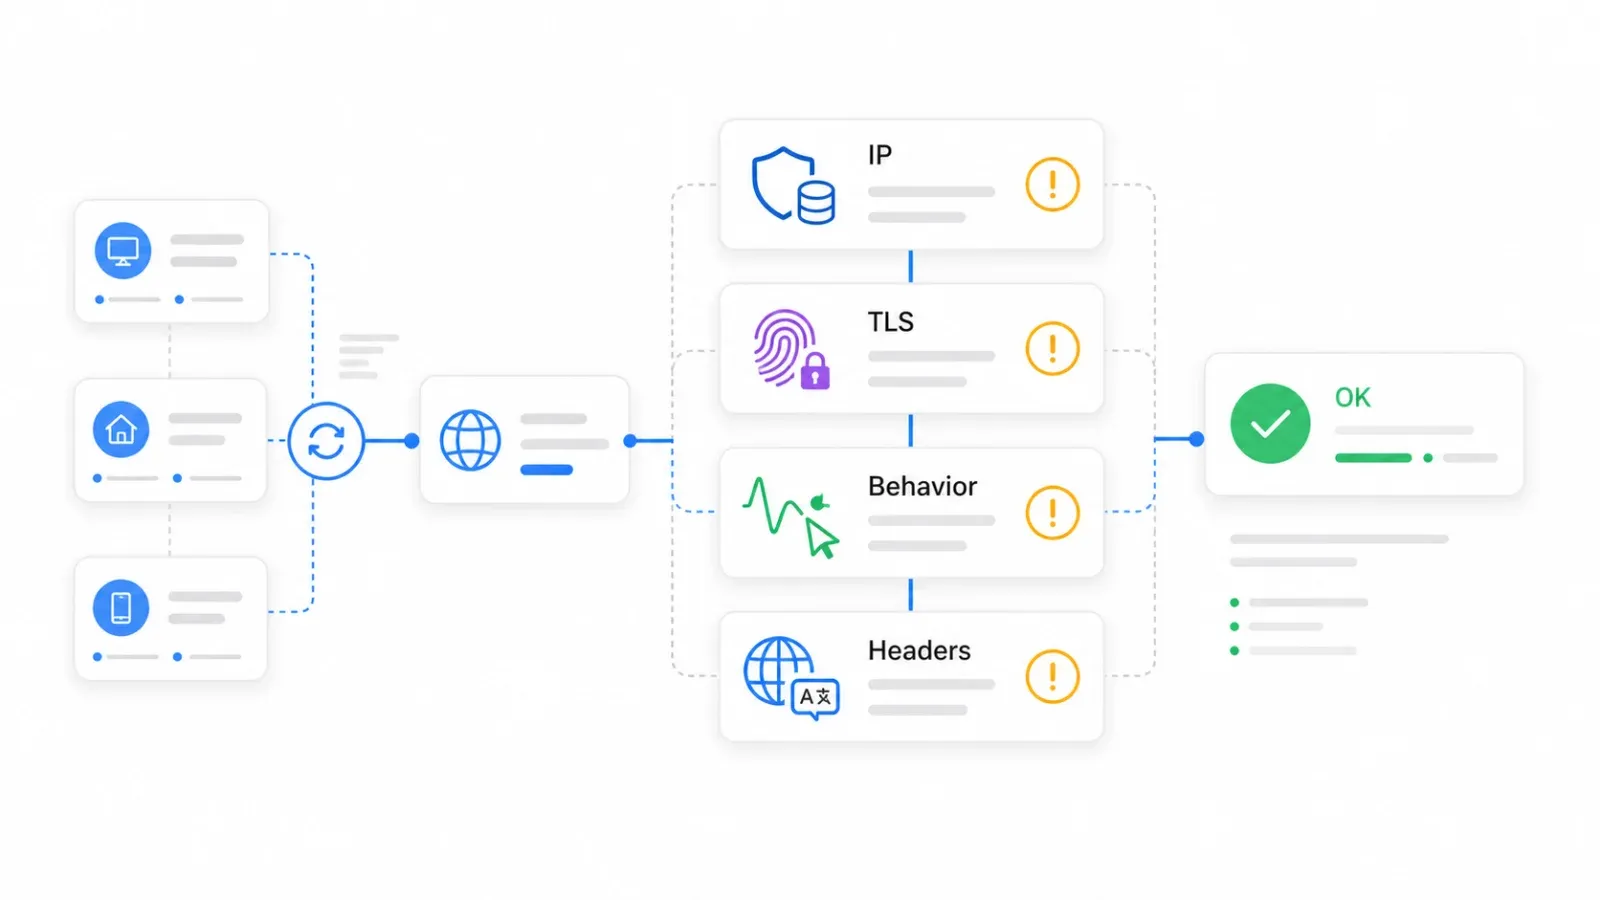
I moderni sistemi anti-bot usano almeno quattro livelli, e cambiare IP ne affronta solo uno.
Livello 1: database di reputazione IP
Gli intervalli IP dei datacenter provengono da ASN di cloud e hosting—Amazon, Google, DigitalOcean, ecc. I vendor anti-bot mantengono database che pre-etichettano questi intervalli. Gli IP residenziali e mobili partono con una fiducia maggiore perché sembrano traffico di utenti normali. La documentazione bot di Cloudflare usa un punteggio bot da 1 a 99, dove i valori bassi indicano con più probabilità automazione. Se il tuo IP proviene da un noto range datacenter, parti con un punteggio di fiducia basso ancora prima di fare una sola richiesta.
Livello 2: fingerprinting TLS/JA3/JA4
È il livello che la maggior parte di chi compra proxy non conosce. Quando il client avvia una connessione HTTPS, l’handshake TLS rivela caratteristiche del software che fa la richiesta. La documentazione JA3/JA4 di Cloudflare spiega che questi fingerprint identificano i client TLS in base alle caratteristiche della connessione e funzionano come identificatori stabili attraverso diversi IP di destinazione. In parole semplici: se la tua richiesta dice di essere Chrome su macOS ma l’handshake TLS sembra provenire dalla libreria Python requests, ruotare l’IP non risolve la discrepanza. Il fingerprint ti segue.
Livello 3: segnali comportamentali
La frequenza delle richieste, l’ordine di navigazione, i movimenti del mouse (o la loro assenza), i pattern di login e il modo in cui le sessioni evolvono rispetto alla navigazione umana. La documentazione di DataDome sul rilevamento descrive modelli comportamentali che segnalano schemi anomali come troppi tentativi di login o velocità di navigazione disumane. Uno studio arXiv del 2026 sugli agenti di browsing AI ha rilevato che i fingerprint comportamentali erano più discriminanti dei fingerprint del browser nel distinguere gli agenti AI dagli esseri umani.
Livello 4: coerenza di header e ambiente
Uno studio accademico di misurazione del 2026 su 10.000 siti ha trovato che il 75% dei blocchi basati solo su Chromium headless era causato unicamente da segnali a livello di header. Se il tuo header Accept-Language dice en-US ma il tuo IP viene geolocalizzato a São Paulo, quella incongruenza è un segnale. Se lo user agent non coincide con il fingerprint TLS, è un altro segnale.
La conclusione: gli IP rotanti riducono i rate limit basati sull’IP e l’accumulo di reputazione. Ma non risolvono mismatch del fingerprint TLS, anomalie comportamentali o incoerenze negli header. È esattamente per questo che gli strumenti di scraping API-first—che gestiscono rendering, coerenza del fingerprint e superamento dei CAPTCHA a livello di infrastruttura—sono diventati un’alternativa pratica alla gestione manuale di tutti e quattro i livelli.
Salta la gestione dei proxy con lo scraping AI Get Started Free
Il vero costo dei proxy statici e rotanti su larga scala
Il prezzo è la parte che molte guide sui proxy saltano o liquidano con un generico “economico”. Ma modello di fatturazione + peso delle pagine + tasso di blocco cambiano in modo drastico il costo totale.
L'HTTP Archive Web Almanac 2025 riporta che la homepage mediana pesa 2,86 MB su desktop. Se renderizzi pagine complete tramite un proxy residenziale a consumo per 50.000 pagine al giorno, parliamo di circa 143 GB/giorno, cioè circa 4,29 TB/mese. Con bandwidth residenziale rotante a $5–$15/GB, arrivi a $21.450–$64.350/mese prima di retry e richieste bloccate.
È una cifra che sorprende quasi tutti la prima volta che la vedono.
Ed è anche il motivo per cui gli scraper esperti bloccano immagini, font, video e script non necessari nei browser headless—una ottimizzazione concreta che può ridurre la banda del 60–80%. Anche con questa riduzione, resti comunque nell’ordine di 858 GB–1,72 TB/mese, che ai prezzi residenziali significa $4.290–$25.740/mese.
Gli scraping via HTTP diretto o a livello API sono molto più leggeri. Una stima pratica indica richieste HTTP dirette da 50–200 KB per pagina, contro 1,5–8 MB per il rendering headless completo. A 200 KB/pagina, 50K pagine/giorno sono solo circa 300 GB/mese.
| Tipo di proxy | Modello di fatturazione | Fascia di costo tipica | Costo stimato per 50K pagine/giorno (rendering completo) | Note |
|---|---|---|---|---|
| Datacenter (statico) | Per IP/mese | ~$0,50–$2/IP | Basso (tariffa fissa, senza contatore GB) | Alto rischio di blocco su target protetti |
| ISP / residenziale statico | Per IP o per GB | ~$3–$8/GB | Medio-alto | Ideale per continuità + target più difficili |
| Residenziale rotante | Per GB | ~$5–$15/GB | Molto alto, salvo ottimizzazione della banda | Lo standard d’oro per l’anonimato; i costi esplodono con il volume |
| Datacenter rotante | Per richiesta o per GB | ~$0,50–$3/GB | Basso-moderato | Utile per target permissivi |
| AI Scraping API (es. Thunderbit) | Per richiesta / crediti | Variabile in base al piano | Prevedibile (nessun contatore banda) | Restituisce dati strutturati, non HTML grezzo |
È esattamente per questo che gli utenti dei forum chiedono dei proxy ISP statici ruotati manualmente come alternativa più economica alla banda residenziale a consumo. Il trade-off tra anonimato e costo è reale, e la risposta giusta dipende dalla sofisticazione anti-bot del target e dal tuo volume.
Scegli il tipo di proxy in meno di 60 secondi
Zero dei sei articoli competitor in cima alla SERP include un flowchart decisionale. Ecco la logica come albero decisionale passo per passo:
-
Ti serve lo stesso IP per sessioni lunghe? → Sì → Proxy statico (ISP/residenziale statico per target difficili, datacenter per quelli più semplici)
-
No → stai facendo scraping di 10K+ pagine? → Sì → Proxy rotante (residenziale per target difficili, datacenter per quelli permissivi)
-
Ti serve persistenza di sessione per attività multi-step (login, carrello, form)? → Sì → Sticky session (residenziale, con TTL configurabile)
-
Vuoi eliminare del tutto la gestione dei proxy? → Sì → AI scraping API (es. Thunderbit API/MCP)
La stessa logica in formato tabellare:
| La tua situazione | Approccio migliore |
|---|---|
| Serve accesso IP grezzo (gestione account, geo-test) | Proxy statici o rotanti gestiti in autonomia |
| Estrarre dati strutturati da siti pesanti in JS | AI scraping API (es. Thunderbit /extract) |
| Crawling ad alto volume per RAG/indexing | AI distill API (es. Thunderbit /distill) + batch |
| Scraping multi-step con login | Proxy browser con sticky session |
| Budget limitato, target poco protetti | Proxy datacenter (più economici) |
La maggior parte dei lettori rientra in uno di questi cinque gruppi. Capisci quale prima di scorrere alla lista degli strumenti.
Cosa abbiamo valutato in questi 9 strumenti
Ogni strumento in questa lista è stato valutato in base a sette criteri:
- Tipi di proxy offerti: copre statici, rotanti, ISP, residenziali, mobili—oppure astrae completamente il layer proxy?
- Dimensione del pool IP: pool più grandi significano qualità di rotazione migliore e minore rischio di riuso. Ma i numeri sui pool sono dichiarazioni di marketing, non dati verificati in modo indipendente.
- Modello di prezzo: per IP, per GB, per richiesta, tariffa fissa o crediti. Il modello di fatturazione conta quanto il prezzo unitario.
- Gestione anti-bot / detection: superamento CAPTCHA integrato, gestione fingerprint o nulla oltre alla diversità IP.
- Supporto sticky session: TTL configurabile, durata massima, affidabilità.
- Miglior caso d’uso: scraping, gestione account, SEO, verifica annunci—ogni strumento ha il suo punto forte.
- Facilità di integrazione: qualità API, disponibilità SDK, usabilità dashboard, opzioni no-code, supporto MCP/CLI.
La lista parte da Thunderbit (il nostro approccio via AI scraping API) e poi copre nove provider di proxy in un ordine approssimativamente decrescente per scala e profondità funzionale.
1. Thunderbit: salta la gestione dei proxy con un’AI Scraping API
Thunderbit non è un provider di proxy. È la scelta giusta quando capisci che i proxy sono solo un mezzo per arrivare a un fine—e che ciò che ti serve davvero sono dati strutturati.
Abbiamo costruito Thunderbit come una AI scraping API che gestisce proxy, misure anti-bot, CAPTCHA e rendering JavaScript a livello di infrastruttura. Tu descrivi quali dati vuoi; ottieni in risposta un output pulito e strutturato. Nessuna configurazione di pool proxy, nessuna logica di rotazione, nessun fingerprint spoofing.
Per sviluppatori (il caso d’uso principale):
- API aperta:
POST /distillconverte una pagina in Markdown pulito.POST /extractprende uno schema JSON e restituisce campi strutturati. Entrambe supportano opzionirenderModee job batch (fino a 100 URL in asincrono con webhook). - Server MCP: Claude, Cursor e altri agenti AI possono chiamare
thunderbit_extractethunderbit_distilldurante l’attività. Il layer proxy resta invisibile: l’agente riceve semplicemente i dati. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>per terminale, CI e workflow cron. Il batch supporta fino a 100 URL per distill / 50 per extract. - Prezzi a crediti: Distill = 1 credito/URL. Extract = 20 crediti/URL. Nessun contatore di banda per GB. Il piano Starter parte da $15/mese con 500 crediti.
Per utenti non tecnici, l'estensione Chrome offre scraping in 2 click con AI Suggest Fields, esportazione in Excel, Google Sheets, Airtable o Notion. Nessuna configurazione proxy necessaria: lo scraping cloud di Thunderbit gestisce rotazione IP e rendering.
Ideale per: estrazione di dati strutturati da siti pesanti in JS, pipeline RAG/indexing, workflow con agenti AI e chi preferisce dedicare tempo all’analisi invece che all’infrastruttura proxy.
Limiti: non è un provider di proxy grezzo. Se ti serve accesso IP diretto per gestione account, geo-testing o sneaker bot, un proxy tradizionale è lo strumento migliore.
Prezzo: piano gratuito disponibile; Starter da circa $15/mese. Consulta la pagina prezzi di Thunderbit per i piani aggiornati.
Per approfondire come funziona lo scraping web AI sotto il cofano, leggi la nostra guida su AI web scraping.
2. Bright Data: il più grande pool IP per proxy statici e rotanti

Bright Data è una delle suite proxy più storiche e complete sul mercato. Il dato principale che evidenziano è oltre 400M di IP residenziali rotanti in 195 paesi, con targeting a livello di città/stato/CAP/ASN, più oltre 1,3M di proxy ISP statici.
- Tipi di proxy: residenziali (rotanti), ISP/residenziali statici, datacenter (statici e rotanti), mobili
- Pool IP: 400M+ residenziali, 1,3M+ ISP—il pool pubblico dichiarato più grande
- Gestione anti-bot: prodotto Web Unlocker con superamento CAPTCHA e gestione fingerprint; Browser API per rendering headless
- Sticky session: sì, configurabili (tipicamente 10–30 min per i residenziali)
Prezzi: residenziali PAYG standard a $8/GB, con tariffe promozionali intorno a $4/GB per impegni più grandi. Datacenter da circa $0,90/IP. ISP da circa $1,30/IP. La struttura è flessibile ma può diventare costosa molto rapidamente su larga scala.
Ideale per: aziende che hanno bisogno di enorme diversità IP, geo-targeting preciso e una suite completa di prodotti. Team con budget e competenze tecniche per gestire una dashboard complessa.
Svantaggi: la dashboard richiede un po’ di apprendimento. I prezzi possono essere alti per i team più piccoli—se fai scraping di 50K pagine/giorno tramite proxy residenziali, il conto banda sale in fretta. Le recensioni online citano spesso la complessità dei prezzi.
3. Oxylabs: proxy premium rotanti e statici per scraping su larga scala
Oxylabs è un altro provider enterprise-grade con forte focus sull’infrastruttura per web scraping. Offre residential, static residential/ISP, datacenter, mobile, Web Unblocker e prodotti Scraper API.
- Tipi di proxy: residenziali (rotanti), ISP/residenziali statici, datacenter (statici e rotanti), mobili
- Pool IP: ampio pool enterprise (il numero preciso varia a seconda del prodotto)
- Gestione anti-bot: Web Unblocker e Scraper API con rendering e supporto CAPTCHA
- Sticky session: la durata standard delle sessioni residenziali è 10 minuti, con altre configurazioni disponibili; alcune impostazioni supportano fino a 24 ore
Prezzi: residenziali da $6/GB all’ingresso, con discesa a $3,50/GB a 1TB di volume. Proxy ISP prezzati per IP/mese. Posizionamento premium.
Ideale per: grandi aziende con esigenze importanti di raccolta dati, team che desiderano soluzioni di scraping gestite insieme all’accesso ai proxy grezzi.
Svantaggi: fascia di prezzo più alta rispetto alle alternative mid-market. Può essere eccessivo per progetti di piccola o media scala.
4. Smartproxy (Decodo): proxy rotanti convenienti e facili da configurare
Smartproxy, ora rebrandizzato come Decodo, è un provider mid-market molto popolare, noto per i prezzi competitivi e la dashboard facile da usare. Molti cercano ancora “Smartproxy”, quindi compaiono entrambi i nomi.
- Tipi di proxy: residenziali (rotanti), ISP/residenziali statici, datacenter, mobili
- Pool IP: oltre 115M IP residenziali
- Gestione anti-bot: disponibili prodotti Site Unblocker e scraping API
- Sticky session: 1, 10, 30, 60 minuti o intervalli personalizzati fino a 24 ore su residenziali, datacenter, ISP e mobile
Prezzi: residenziali da $2/GB sulla soglia dei 3GB, con riduzioni all’aumentare del volume. Static residential/ISP da circa $3,33/IP nella fascia più bassa. Competitivi per il set di funzionalità.
Ideale per: team piccoli e medi che cercano un buon equilibrio tra prezzo e funzionalità, chi acquista proxy per la prima volta e vuole un onboarding semplice.
Svantaggi: pool IP più piccolo rispetto a Bright Data o Oxylabs. Alcuni utenti segnalano velocità non sempre costanti a seconda del target e del pool.
5. IPRoyal: proxy statici e rotanti accessibili con prezzi flessibili
IPRoyal si è ritagliato uno spazio come opzione economica con un plus particolare: traffico residenziale senza scadenza. Compri banda, la usi quando vuoi.
- Tipi di proxy: residenziali (rotanti), ISP/residenziali statici, datacenter, mobili, sneaker proxy
- Pool IP: in crescita; la dimensione esatta varia a seconda della fonte
- Gestione anti-bot: di base—si affida alla qualità IP più che a superamento CAPTCHA o gestione fingerprint integrate
- Sticky session: fino a 7 giorni per i residenziali
Prezzi: residenziali da $7/GB, con sconto fino a $1,75/GB per acquisti bulk. Il modello senza scadenza evita di perdere banda inutilizzata a fine mese.
Ideale per: utenti attenti al budget, utilizzi variabili o stagionali, sneaker ed ecommerce.
Svantaggi: pool IP più piccolo rispetto ai provider premium. Funzionalità anti-detection integrate limitate. Meno adatto a target fortemente protetti.
6. SOAX: proxy rotanti geolocalizzati con filtri granulari
SOAX è particolarmente forte quando serve un targeting iper-locale. Il loro filtro arriva fino a paese, regione, città, ISP e ASN—utile per la verifica annunci e la market research quando la precisione geografica conta davvero.
- Tipi di proxy: residenziali (rotanti), ISP/statici, datacenter, mobili
- Pool IP: oltre 155M IP in più di 195 location
- Gestione anti-bot: pool IP puliti con bassi tassi di ban; disponibile Web Data API
- Sticky session: sì, con frequenze di refresh personalizzabili; supporto protocolli HTTP(S), SOCKS5, UDP e QUIC
Prezzi: piano Business a $4,00/GB con 800GB inclusi ($3.200/mese). Le tariffe enterprise partono da $0,32/GB per accordi custom ad alto volume.
Ideale per: team di market research che hanno bisogno di dati iper-locali, verifica annunci in aree geografiche e ISP specifici.
Svantaggi: può sembrare complesso per casi d’uso semplici. La durata massima delle sticky session varia a seconda del prodotto—verifica prima di impegnarti.
7. ScraperAPI: proxy rotanti integrati in una API pensata prima per lo scraping
ScraperAPI non è un provider di proxy tradizionale. Come Thunderbit, astrae il layer proxy—ma restituisce HTML grezzo invece di dati strutturati. Invia un URL e ricevi HTML renderizzato. ScraperAPI gestisce dietro le quinte selezione dei proxy, rotazione, retry e anti-bot.
- Come funziona: endpoint API singolo; aggiungi l’URL di destinazione e ScraperAPI gestisce tutto
- Gestione anti-bot: superamento CAPTCHA integrato, rendering JS e geo-targeting
- Sticky session: non applicabile in senso tradizionale—l’API gestisce internamente le sessioni
Prezzi: 1.000 crediti API gratuiti/mese. Pagina standard = 1 credito. Amazon = 5 crediti. Google/Bing = 25 crediti. LinkedIn = 30 crediti. I siti dietro Cloudflare/DataDome/PerimeterX aggiungono 10 crediti per richiesta. Piani a pagamento da circa $49/mese per 100K crediti.
Ideale per: sviluppatori che vogliono evitare l’infrastruttura proxy e ottenere semplicemente HTML. Scraping di piccola o media scala.
Svantaggi: restituisce HTML grezzo—devi comunque parsarlo e strutturarlo tu. Può diventare costoso ad altissimo volume a causa dei moltiplicatori di crediti sui siti protetti. Confronto con Thunderbit: ScraperAPI ti dà HTML; /extract di Thunderbit ti restituisce JSON strutturato e allineato allo schema.
8. Webshare: proxy datacenter e rotanti essenziali a basso costo
Webshare è l’opzione senza fronzoli. Proxy datacenter molto economici, un piano gratuito con 10 proxy e strumenti semplici orientati agli sviluppatori. (Webshare è stato acquisito da Oxylabs nel 2024, e questo potrebbe influire sulla direzione futura del prodotto.)
- Tipi di proxy: datacenter (statici e rotanti), residenziali (rotanti), ISP
- Pool IP: oltre 80M residenziali dichiarati, ampia flotta datacenter
- Gestione anti-bot: minima—nessun CAPTCHA integrato; si basa sulla diversità IP
- Sticky session: sì, per i proxy residenziali
Prezzi: residenziali rotanti da $1,40/GB. Residenziali statici da $0,23/IP. Piano gratuito con 10 proxy. Tra le opzioni più economiche disponibili.
Ideale per: sviluppatori con budget ristretto, strumenti interni, scraping di siti poco protetti, prototipazione.
Svantaggi: gli IP datacenter vengono spesso bloccati dai grandi siti. Anti-detection limitata. La qualità del pool residenziale varia.
9. Storm Proxies: proxy rotanti semplici con prezzo flat
Storm Proxies è uno dei pochi provider che offre piani proxy rotanti flat-rate con banda illimitata. Il modello di prezzo è semplice: paghi per porta proxy al mese e usi quanta banda vuoi.
- Tipi di proxy: residenziali rotanti, datacenter rotanti, datacenter statici dedicati
- Pool IP: la pagina ufficiale dichiara oltre 20M di reverse backconnect proxy residenziali; recensioni di terze parti suggeriscono che il pool effettivo sia più piccolo
- Gestione anti-bot: minima—nessun CAPTCHA o fingerprint management integrato
- Sticky session: rotazione a ogni richiesta, oppure ogni 3 o 15 minuti
Prezzi: tariffa mensile flat basata sul numero di porte proxy. Fonti terze descrivono piani come 5 porte residenziali per circa $50/mese con banda illimitata. Verifica la pagina di checkout prima dell’acquisto.
Ideale per: chi vuole costi mensili prevedibili senza contatore banda. Scraping leggero o moderato dove la prevedibilità dei costi conta più della dimensione del pool.
Svantaggi: pool IP effettivo molto piccolo (alto rischio di riuso). Geo-targeting limitato. Dashboard datata. Non adatto a siti fortemente protetti.
Proxy statici vs proxy rotanti: confronto strumenti affiancato
| Strumento | Tipi di proxy / API | Dimensione approssimativa del pool | Modello di prezzo | Gestione anti-bot | Supporto sticky session | Caso d’uso migliore |
|---|---|---|---|---|---|---|
| Thunderbit | AI scraping API, MCP, CLI, estensione Chrome | Batch fino a 100 URL | Crediti (Distill 1/URL, Extract 20/URL) | Completa: rendering, anti-bot, CAPTCHA | N/D (gestita) | Estrazione di dati strutturati, RAG, agenti AI |
| Bright Data | Residenziali, ISP, datacenter, mobile | 400M+ residenziali, 1,3M+ ISP | Per GB + per IP + per richiesta | Web Unlocker, Browser API | Sì (10–30 min) | Scala enterprise, geo-targeting |
| Oxylabs | Residenziali, ISP, datacenter, mobile | Ampio pool enterprise | Residential da $6 a $3,50/GB | Web Unblocker, Scraper API | Sì (10 min standard, configurabile) | Scraping enterprise, soluzioni gestite |
| Smartproxy/Decodo | Residenziali, ISP, datacenter, mobile | 115M+ residenziali | Residenziali circa $3,75/GB; ISP circa $3,33/IP | Site Unblocker | Sì (1–60 min, fino a 24h) | Mid-market, primi acquisti |
| IPRoyal | Residenziali, ISP, datacenter, mobile, sneaker | Pool in crescita | Residenziali $7→$1,75/GB, senza scadenza | Base (qualità IP) | Sì (fino a 7 giorni) | Utenti budget, uso stagionale |
| SOAX | Residenziali, ISP, datacenter, mobile | 155M+, 195+ location | Business $4/GB; enterprise $0,32/GB | Pool puliti, Web Data API | Sì (refresh personalizzato) | Targeting iper-locale, market research |
| ScraperAPI | Scraping API con rotazione proxy | A livello di servizio (non pool grezzo) | Per credito; standard 1, Amazon 5, Google 25 | CAPTCHA, rendering, geo integrati | Gestita internamente | Sviluppatori che vogliono HTML grezzo |
| Webshare | Datacenter, residenziali, ISP | 80M+ residenziali | Residenziali rotanti $1,40/GB; statici $0,23/IP | Minima | Sì (residenziali) | Sviluppatori budget, prototipazione |
| Storm Proxies | Residenziali rotanti/datacenter, DC statici | 20M+ dichiarati | Mensile flat per porta, banda illimitata | Minima | Ogni richiesta / 3 / 15 min | Costi prevedibili, scraping leggero |
NetNut è stato rimosso da questo confronto: ad agosto 2026, netnut.io mostra un avviso di sequestro federale statunitense al posto del sito prodotto.
Gli strumenti si dividono in tre gruppi. Infrastruttura proxy grezza (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) ti dà accesso agli IP e poi devi gestire tutto il resto. Scraping API (ScraperAPI) astrae il layer proxy ma restituisce ancora HTML grezzo. API di estrazione AI (Thunderbit) astrae sia il layer proxy sia il parsing, restituendo direttamente dati strutturati.
Quando i proxy non sono la risposta: AI scraping API vs proxy gestiti in autonomia
Questa è la parte che nessun articolo competitor copre: la maggior parte delle persone che legge di “proxy statici vs proxy rotanti” non è appassionata di proxy. Sta cercando di estrarre dati, e i proxy sono solo un mezzo per arrivare a un risultato.
Per molti casi d’uso, gestire pool di proxy, logiche di rotazione, fingerprint spoofing e superamento CAPTCHA è un overhead che uno strumento API-first elimina del tutto. Ma non sempre. Ecco quando ha senso ciascun approccio:
I proxy gestiti in autonomia hanno senso quando ti serve accesso IP grezzo per gestione account, geo-testing o sneaker bot; controllo fine su ASN, carrier o comportamento dell’exit IP; oppure uno stack browser/proxy personalizzato che il tuo team mantiene già.
L’estrazione API-first ha senso quando ti serve dato strutturato (elenchi prodotti, contatti, prezzi) invece di HTML grezzo, Markdown pulito per pipeline RAG, workflow con agenti AI in cui l’accesso al web durante l’attività deve restare invisibile, o semplicemente meno tempo sull’infrastruttura proxy e più tempo sui dati.
L’API di Thunderbit gestisce rendering, anti-bot e CAPTCHA lato server. Gli sviluppatori ottengono Markdown pulito (/distill) o JSON allineato allo schema (/extract) senza configurare pool proxy o coerenza del fingerprint. Il server MCP permette a Claude o Cursor di fare scraping a metà task tramite thunderbit_extract—il layer proxy è davvero invisibile.
Per una panoramica più ampia su web scraping senza codice, abbiamo trattato l’argomento a parte.
Qual è lo strumento proxy statico o rotante giusto per te?
Raccomandazioni specifiche per scenario, perché “dipende” è corretto ma poco utile:
- Migliore per enterprise che richiedono pool IP enormi: Bright Data, Oxylabs
- Migliore per team attenti al budget: IPRoyal, Webshare, Storm Proxies
- Migliore per una configurazione mid-market semplice: Smartproxy/Decodo, SOAX
- Migliore per evitare del tutto la gestione dei proxy: Thunderbit (dati strutturati), ScraperAPI (HTML grezzo)
- Migliore per workflow con agenti AI e MCP: Thunderbit
I sistemi anti-bot continuano a diventare più intelligenti—con layering di reputazione IP, fingerprinting TLS, analisi comportamentale e coerenza degli header—e il costo della gestione autonoma dei proxy cresce di pari passo. Per i team il cui obiettivo finale è ottenere dati web puliti e strutturati, gli strumenti API-first che astraono l’intero layer proxy stanno diventando sempre più la scelta pratica.
Questo cambiamento non è teorico. Sta già accadendo.
Se vuoi vedere come funziona nella pratica, l'estensione Chrome di Thunderbit è un buon punto di partenza per gli utenti non tecnici, mentre la documentazione API copre il flusso per sviluppatori. Per avere più contesto sul panorama degli strumenti di scraping, dai un’occhiata al nostro confronto dei migliori AI web scraper. Puoi anche guardare le guide sul canale YouTube di Thunderbit.
Prova Thunderbit AI Web Scraper Get Started Free
FAQ
1. Quando dovrei usare proxy statici invece di proxy rotanti?
Usa proxy statici quando ti serve un IP coerente tra sessioni—gestione account, accesso a contenuti geo-bloccati, monitoraggio posizionamenti o qualunque piattaforma che consideri sospetti i cambi di IP. Se il target si aspetta di vedere la stessa identità nel tempo, lo statico è la scelta giusta. Per target difficili, gli IP ISP/static residential sono più sicuri dei datacenter.
2. Qual è la differenza tra una sticky session e un proxy statico?
Una sticky session mantiene lo stesso IP per una finestra temporale configurabile (es. 10 minuti, 30 minuti, fino a 24 ore a seconda del provider), poi passa a un altro. Un proxy statico mantiene lo stesso IP senza limiti di tempo, finché non lo sostituisci manualmente. Non sono la stessa cosa, anche se alcuni documenti dei provider usano i termini in modo intercambiabile.
3. Perché i proxy rotanti vengono comunque bloccati su alcuni siti?
Perché i moderni sistemi anti-bot usano una rilevazione multilivello che va oltre il semplice indirizzo IP. Il fingerprinting TLS/JA3, l’analisi comportamentale (pattern di richiesta, percorsi di navigazione) e i controlli di coerenza degli header possono segnalare traffico automatizzato indipendentemente dalla rotazione IP. Gli IP rotanti riducono i rate limit basati sull’IP, ma non risolvono questi altri livelli di detection.
4. Quanto costano i proxy residenziali rotanti su larga scala?
I prezzi pubblici self-serve vanno circa da $1,40/GB (Webshare) a $8/GB nel PAYG standard (Bright Data), con sconti enterprise disponibili. Con rendering a pagina intera (50K pagine/giorno a circa 2,86 MB/pagina), la sola banda può superare i 4 TB/mese—potenzialmente per decine di migliaia di dollari. Le API a crediti o per richiesta (come Thunderbit o ScraperAPI) offrono prezzi più prevedibili senza contatori di banda.
5. Una AI scraping API può sostituire del tutto i proxy?
Per l’estrazione di dati strutturati e lo scraping web, spesso sì. Strumenti come Thunderbit gestiscono rotazione proxy, misure anti-bot, superamento CAPTCHA e rendering JS a livello di infrastruttura—tu ricevi i dati puliti senza gestire l’infrastruttura proxy. Per casi d’uso che richiedono accesso IP grezzo (gestione account, geo-testing, sneaker bot), i proxy tradizionali restano necessari.
Scopri di più



