
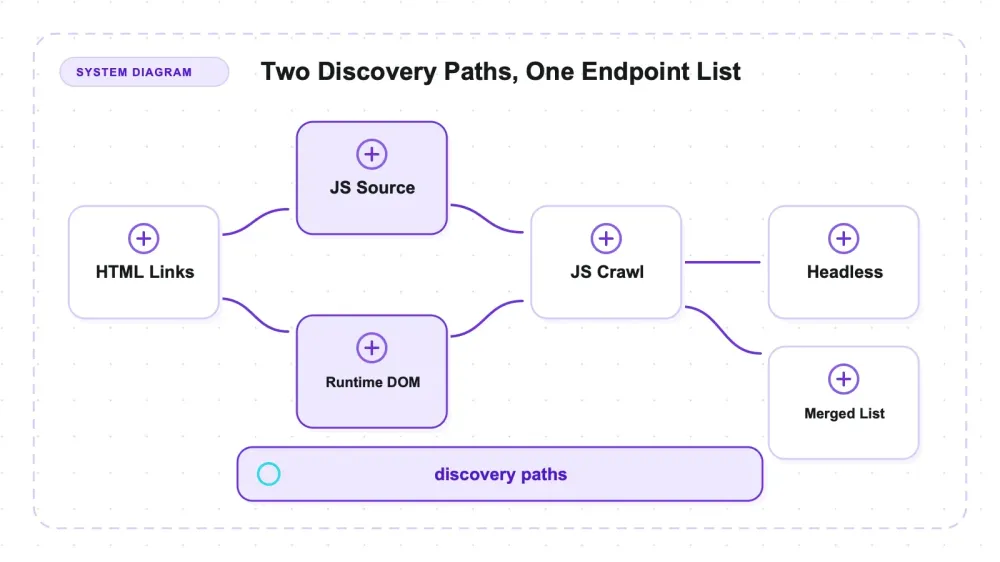
Katana adalah crawler discovery endpoint dari ProjectDiscovery — binary Go berlisensi MIT yang menerima sebuah target lalu mengembalikan URL dan endpoint untuk diproses oleh tool berikutnya dalam pipeline. Katana bisa jalan dalam mode HTTP tanpa browser, atau dengan -headless yang mengendalikan Chromium. Panduan resmi menempatkan mode headless sebagai opsi dengan cakupan lebih luas; contoh ini menunjukkan bahwa jenis endpoint sama pentingnya dengan jumlah endpoint yang ditemukan.
Saya membangun sebuah situs kecil dengan tiga kelas endpoint yang sengaja dibuat berbeda, lalu mengukur mode mana yang menemukan masing-masing endpoint pada v1.6.1 dengan -d 4. HTML biasa berhasil menjangkau 4/4 link dan rantai tiga lompatan penuh di semua empat konfigurasi. Perbedaannya muncul pada endpoint yang diekspos lewat source JavaScript versus perubahan DOM saat runtime.
Pada fixture ini, headless menemukan kelas runtime-DOM yang terlewat oleh mode tanpa browser yang diuji, sementara mode standar dengan -jc menemukan literal di file JavaScript yang terlewat oleh kedua mode headless. Tidak ada satu pun baris di matriks empat perintah yang mencakup kedua kelas sekaligus. Scope, resume, dan perilaku known-files menjadi batas praktis lainnya.
Apa sebenarnya Katana itu
Crawler katana — projectdiscovery/katana di GitHub — ditulis dengan Go dan berlisensi MIT. Saya menguji v1.6.1 pada 27 Juli 2026; versinya penting karena temuan cakupan dan known-files di bawah ini merupakan hasil observasi spesifik build.
Label kategorinya lebih penting dari biasanya di sini. Endpoint-discovery crawler bukan alat ekstraksi field. Jika yang Anda cari adalah go web crawler yang menyerahkan nama produk dan harga sebagai JSON terstruktur, Katana berada di rak yang salah sama sekali — dia akan dengan senang hati memberi tahu bahwa /products/1138 ada, tetapi tidak akan mengatakan apa pun tentang isi halaman itu. Memang begitu desainnya, jadi menilainya sebagai alat ekstraksi sama seperti menilai metal detector dari kemampuannya menaksir nilai perhiasan.
Wilayah alaminya adalah recon keamanan ofensif dan pipeline automasi: masuk STDIN, keluar URL, lalu teruskan ke tool berikutnya. Karena itu, satu peringatan penting langsung perlu ditegaskan — semua pengukuran di sini dijalankan terhadap fixture di 127.0.0.1 yang saya tulis sendiri. Jalankan Katana hanya pada host yang Anda miliki atau yang Anda punya otorisasi tertulis untuk diuji, dan tidak untuk yang lain. Ini bukan soal menghindari pertahanan siapa pun; ini soal seberapa banyak permukaan endpoint sebuah situs yang benar-benar diinventarisasi oleh sebuah perintah.
Tiga mode, dan apa yang masing-masing bisa lihat
Mode standar adalah HTTP client Go. Ia mengambil halaman, mem-parsing HTML, mengikuti href, dan tidak pernah menyalakan browser. Cepat, murah, tetapi buta terhadap apa pun yang hanya ada setelah JavaScript berjalan.
-jc (-js-crawl) menambahkan parser JavaScript ke jalur tanpa browser tersebut. Ia mengunduh file .js yang ditautkan dan menarik string literal yang bentuknya seperti URL dari source. Tidak dieksekusi, hanya dibaca. Ada juga -jsl (jsluice), yang dijelaskan di README sebagai parser yang lebih berat dan lebih boros memori — saya tidak mengujinya, jadi saya tidak bisa menyimpulkan apakah itu mengubah hasil cakupan.
-headless menjalankan Chromium dan mengeksekusi script halaman. Pada fixture ini, itulah satu-satunya mode Katana yang berhasil memulihkan path yang disusun dari fragmen dan disisipkan ke DOM saat runtime. Hasil itu tidak membuktikan apa yang mungkin dipulihkan oleh parser lain atau mode Katana di masa depan.
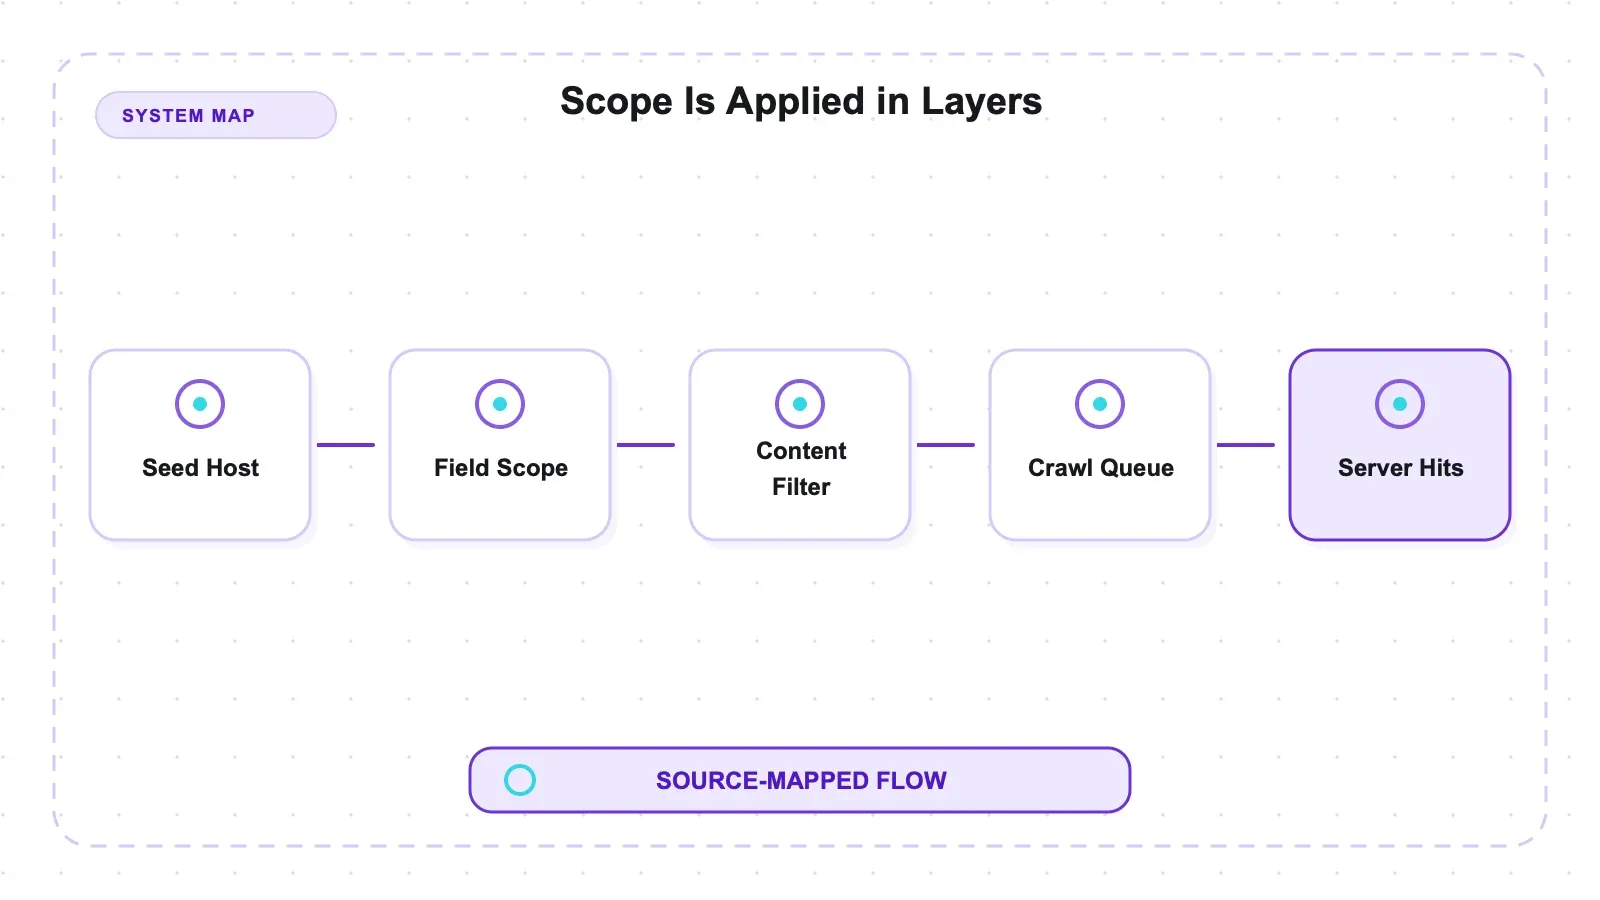
Lalu ada model scope, dan inilah bagian yang sebaiknya dipahami sebelum mengetik apa pun ke lingkungan produksi.
| Flag | Fungsinya | Nilai / default |
|---|---|---|
-fs (field scope) | host mana yang termasuk dalam cakupan | dn, rdn, fqdn, atau regex khusus — default-nya rdn |
-cs dan -cos | regex URL yang memfilter di dalam field scope tersebut | — |
-kf | known files: robots.txt dan sitemap.xml | README menyebutkan perlu kedalaman minimum 3 |
-d | kedalaman | default 3 |
-resume | melanjutkan crawl yang terputus | — |
Urutannya bukan sekadar kosmetik: urutan itu menentukan apakah regex host memperluas crawl atau diam-diam malah mengosongkannya.
Setup: satu binary, satu pengecualian kecil
Ada tiga cara instalasi, dan hanya satu yang butuh toolchain:
| Jalur instalasi | Prasyarat |
|---|---|
Dari source: go install github.com/projectdiscovery/katana/cmd/katana@latest | Go 1.25 atau lebih baru adalah syarat yang disebutkan |
| Binary precompiled di halaman rilis | tidak perlu toolchain |
| Image Docker | tidak perlu toolchain |
Milik saya terpasang di ~/go/bin/katana dan menampilkan Current version: v1.6.1 pada setiap run. Sejauh ini, kisah Go yang menyenangkan seperti biasa: satu file, tanpa runtime tambahan.
Pengecualian kecilnya ada di headless, di mana browser menjadi prasyarat terpisah dari binary:
Tempat -headless dijalankan | Yang dibutuhkan |
|---|---|
| Mesin saya | katana otomatis mendeteksi Chromium yang sudah terinstal; saya tidak mencatat build browser atau memberikan path browser |
| Server kosong, menurut instruksi Ubuntu resmi proyek | apt install google-chrome-stable sebelum headless bisa bekerja |
| Jalur Docker | menjalankan headless dengan -system-chrome |
Di server kosong, kenyamanan itu hilang. Begitu -headless masuk ke command line, Anda perlu menganggarkan browser, bukan hanya binary.
Satu hal kecil lain yang perlu diketahui bila Anda menjalankannya di CI: Katana melakukan panggilan cek versi ke GitHub saat startup. -duc mematikannya. Di laptop itu cuma noise; di runner yang terisolasi jaringan atau dibatasi rate, itu adalah round trip jaringan per run yang tidak Anda minta. Run pengukuran saya memakai -duc supaya angka yang dihasilkan benar-benar mengukur crawling, bukan telepon pulang.
Cara saya mengujinya
Tiga kelas endpoint, dipilih khusus karena memisahkan mode-mode tersebut. Semuanya berada di fixture server lokal, dan ground truth ditulis sebelum crawl apa pun dijalankan, jadi recall diukur terhadap set tetap, bukan terhadap apa pun yang kebetulan dicetak Katana.
- Kelas A — HTML biasa.
/page/a,/page/b,/page/c, plus rantai tiga lompatan/depth/1 → /depth/2 → /depth/3. Setiap crawler seharusnya bisa mendapatkannya. - Kelas B — literal di file JavaScript.
/api/js-endpoint-7dan/api/js-endpoint-8hanya ada sebagai string literal di/static/app.jsyang ditautkan. Bisa dibaca tanpa browser, jika ada yang mau membaca JS-nya. - Kelas C — hanya muncul saat runtime-DOM. Satu path disusun saat runtime dari fragmen (
'endpoint' + (6 * 7)) dan disisipkan ke DOM oleh script. String/runtime-only/endpoint42tidak pernah muncul utuh dalam byte apa pun yang dikirim server — tidak di HTML, tidak juga di source JS. Hanya eksekusi yang mengungkapkannya.
Ditambah robots.txt, sitemap.xml yang memuat dua endpoint <loc> yang tidak muncul di tempat lain, satu route yang mengembalikan 500, satu dead link, dan satu link di luar scope yang mengarah ke server kedua pada hostname berbeda.
Instrumen sama pentingnya dengan fixture: server menghitung apa yang benar-benar di-fetch, jadi klaim scope dan resume bertumpu pada hit truth, bukan pada stdout Katana sendiri. Run mentahnya ada di repo benchmark jika Anda ingin memeriksa perhitungan saya.
Perbedaan cakupan yang tak pernah dihitung orang
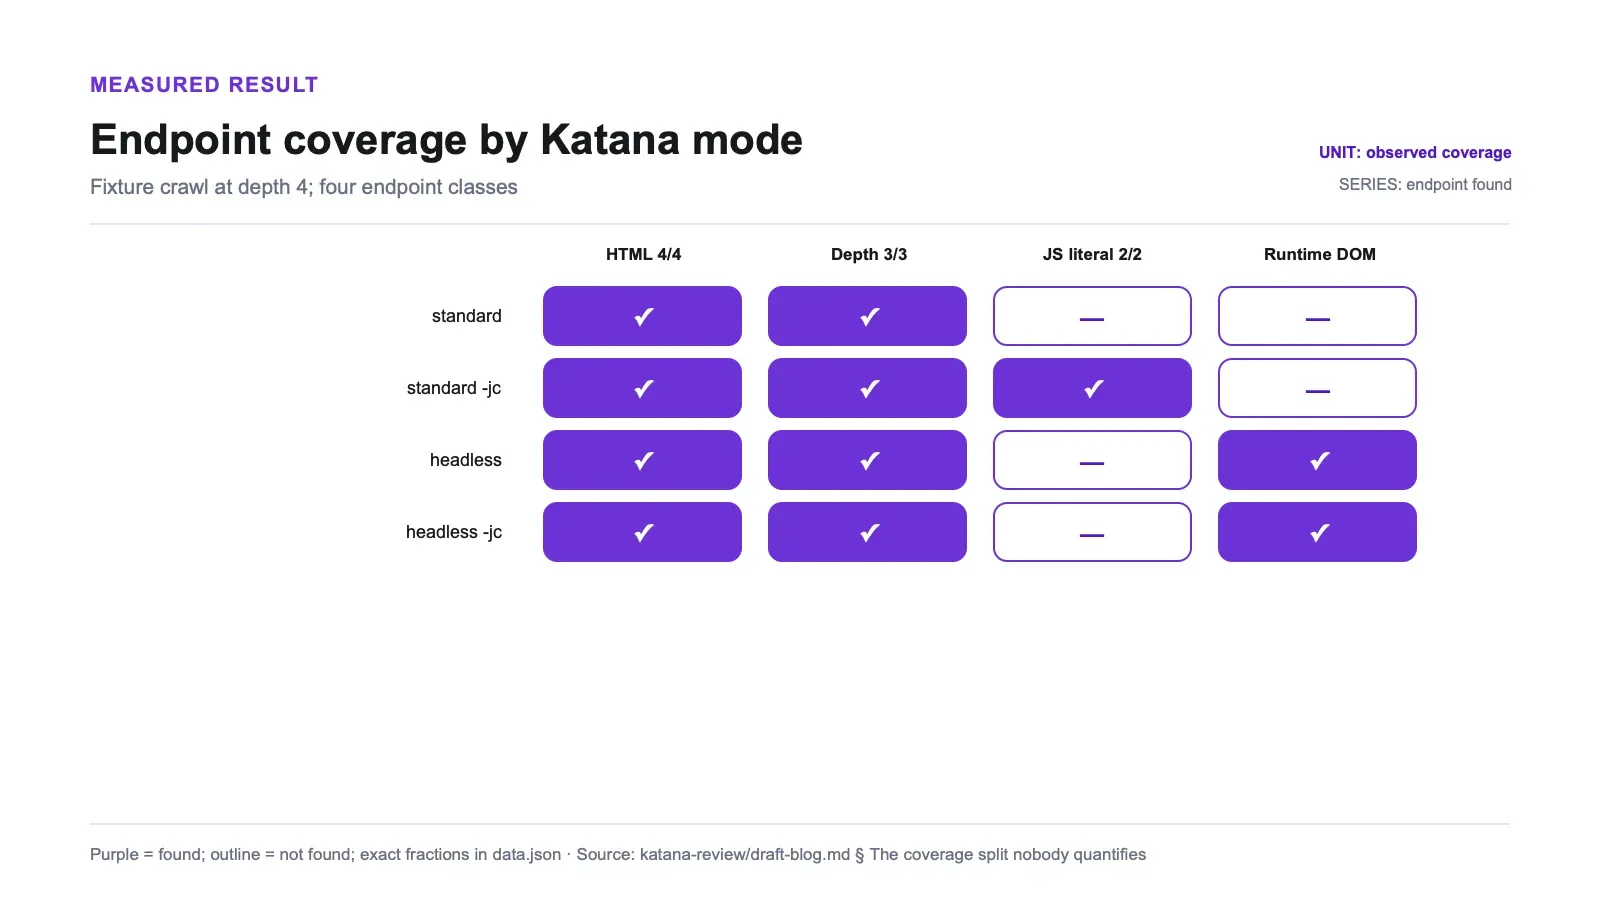
Matriks per mode dan per kelas endpoint, pada -d 4:
| Mode | HTML links (A) | Depth chain (A) | JS-file literals (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | not found |
standard -jc | 4/4 | 3/3 | 2/2 | not found |
-headless | 4/4 | 3/3 | 0/2 | found |
-headless -jc | 4/4 | 3/3 | 0/2 | found |
Baca dua kolom terakhir sebagai pasangan, dan masalahnya langsung terlihat. Kelas B hanya ditemukan oleh satu konfigurasi: mode standar dengan -jc. Kelas C hanya ditemukan oleh dua konfigurasi: kedua run headless. Tidak ada baris yang mendapatkan hit di kedua kolom. Matriks lengkapnya ada di discovery-summary.json, di mana field terhitung headless_jc_covers_both bernilai false.
Konsekuensi praktisnya: “cukup pakai headless untuk cakupan lebih baik” ternyata belum lengkap untuk tes ini. Headless tidak menambahkan kelas B di atas hasil standar; ia memulihkan kelas C tetapi melewatkan kelas B. Untuk mencakup semua kelas yang ditanam di fixture ini, dibutuhkan dua crawl dan satu proses merge:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
Baris -headless -jc adalah yang paling ingin saya dapatkan jawaban upstream-nya. Menambahkan parser JavaScript ke run headless tidak menambah apa pun — tetap 0/2 pada kelas B, di setiap run, termasuk reproduksi ulang yang baru. Saya melaporkan perilakunya, bukan mengklaim sudah menelusuri mekanismenya; saya tidak menginstrumentasi internal Katana untuk mencari tahu mengapa jalur browser berhenti menyumbang literal file JS. Perlakukan ini sebagai observasi yang dapat direproduksi dan sebagai kandidat issue GitHub yang bagus, bukan diagnosis. (Perlu dicatat juga: kombinasi -hl -jc selesai dengan return code 0 pada v1.6.1 di macOS ARM, sesuatu yang secara historis tidak selalu benar.)
Docs resmi menggambarkan headless sebagai pemberi cakupan yang lebih baik, dan memang begitu untuk kelas yang dirender saat runtime di sini. Panduan yang diperiksa tidak menjelaskan pemisahan source-literal/runtime-DOM ini, jadi perlakukan matriks ini sebagai alasan untuk menguji kedua jalur terhadap kelas endpoint Anda sendiri, bukan sebagai taksonomi universal.
Biaya headless dalam waktu nyata
Tiga run berurutan per mode pada mesin yang tidak sibuk:
| Mode | p50 | min–max | mean |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
Itu rasio 5,1x, dengan rentang yang sama sekali tidak tumpang tindih — run standar paling lambat saya (13.17s) masih mengalahkan run headless tercepat saya (66.78s) lebih dari 53 detik (cost-summary.json). Ini bukan noise pengukuran.
Satu catatan untuk angka 13 detik itu: fixture saya sengaja menyertakan route 500 dan dead link, dan mode standar menunggu retry tail default -timeout 10 pada keduanya. Saya tidak menyetel timeout untuk membuat mode cepat terlihat lebih baik, yang berarti run standar yang di-tuning kemungkinan justru akan memperlebar selisih, bukan menyempitkannya.
Rasio ini adalah sinyal kapasitas lokal, bukan ramalan produksi. Target nyata berbeda dalam latensi, kegagalan, kerja script, dan penjadwalan, sementara fixture ini juga menyertakan tail timeout default. Gunakan perbedaan 5,1x yang terukur untuk memutuskan apakah headless layak mendapat anggaran dan subset target sendiri, lalu benchmark rencana itu pada host yang representatif dan terotorisasi.
Scope terjaga, tetapi satu flag diam-diam tidak melakukan apa-apa
Tes scope memakai dua server: server utama di 127.0.0.1, dan server kedua yang dapat diakses sebagai localhost pada port berbeda, melayani path yang hanya ada di sana. Jadi, adanya hit pada path tersebut membuktikan bahwa host di luar scope benar-benar di-fetch, bukan sekadar dicetak.
| Konfigurasi | Host di luar scope di-fetch? | Hit pada server kedua |
|---|---|---|
default (-fs rdn) | tidak | 0 |
-fs fqdn | tidak | 0 |
-cs localhost | tidak | 0 |
| `-fs '(127.0.0.1 | localhost)'` | ya |
Disiplin scope adalah kabar baik: secara default Katana tetap di tempat, dan perlu tindakan eksplisit untuk memperluasnya. Itu default yang tepat untuk tool yang diarahkan ke infrastruktur milik orang lain.
Baris yang menarik adalah -cs localhost. Perintah itu tidak memperluas crawl ke host kedua — dan juga menghasilkan nol URL sama sekali. Karena -cs memfilter di dalam field scope, dan field scope masih host utama, regex tersebut tidak cocok apa pun sehingga crawl mengembalikan set kosong alih-alih error. Jika Anda pernah menulis regex scope crawl yang menyebut host yang ingin dimasukkan lalu mendapati file output kosong, mekanismenya memang seperti itu (scope-summary.json). Untuk menambahkan host, set -fs. Untuk mempersempit di antara host yang sudah ada, gunakan -cs/-cos.
Resume lebih kasar daripada yang disiratkan flag
README menjelaskan flag ini sebagai -resume string resume scan using resume.cfg, yang terdengar seperti file yang jatuh di direktori kerja Anda. Ternyata tidak. Di mesin saya, checkpoint ditulis ke ~/.config/katana/resume-<xid>.cfg — diukur, bukan dibaca dari halaman docs, karena docs tidak menyebutkan path.
Isi file itulah kejutan yang lebih penting. File itu menyimpan map InFlightUrls yang isinya tepat satu hal: seed URL. Bukan set yang sudah dikunjungi, bukan frontier. Jadi inilah yang terjadi saat saya menghentikan crawl dengan SIGINT setelah tiga detik lalu melanjutkannya:
| Run | Path unik |
|---|---|
| Baseline crawl penuh | 11 |
| Di-fetch sebelum interrupt | 10 |
| Di-fetch ulang oleh run resume | semua 11, termasuk semua 10 yang sudah selesai |
Resume memang mencapai set endpoint akhir yang sama, jadi tidak ada yang rusak. Tetapi granularitas checkpoint adalah per seed input, bukan per URL — filter dedupe di memori tidak pernah dipersistkan, jadi resume untuk crawl satu seed akan meng-crawl ulang seed itu dari nol (resume-summary.json). Jika Anda memberi Katana daftar 500 host, resume seharusnya menghemat host yang sudah selesai sepenuhnya; perilaku multi-seed itu mengikuti cara state disimpan, tetapi saya hanya mengukur kasus satu seed. Kalau Anda sedang mendalami satu situs yang sangat besar, resume memberi Anda kebenaran hasil, bukan penghematan waktu.
Known files: diminta, lalu dijatuhkan
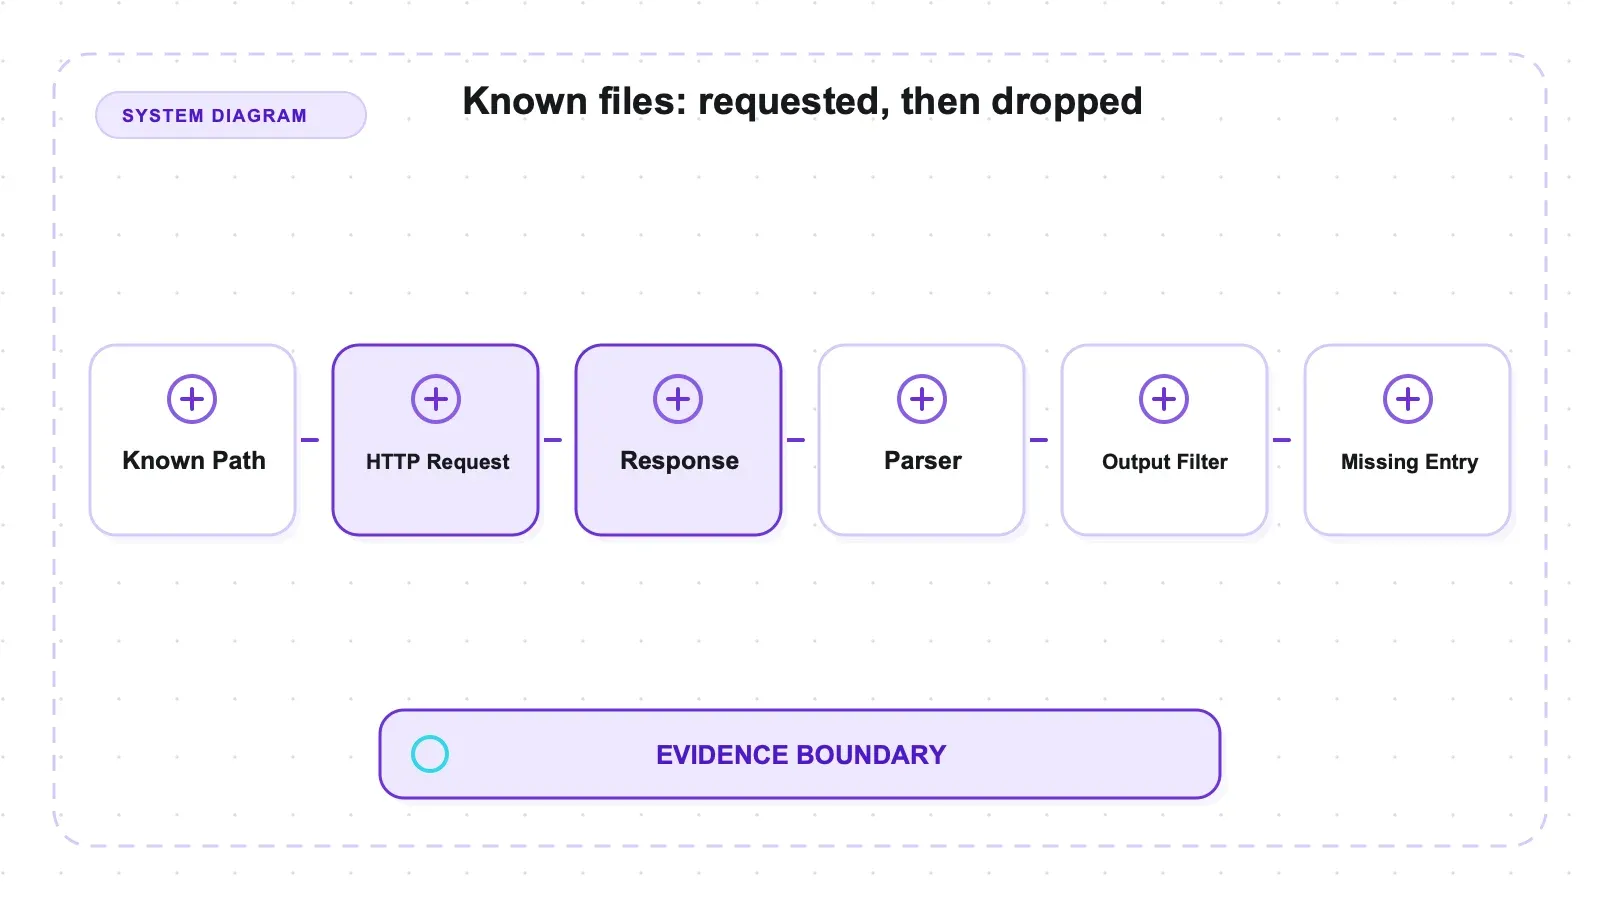
-kf all -d 3 memang meminta kedua file — robots.txt dan sitemap.xml muncul di log hit server — tetapi kemudian memulihkan 0 dari 2 endpoint yang tercantum di elemen <loc> sitemap itu. Recall 0,0.
Sebelum menyebutnya sebagai keterbatasan, saya mencoba membuatnya jadi kesalahan saya sendiri. Setiap variasi memberi hasil yang sama:
| Variasi yang dicoba | Endpoint <loc> sitemap yang dipulihkan |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| depth 3 | 0/2, recall 0.0 |
| depth 4 | 0/2, recall 0.0 |
| depth 5 | 0/2, recall 0.0 |
dengan -jc ditambahkan | 0/2, recall 0.0 |
di-seed langsung ke /sitemap.xml | 0/2, recall 0.0 |
Syarat yang didokumentasikan — gunakan -kf, dan setidaknya tiga tingkat kedalaman — terpenuhi setiap kali. Ini bukan cerita tentang flag yang hilang.
Keputusan yang berguna ada di depan: pada fixture IP-literal ini, jangan berasumsi bahwa meminta known files berarti URL <loc>-nya ikut menjadi bagian crawl. Verifikasi recall-nya, atau ekstrak dan seed URL tersebut sendiri.
Alur kode v1.6.1 konsisten dengan observasi itu, tetapi saya tidak menginstrumentasikannya selama run. Di sitemapxml.go pada v1.6.1, NewNavigationRequestURLFromResponse membangun request navigasi <loc> dari response tanpa RootHostname yang terisi. Request itu kemudian mencapai ValidateScope; di scope.go pada v1.6.1, cabang IP-literal membandingkan host URL dengan root yang kosong itu dan dapat menolaknya. Perintah custom -fs '(127.0.0.1|localhost)' mengambil cabang scope berbeda pada tes scope terpisah, jadi itu adalah penyelamatan yang diprediksi oleh source, bukan workaround -kf yang terukur. Upaya konfirmasi terhalang oleh dial yang intermittent pada client known-files di host ini; karena itu hasil yang dilaporkan tetap 0/2.
Kalau saya benar-benar harus menjalankannya di produksi sebelum ada yang mengonfirmasi flag itu, saya akan mengambil sitemap sendiri, mengekstrak URL <loc>, lalu memberikannya ke Katana sebagai daftar seed. Dua baris shell, tanpa validasi scope sama sekali.
Satu hal berperilaku persis seperti yang dijanjikan dan pantas disebutkan: route 500 dan dead link di-fetch, dicatat, lalu dilewati. Semua run tanpa browser berakhir dengan return code 0. Crawler yang mati pada respon buruk pertama tidak berguna untuk operasi tanpa pengawasan, dan Katana tidak seperti itu.
Cek cakupan spesifik target sebelum deployment
Matriks fixture ini paling berguna sebagai template untuk menguji target terotorisasi Anda sendiri. Definisikan kelas endpoint sebelum menjalankan Katana: link biasa, literal di script yang ditautkan, route yang baru muncul setelah eksekusi, dan entri known-file adalah empat bucket awal yang masuk akal. Simpan sampel ground-truth kecil untuk tiap kelas. Tanpa daftar awal itu, stdout yang lebih besar bisa tampak seperti cakupan yang lebih baik padahal ada kelas yang justru hilang.
Jalankan jalur tanpa browser dan headless sebagai pengukuran terpisah terlebih dahulu. Simpan perintah persisnya, versi Katana, build browser, return code, dan output. Normalisasi lalu diff set endpoint, jangan hanya membandingkan jumlah baris. Jika standard -jc tidak menyumbang apa pun yang unik pada sampel Anda, kebijakan headless-only mungkin cukup; jika set-nya berbeda seperti di sini, pertahankan dua pass yang terpisah dan merge setelah pengumpulan. Menambahkan kedua flag ke satu perintah tidak boleh diasumsikan sama dengan union sampai diff spesifik target membuktikannya.
Validasi scope dengan bukti di luar output Katana. Letakkan URL canary pada host yang seharusnya tetap dikecualikan dan periksa log request server itu. Uji juga host kedua yang memang dimaksudkan jika crawl seharusnya diperluas. Run -cs localhost di sini menghasilkan output kosong karena filtering content-scope tidak memperluas field scope; invocation -fs '(127.0.0.1|localhost)' memang menyentuh server kedua. Mencatat regex persisnya penting karena perubahan satu karakter saja bisa mengubah regex, bukan sekadar tampilannya.
Uji interruption dan known files secara terpisah dari recall discovery. Untuk resume, hentikan seed yang representatif setelah beberapa halaman, simpan path checkpoint yang dihasilkan, dan hitung berapa banyak URL yang sudah selesai di-fetch ulang. Untuk -kf, pastikan bukan hanya robots/sitemap yang diminta, tetapi juga URL <loc> yang ditanam benar-benar dijadwalkan. Itu dua klaim yang berbeda. Pada fixture ini file memang di-fetch sementara dua endpoint sitemap tidak ada, sehingga log request dan output endpoint sama-sama diperlukan untuk melihat batasnya.
Terakhir, tetapkan baseline biaya lokal dengan run berurutan pada mesin yang sedang tidak sibuk, lalu ulangi pada host yang representatif. Simpan min, max, dan median, bukan hanya faktor pengali. Angka 5,1x di sini memasukkan perilaku error dan timeout pada fixture ini; itu memberi tahu Anda bahwa headless layak mendapat budget sendiri, bukan berapa lama inventarisasi produksi akan berlangsung.
Kelebihan dan kekurangan
Kelebihan:
- Recall sempurna pada HTML biasa di semua mode — 4/4 link dan rantai kedalaman 3/3 penuh, tanpa konfigurasi tambahan.
-jcbenar-benar bekerja tanpa browser: 2/2 endpoint dipulihkan dari string literal di file JS yang ditautkan, tanpa biaya browser.-headlessadalah satu-satunya yang menemukan endpoint yang disusun saat runtime — kelas yang secara desain tidak terlihat oleh parsing source.- Default scope bersifat konservatif. Host di luar scope tidak pernah di-fetch pada default,
-fs fqdn, atau-cs. - Satu binary Go, lisensi MIT, build precompiled dan image Docker, I/O yang cocok untuk pipeline.
- Tangguh terhadap kegagalan: response 500 dan dead link tidak menghentikan crawl.
Kekurangan:
- Tidak ada satu invocation pun yang mencakup endpoint JS-file dan runtime-DOM sekaligus. Cakupan penuh butuh dua run dan merge.
-jctidak memberi kontribusi apa pun di bawah-headless— 0/2 pada kelas B di setiap run headless.- Headless memakan waktu wall time 5,1x lebih lama (p50 66.82s vs 13.08s, rentang tidak saling tumpang tindih).
-resumemeng-crawl ulang halaman yang sudah selesai dalam satu seed. Ia memulihkan set endpoint, bukan waktu yang sudah lewat.- Known files memang meminta robots.txt dan sitemap.xml, tetapi gagal memulihkan 0/2 endpoint
<loc>sitemap terhadap target IP. - Headless diam-diam membutuhkan Chromium di mesin; kisah “satu binary” berhenti di browser.
- Hanya discovery. Tidak ada ekstraksi terstruktur, tidak ada konversi konten, tidak ada schema field.
Belum diuji, dan karena itu berada di luar cakupan angka-angka di atas: -jsluice, uji cutoff kedalaman khusus pada -d 1/-d 2, resume multi-seed, pengisian formulir otomatis, dan situs produksi nyata yang banyak JavaScript atau dilindungi. Semua angka berasal dari satu mesin (macOS arm64) terhadap fixture lokal.
Untuk siapa alat ini, dan siapa yang sebaiknya melewatinya
Jika tugas Anda adalah menghasilkan inventaris endpoint untuk infrastruktur yang memang Anda berwenang menyentuhnya, Katana punya bentuk pipeline yang tepat: plumbing STDIN/STDOUT, binary yang bisa didistribusikan, serta mode tanpa browser dan dengan browser. Merge dua pass memang diperlukan untuk kelas yang ditanam pada fixture ini; apakah target Anda juga memerlukan dua pass, itu harus dibuktikan dari halaman representatif.
Lewati alat ini kalau Anda butuh data, bukan alamat. Katana tidak akan pernah menyerahkan tabel produk; ia hanya menyerahkan URL tempat produk mungkin berada, lalu alat lain yang melakukan ekstraksi. Lewati juga kalau Anda butuh satu perintah yang selesai dengan sendirinya — dua-pass merge itu enak di pipeline tapi terasa merepotkan di prompt. Dan jika enumerasi Anda bergantung pada endpoint <loc> sitemap saat menargetkan IP, pastikan dulu Anda benar-benar mendapat apa sebelum percaya pada outputnya, karena pada fixture saya jalur itu menghasilkan nol.
Alternatif, dan batas antara discovery dan ekstraksi
Katana gratis, berlisensi MIT, dan self-hosted. Ia menjaga discovery, pemilihan mode, deployment browser, dan penggabungan hasil tetap di sisi Anda dari batas tersebut.
Di dunia open source, perbandingan yang berguna adalah berdasarkan tugas, bukan bahasa. Colly adalah opsi Go lainnya, tetapi ia berupa library yang Anda kompilasi dengan callback sendiri dan sama sekali tidak merender JavaScript. Crawl4AI menjalankan browser sungguhan dan menghasilkan Markdown untuk pipeline LLM, yang merupakan output yang berbeda sama sekali. Jika Anda sedang mempertimbangkan beberapa alat ini sekaligus, ringkasan scraper open-source kami menempatkan kategorinya berdampingan.
Pengungkapan: Thunderbit adalah produk penerbit dan tidak diuji dalam fixture Katana ini. Ia berada di hilir pada kategori ekstraksi terkelola, mengubah halaman menjadi teks atau record terstruktur, bukan menginventarisasi permukaan endpoint target yang diotorisasi. Sebuah workflow bisa memakai kedua kategori, tetapi review ini hanya menyediakan bukti untuk perilaku discovery Katana.
Coba Thunderbit untuk Ekstraksi Data Web
Putusan akhir
Gunakan Katana ketika deliverable Anda adalah daftar endpoint untuk target yang memang Anda berwenang crawl dan Anda bisa memvalidasi cakupan mode terhadap target tersebut. Dalam fixture ini, standard -jc memulihkan literal JavaScript yang ditanam, sementara headless memulihkan endpoint runtime-DOM; mode browserless yang diuji tidak memulihkan path runtime itu. Default scope juga membuat server kedua tidak di-fetch, dan run tanpa browser tetap melewati response 500 serta dead link.
Catatannya bersifat operasional: merge dua pass mungkin diperlukan untuk kelas endpoint campuran, headless memakan waktu sekitar lima kali lebih lama secara lokal, resume untuk satu seed meng-crawl ulang path yang sudah selesai, dan recall known-files adalah 0/2 terhadap target IP. Itu adalah hasil fixture v1.6.1, bukan jaminan untuk setiap situs. Tetapi hasil itu sudah cukup untuk mendefinisikan cek yang perlu diulang dalam evaluasi produksi.
Coba Thunderbit untuk Ekstraksi Data Web Get Started Free
FAQ
Di mana Katana menyimpan file resume, dan apakah resume melewati halaman yang sudah saya crawl?
Checkpoint-nya jatuh di ~/.config/katana/resume-<xid>.cfg, bukan resume.cfg di direktori kerja seperti yang disiratkan teks bantuan flag. Dan tidak, ia tidak melewati halaman yang sudah selesai: file tersebut hanya menyimpan seed URL yang sedang in-flight, jadi crawl satu seed yang dilanjutkan akan mengambil ulang seluruh 11 path baseline termasuk 10 yang sudah selesai. Anda memang mendapat set endpoint akhir yang sama, hanya saja waktu yang sudah dihemat tidak ikut tersimpan.
Mengapa -kf all meminta sitemap.xml saya tetapi tidak merayapi URL di dalamnya?
Terhadap target IP, hasilnya konsisten dengan batas validasi scope, bukan salah flag. Dalam kode v1.6.1, parser sitemap Katana membangun setiap request <loc> tanpa membawa root hostname ke depan, lalu pemeriksaan DNS-scope untuk host IP-literal dapat menolak URL tersebut; saya tidak menginstrumentasi run untuk memastikan mekanisme itu. Hasilnya bertahan di recall 0 di semua variasi flag, kedalaman, dan seeding yang saya coba. Regex host -fs kustom mengambil cabang validasi yang berbeda dan itulah perbaikan yang diprediksi source — tetapi saya tidak bisa mengonfirmasinya terhadap -kf di mesin saya, jadi anggap saja belum diuji. Mengekstrak URL <loc> sendiri lalu men-seed Katana dengan itu adalah pendekatan yang akan saya percaya hari ini.
Apa yang perlu saya simpan saat melaporkan tes cakupan Katana?
Catat versi Katana dan command persisnya, termasuk ekspresi -fs byte-per-byte; definisikan kelas endpoint sebelum run; simpan log hit sisi server selain stdout; dan pisahkan perilaku yang diukur dari hipotesis berbasis source. Untuk run headless, catat juga build browser — tes ini tidak melakukannya, sehingga reproduksibilitas menjadi terbatas.
Sebaiknya saya pakai -jc, -headless, atau keduanya?
Pilih berdasarkan kelas endpoint yang Anda butuhkan. Pada fixture ini, standard -jc menemukan literal yang disimpan di file JavaScript, sementara headless menemukan endpoint yang disisipkan ke runtime DOM. Tidak ada mode tunggal yang mencakup keduanya sekaligus, jadi run dua-pass lalu dedup adalah pilihan yang paling bisa dipertanggungjawabkan untuk target campuran.
Apakah satu URL yang gagal akan menghentikan crawl? Tidak pada run terkontrol ini. Katana tetap berjalan setelah respons 500 dan dead link, lalu tetap mengembalikan path lain yang bisa dijangkau. Itu bukan pengganti pencatatan error produksi: simpan log request gagal dan tentukan tingkat kegagalan yang dapat diterima agar crawl yang hanya sebagian berhasil tidak disalahartikan sebagai cakupan lengkap.




