
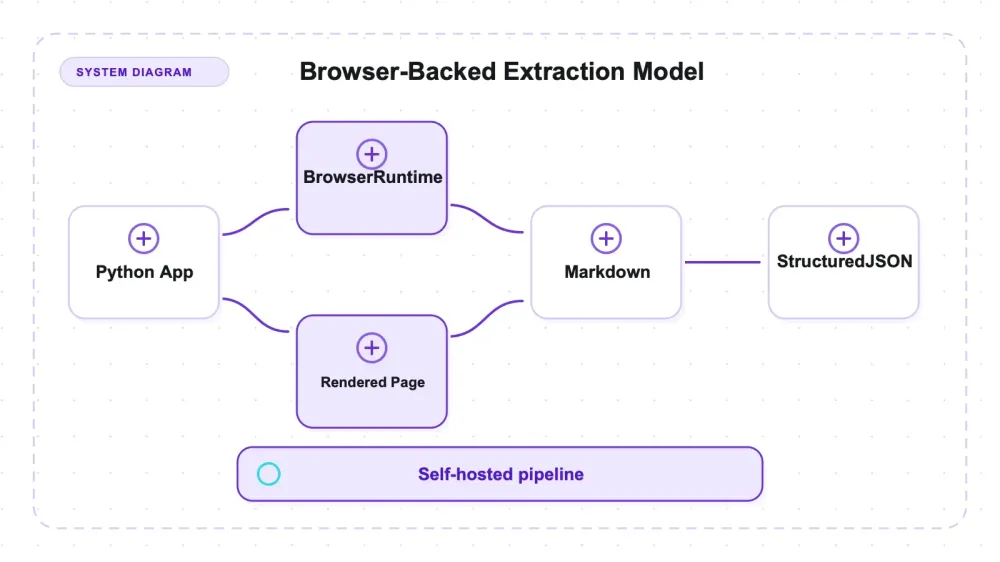
Beberapa perbandingan scraper pihak ketiga menyematkan klaim "Adaptive Intelligence" — selector yang mempelajari sebuah situs dan memperbaiki diri setelah markup berubah — kepada Crawl4AI. Saya tidak menemukan perilaku seperti itu pada permukaan API yang diuji. Yang benar-benar disediakan Crawl4AI adalah pembuatan Markdown berbasis browser serta ekstraksi CSS/XPath. Scrapling memang punya fitur adaptive selector yang terpisah, dengan batasan seperti yang dijelaskan dalam ulasannya sendiri.
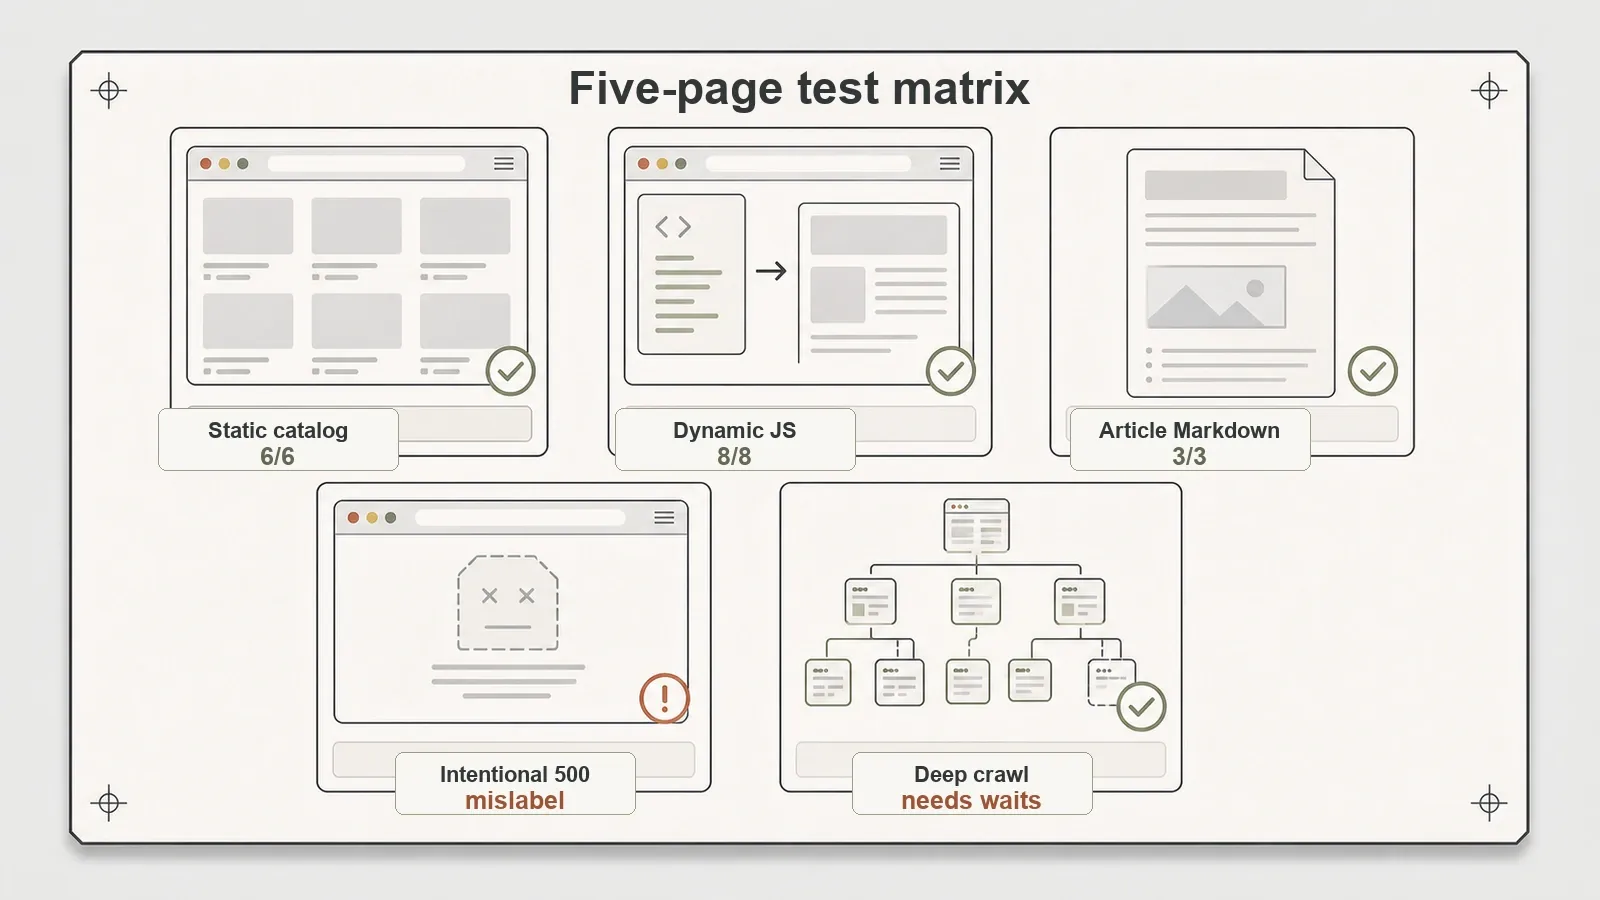
Saya menguji Crawl4AI 0.9.0 pada lima tipe halaman dengan ground truth yang sudah diketahui: katalog statis, katalog yang dirender JavaScript, artikel yang dibungkus boilerplate, respons 500 yang sengaja dibuat, dan graf multi-halaman yang saling tertaut. Jalur Markdown dan schema yang diuji mengembalikan konten fixture sesuai harapan. Markdown mentah tetap membawa boilerplate, deep crawling butuh jeda yang spesifik per halaman, dan error 500 biasa justru diberi label ala anti-bot.
Apa sebenarnya Crawl4AI itu
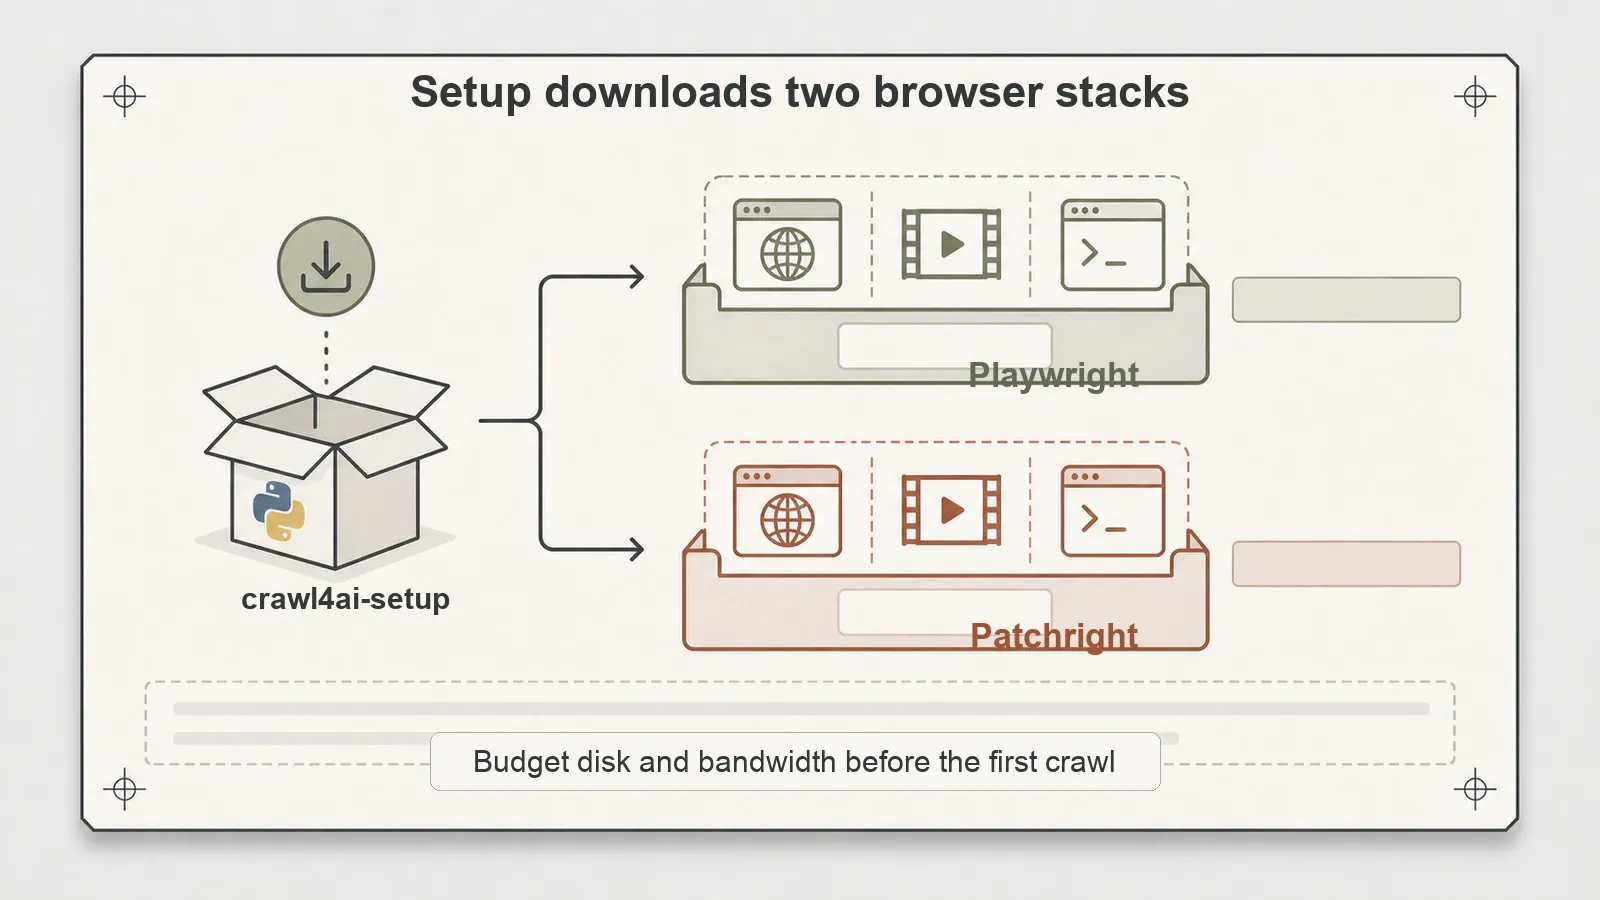
Mulailah dari hal yang paling sering keliru saat instalasi. Crawl4AI bukan parser Python kecil. Perintah pertama crawl4ai-setup diam-diam mengunduh dua stack browser lengkap — Playwright dan Patchright — dan begitu kamu paham itu, alat ini langsung terasa masuk akal: ini adalah headless browser yang dikendalikan, dengan konverter Markdown di atasnya, dibungkus gaya scraper.
Secara resmi, ini adalah library open-source berlisensi Apache-2.0 untuk mengubah halaman web menjadi Markdown bagi pipeline RAG, agent, dan alur kerja data. Saya menguji v0.9.0. Primitive intinya mencakup AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, pembuatan Markdown, serta strategi ekstraksi berbasis CSS/XPath atau LLM, sesuai quick start resmi.
Inilah model mental yang penting. Kebanyakan library parsing mengirim request HTTP lalu mem-parsing byte yang diterima; Crawl4AI menjalankan browser sungguhan. Rendering browser sudah tertanam, jadi instalasinya memang lebih berat daripada parser HTTP murni, sementara ekstraksi yang andal dari elemen yang dirender secara asinkron tetap bisa butuh explicit wait. Tidak ada pengujian di sini yang menulis ulang selector setelah redesign. Perlakukan klaim self-healing sebagai kekeliruan dari perbandingan pihak ketiga, kecuali ada sumber resmi tertentu dan API yang bisa direproduksi.
Fitur utama, dan cara kerjanya di balik layar
Jalur satu halaman adalah inti utamanya. Kamu mengarahkan AsyncWebCrawler ke sebuah URL, alat ini memuat halaman di browser, lalu mengembalikan Markdown. Pada quickstart resmi example.com, proses bolak-balik itu memakan 1.81 detik dan menghasilkan status 200 yang bersih. Tidak ada yang aneh, tetapi ini menegaskan bahwa jalur minimal bekerja dengan hampir tanpa konfigurasi — tanpa schema, tanpa wait, tanpa browser config.
Video tutorial (1:02:38): Crawl4AI Official Tutorial, Full 1hr with Quickstart Examples.
Ekstraksi terstruktur adalah pilar kedua, dan inilah hal paling dekat dengan “pemahaman” halaman yang dimiliki Crawl4AI — maksudnya bukan inferensi, melainkan schema yang kamu tulis sendiri. Alih-alih sekadar membuang Markdown, kamu memberinya schema CSS lewat JsonCssExtractionStrategy lalu mendapatkan objek JSON dengan field yang kamu minta. Pada katalog statis lokal saya, hasilnya 6 record JSON bersih — nama produk, kategori, harga, rating, URL detail — pas dengan 6 produk yang diharapkan. Itulah bedanya antara “ini halaman sebagai teks” dan “ini data sebagai baris,” dan Crawl4AI melakukan keduanya dari crawl yang sama. Namun, selector-nya tetap harus kamu tentukan; alat ini mencocokkan apa yang kamu berikan, bukan menebak schema untukmu.
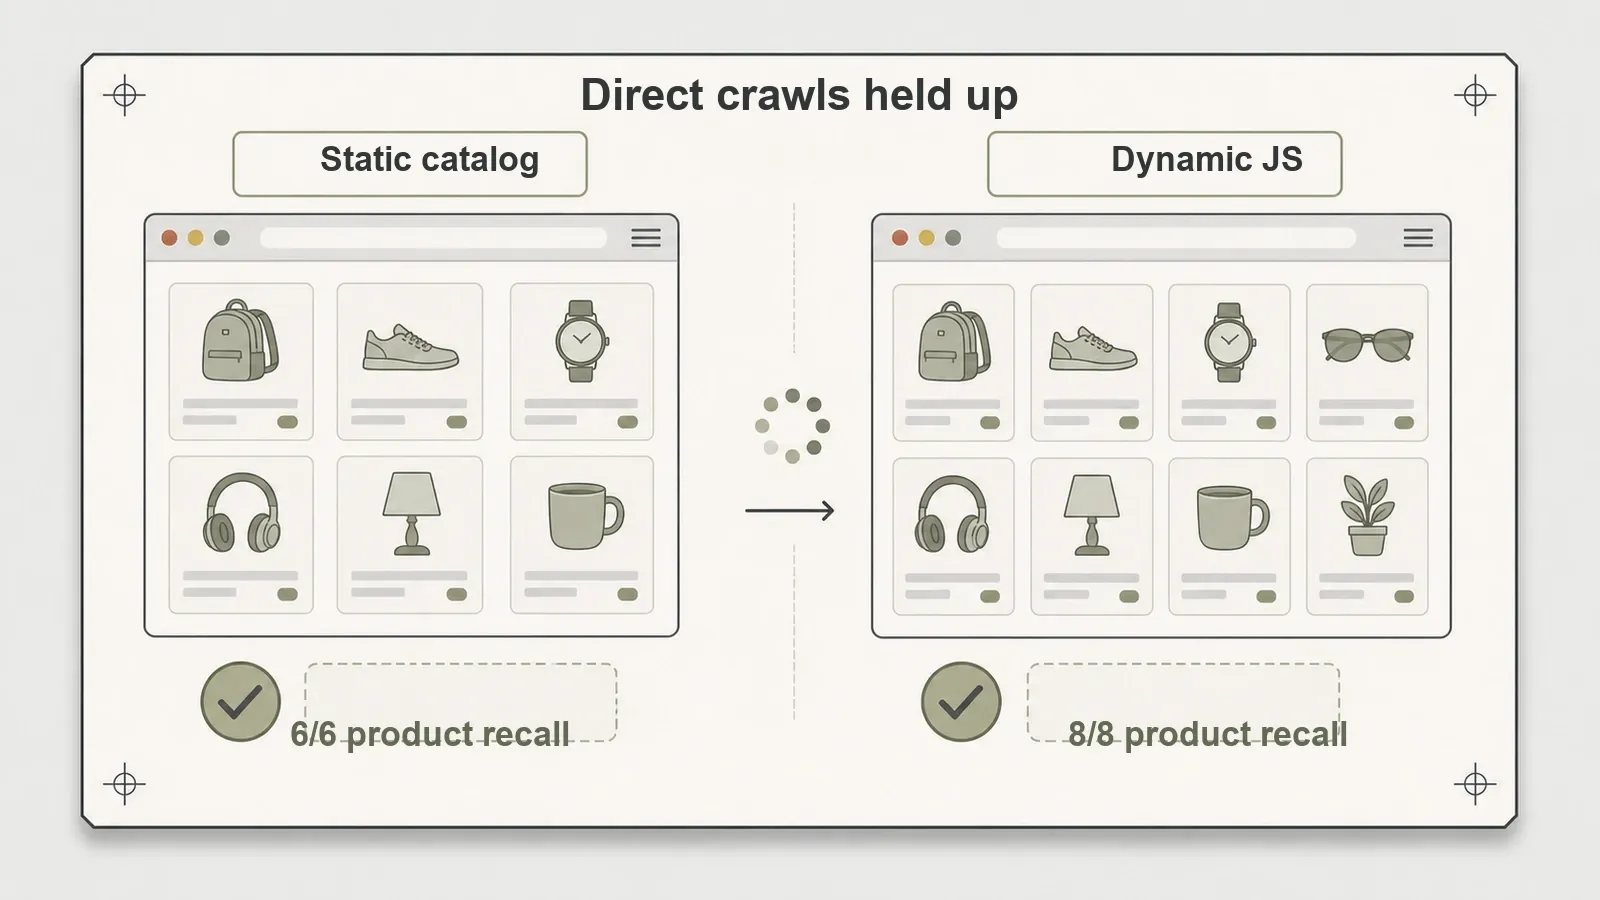
Rendering dinamis adalah tempat dukungan browser benar-benar terasa. Arahkan ke katalog yang dirender JavaScript dengan wait_for="css:.product-card" dan Crawl4AI akan menunggu sampai render sisi klien selesai sebelum mengekstrak. Hasilnya 8/8 product recall pada output Markdown dan schema untuk fixture JS lokal saya, dalam sekitar 1.56 detik. Pada halaman publik Quotes to Scrape JS page, alat ini menangkap kutipan yang sudah dirender dan menyimpan screenshot yang bisa dipakai — konten yang takkan pernah terlihat oleh request HTTP biasa, karena di HTML awal memang tidak ada apa-apa untuk diparse.
Lalu ada skala dan crawling. arun_many() menjalankan enam detail page lokal secara paralel dengan recall penuh 6/6 dalam 3.76 detik. Crawl4AI juga membawa strategi deep-crawl — BFS, DFS, BestFirst — yang menelusuri graf tautan dengan batas kedalaman, jumlah halaman, filtering, dan scoring. Deep crawl BFS pada homepage fixture saya menelusuri graf tautan dan mengambil lima halaman. Di sinilah klaim marketing dan realitas mulai berpisah, dan saya akan membahasnya di bawah.
Setup: bagian yang hampir tak pernah ditulis di pembuka README
Instalasi di mesin saya lebih mulus dari dugaan di satu sisi, tetapi lebih berat di sisi lain. pip install -U crawl4ai dan smoke test berhasil di Python 3.14.2 pada macOS arm64. Spesifikasi PyPI >=3.10 memang sudah mencakup 3.14; hasil ini hanya membuktikan instalasi dan alur kerja yang diuji, bukan kompatibilitas yang lebih luas.
Titik friksi ada di langkah setup. crawl4ai-setup mengunduh aset browser untuk Playwright dan Patchright — Chrome for Testing, FFmpeg, Headless Shell. Kalau kamu memakai laptop dengan ruang disk terbatas atau koneksi berkuota, ini biaya nyata, dan dokumentasinya baru disinggung sekilas, bukan di awal. crawl4ai-doctor kemudian lolos dan melakukan crawl ke crawl4ai.com dalam 14.65 detik, yang cukup baik sebagai smoke test end-to-end tetapi bukan benchmark apa pun — saya tidak akan menarik kesimpulan performa dari angka itu.
Pelajaran untuk evaluasi kamu sendiri: siapkan anggaran untuk unduhan browser, bukan cuma untuk instalasi pip. Ini lebih mirip menyiapkan lingkungan headless browser daripada sekadar memasang library ke dalam script. Dua stack browser masuk ke disk sebelum kamu melakukan crawl pada satu halaman nyata pun, dan itu adalah biaya satu kali yang tetap harus kamu bayar, baik workload nanti memakai lapisan stealth Patchright atau tidak.
Praktik langsung: apa yang stabil, dan apa yang perlu diwaspadai
Empat hasil layak dicatat dengan hati-hati, karena justru di sinilah nuansa yang biasanya dirapikan oleh halaman marketing — dan dalam satu kasus, malah salah label.
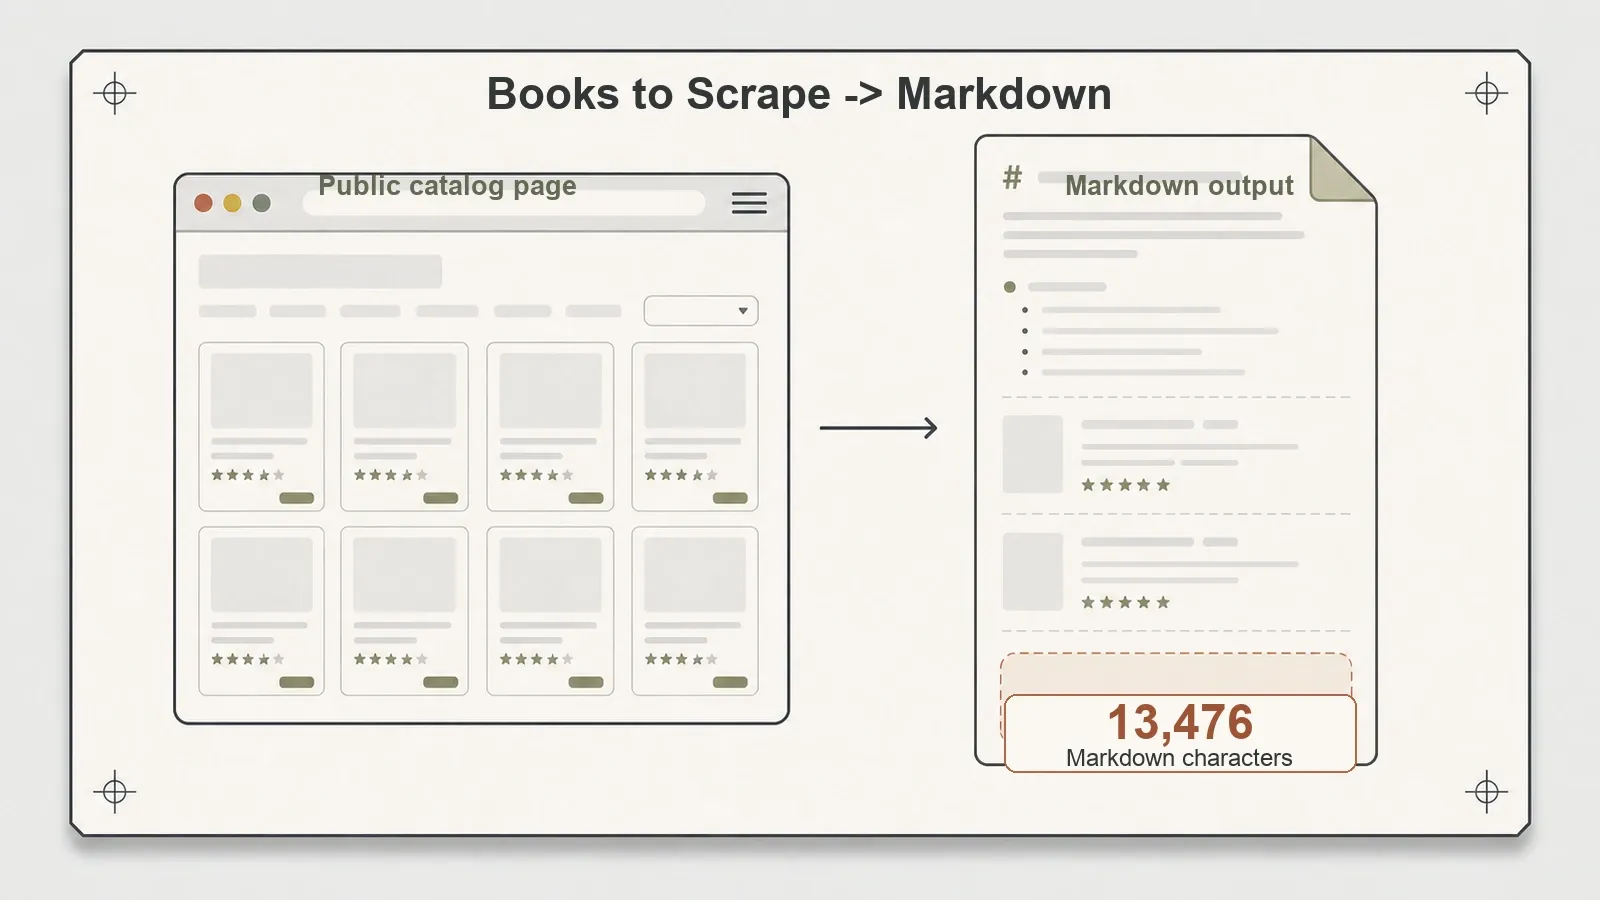
Dua halaman demo publik juga berhasil melewati alur normal. Pada homepage Books to Scrape, Crawl4AI menghasilkan 13.476 karakter Markdown dalam 2.43 detik. Halaman Quotes JS publik mengembalikan 1.666 karakter Markdown yang sudah dirender dalam sekitar 3.1 detik. Keduanya bukan bukti tentang skala, situs yang agresif, stabilitas jangka panjang, session, proxy, retry, atau perilaku memori.
Fixture artikel menunjukkan satu catatan tentang kualitas Markdown. Crawl4AI menangkap judul dan semua 3/3 paragraf isi — bagus. Namun Markdown mentahnya juga tetap menyertakan teks navigasi, tautan terkait, satu baris langganan, dan teks footer. Itu bukan bug; tanpa content filter atau target selector, “ubah halaman ini menjadi Markdown” memang jujur berarti seluruh halaman. Pelajarannya adalah membedakan konversi Markdown mentah dari ekstraksi artikel yang bersih. Kalau yang kamu cari adalah yang terakhir, kamu perlu content filter seperti PruningContentFilter atau target selector — yang belum saya uji secara stres, jadi saya tidak akan mengklaim angka kebersihannya.
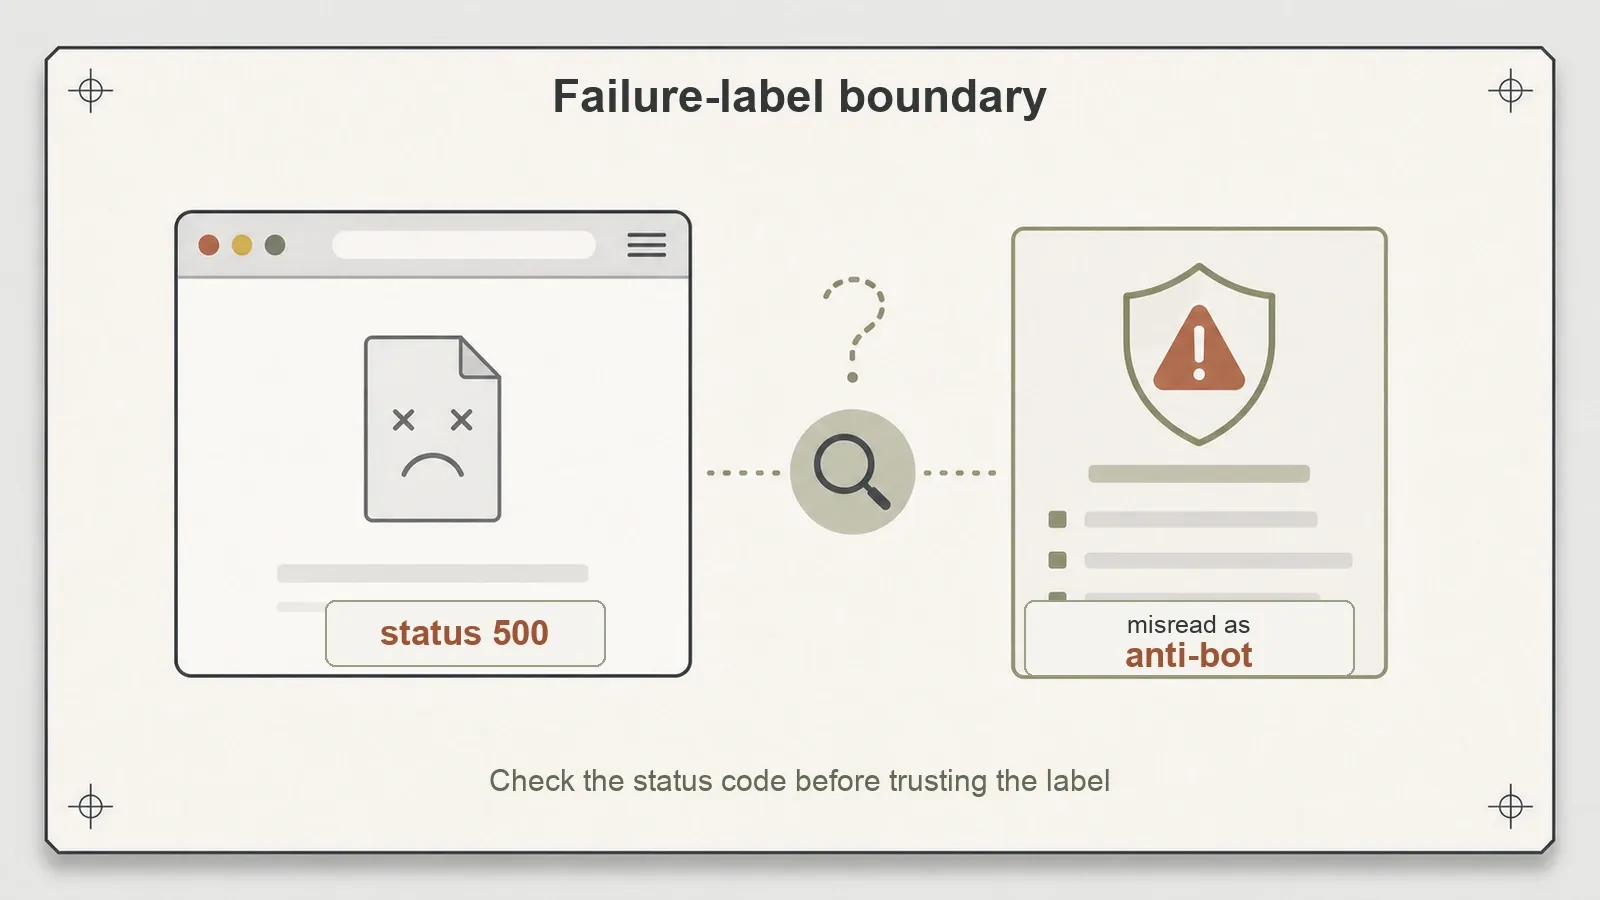
Halaman rusak justru memberi hasil paling informatif. Saya menyajikan respons HTTP 500 yang sengaja dibuat dengan body kecil. Crawl4AI mengembalikan success=false dan status 500 — benar — tetapi pesan error-nya membingkainya sebagai “Blocked by anti-bot protection: Structural: minimal_text on small page.” Tidak ada tembok anti-bot. Itu cuma halaman error kecil. Heuristik struktural Crawl4AI melihat teks terlihat yang sangat sedikit lalu menyimpulkan penjelasan anti-bot. Bagi siapa pun yang membangun di atas alat ini, ini penting: jangan percaya label “anti-bot” begitu saja. Periksa status code dan respons asli sebelum menyimpulkan situs sedang melawanmu. Hasil mentahnya ada di repo benchmark di results/local_failure_500.json.
Deep crawling butuh konfigurasi yang disengaja. Crawl dinamis langsung dengan wait_for berjalan mulus, sedangkan deep crawl BFS menemukan katalog dinamis lalu mengembalikan kegagalan. Klasifikasi minimal-text konsisten dengan pembacaan sebelum kartu selesai dirender, dan deep crawl tidak menerapkan wait dari crawl langsung. Dari lima halaman, tiga berhasil dan dua gagal. Karena rerun dengan konfigurasi wait tidak ditampilkan di sini, diagnosis itu masih berupa inferensi, bukan sebab yang sudah terbukti.
Hasil angka akhirnya
| Test | Hasil | Waktu nyata yang teramati (satu run yang tercapture) |
|---|---|---|
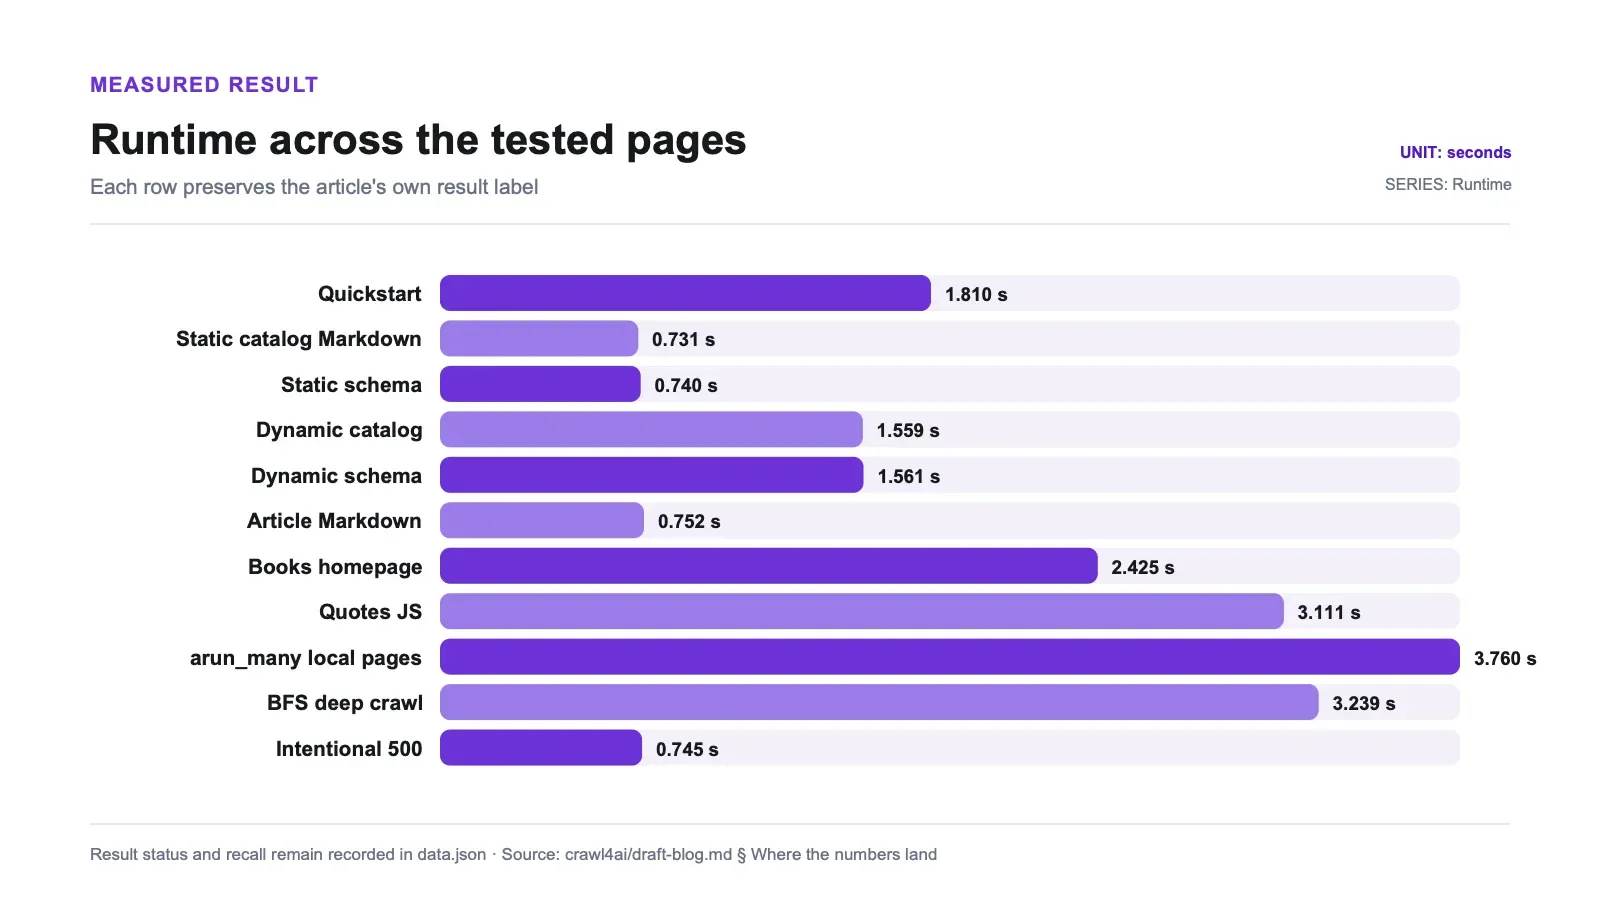
Quickstart (example.com) | sukses, 200 | 1.81s |
| Katalog statis lokal (Markdown) | recall produk 6/6 | 0.731s |
| Ekstraksi schema CSS katalog statis lokal | 6 record JSON | 0.740s |
Katalog dinamis lokal (wait_for) | recall produk 8/8 | 1.559s |
| Ekstraksi schema CSS katalog dinamis lokal | 8 record JSON | 1.561s |
| Markdown artikel | 3/3 paragraf (+ boilerplate) | 0.752s |
| Homepage publik Books to Scrape | 13.476 karakter Markdown | 2.425s |
| Halaman Quotes JS publik | 1.666 karakter Markdown, dirender | 3.111s |
arun_many() (6 halaman lokal) | recall 6/6 | 3.760s |
| Deep crawl BFS lokal | 5 halaman ditemukan, 3 sukses / 2 gagal | 3.239s |
| Halaman 500 yang disengaja | gagal, 500 (salah label "anti-bot") | 0.745s |
Ini adalah timing smoke test, bukan benchmark performa: artikel ini tidak mendokumentasikan hardware, jumlah pengulangan, kondisi warm/cold, status cache, kontrol concurrency, atau variasi hasil. Yang ditunjukkan hanyalah workflow di atas selesai di mesin ini. Artefak run lengkap ada di direktori repo benchmark.
Untuk pengujian performa yang layak dipakai mengambil keputusan, ulangi setiap workflow dalam sesi browser baru dan sesi yang sudah dipakai, laporkan distribusi alih-alih satu angka desimal, pin build browser, dan catat CPU, memori, status cache, serta concurrency. Dengan begitu, overhead library bisa dipisahkan dari startup browser dan variasi jaringan.
| Kebutuhan | Kecocokan dalam ulasan ini | Syarat utama |
|---|---|---|
| Merender halaman dan mengembalikan Markdown | Kandidat yang bagus | Filter boilerplate sebelum dianggap artikel yang bersih |
| Mengekstrak JSON berbentuk schema | Kandidat yang bagus | Kamu tetap menulis dan memelihara schema CSS |
| Menunggu konten halaman yang dimuat asinkron | Didukung | Definisikan kondisi wait_for yang eksplisit dan spesifik target |
| Melakukan crawl dinamis secara mendalam | Bersyarat | Terapkan aturan kesiapan; default yang diuji menghasilkan kegagalan sebagian |
| Menjadi parser HTTP kecil yang minim dependensi | Tidak cocok | Aset browser dan pemeliharaannya adalah bagian dari deployment |
| Memakai selector yang self-healing | Tidak didukung oleh pengujian ini | Jangan menyimpulkan fitur ini dari copy perbandingan yang tidak terkait |
Kelebihan dan kekurangan
Kelebihan:
- Satu library menangani Markdown mentah dan JSON terstruktur berbasis CSS schema — kamu tidak perlu menggabungkan dua alat.
- Rendering browser sudah built-in; target yang dirender secara asinkron mungkin butuh
wait_foreksplisit. - Workflow satu halaman yang diuji selesai dalam waktu yang tercantum di atas; tidak ada klaim kecepatan komparatif di sini.
- Lisensi Apache-2.0 — ramah untuk penggunaan komersial, tanpa kejutan copyleft.
- Proyek aktif dengan rilis terbaru dan komunitas besar yang terlibat.
Kekurangan:
- Setup awal berat (dua stack browser) dan intro-nya cenderung meremehkan hal itu.
- Markdown mentah memuat boilerplate kecuali kamu mengatur content filter.
- Deep crawling tidak otomatis menunggu halaman dinamis — kamu harus mengonfigurasinya per crawl atau hasilnya gagal.
- Pesan kegagalan bisa salah melabeli error biasa sebagai "anti-bot," yang bikin bingung di log.
- Tidak ada selector yang menyesuaikan diri sendiri, meski beberapa perbandingan menyiratkan sebaliknya — schema ditulis manual dan statis.
- Kamu sendiri yang menjalankan dan memelihara lingkungan browser, termasuk update dan potensi kerusakan.
Cocok untuk siapa — dan siapa yang sebaiknya melewatkannya
Crawl4AI layak dievaluasi jika kamu seorang developer yang membangun pipeline RAG atau agent, kamu nyaman menjalankan lingkungan headless browser, dan kamu menginginkan Markdown plus JSON terstruktur dari crawl yang sama. Pengujian ini tidak mencakup ketahanan terhadap situs yang agresif, stabilitas jangka panjang, memori, session, retry, proxy, atau deployment produksi, jadi rekomendasinya hanya berlaku untuk workflow yang diuji di sini.
Lewati — atau setidaknya tunda dulu — jika yang kamu cari adalah parser HTTP kecil dengan dependensi ringan (ini kebalikannya), jika kamu tidak bisa menyediakan ruang disk dan bandwidth untuk unduhan browser, atau jika kamu tidak ingin memikul maintenance stack browser di produksi. Dan khususnya lewati jika kamu datang karena self-healing selector: itu bukan jenis alat ini, dan membangun workflow di atas fitur yang tidak ada akan jadi masalah nanti. Untuk ekstraksi teks artikel murni dengan boilerplate yang dibuang, alat yang lebih ringan dan memang dibuat khusus untuk tugas itu mungkin lebih cocok.
Alternatif, termasuk posisi Thunderbit
Framing yang jujur: Crawl4AI adalah library open-source gratis yang kamu-host dan rawat sendiri. Kamu dapat kontrol penuh dan tidak ada biaya vendor per penggunaan, tetapi tetap membayar compute, bandwidth, storage, update browser, schema, dan pekerjaan operasional.
Di sisi lain ada layanan scraping terkelola seperti Thunderbit, di mana pengambilan dan ekstraksi berjalan di balik API. Thunderbit tidak dijalankan melalui fixture ini, jadi artikel ini tidak membuat klaim yang setara soal rendering, penanganan anti-bot, CAPTCHA, akurasi, atau kecepatan. Perbandingan yang relevan adalah kepemilikan operasional: kamu meng-host sendiri library berbasis browser, atau membayar layanan untuk mengoperasikan lapisan itu.
Bedanya ada pada siapa yang menjalankan browser. Dengan Crawl4AI, kamu memiliki rendering, wait, schema, dan maintenance. Dengan API terkelola, kamu membayar per panggilan dan memindahkan sebagian tanggung jawab operasional ke penyedia. Eksperimen ini tidak membandingkan kedua jalur tersebut dari sisi hasil.
Ulasan benchmark terkait: perbandingan lengkap scraper open-source, ulasan self-hosted Firecrawl, dan ulasan ekstraksi artikel trafilatura.
Coba Thunderbit untuk Ekstraksi Data Web
Kesimpulan
Crawl4AI adalah kandidat yang masuk akal jika kamu menginginkan ekstraksi open-source berbasis browser yang menghasilkan Markdown dan JSON berbentuk schema, dan kamu siap memelihara lingkungan browsernya. Workflow statis langsung dan dynamic yang memakai wait berhasil pada fixture ini. Lisensi Apache-2.0 cukup permisif, meski tinjauan normal terhadap dependensi dan distribusi tetap diperlukan.
Sisihkan anggaran untuk aset browser. Markdown mentah perlu difilter sebelum layak disebut artikel bersih. Wait untuk deep crawl harus dikonfigurasi dengan sengaja, dan log yang mengatakan "anti-bot" perlu dicek terhadap status code dan respons. Selector schema tetap harus kamu tulis dan pelihara sendiri. Itulah batas keputusan yang teruji; skala produksi dan perilaku pada situs agresif masih menjadi pertanyaan terbuka.
Coba Thunderbit untuk Ekstraksi Data Web Get Started Free
FAQ
Apakah Crawl4AI punya selector adaptif atau self-healing? Tidak. Meski ada beberapa perbandingan yang menganggapnya punya "adaptive intelligence," Crawl4AI mencocokkan schema CSS/XPath yang kamu tulis — bukan memetakan ulang elemen dan menemukannya lagi setelah markup berubah. Dalam pengujian, ekstraksi terstruktur mencapai recall 6/6 dan 8/8 dengan schema yang saya buat manual. Jika sebuah situs mengubah class-nya, schema kamu akan rusak sampai kamu memperbaruinya. Pelacakan elemen self-healing adalah fitur library lain, bukan milik ini.
Mengapa instalasinya begitu besar?
crawl4ai-setup mengunduh aset browser penuh untuk Playwright dan Patchright — Chrome for Testing, FFmpeg, dan Headless Shell. Itu adalah harga dari pengiriman rendering browser sungguhan. Siapkan ruang disk dan bandwidth untuk ini; lebih berat daripada parser HTTP murni, dan biayanya tetap kamu tanggung meski workload kamu tidak pernah memakai stack stealth.
Apakah Crawl4AI bisa menangani halaman yang dirender JavaScript?
Ya, karena alat ini mengoperasikan headless browser sungguhan. Dalam pengujian, katalog dinamis dengan wait_for="css:.product-card" mengembalikan recall produk penuh 8/8, dan halaman Quotes JS publik dirender dengan bersih. Catatannya, deep crawl tidak otomatis menerapkan wait itu ke halaman yang ditemukan — crawl BFS gagal pada halaman dinamis yang ditemukannya karena tidak menunggu. Kamu harus mengonfigurasi wait sendiri, per crawl.
Apakah Crawl4AI memberi saya teks artikel bersih atau seluruh halaman?
Secara default, seluruh halaman. Dalam pengujian, alat ini menangkap semua paragraf isi tetapi juga tetap membawa navigasi, tautan terkait, dan teks footer. Untuk ekstraksi artikel yang bersih, kamu perlu menerapkan content filter (seperti PruningContentFilter) atau target selector, bukan mengandalkan Markdown mentah.
Bisakah saya mempercayai pesan error Crawl4AI? Baca dengan sedikit skeptis. Halaman error 500 yang sengaja dibuat dengan body kecil dilabeli "Blocked by anti-bot protection" semata-mata karena heuristik teks terlihat yang rendah — bukan karena ada tembok anti-bot. Hasil mentahnya ada di repo benchmark. Selalu periksa status code HTTP aktual dan body respons sebelum menyimpulkan situs sedang memblokirmu.




