
Di sekitar tab browser yang keempat belas dan kalkulator harga yang ketiga, saya sadar bahwa memilih layanan web scraping di 2026 justru lebih sulit daripada proses scraping itu sendiri. Pasarnya meledak — ekstensi Chrome tanpa kode, API mentah, stack enterprise yang penuh proxy, AI extractor, hingga agensi layanan penuh — semuanya berebut anggaran yang sama.
Selama beberapa minggu, saya menguji 12 layanan web scraping dengan tugas nyata: mengambil data produk dari situs ecommerce, mengekstrak prospek dari direktori bisnis, dan meng-scrape daftar lowongan dengan pagination serta subpage. Tujuannya bukan sekadar membandingkan fitur di atas kertas, melainkan menjawab satu pertanyaan praktis: layanan mana yang benar-benar cocok untuk tim yang mana?
Menurut laporan web data publik Bright Data, 82% organisasi kini menganggap data web publik sangat penting bagi masa depan mereka. Laporan pasar 2025 dari ScrapeOps menemukan bahwa lebih dari 65% organisasi menggunakan web scraping untuk membangun dataset bagi analitik dan AI. Namun, survei Apify 2026 menunjukkan 46,7% profesional masih sepenuhnya mengandalkan kode internal, lengkap dengan beban pemeliharaannya.
Sebelum masuk ke daftar tools, berikut penjelasan singkat soal sisi legal dari scraping.
Cara Saya Mengevaluasi Layanan Web Scraping Terbaik
Berikut hal-hal yang saya nilai. Saya memilihnya setelah melihat apa yang sering gagal setelah fase demo, bukan hanya dari halaman fitur.
- Kemudahan setup / tingkat keahlian teknis yang dibutuhkan — Bisakah orang non-developer mendapatkan hasil dalam waktu kurang dari 10 menit?
- Penanganan anti-bot & proxy — Apakah layanan ini mengelola proxy dan pemecahan CAPTCHA, atau itu urusan Anda?
- Rendering JavaScript — Apakah bisa menangani halaman dinamis yang berat JS secara langsung?
- Format ekspor data & integrasi — Bisakah data masuk ke Sheets, Airtable, atau Notion tanpa menulis kode penghubung?
- Penjadwalan / monitoring otomatis — Bisakah Anda mengatur scraping berulang tanpa cron job?
- Skalabilitas — Apakah tetap berjalan di 100 halaman, dan masih stabil di 1 juta halaman?
- Transparansi harga & biaya skala besar — Bisakah Anda memprediksi tagihan bulan depan, atau akan ada kejutan?
- Ekstraksi berbasis AI vs selector manual — Apakah AI digunakan untuk menebak field, atau Anda harus menulis CSS/XPath sendiri?
- Beban pemeliharaan dari waktu ke waktu — Apa yang terjadi saat situs target melakukan redesign?
Poin terakhir itu layak digarisbawahi. Ulasan pengguna untuk tool seperti Octoparse, Apify, Browse AI, dan Bright Data terus mengulang keluhan yang sama: kebingungan soal harga kredit, selector rusak setelah situs berubah, proses cloud gagal di halaman yang diproteksi, dan kurva belajar yang curam setelah demo awal. "Beban pemeliharaan" bukan sekadar nilai tambah. Itulah faktor yang menentukan apakah Anda masih memakai tool itu enam bulan kemudian.
Jenis Layanan Web Scraping Mana yang Cocok untuk Tim Anda?
Sebelum membandingkan satu per satu, hal paling berguna yang bisa saya lakukan adalah membantu Anda langsung menuju kategori yang tepat. Pasar web scraping bukan satu pasar. Ada lima pasar yang saling tumpang tindih, dan memilih kategori yang salah akan membuang lebih banyak waktu dibanding memilih tool yang salah di kategori yang tepat.
| Situasi Anda | Jenis Layanan yang Disarankan | Alasannya | Cocok dari Daftar Ini |
|---|---|---|---|
| Tim non-teknis (sales, marketing, ops) yang butuh data cepat | Ekstensi Chrome tanpa kode | Jalur tercepat dari website ke spreadsheet, setup paling ringan | Thunderbit, Browse AI, Octoparse |
| Developer yang membangun scraping ke dalam aplikasi atau pipeline | Scraping API | Kontrol lebih besar, webhook, job async, lebih cocok untuk CI/CD | ScrapingBee, ScraperAPI, ZenRows |
| Tim yang memasok data ke workflow AI/LLM | API ekstraksi native AI | Output Markdown/JSON dari awal, lebih sedikit pembersihan HTML | Thunderbit API, Firecrawl, Diffbot |
| Enterprise yang butuh infrastruktur proxy + skala besar | Platform pengumpulan data full-stack | Proxy bawaan, anti-bot, SLA, concurrency tinggi | Bright Data, Oxylabs, Apify |
| Perusahaan yang ingin data jadi, bukan alat yang dioperasikan sendiri | Managed service / agency | Vendor menangani build, monitoring, QA, dan delivery | ScrapeHero |
Ini bukan teori. Panduan build-vs-buy dari Zyte tahun 2026 menjelaskan tradeoff-nya secara gamblang: DIY memberi kontrol, tapi menambah pekerjaan maintenance terus-menerus; stack campuran menciptakan tambal sulam operasional; managed service mengurangi beban internal, tetapi juga mengurangi fleksibilitas self-serve.
Ekstraksi Berbasis AI vs Selector CSS/XPath Tradisional
Inilah percabangan teknis terbesar di pasar saat ini.
Scraping tradisional ibarat mengikuti peta harta karun dengan koordinat yang presisi. Anda memeriksa halaman, menemukan selector seperti .product-title, menulis aturan ekstraksi, menguji, lalu berharap situs tidak berubah besok. Ketika tim frontend mengganti nama class atau membungkus konten dengan div baru, scraper Anda rusak.
Scraping berbasis AI lebih seperti bertanya pada asisten cerdas: "Temukan nama produk, harga, dan status stok di halaman ini." Alih-alih meng-hardcode rutenya, Anda cukup menjelaskan tujuan akhirnya.
Berikut alur keduanya dalam praktik:
Alur tradisional:
- Inspect elemen di DevTools
- Identifikasi class
.product-titleatau XPath - Tulis aturan ekstraksi
- Uji di halaman contoh
- Perbaiki setiap kali situs mengganti class
Alur berbasis AI (mis. Thunderbit):
- Buka halaman dan klik sekali
- AI memilih kolom yang relevan — nama produk, harga, rating
- Sesuaikan jika ingin hasil berbeda, atau cukup jelaskan kebutuhan Anda
- Kalau tidak ada perubahan, proses langsung berjalan dan Anda mendapat tabelnya
Riset yang dipublikasikan memang belum seluas klaim pemasaran. Sebuah paper Scientific Reports 2025 melaporkan akurasi ekstraksi 35% lebih baik dan efisiensi pemrosesan 40% lebih baik untuk AI crawler dibanding crawler konvensional, tetapi pengujiannya memakai arsip koran, bukan halaman produk atau direktori bisnis, jadi saya tidak akan langsung menyamakan hasil itu dengan situs-situs dalam artikel ini. Review Springer 2025 lebih berguna: model AI memang lebih adaptif terhadap struktur dinamis, tetapi tetap butuh retraining atau fallback logic ketika domain atau polanya berubah cukup besar.
| Dimensi | Tradisional (CSS/XPath) | Ekstraksi Berbasis AI |
|---|---|---|
| Waktu setup | 15–60 menit per situs | ~30 detik |
| Keahlian teknis | Level developer | Tidak perlu |
| Menangani perubahan layout dan situs baru | Mudah rusak — aturan baru setiap redesign, aturan baru untuk tiap situs baru | Biasanya beradaptasi — membaca halaman dari awal setiap kali jalan |
| Prediktabilitas | Deterministik — aturan yang sama menghasilkan field yang sama setiap kali | Probabilistik — kadang memilih field yang salah, jadi perlu cek sampel |
| Pelabelan / transformasi data | Tahap post-processing terpisah | Bisa melabeli, menerjemahkan, dan mengategorikan saat scraping |
| Paling cocok untuk | Pipeline stabil, volume tinggi, dikelola developer | Situs long-tail, layout beragam, pengguna non-developer |
Perbedaan paling terasa di dunia nyata adalah maintenance. Tidak ada angka publik yang benar-benar andal tentang seberapa sering scraper rusak, jadi saya tidak akan mengarang angka di sini. Yang konsisten adalah pola keluhan di review G2 dan Capterra untuk tool berbasis selector di daftar ini: jarang karena tool tidak bisa mengambil data sama sekali, hampir selalu karena ia berhenti mengambil data setelah situs berubah.
Thunderbit adalah contoh paling bersih dari model AI-first di daftar ini. AI-nya memilih field yang layak diambil hanya dengan satu klik, atau Anda bisa menjelaskan data yang diinginkan dalam satu baris, dan Field AI Prompts-nya bisa memberi label, menerjemahkan, meringkas, atau mengategorikan data saat ekstraksi — bukan hanya setelahnya. Open API-nya mengekspos endpoint Distill dan Extract, jadi model ekstraksi AI yang sama juga bisa dipakai secara programatik.
Coba scraping berbasis AI dengan Thunderbit
12 Layanan Web Scraping Terbaik dalam Sekilas
| Layanan | Jenis | Paling Cocok Untuk | Anti-Bot/Proxy | Rendering JS | Ekstraksi AI | Free Tier | Harga Awal (bulanan) | Opsi Ekspor |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Ekstensi Chrome tanpa kode + API | Tim non-teknis | ⚠️ Penanganan berbasis cloud | ✅ | ✅ Field yang dipetakan AI | ✅ 6 halaman gratis | Gratis; berbayar mulai $15/bln | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Platform full-stack | Pipeline skala enterprise | ✅ Jaringan proxy terbaik di kelasnya | ✅ | ⚠️ Sebagian / lapisan AI yang lebih baru | ✅ 5K record/bln | Tidak ada minimum bulanan | JSON, CSV, API, webhook |
| Oxylabs | Proxy enterprise + scraping | Scraping SERP, situs yang diproteksi | ✅ Proxy residential/DC | ✅ | ⚠️ Terbatas | ⚠️ Trial | ~$49/bln | JSON, CSV, API |
| Apify | Platform + marketplace | Developer, builder automation | ✅ Lewat konfigurasi proxy | ✅ | ⚠️ Beberapa actor | ✅ $5 gratis/bln | $29/bln + pemakaian | JSON, CSV, Excel, API |
| ScrapingBee | Layanan API | Pipeline developer | ✅ Bawaan | ✅ | ⚠️ Beberapa ekstraksi AI | ✅ 1.000 credit | $49/bln | JSON, HTML, Markdown, API |
| ScraperAPI | Layanan API | Monitoring harga skala besar | ✅ Rotasi bawaan | ✅ | ❌ | ⚠️ Trial 7 hari, 5K credit | $49/bln | JSON, CSV, API |
| ZenRows | Layanan API | Situs dengan anti-bot berat | ✅ Anti-bot premium | ✅ | ⚠️ Beta | ✅ 5K credit/bln | $19/bln | JSON, API |
| Octoparse | Desktop tanpa kode + cloud | Scraping visual tanpa kode | ✅ Bawaan | ✅ | ⚠️ Auto-detect terbatas | ✅ Paket gratis (10 tugas) | $39/bln | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | Platform AI/NLP | Data enterprise terstruktur | ⚠️ Dasar hingga menengah | ✅ | ✅ Berbasis NLP | ✅ 10K credit/bln | $299/bln | JSON, CSV, API |
| Firecrawl | API developer (AI) | Pipeline LLM/RAG | ✅ Bawaan | ✅ | ✅ Markdown + terstruktur | ✅ 1.000 credit/bln | $19/bln | Markdown, JSON, HTML, API |
| Browse AI | Monitoring tanpa kode | Deteksi perubahan, non-developer | ⚠️ Dasar | ✅ | ⚠️ Berbasis template | ✅ 50 credit/bln | $48/bln | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Managed service/agency | Enterprise yang ingin lepas tangan | ✅ Dikelola penuh | ✅ | N/A | ❌ | Mulai $199/bln | Delivery kustom |
Pola umumnya cukup jelas.
Thunderbit, Browse AI, dan Octoparse mengutamakan kecepatan setup. ScrapingBee, ScraperAPI, dan ZenRows mengutamakan kontrol developer. Bright Data, Oxylabs, dan Apify mengutamakan skala dan infrastruktur. Firecrawl dan Diffbot mengutamakan output yang cocok untuk AI. ScrapeHero mengutamakan Anda tidak perlu mengoperasikan apa pun sendiri.
1. Thunderbit
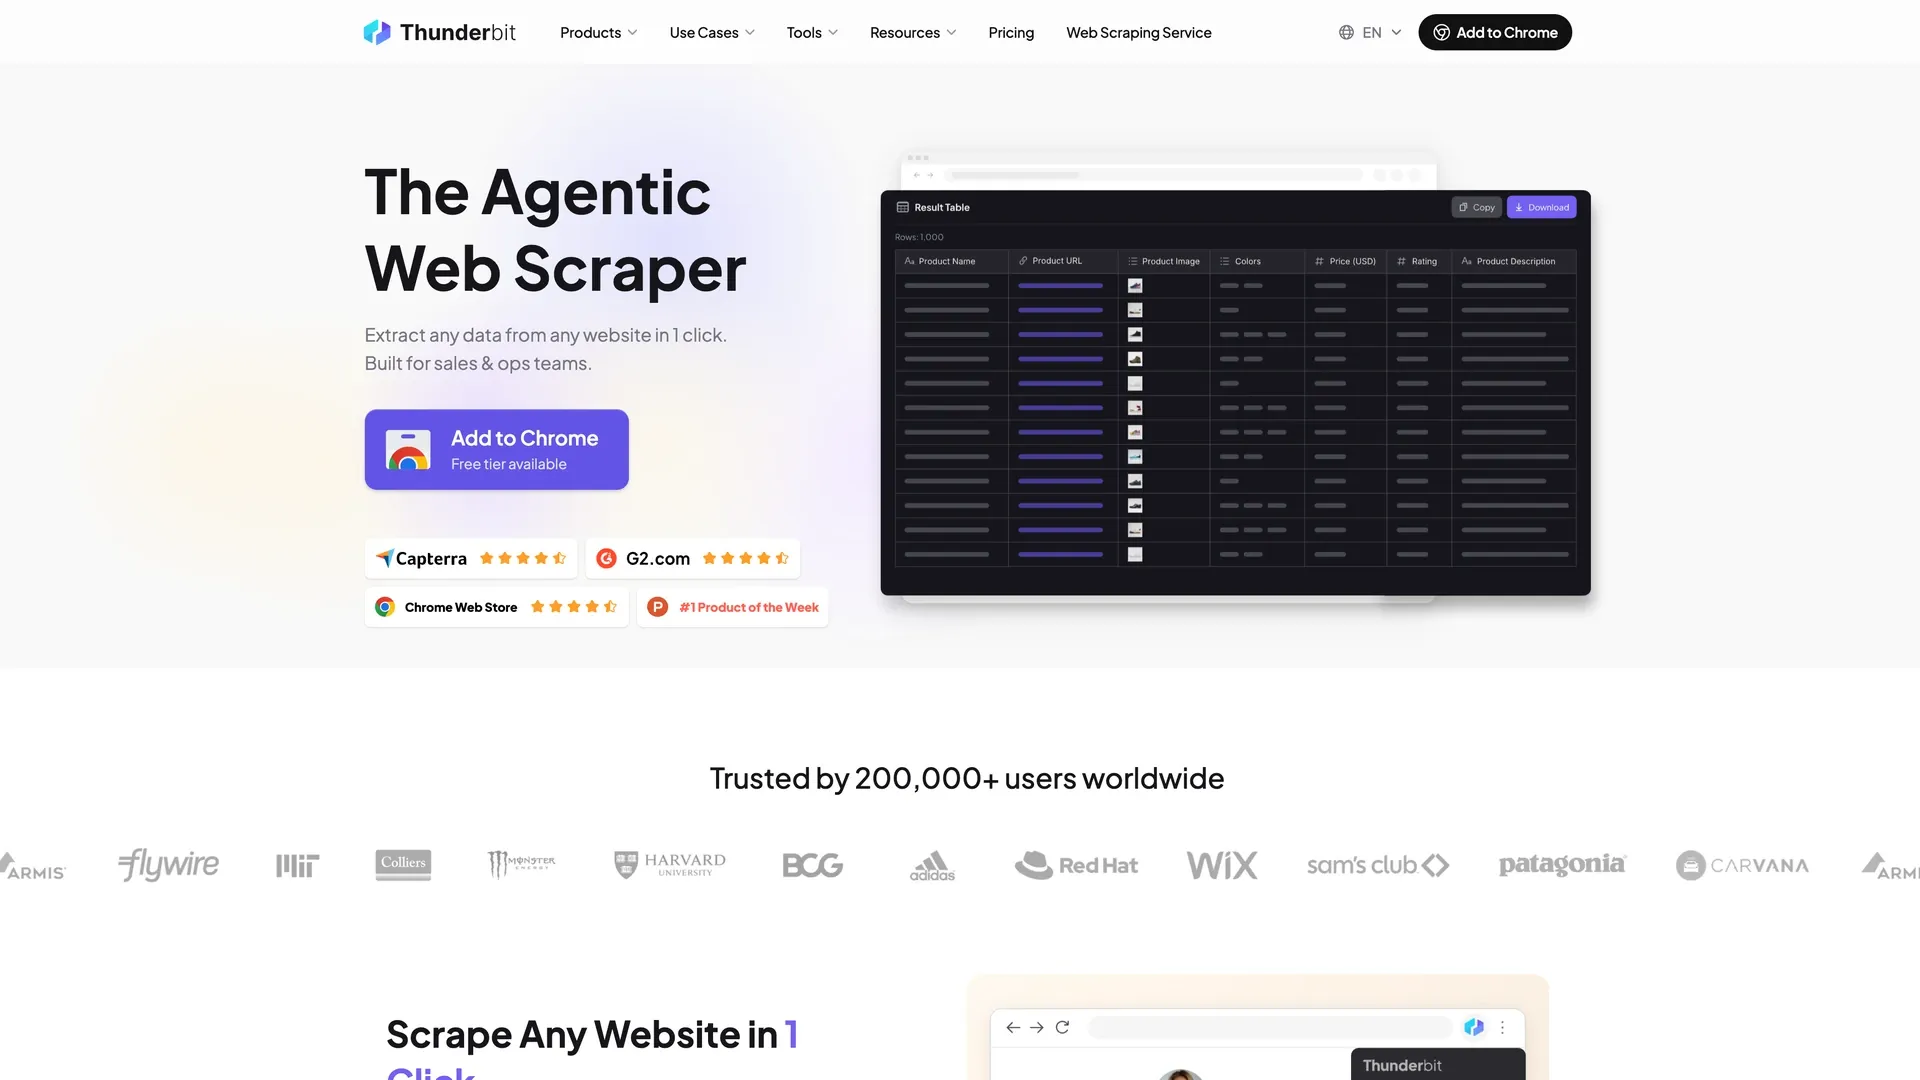 Thunderbit adalah produk paling mudah di daftar ini bagi pengguna non-teknis yang ingin berpindah dari website ke spreadsheet tanpa menyentuh satu selector pun. Alur kerjanya sangat langsung: buka ekstensi Chrome di halaman mana pun dan klik sekali — AI akan menentukan field mana yang layak diambil dan menjalankan job secara otomatis, dan jika Anda ingin hasil tertentu, Anda cukup menjelaskannya dalam bahasa Inggris biasa. Bagi sebagian besar halaman, memang sesederhana itu. Tidak perlu CSS selector. Tidak perlu XPath. Tidak perlu inspect element.
Yang membuat Thunderbit menonjol adalah ia tidak hanya mengekstrak field. Ia juga bisa memberi label, menerjemahkan, meringkas, mengategorikan, dan memformat ulang data saat scraping menggunakan Field AI Prompts. Ini penting karena bottleneck sebenarnya bagi pengguna bisnis sering kali bukan ekstraksinya, melainkan pembersihan data setelah ekspor. Dengan Thunderbit, Anda bisa meng-scrape halaman produk berbahasa Prancis dan mendapatkan output bahasa Inggris dengan label sentimen — dalam satu kali proses.
Fitur utama:
- Setup tanpa selector — satu klik dan AI memilih kolom untuk Anda, atau Anda cukup memberi tahu apa yang Anda mau
- Mode browser untuk halaman login dan mode cloud (50 halaman sekaligus) untuk scraping halaman publik dengan cepat
- Scraping subpage untuk memperkaya daftar halaman dengan data dari halaman detail secara otomatis
- Penanganan pagination dan infinite scroll bawaan
- Penjadwalan berbasis bahasa alami untuk monitoring berulang (misalnya, "setiap Senin pukul 9 pagi")
- Template scraper instan untuk situs populer seperti Amazon, Zillow, Google Maps, dan Indeed
- Open API dengan endpoint
DistilldanExtractuntuk use case developer - Dukungan 34 bahasa termasuk terjemahan saat ekstraksi
Cerita ekspor adalah salah satu keunggulan paling jelas Thunderbit. Ia menawarkan ekspor gratis dan native ke Excel, CSV, JSON, Google Sheets, Airtable, dan Notion — termasuk pengelolaan gambar dalam ekspor Airtable dan Notion. Bagi tim sales yang hidup di Sheets atau tim marketing yang mengatur riset di Notion, ini menghilangkan satu langkah transformasi yang biasanya harus Anda lakukan sendiri pada tool berbasis API.
Harga: Berbasis credit. Ada free tier dengan 6 halaman per bulan, plus trial 7 hari untuk fitur Pro. Paket browser berbayar mulai dari $15/bln jika dibayar bulanan atau $9/bln jika ditagih tahunan. API-nya punya harga terpisah: 600 unit gratis di awal, lalu $29/bln untuk 6.000 unit pada Starter, $72/bln untuk 60.000 pada Pro 1, $120/bln untuk 120.000 pada Pro 2, dan slider hingga 480.000 unit per bulan. Jika ditagih tahunan, biayanya $16/bln untuk 60.000 unit per tahun pada Starter dan $40/bln untuk 600.000 pada Pro 1.
Kelebihan:
- Friksi setup paling rendah di seluruh perbandingan ini
- Ekspor native yang fokus ke spreadsheet, bukan JSON lalu Anda bingung sendiri
- Transformasi AI saat ekstraksi, bukan hanya setelahnya
- Cocok untuk sales, ecommerce, riset, dan real estate
Kekurangan:
- Ada dua sistem credit dengan satuan berbeda: ekstensi menagih 1 credit per baris output (2 jika memakai subpage scraping), sedangkan API menagih 1 unit per halaman Distill dan 20 per halaman Extract — Anda harus menganggarkannya terpisah
- Free tier hanya 6 halaman per bulan, jauh di bawah apa yang dibagikan vendor API lain di sini (Firecrawl 1.000 credit/bln, ZenRows 5.000, Diffbot 10.000)
- Self-serve berhenti sebelum volume enterprise: paket browser publik tertinggi adalah Pro di $38/bln jika ditagih bulanan, dan setelah itu masuk ke penawaran Business kustom
Paling cocok untuk: Lead generation sales, pemantauan kompetitor ecommerce, riset marketing, scraping lowongan dan direktori, listing properti.
2. Bright Data
 Bright Data adalah pilihan pembeli enterprise ketika mereka ingin satu vendor untuk proxy, scraping API, dataset, SERP API, dan makin sering juga ekstraksi berbantuan AI. Ini bukan satu produk tunggal, melainkan sebuah stack akuisisi data yang lengkap.
Harga Web Scraper API bersifat publik: free tier 5.000 record per bulan, pay-as-you-go sekitar $1,50 per 1.000 record, dan paket scale $499/bln dengan 384.000 record termasuk serta $1,30 per 1.000 setelah itu. Di sini, satu record berarti satu item hasil ekstraksi — satu baris di tabel — bukan satu halaman yang dimuat. Proxy residential mulai dari $4/GB. Ada juga structured dataset, Scraper Studio, AI scrapers, dan dukungan MCP.
Fitur utama:
- Jaringan proxy yang sangat kuat (residential, datacenter, mobile, ISP)
- Full browser rendering dan pemecahan CAPTCHA sudah termasuk dalam harga Web Scraper API
- Marketplace dataset untuk data yang sudah dikumpulkan
- Sikap enterprise yang kuat terhadap kepatuhan dengan Trust Center dan sertifikasi
Harga: Pay-as-you-go mulai sekitar $1,50/1K record; paket scale mulai $499/bln.
Kelebihan: Skala dan infrastruktur proxy yang sulit ditandingi. Tata kelola enterprise yang luas. Kekurangan: Lebih kompleks daripada yang dibutuhkan banyak tim mid-market. Harganya bisa membengkak saat API, proxy, dan lapisan add-on digabung. Platform ini masih mengasumsikan ada owner teknis, bahkan dengan fitur AI yang lebih baru.
Paling cocok untuk: Pipeline Fortune 500, tim data yang meng-scrape jutaan halaman, scraping lintas negara yang sangat bergantung pada kualitas proxy, enterprise yang butuh kepatuhan formal.
3. Oxylabs
 Oxylabs adalah opsi enterprise murni paling kuat untuk proxy dan scraping bagi tim yang paling peduli pada reliabilitas di target yang diproteksi. Produknya mencakup residential dan datacenter proxy, Web Scraper API, SERP Scraper API, Web Unblocker, serta lapisan Headless Browser yang lebih baru.
Harga mulai dari $49/bln untuk Web Scraper API, dan tarif per hasil tergantung pada situs target dan paket yang Anda pakai. Pada paket Micro $49, situs umum — apa pun selain Amazon atau Google — biayanya $1,15 per 1.000 hasil tanpa rendering JS dan $1,35 dengan rendering; di paket Advanced $249, dua angka itu turun menjadi $0,95 dan $1,25, dan terus turun di tier di atasnya. Proxy residential mulai dari $6/GB dan turun ke $2,50/GB pada 1TB.
Fitur utama:
- Infrastruktur proxy yang sangat kuat dengan rotasi otomatis dan manajemen sesi
- SERP Scraper API yang memang dirancang untuk monitoring mesin pencari
- Framing bayar-hanya-jika-sukses pada produk utama
- Trust Center dan posisi kepatuhan yang jelas
Harga: Mulai dari $49/bln; tidak ada free tier berkelanjutan (berbasis trial).
Kelebihan: Proxy andal, sangat bagus untuk scraping SERP, posture kepercayaan enterprise yang kuat.
Kekurangan: Jumlah hasil yang ditampilkan di tiap paket mengasumsikan Amazon tanpa rendering JS — pada situs umum, paket Micro $49 sebenarnya sekitar 42.600 hasil, bukan 98.000. Karena tarif per 1.000 hasil berubah mengikuti situs target dan tier paket, dua tim yang meng-scrape volume sama bisa menerima tagihan yang sangat berbeda.
Paling cocok untuk: Tim SEO, monitoring SERP enterprise, workload besar yang sangat bergantung pada proxy.
4. Apify
 Apify adalah platform bergaya marketplace yang paling fleksibel di sini. Ia menggabungkan eksekusi cloud, storage, penjadwalan, log, API, dan ekosistem besar "Actor" siap pakai — Apify Store kini menampilkan lebih dari 59.000 Actor. Alih-alih membangun semua scraper sendiri, Anda sering bisa memulai dari actor yang sudah ada untuk Google Maps, Amazon, Instagram, TikTok, atau crawler konten website umum.
Fitur utama:
- Marketplace besar berisi scraper siap pakai
- Apify SDK untuk pengembangan actor kustom
- Manajemen proxy dan eksekusi cloud bawaan
- API, storage, penjadwalan, dan log yang kuat
Harga berbasis pemakaian: paket gratis dengan kredit belanja $5, lalu $29/bln di Starter, $199 di Scale, $999 di Business — semuanya dengan billing compute unit yang ditambahkan di atasnya. Fleksibilitas ini sangat kuat, tetapi prediksi biaya bulanan jadi lebih sulit dibanding produk API yang lebih sederhana.
Kelebihan: Komunitas besar, banyak scraper siap pakai, cocok dari proyek kecil sampai produksi dan automation serius.
Kekurangan: Menyesuaikan atau debug actor punya kurva belajar. Harga compute unit plus biaya actor plus proxy sulit diprediksi. Lebih cocok untuk builder daripada pengguna bisnis yang terbiasa spreadsheet.
Paling cocok untuk: Developer dan builder automation, tim yang ingin memakai kembali scraper yang sudah ada, workflow campuran build-and-buy.
5. ScrapingBee
 ScrapingBee adalah salah satu scraping API yang paling mudah dipahami dan diintegrasikan. Fokusnya pada rendering Chrome headless, rotasi proxy, dan ergonomi API yang bersih, bukan pada platform visual.
Harga dimulai dari $49/bln untuk 250.000 credit dan 50 request paralel, dengan Startup di $99/bln untuk 1.000.000 credit dan 100 request paralel. Pengguna baru mendapat 1.000 credit API gratis. Catatannya: rendering JS, premium proxy, screenshot, dan ekstraksi AI semuanya menghabiskan credit dengan multiplier yang lebih tinggi.
Fitur utama:
- REST API yang sangat bersih
- Endpoint khusus untuk Amazon, Google, YouTube, Walmart, dan ChatGPT
- Bisa mengembalikan HTML, JSON, Markdown, atau plain text
- Cocok untuk pipeline AI/LLM karena output Markdown mengurangi pekerjaan pembersihan
Kelebihan: Ramah developer, rendering JS andal, harga dasar transparan.
Kekurangan: Paket $49 memang berisi 250.000 credit, tetapi itu 250.000 request biasa saja — rendering JS, premium proxy, screenshot, dan ekstraksi AI masing-masing menghabiskan lebih dari satu credit per pemanggilan, jadi di target nyata halaman yang bisa diambil jauh lebih sedikit dari angka headline. Concurrency juga terikat paket (50 request paralel di Freelance), jadi throughput bisa memaksa Anda naik tier sebelum volumenya sendiri menuntut. Tetap membutuhkan kepemilikan kode.
Paling cocok untuk: Developer yang menanamkan scraping ke backend, tim yang ingin ergonomi API sederhana, pipeline LLM yang butuh output text-first.
6. ScraperAPI
 ScraperAPI tetap menjadi salah satu opsi API terstruktur terkuat untuk monitoring ecommerce dan scraping massal berulang. Fokus produknya sederhana: satu endpoint yang membundel proxy, retry, rendering JS, geo-targeting, dan output terstruktur.
Harga dimulai dari $49/bln untuk 100.000 credit dan 20 thread, dengan Startup di $149/bln untuk 1.000.000 credit dan 50 thread. Ada juga trial 7 hari dengan 5.000 credit, tanpa perlu kartu. Yang menarik dari ScraperAPI adalah lapisan terstrukturnya: async API, pengiriman webhook, DataPipeline untuk proyek low-code, dan structured endpoints untuk Amazon, eBay, Google, Redfin, dan Walmart.
Fitur utama:
- Endpoint terstruktur yang kuat untuk domain ecommerce dan pencarian utama
- Dukungan async dan webhook yang baik
- Kompetitif untuk monitoring volume tinggi
- Opsi geo-targeting dan rendering yang luas
Kelebihan: Credit trial yang cukup besar, dokumentasi bagus, andal untuk monitoring ecommerce.
Kekurangan: Multiplier credit membuat pemodelan biaya lebih sulit. Tidak ada ekstraksi AI sejati untuk halaman arbitrer. Hanya untuk developer.
Paling cocok untuk: Monitoring harga ecommerce, competitive intelligence, pipeline pencarian dan marketplace.
7. ZenRows
 ZenRows adalah spesialis anti-bot. Fokusnya adalah menembus perlindungan seperti Cloudflare, DataDome, Akamai, Imperva, dan sejenisnya, sambil tetap menawarkan pengalaman developer yang modern.
Harga dimulai dari $19/bln pada paket Build (45.000 credit, 20 request paralel). Build sendiri adalah slider — $29 untuk 80.000 credit, $39 untuk 120.000 — dan di atasnya ada Launch di $69/bln untuk 250.000 credit dan 50 request paralel serta Growth di $199/bln untuk 1,2 juta credit; harga tersebut berlaku untuk billing bulanan, dan billing tahunan memberi diskon 17%. Model biayanya berbasis multiplier: rendering JS 5x, premium proxy 10x, dan kalau dipakai bersama-sama menjadi 25x.
Fitur utama:
- Fokus sangat kuat pada situs yang sangat diproteksi
- Dokumentasi dan cakupan anti-bot yang luas
- Ekosistem integrasi modern termasuk LangChain, LlamaIndex, dan MCP
- Menagih hanya request yang berhasil
Kelebihan: Tingkat keberhasilan anti-bot yang sangat bagus pada target sulit.
Kekurangan: Biaya cepat naik pada workload yang diproteksi. Halaman yang butuh rendering JS dan premium proxy sekaligus biayanya 25 credit, bukan 1, jadi paket $19 yang terlihat seperti 45.000 halaman sebenarnya hanya sekitar 1.800 halaman pada target sulit.
Paling cocok untuk: Developer yang meng-scrape target sulit, job monitoring yang sangat anti-bot, tim yang lebih peduli bisa tembus daripada UX spreadsheet.
8. Octoparse
 Octoparse adalah desktop scraper klasik tanpa kode: visual workflow builder dengan eksekusi desktop, cloud scheduling, navigasi browser bawaan, dan permukaan ekspor yang luas. Jika Thunderbit adalah opsi AI-first dengan pendekatan "one-click", Octoparse adalah opsi visual flow-builder untuk pengguna yang ingin memodelkan logika ekstraksi langkah demi langkah.
Harga ternyata lebih kompleks daripada yang terlihat. Help center mencantumkan tarif bulanan — Basic $39/bln, Standard mulai $83/bln, dan Professional $299/bln — sedangkan halaman harga utama default ke billing tahunan, sehingga harga yang ditampilkan menjadi $69/bln untuk Standard dan $249/bln untuk Professional. Itu paket yang sama dengan term penagihan berbeda, bukan daftar harga yang bertentangan; satu-satunya celah nyata adalah Basic, yang sama sekali tidak ditampilkan di halaman harga utama. Jadi, periksa dulu apakah harga yang Anda lihat mengacu pada billing bulanan atau tahunan sebelum membandingkannya dengan apa pun. Halaman harga juga menekankan add-on seperti residential proxy, pemecahan CAPTCHA, setup crawler, dan layanan data yang sepenuhnya dikelola.
Fitur utama:
- Visual workflow builder yang matang
- Ekspor luas: Excel, CSV, JSON, HTML, XML, Google Sheets, database
- Cloud scheduling dan automation bawaan
- Template scraper untuk situs umum
Kelebihan: Tidak perlu coding, cocok untuk scraping berulang skala menengah, opsi ekspor sangat luas.
Kekurangan: Butuh maintenance lebih besar dibanding tool AI-native saat layout berubah (berbasis selector). Situs dinamis atau yang diproteksi masih bisa menimbulkan friksi. UX desktop-first bisa terasa lebih berat daripada tool browser-first.
Paling cocok untuk: Pengguna tanpa kode yang butuh kontrol lebih dari sekadar prompt AI sederhana, scraping berulang skala menengah, tim yang nyaman dengan flow visual.
9. Diffbot
 Diffbot adalah platform ekstraksi AI paling enterprise-grade dalam daftar ini. Nilai jualnya bukan "scrape halaman ini" melainkan "pahami tipe halaman ini dan ubah menjadi data terstruktur dalam skala besar." Produknya meliputi Extract, Crawl, Natural Language, dan Knowledge Graph.
Harga dimulai dari gratis dengan 10.000 credit, lalu $299/bln untuk Startup (250.000 credit), $899 untuk Plus (1.000.000 credit), dan paket enterprise kustom. Satu halaman web yang diekstrak standar memakai satu credit; ekspor record Knowledge Graph jauh lebih mahal.
Fitur utama:
- Pemahaman otomatis yang kuat terhadap tipe halaman (artikel, produk, diskusi)
- Sangat cocok untuk membangun knowledge graph dan pipeline entity
- Ekstraksi berbasis NLP — tanpa selector
- Dukungan premium dan positioning enterprise
Kelebihan: Pemahaman AI yang kuat terhadap struktur halaman, sangat bagus untuk membangun knowledge graph.
Kekurangan: Mahal untuk proyek kecil atau kasual. Workflow DQL dan KG punya kurva belajar. Berlebihan untuk scraping spreadsheet sederhana.
Paling cocok untuk: Enterprise yang membangun dataset terstruktur, proyek knowledge graph dan entity resolution, pipeline ingestion berbasis NLP.
10. Firecrawl
 Firecrawl adalah tool ingestion LLM yang paling developer-native di kelompok ini. Ia mengubah URL menjadi Markdown bersih, HTML, screenshot, atau JSON terstruktur, dan dibangun di atas permukaan API yang sederhana, bukan aplikasi visual.
Harga cukup jelas: gratis dengan 1.000 credit per bulan, Hobby 5.000 credit, Standard 100.000, Growth 500.000, Scale 1.000.000, dan Enterprise di atas itu. Paket entry-level adalah $19/bln, atau $16/bln jika ditagih tahunan.
Fitur utama:
- Output Markdown yang bersih untuk pipeline RAG dan LLM
- Dukungan JSON terstruktur dengan schema atau prompt
- Dokumentasi developer yang bagus dan adopsi open-source yang aktif
- Tier browser concurrent yang kuat pada paket atas
Kelebihan: Dibuat khusus untuk memasok data ke LLM. Harga masuk terjangkau. Output bersih.
Kekurangan: Dibuat untuk developer. Ada playground dan beberapa tool halaman tunggal gratis, tetapi keduanya tidak menjalankan job berulang — apa pun yang ingin Anda jadwalkan, batch, atau hubungkan ke pipeline tetap harus lewat API call atau SDK. Credit kedaluwarsa di akhir bulan pada semua paket di bawah tier Scale $749. Dan ada celah di tengah struktur paket: slider credit-nya meloncat dari 5.000, 6.500, 8.000 halaman per bulan, lalu langsung ke 100.000 — paket Standard $99.
Paling cocok untuk: Pipeline RAG, AI agent, ingestion dan analisis konten.
11. Browse AI
 Browse AI paling tepat dipahami sebagai produk monitoring yang juga bisa scraping, bukan sekadar scraper yang kebetulan bisa monitoring. Kecocokan terkuatnya adalah deteksi perubahan berulang: harga, stok, teks, screenshot, dan perubahan halaman dari waktu ke waktu.
Harga dimulai dengan paket gratis 50 credit per bulan, lalu Personal di $48/bln untuk 2.000 credit dan Professional dengan slider — $87 untuk 5.000 credit, $162 untuk 10.000, hingga $399 untuk 30.000 — dengan Premium dikutip mulai $500/bln pada billing tahunan. Pada billing tahunan, Personal menjadi $19/bln dan Professional $69. Credit dikonsumsi berdasarkan baris dan kompleksitas tugas: satu halaman yang dibuka untuk datanya sendiri adalah satu tugas dengan minimum satu credit, sepuluh baris juga tetap satu credit, dan situs premium biayanya dua hingga sepuluh kali lebih mahal.
Fitur utama:
- Orientasi monitoring dan alerting yang sangat kuat
- Cocok untuk pengecekan harga atau stok berulang
- Integrasi dengan Sheets, Airtable, webhook, dan workflow API
- Setup awal cepat untuk pengguna non-teknis
Kelebihan: Sangat bagus untuk use case "apa yang berubah", setup mudah bagi non-developer.
Kekurangan: Kurang fleksibel dibanding scraper serbaguna pada situs yang asing atau kompleks. Transformasi AI native lebih terbatas dibanding Thunderbit.
Paling cocok untuk: Tim ecommerce yang memantau harga kompetitor, pengguna non-teknis yang butuh alert perubahan.
12. ScrapeHero
 ScrapeHero adalah outlier karena pada dasarnya bukan software tool. Ini adalah layanan scraping terkelola. Anda memberi tahu data apa yang Anda butuhkan, lalu tim mereka membangun, memelihara, melakukan QA, dan mengirimkan dataset-nya.
Harga mencerminkan model layanan: proyek on-demand mulai $550 per situs, paket Business bulanan mulai $199 untuk hingga dua situs dengan 1–5K halaman masing-masing, Enterprise Basic mulai $1.500/bln untuk hingga empat situs dengan halaman yang dibundel di antaranya dan volume tambahan seharga $650–$2.200 per juta, serta Enterprise Premium mulai $8.000. Biaya setup terpisah sebagai sekali bayar pada Business dan Enterprise Basic. Proses delivery mencakup tim proyek khusus, QA manual, dan format kustom.
Fitur utama:
- Hampir tanpa maintenance untuk klien
- QA manusia dan format delivery kustom
- Cocok untuk proyek kompleks lintas banyak situs
- Sikap kepatuhan untuk kebutuhan enterprise
Kelebihan: Zero maintenance, menangani proyek kompleks, layanan white-glove.
Kekurangan: Mahal dibanding tool self-serve. Waktu penyelesaian awal lebih lambat daripada mengerjakannya sendiri. Sama sekali bukan self-serve.
Paling cocok untuk: Enterprise yang mengalihdayakan scraping, tim yang lebih peduli pada hasil daripada kepemilikan tool, proyek kompleks multi-situs yang sering berubah.
Biaya Nyata Layanan Web Scraping di 10K, 100K, dan 1M Halaman
Membandingkan layanan ini dari sisi harga memang tidak mudah karena vendor menagih dalam unit yang berbeda — halaman, record, credit, compute time, baris, atau minimum proyek. Jadi tabel di bawah menampilkan satu angka yang tetap masuk akal setelah diterjemahkan: berapa yang benar-benar ditagihkan ke kartu Anda bulan itu. Setiap angka adalah daftar harga bulanan pada paket termurah yang mencakup volume dalam bentuk halaman biasa — tanpa rendering JavaScript, tanpa premium proxy — dengan allowance gratis bulanan dari vendor sudah dikurangkan. Biaya proxy, add-on CAPTCHA, dan jam engineering tidak dimasukkan ke dalam angka; semuanya disebutkan di kolom terakhir. Jika tidak ada paket publik yang mencapai volume itu, selnya tertulis Custom quote, bukan dipaksa mengikuti paket tertinggi. Dan jika vendor tidak menjual per halaman, selnya menyebut apa yang benar-benar dijual, bukan mengarang harga per halaman.
| Layanan | Free tier | Tagihan bulanan di 10K halaman | Tagihan bulanan di 100K halaman | Tagihan bulanan di 1M halaman | Cara penagihan, dan apa yang tidak termasuk |
|---|---|---|---|---|---|
| Thunderbit API | 600 unit, sekali saja | $72 Pro 1 | $120 Pro 2 | Custom quote | Distill menagih 1 unit per halaman, Extract 20. Unit gratis hanya diberikan sekali di awal, bukan allowance bulanan, jadi tidak ada yang perlu dikurangkan. Self-serve berhenti di 480.000 unit per bulan. |
| Bright Data | 5.000 record/bln | $7,50 untuk 10K record | $142,50 untuk 100K record | $1.293 untuk 1M record | Menagih per record — satu item hasil ekstraksi, satu baris di tabel — bukan per halaman yang dimuat, jadi satu halaman daftar bisa menghasilkan banyak record. 5.000 record gratis dikurangkan dari ketiga skenario. Pada 1M, Scale lebih murah daripada pay-as-you-go: $499 plus 611.000 record tambahan di $1,30/1K. |
| Oxylabs | Trial, 2K hasil | $49 Micro | $249 Advanced | $999 Business | Menagih per hasil yang berhasil dengan tarif yang ditentukan oleh situs target dan tier paket. Jumlah hasil headline mengasumsikan Amazon tanpa rendering JS — pada situs umum dengan $1,15 per 1.000, paket Micro $49 hanya sekitar 42.600 hasil, bukan 98.000. Hasil trial tidak diperbarui, jadi tidak ada yang dikurangkan. |
| Apify | $5 pemakaian/bln | Mulai $29/bln + pemakaian | Mulai $29/bln + pemakaian | Mulai $29/bln + pemakaian | Tidak ditagih per halaman. Biaya paket adalah kredit pemakaian prabayar — Starter $29, Scale $199, Business $999 — yang dipakai untuk compute unit dan Actor Store yang menetapkan harga per hasil sendiri, jadi hitungan halaman saja tidak menentukan tagihan. Proxy adalah add-on terpisah. |
| ScrapingBee | 1.000 credit, sekali | $49 Freelance | $49 Freelance | $99 Startup | 1 credit per request biasa. Rendering JS, premium proxy, screenshot, dan ekstraksi AI masing-masing menghabiskan beberapa credit, jadi target nyata membeli jauh lebih sedikit halaman daripada angka headline. Credit pendaftaran tidak diperbarui, jadi tidak ada yang dikurangkan. |
| ScraperAPI | Trial 7 hari, 5.000 credit | $49 Hobby | $49 Hobby | $149 Startup | 1 credit per request biasa, tetapi 5 di Amazon dan 25 di Google. Di 100K halaman, paket Hobby tepat habis, tanpa sisa untuk retry. Credit trial tidak diperbarui, jadi tidak ada yang dikurangkan. |
| ZenRows | 5.000 credit/bln | $19 Build | $39 Build | $199 Growth | 1 credit per halaman biasa, 25 untuk yang butuh JS plus premium proxy. 5.000 credit gratis dikurangkan dulu — menjadi 5.000, 95.000, dan 995.000 halaman yang bisa ditagih — tetapi tidak mengubah tier yang Anda masuki. |
| Octoparse | Paket gratis, 10 tugas | Mulai $39/bln | Mulai $39/bln | Mulai $39/bln | Dihargai berdasarkan jumlah tugas dan concurrency cloud, bukan per halaman, jadi tidak ada volume halaman yang bisa dipetakan ke tier: Basic $39, Standard $83, Professional $299 untuk billing bulanan. Residential proxy dan CAPTCHA solving dijual sebagai add-on: $3/GB dan $1–1,5 per seribu solve. |
| Diffbot | 10.000 credit/bln | $0, free tier sudah cukup | $299 Startup | $899 Plus | 1 credit per halaman yang diekstrak. 10.000 credit gratis per bulan dikurangkan di sini sama seperti skenario lain: di 10K seluruh bulan tertutup, di 100K masih ada 90.000 halaman untuk dibeli, di 1M ada 990.000. |
| Firecrawl | 1.000 credit/bln | $99 Standard | $99 Standard | $749 Scale | 1 credit per halaman yang di-scrape. Setelah dikurangi credit gratis, masih tersisa 9.000 halaman yang perlu dibeli pada titik 10K, masih melewati Hobby 5.000, jadi tier tidak berubah. Credit tidak rollover di bawah Scale. |
| Browse AI | 50 credit/bln | $162 Professional | Custom quote | Custom quote | Menagih dalam credit: halaman detail adalah satu tugas dengan minimum satu credit, dan sepuluh baris juga tetap satu credit, jadi halaman daftar 50 baris biayanya lima. Situs premium biayanya dua sampai sepuluh kali lebih mahal. Self-serve berhenti di 30.000 credit per bulan, jadi di atas itu dikutip kustom. |
| ScrapeHero | Tidak ada | Mulai $199/bln | Mulai $1.500/bln | Mulai $1.500/bln | Dikutip per situs, kompleksitas, dan frekuensi refresh, bukan per halaman: Business mencakup hingga 2 situs dengan 1–5K halaman masing-masing, Enterprise Basic membundel halaman di hingga 4 situs dan menambah $650–$2.200 per juta ekstra. Biaya setup adalah sekali bayar dan ditagihkan terpisah. |
Beberapa catatan penting:
- Produk browser Thunderbit berbasis baris dan ditujukan untuk pengguna akhir, jadi baris di atas memakai API — dan khususnya endpoint Distill, 1 unit per halaman Markdown, karena itulah yang dipakai baris API lainnya. Structured Extract memakai 20 unit per halaman, yang akan membuat 10K halaman menjadi $240, bukan $72.
- Biaya Apify sangat bergantung pada runtime actor, memori, dan layanan tambahan seperti proxy.
- ZenRows, ScrapingBee, dan ScraperAPI terlihat murah pada halaman publik sederhana, tetapi cepat menjadi mahal begitu rendering JS, premium proxy, atau target yang sangat anti-bot ikut terlibat.
- Unit economics ScrapeHero berbeda karena Anda membayar engineering, QA, dan project management — bukan hanya compute.
Biaya tersembunyi yang hampir selalu diremehkan oleh halaman harga adalah maintenance. Biaya proxy saja memang terlihat lebih murah di atas kertas, tetapi begitu Anda memasukkan retry, pemeliharaan parser, sesi yang diblokir, dan jam engineering, layanan scraping bundling sering kali menang dalam total cost of ownership.
Jika Anda hanya scraping sesekali, sisi tanpa kode lebih murah untuk memulai: free plan Thunderbit mencakup 6 halaman per bulan, dan paket browser berbayarnya mulai dari $15/bln, atau sekitar $9/bln pada penagihan tahunan. Layanan API di sini tidak semuanya lebih mahal di pintu masuk — ZenRows dan Firecrawl sama-sama mulai $19/bln — tetapi blok terkecil yang mereka jual tetap ribuan halaman per bulan, jadi Anda membayar kapasitas yang belum tentu terpakai. Untuk pipeline enterprise di 1 juta+ halaman, platform full-stack atau managed service lebih masuk akal secara ekonomi meskipun harga labelnya lebih tinggi, karena biaya proxy sudah dibundel.
Data Hasil Scraping Anda Masuk ke Mana? Perbandingan Ekspor dan Integrasi
JSON tidak sama dengan Google Sheets. Bagi pengguna non-developer, tujuan akhir data hasil scraping sama pentingnya dengan proses ekstraksinya.
| Layanan | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Native | ✅ Native | ✅ Native | API tersedia |
| Bright Data | ✅ | ✅ | ❌ Tidak native | Tidak langsung | Tidak langsung | Tidak langsung | API/webhook kuat |
| Oxylabs | ✅ | ✅ | ❌ Tidak native | Tidak langsung | Tidak langsung | Tidak langsung | API kuat |
| Apify | ✅ | ✅ | ✅ | Lewat integrasi | Lewat integrasi | Lewat integrasi | API kuat |
| ScrapingBee | Lewat tooling | ✅ | ❌ | ❌ | ❌ | ❌ | API kuat |
| ScraperAPI | ✅ pada structured endpoints | ✅ | ❌ | ❌ | ❌ | ❌ | API/webhook kuat |
| ZenRows | Terbatas | ✅ | ❌ | ❌ | ❌ | ❌ | API kuat |
| Octoparse | ✅ | ✅ | ✅ | ✅ Native | ⚠️ Lewat Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Workflow didukung | Tidak langsung | Tidak langsung | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Native | ✅ Native | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Delivery kustom | Delivery kustom | Delivery kustom | Delivery API/DB kustom |
Ini adalah salah satu keunggulan paling jelas Thunderbit. Jika Anda adalah tim bisnis yang hidup di Google Sheets atau Notion, layanan API-only menambah langkah ekstra: menulis kode untuk mengubah JSON, mengunggah manual, lalu mengulang. Ekspor gratis Thunderbit ke Sheets, Airtable, dan Notion — termasuk upload gambar ke Notion dan Airtable — menghapus friksi itu sepenuhnya. Dikombinasikan dengan scheduled scraping, data bisa mengalir otomatis ke tujuan tertentu secara berkala tanpa perlu glue code.
Apa yang Terjadi Saat Situs Berubah? Maintenance dan Reliabilitas
Scraper pasti rusak. Itulah masalah nomor satu di pasar ini.
Pasar terbagi menjadi tiga profil maintenance:
- Tool berbasis selector (Octoparse, banyak actor Apify, template Browse AI): rusak saat situs mengubah layout, perlu update aturan manual.
- Layanan API dengan abstraksi parser (structured endpoint ScraperAPI, structured dataset Bright Data): bekerja baik di situs umum, tetapi kesulitan di halaman long-tail atau niche yang parser-nya belum dibuat.
- Tool berbasis AI (Thunderbit, Firecrawl, Diffbot): membaca halaman dari awal setiap kali dijalankan, jadi sebagian besar perubahan layout tidak membutuhkan update aturan. Mode gagalnya bergeser dari "selector rusak" menjadi "AI salah menafsirkan" — dan itu biasanya lebih mudah diperbaiki dengan tweak prompt daripada menulis ulang selector sepenuhnya.
Ada satu bottleneck reliabilitas lagi selain drift layout: penanganan anti-bot.
- Bright Data, Oxylabs, dan ZenRows adalah yang terkuat di sini.
- ScraperAPI dan ScrapingBee cukup solid untuk target umum yang diproteksi.
- Browse AI dan Octoparse lebih sering mengalami masalah pada situs dinamis yang sangat diproteksi.
- Mode browser Thunderbit membantu pada halaman login dan halaman yang dipersonalisasi, tempat tool API-only sering menambah kompleksitas.
Kesimpulannya: jika Anda ingin beban maintenance serendah mungkin, ekstraksi berbasis AI (Thunderbit, Firecrawl, Diffbot) lebih tahan terhadap perubahan layout dibanding tool berbasis selector. Jika kekhawatiran utama Anda adalah perlindungan anti-bot, Bright Data, Oxylabs, dan ZenRows adalah opsi terkuat. Kebanyakan tim menghadapi kedua masalah itu sekaligus, itulah sebabnya keputusan "jenis mana yang cocok untuk tim Anda" di awal artikel ini lebih penting daripada perbandingan fitur individual mana pun.
Pertimbangan Legal dan Etis untuk Web Scraping
Mengambil data yang tersedia publik sering kali legal, tetapi itu tidak berarti setiap use case aman. Tim tetap perlu menghormati robots.txt bila relevan, memeriksa terms of service, dan mematuhi hukum privasi seperti GDPR dan CCPA ketika data pribadi terlibat. Rangkaian kasus hiQ v. LinkedIn mendukung gagasan bahwa scraping data publik tidak otomatis melanggar CFAA di AS, tetapi isu kontrak, hak cipta, dan privasi tetap menjadi risiko tersendiri. Vendor enterprise seperti Bright Data, Oxylabs, dan ScrapeHero secara eksplisit memasarkan fitur kepatuhan dan governance. Untuk yang lain: dapatkan nasihat hukum yang spesifik untuk use case Anda sebelum melakukan scraping skala besar. Untuk latar belakang lebih lanjut, lihat panduan kami tentang implikasi legal web scraping.
Layanan Web Scraping Mana yang Sebenarnya Harus Anda Pilih?
Cukup tabel perbandingan. Berikut versi singkat setelah menguji semua 12:
Tim bisnis non-teknis (sales, ops, marketing): Thunderbit. Scraping AI satu klik, ekspor gratis ke Sheets/Airtable/Notion, dan jauh lebih sedikit pekerjaan ulang saat situs mengubah layout. Ia menghilangkan dua sumber friksi terbesar — kompleksitas setup dan friksi ekspor setelah scraping — sekaligus.
Developer yang membangun pipeline scraping:
- ScrapingBee jika Anda menginginkan UX API paling bersih
- ScraperAPI jika Anda menginginkan structured endpoint dan monitoring ecommerce berulang
- ZenRows jika masalah utama Anda adalah perlindungan anti-bot
Tim yang memasok data ke workflow AI/LLM:
- Firecrawl jika output Anda harus Markdown atau JSON berbasis schema
- Thunderbit API jika tim yang sama juga butuh jalur tanpa kode, karena ekstensi dan API menjalankan model ekstraksi yang sama
- Diffbot jika Anda membangun lapisan knowledge enterprise
Enterprise yang butuh skala besar + infrastruktur proxy:
- Bright Data untuk stack enterprise terluas
- Oxylabs jika reliabilitas pada target yang diproteksi adalah yang paling penting
Tim yang menginginkan marketplace scraper siap pakai: Apify.
Perusahaan yang ingin delivery tanpa repot: ScrapeHero.
Tim hemat biaya yang butuh monitoring tanpa kode: Browse AI.
Pengguna tanpa kode yang menginginkan visual desktop builder dengan kontrol manual lebih besar: Octoparse.
Untuk cakupan pengguna bisnis terluas, Thunderbit tetap menang karena ia menghapus dua penghambat yang paling sering membunuh adopsi: setup teknis dan friksi ekspor. Coba free tier atau pasang ekstensi Chrome untuk melihat sendiri. Dan kalau Thunderbit bukan pilihan yang pas, coba beberapa opsi lain dari daftar ini — tidak pernah ada waktu yang lebih baik untuk berhenti copy-paste manual. Untuk panduan video tentang cara kerja tool-tool ini dalam praktik, lihat channel YouTube Thunderbit.
Coba ekstensi Chrome Thunderbit
FAQ
Apa itu layanan web scraping?
Layanan web scraping adalah tool atau penyedia terkelola yang mengumpulkan data dari website untuk Anda. Sebagiannya berupa aplikasi tanpa kode yang dijalankan di browser, sebagiannya API untuk developer, dan sebagiannya lagi agensi full-managed yang mengirimkan data bersih tanpa Anda perlu mengoperasikan infrastruktur apa pun.
Apakah saya perlu skill coding untuk memakai layanan web scraping?
Tidak selalu. Tool seperti Thunderbit, Browse AI, dan Octoparse dibuat untuk pengguna non-teknis. Layanan API seperti ScrapingBee, ScraperAPI, Firecrawl, dan ZenRows mengasumsikan keterlibatan developer. ScrapeHero berada di ujung lain — tim mereka yang menjalankan seluruh proyek untuk Anda.
Layanan web scraping mana yang terbaik untuk bisnis kecil?
Untuk kebanyakan bisnis kecil, Thunderbit adalah rekomendasi paling aman. Ia punya free plan yang tidak kedaluwarsa (6 halaman per bulan), friksi setup yang rendah, dan ekspor langsung ke tujuan bisnis yang familiar seperti Google Sheets, Airtable, dan Notion. Browse AI juga cocok jika use case utamanya adalah memantau perubahan dari waktu ke waktu.
Berapa biaya layanan web scraping?
Rentangnya sangat lebar. Beberapa layanan menawarkan free tier atau trial. API developer dalam daftar ini mulai dari sekitar $19 hingga $49 per bulan, dan platform AI enterprise jauh lebih mahal — Diffbot mulai $299. Tool tanpa kode mulai sekitar $15 hingga $48 per bulan. Layanan enterprise dan managed service bisa cepat masuk ke ratusan atau ribuan dolar per bulan. Cerita biaya yang lebih besar bukan cuma harga langganan, tetapi juga multiplier untuk rendering JS, premium proxy, dan waktu internal yang dibutuhkan agar scraper tetap berjalan.
Apakah layanan web scraping legal digunakan?
Umumnya ya untuk data publik, tetapi legalitas tergantung pada situsnya, jenis datanya, yurisdiksi Anda, dan apa yang Anda lakukan dengan output-nya. Privasi, hak cipta, dan isu kontrak tetap penting, bahkan ketika scraping halaman publik. Konsultasikan panduan hukum untuk use case spesifik Anda.
Coba Thunderbit untuk AI web scraping Get Started Free
Pelajari Lebih Lanjut



