
Web itu penuh data, dan jujur saja—tidak ada orang yang punya waktu buat copy-paste ribuan listing produk atau halaman harga kompetitor satu per satu. Kalau Anda pakai Linux (seperti saya untuk sebagian besar pekerjaan otomasi dan development), Anda pasti tahu platform ini jadi andalan buat tim yang bergantung pada data. Faktanya, sistem keluarga Unix menjalankan 91,9% website yang sistem operasinya diketahui, dengan Linux sebagai varian terbesar secara jauh. Tapi tantangannya begini: menemukan web scraper untuk Linux yang benar-benar pas dengan alur kerja Anda—baik Anda pengguna bisnis non-teknis maupun developer hardcore—sering rasanya seperti cari jarum di tumpukan jerami.
Karena itu, saya menyusun ulasan mendalam tentang 18 alat web scraping Linux terbaik untuk 2026 ini. Dari solusi AI tanpa kode seperti Thunderbit (ya, yang dibangun oleh tim saya dan saya) sampai framework klasik untuk developer seperti Scrapy dan Beautiful Soup, daftar ini jadi jalan pintas Anda untuk memilih web scraper Linux terbaik sesuai kebutuhan—tanpa drama coba-coba yang capek.
Mengapa Alat Web Scraping Linux Penting untuk Pengguna Bisnis
Hindari Copy-Paste Sebelum Anda Memilih Alat Thunderbit berjalan di Chrome pada desktop Linux Anda — tanpa paket, tanpa driver, cukup jadi tabel rapi dalam 1 klik. Get Started Free
Mari realistis: pengumpulan data manual itu benar-benar pembunuh produktivitas. Studi menunjukkan tim yang masih mengandalkan copy-paste membuang waktu berjam-jam tiap minggu dan menghadapi tingkat kesalahan mendekati 5%—itu resep pasti untuk kesalahan mahal dan peluang yang kelewat (Thunderbit Blog). Linux, dengan stabilitas, keamanan, dan fleksibilitasnya, jadi platform pilihan untuk menjalankan scraper yang harus kerja 24/7—baik di desktop, server, maupun cloud.
Contoh penggunaan bisnis yang umum untuk alat web scraping Linux:
- Lead Generation: Tim sales mengekstrak direktori, media sosial, atau situs ulasan untuk dapat kontak baru tanpa kerja manual yang bikin pegal (Thunderbit Blog).
- Pemantauan Harga: Tim e-commerce menarik data harga dan stok kompetitor secara otomatis supaya penetapan harga tetap tajam dan selalu update.
- Riset Kompetitor: Tim marketing dan operasional memantau peluncuran produk, ulasan, dan keyword SEO—jadi tidak lagi kerja “nggak jelas arahnya”.
- Intelligence Pasar: Analis menggabungkan data berita, forum, dan media sosial untuk menangkap tren secara real-time.
- Automasi Workflow: Beberapa alat (terutama yang berbasis AI) bahkan bisa mengotomatisasi alur kerja web, seperti mengisi formulir atau menavigasi dashboard, langsung dari mesin Linux Anda.
Kabar baiknya? Alat web scraping Linux yang tepat bisa memberdayakan pengguna non-teknis—bukan cuma programmer—untuk memanfaatkan data web demi keputusan bisnis yang lebih cepat dan cerdas.
Cara Kami Memilih Web Scraper Terbaik untuk Linux
Tidak semua scraper dibuat sama, apalagi di Linux. Ini yang saya jadikan acuan:
- Kompatibilitas Linux: Semua alat di sini berjalan secara native di Linux, lewat browser, atau dengan workaround sederhana (seperti Wine atau akses cloud).
- Kemudahan Penggunaan: Dari prompt AI berbasis bahasa alami sampai antarmuka visual point-and-click, saya memprioritaskan alat yang memungkinkan non-coder dapat hasil cepat—tapi tetap mempertimbangkan power user yang ingin kontrol penuh.
- Kekuatan Ekstraksi Data: Apakah alat ini mampu menangani konten dinamis, pagination, subpage, dan berbagai jenis data? Apakah tahan terhadap trik anti-scraping?
- Skalabilitas & Automasi: Penjadwalan, cloud scraping, distributed crawling—ini wajib untuk proyek data yang serius.
- Integrasi & Ekspor: CSV, Excel, Google Sheets, API—kalau datanya tidak bisa dikeluarkan, buat apa?
- Harga & Lisensi: Gratis, open-source, atau berbayar—ada opsi buat setiap anggaran, dari founder solo sampai tim enterprise.
- Komunitas & Dukungan: Basis pengguna yang aktif, dokumentasi yang bagus, dan dukungan yang responsif sangat membantu saat ada masalah.
Saya juga menggabungkan feedback pengguna nyata, ulasan industri, dan pengalaman langsung saya memakai alat-alat ini. Yuk, langsung masuk ke daftarnya.
1. Thunderbit
 Thunderbit adalah pilihan utama saya untuk pengguna bisnis yang ingin web scraper untuk Linux yang benar-benar gampang dipakai. Sebagai ekstensi Chrome berbasis AI, Thunderbit berjalan mulus di Linux (cukup buka Chrome atau Chromium) dan memungkinkan Anda mengekstrak data dari situs apa pun hanya dengan satu klik.
Yang membuat Thunderbit menonjol:
- Prompt Bahasa Alami: Cukup jelaskan apa yang Anda mau (“Ekstrak semua nama produk dan harganya dari halaman ini”) dan AI Thunderbit akan mengurus sisanya.
- AI Suggest Fields: Klik sekali, Thunderbit memindai halaman dan menyarankan kolom serta tipe data—tanpa pilih field manual.
- Scraping Subpage & Pagination: Butuh detail lebih dalam? Thunderbit bisa membuka tiap subpage (misalnya halaman detail produk) dan memperkaya tabel Anda otomatis.
- Cloud atau Local Scraping: Ambil hingga 50 halaman sekaligus di cloud, atau pakai mode browser untuk situs yang butuh login.
- Ekspor Instan: Ekspor satu klik ke Excel, Google Sheets, Airtable, Notion, CSV, atau JSON—selalu gratis.
- Fitur Bonus: Ekstrak email, nomor telepon, dan gambar dalam satu klik. AI autofill juga bisa mengotomatisasi input formulir.
Harga: Paket gratis (6 halaman/bulan), paket berbayar mulai dari $15/bulan untuk 500 baris (Thunderbit Pricing). Pengguna suka pengalaman yang “tanpa kurva belajar” dan bagaimana alat ini “mengubah pekerjaan berjam-jam jadi menit” (Product Hunt Reviews). Untuk pekerjaan besar, mungkin Anda perlu membaginya jadi beberapa run kecil, tapi untuk sebagian besar kebutuhan bisnis, alat ini sangat hemat waktu.
Kompatibilitas Linux: 100%. Cukup jalankan Chrome/Chromium di desktop atau server Linux Anda.
Cocok untuk: Pengguna bisnis non-teknis (sales, marketing, operasional) yang ingin setup paling cepat dan paling gampang.
Coba Thunderbit Gratis di Linux Berjalan di Chrome pada desktop Linux apa pun — tanpa paket untuk dibangun, tanpa driver untuk dipasang, cukup 1 klik untuk mengekstrak. Get Started Free
2. Scrapy
 Scrapy adalah standar emas untuk developer Python yang menginginkan web scraper Linux yang fleksibel dan skalabel. Open-source, super cepat (asynchronous crawling), dan mampu menangani semuanya mulai dari scraping sederhana sampai crawl terdistribusi skala besar.
Fitur utama:
- Crawling asinkron dengan kecepatan tinggi—pas untuk scraping ribuan halaman.
- Sangat extensible: Plugin untuk proxy, CAPTCHA, dan lain-lain.
- Terintegrasi dengan ekosistem data Python: Output ke JSON, CSV, database, atau pandas.
- Menangani cookies, session, dan auto-throttling.
Harga: 100% gratis dan open-source.
Kompatibilitas Linux: Native (instal via pip). Jalan sangat baik di server dan container.
Cocok untuk: Developer yang membangun scraper custom skala besar.
Catatan: Ada kurva belajar untuk non-coder, tapi kalau Anda paham Python, Scrapy sulit dikalahkan.
3. Beautiful Soup
 Beautiful Soup adalah library Python ringan untuk parsing HTML dan XML. Ini jadi andalan buat scraping cepat atau membersihkan halaman web yang berantakan.
Fitur utama:
- API sederhana dan gampang dipahami—cocok untuk pemula.
- Pas dipasangkan dengan requests untuk mengambil halaman.
- Menangani HTML yang rusak dengan baik.
Harga: Gratis dan open-source.
Kompatibilitas Linux: 100% (pure Python).
Cocok untuk: Developer dan data scientist yang mengerjakan parsing atau scraping kecil hingga menengah.
Keterbatasan: Tidak menangani JavaScript atau konten dinamis—gabungkan dengan Selenium atau Puppeteer kalau Anda membutuhkannya.
4. Selenium
 Selenium adalah framework klasik untuk otomasi browser. Anda bisa mengontrol Chrome, Firefox, atau browser lain untuk scraping situs dinamis yang berat JavaScript.
Fitur utama:
- Mengotomatisasi browser sungguhan—bisa login, klik, scroll, dan berinteraksi seperti manusia.
- Mendukung Python, Java, C#, dan lainnya.
- Mode headless untuk dijalankan di server Linux.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Dukungan penuh (cukup pasang browser driver yang sesuai).
Cocok untuk: QA engineer, developer scraping, dan siapa pun yang perlu meniru perilaku pengguna.
Catatan: Cukup boros resource dan lebih lambat daripada scraper HTTP murni, tapi kadang itu satu-satunya cara buat dapat data yang dibutuhkan.
5. Puppeteer
 Puppeteer adalah library Node.js dari Google untuk mengendalikan headless Chrome/Chromium. Mirip Selenium, tapi dengan API JavaScript modern dan integrasi yang erat dengan fitur Chrome.
Fitur utama:
- Menjalankan JavaScript, menangani konten dinamis, dan mengambil screenshot.
- Cepat, stabil, dan mudah dipakai oleh developer Node.js.
- Bisa mencegat request jaringan dan memblokir resource yang tidak diperlukan.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Menginstal Chromium otomatis; default-nya headless.
Cocok untuk: Developer yang scraping web app modern atau situs single-page.
6. Octoparse
 Octoparse adalah web scraper tanpa kode dengan antarmuka drag-and-drop dan banyak template siap pakai. Walaupun aplikasi desktop-nya cuma untuk Windows/Mac, pengguna Linux bisa mengakses platform cloud Octoparse lewat browser atau menjalankan aplikasi Windows dengan Wine.
Fitur utama:
- 100+ template scraping siap pakai untuk situs seperti Amazon, eBay, Zillow, dan lainnya.
- Visual workflow designer—point and click untuk membangun scraper.
- Cloud scraping dan scheduling—biarkan server Octoparse yang kerja berat.
- Ekspor ke Excel, CSV, JSON, dan database.
Harga: Paket gratis (10 task, sekitar 50K baris/bulan). Paket berbayar mulai dari $69/bulan untuk paket Standard (ditagih tahunan); Professional $249/bulan. (Octoparse Pricing)
Kompatibilitas Linux: Akses cloud/web; aplikasi desktop via Wine.
Cocok untuk: Non-coder yang butuh data e-commerce atau marketplace dengan cepat.
7. PhantomJS
 PhantomJS adalah browser WebKit headless yang dulu jadi andalan untuk otomasi browser ringan. Sekarang sudah deprecated, tapi masih bisa dijalankan di Linux untuk tugas legacy atau sederhana.
Fitur utama:
- Dapat diprogram dengan JavaScript.
- Menangani JavaScript tingkat menengah dan mengambil screenshot/PDF.
- Tidak perlu GUI.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Binary native.
Cocok untuk: Proyek legacy atau lingkungan yang tidak memungkinkan instal Chrome.
Catatan penting: Secara resmi deprecated pada 2017 dan pengembangannya dihentikan pada Maret 2018; rilis terakhir adalah v2.1.1. Tidak ada patch keamanan, tidak ada mesin JS modern, dan banyak situs modern tidak kompatibel. Untuk proyek baru, pakai Puppeteer atau Playwright. Alat ini tetap saya cantumkan karena sering muncul di stack scraping Linux lawas yang mungkin Anda warisi.
8. ParseHub
 ParseHub adalah web scraper visual lintas platform dengan aplikasi native untuk Linux. Cocok untuk non-coder yang ingin scraping situs kompleks dan dinamis.
Fitur utama:
- Antarmuka point-and-click—pilih elemen, bangun workflow secara visual.
- Menangani konten dinamis, maps, infinite scroll, dan lainnya.
- Eksekusi cloud dan scheduling.
- Ekspor ke CSV, JSON, atau lewat API.
Harga: Paket gratis (5 proyek), paket berbayar mulai dari $189/bulan.
Kompatibilitas Linux: Aplikasi native untuk Linux, Windows, Mac.
Cocok untuk: Analis dan pengguna semi-teknis yang ingin kontrol tanpa coding.
9. Kimurai
 Kimurai adalah framework web scraping Ruby yang mendukung Linux secara native. Mirip Scrapy, tapi untuk developer Ruby.
Fitur utama:
- Dukungan multi-browser: Headless Chrome, Firefox, PhantomJS, atau HTTP biasa.
- Pemrosesan asinkron untuk concurrency tinggi.
- Ruby DSL yang rapi untuk menulis spider.
Harga: Gratis dan open-source.
Kompatibilitas Linux: 100% (Ruby).
Cocok untuk: Developer Ruby atau tim Rails yang butuh scraping custom dengan concurrency tinggi.
10. Apify
 Apify adalah platform web scraping berbasis cloud dengan SDK open-source dan marketplace berisi “actor” siap pakai. Anda bisa menjalankan scraper di mesin Linux Anda atau di cloud.
Fitur utama:
- SDK untuk Node.js, Python, dan lainnya.
- Marketplace scraper siap pakai.
- Eksekusi cloud, scheduling, dan integrasi API.
Harga: Paket gratis, bayar sesuai pemakaian untuk cloud.
Kompatibilitas Linux: CLI/SDK berjalan di Linux; platform cloud dapat diakses lewat browser.
Cocok untuk: Developer yang ingin kombinasi coding custom dan infrastruktur cloud yang siap pakai.
11. Colly
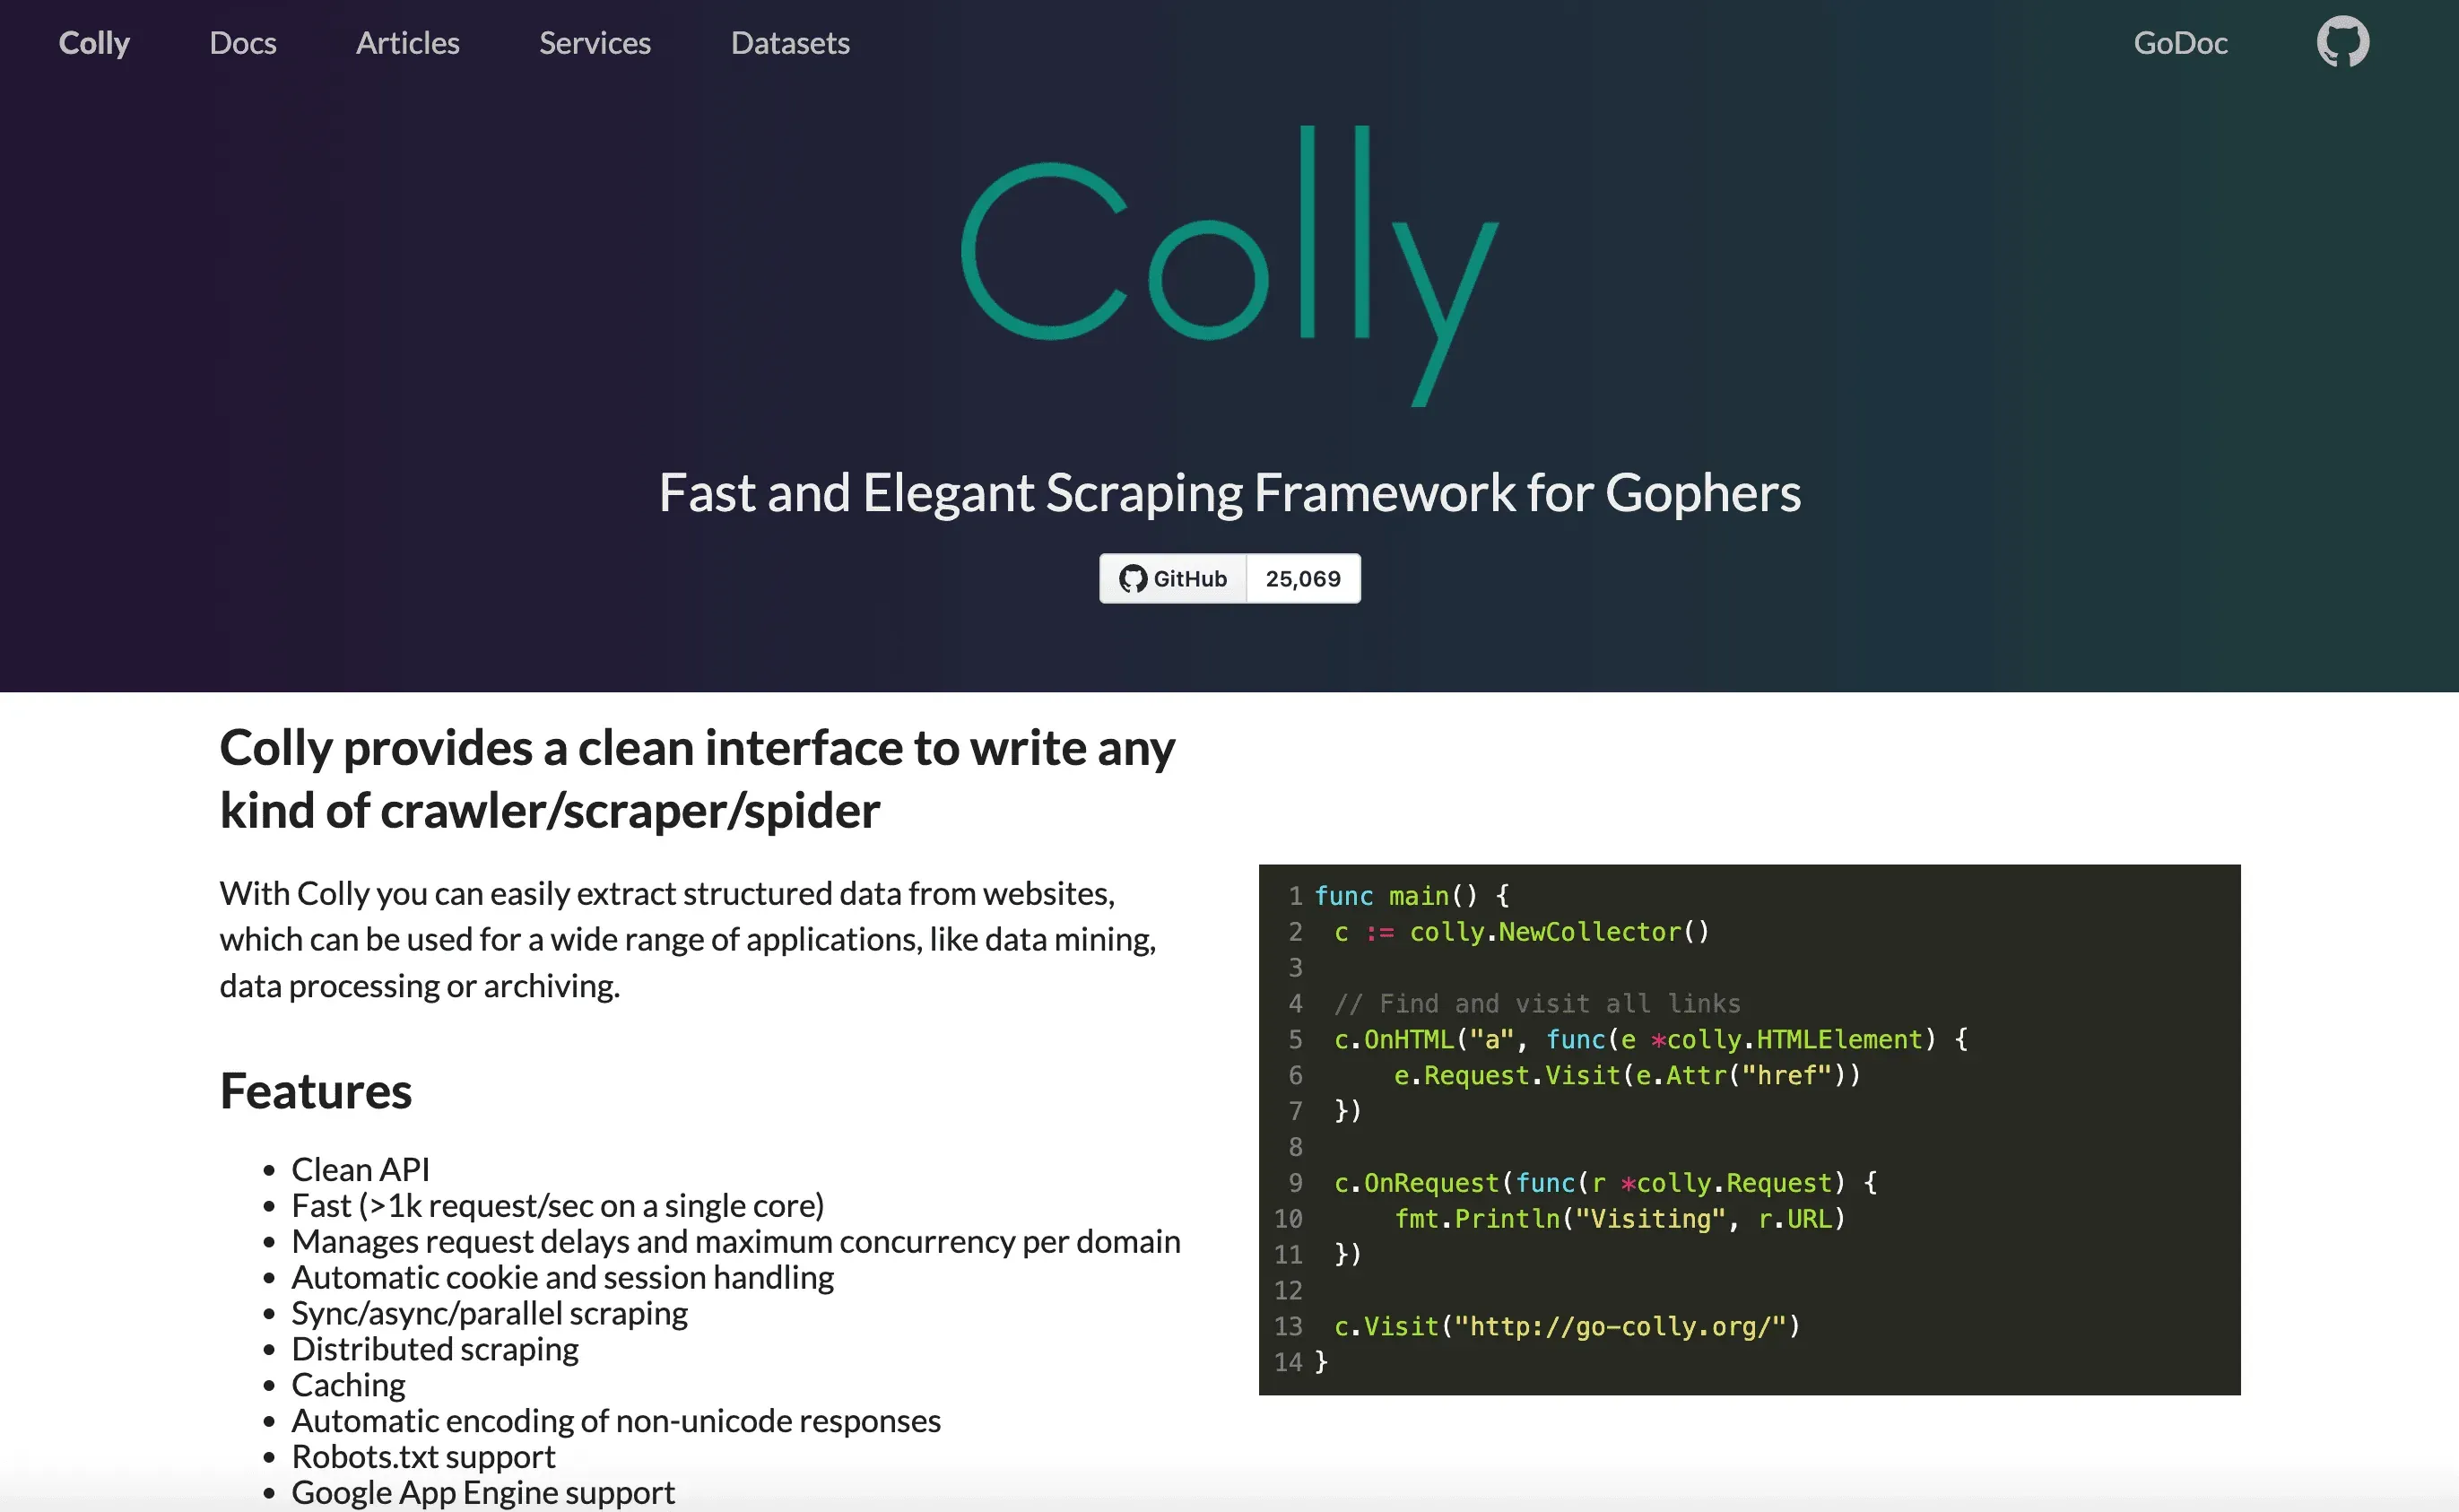 Colly adalah framework web scraping berbasis Go yang dibangun untuk kecepatan dan efisiensi. Kalau Anda developer Go, ini alat yang tepat.
Fitur utama:
- Scraping super cepat dan concurrent—lebih dari 1.000 request/detik di satu core.
- Crawling yang sopan (mematuhi robots.txt), manajemen session/cookie.
- Jejak memori rendah.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Binary native Go.
Cocok untuk: Developer Go yang butuh scraping performa tinggi.
12. PySpider
 PySpider adalah sistem web crawler Python dengan UI web — Anda bisa mengelola, menjadwalkan, dan memantau crawl dari browser. Perlu dicatat dari awal: repositorinya sudah ditandai sebagai public archive di GitHub dan author aslinya sudah tidak merilis update baru, jadi statusnya ya memang apa adanya. Kalau Anda cuma butuh pola UI/dashboard-nya di Linux, alat ini masih bisa jalan; untuk sesuatu yang ingin Anda andalkan jangka panjang, anggap ini legacy.
Fitur utama:
- Antarmuka berbasis web untuk scripting dan monitoring.
- Distributed crawling, scheduling, dan retry.
- Terintegrasi dengan database dan message queue.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Dirancang untuk deployment di Linux.
Cocok untuk: Tim yang nyaman melakukan fork dan memelihara sendiri UI web untuk scraping multi-proyek (jangan berharap perbaikan dari upstream).
13. WebHarvy
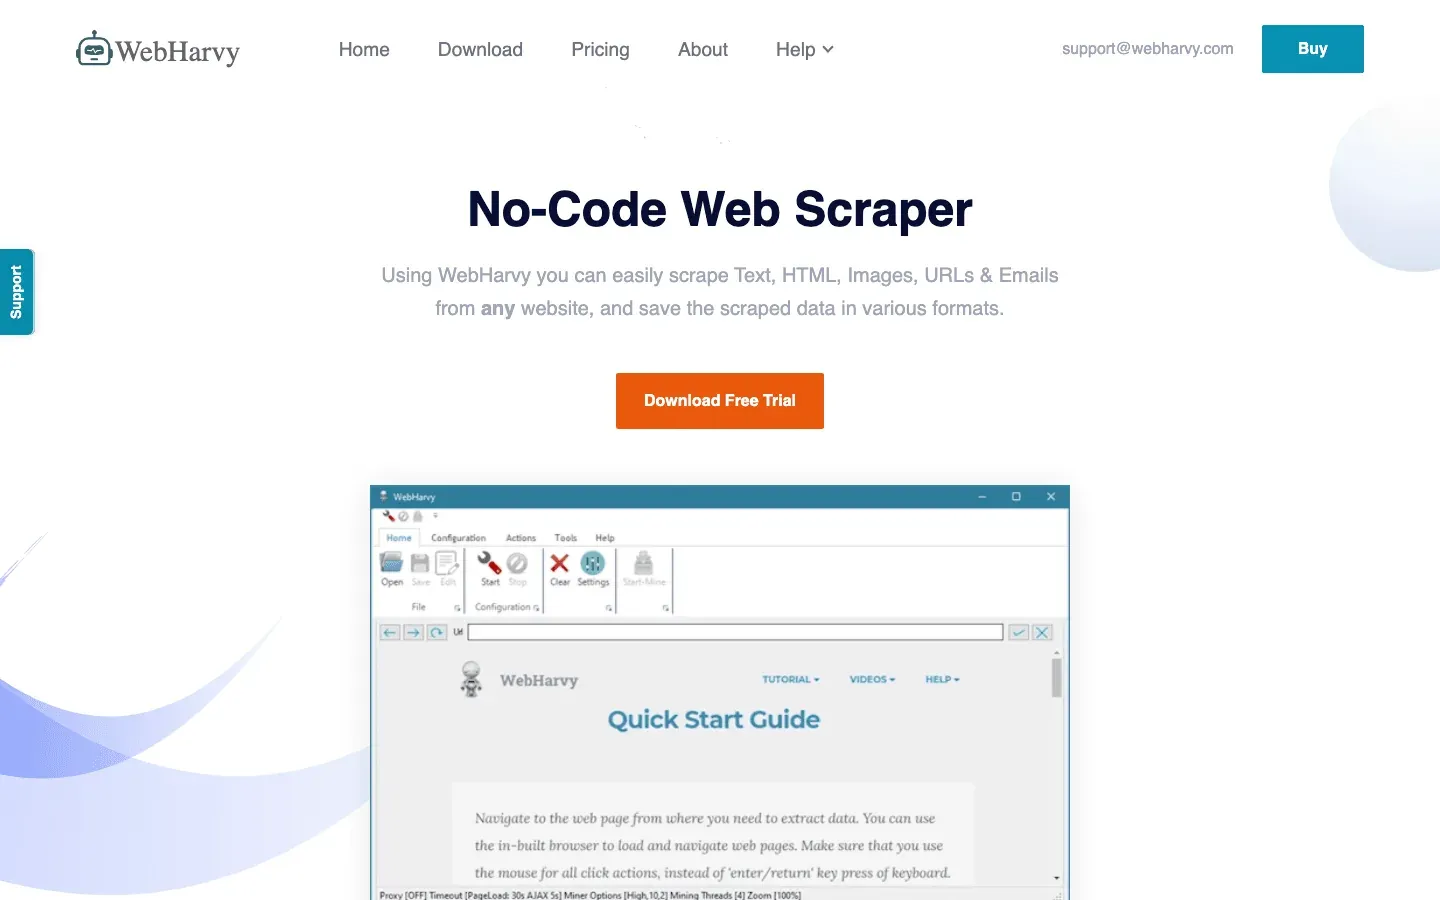 WebHarvy adalah scraper visual point-and-click untuk Windows, tetapi pengguna Linux bisa menjalankannya lewat Wine. Alat ini terkenal karena deteksi polanya dan model pembelian satu kali.
Fitur utama:
- Browse dan klik untuk memilih data—tanpa coding.
- Deteksi pola otomatis untuk daftar.
- Ekspor ke CSV, JSON, XML, SQL.
Harga: Lisensi satu kali sekitar $129.
Kompatibilitas Linux: Berjalan di bawah Wine atau VM.
Cocok untuk: Pemula atau profesional solo yang menginginkan scraper visual yang cepat.
14. OutWit Hub
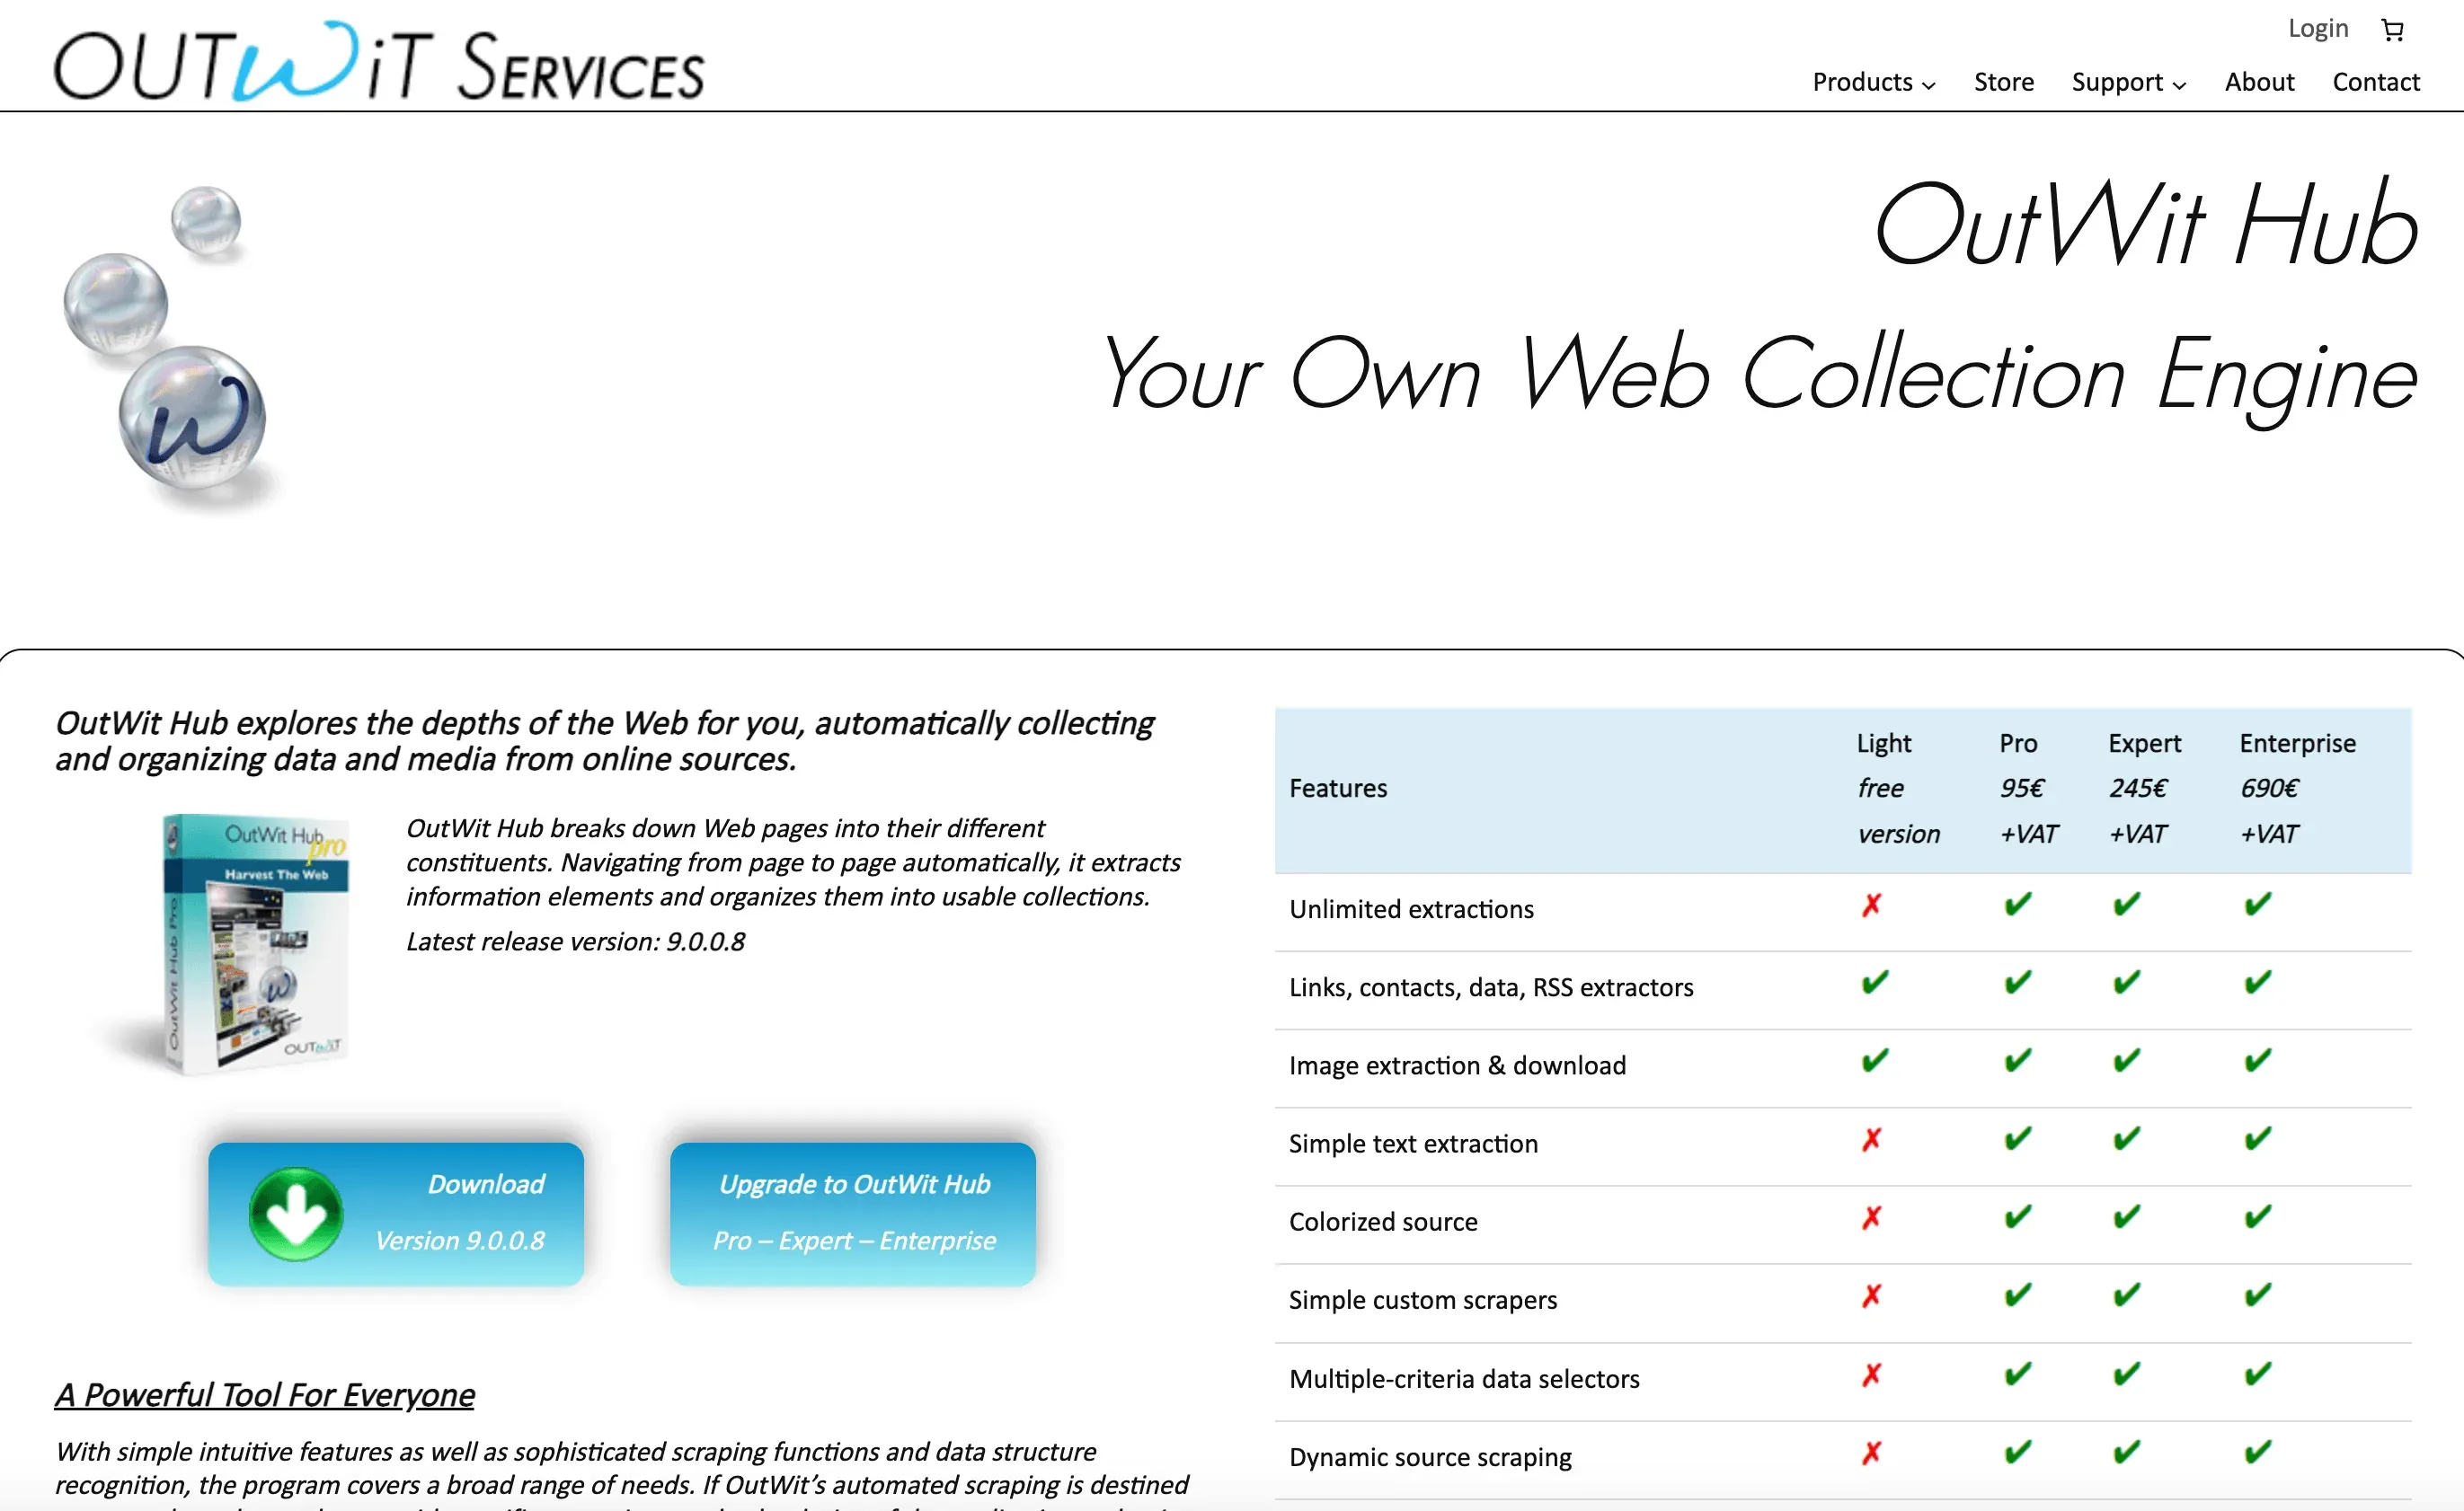 OutWit Hub adalah aplikasi GUI native Linux untuk web scraping. Alat ini mengenali pola data secara otomatis dan menawarkan fitur ekstraksi serta automasi yang kuat.
Fitur utama:
- Mendeteksi otomatis link, gambar, tabel, email, dan lainnya.
- Editor skrip untuk ekstraksi custom.
- Otomasi macro dan scheduling.
Harga: Versi gratis (terbatas); lisensi Pro berbayar — cek toko vendor untuk harga terbaru.
Kompatibilitas Linux: Aplikasi native untuk Linux, Windows, Mac.
Cocok untuk: Non-coder dengan sedikit latar teknis yang ingin scraper GUI desktop.
15. Portia
 Portia adalah web scraper visual open-source dari Scrapinghub. Alat ini berjalan di browser dan memungkinkan Anda memberi anotasi pada halaman untuk melatih scraper — tapi perlu dicatat, repositorinya sudah lebih dari setahun tidak dapat pembaruan berarti, jadi posisinya sekarang masuk kategori "gunakan dengan risiko sendiri". Kalau Anda mau ide anotasi visual dengan dukungan pengembangan yang aktif, ParseHub atau Thunderbit adalah pilihan yang lebih rapi.
Fitur utama:
- Antarmuka berbasis browser untuk ekstraksi visual.
- Terintegrasi dengan Scrapy untuk proyek custom.
- Open-source dan extensible.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Berbasis browser; bekerja di OS apa pun.
Cocok untuk: Pengguna yang menginginkan scraping visual open-source dengan integrasi Scrapy.
16. Sequentum Enterprise (sebelumnya Content Grabber)
 Sequentum Enterprise adalah visual scraper kelas enterprise untuk Windows, tapi bisa dijalankan di Linux lewat Wine atau virtualisasi.
Fitur utama:
- Visual editor plus scripting C# untuk logika lanjutan.
- Manajemen banyak agen dan scheduling.
- Terintegrasi dengan database, API, dan lainnya.
Harga: Lisensi enterprise, harga berdasarkan penawaran per deployment.
Kompatibilitas Linux: Via Wine atau VM.
Cocok untuk: Agency dan tim besar yang mengelola banyak proyek scraping.
17. Helium
 Helium adalah library Python yang menyederhanakan otomasi Selenium. Alat ini dibuat supaya scripting browser terasa lebih natural dan enak dibaca.
Fitur utama:
- Perintah intuitif seperti
click("Login")atauwrite("email"). - Mengotomatisasi Chrome dan Firefox.
- Sangat cocok untuk scripting cepat dan tugas automasi.
Harga: Gratis dan open-source.
Kompatibilitas Linux: Berfungsi di Linux (dibangun di atas Selenium).
Cocok untuk: Pengguna Python yang merasa Selenium terlalu ribet.
18. Dexi.io
 Dexi.io adalah platform ekstraksi data dan automasi berbasis cloud. Karena bisa diakses lewat browser, pengguna Linux dapat memakainya tanpa instalasi apa pun.
Fitur utama:
- Visual workflow designer untuk scraping dan automasi.
- Scheduling, transformasi data, dan integrasi API.
- Skalabilitas dan dukungan kelas enterprise.
Harga: Kini dijual melalui Mozenda: uji coba gratis 14 hari, Pilot $500/bulan, enterprise berdasarkan penawaran.
Kompatibilitas Linux: Aplikasi web—jalan di OS apa pun.
Cocok untuk: Profesional dan enterprise yang butuh ekstraksi data web terintegrasi dan skalabel.
Tabel Perbandingan Cepat: Sekilas Alat Web Scraping Linux
| Alat | Jenis / Fitur Utama | Cocok Untuk | Harga | Kompatibilitas Linux |
|---|---|---|---|---|
| Thunderbit | Ekstensi Chrome AI, 1 klik, subpage, cloud/local | Pengguna bisnis non-teknis | Gratis, mulai $15/bulan | ✔ Chrome di Linux |
| Scrapy | Framework Python, async, CLI, sangat extensible | Developer, scraper custom skala besar | Gratis | ✔ Native |
| Beautiful Soup | Library Python, parsing HTML/XML sederhana | Dev, data scientist, tugas kecil | Gratis | ✔ Native |
| Selenium | Otomasi browser, situs berat JavaScript | QA, dev, konten dinamis | Gratis | ✔ Native |
| Puppeteer | Node.js, headless Chrome, rendering JS | Dev Node, web app modern | Gratis | ✔ Native |
| Octoparse | Tanpa kode, drag-and-drop, template cloud | Non-coder, e-commerce | Gratis, mulai $69/bulan | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, JavaScript yang dapat diprogram | Legacy, ringan, tanpa Chrome | Gratis | ✔ Native |
| ParseHub | Visual, lintas platform, point-and-click | Analis, pengguna semi-teknis | Gratis, mulai $189/bulan | ✔ Native |
| Kimurai | Framework Ruby, multi-browser, async | Dev Ruby, concurrency tinggi | Gratis | ✔ Native |
| Apify | Platform cloud, SDK, marketplace | Dev, hybrid custom/cloud | Paket gratis, berbasis pemakaian | ✔ Native/Cloud |
| Colly | Framework Go, cepat, concurrent | Dev Go, performa tinggi | Gratis | ✔ Native |
| PySpider | Python, UI web, scheduling, distributed | Tim, banyak proyek | Gratis | ✔ Native |
| WebHarvy | Visual, deteksi pola, lisensi sekali bayar | Pemula, profesional solo | ~$129 sekali bayar | ◐ Wine/VM |
| OutWit Hub | GUI native, deteksi data otomatis, scripting | Non-coder, GUI desktop | Gratis; Pro berbayar (cek vendor) | ✔ Native |
| Portia | Open-source, visual, berbasis browser | Open-source, integrasi Scrapy | Gratis | ✔ Browser |
| Sequentum Enterprise | Enterprise, visual, scripting, multi-agent | Agency, tim besar | $$$, berdasarkan penawaran | ◐ Wine/VM |
| Helium | Python, Selenium yang disederhanakan, API intuitif | Pengguna Python, automasi cepat | Gratis | ✔ Native |
| Dexi.io | Cloud, visual workflow, scheduling, API | Enterprise, automasi skalabel | Mulai $500/bulan (via Mozenda) | ✔ Browser |
Cara Memilih Web Scraper yang Tepat untuk Linux: Pertimbangan Utama
Masih Ragu Soal Paket yang Dibutuhkan? Mulai dari yang Paling Mudah Kalau Anda tidak ingin repot merawat selector, biarkan AI menentukan field untuk Anda — 1 klik, lalu ekspor ke Sheets, Excel, Airtable, atau Notion. Get Started Free
Memilih alat yang tepat pada dasarnya soal mencocokkan kebutuhan dan kemampuan Anda:
- Tingkat Keahlian Teknis: Non-coder sebaiknya mengarah ke Thunderbit, ParseHub, Octoparse, atau OutWit Hub. Developer bisa memaksimalkan Scrapy, Puppeteer, Colly, atau Kimurai.
- Kompleksitas Data: Untuk halaman statis, Beautiful Soup atau Colly cepat dan simpel. Untuk situs dinamis yang berat JavaScript, Anda lebih cocok dengan Selenium, Puppeteer, atau alat visual yang mendukung JS.
- Skala & Frekuensi: Untuk pekerjaan sekali jalan, alat no-code atau cloud scraper sudah cukup. Untuk crawl besar yang terjadwal, pilih Scrapy, PySpider, atau Apify.
- Kebutuhan Integrasi: Butuh ekspor ke Excel, Sheets, atau database? Pastikan alat Anda mendukung alur kerja itu.
- Anggaran: Opsi gratis dan open-source sangat banyak untuk coder. Untuk pengguna bisnis, Thunderbit dan ParseHub menawarkan titik masuk yang terjangkau, sementara tim enterprise mungkin berinvestasi di Dexi.io atau Sequentum Enterprise.
- Dukungan & Komunitas: Alat open-source punya komunitas besar; alat komersial menawarkan dukungan khusus.
Tips pro: Jangan takut menggabungkan beberapa alat. Pakai Thunderbit untuk prototyping dan mengenali pola data, lalu pindah ke Scrapy untuk crawl skala produksi. Atau gunakan Selenium untuk login dan mengambil session cookie, lalu serahkan ke Colly atau Scrapy untuk scraping berkecepatan tinggi.
Kesimpulan: Temukan Alat Web Scraping Linux Terbaik Anda untuk 2026
Pengguna Linux benar-benar dimanjakan pilihan di 2026. Entah Anda mau alat AI tanpa kode yang menghasilkan data dalam hitungan menit (Thunderbit), framework developer yang tangguh (Scrapy, Colly), atau platform kelas enterprise (Dexi.io), selalu ada web scraper untuk Linux yang sesuai dengan kebutuhan dan alur kerja Anda.
Poin utama:
- Linux adalah tulang punggung infrastruktur data modern—sebagian besar scraper terbaik berjalan secara native atau lewat browser.
- Alat AI dan no-code sedang mendemokratisasi web scraping untuk pengguna bisnis.
- Framework untuk developer tetap unggul dalam fleksibilitas, kecepatan, dan skala.
- Coba dulu sebelum membeli—kebanyakan alat menyediakan paket gratis atau trial.
Siap mulai? Unduh Thunderbit atau kunjungi Thunderbit Blog untuk panduan lain tentang web scraping, automasi, dan pertumbuhan berbasis data.
Jelajahi AI Web Scraper Thunderbit Lupakan scripting dan cron job — biarkan AI membaca halaman dan memberi Anda tabel dalam 1 klik. Get Started Free
FAQ
1. Apa web scraper Linux termudah kalau saya tidak bisa coding?
Thunderbit adalah pilihan utama untuk pengguna non-teknis. Alat ini berjalan sebagai ekstensi Chrome di Linux, memakai AI untuk mengotomatisasi semuanya, dan memungkinkan Anda mengekstrak data hanya dengan satu klik.
2. Web scraper Linux mana yang terbaik untuk proyek custom skala besar?
Scrapy adalah pilihan utama untuk developer. Cepat, skalabel, dan sangat bisa dikustomisasi—pas untuk crawl besar yang berulang.
3. Bisakah saya scraping situs yang berat JavaScript atau dinamis di Linux?
Bisa! Pakai Selenium atau Puppeteer untuk mengontrol browser sungguhan dan mengekstrak konten dinamis. Alat visual seperti ParseHub dan Thunderbit juga mendukung situs dinamis.
4. Apakah ada alat web scraping Linux gratis untuk kebutuhan bisnis?
Tentu saja. Scrapy, Beautiful Soup, Selenium, Colly, PySpider, dan Kimurai semuanya gratis dan open-source. Thunderbit dan ParseHub juga punya paket gratis untuk pekerjaan kecil.
5. Bagaimana cara memilih antara scraper Linux tanpa kode dan berbasis kode?
Kalau Anda ingin cepat dan simpel, pilih no-code (Thunderbit, ParseHub, Octoparse). Kalau Anda butuh fleksibilitas, automasi, atau integrasi dengan sistem lain, alat berbasis kode (Scrapy, Puppeteer, Colly) adalah pilihan terbaik.
Selamat scraping—semoga proyek data bertenaga Linux Anda berjalan lebih mulus daripada instalasi Ubuntu yang baru. Kalau Anda ingin lihat lebih banyak tips web scraping, cek Thunderbit Blog atau subscribe ke channel YouTube kami untuk tutorial praktis.
Coba AI Web Scraper untuk Linux Get Started Free
Pelajari Lebih Lanjut



