
Perkembangan web itu lebih cepat dari kecanduan kopi saya—dan serius, ini bukan cuma omong kosong. Di tahun 2026 nanti, ekstraksi data web itu bukan lagi cuma keahlian khusus para ahli data; ini sudah jadi tulang punggung intelijen bisnis, pelatihan AI, dan otomatisasi. Mau kamu lagi ngikutin tren pasar, ngelatih LLM generasi berikutnya, atau cuma pengen tahu harga kompetitor, kebutuhan data web terstruktur secara real-time itu makin tinggi. Dan di tengah "demam emas" data ini? Python jawabannya. Dengan ekosistemnya yang gede banget dan sintaksis yang gampang dimengerti, Python tetap jadi bahasa andalan buat web scraping, ngedukung segala macem, mulai dari skrip cepet buat sekali pakai sampai crawler kelas industri.
Tapi, ini dia intinya: milih paket web scraping Python yang pas itu bisa nentuin sukses atau gagalnya proyek kamu. Saya udah sering liat tim buang-buang waktu berhari-hari ngelawan tembok anti-bot pake alat yang salah, atau ngabisin berjam-jam ngurai HTML yang berantakan padahal ada library yang lebih pinter bisa nyelesaiin dalam hitungan menit. Jadi, sebagai orang yang udah bertahun-tahun berkecimpung di SaaS, otomatisasi, dan AI (dan bikin Thunderbit biar scraping jadi gampang buat semua orang), saya udah ngumpulin 12 paket web scraping Python terbaik buat tahun 2026—masing-masing punya kelebihan, keunikan, dan kasus penggunaan idealnya sendiri. Yuk, kita bedah satu per satu dan cari tahu mana yang paling cocok buat petualangan data kamu berikutnya.
Kenapa Milih Paket Web Scraping Python yang Tepat Itu Penting Banget
Scrape data dari situs web mana pun menggunakan AI Get Started Free
Jujur aja, ya: gak semua proyek web scraping itu sama. Kadang kamu cuma perlu ngambil beberapa harga produk dari halaman statis. Di lain waktu, kamu harus berurusan sama situs yang banyak pake JavaScript yang lebih bandel dari kucing pas dimandiin. Paket yang tepat itu bisa ngirit waktu berjam-jam (atau berhari-hari), ngurangin kesalahan, dan bantu kamu ngehindarin jebakan umum kayak diblokir anti-bot atau HTML yang rusak.
Popularitas Python di dunia web scraping itu bukan cuma isapan jempol. Library kayak requests dan urllib3 itu diunduh lebih dari 1 miliar kali per bulan, dan hampir semua alat scraping utama itu ngutamain Python. Tapi, dengan kekuatan besar datang tanggung jawab besar: salah pilih alat, kamu bisa kejebak di proyek yang lebih lambat dari internet dial-up. Pilih yang bener, dan kamu bakal berenang di data yang bersih dan terstruktur sebelum kopi kamu dingin.
Cara Kami Milih Paket Web Scraping Python Terbaik
Saya gak cuma asal lempar panah ke grafik PyPI. Begini cara saya ngevaluasi setiap paket:
- Performa & Konkurensi: Bisa gak dia ngambil ratusan (atau ribuan) halaman dengan cepet?
- Kemudahan Penggunaan: Ramah gak buat pemula, atau butuh gelar PhD di ilmu komputer?
- Kekuatan Parsing HTML: Bisa gak dia nangani markup yang rusak, dukung selektor XPath/CSS, dan bikin ekstraksi data jadi gampang?
- Dukungan Konten Dinamis: Bisa gak dia nangani situs yang banyak pake JavaScript, atau cuma buat halaman statis?
- Komunitas & Dokumentasi: Ada gak komunitas pengguna yang berkembang dan dokumentasi yang solid, atau kamu bakal kejebak di "neraka" Stack Overflow?
- Kasus Penggunaan Terbaik: Buat skrip cepet, crawler skala gede, atau di antaranya?
Saya juga mempertimbangkan feedback pengembang di dunia nyata, tolok ukur terbaru, dan pengalaman saya sendiri (kadang nyebelin) di lapangan. Nah, sekarang, yuk kita kenalan sama para pesaingnya.
1. Thunderbit
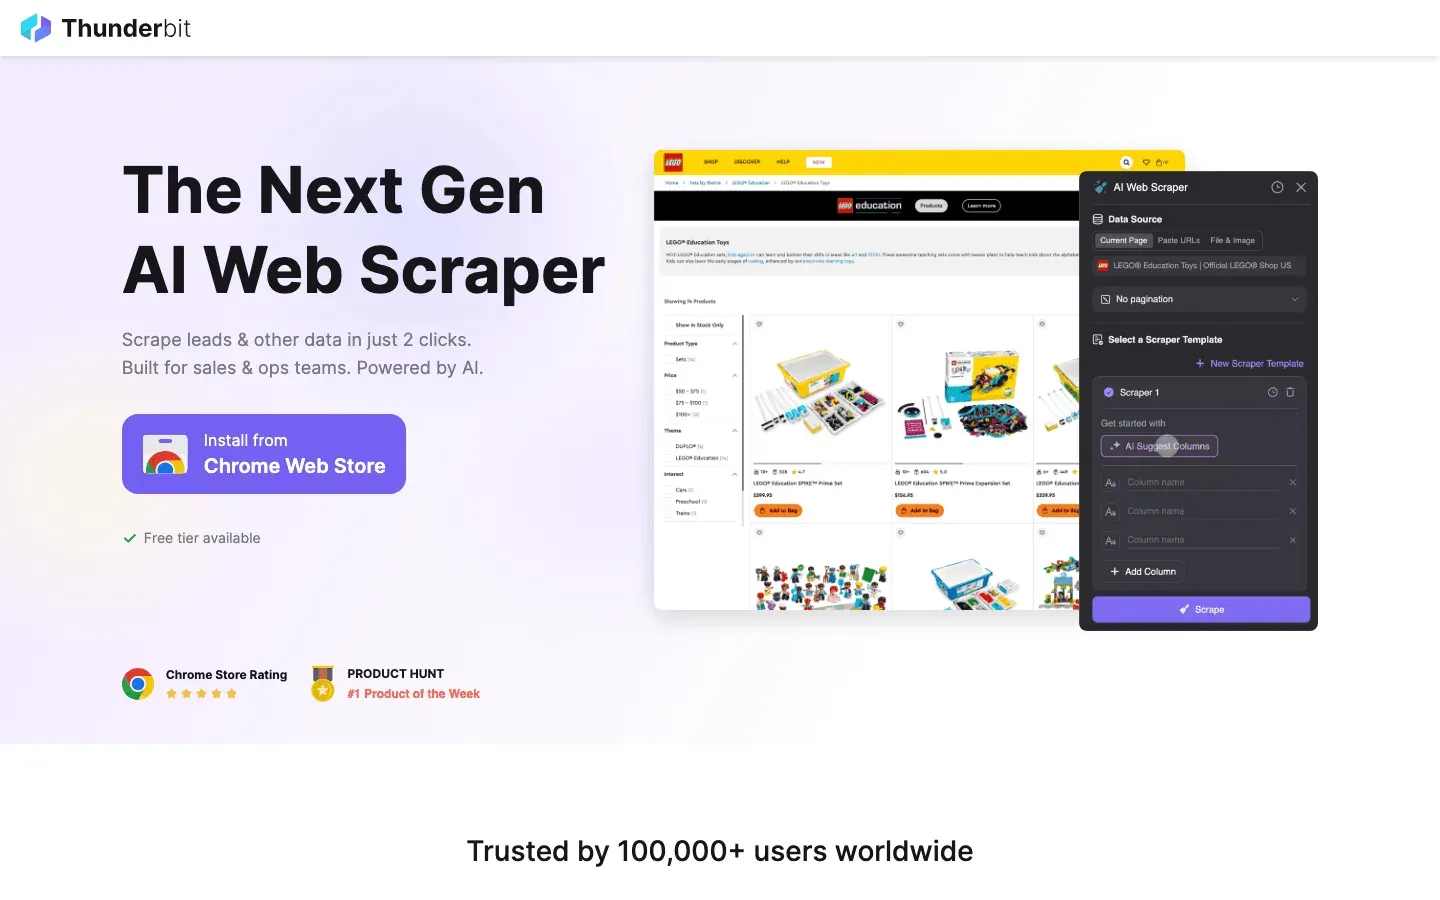 Thunderbit itu bukan library Python biasa—ini ekstensi Chrome bertenaga AI yang ngubah permainan web scraping, terutama buat pengembang Python yang pengen cepet, akurat, dan ada sentuhan keajaiban AI. Apa yang bikin Thunderbit beda? Dia ngasih kamu kemampuan buat pake instruksi bahasa alami buat ngasih tahu AI data apa yang kamu mau, terus dia yang ngurusin semuanya: saran field, navigasi subhalaman, paginasi, bahkan ekspor ke Excel, Google Sheets, Notion, atau Airtable.
Thunderbit itu penyelamat buat scraping data yang kompleks dan gak terstruktur—bayangin direktori yang berantakan, daftar produk, atau situs di mana HTML-nya lebih mirip "seni abstrak" daripada "dokumen terstruktur." Fitur AI Suggest Fields-nya ngebaca halaman dan nyaranin kolom terbaik, sementara Subpage Scraping ngasih kamu kesempatan buat ngelengkapi dataset dengan otomatis ngunjungin halaman detail yang terhubung. Dan kalo kamu udah bosen sama masalah anti-bot, opsi scraping berbasis browser dan cloud Thunderbit siap bantu kamu.
Pengembang Python suka Thunderbit buat prototyping cepet, lead generation, dan riset pasar. Kamu bisa pake hasilnya langsung di pipeline data Python kamu, atau bahkan ngotomatisasi alur kerja scraping pake API-nya. Ini bukan library kode tradisional, tapi cepet banget jadi favorit buat siapa aja yang pengen ngabisin lebih sedikit waktu buat coding dan lebih banyak waktu buat nganalisis data.
Fitur Utama:
- Saran field dan ekstraksi data bertenaga AI
- Nangani subhalaman, paginasi, bahkan PDF/gambar
- Ekspor ke CSV, Excel, Google Sheets, Notion, Airtable
- Gak perlu coding—sempurna buat pengguna non-teknis dan profesional Python yang pengen gerak cepet
- Tersedia tingkat gratis; paket berbayar disesuaikan sama kebutuhan kamu
Terbaik Untuk: Lead generation, riset pasar, prototyping cepet, dan scraping data web yang kompleks atau berantakan.
Coba Thunderbit AI Web Scraper secara Gratis
2. Beautiful Soup
 Beautiful Soup itu library parsing HTML asli di Python. Kalo kamu baru mulai, atau perlu ngekstrak data dari halaman web statis, ini teman terbaik kamu. Beautiful Soup jago banget dalam navigasi dan ngurai HTML yang gak terstruktur dengan baik ("sup tag"), bikin dia jadi penyelamat buat scraping situs yang gak ngikutin aturan.
API-nya ramah buat pemula—bayangin .find(), .select(), dan .text—dan cocok banget sama requests buat ngambil halaman web. Di balik layar, kamu bisa milih parser yang beda (kayak lxml buat kecepatan atau html5lib buat kompatibilitas maksimal). Dokumentasinya bagus banget, dan komunitasnya gede.
Fitur Utama:
- API yang intuitif dan Pythonic buat navigasi HTML/XML
- Nangani markup yang rusak atau gak konsisten dengan baik
- Kerja sama beberapa parser buat kecepatan atau kompatibilitas
- Komunitas gede dan banyak tutorial
Terbaik Untuk: Skrip cepet, scraping halaman statis, dan pemula yang pengen kurva belajar yang gampang.
Pelajari lebih lanjut tentang Beautiful Soup
3. Scrapy
 Scrapy itu juara kelas berat buat web crawling otomatis skala gede. Kalo kamu perlu scraping ratusan atau ribuan halaman, ngelola pipeline, atau ngejadwalin pekerjaan berulang, Scrapy itu framework yang paling banyak dipake sama tim. Dia masih jalan di reaktor Twisted di balik layar, tapi di rilis 2.14 sebagian besar internal asinkronnya ditulis ulang sebagai coroutine
asyncio asli, dan sekarang ada titik masuk AsyncCrawlerProcess / AsyncCrawlerRunner yang berfungsi baik sama ekosistem async Python modern lainnya. Dia cepet, dukung crawling konkuren, pipeline item buat pembersihan data, dan ekspor ke JSON, CSV, atau database.
Scrapy itu bisa diperluas, dengan plugin buat proxy, caching, dan bahkan rendering JavaScript terbatas (lewat integrasi Splash atau Selenium). Kurva belajarnya lebih curam daripada Beautiful Soup, tapi kalo kamu serius sama data web dalam skala besar, Scrapy itu pilihan yang pas.
Fitur Utama:
- Crawling asinkron lewat reaktor Twisted + coroutine
asyncioasli (Scrapy 2.14+, Python 3.10+) - Pipeline bawaan buat pembersihan dan penyimpanan data
- Ekspor ke berbagai format (JSON, CSV, DB)
- Komunitas gede dan aktif serta ekosistem plugin
Terbaik Untuk: Proyek scraping berulang skala besar, pipeline data, dan siapa aja yang butuh kecepatan dan keandalan.
4. Selenium
 Selenium itu alat pilihan buat scraping situs yang banyak pake JavaScript atau interaktif. Dia ngotomatisasi browser sungguhan (Chrome, Firefox, dll.), ngasih kamu kemampuan buat nyimulasi tindakan pengguna kayak klik, scrolling, dan ngirim form. Kalo data yang kamu butuhin cuma muncul setelah JavaScript jalan, Selenium bisa dapetin—gak peduli seberapa bandel situs itu.
Kekurangannya? Selenium itu lambat dan boros sumber daya. Kamu ngejalanin browser penuh buat setiap scraping, jadi jangan harap bisa ngeproses ribuan halaman per menit. Tapi buat skenario "gak ada alat lain yang bisa", Selenium itu penyelamat.
Fitur Utama:
- Otomatisasi browser penuh (dukung Chrome, Firefox, Edge, dll.)
- Nangani konten yang dirender JavaScript dan elemen interaktif
- Dukung mode headless buat scraping yang lebih cepet dan tanpa UI
- Komunitas gede dan dokumentasi ekstensif
Terbaik Untuk: Scraping situs dinamis yang banyak pake JavaScript, ngotomatisasi alur login, dan nangani CAPTCHA atau interaksi pengguna yang kompleks.
Baca lebih lanjut tentang kekuatan dan kelemahan Selenium
5. PyQuery
 PyQuery itu ngebawa sintaksis gaya jQuery ke Python, bikin parsing HTML kerasa akrab buat siapa aja yang pernah kerja sama jQuery di JavaScript. Dia ngebungkus parser
lxml yang cepet dan ngasih kamu kemampuan buat pake selektor CSS kayak $('div.classname') buat nemuin elemen.
PyQuery bagus banget buat prototyping cepet dan buat pengembang yang pengen kode yang ringkas dan gampang dibaca. Dia lebih cepet daripada Beautiful Soup buat query kompleks dan terintegrasi dengan gampang sama alat async atau Selenium buat alur kerja yang lebih canggih.
Fitur Utama:
- Selektor dan sintaksis kayak jQuery di Python
- Parsing cepet dengan backend lxml
- Bagus banget buat pengembang yang pindah dari JavaScript
- Dukung chaining dan query ringkas
Terbaik Untuk: Prototyping, penggemar jQuery, dan siapa aja yang pengen nulis lebih sedikit kode buat parsing HTML.
Tutorial dan perbandingan PyQuery
6. LXML
 LXML itu "speed demon" parsing HTML dan XML di Python. Dibangun di atas library C
libxml2 dan libxslt, dia terkenal karena performanya dan dukungan kuat buat selektor XPath dan CSS. Kalo kamu berurusan sama dokumen gede atau perlu ngejalanin query kompleks, lxml itu pilihan terbaik kamu.
Dia bisa dipake secara langsung atau sebagai backend buat Beautiful Soup atau PyQuery. API-nya sedikit lebih canggih, tapi kecepatan dan fleksibilitasnya sepadan buat pekerjaan gede.
Fitur Utama:
- Parsing tercepat yang tersedia di Python
- Dukungan penuh buat selektor XPath dan CSS
- Nangani dokumen gede dan kompleks secara efisien
- Bisa dipake secara mandiri atau sebagai parser buat library lain
Terbaik Untuk: Parsing berkinerja tinggi, scraping skala besar, dan proyek yang butuh query canggih.
Mengapa lxml menonjol untuk parsing
7. Requests
 Requests itu standar de facto buat bikin permintaan HTTP di Python. API-nya yang bersih dan intuitif bikin ngambil halaman web semudah
requests.get(url). Dia nangani cookie, sesi, dan bahkan decoding JSON secara otomatis.
Meskipun Requests itu sinkron (setiap permintaan nunggu selesai), dia sempurna buat skrip cepet dan scraping skala kecil. Pasangin sama Beautiful Soup atau lxml buat alur kerja scraping klasik.
Fitur Utama:
- API yang sederhana dan Pythonic buat permintaan HTTP
- Nangani cookie, sesi, dan pengalihan
- Terintegrasi dengan mulus sama library parsing
- Komunitas dan dokumentasi yang sangat gede
Terbaik Untuk: Skrip sederhana, scraping halaman statis, dan pemula yang pengen mulai cepet.
Lihat mengapa Requests begitu populer
8. MechanicalSoup
 MechanicalSoup itu library ringan yang ngotomatisasi interaksi browser sederhana—kayak ngisi form atau navigasi alur login multi-langkah—tanpa ngeluncurin browser penuh. Dia ngebungkus
requests dan Beautiful Soup, bikin dia jauh lebih cepet dan ringan daripada Selenium buat situs yang gak terlalu bergantung sama JavaScript.
Kalo kamu perlu login, ngirim form, atau ngeklik beberapa halaman (dan situsnya gak terlalu dinamis), MechanicalSoup itu jalan tengah yang bagus.
Fitur Utama:
- Ngotomatisasi pengisian form dan navigasi
- Dibangun di atas Requests dan Beautiful Soup
- Ringan dan cepet (tanpa overhead browser)
- Gampang dipake buat interaktivitas sedang
Terbaik Untuk: Situs yang butuh login atau pengiriman form, tugas otomatisasi sederhana, dan siapa aja yang pengen ngehindarin overhead Selenium.
Tutorial MechanicalSoup
9. Aiohttp
 Aiohttp itu "powerhouse" asinkron buat permintaan web berkecepatan tinggi dan konkuren. Kalo kamu perlu scraping ratusan halaman dengan cepet, aiohttp ngasih kamu kemampuan buat ngirim permintaan secara paralel, secara dramatis ngurangin total waktu jalan. Dalam satu tolok ukur, scraping 50 halaman cuma butuh 3 detik dengan aiohttp, dibandingin sama 16 detik pake permintaan sinkron (lihat perbedaan performa).
Aiohttp butuh penulisan kode async def dan penggunaan await, tapi peningkatan kecepatannya sepadan buat pekerjaan skala besar.
Fitur Utama:
- Framework klien/server HTTP asinkron
- Dukung sesi, cookie, dan HTTP/2
- Peningkatan kecepatan gede buat permintaan konkuren
- Terintegrasi sama library parsing asinkron
Terbaik Untuk: Scraping berkecepatan tinggi dan skala besar, pengambilan API, dan siapa aja yang nyaman sama pemrograman asinkron.
10. Twisted
 Twisted itu mesin jaringan berbasis peristiwa yang ngedukung Scrapy. Meskipun ini bukan library scraping, pengguna tingkat lanjut bisa pake Twisted secara langsung buat bikin crawler kustom, nangani protokol non-HTTP, atau ngimplementasiin spider yang sangat konkuren.
Twisted itu kuat banget tapi punya kurva belajar yang curam. Ini paling baik buat skenario yang sangat kustom atau pas bikin framework dari awal.
Fitur Utama:
- Jaringan berbasis peristiwa buat HTTP, WebSockets, SSH, dan lainnya
- Dukung SSL, konkurensi, dan protokol kustom
- Dukung mesin async Scrapy
- Sangat fleksibel buat kasus penggunaan tingkat lanjut
Terbaik Untuk: Protokol kustom, bikin framework scraping, dan pengguna tingkat lanjut yang butuh kontrol maksimal.
11. Grab
 Grab itu toolkit scraping all-in-one yang ngegabungin permintaan HTTP, parsing, otomatisasi, rotasi proxy, dan penanganan CAPTCHA. Ini mirip sama Scrapy tapi tujuannya lebih gampang dipelajari dan dipake, dengan dukungan bawaan buat proxy, caching, dan spider asinkron.
Fitur unggulan Grab itu sistem Grab:Spider-nya, yang bisa ngejalanin ribuan permintaan secara paralel pake multicurl. Kalo kamu butuh solusi all-in-one dengan setup yang lebih sedikit daripada Scrapy, Grab patut dicoba.
Fitur Utama:
- Dukungan bawaan buat proxy, rotasi user-agent, dan caching
- Sistem spider asinkron buat konkurensi tinggi
- Parsing XPath dan arsitektur modular
- Dipake dalam produksi buat scraping skala besar
Terbaik Untuk: Proyek scraping all-in-one, tugas yang banyak pake proxy, dan pengguna yang pengen kekuatan tanpa kompleksitas Scrapy.
Pengenalan kerangka kerja Grab
12. Urllib3
 Urllib3 itu mesin HTTP tingkat rendah yang ngedukung banyak klien Python, termasuk Requests. Dia nawarin kumpulan koneksi, keamanan thread, percobaan ulang, dan kontrol yang terperinci atas koneksi HTTP. Meskipun sebagian besar pengembang pake dia secara gak langsung, urllib3 itu pilihan kamu pas kamu butuh performa maksimum atau lagi bikin library tingkat yang lebih tinggi.
Dia gak seramah pemula kayak Requests, tapi dia udah teruji dan sangat andal.
Fitur Utama:
- Kumpulan koneksi dan keamanan thread
- Kontrol terperinci atas koneksi HTTP
- Dipake sebagai dasar buat banyak library lain
- Performa tinggi buat permintaan berulang
Terbaik Untuk: Klien HTTP kustom, crawler multi-thread, dan pengembang yang bikin di atas tumpukan HTTP Python.
Lihat peran urllib3 dalam scraping
Tabel Perbandingan: Paket Web Scraping Python Sekilas
| Paket | Kemudahan Penggunaan | Performa | Konten Dinamis | Kekuatan Parsing | Komunitas/Dokumen | Terbaik Untuk |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Cepat (cloud/lokal) | Ya (via AI) | Bidang otomatis, subhalaman | Berkembang (tren AI) | Pembuatan prospek, riset pasar, pengguna tanpa kode |
| Beautiful Soup | ★★★★★ (mudah) | Sedang | Tidak | HTML/XML, pemaaf | Sangat besar | Halaman statis, pemula |
| Scrapy | ★★☆☆☆ (curam) | ★★★★★ (sangat tinggi) | Hanya plugin | CSS/XPath, pipeline | Besar, aktif | Scraping skala besar, berulang |
| Selenium | ★★☆☆☆ (sedang) | ★☆☆☆☆ (lambat) | Ya (penuh) | DOM penuh, JS | Matang | Situs interaktif, banyak JS |
| PyQuery | ★★★★☆ (jQuery) | Cepat (lxml) | Tidak* | Selektor jQuery | Sedang | Pembuatan prototipe, pengembang jQuery |
| LXML | ★★★☆☆ (tingkat lanjut) | ★★★★★ (tercepat) | Tidak | XPath/CSS, XML | Sedang | Dokumen besar, kueri canggih |
| Requests | ★★★★★ (sangat mudah) | ★★☆☆☆ (sinkron) | Tidak | HTTP, JSON | Sangat besar | Skrip sederhana, halaman statis |
| MechanicalSoup | ★★★★☆ (mudah) | ★★☆☆☆ (sinkron) | Tidak | Formulir, navigasi | Kecil | Alur login, otomatisasi formulir |
| Aiohttp | ★★☆☆☆ (async) | ★★★★★ (konkuren) | Tidak | HTTP asinkron | Besar (async) | Scraping berkecepatan tinggi, konkuren |
| Twisted | ★☆☆☆☆ (kompleks) | ★★★★★ (kustom) | Tidak | Jaringan, protokol | Niche | Kerangka kerja kustom, pengguna tingkat lanjut |
| Grab | ★★★☆☆ (modular) | ★★★★☆ (async) | Tidak | Proxy, XPath | Kecil | All-in-one, banyak proxy/captcha |
| Urllib3 | ★★★★☆ (tingkat rendah) | ★★★★☆ (pooled) | Tidak | HTTP, pooling | Sangat besar | Klien kustom, crawler multi-thread |
*PyQuery bisa digabungin sama Selenium buat situs dinamis.
Cara Milih Paket Web Scraping Python yang Tepat buat Kebutuhan Kamu
Apa Itu Data Scraping dan Cara Melakukannya di Tahun 2026 Get Started Free
Jadi, paket mana yang harus kamu pilih? Ini dia contekan saya:
- Halaman statis, pekerjaan kecil, atau kamu baru kenal scraping: Mulai aja pake Requests + Beautiful Soup.
- Scraping skala besar, berulang, atau produksi: Scrapy atau Grab (buat kebutuhan all-in-one).
- Situs yang banyak pake JavaScript atau interaktif: Selenium (atau Thunderbit kalo kamu pengen scraping bertenaga AI, tanpa kode).
- Scraping berkecepatan tinggi, konkuren: Aiohttp (kalo kamu nyaman sama async).
- Otomatisasi form atau alur login: MechanicalSoup (buat situs sederhana), Selenium (buat JS kompleks).
- Parsing tingkat lanjut atau dokumen gede: LXML atau PyQuery.
- Jaringan kustom atau pekerjaan protokol: Twisted.
- Prototyping cepet, lead generation, atau data yang berantakan/gak terstruktur: Thunderbit.
Dan jangan takut buat nyampur dan nyocokin—banyak alur kerja ngegabungin alat-alat ini buat efisiensi maksimal. Misalnya, kamu mungkin pake Selenium buat render halaman, terus nerusin HTML-nya ke Beautiful Soup atau PyQuery buat parsing.
Kesimpulan: Tingkatkan Web Scraping Kamu dengan Alat Python yang Tepat
Web scraping di tahun 2026 itu lebih kuat—dan lebih diperlukan—dari sebelumnya. Dengan paket web scraping Python yang tepat, kamu bisa ngubah kekacauan web jadi data yang bersih dan bisa ditindaklanjuti buat bisnis, penelitian, atau ide gede kamu berikutnya. Mau kamu pengembang berpengalaman atau baru mulai di dunia data, ada alat di daftar ini yang cocok sama kebutuhan kamu.
Kalo kamu pengen liat kayak apa scraping bertenaga AI, tanpa kode, coba Thunderbit. Dan kalo kamu haus akan lebih banyak tips, ulasan mendalam, dan tutorial, kunjungi Blog Thunderbit buat informasi terbaru tentang web scraping, otomatisasi, dan alur kerja berbasis data.
Coba Thunderbit AI Web Scraper secara Gratis
Selamat scraping—dan semoga selektor kamu selalu cocok, proxy kamu gak pernah gagal, dan data kamu sebersih kode kamu.
FAQ
1. Apa paket web scraping Python terbaik buat pemula? Buat sebagian besar pemula, kombinasi Requests dan Beautiful Soup itu cara termudah buat mulai. Keduanya punya API yang intuitif, banyak tutorial, dan nangani sebagian besar tugas scraping halaman statis.
2. Gimana cara scraping situs web yang banyak pake JavaScript dengan Python? Pake Selenium buat ngotomatisasi browser sungguhan, atau coba Thunderbit buat scraping bertenaga AI, tanpa kode yang bisa nangani konten dinamis. Buat kebutuhan skala besar, Scrapy bisa digabungin sama Splash atau Selenium.
3. Paket mana yang terbaik buat scraping skala besar dan berkecepatan tinggi? Scrapy dibangun buat crawling asinkron skala besar. Kalo kamu butuh kecepatan lebih dan nyaman sama kode async, aiohttp itu pilihan utama buat permintaan konkuren.
4. Bisa gak saya ngegabungin paket-paket ini dalam alur kerja saya? Tentu aja! Banyak pengembang pake Requests atau Selenium buat ngambil halaman, terus ngurai dengan Beautiful Soup, lxml, atau PyQuery. Ekspor Thunderbit bisa dimasukkin ke dalam skrip Python buat analisis lebih lanjut.
5. Apakah Thunderbit library Python atau alat mandiri? Thunderbit itu ekstensi Chrome dan platform bertenaga AI, bukan library Python tradisional. Tapi, hasilnya (CSV, Excel, Sheets, Notion, Airtable) terintegrasi dengan mulus ke dalam pipeline data Python, bikin dia jadi pendamping yang kuat buat pengembang Python.
6. Apakah agen coding AI ngeganti library scraping Python di tahun 2026? Belum, tapi patut diketahui. Alat kayak Claude Code dan OpenAI Codex bisa ngehasilin skrip Requests + Beautiful Soup atau Scrapy yang berfungsi dari perintah bahasa Inggris biasa dalam hitungan detik, yang sangat berguna buat pekerjaan sekali pakai dan prototyping. Buat alur browser bahasa alami (login, JS dinamis, navigasi multi-langkah), Browser Use itu opsi open-source yang banyak dipake, dan Firecrawl populer pas tujuannya itu masukkin markdown bersih ke LLM. Gak ada yang ngilangin bagian-bagian sulit—pertahanan anti-bot, batas kecepatan, dan TOS masih berlaku—dan buat crawler produksi dalam skala besar, Scrapy + aiohttp masih unggul dalam biaya dan kontrol. Anggap agen AI sebagai cara yang lebih cepet buat nulis scraper, bukan pengganti langsung buat library di daftar ini.
Pengen tetap terdepan di dunia web scraping? Langganan Saluran YouTube Thunderbit dan pantau terus Blog Thunderbit buat panduan, perbandingan, dan tips otomatisasi lainnya.
Coba Thunderbit AI Web Scraper secara Gratis Get Started Free
Pelajari Lebih Lanjut




