
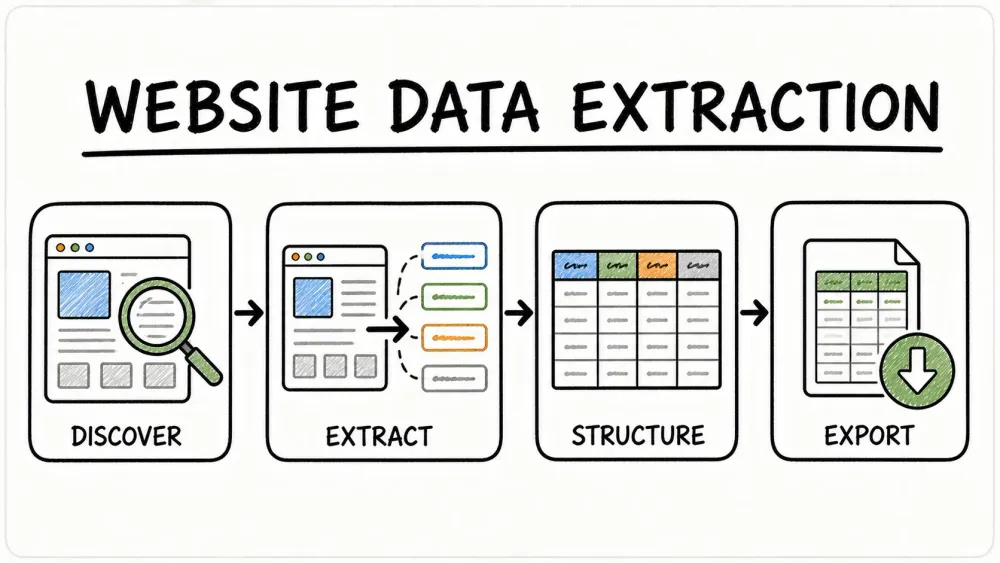
Web dipenuhi informasi, tetapi mengubah kekacauan itu menjadi data bisnis yang bisa ditindaklanjuti? Di situlah tantangan sekaligus peluang sebenarnya berada. Selama bertahun-tahun membangun SaaS dan alat otomasi, saya melihat dunia bergeser dari keputusan berbasis firasat ke keputusan berbasis data di hampir semua hal. Bukan cuma perusahaan teknologi raksasa; tim kecil pun sekarang berlomba mengekstrak data dari situs web untuk mendukung penjualan, pemasaran, penetapan harga, dan strategi produk. Namun, seiring web makin kompleks dan dinamis, mendapatkan data yang bersih, patuh, dan benar-benar berguna jadi tantangan yang sama sekali berbeda.
Mari kita bahas secara praktis: saya akan menunjukkan mengapa mengekstrak data dari situs web sangat penting bagi bisnis modern, hambatan terbesar yang akan Anda hadapi, serta praktik terbaik—termasuk pelajaran berharga dari tim Thunderbit—agar prosesnya dilakukan dengan benar: legal, efisien, dan bisa diskalakan. Baik Anda sedang mengolah konten tak terstruktur, khawatir soal GDPR, atau sekadar ingin berhenti copy-paste ke spreadsheet, panduan ini dibuat untuk Anda.
Mengapa Ekstraksi Data dari Situs Web Penting untuk Bisnis Modern
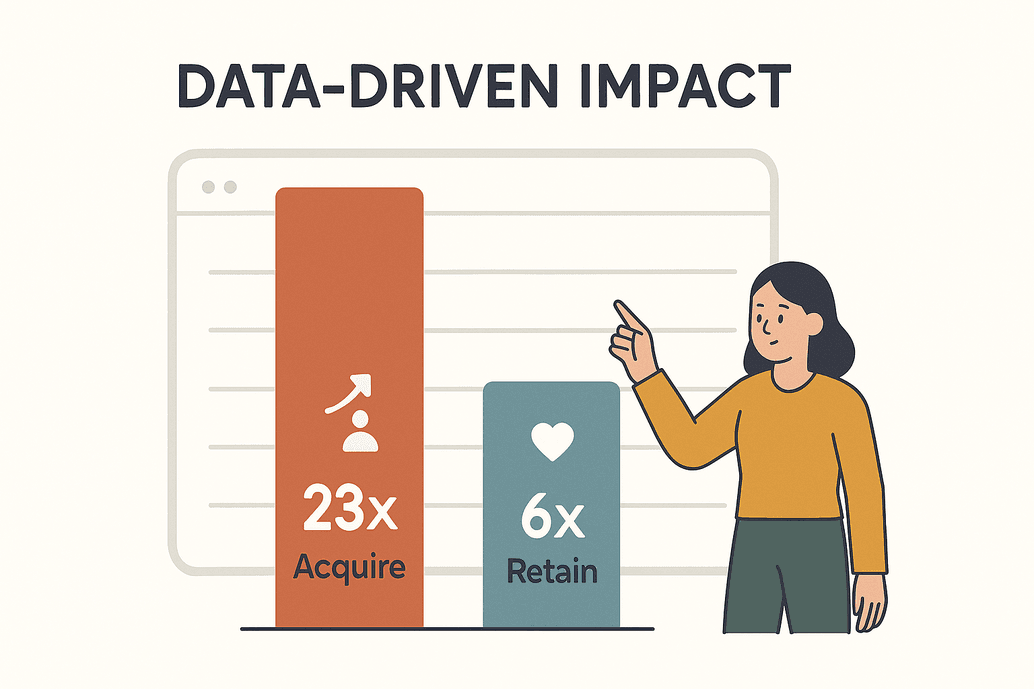 Data bukan sekadar kata keren—ini adalah urat nadi bisnis yang kompetitif saat ini. Menurut sebuah survei McKinsey, organisasi yang berbasis data 23× lebih mungkin mendapatkan pelanggan dan 6× lebih mungkin mempertahankan mereka. Itu bukan cuma mengesankan—itu sudah menyangkut kelangsungan hidup bisnis. Pada 2025, bisnis diperkirakan akan meng-crawl miliaran halaman web setiap hari untuk memberi makan analitik, model AI, dan pengambilan keputusan real-time (kanhasoft.com).
Jadi, bentuk nyatanya seperti apa? Berikut beberapa skenario yang sering saya lihat setiap minggu:
| Aplikasi Bisnis | Deskripsi & Manfaat | Contoh/Statistik |
|---|---|---|
| Pemantauan Harga | Lacak harga, stok, dan promo kompetitor secara real-time; sesuaikan strategi Anda supaya tetap unggul. | Lebih dari 80% retailer online teratas meng-crawl harga kompetitor setiap hari (kanhasoft.com). |
| Generasi Prospek | Ekstrak direktori, media sosial, atau situs ulasan untuk mendapatkan prospek dan informasi kontak baru. | Ekstraksi data otomatis mengisi CRM jauh lebih cepat daripada riset manual. |
| Analisis Tren Pasar | Kumpulkan ulasan, forum, dan berita untuk mendeteksi tren atau perubahan sentimen lebih awal. | 26% aktivitas scraping difokuskan pada media sosial untuk insight tren (blog.apify.com). |
| Agregasi Konten | Kumpulkan berita, daftar produk, atau event dari berbagai situs agar mudah diakses. | Tim media menyusun feed untuk audiens mereka. |
| Data Produk & Riset | Ambil detail produk, ulasan, atau data riset untuk analisis dan pengembangan. | 67% penasihat investasi menggunakan data web alternatif (scrap.io). |
| Data Pelatihan AI | Ambil volume besar teks, gambar, atau catatan untuk melatih model AI. | Sekitar 70% model AI besar bergantung pada data web hasil scraping (kanhasoft.com). |
Kalau Anda belum mengekstrak data dari situs web, Anda bukan cuma tertinggal—Anda nyaris tak terlihat di pasar Anda. Saya melihat tim e-commerce melipatgandakan ROI mereka dalam enam bulan hanya dengan mengotomatiskan scraping harga kompetitor (kanhasoft.com). Intinya: data web adalah aset strategis, dan mengolahnya dengan baik sekarang sudah jadi kebutuhan dasar.
Tantangan Utama Saat Anda Menarik Data dari Situs Web Apa Pun
Tentu saja, semuanya tidak selalu mulus. Web itu medan yang liar, dan mengekstrak data dari situs web punya tantangan nyata:
- Data Tidak Terstruktur: Sekitar 80% data online bersifat tidak terstruktur—tersembunyi dalam HTML yang berantakan, tersebar di banyak halaman, atau disembunyikan di balik elemen interaktif. Mengubahnya jadi tabel rapi bukan pekerjaan kecil (scrapingapi.ai).
- Situs yang Terus Berubah: Tata letak situs sering diperbarui. Saya pernah melihat scraper rusak 15 kali dalam sebulan hanya karena situs target mengubah desainnya (scrap.io).
- Volume dan Skala: Bisnis sering perlu mengekstrak data dari ratusan atau ribuan halaman—biasanya dengan jadwal tertentu. Copy-paste manual jelas tidak sanggup mengimbangi.
- Pertahanan Anti-Scraping: CAPTCHA, rate limit, login wall… Situs makin pintar memblokir bot. Lebih dari sepertiga trafik web kini berasal dari bot (scrap.io), dan teknologi anti-bot terus berkembang cepat.
- Kesalahan Manual: Copy-paste oleh manusia lambat dan rawan salah. Satu selector keliru saja, dan Anda bisa mengambil data yang salah—atau tidak ada data sama sekali.
Metode tradisional memang tidak bisa diskalakan. Itu sebabnya semakin banyak tim beralih ke solusi yang lebih cerdas dan otomatis—dan mengapa saya sangat optimistis terhadap alat berbasis AI.
Praktik Terbaik Legal, Kepatuhan, dan Keamanan untuk Ekstraksi Data Situs Web
Mari kita luruskan satu hal: hanya karena Anda bisa mengekstrak data dari situs web, bukan berarti Anda boleh melakukannya—setidaknya tanpa memikirkan sisi legal dan etisnya. Ini yang perlu diketahui setiap bisnis:
- Data Publik vs Privat: Scraping informasi yang tersedia untuk umum umumnya legal di banyak negara. Tapi kalau datanya berada di balik login? Itu wilayah terlarang. Melewati autentikasi bukanlah langkah yang boleh dilakukan (xbyte.io).
- Syarat & Ketentuan: Selalu cek ToS situs. Jika scraping dilarang, Anda berisiko digugat atau diblokir. Jika ragu, mintalah izin atau gunakan API resmi.
- Undang-Undang Privasi (GDPR, CCPA): Jika Anda mengumpulkan data pribadi, Anda memerlukan dasar hukum yang sah (misalnya legitimate interest), harus meminimalkan data yang diambil, dan siap menghapus data bila diminta. Pelanggaran bisa berujung denda besar (xbyte.io).
- Hormati robots.txt: Memang tidak mengikat secara hukum, tetapi ini etika yang baik. Ikuti aturan crawl-delay dan jangan membebani server.
- Keamanan Data: Perlakukan data hasil scraping sebagai data sensitif. Simpan dengan aman, batasi akses, dan bersihkan sebelum digunakan.
Checklist Kepatuhan:
| Pertimbangan | Praktik Terbaik |
|---|---|
| Akses Legal | Scrape hanya data publik; jangan pernah melewati login (xbyte.io). |
| Syarat & Ketentuan | Tinjau dan patuhi ToS situs; gunakan API jika scraping dilarang. |
| Data Pribadi | Hindari bila memungkinkan; jika perlu, minimalkan dan patuhi GDPR/CCPA. |
| robots.txt & Crawl Delay | Patuhi aturan situs; batasi laju permintaan. |
| Keamanan Data | Enkripsi, batasi akses, dan hapus saat tidak lagi dibutuhkan. |
Meningkatkan Efisiensi: Bagaimana AI Mengoptimalkan Ekstraksi Data Situs Web
Di sinilah semuanya jadi menarik. AI benar-benar mengubah cara mengekstrak data dari situs web. Alih-alih repot mengatur selector atau menulis skrip yang mudah rusak, kini Anda bisa memakai alat berbasis AI yang “membaca” halaman dan menentukan apa yang perlu diekstrak—sering kali hanya dengan beberapa klik.
Apa artinya dalam praktik?
- Setup Minimal: Scraper berbasis AI seperti Thunderbit bisa mendeteksi field secara otomatis. Cukup klik “One Click Extract” dan alat akan mengusulkan kolom yang tepat—tanpa coding, tanpa coba-coba.
- Adaptif: AI scraper mengenali pola, bukan hanya layout tetap. Jika situs berubah, AI sering kali menyesuaikan diri otomatis. Artinya perawatan lebih sedikit dan lebih jarang panik tengah malam.
- Akurasi: AI bisa menyaring noise, menghapus duplikasi, bahkan merapikan data yang kacau saat proses scraping berlangsung. Beberapa tim melaporkan tingkat akurasi hingga 99,5% dengan extractor berbasis AI (scrapingapi.ai).
- Konten Dinamis: AI scraper dapat menangani situs yang berat JavaScript, infinite scroll, bahkan mengekstrak teks dari gambar atau PDF.
- Pemrosesan Langsung: Butuh data diterjemahkan, dikategorikan, atau diringkas saat proses scraping? AI bisa melakukannya dalam satu langkah.
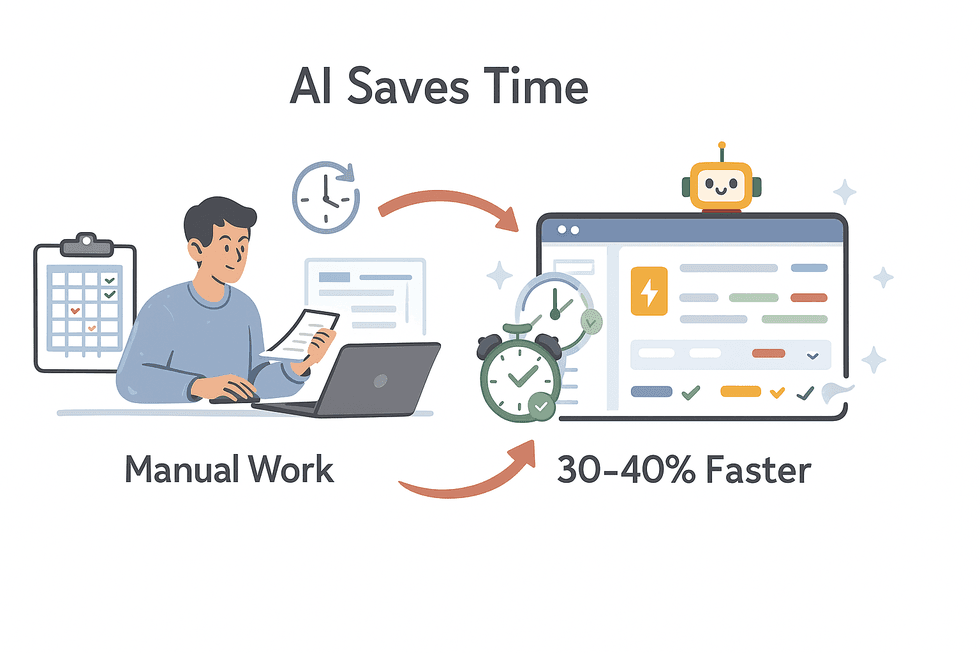 Saya melihat tim menghemat 30–40% waktu untuk ekstraksi data hanya dengan beralih ke alat berbasis AI (scrapingapi.ai). Itu bukan sekadar peningkatan produktivitas—itu keunggulan kompetitif.
Ekstrak data dari situs web apa pun dengan AI Agentic web scraper dari Thunderbit membaca situs web sendiri dan memilih field yang perlu diekstrak, satu klik demi satu klik. Get Started Free
Thunderbit dirancang supaya ekstraksi jadi mudah, akurat, dan mudah diakses—bahkan untuk orang yang belum pernah menulis satu baris kode pun. (Dan ya, ibu saya bisa memakainya. Walau masih berjuang dengan Netflix.)
Thunderbit Agentic Web Scraper: Fitur Utama untuk Pengguna Bisnis
Izinkan saya sedikit membanggakan apa yang kami bangun di Thunderbit (hei, masa nggak boleh, kan?). Thunderbit dirancang untuk pengguna bisnis—sales, operasional, marketing, properti—yang menginginkan hasil, bukan pusing. Inilah yang membuatnya menonjol:
- One Click Extract: Klik sekali, dan AI Thunderbit memindai halaman, menyarankan kolom, lalu menyiapkan scraper untuk Anda. Tak perlu lagi utak-atik selector.
- 2-Click Scraping: Setelah field siap, tinggal tekan “Scrape” dan dapatkan tabel yang rapi—tanpa coding, tanpa setup rumit.
- Subpage Scraping: Butuh detail tambahan? Thunderbit bisa otomatis membuka setiap subhalaman (seperti halaman produk atau profil) dan memperkaya tabel Anda dengan informasi ekstra.
- Template Siap Pakai: Untuk situs populer (Amazon, Zillow, Instagram, Shopify, dll.), cukup pilih template lalu mulai—tanpa setup.
- Ekspor ke Mana Saja: Ekspor gratis ke Excel, Google Sheets, Airtable, Notion, atau CSV. Tanpa biaya tersembunyi.
- Scheduled Scraping: Otomatiskan scraping berkala—cukup jelaskan intervalnya (“setiap Senin jam 8 pagi”) dan Thunderbit mengurus sisanya.
- Cloud atau Browser Scraping: Gunakan server cloud Thunderbit untuk kecepatan, atau browser Anda sendiri untuk situs yang membutuhkan login.
- Dukungan Multibahasa: Scrape dalam 34 bahasa, termasuk Inggris, Spanyol, Mandarin, dan lainnya.
Coba Thunderbit Agentic Web Scraper Gratis Paket gratis mencakup 6 halaman per bulan, tanpa perlu kartu kredit — cara yang bagus untuk menguji ekstraksi di situs target Anda. Get Started Free
Otomatiskan dan Skalakan: Menggunakan Alat Penjadwalan dan Integrasi untuk Menarik Data
Scraping manual itu sudah zamannya dulu. Nilai sebenarnya muncul saat Anda mengotomatiskan dan mengintegrasikan ekstraksi data ke dalam alur kerja Anda:
- Scheduled Scraping: Atur Thunderbit agar menjalankan scraping harian, mingguan, atau sesuai jadwal apa pun yang Anda mau. Cocok untuk pemantauan harga, generasi prospek, atau agregasi berita.
- Integrasi Langsung: Ekspor data hasil scraping langsung ke Google Sheets, Excel, Airtable, atau Notion. Tak perlu lagi mengunduh dan mengunggah file berulang kali.
- Integrasi CRM & Analitik: Alirkan data ke CRM atau alat BI untuk dashboard real-time, notifikasi, atau outreach otomatis.
Contoh: Alur Kerja Pemantauan Harga Otomatis
- Siapkan Thunderbit di halaman produk kompetitor.
- Gunakan “One Click Extract” untuk menangkap nama produk, harga, dan URL.
- Jadwalkan scraping setiap pagi pukul 7.
- Ekspor hasil ke Google Sheets yang terhubung ke dashboard.
- Manajer pricing meninjau perubahan dan menyesuaikan strategi sebelum kompetitor bangun.
Dengan otomasi, Anda bukan cuma lebih cepat—Anda juga selalu update.
Praktik Terbaik Menangani Data Tidak Terstruktur Saat Menarik Data dari Situs Web
Jujur saja: sebagian besar data web tidak rapi dan serba teratur. Datanya tidak terstruktur, tidak konsisten, dan kadang memang aneh. Begini cara merapikannya:
- Biarkan AI Menentukan Strukturnya: Gunakan One Click Extract atau template untuk memberi urutan—AI yang menentukan kolom dan tipe data, lalu Anda bisa menyesuaikannya setelah itu jika perlu.
- Field AI Prompts: Thunderbit memungkinkan Anda menambahkan instruksi khusus untuk setiap field. Ingin mengategorikan produk, memformat nomor telepon, atau menerjemahkan deskripsi? Cukup beri tahu AI apa yang Anda mau.
- Manfaatkan NLP: Untuk ulasan, komentar, atau artikel, gunakan fitur NLP bawaan untuk meringkas, menilai sentimen, atau mengekstrak kata kunci.
- Normalisasi Data: Rapikan format (tanggal, harga, nomor telepon) saat proses scraping, bukan setelahnya. Konsistensi adalah kunci.
- Hilangkan Duplikasi dan Validasi: Hapus data ganda dan cek sampel hasil untuk memastikan akurasi. Kalau ada yang janggal, sesuaikan prompt atau pengaturannya.
Field AI Prompts: Menyesuaikan Ekstraksi Data untuk Hasil yang Lebih Baik
Ini salah satu fitur favorit saya. Dengan prompt AI per field, Anda bisa:
- Memberi Label dan Kategori: “Klasifikasikan produk ini sebagai Elektronik, Furnitur, atau Pakaian berdasarkan deskripsinya.”
- Memaksa Format: “Keluarkan tanggal dalam format YYYY-MM-DD.” “Ambil hanya harga numeriknya.”
- Menerjemahkan Secara Langsung: “Terjemahkan deskripsi produk ke bahasa Inggris.”
- Membersihkan Noise: “Ambil bio pengguna, abaikan tautan ‘Read more’ atau iklan.”
- Menggabungkan Field: “Gabungkan beberapa baris alamat menjadi satu field.”
Rasanya seperti punya analis junior yang tertanam di dalam scraper—yang tidak pernah mengeluh soal waktu istirahat kopi.
Memastikan Kualitas dan Konsistensi Data dalam Ekstraksi Data Situs Web
Ekstraksi data yang bagus tidak berhenti saat Anda menekan “Export.” Begini cara menjaga data tetap bersih dan andal:
- Pengecekan Validasi: Gunakan range check, field wajib, dan unique key untuk mendeteksi kesalahan.
- Audit Sampel: Tinjau manual sebagian sampel data hasil scraping terhadap situs sumber—terutama setelah setup atau jika situs berubah.
- Penanganan Error: Catat scraping yang gagal dan siapkan notifikasi untuk anomali (misalnya penurunan jumlah baris yang tiba-tiba).
- Pembersihan Berkelanjutan: Gunakan spreadsheet atau skrip untuk menghapus spasi, memperbaiki encoding, dan menormalkan teks.
- Konsistensi Skema: Jaga nama field dan format tetap stabil dari waktu ke waktu. Dokumentasikan perubahan agar tim Anda tidak perlu menebak-nebak.
Kepercayaan terhadap data itu segalanya. Sedikit ketelitian di awal akan menghemat banyak masalah di kemudian hari.
Lihat Perbandingan Thunderbit Lihat bagaimana ekstraksi AI satu klik dari Thunderbit cocok dibandingkan alat web scraping lainnya di pasar. Get Started Free
Membandingkan Alat Ekstraksi: Apa yang Perlu Dicari Saat Memilih Solusi
Tidak semua alat web scraping itu sama. Ini yang perlu dipertimbangkan:
| Alat | Kelebihan | Pertimbangan |
|---|---|---|
| Thunderbit | Paling mudah untuk pengguna non-teknis; deteksi field berbasis AI; scraping subpage; template siap pakai; ekspor gratis; paket terjangkau (Thunderbit Blog). | Tidak dirancang untuk proyek super besar yang sangat bergantung pada developer; menggunakan sistem kredit. |
| Browse AI | No-code, bagus untuk memantau perubahan; integrasi Google Sheets; ekstraksi massal. | Paket awal lebih mahal; setup bisa memakan waktu. |
| Octoparse | Kuat, mampu menangani situs dinamis; fitur lanjutan untuk pengguna teknis. | Kurva belajar curam; harga lebih tinggi. |
| Web Scraper (webscraper.io) | Gratis untuk proyek kecil; setup visual; komunitas kuat. | Setup manual bisa membingungkan; dukungan AI terbatas. |
| Diffbot | Berbasis AI, memproses halaman tidak terstruktur via API; sangat cocok untuk developer. | Mahal, berbasis API, tidak cocok untuk pengguna non-teknis. |
Saran saya: Jika Anda pengguna bisnis yang menginginkan hasil cepat dan akurat, Thunderbit adalah pilihan yang sangat pas. Untuk power user atau developer, Octoparse atau Diffbot bisa layak dipertimbangkan jika Anda siap dengan kompleksitas ekstra. Selalu coba paket gratis atau trial sebelum berkomitmen.
Kesimpulan: Menerapkan Praktik Terbaik Ekstraksi Data Situs Web
Menarik data dari situs web kini bukan lagi sesuatu yang “bagus kalau ada”—ini sudah wajib bagi bisnis yang ingin tetap kompetitif. Berikut poin yang saya harap Anda bawa pulang:
- Nilai: Data web mendorong keputusan yang lebih cerdas dan cepat. Jangan biarkan itu terlewat.
- Atasi Tantangan: Gunakan alat berbasis AI untuk menangani data tidak terstruktur, volume besar, dan perubahan situs.
- Tetap Legal: Patuhi hukum privasi, aturan situs, dan keamanan data.
- Otomatiskan: Jadwalkan dan integrasikan ekstraksi ke alur kerja harian Anda.
- Utamakan Kualitas: Validasi, bersihkan, dan pantau data Anda agar tetap tepercaya.
Siap melihat betapa mudahnya? Unduh Ekstensi Chrome Thunderbit dan coba di proyek data berikutnya. Kalau Anda ingin belajar lebih dalam, kunjungi Thunderbit Blog untuk panduan, tips, dan contoh nyata lainnya.
Selamat scraping—semoga data Anda selalu terstruktur, patuh, dan siap dipakai.
Mulai Ekstraksi Data dengan Thunderbit Pasang ekstensi Chrome gratis dari Thunderbit dan mulai mengekstrak data terstruktur dari halaman mana pun hanya dengan satu klik. Get Started Free
FAQ
1. Apakah legal mengekstrak data dari situs web apa pun?
Secara umum, scraping data yang tersedia untuk publik legal di banyak yurisdiksi, tetapi Anda harus menghindari melewati login atau mekanisme keamanan. Selalu tinjau syarat layanan situs dan patuhi undang-undang privasi seperti GDPR dan CCPA (xbyte.io).
2. Bagaimana AI meningkatkan proses ekstraksi data dari situs web?
Alat berbasis AI seperti Thunderbit bisa mendeteksi field otomatis, menyesuaikan diri dengan layout yang berubah, membersihkan dan memformat data, bahkan menangani konten dinamis atau terjemahan—semuanya dengan setup minimal dan akurasi tinggi (scrapingapi.ai).
3. Apa praktik terbaik untuk menangani data tidak terstruktur?
Tentukan struktur data dari awal, gunakan prompt AI per field untuk memandu ekstraksi, normalisasi format saat scraping, dan validasi hasil Anda. Alat seperti Thunderbit memudahkan pengkategorian, pemformatan, dan pelabelan data secara langsung.
4. Bagaimana cara mengotomatiskan dan menskalakan ekstraksi data situs web?
Gunakan fitur penjadwalan untuk menjalankan scraping secara berkala, lalu integrasikan hasilnya langsung ke alat seperti Google Sheets, Airtable, atau CRM Anda. Otomasi memastikan data tetap segar dan mengurangi pekerjaan manual.
5. Bagaimana memastikan kualitas dan konsistensi data hasil ekstraksi?
Terapkan pengecekan validasi, audit sampel secara rutin, tangani error dengan baik, dan jaga skema tetap konsisten dari waktu ke waktu. Peningkatan berkelanjutan dan pemantauan adalah kunci untuk menjaga data tetap dapat dipercaya.
Ingin melihat praktik terbaik ini bekerja langsung? Coba paket gratis Thunderbit dan rasakan betapa mudah, legal, dan skalabelnya ekstraksi data web.
Coba Agentic Web Scraper Get Started Free
Pelajari Lebih Lanjut




