
בואו נהיה כנים — אף אחד לא מתעורר בבוקר עם חשק להעתיק ולהדביק 500 שורות של מחירי מוצרים לתוך גיליון אלקטרוני. (אם כן, אני מצדיע לך על הסיבולת וממליץ על תומך טוב לפרק כף היד.) בין אם אתה עובד במכירות, בתפעול, או פשוט מנסה להשאיר את העסק שלך צעד אחד לפני המתחרים, כנראה כבר חווית את הכאב של עבודה עם נתונים מאתרים. העולם נשען היום על נתוני ווב, והביקוש לחילוץ אוטומטי רק מזנק — שוק תוכנות גריפת אתרים צפוי להגיע ליותר מ-11 מיליארד דולר עד 2032.
ביליתי שנים בעולם ה-SaaS והאוטומציה, וראיתי הכול: ממקרו-Excel הירואיים ועד סקריפטי Python שחוברו יחד עם פלסטרים ב-2 בלילה. במדריך הזה אראה לך איך להשתמש במנתח HTML של Python כדי לגרוף נתונים אמיתיים מהעולם — כן, נחלץ יחד דירוגי סרטים מ-IMDb — וגם אראה לך למה ב-2026 יש דרך טובה יותר: כלים מבוססי AI כמו Thunderbit שמאפשרים לך לדלג על הקוד ולעבור ישר לתובנות.
מהו מנתח HTML ולמה להשתמש בו ב-Python?
נתחיל מהבסיס: מה בעצם עושה מנתח HTML? תחשוב עליו כספרן האישי שלך לרשת. הוא קורא את קוד ה-HTML המבולגן שמאחורי דף אינטרנט ומארגן אותו למבנה מסודר, דמוי עץ. כך אפשר לשלוף בדיוק את הנתונים שאתה צריך — כותרות, מחירים, קישורים — בלי ללכת לאיבוד בים של תגיות זווית ו-div-ים.
Python היא השפה המועדפת למשימה הזו, ובצדק. היא קריאה, ידידותית למתחילים, ויש לה אקו-סיסטם עצום של ספריות לגריפת ווב ולניתוח HTML. למעשה, Python היא בפער השפה הפופולרית ביותר לגריפת אתרים, בזכות עקומת הלמידה הנוחה והתמיכה החזקה של הקהילה.
רשימת שחקני ה-HTML Parser של Python
אלו הכלים המרכזיים שתפגוש כשמנתחים HTML ב-Python:
- BeautifulSoup: הבחירה הקלאסית והידידותית למתחילים. עדיין מתוחזקת באופן פעיל —
beautifulsoup44.14.3 שוחררה ב-PyPI בסוף 2025 — כך שההדרכות כאן לא שולחות אותך לספרייה מיושנת. - lxml: מהיר וחזק, עם שאילתות מתקדמות.
- html5lib: סלחני במיוחד ל-HTML מבולגן, בדיוק כמו הדפדפן שלך.
- PyQuery: מאפשר להשתמש בסלקטורים בסגנון jQuery בתוך Python.
- HTMLParser: המנתח המובנה של Python — תמיד שם, אבל קצת בסיסי.
לכל אחד יש את הניואנסים שלו, אבל כולם עוזרים להפוך HTML גולמי לנתונים מובְנים.
מקרי שימוש מרכזיים: איך עסקים נהנים ממנתחי HTML של Python
חילוץ נתונים מהווב הוא לא רק עניין של חובבי טכנולוגיה או מדעני נתונים. זה הפך לפעילות עסקית מרכזית, במיוחד במכירות ובתפעול. הנה למה:
| מקרה שימוש (ענף) | נתונים שנגרפים בדרך כלל | תוצאה עסקית |
|---|---|---|
| ניטור מחירים (קמעונאות) | מחירי מתחרים, רמות מלאי | תמחור דינמי, שיפור מרווחים (מקור) |
| מודיעין על מוצרים של מתחרים | רשימות מוצרים, ביקורות, זמינות | זיהוי פערים, יצירת לידים (מקור) |
| יצירת לידים (מכירות B2B) | שמות עסקים, אימיילים, אנשי קשר | איתור לקוחות פוטנציאליים אוטומטי, צמיחה בצנרת המכירות (מקור) |
| סנטימנט שוק (שיווק) | פוסטים חברתיים, ביקורות, דירוגים | משוב בזמן אמת, זיהוי מגמות (מקור) |
| איסוף נדל״ן | רשימות נכסים, מחירים, מידע על מתווכים | ניתוח שוק, אסטרטגיית תמחור (מקור) |
| מודיעין לגיוס | פרופילי מועמדים, משכורות | איתור טאלנטים, השוואת שכר (מקור) |
בקיצור: אם עדיין אתה מעתיק נתונים ידנית, אתה משאיר זמן וכסף על השולחן.
הכירו את ערכת הכלים של מנתח HTML ב-Python: השוואה בין ספריות פופולריות
בואו ניכנס לעומק. הנה השוואה מהירה בין ספריות מנתחי HTML הפופולריות ביותר ב-Python, כדי שתוכל לבחור את הכלי הנכון למשימה:
| ספרייה | קלות שימוש | מהירות | גמישות | צורכי תחזוקה | מתאים במיוחד ל |
|---|---|---|---|---|---|
| BeautifulSoup | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐ | בינוניים | מתחילים, HTML מבולגן |
| lxml | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | בינוניים | מהירות, XPath, מסמכים גדולים |
| html5lib | ⭐⭐⭐ | ⭐ | ⭐⭐⭐⭐⭐ | נמוכים | ניתוח כמו דפדפן, HTML שבור |
| PyQuery | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ | בינוניים | חובבי jQuery, סלקטורים של CSS |
| HTMLParser | ⭐⭐⭐ | ⭐⭐⭐ | ⭐ | נמוכים | משימות פשוטות, מובנות במערכת |
BeautifulSoup: הבחירה הידידותית למתחילים
BeautifulSoup הוא ה-“hello world” של ניתוח HTML. התחביר שלו אינטואיטיבי, התיעוד מצוין, והוא סלחני ל-HTML מכוער או לא תקין (ראו עוד). החיסרון? הוא לא המהיר ביותר, במיוחד בעמודים גדולים או מורכבים, והוא לא תומך כברירת מחדל בסלקטורים מתקדמים כמו XPath.
lxml: מהיר ועוצמתי
אם אתה צריך מהירות או רוצה להשתמש בשאילתות XPath, lxml הוא חבר שלך (פרטים). הוא בנוי על ספריות C, ולכן הוא מהיר מאוד, אבל ההתקנה שלו יכולה להיות קצת מאתגרת ועקומת הלמידה תלולה יותר.
אפשרויות נוספות: html5lib, PyQuery ו-HTMLParser
- html5lib: מנתח HTML בדיוק כמו הדפדפן שלך — מצוין ל-Markup שבור או מוזר, אבל הוא איטי (השוואה).
- PyQuery: מאפשר להשתמש בסלקטורים בסגנון jQuery בתוך Python, וזה נוח אם אתה מגיע מעולם ה-Front-end (ראו תיעוד).
- HTMLParser: האפשרות המובנית של Python — מהירה ותמיד זמינה, אבל פחות עשירה ביכולות.
שלב 1: הגדרת סביבת מנתח ה-HTML שלך ב-Python
לפני שאפשר לנתח משהו, צריך להקים את סביבת ה-Python. כך עושים זאת:
-
התקן את Python: הורד מ-python.org אם עדיין אין לך.
-
התקן pip: בדרך כלל מגיע עם Python 3.4+, אבל אפשר לבדוק עם
pip --versionבטרמינל. -
התקן את הספריות (במדריך הזה נשתמש ב-BeautifulSoup וב-requests):
pip install beautifulsoup4 requests lxmlbeautifulsoup4הוא המנתח.requestsמאפשר לשלוף דפי ווב.lxmlהוא מנתח מהיר ש-BeautifulSoup יכול להשתמש בו ברקע.
-
בדוק את ההתקנה:
python -c "import bs4, requests, lxml; print('All good!')"
טיפים לפתרון בעיות:
- אם מופיעות שגיאות הרשאה, נסה
pip install --user ... - ב-Mac/Linux, ייתכן שתצטרך להשתמש ב-
python3וב-pip3. - אם אתה רואה “ModuleNotFoundError”, בדוק שוב את האיות ואת סביבת ה-Python שלך.
שלב 2: ניתוח דף אינטרנט ראשון עם Python
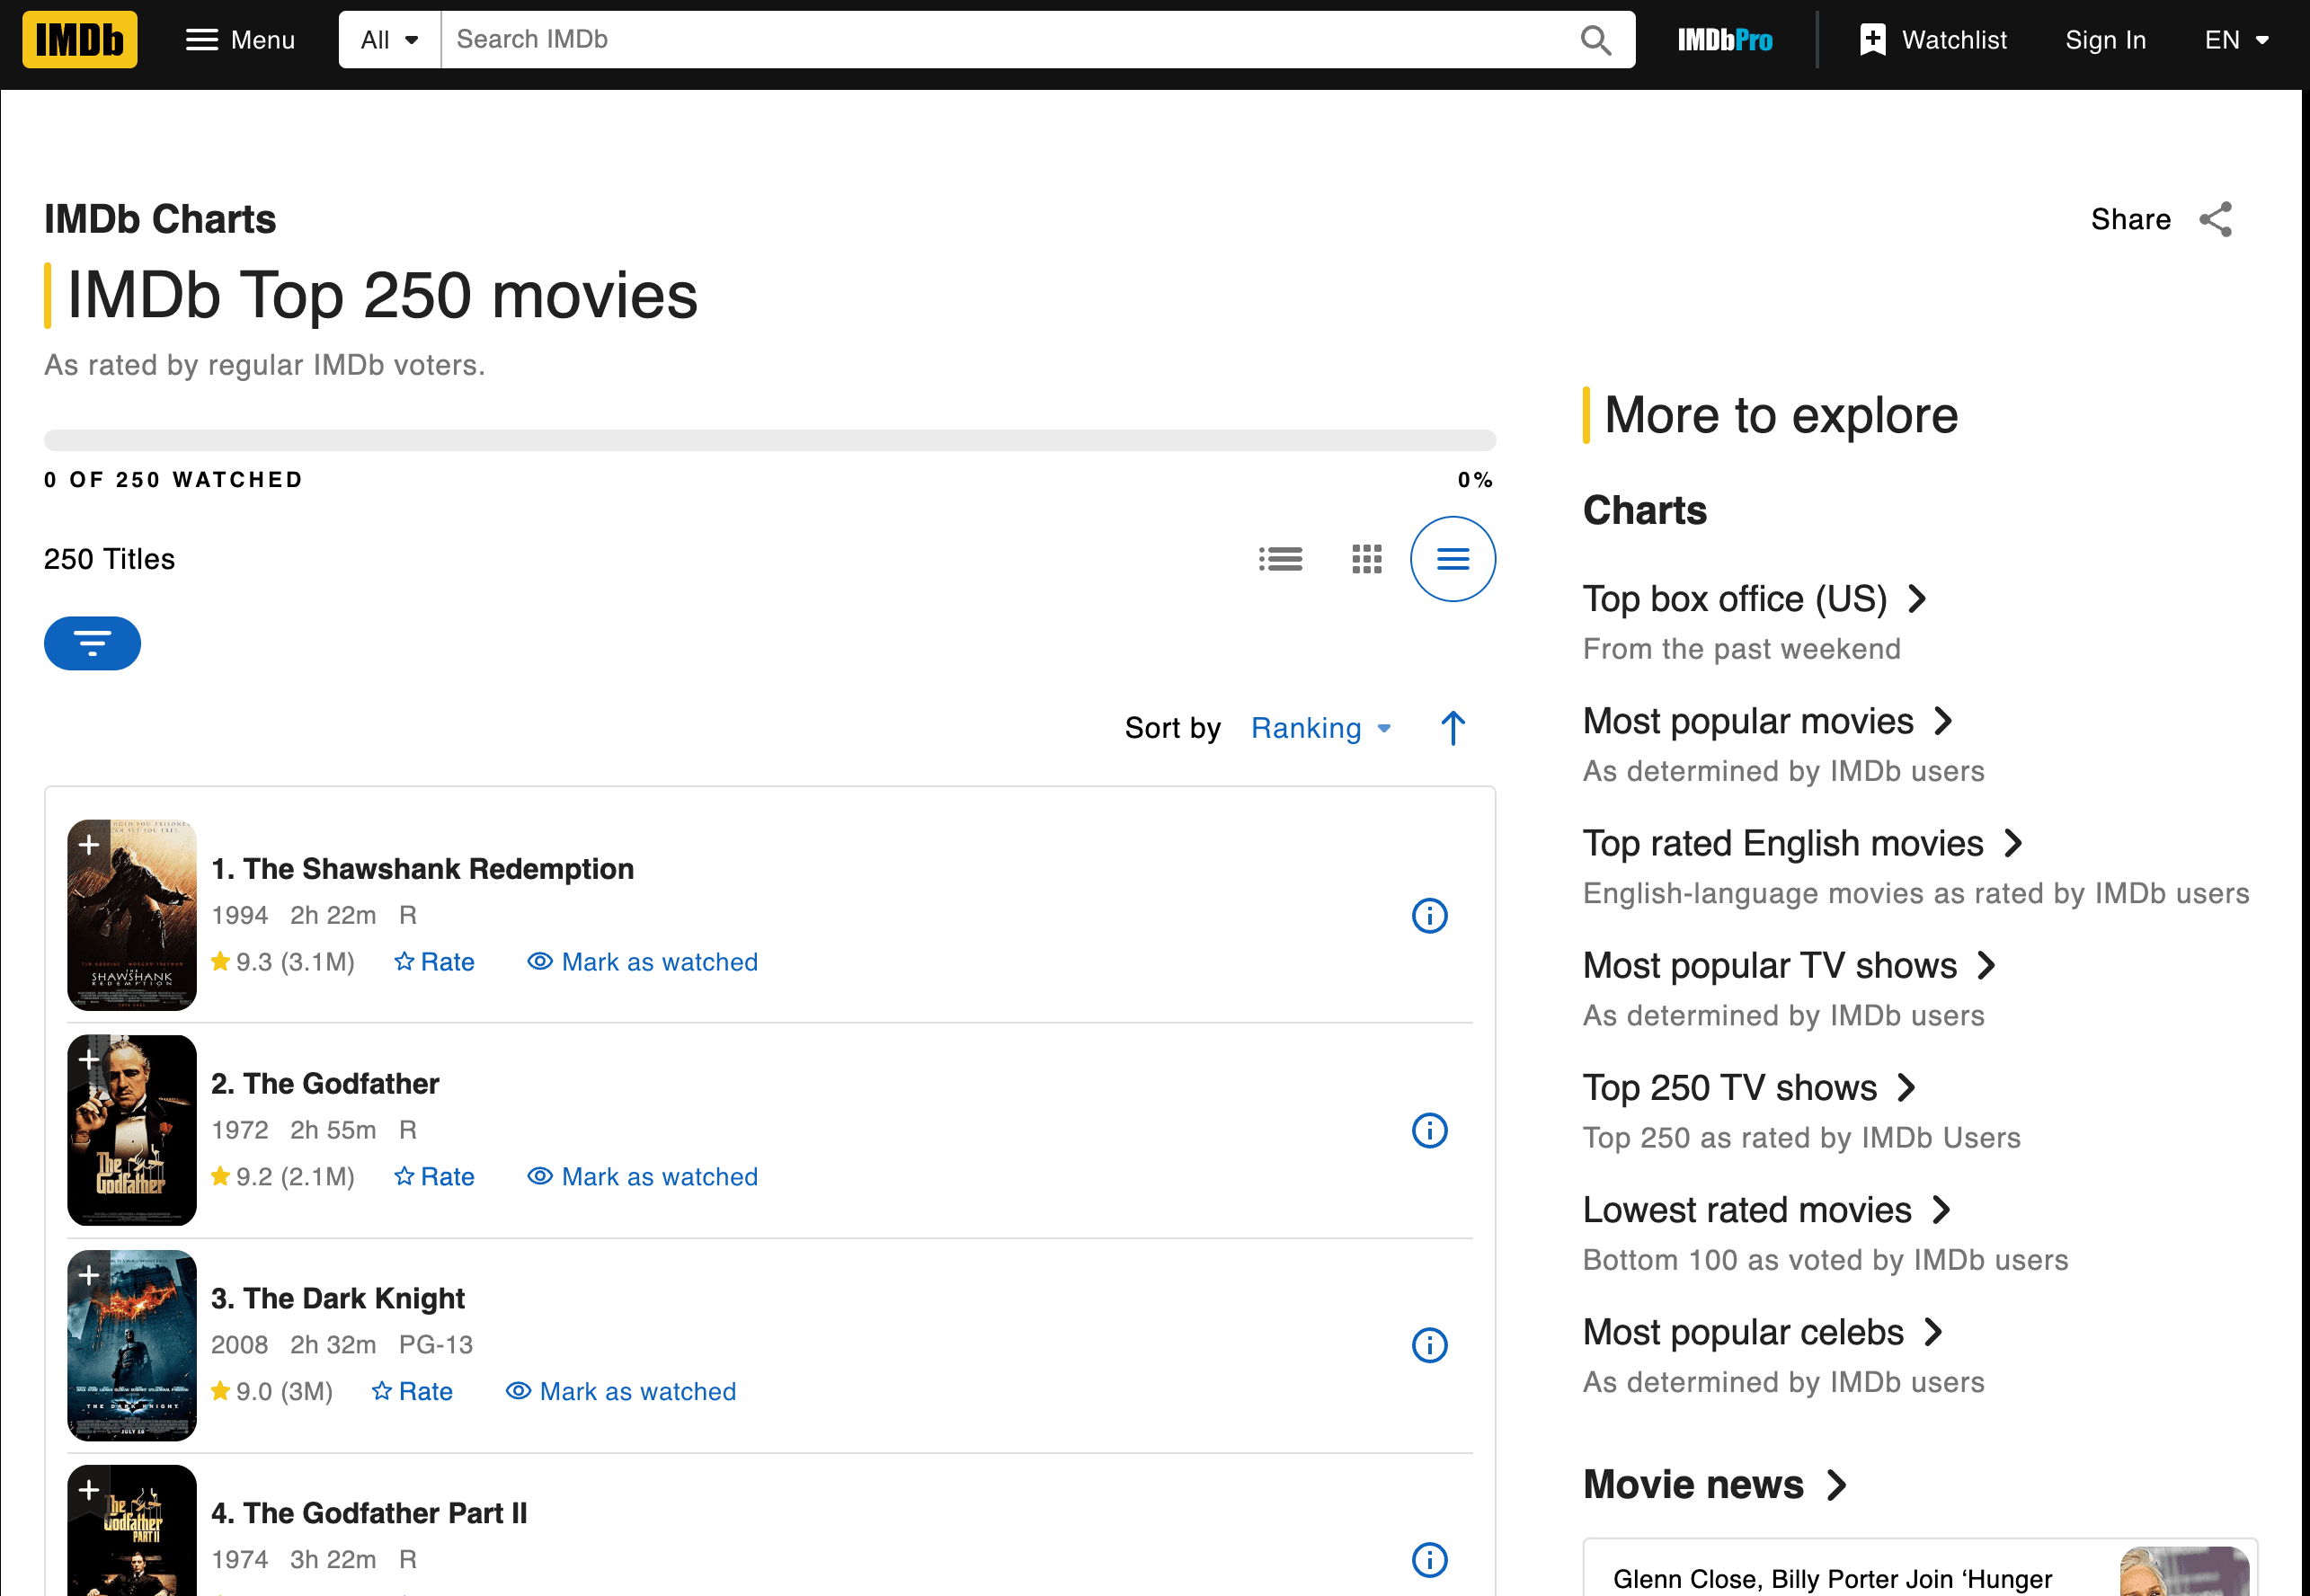
בואו נלכלך קצת את הידיים ונגרוף את 250 הסרטים המובילים של IMDb. נחלץ את שמות הסרטים, השנים והדירוגים.
שליפת הדף וניתוחו
הנה סקריפט שלב-אחר-שלב. הערה קצרה לפני שאתה מעתיק: IMDb עיצבה מחדש את דף Top 250 ביוני 2023, כך שהסלקטורים הישנים td.titleColumn / td.ratingColumn שתראה עדיין בהדרכות ישנות כבר לא מתאימים לשום דבר. ה-Markup הנוכחי משתמש במחלקות שמתחילות ב-ipc- ונוצרות על ידי מערכת הרכיבים שלהם, ו-IMDb שינתה את הדף עוד כמה פעמים מאז (כולל אמצע 2025), אז כדאי להסתכל שוב ב-DevTools בכל פעם שחוזרים לדוגמה הזו.
import requests
from bs4 import BeautifulSoup

url = "https://www.imdb.com/chart/top/"
headers = {"User-Agent": "Mozilla/5.0"}  # IMDb מחזירה Markup מצומצם בלי UA אמיתי
resp = requests.get(url, headers=headers)
soup = BeautifulSoup(resp.text, "html.parser")

# כל שורה היא פריט רשימה מתחת למכלול התרשימים
rows = soup.select("li.ipc-metadata-list-summary-item")

for i, row in enumerate(rows[:3], start=1):
    title_el  = row.select_one("h3.ipc-title__text")
    year_el   = row.select_one("span.cli-title-metadata-item")
    rating_el = row.select_one("span.ipc-rating-star--rating")

    title  = title_el.get_text(strip=True) if title_el else None
    # הטקסט של h3 חוזר כ-"1. The Shawshank Redemption" — מסירים את קידומת הדירוג
    if title and ". " in title:
        title = title.split(". ", 1)[1]
    year   = year_el.get_text(strip=True) if year_el else None
    rating = rating_el.get_text(strip=True) if rating_el else None

    print(f"{i}. {title} ({year}) -- Rating: {rating}")
מה קורה כאן?
- אנחנו משתמשים ב-
requests.get()כדי להביא את הדף (עםUser-Agentשנראה אמיתי — לפעמים IMDb מגישה שלד מצומצם ללקוחותpython-requestsרגילים). BeautifulSoupמנתח את ה-HTML.- אנחנו שולפים כל שורת סרט דרך
li.ipc-metadata-list-summary-item, ואז שולפים מתוכה את הכותרת (h3.ipc-title__text), השנה (span.cli-title-metadata-item) והדירוג (span.ipc-rating-star--rating) באמצעותselect_one(). - אנחנו מחלצים את הטקסט של הכותרת, השנה והדירוג, ומסירים את מספר הדירוג המוביל (
"1. ") ש-IMDb מטמיעה בתוך טקסט הכותרת.
אם אתה רוצה משהו עמיד יותר מאשר לרדוף אחרי שינויים בשמות מחלקות כל כמה חודשים, IMDb גם מציבה באותו דף בלוק <script type="application/ld+json"> עם אותם נתונים בצורה מובנית — אפשר לנתח אותו עם json.loads(soup.find("script", type="application/ld+json").string) וללכת על מערך itemListElement. זו הגישה שהייתי מעדיף בייצור; גרסת סלקטורי ה-CSS למעלה קלה יותר ללימוד אבל שבירה יותר.
פלט:
1. The Shawshank Redemption (1994) -- Rating: 9.3
2. The Godfather (1972) -- Rating: 9.2
3. The Dark Knight (2008) -- Rating: 9.0
חילוץ נתונים: איך מוצאים כותרות, דירוגים ועוד
איך ידעתי באילו תגיות ומחלקות להשתמש? בדקתי את ה-HTML של דף IMDb (קליק ימני > Inspect Element בדפדפן). חפש תבניות — כאן, כל שורת סרט נמצאת בתוך <li class="ipc-metadata-list-summary-item">, כשהכותרת תחת <h3 class="ipc-title__text"> והדירוג תחת <span class="ipc-rating-star--rating">. ויש הסתייגות חשובה: IMDb החליפה את ה-Markup הזה יותר מפעם אחת (הפריסה של td.titleColumn שתמצא עדיין במדריכים ישנים לא עובדת מאז העיצוב מחדש של יוני 2023), ולכן תמיד התייחס למחרוזות המחלקה כדוגמה בלבד ובדוק שוב לפני הרצת הסקריפט.
טיפ מקצועי: אם אתה גורף אתר אחר, תמיד תתחיל בבדיקת מבנה ה-HTML ובזיהוי שמות מחלקות או תגיות ייחודיים.
שמירה וייצוא של התוצאות
בואו נשמור את הנתונים שלנו לקובץ CSV:
import csv

movies = []
for i in range(len(title_cells)):
    title_cell = title_cells[i]
    rating_cell = rating_cells[i]
    title = title_cell.a.text
    year = title_cell.span.text.strip("()")
    rating = rating_cell.strong.text if rating_cell.strong else rating_cell.text
    movies.append([title, year, rating])

with open('imdb_top250.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(['Title', 'Year', 'Rating'])
    writer.writerows(movies)
טיפים לניקוי נתונים:
- השתמש ב-
.strip()כדי להסיר רווחים מיותרים. - טפל בנתונים חסרים עם בדיקות
if. - לייצוא ל-Excel, אפשר לפתוח את ה-CSV ב-Excel או להשתמש ב-
pandasכדי לכתוב קבצי.xlsx.
שלב 3: התמודדות עם שינויים ב-HTML ואתגרי תחזוקה
כאן הדברים מתחילים להיות אמיתיים. אתרים אוהבים לשנות את הפריסה שלהם — לפעמים רק כדי להשאיר את הסקרייפרים על קצות האצבעות (או לפחות ככה זה מרגיש). אם IMDb מחליפה class="titleColumn" ל-class="movieTitle", הסקריפט שלך פתאום יחזיר תוצאות ריקות. הייתי שם, ניפיתי באגים בזה.
כשהסקריפטים נשברים: בעיות אמיתיות מהשטח
בעיות נפוצות:
- לא נמצאו סלקטורים: הקוד לא מצליח למצוא את התג/מחלקה שציינת.
- תוצאות ריקות: מבנה הדף השתנה, או שהתוכן נטען עכשיו דרך JavaScript.
- שגיאות HTTP: האתר הוסיף מנגנוני אנטי-בוט.
שלבי פתרון בעיות:
- בדוק אם ה-HTML שאתה מנתח תואם למה שאתה רואה בדפדפן.
- עדכן את הסלקטורים כך שיתאימו למבנה החדש.
- אם התוכן נטען באופן דינמי, ייתכן שתצטרך לעבור לכלי אוטומציה של דפדפן (כמו Selenium) או למצוא נקודת קצה של API.
מה כאב הראש האמיתי? אם אתה גורף 10, 50 או 500 אתרים שונים, ייתכן שתבזבז יותר זמן על תיקון סקריפטים מאשר על ניתוח הנתונים עצמם (ראו סיפורי מפתחים).
שלב 4: סקיילינג — העלויות הנסתרות של ניתוח HTML ידני ב-Python
נניח שאתה רוצה לגרוף לא רק את IMDb, אלא גם את Amazon, Zillow, LinkedIn ועוד תריסר אתרים. כל אתר צריך סקריפט משלו. וכל פעם שאתר משתנה, אתה חוזר לעורך הקוד.
העלויות הנסתרות:
- עבודת תחזוקה: יש שמעריכים שתחזוקה היא פי 10 מעלות הפיתוח הראשונית.
- תשתית: תצטרך פרוקסי, טיפול בשגיאות ומעקב.
- ביצועים: סקיילינג אומר להתמודד עם מקביליות, מגבלות קצב ועוד.
- בקרת איכות: יותר סקריפטים = יותר מקומות שבהם דברים יכולים להישבר.
עבור צוותים לא טכניים, זה הופך מהר מאוד לבלתי-בר-קיימא. זה כמו להעסיק צוות של מתמחים להעתיק ולהדביק נתונים כל היום — רק שהמתמחים הם סקריפטי Python, והם “מוציאים מחלה” בכל פעם שאתר משתנה.
הערה קצרה על סוכני קוד מבוססי AI
לפני שנעבור לכלים ללא קוד, שווה להזכיר נתיב ביניים שבקושי היה קיים כשנכתבו רוב המדריכים בסגנון “למד BeautifulSoup”: סוכני קוד מבוססי AI. כלים כמו Claude Code או Cursor ישמחו לקבל תיאור באנגלית (“fetch IMDb’s Top 250, pull title / year / rating into a CSV”) ולנסח עבורך סקריפט עובד של requests + BeautifulSoup במכה אחת, כולל סוג הניקוי של הסלקטורים שעשינו ידנית זה עתה. לזרימות דפדפן בשפה טבעית — התחברות, דפדוף בין עמודים, התמודדות עם באנרי קוביות — ספרייה כמו Browser Use יכולה להפעיל דפדפן headless ישירות מתוך פרומפט.
אבל הם לא מעלימים את הקשיים. מגבלות קצב, robots.txt, מסכי התחברות והגנות אנטי-בוט עדיין עליך, וכשסלקטור נשבר בשקט (כמו שקרה ל-IMDb) עדיין צריך להבין מה הסוכן יצר ולתקן אותו. לכן, גם אם יש סוכן בלולאה, ההבנה של זרימת מנתח ה-HTML במדריך הזה היא מה שמאפשר לך לדבג את הפלט במקום לבהות ברשימות ריקות.
מעבר למנתחי HTML ב-Python: הכירו את Thunderbit, האלטרנטיבה מבוססת ה-AI
ועכשיו נכנסים לחלק המרגש. מה אם היית יכול לדלג על הקוד, לדלג על התחזוקה, ופשוט לקבל את הנתונים שאתה צריך — לא משנה איך האתר משתנה?
בדיוק בשביל זה בנינו את Thunderbit. זו תוספת Chrome של AI web scraper שמאפשרת לך לחלץ נתונים מובְנים מכל אתר בשני קליקים. בלי Python, בלי סקריפטים, בלי כאב ראש.
מנתחי HTML של Python מול Thunderbit: זה לצד זה
| היבט | מנתחי HTML ב-Python | Thunderbit (ראו תמחור) |
|---|---|---|
| זמן הקמה | גבוה (התקנה, קוד, דיבוג) | נמוך (התקנת התוסף, קליק) |
| קלות שימוש | דורש קוד | בלי קוד — מצביעים ולוחצים |
| תחזוקה | גבוהה (סקריפטים נשברים לעיתים קרובות) | נמוכה (ה-AI מסתגל אוטומטית) |
| סקיילביליות | מורכבת (סקריפטים, פרוקסי, תשתית) | מובנית (גריפת ענן, משימות אצווה) |
| העשרת נתונים | ידנית (לכתוב עוד קוד) | מובנית (תיוג, ניקוי, תרגום, תתי-עמודים) |
למה לבנות כשאפשר לפתור את הבעיה עם AI?
למה לבחור ב-AI לחילוץ נתוני ווב?
הסוכן החכם של Thunderbit קורא את הדף, מבין את המבנה, ומסתגל כשהדברים משתנים. זה כאילו יש לך מתמחה-על שלעולם לא ישן ולעולם לא מתלונן כששמות המחלקות משתנים.
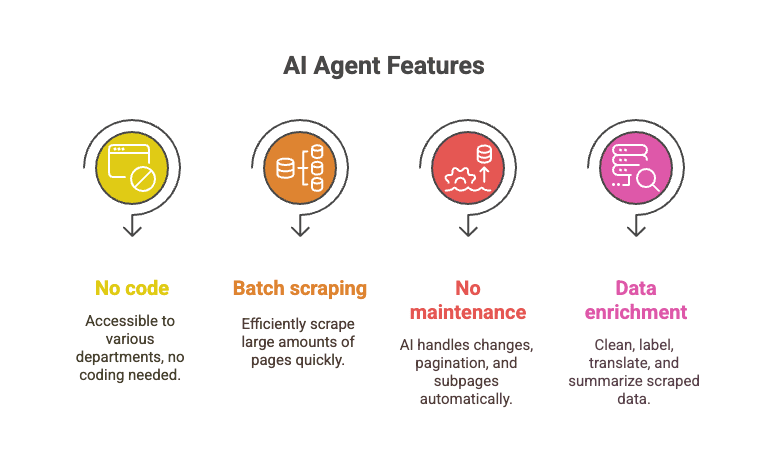
- אין צורך בקוד: כל אחד יכול להשתמש בזה — מכירות, תפעול, שיווק, מה שתרצה.
- גריפה באצווה: גרוף יותר מ-10,000 עמודים בזמן שלוקח לנפות באגים בסקריפט Python אחד.
- בלי תחזוקה: ה-AI מטפל בשינויי פריסה, דפדוף בין עמודים, תתי-עמודים ועוד.
- העשרת נתונים: נקה, תייג, תרגם וסכם נתונים תוך כדי הגריפה.
הצד השני של תהליך BeautifulSoup שעברנו עליו זה בדיוק סוג השבריריות שפגשנו בסלקטורים של IMDb למעלה — כשהעמוד מתארגן מחדש, הסקריפט מחזיר בשקט תוצאות ריקות, ואתה מעביר את אחר הצהריים ב-DevTools במקום להסתכל על נתונים. סקרייפר AI ללא קוד מסתיר את השלב הזה מאחורי שכבת הסקה משלו; זו פשרה אמיתית (אתה סומך על כך שהחילוץ של מישהו אחר נכון), לא קסם.
צעד-אחר-צעד: גריפת דירוגי סרטים מ-IMDb עם Thunderbit
בואו נראה איך Thunderbit מטפל באותה משימה של IMDb:
- התקן את תוסף Chrome של Thunderbit.
- נווט אל דף Top 250 של IMDb.
- לחץ על אייקון Thunderbit.
- לחץ על “AI Suggest Fields.” Thunderbit יקרא את הדף וימליץ על עמודות (כותרת, שנה, דירוג).
- בדוק או התאם את העמודות אם צריך.
- לחץ על “Scrape.” Thunderbit יחלץ את כל 250 השורות מיד.
- ייצא ל-Excel, Google Sheets, Notion או CSV — לבחירתך.
זהו. בלי קוד, בלי דיבוג, בלי רגעי “למה הרשימה ריקה?”.
רוצה לראות את זה בפעולה? בדוק את ערוץ היוטיוב של Thunderbit להדרכות, או קרא את המדריך שלב-אחר-שלב לגריפת Amazon לדוגמה נוספת מהעולם האמיתי.
מסקנה: איך לבחור את הכלי הנכון לצורכי נתוני הווב שלך
מנתחי HTML של Python כמו BeautifulSoup ו-lxml הם חזקים, גמישים וחינמיים. הם מצוינים למפתחים שרוצים שליטה מלאה ולא אכפת להם ללכלך את הידיים. אבל הם מגיעים עם עקומת למידה תלולה, תחזוקה שוטפת ועלויות נסתרות — במיוחד ככל שצרכי הגריפה שלך גדלים.
עבור משתמשי עסק, צוותי מכירות וכל מי שרוצה פשוט את הנתונים (ולא את הקוד), כלים מבוססי AI כמו Thunderbit הם משב רוח רענן. הם מאפשרים לך לחלץ, לנקות ולהעשיר נתוני ווב בקנה מידה גדול, בלי קוד ובלי תחזוקה.
העצה שלי? השתמש ב-Python אם אתה אוהב סקריפטים וצריך התאמה אישית מלאה. אבל אם הזמן שלך יקר לך — וגם השפיות — תן ל-Thunderbit הזדמנות. למה לבנות ולשמור על סקריפטים כשאפשר לתת ל-AI לעשות את העבודה הקשה?
רוצה ללמוד עוד על גריפת אתרים, חילוץ נתונים ואוטומציה מבוססת AI? צלול לעוד מדריכים ב-בלוג של Thunderbit, כמו איך לגרוף נתוני אתר לתוך Excel באמצעות AI או כלי ותוכנות הגריפה הטובים ביותר ב-2025.




