
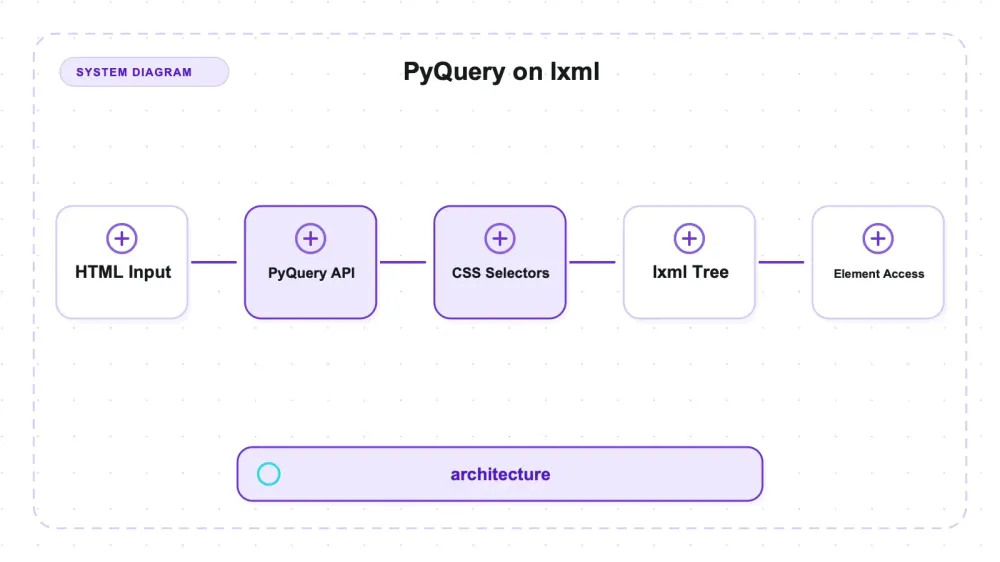
PyQuery מציבה ממשק API בסגנון jQuery מעל lxml. על פני חמישה גדלי עמוד, מ-1 KB ועד 10 MB, כל חמשת ערכי החציון שהוצגו היו נמוכים יותר מאלה של lxml הגולמי, כולל פער של 1.5% בגודל הגדול ביותר. הבנצ'מרק לא מוכיח שה־wrapper מהיר יותר; הוא פשוט לא מצא הבדל מספיק גדול כדי לשנות את ההחלטה לגבי בחירה וקריאה.
גם מול selectolax התוצאות היו בטווח של כמה אחוזים בלבד, החל מ-10 KB ומעלה, בערכי החציון המוצגים. בלי תחום שקילות שהוגדר מראש, זו תוצאה קרובה — לא תיקו סטטיסטי.
מה זה PyQuery
PyQuery היא ספריית Python שמעניקה לעץ מסמכי lxml ממשק בחירה ושרשור כמו של jQuery. גרסה שנבדקה: 2.1.0, רישיון BSD, 2,380 כוכבי GitHub, 59 בעיות פתוחות, דחיפה אחרונה ב-2026-07-27.
מסמך רשמי: תיעוד PyQuery.
from pyquery import PyQuery as pq
d = pq(html)
titles = [e.text_content() for e in d("h3.title")]
hrefs = [e.get("href") for e in d("a")]
האובייקטים שהיא מחזירה הם איברי lxml, כך שכל מה שיודעים לעשות עם lxml עדיין עובד. זה בדיוק הרעיון: PyQuery היא שכבת נוחות, לא פרסר. pip install pyquery מתקין 3 חבילות — lxml, cssselect ו-PyQuery עצמה — ותופס 20.1 MiB, כמעט כולו תוספים קומפילטיביים של lxml.
אם השתמשתם ב-cheerio ב-Node, זה אותו רעיון כללי של API גם ב-Python. שני הסלקטורים שנבדקו כאן עבדו בשתיהן; הבדיקה לא מוכיחה שקילות מלאה של שפת הסלקטורים בין cssselect ל-cheerio.
איך נמדד המבחן
לבסיס המחקר הזה כבר היה בנצ'מרק לפרסרים עם תכונה שרוב המדדים חסרים: שער שקילות שמחשב hash לתוכן שחולץ — כותרות ממוינות בתוספת hrefים ממוינים — מול פרסר ייחוס, כך שספרייה שחותכת פינות לא יכולה להציג זמן מהיר מזויף. חמישה גדלי עמודים, 50 איטרציות, שלוש הרצות בלתי תלויות.
כדי להוסיף אליו את PyQuery היה צריך שני דברים.
להריץ מחדש את הייחוס. selectolax רץ שוב באותו תהליך. ה-hash של התוכן שוחזר ב-5 מתוך 5 גדלים וערך ה-p50 שלו היה בין 0.989× ל-1.079× מהנתון שפורסם — כלומר, מדובר באותה מכונה ובאותה סביבת בדיקה.
להריץ גם את lxml באותו תהליך. הבנצ'מרק שפורסם מתעד את המכונה ואת גרסת Python, אבל לא את גרסאות הספריות, ולכן שורת lxml שם יכלה להגיע מגרסת lxml אחרת מזו ש-PyQuery עוטפת כאן. השוואה על פני הפער הזה הייתה משווה למעשה בין שתי גרסאות lxml ומייחסת זאת לעלות של ה-wrapper. הרצת lxml לצד PyQuery מסירה את השאלה הזו — שניהם lxml 6.1.1 בסביבת ה-venv הזו.
| גודל עמוד | selectolax | PyQuery | lxml | PyQuery לעומת lxml |
|---|---|---|---|---|
| 1 KB | 0.0286 ms | 0.0456 ms | 0.0508 ms | 0.90× |
| 10 KB | 0.1725 ms | 0.1728 ms | 0.1802 ms | 0.96× |
| 100 KB | 1.4855 ms | 1.4093 ms | 1.4145 ms | 1.00× |
| 1 MB | 14.97 ms | 14.96 ms | 15.03 ms | 1.00× |
| 10 MB | 158.10 ms | 162.86 ms | 165.25 ms | 0.99× |
p50 במילישניות, חציון של שלוש הרצות, כולן באותו תהליך. parser-bench.json. כל שלושת ה-hashים של התוכן תאמו את הייחוס בכל גודל.
העלות של ה-wrapper שלא קיימת
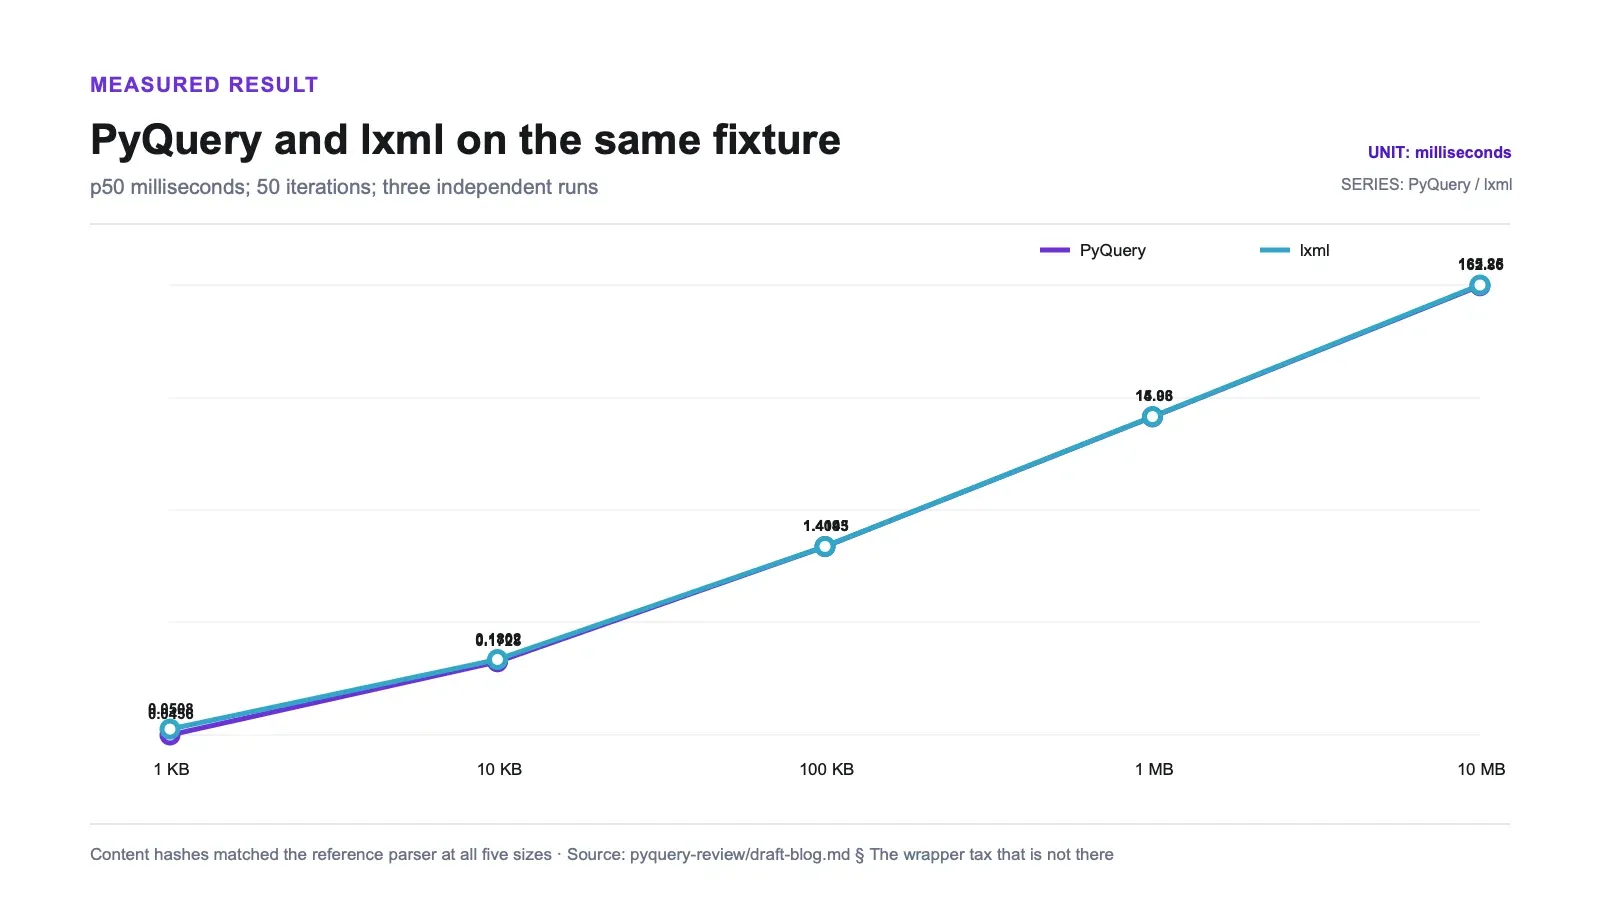
PyQuery יצאה באותו טווח או מתחת ל-lxml הגולמי בכל חציון שהוצג. אין בכך הוכחה שה-wrapper מאיץ פרסור. שלושה חציונים של הרצות, בלי תחום שקילות מוגדר מראש, תומכים במסקנה המצומצמת יותר: בדוגמה הזו לא נראתה תקורת בחירה רלוונטית-להחלטה.
ב-10 MB, שלוש ההרצות של PyQuery היו 162.86, 163.17 ו-161.13 ms; של lxml היו 169.46, 165.25 ו-164.18. הטווחים קרובים אך אינם חופפים. ב-1 MB שני החציונים נבדלים ב-0.5%. הרצות קצרות כאלה תומכות בשיקול מעשי, לא בטענת שקילות סטטיסטית.
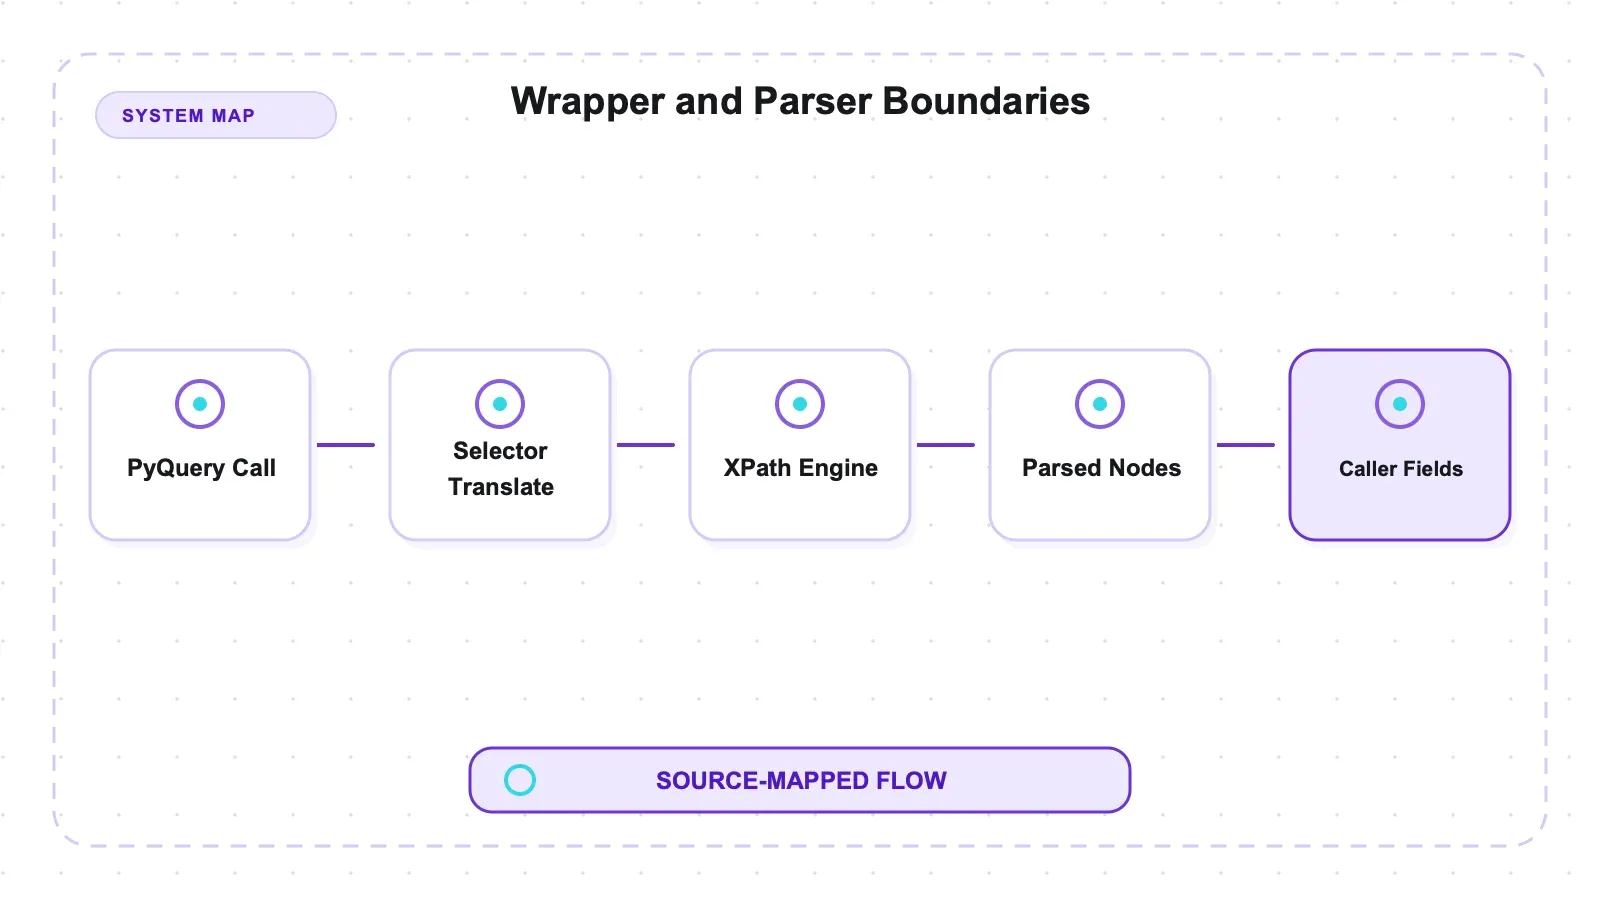
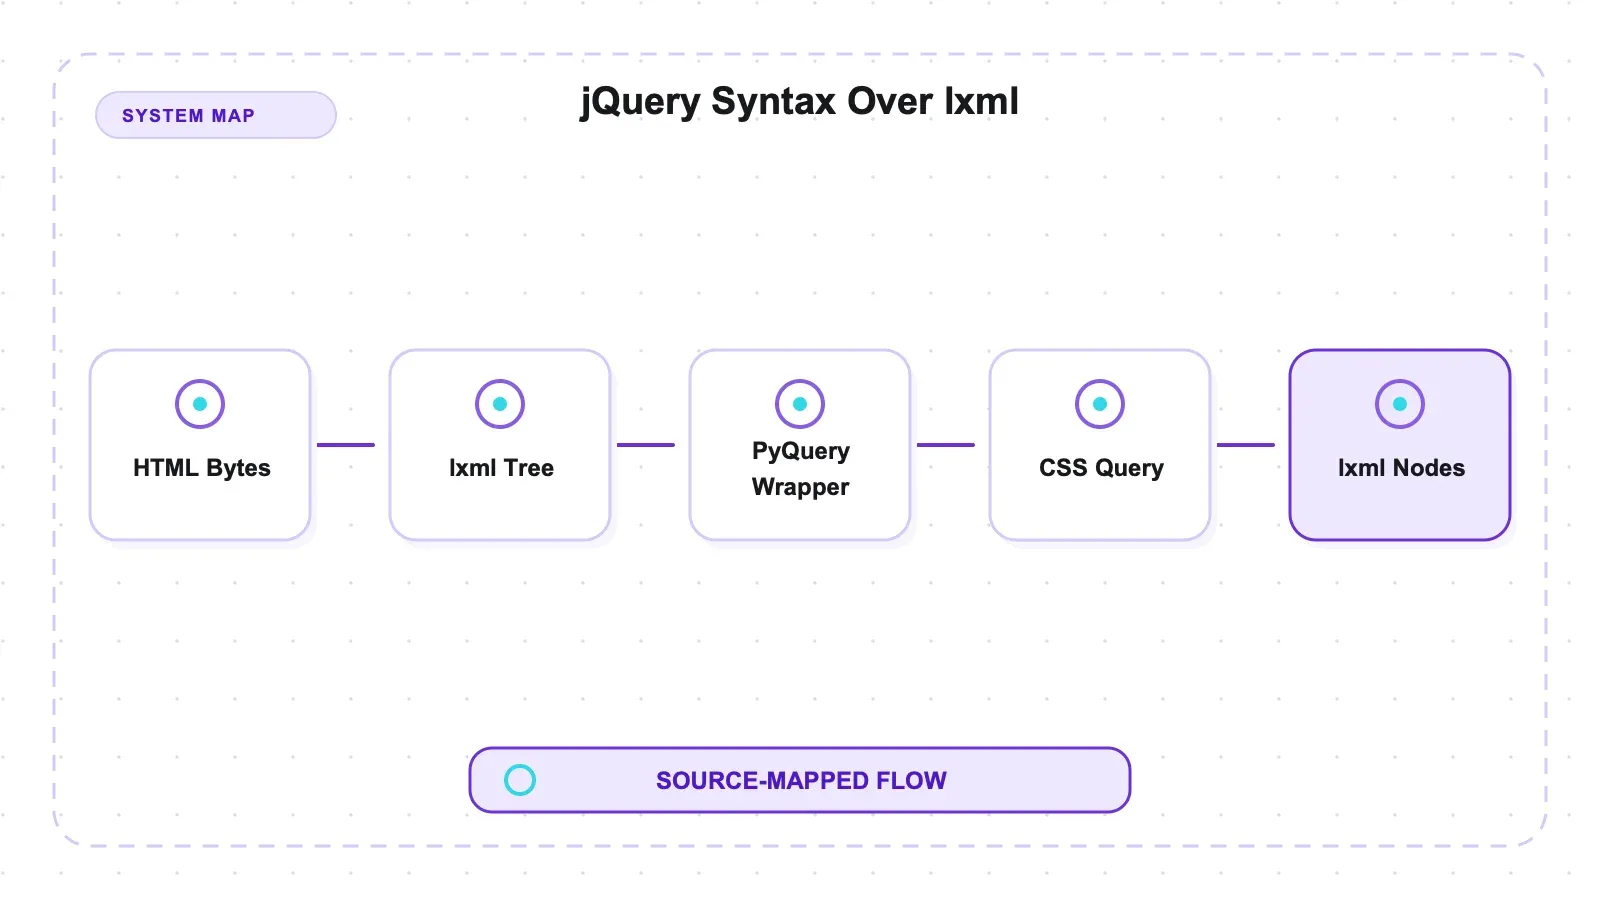
המנגנון פשוט למדי: pq(html) בונה עץ lxml פעם אחת, d("h3.title") מקמפל את סלקטור ה-CSS דרך cssselect בדיוק כמו tree.cssselect(), והאיברים שמוחזרים הם איברי lxml. לכן, יש מעט מאוד עבודה של PyQuery בנתיב החם שנמדד. Traversal, מניפולציה, שאילתות חוזרות, import וזיכרון — כולם מחוץ לטענת הזמן של הסלקטור.
תוצאות קרובות מ-10 KB ומעלה
הממצא השימושי יותר הוא העמודה הראשונה.
מ-10 KB ומעלה, הפער בין המהיר ביותר לאיטי ביותר בחציון בין selectolax, lxml ו-PyQuery היה 4.5% ב-10 KB, 5.4% ב-100 KB, 0.5% ב-1 MB, ו-4.5% ב-10 MB. זה לא היה מבחן שקילות; המסקנה המעשית היא שהפערים האלה לא צפויים לשנות את רוב הבחירות בפרסר עבור עומס העבודה הזה.
selectolax אכן מהירה יותר ב-1 KB — 0.0286 ms מול 0.0456 ו-0.0508 — אבל השורה הזו לא ניתנת לדירוג. בין שלושת הפרסרים הפער בגודל הזה הוא 77.6%, ושלוש הרצות של selectolax עצמה נעו בין 0.0267 ל-0.0404 ms. ב-28 מיקרו-שניות, הטיימר וה-scheduler שולטים. לא הייתי מדרג שם אף אחת.
לעומס העבודה הזה של בחירה וקריאה, כדאי לבחור בין שלוש האפשרויות לפי ה-API ולפי נתוני התלויות שנמדדו — ולא לפי היררכיית מהירות משוערת. PyQuery לא הציגה עונש רלוונטי-להחלטה מול lxml. ל-selectolax יש סט פרסר שונה, אבל המאמר הזה לא מדד את footprint ההתקנה שלה, כיסוי ה-wheels או דרישות הבנייה באותו אופן.
לשם השוואה, הבנצ'מרק שפורסם כלל עוד שתי אפשרויות Python על אותו fixture של 10 MB, ואלו דווקא התוצאות שבאמת שונות:
| פרסר (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159.93 ms |
| lxml | 172.93 ms |
| parsel | 231.85 ms |
| selectolax (modest) | 247.95 ms |
| BeautifulSoup + lxml | 2,261.56 ms |
| BeautifulSoup + html.parser | 2,788.75 ms |
הנתונים פורסמו מתוך bench_parse.json.
שורות הבנצ'מרק ההיסטוריות מציבות את BeautifulSoup יותר מסדר גודל אחד מעל חציוני הפרסרים המהירים יותר על אותו fixture. השורות האלה לא הורצו מחדש עם זוג PyQuery/lxml בתהליך הנוכחי, ולכן הן שימושיות כהקשר — לא כמכפיל מבוקר לפסק הדין הראשי.
השורה המאוחסנת של Cheerio הייתה 2,927.89 ms (2927.8857 ב-parser-bench.json) עם התאמה של hashים לתוכן שנחילץ. גם התוצאה הזו בין סביבות ריצה תלוייה ב-Node, בגרסאות חבילה ובבקרות ההרצה ההיסטוריות; אי אפשר לקרוא ממנה מכפיל מהירות של ספרייה בודדת בלבד.
מציאות ההתקנה
| ספרייה | חבילות | נפח דיסק | רישיון | כוכבים | דחיפה אחרונה |
|---|---|---|---|---|---|
| PyQuery | 3 | 20.1 MiB | BSD | 2,380 | 2026-07-27 |
| cheerio (Node) | 22 (npm) | 9.0 MiB | MIT | 30,449 | 2026-08-11 |
מסמך רשמי: PyQuery ב-PyPI.
שלוש חבילות הן footprint תלותי נקי, ושתיים מהן — lxml ו-cssselect — הן רכיבים שכבר יושבים בהרבה פרויקטים של scraping ב-Python. במקרה כזה, העלות הנוספת של PyQuery היא רק כמה עשרות קילובייטים.
ה-20.1 MiB הם התוספים הקומפילטיביים של lxml, לא של PyQuery. זה אותו 20 MiB שתשלמו גם אם תשתמשו ב-lxml ישירות.
החבילה היא ברישיון BSD. בנקודת הזמן המתועדת היו לה 59 בעיות פתוחות ודחיפה שלושה שבועות לפני הבדיקה; התצפיות האלה לבדן לא מוכיחות איכות תחזוקה או תאימות עתידית.
זיכרון, ומה HTML שבור עושה לו
שני דברים שכל סקירה בגל הזה סימנה כלא נבדקו — נמדדו עכשיו.
הקשר הרחב יותר של מבחן העומס נמצא ב-השוואת הזיכרון ו-HTML שבור בין עשר ספריות.
Peak resident memory, באמצעות /usr/bin/time -l, תהליך חדש לכל תא — סף ה-import הוא מה שהספרייה צורכת כשהיא טעונה אבל לא עושה כלום, והפיקים כוללים את המסמך.
| Library | Runtime | Import floor | 226 KB peak | 10 MB peak |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. אין להשוות ישירות בין הבסיס של Python לזה של Node; המתורגמן נמצא בשניהם.
PyQuery היא קלה יותר מ-resiliparse במסמך הגדול — 172.5 MiB מול 225.1 — למרות סף import גבוה יותר. עץ ה-lxml קומפקטי, ורוב ה-30.3 MiB בסף של PyQuery הם בעצם טעינה של lxml ולא משהו ש-PyQuery עצמה עושה.
HTML שבור. שנים-עשר מסמכים, כשכל אחד מהם שובר בדיוק דבר אחד — תגיות לא סגורות, inline elements בתוך מבנה לא נכון, תכונות בלי מרכאות עם רווחים, סגירות מיותרות, בלי <html> בכלל, תכונות כפולות, מסמך שנחתך באמצע תג, ישויות לא תקינות, <script> לא סגור, הצהרת charset שקרית, תגובה שמכילה markup, ו-600 רמות קינון — ועוד שני מסמכי בקרה תקינים בגודל תואם, כי “זה החזיר כלום” אומר משהו על malformedness רק אם הספרייה גם שקטה על מסמך נקי באותו גודל.
pyquery זרקה חריגה ב-0 מתוך 14 ולא החזירה כלום ב-1, ושחזרה 10/22 סמנים ב-fixtures השבורים (malformed-results.json). פיק אחד נגרע מהספירה הזו: לפי HTML5, כל מה שאחרי <script> לא סגור הוא תוכן script, ולכן לאבד אותו שם זה נכון, והשחזור שלו הוא דווקא הסטייה. בלי תוצאות הסמנים של החלופות הישירות ליד זה, 10/22 הוא תצפית על robustness ולא דירוג בחירת פרסר.
יתרונות וחסרונות
לזכותה. תחביר jQuery, מוכר לכל מי שכתב JavaScript לצד לקוח או השתמש ב-cheerio. לא הופיעה תקורת בחירה רלוונטית-להחלטה מול lxml הגולמי ב-fixture הזה. רק 3 חבילות, ו-2 מהן כנראה כבר אצלכם בעץ. היא מחזירה איברי lxml, כך שאפשר להמשיך להשתמש בטכניקות של lxml. BSD. ה-hashים של התוכן תאמו את הייחוס בכל חמשת הגדלים.
נגדה. 20.1 MiB, בגלל lxml. 2,380 כוכבים אומר קהילה קטנה בהרבה מזו של cheerio עם 30,449 — פחות דוגמאות מעשיות כשמשהו מתנהג מוזר. זו שכבת נוחות, אז מה ש-lxml לא יכול לעשות, היא גם לא יכולה. ואם קיוויתם ש-API של jQuery יקנה ביצועים, זה לא המצב: הוא קונה נוחות, והפרסר שמתחת הוא זה שעושה את העבודה.
מי צריך להשתמש בזה, ומי לא
כדאי להשתמש ב-PyQuery אם אתם או הצוות שלכם מעדיפים סלקטורים בסגנון jQuery ב-Python. מדידות הבנייה, שתי הבחירות והקריאות לא הראו עונש רלוונטי-להחלטה מול lxml; פעולות PyQuery אחרות לא נמדדו.
כדאי להשתמש ישירות ב-lxml אם אתם מעדיפים XPath או רוצים חבילה אחת פחות. בהרצה הזו לא עלתה סיבה מבוססת-מהירות לבחור ביניהם.
כדאי להעריך את selectolax אם ממשק הפרסר וסט התלויות שלה מתאימים לפרויקט שלכם. שורת ה-1 KB מסומנת במפורש כלא מדורגת, והמאמר הזה לא תומך בטענה של “סט התלויות הקטן ביותר”.
ב-Node, cheerio היא הצורה המקבילה של אותו רעיון API. השורות המאוחסנות בין סביבות הריצה היו איטיות יותר כאן, אבל ההבדלים בין runtime ובין הרצות היסטוריות מונעים מסקנה נקייה על הספרייה לבדה.
איפה ממשק מנוהל משתלב
PyQuery מנתחת HTML שכבר יש לכם. היא לא מושכת את הדף, לא מרנדרת JavaScript, ולא מטפלת בשכבת anti-bot — ואף פרסר בהשוואה הזו לא עושה זאת, וברבה יעדים אמיתיים זה החצי הקשה יותר.
הערת המחבר: Thunderbit היא האפשרות המנוהלת שלנו למשיכת URL, לרינדור ולחילוץ. היא לא הושוותה כאן ל-PyQuery בבנצ'מרק. הגבול הרלוונטי הוא אם כבר יש לכם HTML ואתם רוצים סלקטורים מקומיים, או שאתם רוצים רכישה וחילוץ של עמוד כ-Service.
המסגור הכנה: אם ה-HTML כבר אצלכם ואתם יודעים את הסלקטורים, PyQuery היא חינמית ונעימה. אם הסלקטורים ממשיכים להישבר, או אם אתם מבצעים fetching בהיקף גדול, זו כבר רכישה אחרת.
לשדה הרחב יותר, ה-סקירה שלנו על Web Scraping APIs מכסה אפשרויות hosted, ו-פוסט ה-pillar על open-source scrapers את אלו שמארחים בעצמם. אם הפלט המנותח מוזן למודל, המרת HTML ל-Markdown ב-Python היא המקום שבו נאמנות הנתונים מתחילה ללכת לאיבוד.
נסו את Thunderbit לחילוץ נתוני אינטרנט
האם כדאי להשתמש ב-PyQuery?
כן, אם אתם רוצים תחביר בסגנון jQuery ב-Python, ונתיב הבחירה והקריאה שנמדד מייצג את עומס העבודה שלכם.
הבנצ'מרק לא מצא תקורת בחירה רלוונטית-להחלטה מול lxml, תוך שמירה על שוויון ב-hash של התוכן. הוא לא הוכיח שעלות הספרייה כולה היא אפס.
על פני חמישה גדלים, חציוני שלושת פרסרי ה-Python נשארו קרובים מספיק כך שהתאמת ה-API כנראה תכריע יותר מהכול בעומס העבודה הזה. הגדירו תחום שקילות והריצו מחדש את החלופות המדויקות לפני שממירים את ההערכה הזו לדירוג פרסרים רחב יותר.
נסו את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם PyQuery מאטה את lxml?
לא הופיעה תקורת בחירה רלוונטית-להחלטה בהרצה הזו. על פני חמישה גדלי עמודים, החציונים שלה היו באותו טווח או נמוכים יותר מ-lxml הגולמי, כששניהם משתמשים ב-lxml 6.1.1 באותו תהליך. ב-10 MB הטווחים הקרובים לא חפפו: PyQuery 161.13–163.17 ms ו-lxml 164.18–169.46 ms. pq(html) בונה עץ lxml, והסלקטורים שנבדקו מתקמפלים דרך cssselect.
האם selectolax מהירה יותר מ-PyQuery? בחציון של 1 KB היא הייתה נמוכה יותר, אבל השורה הזו לא מדורגת כי השונות שולטת בקנה מידה של מיקרו-שניות. מ-10 KB ומעלה, פערי החציונים היו 0.5%–5.4%. זה קרוב לעומס העבודה הזה, אבל לא הוכחה לשקילות או לחפיפת טווחים בכל מקרה.
למה להריץ מחדש את lxml במקום לצטט את המספר שפורסם? כי הבנצ'מרק שפורסם מתעד את המכונה ואת גרסת Python, אבל לא את גרסאות הספריות. ייתכן ששורת lxml שם הגיעה מגרסת lxml אחרת מזו ש-PyQuery עוטפת היום, ופער גרסאות היה נראה כמו עלות wrapper שלא באמת קיימת. הרצת שתיהן באותו תהליך ב-lxml 6.1.1 מסירה את העמימות.
איך זה משתווה ל-cheerio? אותו רעיון API כללי, אקוסיסטם שונה. שני הסלקטורים שנבדקו כאן עבדו בשתיהן וה-hashים של התוכן תאמו בכל חמשת הגדלים; זה לא מוכיח תאימות מלאה של סלקטורים. הזמנים המאוחסנים של Cheerio היו איטיים יותר, אבל בקרות בין-סביבתיות והיסטוריות מונעות טענה על מכפיל של ספרייה בודדת.
מה לא נבדק כאן? הזיכרון נמדד כ-RSS שיא עבור import בלבד, מסמך של 226 KB ומסמך של 10 MB. HTML שבור נבחן עם 12 מסמכים פגומים ועוד שתי בקרות תואמות. עדיין לא נבדקו ביצועי manipulation ו-traversal של PyQuery, מטמון של שאילתות חוזרות, שליפת URLs, מקביליות, ועומסי עבודה מייצגים מאתרים אמיתיים. זמן ה-1 KB נשאר לא מדורג.




