
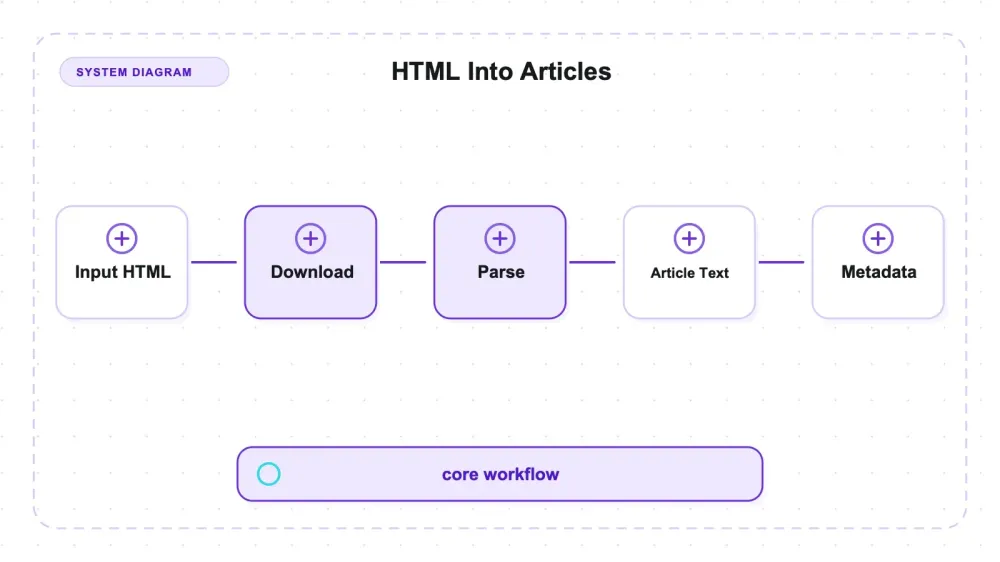
במערך בדיקות אחד, עם תיוג מפורט ומיקוד בכתבות, newspaper4k הפיקה פלט בכל 22 התרחישים, שיחזרה 98.65% מיחידות התוכן שדורגו, ולא כללה אף אחד מטוקני ה־boilerplate שסומנו. שלושת הממדים האלה הופכים אותה למועמדת חזקה לפי סדרי העדיפויות של הבדיקה הזו; הם לא קובעים מנצחת אוניברסלית.
אף כלי אחר במערך הזה לא שילב את שלושת התוצאות הללו יחד. Mozilla Readability שיחזרה את כל יחידות התוכן שדורגו, אבל כללה יותר boilerplate מסומן; goose3 לא כלל boilerplate מסומן, אבל החזיר מחרוזות ריקות פעמיים. כללי הכרעה אחרים יכולים להעדיף ספרייה אחרת.
יש ברירת מחדל אחת ל־fetching שכדאי לשים לב אליה לפני שמכניסים את הכלי לייצור.
מהי newspaper4k
newspaper4k היא גרסה מתוחזקת של newspaper3k, שהייתה בעצמה ההמשך ב־Python 3 של newspaper המקורית. השושלת הזו חשובה כשמחפשים עזרה, כי רוב מה שתמצאו ברשת מתייחס לספריית האם, וחלק מה־API כבר עבר שינוי.
הפניה רשמית: המאגר הרשמי של newspaper4k.
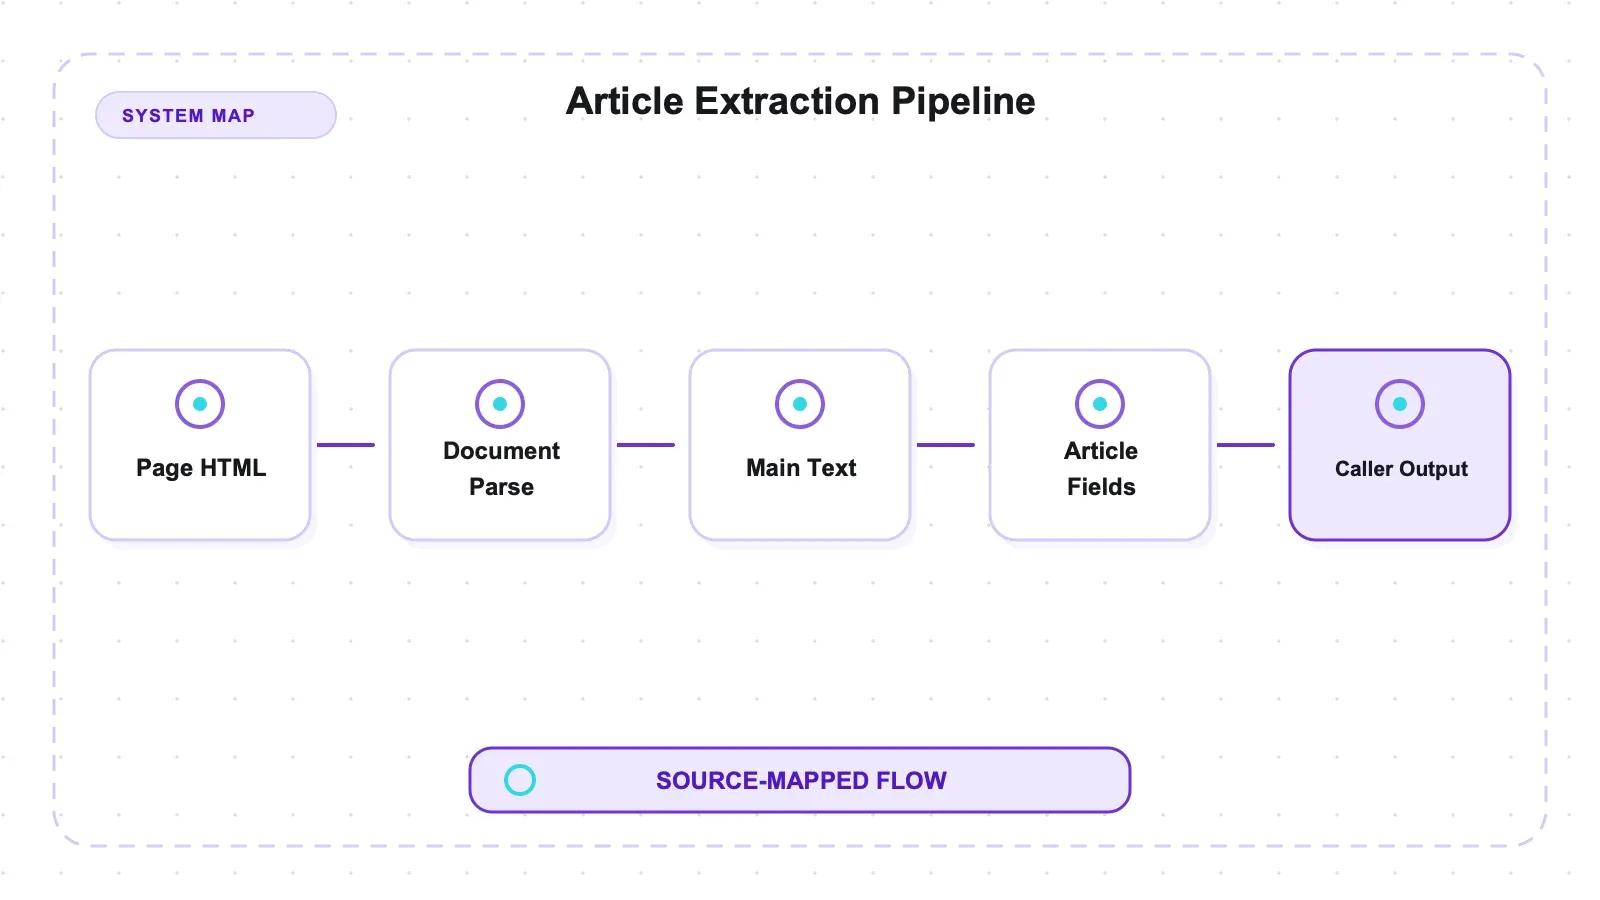
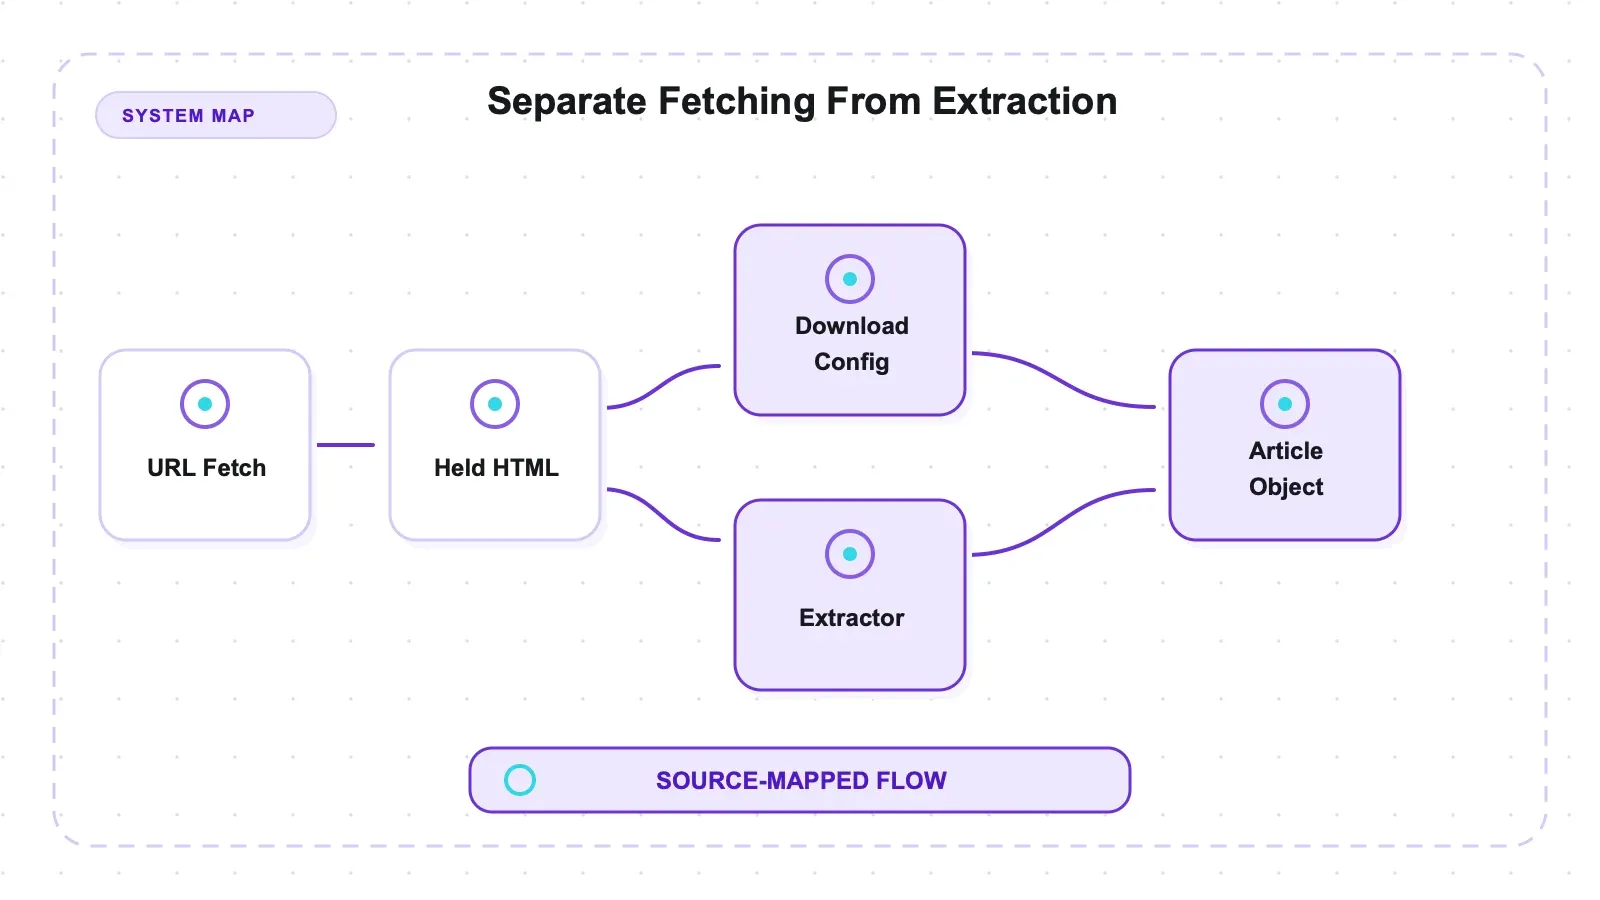
הטעות הנפוצה ביותר עם הספרייה הזו, למשל, היא לנסות להשתמש ב־set_html(). השיטה הזו לא קיימת. HTML נכנס דרך download():
from newspaper import Article
a = Article(url="https://example.com/story")
a.download(input_html=html)     # not set_html()
a.parse()
text = a.text
אני טעיתי בזה בהפעלה הראשונה שלי, ורשמתי לספרייה 0 מתוך 22 תרחישי בדיקה לפני שבדקתי אם הבעיה אצלי. והיא הייתה אצלי.
מה שמקבלים בחזרה הוא לא רק טקסט. אובייקט Article חושף שדות כמו text, title, authors, publish_date, top_image, images, movies, meta_description, meta_lang, tags, ו־article_html. השדות keywords ו־summary דורשים התקנת NLP אופציונלית והגדרת corpus, כמפורט בהמשך. את מגוון השדות מיפינו, אבל את דיוק המטא־דאטה לא דירגנו.
גרסה שנבדקה: 0.9.6, רישיון MIT, 1,135 כוכבי GitHub, עם push למאגר מיום 2026-07-31. הפעילות המתועדת הזו היא תמונת מצב, לא הערכה מלאה של בריאות התחזוקה. Python 3.14.2.
התוצאה
| Library | Article recall (all 22) | Boilerplate leak | Content-token precision | Contaminating tokens | Produced output |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 | 22/22 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 | 22/22 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 | 22/22 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 | 22/22 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 | 19/22 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 | 20/22 |
sixway-scores.json. לכל יחידה בכל תרחיש יש token סנטינל ייחודי, לכן "recovered" ו־"leaked" הם בדיקות מדויקות של הימצאות כמחרוזת, ולא ציון דמיון. ה־recall מחושב על כל 22 התרחישים; ה־leak וה־precision על 11 התרחישים שמכילים גם article וגם boilerplate.
כדאי להפריד בין שלוש עמודות.
היא ענתה לכל דף. goose3 ו־jusText לא — 20 ו־19 מתוך 22. זה משמעותי יותר ממה שזה נראה, כי precision ו־F1 בטבלה כזו תלויים בכך שהכלי מפיק פלט: ספרייה שמחזירה מחרוזת ריקה לא תורמת לאף צד של היחס, ולכן הימנעות היא “חופשית”. ה־precision של goose3, שעומד על 1.0000, נמדד על 10 מתוך 11 תרחישים; של newspaper4k, 0.9452, על 11 מתוך 11. זו לא בדיוק אותה מדידה.
היא לא הדליפה כלום. התרחישים כוללים boilerplate אגרסיבי במכוון — בלוקי promo מסווגים כ־neutral שיושבים כאחים של הכתבה, שרשורי תגובות עם שמות מחלקה תמימים, ובלוקי פרסומות שלא אומרים "ad". ההיוריסטיקה של Readability שמצרפת אחים בלעה כמה מהם; newspaper4k לא לקחה אף אחד.
היא פספסה יחידה אחת מתוך 74, והיחידה הזו היא יחידה משותפת.
הפספוס הוא בתרחיש הלא־פרוזאי — עמוד שנבנה מטבלאות, בלוק קוד, פריטים קצרים וכיתוב לתמונה במקום פסקאות — והיחידה שנעלמה היא הכיתוב. היא לא לבד שם:
| Library | Recall on the non-prose page | Units dropped |
|---|---|---|
| Readability | 1.000 | — |
| jusText | 1.000 | — |
| trafilatura | 0.875 | the caption |
| resiliparse | 0.875 | the caption |
| newspaper4k | 0.875 | the caption |
| goose3 | 0.250 | both tables, the code block, both short items, the caption |
שלוש ספריות מפילות את אותו caption ורק אותו, וזה נראה פחות כמו שלושה באגים נפרדים ויותר כמו הנחת יסוד משותפת לגבי הערך של כיתוב. אם התוכן שלכם הוא תיעוד, מתכונים או כל דבר שבו הכיתוב נושא מידע שהפסקה לא כוללת, שווה לבדוק את זה לפני שמתחייבים — ו־Readability וגם jusText שמרו עליו.
אותו תרחיש הוא גם המקום שבו goose3 מתפרקת לגמרי, ומאבדת שלושה רבעים מהעמוד, כך ש"תוכן לא־פרוזאי" הוא ציר שבו שש הספריות האלה שונות הרבה יותר ממה שנראה מטבלת הכותרת.
במהירות, החציון של newspaper4k על פני 22 התרחישים היה 2.69 ms, האיטי ביותר מבין השש, עם מקרה קיצון של 199.81 ms. מול חציון של 0.06 ms ב־resiliparse, מדובר בפער של 45× בהרצה המבוקרת הזו. ייתכן שחציון כזה קטן בתוך workflow של עמוד יחיד, אבל תפוקה ו־tail latency תחת עומס לא נבדקו. יבוא קר נמדד בנפרד בהמשך.
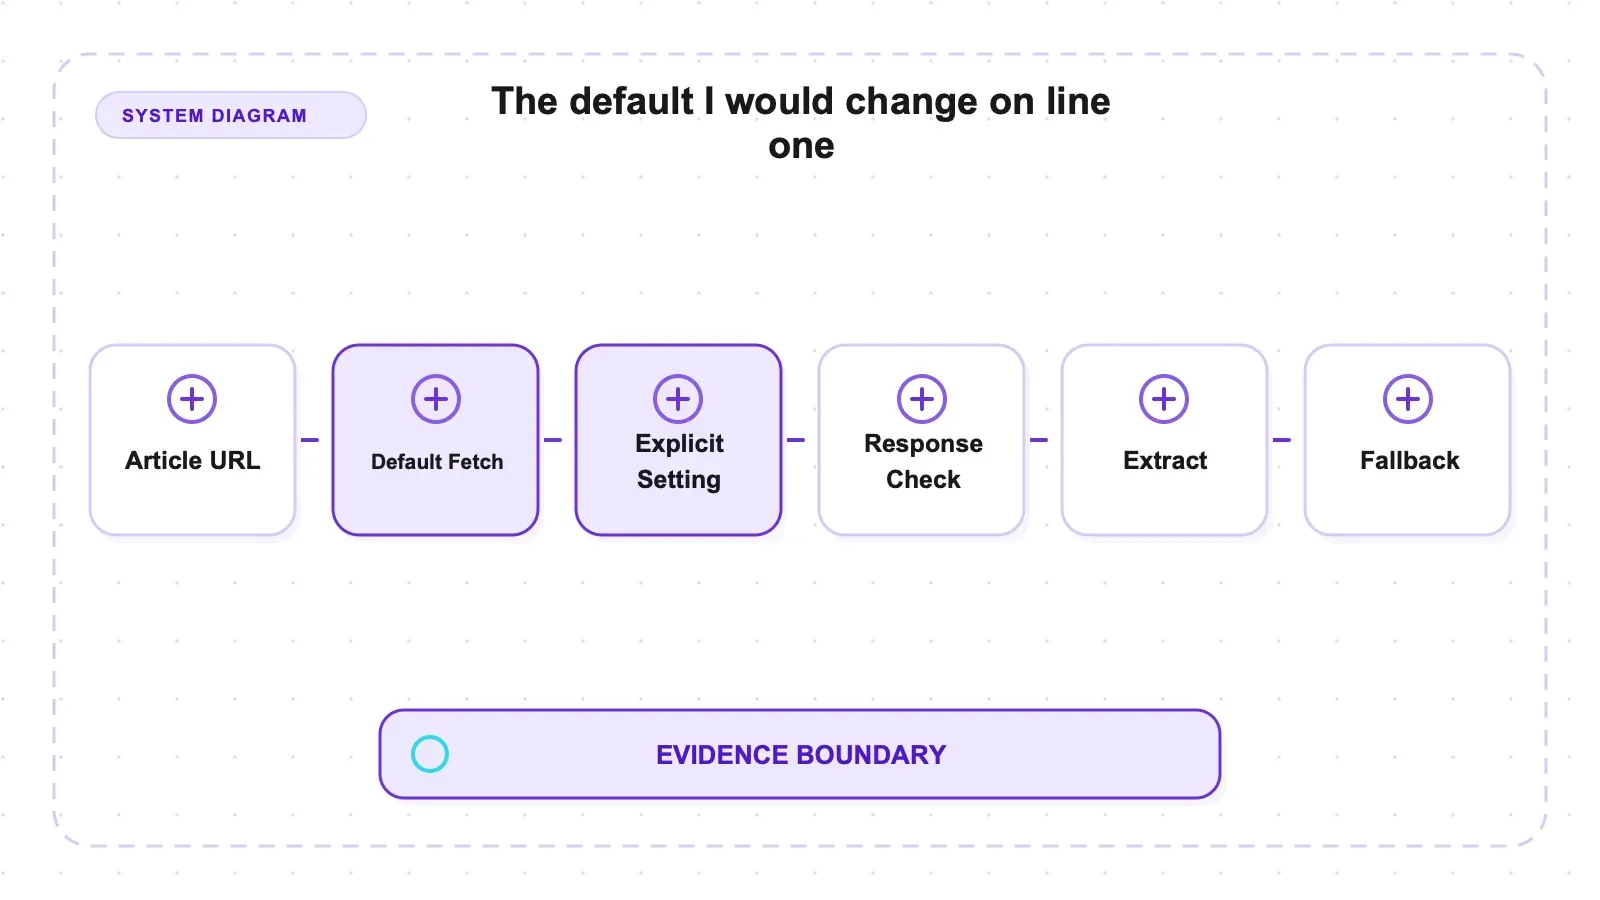
ברירת המחדל שהייתי משנה בשורה הראשונה
הפניה רשמית: התיעוד של newspaper4k.
עיון באובייקט Configuration שמגיע עם החבילה מעלה 22 הגדרות. אחת מהן היא זו:
_honor_robotstxt = False
newspaper4k לא מכבדת robots.txt אלא אם אומרים לה. אם נותנים לה להביא את הדף — Article(url).download() בלי input_html — היא תמשוך כל כתובת שתתנו לה, בלי קשר למה שקובץ ה־robots של האתר אומר.
זו ברירת מחדל הנדסית סבירה עבור ספרייה שהשימוש העיקרי שלה הוא ניתוח HTML שכבר יש בידיכם, אבל היא ברירת מחדל לא סבירה לגלות בייצור אחרי שכבר כיוונתם אותה לאלף כתובות. הגדירו honor_robotstxt=True ב־Configuration, או העבירו input_html ותבצעו את ה־fetching בעצמכם, כפי שעשיתי לאורך הבדיקה הזו.
עוד שתי נקודות שכדאי להכיר:
number_threads = 10. ברירת המחדל של מקביליות לעזרי multi-article היא עשרה threads. מקביליות היא לא בקשות בשנייה, אבל היא כן יכולה ליצור burst של בקשות בו־זמנית אם לא מגדירים מגבלות ותזמון לפי host.
fetch_images = True. שליפת תמונות דולקת כברירת מחדל, וזה מעלה שאלה לגבי שימוש לא־מקוון. עם socket.connect חסום, המסלול שנבדק ב־newspaper4k 0.9.6 — download(input_html=…) ואז parse() על קלט HTML מוחזק אחד — הסתיים, החזיר 1,292 תווים, ולא ניסה אף חיבור רשת. זה תומך בדיוק במסלול הזה, לא בכל תצורה, תוסף, סוג תוכן או גרסה עתידית.
שאר ההגדרות נראות סבירות: min_word_count 300, min_sent_count 7, max_text 100,000, http_success_only True, memorize_articles True, follow_meta_refresh False, allow_binary_content False.
מציאות ההתקנה
pip install newspaper4k מושך 22 חבילות ו־47.5 MiB בכשש שניות. יבוא קר בתהליך subprocess חדש: 2.812 s — האיטי ביותר בהשוואה.
| Library | Packages | site-packages | Cold import | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. כל ספרייה בתוך virtualenv ריק משלה, כך ששום דבר לא יורש תלויות של שכנה.
2.812 שניות לייבוא הן 187 פעמים יותר מ־15 המילישניות של resiliparse. ב־worker שרץ לאורך זמן משלמים את זה פעם אחת וזה כמעט לא משנה. בפונקציית serverless משלמים על זה בכל cold start, ושם newspaper4k היא בחירה לא נכונה, בלי קשר לאיכות ה־extraction שלה.
יש גם נקודת חיכוך בהתקנה. בעת הייבוא מתקבלת אזהרה:
UserWarning: nltk is not installed. Some NLP features will be unavailable. Install it with: pip install 'newspaper4k[nlp]'
שום דבר בבדיקה הזו לא נזקק ליכולות האלה וה־extraction עבד מצוין בלעדיהן, אבל ההתקנה הבסיסית אינה ההתקנה המלאה, ו־newspaper4k[nlp] מושכת עץ תלויות כבד יותר משמעותית יחד עם הורדות corpus. תקצו לכך משאבים רק אם אתם צריכים keywords ו־summaries.
זיכרון, ומה HTML מקולקל עושה לו
שני דברים שכל סקירה בסט הזה סימנה כלא נבדקים — עכשיו נמדדו.
ההקשר הרחב של מבחן העומס נמצא ב־השוואת הזיכרון וה־HTML המקולקל בין עשר ספריות.
זיכרון שיא תושבי, באמצעות /usr/bin/time -l, תהליך חדש אחד לכל תא — רצפת הייבוא היא מה שהספרייה צורכת כשהיא טעונה אבל idle, והשיאים כוללים את המסמך.
| Library | Runtime | Import floor (MiB) | 226 KB HTML peak (MiB) | 10 MB HTML peak (MiB) |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Baselines של Python ושל Node אינם בני השוואה ישירה זה לזה; המפרש נמצא בתוך שניהם.
הרצפה של newspaper4k היא 52.6 MiB, וה־peak שלה על HTML בגודל 10 MB הוא 668.5 MiB — השני הכי כבד בין ספריות Python. אף אחד מהמספרים האלה אינו בעיה עבור עמודים רגילים; שניהם כן חשובים אם אתם מעבדים מסמכים גדולים ב־worker עם מגבלת זיכרון.
HTML מקולקל. שנים עשר מסמכים שכל אחד מהם שובר בדיוק דבר אחד — תגיות שלא נסגרו, אלמנטים inline מקוננים לא נכון, attributes בלי מירכאות עם רווחים, סוגרים מיותרים, בלי <html> בכלל, attributes כפולים, מסמך שנחתך באמצע תג, entities פגומים, <script> שלא נסגר, הצהרת charset שקרית, הערה שמכילה markup, ו־600 רמות קינון — ועוד שני קונטרולים תקינים בגודל תואם, כי "זה החזיר כלום" אומר משהו על malformedness רק אם הספרייה לא שותקת גם על מסמך תקין באותו גודל.
הקונטרולים והמקרים המקולקלים נפרדים היטב בתוצאות הגולמיות:
| Group | Documents | Raised | Empty output | Recovered scored sentinels |
|---|---|---|---|---|
| Well-formed matched controls | 2 | 0 | 0 | not used in the malformed score |
| Malformed fixtures | 12 | 0 | 10 | 5/33, excluding the unclosed-<script> case |
שני הקונטרולים הפיקו 70 ו־1,351 תווים, בעוד ש־10 מתוך 12 קלטים מקולקלים החזירו מחרוזת ריקה. לכן השתיקה כאן מיוחסת ל־malformedness לפי תכנון המערך, ולא פשוט לקלט קצר. המדד בודק סנטינלים של כותרת, פסקה וקישור על פני 11 המסמכים המקולקלים הזכאים. תרחיש ה־unclosed-<script> לא נכלל כי לפי פרשנות HTML5, ה־markup שבא אחריו נחשב עדיין תוכן סקריפט. ראו malformed-results.json. זו מגבלת שחזור מהותית שצריך להביא בחשבון בבחירה, לא רק הצלחה מסוג “לא זרק שגיאה”.
יתרונות וחסרונות
לטובתה. אין טוקני boilerplate מסומנים בהשוואה הזו, פלט בכל 22 התרחישים המבוקרים שממוקדים בכתבות, ו־0.9865 recall על יחידות התוכן שדורגו. היא חושפת טקסט כתבה יחד עם שדות מטא־דאטה, אף שדיוק המטא־דאטה לא נבדק. מסלול ה־held-HTML שנבדק לא ניסה כלל חיבורי רשת כשה־socket.connect נחסם. למאגר היה push מתועד ורענן בזמן הבדיקה; בריאות התחזוקה הרחבה יותר לא הוערכה.
נגדה. ה־cold import הכבד ביותר בסט, עם 2.812 שניות ו־22 חבילות / 47.5 MiB של site-packages שנמדדו. ברירת המחדל של honor_robotstxt היא False, ועזרי multi-article משתמשים כברירת מחדל בעשרה threads. ההתקנה הבסיסית מזהירה על NLTK חסר, ולכן keywords ו־summaries דורשים התקנה אופציונלית כבדה יותר. והכי חשוב: 10 מתוך 12 התרחישים המקולקלים החזירו פלט ריק, אף ששני קונטרולים תקינים מקבילים כן הפיקו טקסט.
למי זה מתאים, ולמי לא
שקלו newspaper4k אם סדר העדיפויות שלכם הוא: לייצר טקסט לא ריק על קורפוס מבוקר שממוקד בכתבות, לצמצם boilerplate מסומן בקורפוס הזה, ולהסכים ל־cold import איטי יותר. לפי הכלל הזה, היא הובילה את ההשוואה הזו. כלל אחר יכול לבחור ב־Readability לשימור מקסימלי של תוכן מדורג, או ב־resiliparse למהירות אתחול ו־extraction חציונית.
דלגו עליה או בדקו אותה בקפדנות אם cold start הוא הגורם הדומיננטי, אם 47.5 MiB של site-packages שנמדדו הם נתון מהותי, או אם שחזור אחרי malformedness חשוב לכם. כאן resiliparse יובאה 187× מהר יותר, אבל היא לא השוותה ל־trafilatura בכל עמודות האיכות: ל־trafilatura היה recall גבוה יותר על כתבות, וגם פרופילי leakage ו־precision שונים. newspaper4k מכוונת לכתבות; רשימות מוצרים ולוחות בקרה לא נבדקו, ולכן אין טענה לגבי ההתנהגות שם.
בכל מקרה, הגדירו honor_robotstxt אם אתם נותנים לה למשוך תוכן. זו לא הערת ביצועים.
איפה נכנס API מנוהל
newspaper4k יכולה לנתח HTML שמסופק על ידי הקורא, ויש לה גם מסלולי fetching. שירות חילוץ מנוהל מעביר את ההשגה, הרינדור והעבודה על הסכימה לגבול של ספק חיצוני. אנחנו בונים את Thunderbit, אבל הוא לא הופעל על מערך התרחישים הזה, ולכן הסקירה הזו לא תומכת בשום השוואה של איכות, רינדור, אנטי־בוט, שיהוי או עלות. עבור HTML של כתבות שמוחזק אצלכם, הראיות כאן עוסקות רק ב־newspaper4k; יעדים שאינם כתבות דורשים הערכה משלהם.
לאותה קבוצת תרחישים across all six extractors, ראו את השוואת חילוץ התוכן בין שש ספריות.
לשוק המנוהל, איסוף ה־web scraping APIs שלנו נותן מבט רחב יותר; לחלופות self-hosted, המדריך המרכזי ל־open-source scrapers. אם הטקסט מיועד למודל, המרת HTML ל־Markdown ב־Python מסביר איפה נאבדת fidelity.
נסו את Thunderbit לחילוץ נתוני רשת
אז להשתמש ב־newspaper4k?
התייחסו ל־newspaper4k כמועמדת חזקה לחילוץ טקסט מכתבות כש־HTML כבר זמין לכם, ואז הריצו בדיקת שטח על הקורפוס שלכם לפני אימוץ. המערך המבוקר תומך ב־recall גבוה על תוכן כתבות, בלי boilerplate מסומן, ובפלט לא ריק בכל 22 התרחישים שממוקדים בכתבות. הוא לא מכסה עמודים אמיתיים או דיוק מטא־דאטה, ו־10 מתוך 12 התרחישים המקולקלים החזירו פלט ריק.
אם אתם משתמשים במסלול ה־fetching שלה, בדקו במפורש את honor_robotstxt=False, את המקביליות של עשרה threads ואת בקרות הקצב לכל host. אם cold start או footprint של תלויות חשובים לכם, מדדו את ה־import המקומי של 2.812 שניות ואת תצפית ה־47.5 MiB של site-packages בסביבת הפריסה שלכם, במקום להתייחס אליהם כעלות קונטיינר אוניברסלית.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
למה set_html() לא עובד?
כי אין שיטה כזו ב־newspaper4k. HTML נכנס דרך download(input_html=html), ואז parse(). תוצאות חיפוש יכולות להציג דוגמאות של newspaper3k, ולכן זו טעות קלה; אני עשיתי אותה בהרצה הראשונה ותיקנתי את ה־harness לפני הדירוג.
האם newspaper4k מכבדת robots.txt?
לא כברירת מחדל. honor_robotstxt מגיע עם הערך False. הגדירו אותו ל־True ב־Configuration אם אתם נותנים לספרייה לבצע fetching, או העבירו input_html ובצעו את ה־fetch בעצמכם. גם עבודה עם כמה כתבות במקביל משתמשת כברירת מחדל בעשרה threads. זו מקביליות שלא נבחרה מראש, לא קצב בקשות קבוע; הגדירו מגבלות מפורשות לכל host בעת fetching.
האם parse() יוצר בקשות רשת?
ב־newspaper4k 0.9.6, המסלול שנבדק של download(input_html=…) ואז parse() לא ניסה אף חיבור עבור קלט HTML מוחזק אחד בזמן ש־socket.connect היה חסום. זה לא מוכיח שכל תצורת parser, plugin, סוג תוכן או גרסה עתידית פועלת בלי רשת.
מהי אזהרת NLTK בייבוא?
ההתקנה הבסיסית לא כוללת NLTK, ולכן חילוץ מילות מפתח וסיכום אינם זמינים והספרייה מודיעה על כך כבר בייבוא. עצם החילוץ לא מושפע — כל מה שנמדד כאן רץ על ההתקנה הבסיסית. pip install 'newspaper4k[nlp]' מוסיף את היכולות האלה יחד עם עץ תלויות כבד יותר והורדות corpus.
מה הסקירה הזו לא בדקה? עמודים אמיתיים — אלו תרחישים מבוקרים עם יחידות מתויגות. שדות מטא־דאטה נמנו אך לא דורגו עבור דיוק של כותרת, מחבר, תאריך או תמונה. גם חילוץ רב־לשוני, תוספות NLP, זחילה מרובת threads למקורות ותפוקה תחת עומס לא נבדקו. זיכרון שיא של התהליך נמדד על קלט HTML אחד בגודל 226 KB ואחד בגודל 10 MB, לא תחת מקביליות או עומס מתמשך.




