
בארבעת קובצי ה-HTML המשותפים ל-markitdown, markdownify הפיקה בדיוק את אותו מספר של שורות טבלת Markdown שנמדדו אצלנו — 36 מול 36 — וגם שחזרה את כל 16 מחרוזות התוכן שנבדקו. הפלט שלה, עם 21,062 טוקנים, היה לכאורה הנמוך ביותר, אף על פי ששלושת הממירים הראשונים היו בתוך פער של 1.3% זה מזה. היא תופסת 1.8 MiB בהתקנה, מורשית תחת MIT, ולרגע הצילום היו לה 2,235 כוכבים ב-GitHub.
זו כנראה הספרייה הכי פחות מדובר בה בקטגוריה הזו, ועל פי המספרים האלה — זו שהייתי בוחר בה.
מהי markdownify
markdownify היא ממיר Python מ-HTML ל-Markdown המבוסס על BeautifulSoup. זה כל המנגנון: מפענחים עם BeautifulSoup, עוברים על העץ, ומוציאים Markdown. גרסה שנבדקה: 1.2.3, רישיון MIT, 2,235 כוכבים, 42 תקלות פתוחות, שחרור אחרון ב-2026-06-30 — תחזוקה פעילה, 44 גרסאות.
מקור רשמי: המאגר הרשמי של python-markdownify.
ה-API הוא פונקציה אחת:
from markdownify import markdownify
md = markdownify(html)
קיימת גם גרסת מחלקה (MarkdownConverter) אם רוצים לדרוס את אופן הטיפול ברכיבים, ויש סט נאה של אפשרויות — סגנון כותרות, תווי תבליטים, זיהוי שפת קוד, הסרה של רכיבים. אבל ברוב המקרים השורה הבודדת היא השימוש הטבעי, והיא עובדת.
pip install markdownify מושך 5 חבילות ו-1.8 MiB, ומייבא “קר” ב-0.046 שניות — המהיר ביותר מבין שלושת הממירים שבדקתי. עץ התלויות נשען על BeautifulSoup ועל המלווים הרגילים שלו, שכבר קיימים בפרויקטי Python רבים, כך שהעלות השולית לרוב כמעט אפסית.
המתודולוגיה
הרצתי אותה על ארבעת קובצי ה-HTML שכבר שימשו את אותו מאגר עבור markitdown, יחד עם מחרוזות בדיקה מוגדרות מראש של אותו מאגר — 16 מחרוזות גוף מדויקות שנבדקו אם שרדו, ובנוסף בדיקות לטקסט סטנדרטי של סביבת הדף. קובץ חמישי, Nothing but tables, הוא בדיקה נפרדת שמעמיסה במיוחד על טבלאות, והוא לא נכלל בממוצע של ארבעת הקבצים שלמטה.
| ממיר | בדיקות גוף | תווי פלט | טוקנים (o200k) | שורות טבלת Markdown | קישורים |
|---|---|---|---|---|---|
| markdownify | 16/16 | 76,868 | 21,062 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 36 | 598 |
| turndown | 16/16 | 95,188 | 26,236 | 0 | 611 |
fourway-scores.json. ארבעה קבצים, הטוקנים נספרו עם o200k_base, ושורות הטבלה נספרו לפי כלל אחיד על פני כל הארבעה — כולל ספירה חוזרת של הפלט השמור של markitdown, שהתאים בדיוק לערך שפורסם.
שלושה דברים בולטים מיד.
היא שווה ל-markitdown במספר שורות הטבלה שנפלטו. 36 שורות לכל אחת מתוך ארבעת הקבצים המשותפים, לפי אותה היוריסטיקה. זה לא מוכיח שקיימת שקילות תא-לפי-תא; זה רק אומר ששני הפלטים חשפו לאותו מונה את אותו מספר של שורות Markdown שניתן לזהות.
יש לה את ספירת הטוקנים הנמוכה ביותר. 21,062, קצת מתחת ל-21,176 של html2text ול-21,336 של markitdown, וב-19.7% פחות מה-26,236 של turndown. שלושת הראשונים נמצאים בתוך פער של 1.3% זה מזה, ולכן הייתי קורא לזה תיקו ולא ניצחון; הפער המשמעותי הוא מול turndown.
כל בדיקות התוכן שרדו. כולן, 16 מתוך 16. כך גם אצל שלוש האחרות — שימור תוכן הוא לא המקום שבו הספריות האלה נבדלות.
הטבלה שהיא כן מצליחה לשחזר
קובץ ההוקי-סטטיסטיקות הוא המקום שבו הממירים נפרדים זה מזה. markdownify:
| Team Name | Year | Wins | Losses | OT Losses | Win % | ... |
| --- | --- | --- | --- | --- | --- | ... |
| Boston Bruins | 1990 | 44 | 24 |  | 0.55 | ... |
GFM סטנדרטי עם פס אנכי בתחילה ובסוף, שורת מפריד, ו—שימו לב לתא הריק בין 24 ל-0.55— הוא פולט את התא הריק במקום לדלג עליו. זה נשמע טריוויאלי, אבל זה ממש לא כך: ממיר שמוחק תאים ריקים מזיז כל ערך שאחריהם לעמודה הלא נכונה, ועדיין פולט טבלה שנראית תקינה לחלוטין.
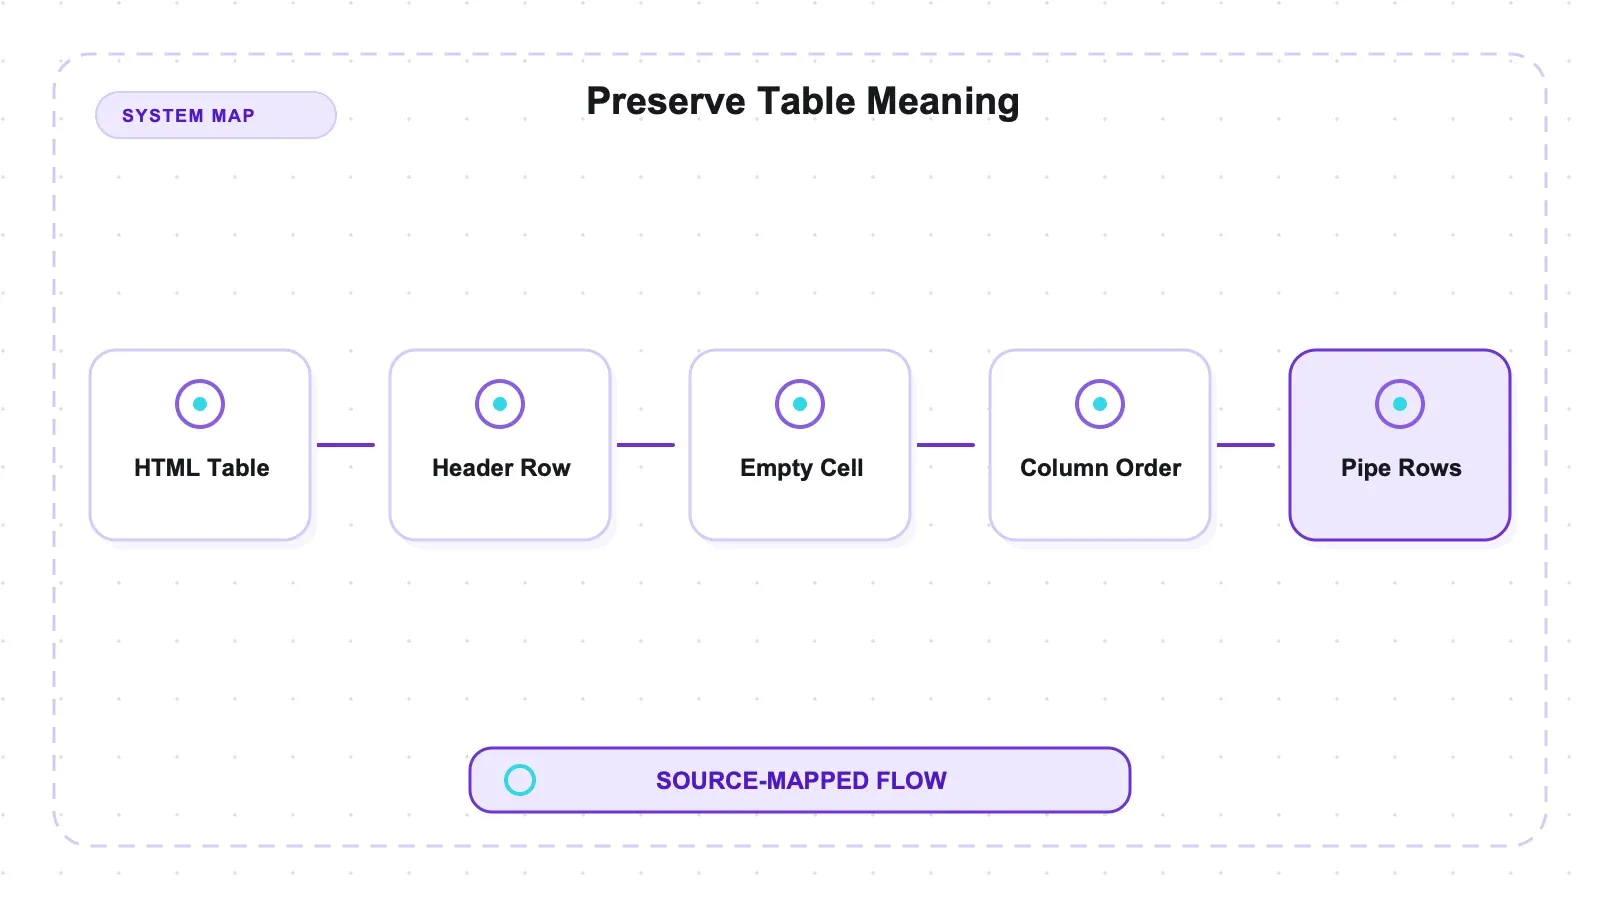
turndown על אותו קלט פולט כל ערך כפסקה נפרדת, בלי שום מבנה עמודות. html2text מפיק טבלה נכונה בסגנון אחר, בלי הפסיים החיצוניים.
אם ה-Markdown מיועד למודל, הפסיים והתא הריק שנשמר הם מה שמאפשרים לו לענות "כמה משחקים Boston הפסידה" במקום לנחש.
שני דברים שהיא מסירה ו-turndown לא
נאמנות הטבלאות היא ההבדל שנראה לעין. זה גדול יותר, וכמעט אף אחד לא מדבר עליו.
markdownify מסירה תוכן מתוך <script> ו-<style>. turndown לא. כשסופרים לפי סמנים שמופיעים רק בתוך הרכיבים האלה, הפלט של markdownify לאורך הקבצים כולל אפס סמני script ואפס סמני style; אצל turndown יש 10 ו-84. בקובץ Wikipedia, זה ההבדל בין 59,561 תווים לבין 74,939 — ו-שמונה שורות של קונפיגורציית JavaScript מוטמעת ו-CSS של MediaWiki אחראיות ל-14,644 תווים, כלומר 95% מהפער (script-style-stripping.json).
עבור כל דבר שמזין מודל, זה כנראה הפריט היקר ביותר בכל ההשוואה הזו: גוש קונפיגורציה של JavaScript עולה טוקנים אבל לא מוסיף מידע. markdownify מסירה אותו אוטומטית. גם html2text עושה זאת.
לפי קובץ, markdownify ו-html2text מסכימות בדיוק כשהטבלה פשוטה, ונבדלות כשהיא לא:
| קובץ בדיקה | markdownify | html2text |
|---|---|---|
| סטטיסטיקות הוקי | 27 שורות | 27 שורות |
| Wikipedia | 9 שורות | 5 שורות |
| Nothing but tables (בדיקה נפרדת) | 62 שורות | 59 שורות |
markdownify פולטת יותר שורות מזוהות בשתי בדיקות ההשוואה. במיוחד ב-Wikipedia היא שומרת תשע שורות, לעומת חמש של html2text תחת אותו מונה. זהו אות אזהרה מועיל לבדוק טבלאות מקוננות ולא סדירות לפני שבוחרים, אבל לא הוכחה שכל תא שנפלט נכון סמנטית.
התקנה ורישיון, מול החלופות
| ספרייה | חבילות | נפח דיסק | ייבוא קר | רישיון | כוכבים | שחרור אחרון |
|---|---|---|---|---|---|---|
| markdownify | 5 | 1.8 MiB | 0.046 שניות | MIT | 2,235 | 2026-06-30 |
| html2text | 1 | 0.2 MiB | 0.077 שניות | GPL-3.0-or-later | 2,168 | 2025-04-15 |
| turndown | 3 (npm) | 8.8 MiB | 0.056 שניות | MIT | 11,386 | 2026-04-03 |
מקור רשמי: markdownify ב-PyPI.
install-and-import.json ו-metadata-snapshot.json. כל ספרייה הותקנה בסביבה ריקה משלה.
html2text קטנה פי תשעה על הדיסק, והיא תחת GPL-3.0-or-later. במוצר שמופץ הלאה, זה צריך להיות שלב בדיקה אצל מי שאחראי על הרישוי; המאמר הזה אינו ייעוץ משפטי. markdownify היא MIT, שלרוב נחשב מקל יותר, אבל עדיין צריך להיכנס לבדיקה הרגילה של תאימות רישוי.
גם 1.8 MiB הוא נתון קצת תיאורטי אם הפרויקט שלכם כבר משתמש ב-BeautifulSoup, וכך קורה אצל לא מעט פרויקטי scraping ב-Python — במקרה כזה העלות השולית של markdownify כמעט אפסית.
קצב השחרורים של markdownify הוא הבריא ביותר מבין השלוש: 44 גרסאות ודחיפה שישה שבועות לפני הבדיקה, לעומת השחרור האחרון של html2text באפריל 2025.
מה באמת מקבלים משורת Python אחת
הספרייה כולה היא markdownify(html), וכדאי להיות מפורשים לגבי מה הקריאה הזו מחליטה בשבילך — כי שלוש מההחלטות האלה הן בדיוק אלה שעליהן נשענה ההשוואה.
היא מפענחת בעזרת BeautifulSoup, מסירה <script> ו-<style> בלי שתבקשו, ופולטת טבלאות בסגנון GFM עם פסיים חיצוניים ותאי ריקים שנשמרים. עצם השימוש ב-parser מוכר לא מבטיח התנהגות תקינה מול קלט פגום, ולכן הנושא הזה נמדד בנפרד בהמשך.
אף אחת מההתנהגויות האלה אינה אפשרות שהגדרתם. זה מה שהברירה המחדלית עושה, ובקטגוריה שבה הברירה המחדלית של turndown שומרת JavaScript וזו של html2text מבצעת שבירת שורות קשיחה כל 78 תווים, ספרייה שההתנהגות שלה “מהקופסה” כבר טובה בלי תיקונים שווה משהו בפני עצמו.
האפשרויות קיימות כשרוצים אותן — heading_style, bullets, code_language, strip ו-convert לרשימות לבנות ושחורות של רכיבים, ו-MarkdownConverter לדריסה לפי רכיב. בכל המדידות כאן לא השתמשנו באף אחת מהן.
זיכרון, ומה HTML שבור עושה לו
הקשר הבדיקות הרחב יותר נמצא ב-השוואה בין עשר ספריות לזיכרון ו-HTML פגום.
שני דברים שבכל סקירה באצווה הזו סומנו כלא-נבדקים, נמדדו עכשיו.
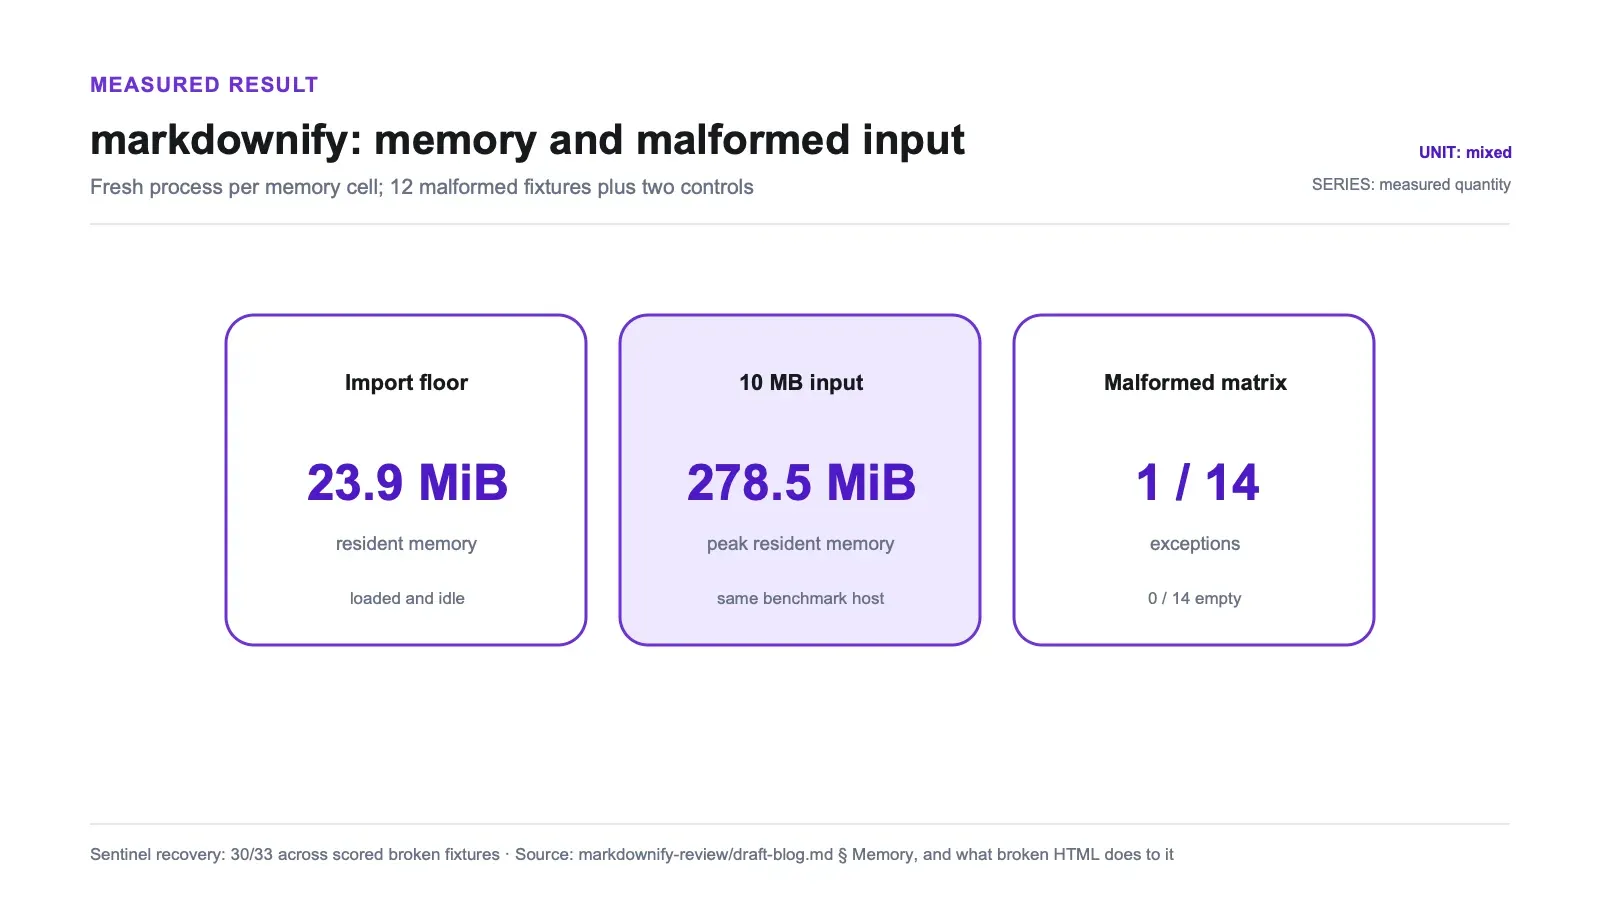
שיא זיכרון תושב בפועל, באמצעות /usr/bin/time -l, תהליך חדש לכל תא — רצפת הייבוא היא מה שהספרייה צורכת כשהיא טעונה ולא פעילה, והשיאים כוללים גם את המסמך.
| ספרייה | סביבת ריצה | רצפת ייבוא | שיא ב-226 KB | שיא ב-10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. בסיסי Python ו-Node אינם בני השוואה ישירה זה לזה; המפרש נכלל בתוך שניהם.
markdownify נמצאת באמצע: רצפת 23.9 MiB ו-278.5 MiB על מסמך של 10 MB. זה פי 3.9 מהשיא של html2text וכעשירית מזה של turndown, וזה המחיר של BeautifulSoup מתחתיה.
HTML שבור. שנים-עשר מסמכים, שכל אחד מהם שובר דבר אחד בדיוק — תגיות שלא נסגרו, רכיבי inline שנקברו אחד בתוך השני בצורה שגויה, מאפיינים בלי מירכאות עם רווחים, סוגרי תג מיותרים, היעדר מוחלט של <html>, מאפיינים כפולים, מסמך שנחתך באמצע תג, ישויות פגומות, <script> לא סגור, הצהרת charset שקרית, תגובה שמכילה markup, ו-600 רמות של קינון — ועוד שני מסמכי בקרה תקינים בגודל תואם, כי "הוא לא החזיר כלום" אומר משהו על פגימות רק אם הספרייה גם שותקת על מסמך תקין באותו גודל.
markdownify זרקה חריגה ב-1 מתוך 14 ולא החזירה כלום ב-0, ושיחזרה 30/33 סמני בדיקה across the broken fixtures (malformed-results.json). קובץ אחד לא נספר שם: לפי HTML5, כל מה שאחרי <script> שלא נסגר הוא אכן תוכן סקריפט, ולכן אובדן שלו שם הוא התנהגות נכונה, ושחזור שלו היה החריגה.
יתרונות וחסרונות
לטובתה. נאמנות טבלאות שוות-ערך ל-markitdown, לפי אותו כלל ספירה. ספירת הטוקנים הנמוכה ביותר מבין ארבע. MIT. 1.8 MiB, וכמעט בלי עלות שולית אם BeautifulSoup כבר בעץ התלויות. ייבוא קר מהיר ביותר ב-0.046 שניות. משוחררת ומתוחזקת באופן פעיל. שומרת תאי טבלה ריקים. מאפשרת דריסה של המרת רכיבים ב-MarkdownConverter. הקריאה הפשוטה בשורה אחת היא הקריאה הנכונה.
נגדה. תלויה ב-BeautifulSoup, כך שהיא תופסת פי תשעה מקום על הדיסק מ-html2text אם עדיין אין לכם אותה. 2,235 כוכבים פירושם קהילה קטנה יותר מזו של turndown — ופחות דוגמאות מעשיות כשמגיעים למשהו מוזר. רק Python, כך שאין לה ערך בתוך סטאק של Node. וגם 42 תקלות פתוחות.
למי כדאי להשתמש בה, ולמי לא
התחילו עם markdownify עבור עומס עבודה ב-Python שדומה לקבצים שבדקנו. היא שווה ל-markitdown במספר השורות שנפלטו לפי המונה הזה, נמצאת באשכול הטוקנים הנמוך ביותר, ומורשית MIT. אם אתם כבר תלויים ב-BeautifulSoup, טביעת הרגל השולית שלה עשויה להיות קטנה; בדקו את ההפרש האמיתי בתלויות בסביבה שלכם.
שקלו html2text במקום אם תקציב התלויות נמדד במאות קילובייטים, וצורת הפלט שלה מתאימה לדפים שלכם. בדקו את GPL-3.0-or-later עם מי שאחראי על רישוי לפני הפצה.
שקלו markitdown במקום אם אתם כבר ממירים PDF או מסמכי Office. תוצאות ה-HTML שלהן כאן היו עם אותו מספר שורות שנפלטו, אבל לא הוכחה שקיימת זהות רחבה יותר בנאמנות ההמרה.
דלגו עליה ב-Node, שם turndown היא התשובה הטבעית — עם turndown-plugin-gfm מותקן לצידה, כי ליבת turndown לא מפיקה טבלאות בכלל.
איפה API מנוהל מתאים
markdownify ממירה HTML שכבר יש לכם. היא לא מביאה את הדף, לא מרנדרת JavaScript, ולא מתמודדת עם שכבת אנטי-בוט — אף אחת מארבע הממירות לא עושה זאת, ובלא מעט יעדים אמיתיים זה החצי הקשה יותר של העבודה.
לאותם קבצים בארבעת הכלים, ראו את ההשוואה החמש-כיוונית של HTML ל-Markdown.
מחסנית המפתחים שלנו ב-Thunderbit מטפלת במשימה שמעליה: POST /distill מביא URL ומחזיר Markdown, בעוד POST /extract מחזיר JSON מובנה לפי סכימה. שתיהן זמינות דרך שרת MCP ו-CLI; המחיר מופיע ב-עמוד התמחור של Thunderbit. נקודות הקצה המתארחות האלה לא נבחנו מול הממירים המקומיים כאן, כך שזו הבחנה בין קטגוריות ולא השוואת ביצועים.
המסגור הישר: אם יש לכם כבר HTML ואתם רוצים Markdown, markdownify היא חינמית ועושה את העבודה כמו כל חלופה כאן. אם אתם מביאים דפים מהאינטרנט, או רוצים שורות במקום פרוזה — זה מוצר אחר לגמרי.
לתמונה הרחבה יותר, סיכום ה-API-ים שלנו לגרידת אתרים מכסה אפשרויות מתארחות, ו-עמוד היסוד של סקרייפרים בקוד פתוח מכסה את אלה שמארחים לבד. המרת HTML ל-Markdown ב-Python הוא המדריך המעשי.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט
האם כדאי להשתמש ב-markdownify?
עבור Python, זו מועמדת חזקה כשהקלטים שלכם דומים לקבצים שנבדקו כאן; כדאי לבדוק אותה על הטבלאות שלכם ועל דפים פגומים לפני שהופכים אותה לברירת המחדל.
היא שווה ל-markitdown במספר שורות הטבלה שנפלטו, נמצאת באשכול הטוקנים הנמוך ביותר, מייבאת הכי מהר בהרצה הזו, ומורשית MIT. מנגד, היא השתמשה ביותר זיכרון מ-html2text, היא רק ל-Python, וזרקה חריגה על אחת ממדידות הקלט הפגום. נפח דיסק ורישוי הם שיקולי בחירה נוספים, לא כל הטיעונים.
מה שתופס אותי הוא מספר הכוכבים. ל-turndown יש פי חמישה יותר תשומת לב, ובברירת המחדל היא לא ממירה אף אחת מהטבלאות ש-markdownify מטפלת בהן נכון. הפופולריות בקטגוריה הזו לא באמת עוקבת אחרי ההתנהגות הנמדדת, וזו בדיוק הסיבה העיקרית שההשוואה הזו הייתה שווה הרצה.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט Get Started Free
שאלות נפוצות
האם markdownify באמת טובה כמו markitdown ב-HTML? בארבעת הקבצים האלה, שתיהן הפיקו 36 שורות Markdown טבלה מזוהות, שיחזרו את כל 16 המחרוזות שנבדקו, והפלט שלהן היה בתוך 0.2% זה מזה במספר התווים. זה לא מבחן זהות ברמת התא או ברמת הרינדור. בנוסף, markitdown יודעת גם לעבוד עם PDF ועם Office, כך שההשוואה הזו עוסקת רק בפלטי ה-HTML שנמדדו.
האם היא צריכה BeautifulSoup? כן — זה ה-parser שלה, וזה חלק גדול מה-1.8 MiB. אם הפרויקט שלכם כבר משתמש ב-BeautifulSoup, העלות השולית של markdownify קטנה. אם לא, ומקום בדיסק באמת חשוב, html2text היא 0.2 MiB עם חבילה אחת, במחיר רישיון GPL-3.0-or-later.
איך היא מטפלת בתאי טבלה ריקים? היא שומרת אותם. בקובץ שבו יש חוסרים בנתונים, הפלט משאיר את התא הריק במקומו, כך שכל ערך שאחריו נשאר בעמודה הנכונה. ממיר שמדלג על תאים ריקים מייצר טבלה שעדיין נראית תקינה, אבל כל ערך בה זז עמודה אחת שמאלה — וזה הכשל הבעייתי יותר, כי שום דבר לא מסמן אותו.
להשתמש בפונקציה או במחלקה?
במקרה הרגיל, markdownify() הפונקציה. להשתמש ב-MarkdownConverter כשצריך לדרוס את אופן ההמרה של רכיב מסוים — כל המדידות כאן השתמשו בפונקציה הפשוטה עם אפשרויות ברירת המחדל.
מה לא נבדק כאן? ארבעה קבצים משותפים ועוד בדיקת טבלאות אחת אינם קורפוס מייצג. חבילת ה-HTML הפגום כללה 12 סוגי שבר מוגדרים ושתי בקרות, אבל לא כל צורה של HTML שבור. לא הושוו רשימות מקוננות, רשימות הגדרות, הערות שוליים, מתמטיקה, סבבי Markdown ל-HTML וחזרה, שקילות טבלאות ברמת התא, או וריאנטים של קונפיגורציה. גם מהירות ההמרה לא הושוותה.




