
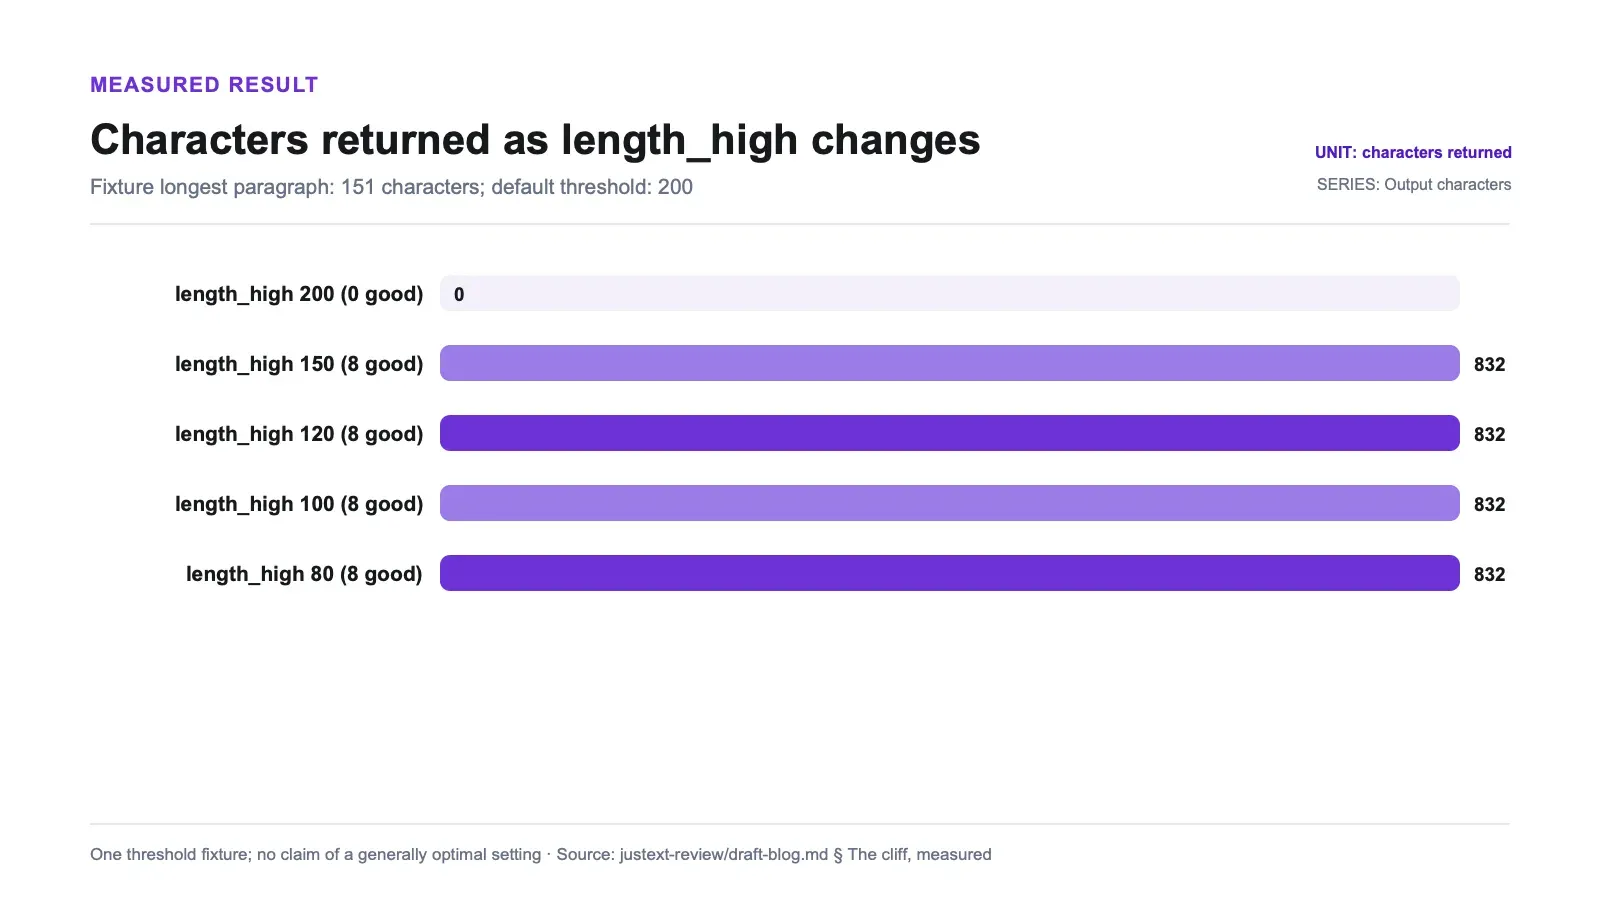
במסמך שבו הפסקה הארוכה ביותר היא 151 תווים, jusText בהגדרות ברירת המחדל שלו מחזיר אפס תווים. לא חילוץ חלקי — מחרוזת ריקה. הורידו סף אחד כך שרק פסקה אחת תעבור אותו, ואותו מסמך יניב 832 תווים. הורידו עוד, ועדיין תקבלו 832.
במדגם הזה ההתנהגות היא תהום ולא מדרון. השאלה אם ברירת המחדל נמצאת בצד הלא נכון תלויה באורכי הפסקאות ובפיזור התוכן המיותר בקורפוס היעד.
מהו jusText, ולמה צפיפות לקסיקלית חשובה
בהשוואה לשאר מחלצי התוכן במערך המדגם הזה, jusText נשען באופן חריג על צפיפות של מילות עצירה ספציפיות לשפה. בלוק עם שיעור גבוה של מילות תפקוד — the, and, of, was — נוטה יותר להיחשב לטקסט פרוזאי. האות הלקסיקלי הזה הוא לא כל הסיווג: גם אורך הפסקה, צפיפות קישורים, גבולות בלוקים שנגזרים מ-HTML, מרחק מכותרות, שכני מחלקות, וגם מעבר רגיש להקשר משפיעים על התוצאה.
הפניה רשמית: המאגר הרשמי של jusText.
מכיוון שהמסווג משתמש ברשימת עצירה לפי שפה, jusText מגיע עם 100 רשימות כאלה. המאפיין הלקסיקלי-לשוני המפורש הזה הוא ההבדל הבולט ביותר שלו בהשוואה הזו, אף שביצועים רב-לשוניים לא נבחנו כאן.
גרסה שנבדקה: 3.0.2, BSD 2-Clause, 822 כוכבים ב-GitHub. Python 3.14.2.
התהום, במדידה
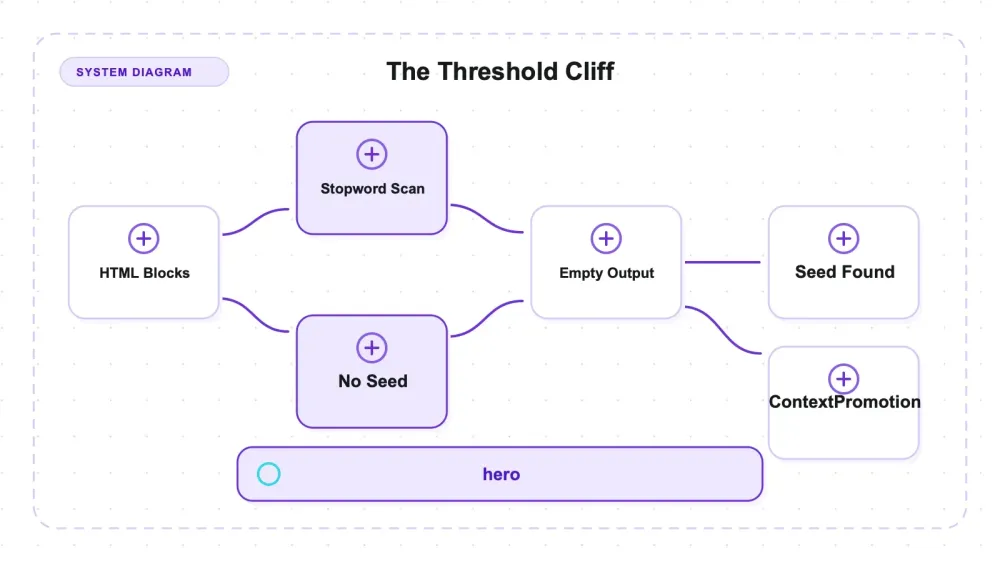
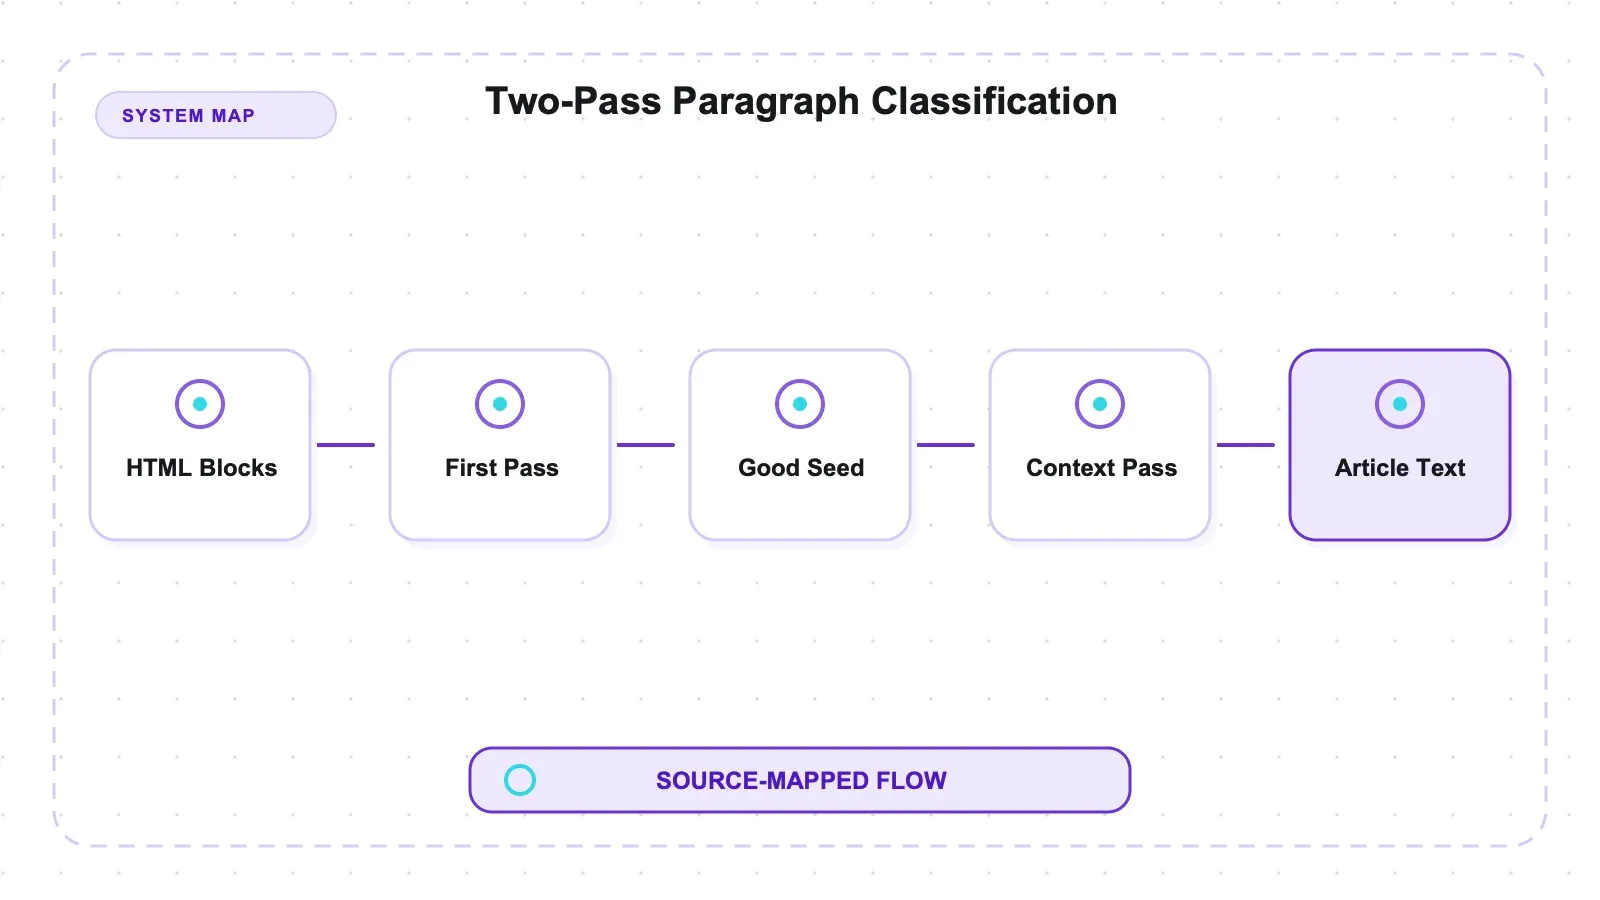
המסווג של jusText פועל בשני מעברים. מעבר שאינו תלוי-הקשר מסווג כל פסקה כ-good, bad, short או neargood. אחר כך מעבר תלוי-הקשר מקדם neargood ל-good — אבל רק כשהוא צמוד לבלוק שכבר מסומן כ-good. ופסקה מקבלת good בכוחות עצמה רק כשהיא עוברת את length_high, שברירת המחדל שלו היא 200 תווים.
במסמך שבו אף פסקה לא עוברת את 200 התווים, אין שום פסקה שמדליקה את מנגנון הקידום, וכל בלוק neargood מתגלגל חזרה ל-content boilerplate. כל הדף חוזר ריק.
בדקתי את הסף על מדגם שהפסקה הארוכה ביותר בו היא 151 תווים:
length_high | פסקאות שסווגו כ-good | תווים שהוחזרו |
|---|---|---|
| 200 (ברירת מחדל) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
justext-length-threshold.json.
במדגם הסף הזה, פסקה אחת שחצתה את הקו שינתה את כל שמונה הפסקאות היעד לפלט, והורדה נוספת של הסף לא הוסיפה דבר. ה-trace תואם למעבר הקונטקסטואלי שמקדם שכנים neargood כשיש סביבם בלוק good קיים; זה לא אומר שכל שכן יקודם בלי תנאי בכל עמוד.
לפני שייחסתי את המעבר ל-length_high, סרקתי את length_low בארבעה ערכים מול max_link_density בשני ערכים: שמונה צירופים, כולם החזירו אפס. שינוי של כל אחד מהשניים האלה לא החזיר פלט במדגם הזה.
בכל מערך 22 המדגמים התבנית נשמרת: 2 מתוך 22 מדגמים החזירו פלט ב-length_high=200, 9 מתוך 22 ב-150, 15 מתוך 22 ב-120.
שני דברים שזה לא אומר. זה לא אומר ש-jusText מחלץ גרוע — בעמוד אמיתי בשפה טבעית, בהגדרות ברירת המחדל, הוא החזיר 1,190 תווים של טקסט כתבה נקי, כי פסקה חדשותית אמיתית עוברת 200 תווים כבר בניסיון הראשון. וזה גם לא אומר שברירת המחדל שגויה; זה אומר שהיא מניחה פסקאות ארוכות, ואתם צריכים לבדוק אם הקורפוס שלכם כזה לפני שרצים על משהו.
הצד השני של מערך המדגם: יותר דליפה בברירת המחדל
במערך המדגמים המסומן הזה, בברירות המחדל של jusText יש את דליפת ה-boilerplate הגבוהה ביותר שנמדדה.
| ספרייה | Recall של כתבה (כל 22) | דליפת boilerplate | Precision של טוקני תוכן | טוקנים מזהמים |
|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 |
sixway-scores.json. מערך מדגמים אחד, מדד אחד, וכל יחידה מסומנת בסמן ייחודי כך שהשחזור הוא התאמת תת-מחרוזת מדויקת.
47% דליפת boilerplate ו-74 טוקנים מזהמים — פי שניים מהדליפה של Readability ויותר מפי שניים מהזיהום שלו במערך הסינתטי המסומן הזה. זו תוצאה אבחונית בברירת המחדל, לא דירוג מוצר יציב לכלל המקרים.
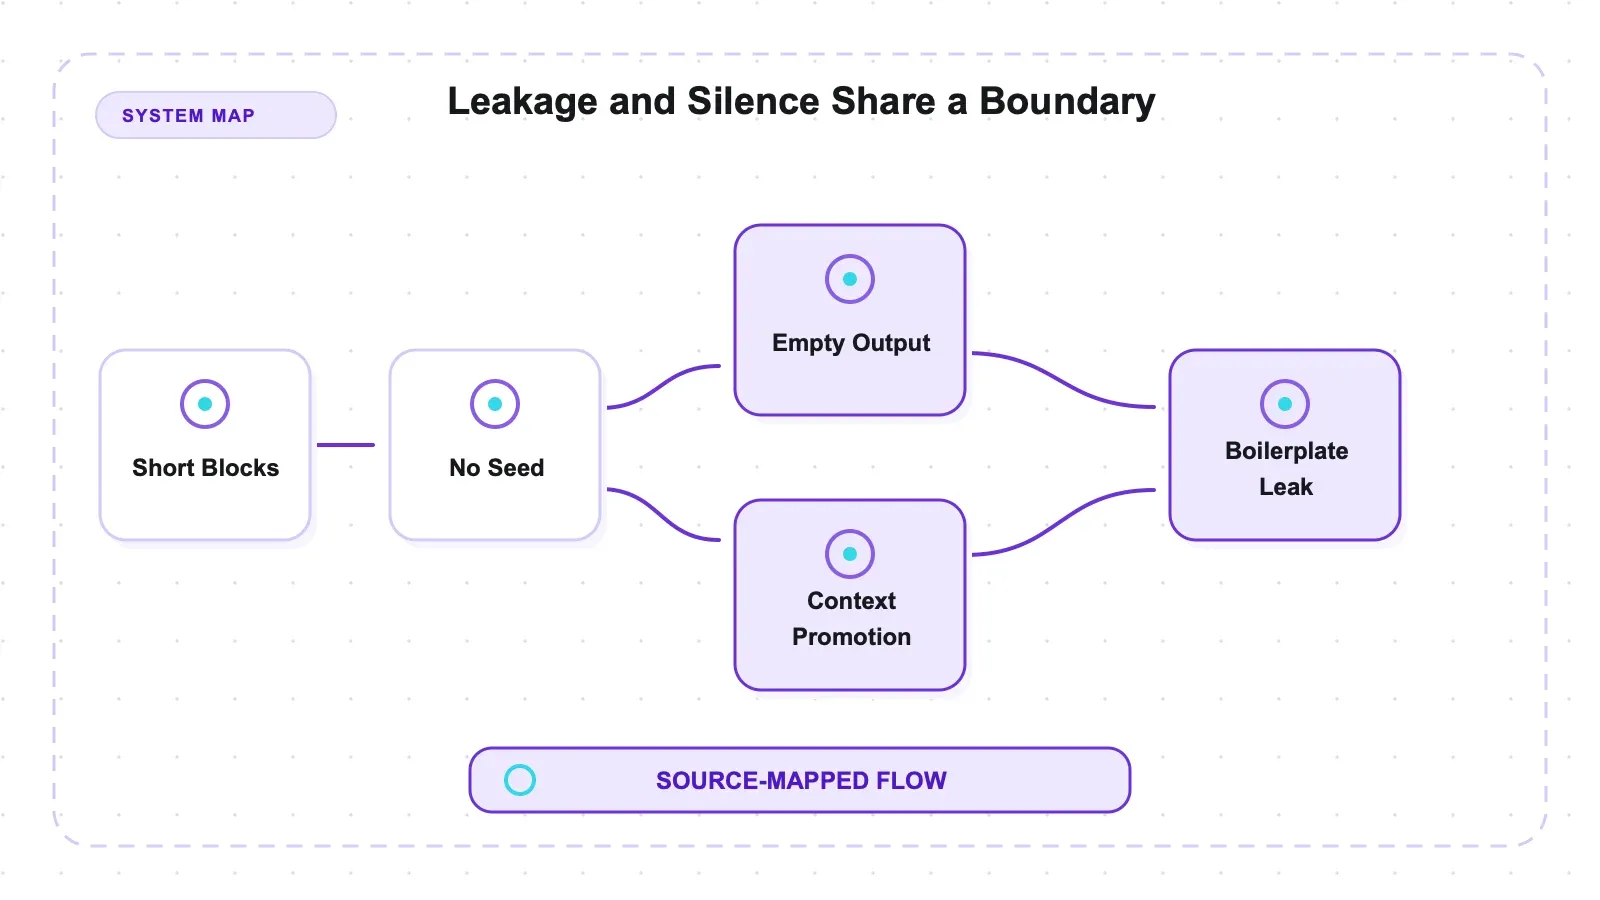
הדליפה שנצפתה תואמת לאותו מעבר קונטקסטואלי שמעורב גם בתהום. בלוקים שכנים מתאימים מסוג neargood יכולים להיות מקודמים כשהמחלקות והמרחקים בסביבה מאפשרים זאת; לכן טקסט דמוי-פרוזה לצד טקסט הכתבה עלול לחצות את הגבול. תוצאת המדגם מראה אילו בלוקים מסומנים דלפו, בעוד שהמנגנון הפשוט עדיין מותנה בכללי ההקשר המדויקים של jusText.
ה-Recall שלו הוא 0.8378, שלישי מהתחתית, וכל ההפסד נובע מהסף: הוא לא החזיר כלום על כתבה בודדת של 129 תווים, לא החזיר כלום על עמוד עם עשר פסקאות קצרות, ולא החזיר כלום על המסמך כמעט-הריק.
מלאי רשימות העצירה לשפות
תשעים ותשע רשימות עצירה אחרות.
justext.get_stoplists() מחזיר 100 שפות. המסווג מתוכנן מלכתחילה להיות פרמטרי-שפה, לא תרגום של היוריסטיקה באנגלית, והחלפת שפה היא ארגומנט אחד:
import justext
paragraphs = justext.justext(html, justext.get_stoplist("Czech"))
text = "\n".join(p.text for p in paragraphs if not p.is_boilerplate)
גם ל-trafilatura ול-goose3 יש התנהגות שקשורה לשפה, אבל הסקירה הזו לא דרגה אף מחלץ על אמת מידה שאינה אנגלית. 100 רשימות העצירה המובנות של jusText הופכות אותו למועמד ברור להערכה רב-לשונית; המלאי לבדו לא מוכיח איכות חילוץ בשפות הללו ולא מוכיח שהמתחרים מכסים אותן פחות טוב.
הממשק כולל שתי פונקציות ותשעה ערכים כוונון — length_low 70, length_high 200, stopwords_low 0.30, stopwords_high 0.32, max_link_density 0.20, max_heading_distance 200, ועוד טיפול בקידוד. קטן, קריא, והכול מתועד בחתימה.
התקנה ומהירות
pip install justext מושך 3 חבילות — הכי מעט בהשוואה — ו-22.4 MiB, בפחות משתי שניות.
הפניה רשמית: jusText ב-PyPI.
| ספרייה | חבילות | site-packages | ייבוא קר | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. כל ספרייה ב-virtualenv ריק משלה.
שלוש חבילות ו-22.4 MiB הן תלות קטנה בהשוואה הזו, ו-0.56 ms חציון חילוץ קרוב ל-0.51 של trafilatura ב-benchmark הזה. מדידת הסביבה לא מפרקת את גודל החבילות לפי סוג קובץ, ולכן אי אפשר לומר כמה מטביעת הדיסק מגיע מרשימות העצירה.
שאלת התחזוקה, בתשובה זהירה
מדדי התחזוקה המתוארכים שנעשה בהם שימוש כאן הם הדחיפה האחרונה למאגר והגרסה האחרונה ב-PyPI, שניהם 2025-02-25. זה היה שבעה עשר חודשים לפני הבדיקה. שמונה גרסאות בסך הכול, 91 forks, 9 בעיות פתוחות, לא בארכיון.
מסווגי PyPI מציינים תמיכה ב-Python עד 3.9. הרצתי אותו על 3.14.2 והוא התקין, יובא בתוך 0.777 שניות וחילץ ב-19 מתוך 22 מדגמים בלי חריגה אחת.
לכן המטא-דאטה מפגר בחמש גרסאות Python אחרי המציאות, והמציאות היא שהוא עובד. זה ההבחנה החשובה: מאגר שקט הוא אות לגבי תמיכה, לא בהכרח לגבי תפקוד. עבור ספרייה שכל האלגוריתם שלה הוא שיטה שפורסמה ב-2011 יחד עם אוסף של רשימות מילים, "סיימה את דרכה" היא מצב סביר — לא נשאר הרבה לשנות, ורשימות העצירה לא נרקבות כמו מעקף נגד-בוט.
מה כן אומר מאגר שקט: אם תפגשו באג, תצטרכו לתקן אותו בעצמכם או לפצל את הפרויקט. שווה לשקול זאת מול 9 בעיות פתוחות, וזה לא הפרופיל של ספרייה שטובעת בבעיות לא מטופלות.
זיכרון, ומה HTML שבור עושה לו
שתי שאלות תפעול נמדדות כאן בנפרד.
הקשר הרחב יותר של מבחן העומס נמצא ב-השוואת זיכרון ו-HTML פגום בין עשר ספריות.
שיא זיכרון resident, באמצעות /usr/bin/time -l, תהליך חדש לכל תא — רף הייבוא הוא מה שהספרייה צורכת כשהיא טעונה ולא פעילה, והשיאים כוללים את המסמך.
| ספרייה | Runtime | רף ייבוא | שיא 226 KB | שיא 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. נקודות הייחוס של Python ו-Node אינן ניתנות להשוואה ישירה זו לזו; המפרשית נמצאת בתוך שתיהן.
הרף של jusText הוא 30.3 MiB והשיא שלו במדגם 10 MB הזה הוא 431.2 MiB, בערך פי 14.2 מרף הייבוא ופי 43.1 מגודל הקלט ב-RSS מוחלט. מדגם אחד ותהליך אחד לא מגדירים עקומת סקיילינג כללית; גם נקודות הייחוס של Python ו-Node נותרות לא-השוואתיות.
HTML שבור. שנים-עשר מסמכים, כל אחד שובר דבר אחד בדיוק — תגיות לא סגורות, אלמנטים inline עם קינון שגוי, מאפיינים ללא מרכאות עם רווחים, סוגרי-יתר שנשארו, אין <html> בכלל, מאפיינים כפולים, מסמך שנקטע באמצע תג, ישויות פגומות, <script> לא סגור, הצהרת charset שקרית, הערה שמכילה markup, ו-600 שכבות קינון — ועוד שני בקרות תקינות במבנה ובגודל תואם, כי "זה לא החזיר כלום" אומר משהו על malformedness רק אם הספרייה לא שותקת גם על מסמך נקי באותו גודל.
justext זרק חריגה ב-0 מתוך 14 ולא החזיר כלום ב-13, ושיחזר 0/33 סנטינלים מדורגים במדגמים השבורים (malformed-results.json). גם הבקרה הקצרה התקינה החזירה 0 תווים; הבקרה הארוכה התקינה הייתה התוצאה הלא-ריקה היחידה, עם 1,333 תווים. כל שנים-עשר המדגמים השבורים נשארו ריקים, ומקרה ה-<script> הלא סגור מוחרג ממדידת הישרדות הסנטינלים. לכן האצווה הזו מראה סבילות של הפרסר — בלי חריגה — אבל לא יכולה לייחס את השתיקה ל-malformedness במקום לסף הגודל שכבר נמדד.
יתרונות וחסרונות
בעד. 100 רשימות עצירה לשפות, ומסווג שבאמת בנוי סביבן ולא רק מתורגם אליהן. ספירת התלויות הקטנה ביותר בהשוואה, 3 חבילות. חציון חילוץ של 0.56 ms. תשעה ערכי כוונון מתועדים וקריאים. BSD 2-Clause. רץ נקי על Python 3.14 למרות שמסווגי PyPI נעצרים ב-3.9.
נגד. דליפת ה-boilerplate הגבוהה ביותר במבחן הסינתטי הזה בברירת מחדל: 47%, עם 74 טוקנים מזהמים. מדגם הפסקאות הקצרות החזיר מחרוזת ריקה כשאף פסקה לא עברה את length_high. ה-Recall היה 0.8378 במערך הזה. הדחיפה האחרונה למאגר וההפצה האחרונה תועדו שבעה עשר חודשים לפני הבדיקה, ולכן צריך להביא בחשבון בעלות תחזוקה.
מי כן צריך להשתמש בו, ומי לא
כדאי להעריך את jusText עבור קורפוסים רב-לשוניים, כי מעטפת רשימות העצירה הספציפית לשפה היא מפורשת ורחבה. המבחן הזה מנה 100 רשימות עצירה אך לא מדד איכות רב-לשונית. הוא גם מועמד טוב כש-3 חבילות תלות ובקרת ספים מפורשת מתאימות לסביבת ההפעלה.
כדאי לדלג עליו אם אתם מזינים מודל לפי טוקנים, כי 74 טוקנים מזהמים מול אפס אצל goose3 ו-newspaper4k הם עלות ישירה. דלגו עליו גם בעמודים עם פסקאות קצרות — תקצירי מוצר, רשימות, יומני שינויים, סעיפי FAQ — אלא אם הגדרתם את length_high בכוונה. ודלגו עליו אם אתם צריכים תלות שמתוחזקת באופן פעיל מסיבות של תאימות או רכש, שזה אילוץ אמיתי גם כשהקוד עובד.
אם כן משתמשים בו, כוונו את length_high מול מדגם ולידציה מתוייג במקום להעתיק את ברירת המחדל או כלל אחוזון. סרקו ספים סבירים ומדדו גם Recall של כתבה וגם precision של boilerplate; הורדת הסף יכולה להציל פרוזה קצרה אבל גם לקדם בלוקים שכנים לא רצויים.
איפה API מנוהל משתלב
jusText עובד על HTML שכבר יש לכם, כמו כל שאר הכלים בהשוואה הזו. אף אחת מהספריות האלה לא מבצעת fetch לעמוד, לא מרנדרת JavaScript, ולא מטפלת בשכבת anti-bot.
לאותם מדגמים על פני ששת המחלצים, ראו את השוואת החילוץ בין שש ספריות.
שירות מבוסס ענן שמבצע fetch/render/extraction, כולל Thunderbit שלנו, מכסה גבול אחר של אחריות. Thunderbit לא נבחן כאן. ההבחנה היא בין סיווג טקסט פרוזאי מתוך HTML שסופק לבין שירות שאוסף ומעבד URL; המאמר הזה לא מספק השוואת איכות לפי אותם מדדים.
הניסוח הכנה: לרשימות העצירה הרב-לשוניות של jusText יש יכולת אמיתית והן חינמיות. אם הבעיה שלכם היא איסוף עמודים בהרבה שפות ולא סיווג הפרוזה שבהם, מדובר ברכישה אחרת לגמרי.
למבט רחב יותר בשוק, הסקירה שלנו על web scraping APIs מכסה אפשרויות מנוהלות ו-העמוד המרכזי על open-source scrapers מכסה פתרונות self-hosted. אם הפלט מיועד למודל, המרת HTML ל-Markdown ב-Python היא המקום שבו רוב האמינות הולכת לאיבוד.
נסו את Thunderbit לחילוץ נתוני רשת
האם כדאי להשתמש ב-jusText?
זה מועמד טוב אם הקורפוס רב-לשוני או שהתפלגות אורך הפסקאות שלו מרוויחה מכוונון מפורש של ספים. יש לאמת את שני המאפיינים לפני הפריסה.
100 רשימות העצירה המצורפות הן מאפיין תכנוני אמיתי, אבל דיוק רב-לשוני לא נבדק. תהום הסף ניתנת לכוונון; האם הגדרה נמוכה יותר מקובלת תלוי ב-Recall ובדיוק boilerplate שנמדדו על מדגם מסומן.
במערך הסינתטי באנגלית הזה, בברירות המחדל, newspaper4k דלף אפס יחידות boilerplate מסומנות ושיחזר 0.9865 מיחידות הכתבה. זה הופך אותו למועמד להשוואה לעומס העבודה הזה, לא להמלצת החלפה אוניברסלית.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
למה jusText מחזיר מחרוזת ריקה במקום חילוץ חלקי?
המסווג שלו פועל בשני מעברים. פסקה מקבלת את המחלקה good בכוחות עצמה רק מעל length_high (ברירת מחדל 200 תווים); המעבר השני מקדם בלוקים neargood שכנים. כשאין פסקה שחוצה את הסף אין זרז ראשוני, ולכן כל מועמד מתגלגל ל-boilerplate והתוצאה ריקה. זה all-or-nothing לפי התכנון, לא כשל למצוא תשובה חלקית.
האם jusText נזנח? הדחיפה האחרונה למאגר והגרסה האחרונה ב-PyPI היו שניהם ב-2025-02-25 — שבעה עשר חודשים לפני הבדיקה — ומסווגי PyPI נעצרים ב-Python 3.9. אבל הוא התקין ורץ על Python 3.14.2 בלי חריגה, ו-9 בעיות פתוחות זה לא backlog גדול. קראו את התאריכים כסיכון תחזוקתי ולא כהוכחה להתנהגות שבורה; הסיכון המעשי הוא שאולי תצטרכו לתקן את הבאגים של עצמכם.
למה הוא מדליף יותר boilerplate מ-Readability? במערך המדגמים הזה, בלוקים שכנים דמויי-פרוזה חצו את גבול הפלט תחת כללי ההקשר ברירת המחדל. הקידום תלוי במחלקת הבלוק, במרחק ובהקשר, ולא מתבצע אוטומטית לכל שכן. התוצאה שנמדדה הייתה דליפת 47% של יחידות boilerplate ו-74 טוקנים מזהמים בברירת המחדל.
איך משתמשים בו לשפה אחרת?
justext.justext(html, justext.get_stoplist("German")). get_stoplists() מחזיר את כל 100 האפשרויות. רשימת העצירה היא הקלט הלקסיקלי הספציפי לשפה למסווג שמשתמש גם באורך פסקה, צפיפות קישורים, פילוח נגזר מ-HTML, מרחק מכותרות, והקשר של בלוקים שכנים. זה משנה את קלט השפה; זה לא מאמת לבדו איכות חילוץ בגרמנית.
מה לא נבדק כאן?
עמודים אמיתיים, בכלל — אלה מדגמים מבוקרים עם יחידות מתויגות. היכולת הרב-לשונית, שהיא נקודת המכירה המרכזית של הספרייה, נרשמה כ-100 רשימות עצירה אך לא קיבלה ציון על טקסט שאינו אנגלי. מקרי קצה של קידוד, למרות ש-jusText חושף פרמטרים של encoding, default_encoding ו-enc_errors. ו-max_heading_distance ושני ספי יחס מילות העצירה נשארו על ברירות המחדל לאורך כל הדרך.




