
כתבו את ה-guard שכולם כותבים:
try:
    r = requests.get(url, timeout=0.5)
except requests.exceptions.Timeout:
    retry()
עכשיו כוונו אותו לשרת ששולח מיד את שורת הסטטוס והכותרות, ואז נתקע לפני גוף התגובה. הקריאה באמת עוברת את מגבלת הזמן. אבל ה-guard לא מופעל. החריגה שנזרקת היא ConnectionError, ו-ConnectionError אינה תת-מחלקה של Timeout.
אותו מצב ב-httpx יזרוק ReadTimeout, שהוא TimeoutException, ולכן ה-guard המקביל כן יתפוס אותו.
יצאתי לבדוק במה httpx שונה מ-requests במקומות ששוברים סקרייפרים, ותכננתי לכתוב על async. בסוף התברר ש-async הוא כמעט הדבר הכי פחות מעניין ברשימה.
מה בדקתי ואיך
שמתי שמונה בדיקות מול שרת fixture מקומי, כי לקוח שמספר מה הוא עשה אינו הוכחה למה שבאמת קרה. השרת סופר חיבורי TCP — מתעדכן פעם אחת לכל socket שהתקבל, עוד לפני שמפענחים שורת בקשה כלשהי — וגם מסלולים שנשלפו בפועל. שימוש חוזר בחיבורים ו-follow redirects הם שניהם טענות לגבי ה-wire, וה-wire הוא המקום שבו בודקים אותן.
httpx 0.28.1 עם התוספת http2, requests 2.34.2, Python 3.14.2, macOS arm64. שניהם הורצו באותו virtualenv טרי, כדי שאף אחד לא יירש עקבות מהשני. פלט גולמי: httpx-probes.json.
שש תחזיות הוזנו למערכת לפני ההרצה הראשונה ונשארו שם גם אחריה. שלוש פגעו, שתיים היו שגויות, ואחת צדקה לגבי המקרה שחשבתי עליו אבל פספסה את המקרה שבאמת חשוב. prediction-scorecard.json כולל את החשבון.
ברירות המחדל שמשתנות מתחת לידיים
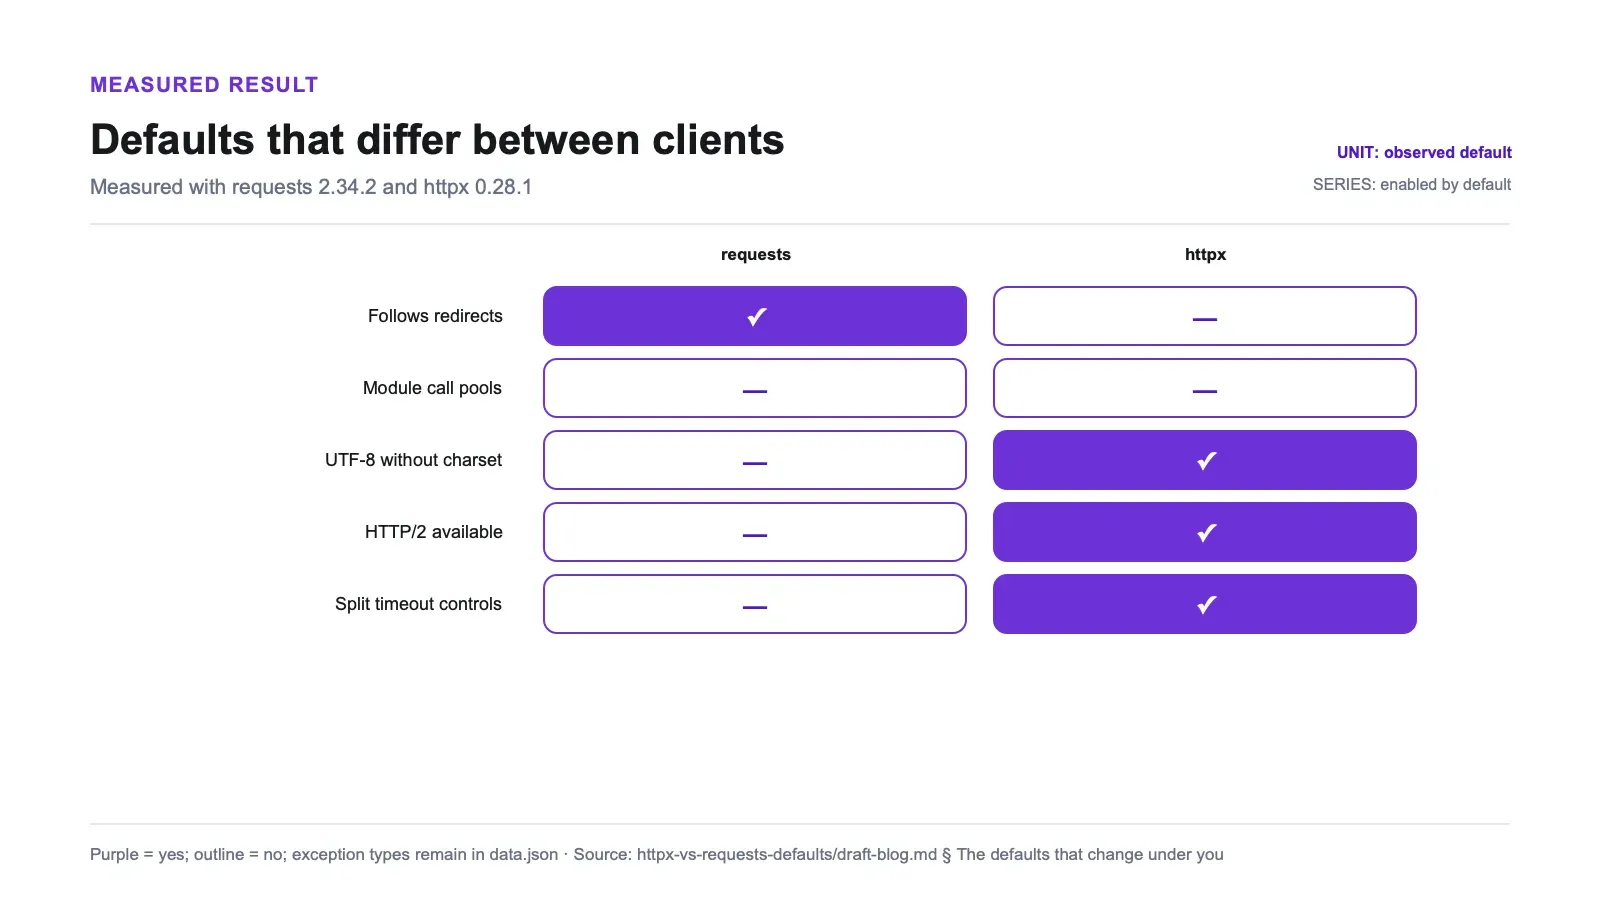
| התנהגות | requests 2.34.2 | httpx 0.28.1 |
|---|---|---|
| עוקב אחרי redirects כברירת מחדל | כן | לא |
| קריאה ברמת מודול עושה reuse לחיבורים | לא | לא |
| תקיעה לפני headers | ReadTimeout | ReadTimeout |
| תקיעה באמצע body | ConnectionError | ReadTimeout |
| בלי charset מוצהר | ISO-8859-1 | utf-8 |
| HTTP/2 | לא זמין | אופציונלי, עובד |
| timeout נפרד ל-connect/read/write/pool | לא | כן |
Redirects, שימוש חוזר ב-sockets, תוצאות חריגות, פענוח וקביעת פרוטוקול נצפו בבדיקות. צורת ה-API של ה-timeout והיעדר דגל HTTP/2 ב-requests הם תצפיות על יכולות ה-API. httpx-probes.json.
שלוש מהשורות האלה ישנו את מה שהקוד שלכם עושה ביום שתעברו, בלי להתריע.
Redirects: כבוי כברירת מחדל, והשרת מוכיח את זה
שרשרת redirect בת ארבע קפיצות שמסתיימת ב-/ok:
| לקוח | מה השרת ראה | הסטטוס שהוחזר |
|---|---|---|
| requests | 5 בקשות | 200 |
| httpx | בקשה 1 | 302 |
httpx, follow_redirects=True | 5 בקשות | 200 |
החמש הוא ארבע קפיצות ועוד יעד הסיום. התחזית שלי אמרה ארבע, שזה היה חישוב שלא בדקתי; הכיוון היה הטענה, והמספר תוקן כאן במקום להיטשטש בשקט בטקסט.
זו התנהגות מתועדת של httpx, והיא גם בחירה עיצובית הגיונית — redirect הוא משהו שלפעמים חשוב ללקוח לדעת עליו. אבל זו גם הדרך הכי סבירה שבה מיגרציה נשברת בלי לזרוק שגיאה. הקוד מקבל 302, ה-response.text ריק, הפרסר לא מוצא שורות, והלוגים שלכם אומרים 200 OK… בעצם הם אומרים 302, ואף אחד לא עקב אחרי קוד הסטטוס כי עם requests לא היה שום דבר לעקוב אחריו.
ממצא ה-timeout, שהוא זה שטעיתי בו
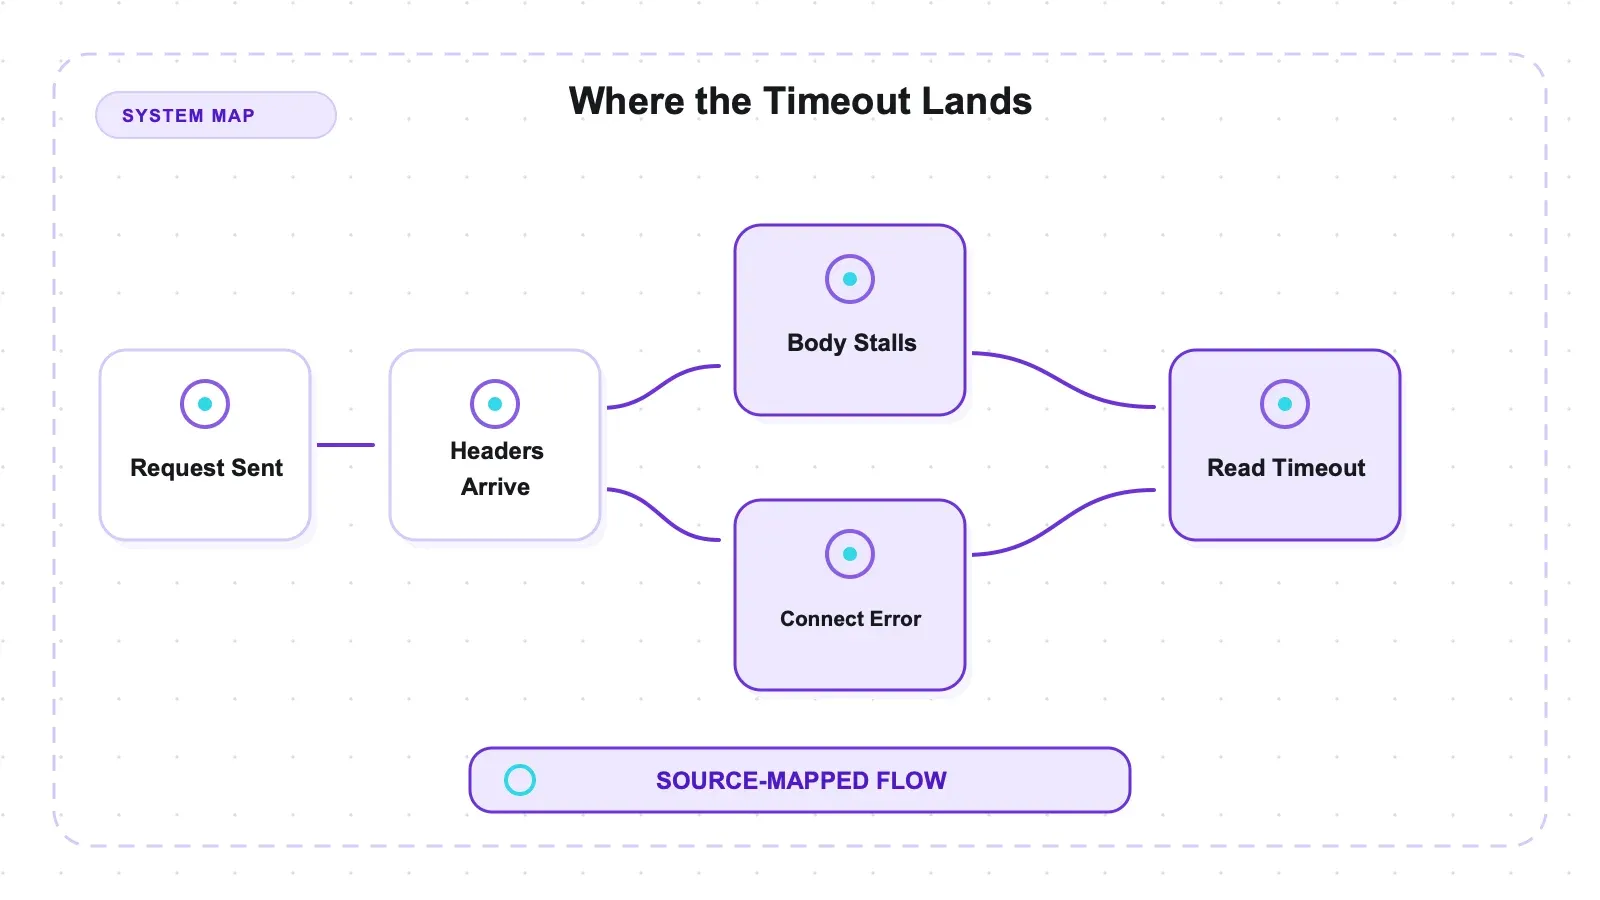
צפיתי ש-httpx יזהה במדויק איזה שלב נכשל, ו-requests יטשטש את הכול למחלקה אחת. בפועל זה הפוך.
מקור רשמי: Requests timeout documentation.
מקור רשמי: HTTPX timeout documentation.
| תקיעה | requests | httpx |
|---|---|---|
| לפני שורת הסטטוס | ReadTimeout | ReadTimeout |
| באמצע ה-body, אחרי שליחת headers | ConnectionError | ReadTimeout |
httpx נותן את אותו שם מדויק לשני המצבים. requests מפריד ביניהם — וגם מפריד אותם בדיוק על הגבול ש-code retry נכתב סביבו.
ההשלכה אינה מסקנה מהיררכיית המחלקות. הרצתי את ה-guard:
| תקיעה | except requests.exceptions.Timeout | except httpx.TimeoutException |
|---|---|---|
| לפני שורת הסטטוס | תופס | תופס |
| באמצע ה-body | בורח כ-ConnectionError | תופס |
timeout-retry-guard.json. requests.exceptions.ConnectionError אינה תת-מחלקה של requests.exceptions.Timeout; לעומת זאת httpx.ReadTimeout היא תת-מחלקה של httpx.TimeoutException.
הודעת החריגה של requests אומרת Read timed out. בתוך ConnectionError. הספרייה כן יודעת מה קרה. היא פשוט לא מספרת זאת לעץ הטיפוסים, וזה בדיוק מה שה-except שלכם בודק.
המקרה שנמדד כאן הוא ספציפי: headers מגיעים, ואז ההתקדמות של ה-body נעצרת מספיק זמן כדי לעבור את ה-read timeout. תגובה שממשיכה לשלוח chunks בתוך חלון הזמן, כולל stream מכוון, יכולה להתנהג אחרת ולא נבדקה כאן.
ניהול חיבורים: כל ההבדל נמצא ב-API של הלקוח
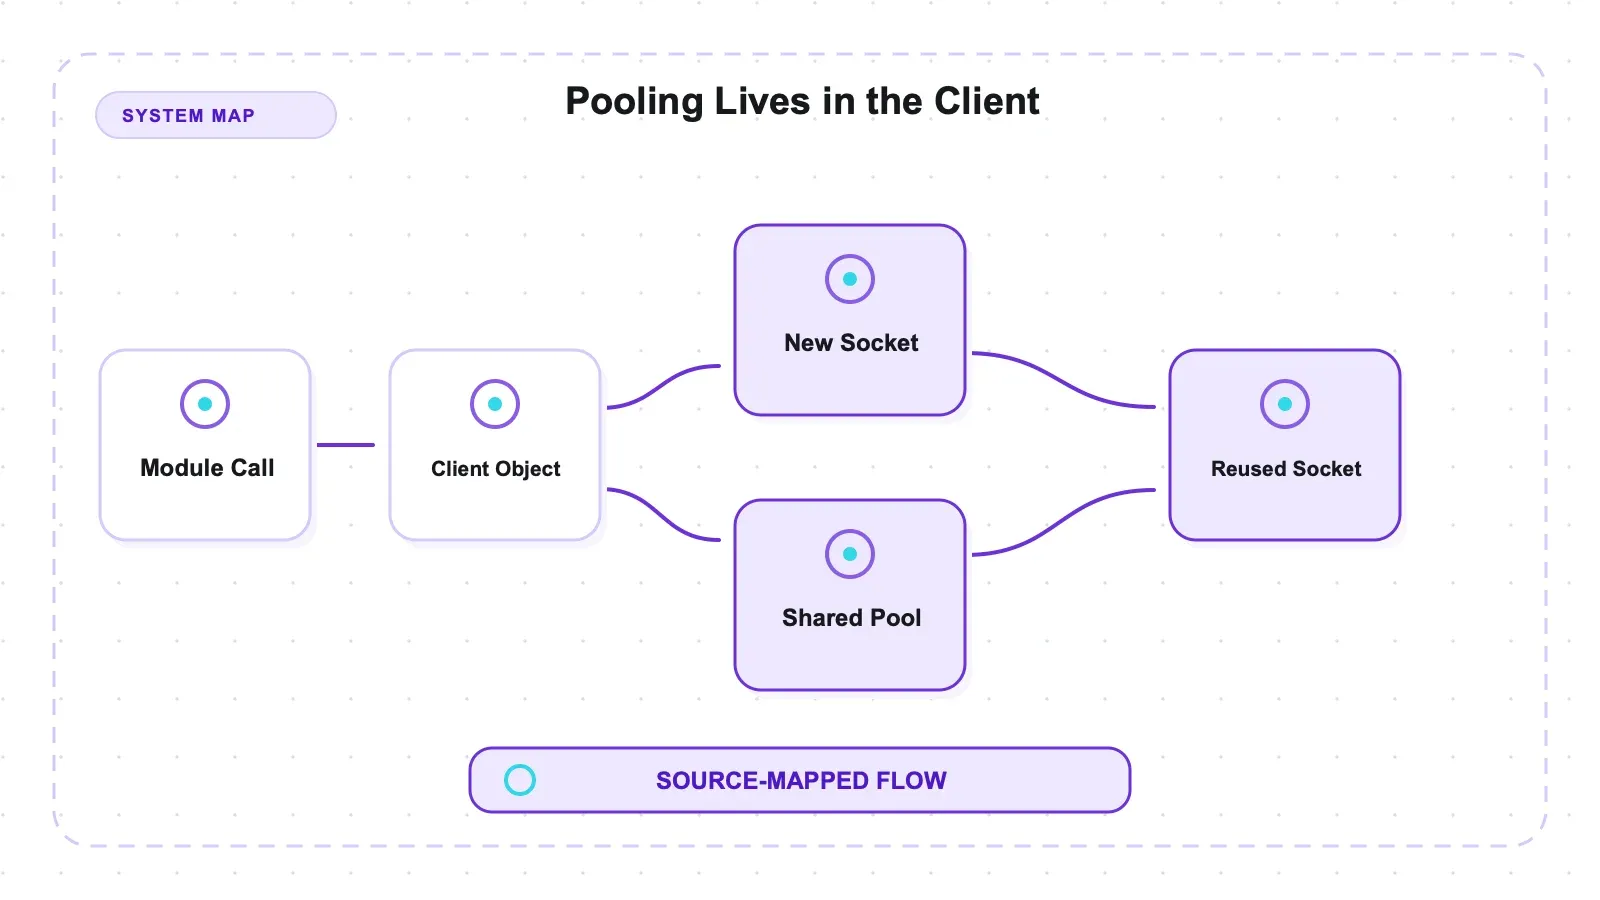
עשר בקשות GET, ארבע דרכים, וסופרים sockets בצד השרת:
| איך | כמה sockets נפתחו |
|---|---|
httpx.get() × 10 | 10 |
requests.get() × 10 | 10 |
httpx.Client() | 1 |
requests.Session() | 1 |
זהה, וחשוב להגיד זאת כי זה בדיוק הידע העממי הנפוץ ביותר על הזוג הזה — ש-httpx עושה pooling ו-requests לא. בפועל אף אחד מהם לא עושה pooling ברמת מודול. שניהם עושים זאת דרך אובייקט הלקוח. אם היום אתם קוראים ל-requests.get() בלולאה, מעבר ל-httpx.get() בלולאה לא ישנה שום דבר ביחס ל-churn של ה-sockets.
HTTP/2 הוא מפורש ודורש את התוספת
מול endpoint ציבורי אחד של HTTP/2 שנרשם בארטיפקט:
מקור רשמי: RFC 9113: HTTP/2.
| לקוח | הפרוטוקול שננשא במשא ומתן |
|---|---|
httpx.Client(http2=True) | HTTP/2 |
httpx.Client(http2=False) | HTTP/1.1 |
| requests | HTTP/1.1, אין דגל כזה |
צריך את התוספת httpx[http2]. הנחתי ש-pip install httpx רגיל יתן לקוח ששותק ועושה negotiate ל-1.1, ובדקתי לפני שכתבתי את זה:
ImportError: Using http2=True, but the 'h2' package is not installed.
Make sure to install httpx using `pip install httpx[http2]`.
הוא זורק כבר בזמן יצירת Client, לפני בקשה אחת, וההודעה גם מציינת איך לתקן. זו הגרסה הטובה של הכשל הזה, ואני טעיתי לגביה (http2-extra-missing.json).
הבדיקה הזו מוכיחה שהפרוטוקול ננשא בהצלחה במשא ומתן על ה-endpoint הזה. היא לא מוכיחה יתרון במהירות סקרייפינג; לא נבדק כאן workload מקביל ב-HTTP/1.1.
תפוקה סדרתית מול מקבילית על fixture
עשרים בקשות אל endpoint שישן 0.3 שניות:
| מצב | זמן כולל | sockets |
|---|---|---|
Sync, Client אחד | 6.138 שנ׳ | 1 |
Async, AsyncClient אחד | 0.357 שנ׳ | 20 |
ההרצה המקבילה הסתיימה ב-0.357 שניות לעומת 6.138 שניות בהרצה הסדרתית. אבל היא גם פתחה עשרים חיבורים, בעוד הלקוח הסינכרוני השתמש שוב באחד, כך שהניסוי משנה את מודל הביצוע ואת רמת המקביליות בפועל במקום לבודד את מהירות הספרייה.
זו המסגור הכנה של המספר. זו מדידה של מקביליות מול endpoint איטי במכוון, לא מדידה של httpx. כל לקוח עם async שעובד ינחת בערך באותו אזור, ומול endpoint מהיר הפער מתכווץ.
מקרה ה-charset שלא חשבתי לנבא
ניבאתי שתגובה שכותרת ה-charset שלה משקרת — charset=iso-8859-1 על bytes של utf-8 — תייצר אותו mojibake בשתי הספריות. וזה נכון. שתיהן מחזירות Café Ubersetzung â naïve résumé במקום המקור Café Ubersetzung — naïve résumé.
המקרה שלא ניבאתי הוא זה שבאמת חשוב:
| תגובה | איך requests מפענח | איך httpx מפענח |
|---|---|---|
charset=utf-8, bytes של utf-8 | נכון | נכון |
charset=iso-8859-1, bytes של utf-8 | mojibake | mojibake |
| אין charset בכלל | mojibake | נכון |
requests חוזר ל-ISO-8859-1 כשה-header לא מציין כלום, בעוד httpx משתמש כברירת מחדל ב-utf-8. לכן ב-fixture של חוסר charset, הלקוחות הפיקו טקסט מפוענח שונה דרך .text; צרכנים שמשתמשים ב-response.content שומרים על אותם bytes מקוריים.
זיכרון, כי קל למדוד אותו
Peak RSS, /usr/bin/time -l, תהליך טרי אחד לכל תא:
| תא | requests | httpx |
|---|---|---|
| רק import | 36.0 MiB | 30.6 MiB |
| import ועוד GET אחד | 35.8 MiB | 40.7 MiB |
אלה snapshots של תהליך אחד, והערך של requests עם GET אחד שנמצא קצת מתחת לערך ה-import-only שלו חושף את רעש הריצה. אי אפשר להסיק מכאן מסקנה כיוונית על זיכרון; היה צריך דגימות חוזרות וטווחים.
מה זה אומר כשבוחרים
מצאתם באגים בקוד קיים של requests? בדקו הנחות לגבי redirects, handlers שתופסים רק requests.exceptions.Timeout אבל מצפים לכסות תקיעה באמצע body, וצרכני .text שמקבלים תגובות בלי charset.
עוברים באופן מכני ל-httpx? עדכנו namespaces של חריגות ל-httpx.TimeoutException או למחלקות הצרות יותר לפי שלב, החליטו אם להפעיל follow_redirects, ובדקו מחדש הנחות פענוח. ה-handler הקיים של requests כבר מפספס את המקרה המוצג של תקיעה באמצע body; המיגרציה לא יוצרת את הבאג הזה.
כותבים משהו חדש שמביא הרבה URLs? httpx הוא מועמד טוב כשצריך AsyncClient ו-timeouts נפרדים ל-connect, read, write ו-pool. השלבים האלה אומרים לכם איפה ההמתנה קרתה — הקמת חיבור, התקדמות ב-body, העלאת הבקשה, או הקצאה מקומית מה-pool — לא למה השרת המרוחק התנהג כך.
כותבים משהו קטן וסינכרוני? requests בסדר גמור, והוא נמצא בכל מקום. הסיבה לעבור היא לא מהירות.
מה שלא תבחרו, השתמשו באובייקט הלקוח ולא בפונקציה ברמת המודול. זה השינוי היחיד ברשימה הזו שהוא ניצחון ברור בשתי הספריות.
איפה API מנוהל משתלב
כל מה שלמעלה הוא שכבת ה-fetch, ושכבת ה-fetch היא החלק הקל. שום דבר מזה לא מריץ JavaScript, שום דבר לא מתמודד עם anti-bot challenge, ושום דבר לא הופך HTML לשורות שרציתם.
הערת מחבר: Thunderbit היא האפשרות המנוהלת שלנו ל-rendering ול-extraction מתוך URL. היא לא נבדקה ב-harness הזה של לקוחות HTTP. כדאי לשקול את הקטגוריה הזו רק כשבעייתכם היא של שליפת עמוד או חילוץ מובנה — ולא סמנטיקה של לקוח HTTP.
אם אתם שולפים דפים רגילים ומנתחים אותם בעצמכם, שני הלקוחות עדיין רלוונטיים. שירות מנוהל הוא החלטה נפרדת של build מול buy, לא הוכחה לבחירה בין הספריות האלה.
לתמונה הרחבה יותר, ה-web scraping API roundup שלנו מסקר את האפשרויות המארחות, וה-open-source scraper pillar את האפשרויות שמתארחות אצלכם.
נסו את Thunderbit לחילוץ נתוני רשת
מסקנה
עבור שכבת fetch חדשה ב-Python שצריכה מקביליות async, timeouts לפי שלב ו-fallback ל-UTF-8, httpx הוא ברירת המחדל שלי תחת המגבלות שנבדקו כאן. requests עדיין בחירה סבירה לקוד סינכרוני ותיק, כשסיכון המיגרציה גדול מהיתרונות האלה. פרוקסים, מדיניות retries, TLS fingerprinting, streaming, uploads ושונות רשת ריאליסטית לא נבדקו, כך שזה לא דירוג אוניברסלי של לקוחות סקרייפינג.
הסיבה להיזהר היא ברירת המחדל של redirects, והיא אכן סכנה אמיתית דווקא משום שזו בחירה עיצובית טובה. explicit עדיף על implicit — עד לרגע שבו מה שהיה implicit היה חלק נושא-משקל בקוד שכבר שחררתם.
לוח הניקוד שנרשם מראש הסתיים בשלוש תחזיות נכונות, שתיים שגויות ותחזית אחת חלקית. התיקון השימושי היה מחלקת החריגה של mid-body; את שאר ההחלטה צריך לגזור מההתנהגות שנצפתה, לא מהנרטיב של לוח הניקוד.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם באמת httpx לא עוקב אחרי redirects?
לא כברירת מחדל. השרת ספר בקשה אחת לשרשרת של ארבע קפיצות, והתגובה חזרה כ-302. אפשר להעביר follow_redirects=True בכל קריאה, או להגדיר זאת פעם אחת על ה-Client. זה מתועד ומכוון; ובכל זאת זו עדיין הסכנה הסבירה ביותר למיגרציה שקטה, כי הכשל הוא פרסר ריק במקום חריגה.
האם except requests.exceptions.Timeout באמת לא מספיק?
לא במקרה של שרת שנתקע אחרי שליחת headers. במקרה כזה נזרק ConnectionError, שאינה תת-מחלקה של Timeout, ולכן ה-guard מפספס אותה — וזה הודגם ישירות ולא הוסק. אם רוצים לתפוס את שניהם, אפשר לתפוס requests.exceptions.RequestException, אבל אז תתפסו גם דברים שאינם טיימאאוטים.
האם httpx מהיר יותר מ-requests? לא באופן משמעותי, כשמדובר בבקשה אחת בכל פעם — זו לא המטרה שלו. ה-17.2× במבחן הזה הוא מדידה של עשרים בקשות מקבילות מול endpoint של 0.3 שנ׳, כלומר מדידה של מקביליות. אם ה-workload שלכם סדרתי, אל תצפו להאצה ובחרו לפי ברירות המחדל.
האם צריך את התוספת http2?
רק אם אתם רוצים HTTP/2 — ואם תגדירו http2=True בלעדיה, httpx יזרוק ImportError בזמן יצירת ה-Client, עם הודעה שמבקשת להתקין httpx[http2]. אין כאן downgrade שקט. אני ציפיתי אחרת ובדקתי במקום לכתוב.
מה לא נבדק כאן? התנהגות של פרוקסים, שמשמעותית מאוד בסקרייפינג ודורשת harness משלה. retries — ל-httpx אין לוגיקת retry מובנית, ול-requests יש את זו של urllib3, כך שהשוואה הוגנת היא בעצם בין שתי ספריות retry. TLS fingerprinting, שזה הציר שמערכות anti-bot באמת בוחנות ושאף אחת מהספריות לא פותרת. streaming והעלאות קבצים. וגם זה: הכול כאן רץ על מכונה אחת, גרסת Python אחת, ובשש מתוך שמונה הבדיקות על localhost — מספרי latency משרת fixture הם מדידה של העיצוב, לא של הרשת שלכם.




