
html2text מתקין חבילה אחת בלבד בגודל של 0.2 MiB — קטן פי תשעה מהאלטרנטיבה הקרובה ביותר ב-Python ופי ארבעים מהאופציה ב-Node. הוא השלים את כל ארבעת הדפים בסט ההמרה ושמר על כל 16 בדיקות הגוף הרשומות. הבדיקות האלה בודקות אם מחרוזות גוף נבחרות נשמרות; הן לא מדרגות היררכיה, קינון של רשימות, יעדי קישורים, תוכן חוזר או נאמנות מלאה של טבלאות.
בנוסף, הוא מופץ ברישיון GPL-3.0-or-later, וזהו המאפיין היחיד בהשוואה הזו שלא מופיע באף בנצ'מרק ויכול להפיל ספרייה מהשימוש לגמרי.
מהו html2text
html2text היא ספריית Python שממירה HTML לטקסט שטוח בסגנון Markdown. המקור שלה הוא בעבודה המקורית של Aaron Swartz, והגרסה המתוחזקת כיום היא 2025.4.15 — שחרור עם תאריך ב-אפריל 2025, עם 2,168 כוכבי GitHub, 95 תקלות פתוחות, ו-push אחרון באוקטובר 2025.
מקור רשמי: המאגרים הרשמיים של html2text.
import html2text
h = html2text.HTML2Text()
h.body_width = 0          # ראו בהמשך; ברירת המחדל תפתיע אתכם
md = h.handle(html)
pip install html2text מושך חבילה אחת ו-0.2 MiB בלבד, עם טעינה ראשונית של 0.077 שניות. בלי תלויות כלל. בתוך קונטיינר או Lambda layer, זה הבדל משמעותי לעומת 1.8 MiB של markdownify ו-8.8 MiB של turndown.
ברירת המחדל שמשנה כל מספר
body_width מוגדר כברירת מחדל ל-78. כלומר, html2text עוטף בכוח כל שורה בפלט אחרי 78 תווים, אלא אם מבטלים זאת.
זו ברירת מחדל סבירה עבור ספרייה שתפקידה המקורי היה לייצר טקסט קריא למסופי עבודה ולאימייל. זו ברירת מחדל פחות מתאימה לכל דבר שנכנס למודל או להשוואת diff, כי שורות חדשות שמתווספות משנות טוקניזציה, שוברות קישורים ארוכים באמצע, והופכות השוואת פלט לחסרת משמעות.
לכל מה שמופיע בהמשך הגדרתי body_width = 0, ואני מציין זאת בגלוי ולא מטשטש את זה: עם עטיפה פעילה, כל ספירת תווים וטוקנים במאמר הזה הייתה שונה. אם אתם עושים בנצ'מרק לממירים בעצמכם, זו ההגדרה שעלולה להפוך את המספרים שלכם לבלתי ניתנים להשוואה בלי שתשימו לב.
המדידה
הפעלתי את html2text על סט המרה בן ארבעה דפים עם שם קבוע, שגם שימש להשוואת markitdown, יחד עם מחרוזות בדיקה רשומות מראש — מחרוזות גוף נבחרות שחייבות להישמר, ומחרוזות boilerplate שנוכחותן מוכיחה שגם מסגרת הדף עברה. אותם ארבעה קבצים, אותן בדיקות, אותו מנגנון ניקוד על פני כל ארבעת הממירים. הישרדות של probe מודדת נוכחות של מחרוזת רשומה, לא נכונות מבנית; עמודות הטבלה והקישורים נבדקות בנפרד בדיוק מהסיבה הזו.
| ממיר | בדיקות גוף | תווי פלט | טוקנים (o200k) | שורות טבלת Markdown | קישורים |
|---|---|---|---|---|---|
| html2text | 16/16 | 76,452 | 21,176 | 32 | 545 |
| markdownify | 16/16 | 76,868 | 21,062 | 36 | 599 |
| markitdown | 16/16 | 76,995 | 21,336 | 36 | 598 |
| turndown | 16/16 | 95,188 | 26,236 | 0 | 611 |
fourway-scores.json. ארבעה קבצים, טוקנים נספרו עם o200k_base.
הפלט הקטן ביותר מבין הארבעה — 76,452 תווים, ובפועל כמעט תיקו בטוקנים מול markdownify ו-markitdown — 21,176 מול 21,062 ו-21,336, פער של 1.3% שלא הייתי קורא לו הבדל משמעותי.
32 שורות טבלה לעומת 36 אצל markdownify ו-markitdown בסט של ארבעת הדפים. הפער של ארבע שורות מופיע על תצורת ויקיפדיה הלא-סדירה, ולא בגלל הבדל בפורמט outer-pipe שמתואר בהמשך.
הכי מעט קישורים — 545, לעומת 598 עד 611 אצל האחרים. כדאי לבדוק זאת מול הדפים שלכם אם שמירת קישורים חשובה — זו העמודה היחידה שבה html2text נמצא בבירור מתחת לקבוצה ולא בתוכה.
הטבלאות שה-regex שלי לא ראה
השקף הזה חשוב, כי כמעט פרסמתי עליו ממצא שגוי.
מונה שורות הטבלה הראשון שלי דרש צינורות בתחילת ובסוף השורה — ^\|.*\|$. לפי הכלל הזה, html2text קיבל שורת טבלה אחת בלבד מתוך חמישה קבצים: סט ארבעת הדפים ועוד fixture סינתטי נפרד של טבלה מורכבת. בפועל המונה הזה בדק סגנון Markdown אחד, לא טבלאות.
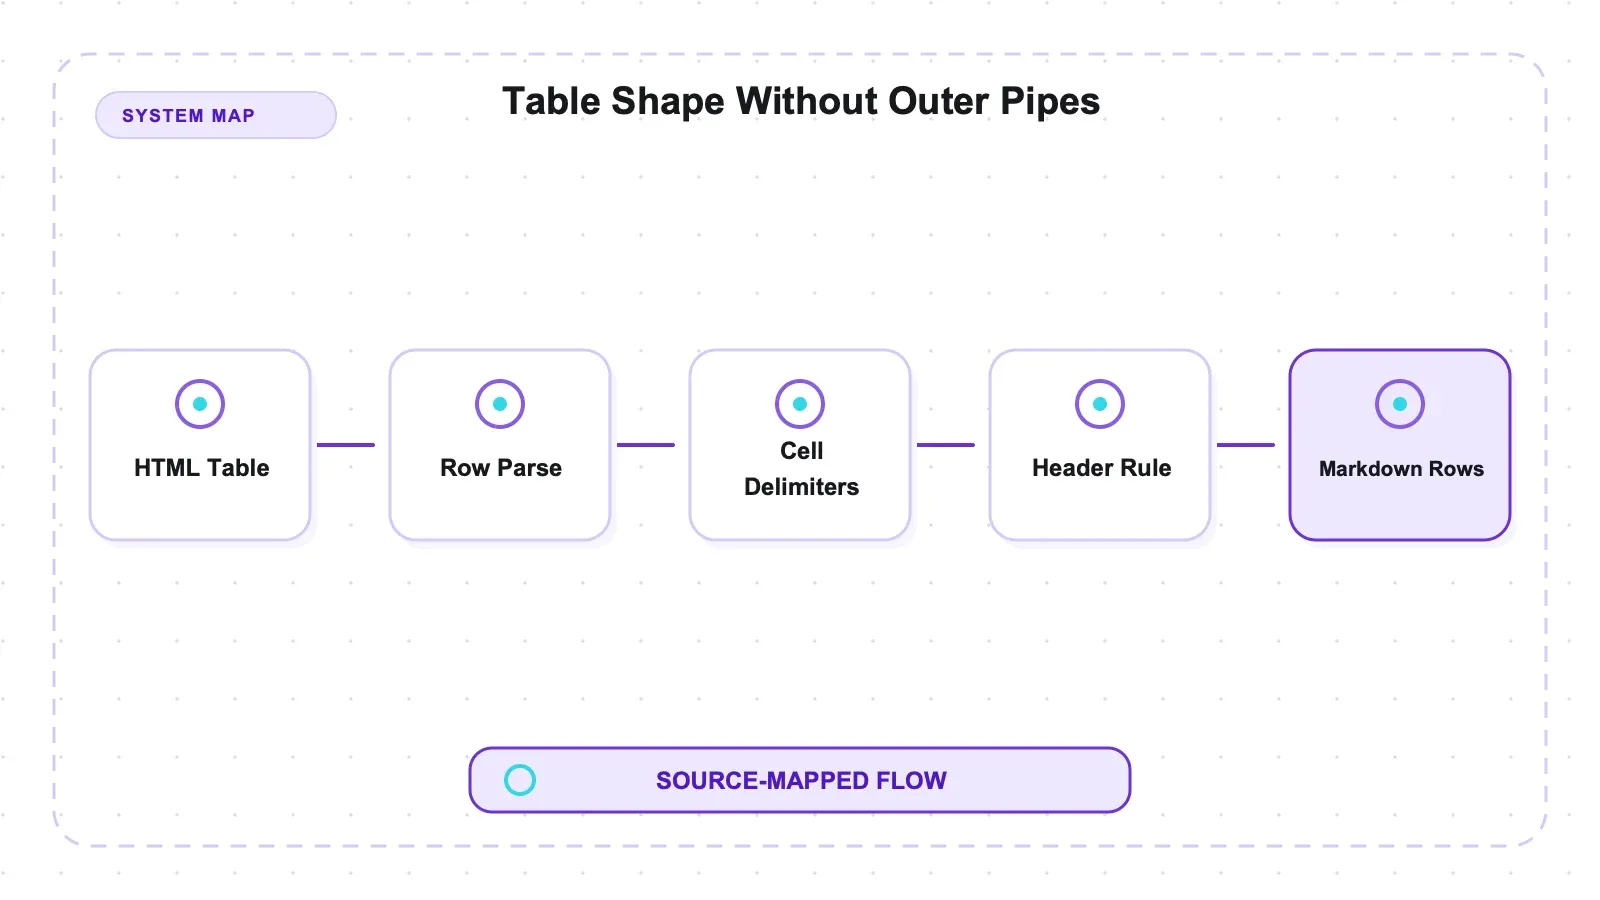
זה כן. הוא פולט טבלאות כך:
Team Name  |  Year  |  Wins  |  Losses  |  Win %
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  |  0.55
בלי צינורות חיצוניים. זהו syntax תקין של pipe-table, אבל ההרצה לא אימתה אותו מול renderers שונים של Markdown. regex שמצפה לסגנון עם צינורות חיצוניים לא יראה אותו. כשכתבתי מחדש את המונה כך שיחפש רצף של שורות עם צינורות וביניהן שורת מפריד, html2text זינק מ-1 שורה ל-32 בסט ארבעת הדפים ול-91 בכל חמשת הקבצים.
אז המסקנה איננה של-html2text חסרות טבלאות. המסקנה היא ש-שניים מתוך ארבעת הממירים האלה מוציאים outer pipes ואחד לא, וזה חשוב אם אתם מבצעים עיבוד-אחרי של ה-Markdown עם pattern matching משלכם. זה נתון אמיתי שכדאי להכיר, והייתי מפספס אותו לגמרי אילו הייתי סומך על המספר הראשון.
מה הוא מסיר, ואיפה הוא מאבד שורות
שני ממצאים שמושכים לכיוונים מנוגדים.
הוא מסיר <script> ו-<style>. לפי מונים שמזהים רק מחרוזות שמופיעות בתוך אלמנטים כאלה, הפלט של html2text על פני כל ה-fixtures כולל אפס סימוני script ואפס סימוני style. לעומת זאת, ל-turndown יש 10 ו-84 — על ה-fixture של ויקיפדיה, שמונה שורות של JavaScript פנימי של MediaWiki ו-CSS בשווי 14,644 תווים (script-style-stripping.json). עבור פלט שמיועד למודל, זה היה מקור הטקסט המיותר הגדול ביותר שראיתי על אותו fixture. לא נמדד עלות downstream.
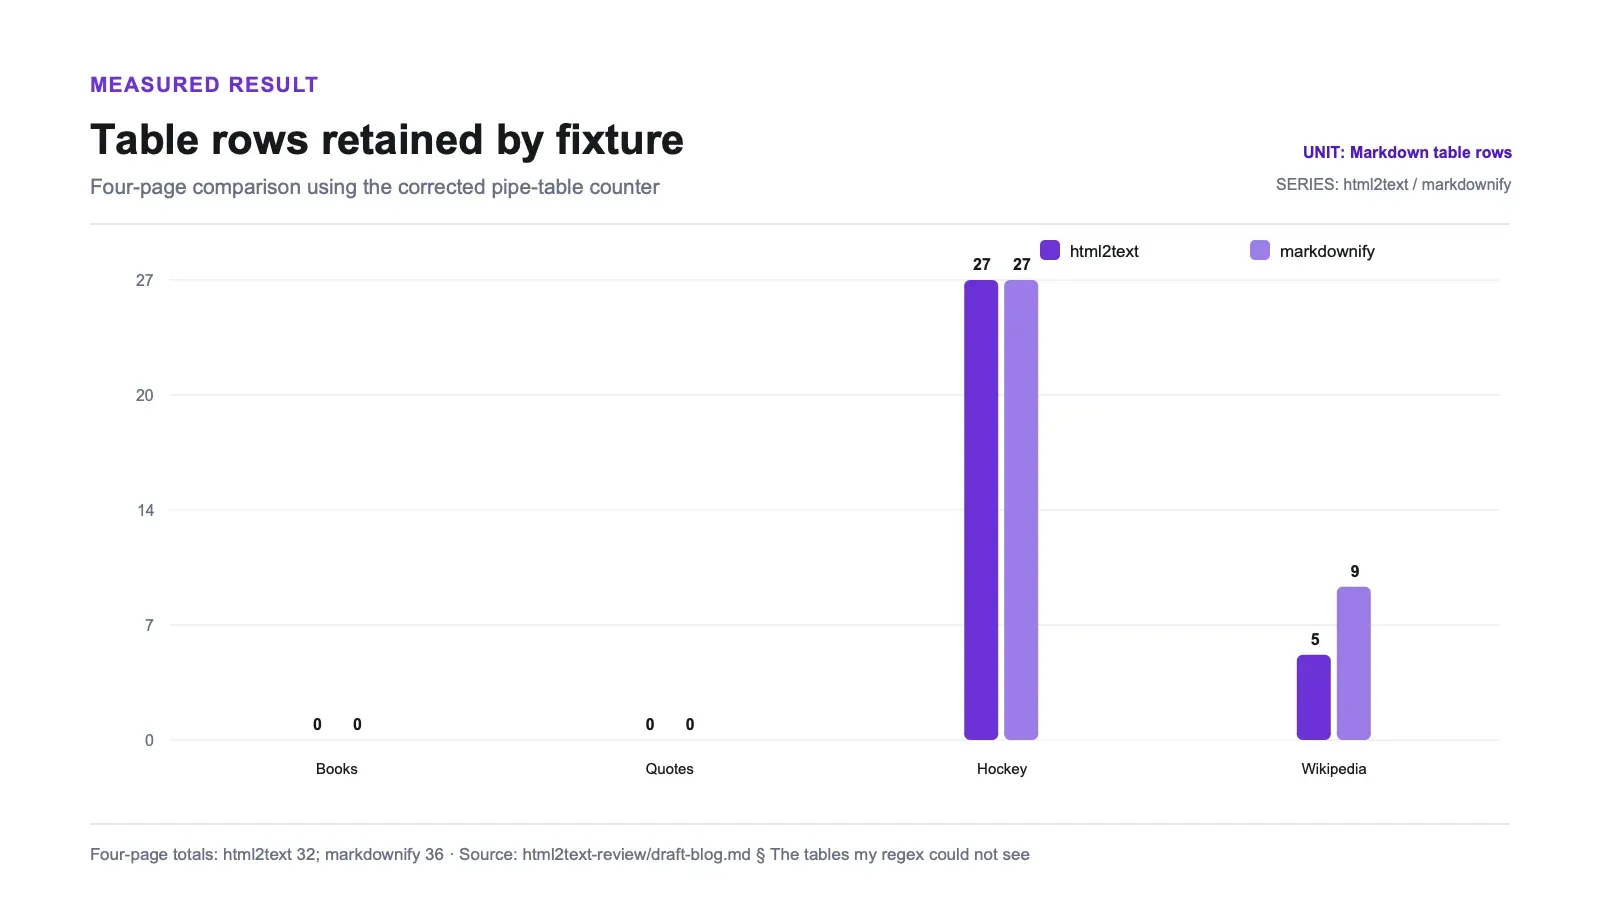
הוא מאבד שורות טבלה בדף הקשה. סט ארבעת הדפים מתיישר כך:
| Fixture | html2text | markdownify |
|---|---|---|
| Books to Scrape | 0 שורות | 0 שורות |
| Quotes to Scrape | 0 שורות | 0 שורות |
| Hockey statistics | 27 שורות | 27 שורות |
| Wikipedia | 5 שורות | 9 שורות |
| סה"כ ארבעת הדפים | 32 שורות | 36 שורות |
ה-fixture הסינתטי הנפרד של הטבלה המורכבת מוסיף 59 שורות ל-html2text ו-62 ל-markdownify, כך שהסך הכול בחמשת הקבצים מגיע ל-91 ו-98. הוא לא חלק מההשוואה המרכזית של ארבעת הדפים. על הטבלה הנקייה של הוקי הם מסכימים. בויקיפדיה, שבה הטבלאות מקוננות ולא סדירות, html2text מפיק חמש שורות במקום תשע.
כלומר, הדפוס הוא: טבלאות פשוטות — זהות; טבלאות מסורבלות — html2text שומר פחות. אם הדפים שלכם כוללים טבלאות כמו של ויקיפדיה, בדקו זאת לפני שמתחייבים. אם הם כוללים טבלאות כמו של דף סטטיסטיקות, שני הכלים שקולים כמעט לגמרי בציר הזה.
הרישיון
| ספרייה | רישיון | חבילות | נפח |
|---|---|---|---|
| html2text | GPL-3.0-or-later | 1 | 0.2 MiB |
| markdownify | MIT | 5 | 1.8 MiB |
| turndown | MIT | 3 (npm) | 8.8 MiB |
מקור רשמי: html2text ב-PyPI.
אומת בשלושה מקומות: מטא-דאטה של PyPI, מאגר GitHub, וקובץ ה-METADATA של החבילה המותקנת, שבו מופיע License-Expression: GPL-3.0-or-later.
מה זה אומר בפועל תלוי באופן שבו התוכנה משולבת, מועברת ומופצת. שימוש פנימי או דרך רשת הוא בדרך כלל תרחיש GPL שונה משחרור תוכנה שכוללת את החבילה או מקושרת אליה, אבל המאמר הזה אינו ניתוח משפטי. צוותים שמפיצים תוכנה צריכים להתייעץ עם ייעוץ משפטי לגבי מודל האינטגרציה וההפצה המדויק.
החלק המביך הוא המתאם. הספרייה עם טביעת הרגל הקטנה ביותר, זו שהייתם בוחרים בדיוק כי אתם מנסים לשמור על ארטיפקט שניתן להפצה קטן ככל האפשר, היא גם זו עם הרישיון שמגביל את ההפצה הכי הרבה. שתי החלופות האחרות הן MIT.
אני לא עורך דין וזה לא ייעוץ — רק עובדה, עם מקור, כי זה המאפיין שסביר ביותר שיקבע ובו בזמן הכי פחות סביר שייראה בטבלת השוואה.
תחזוקה
שחרור אחרון 2025.4.15, push אחרון למאגר באוקטובר 2025 — בערך עשרה חודשים לפני הבדיקה, עם 41 שחרורים מאחוריו. requires_python >= 3.9, והוא הותקן והופעל בהצלחה על Python 3.14.2.
זה שקט יותר מ-markdownify (שחרור אחרון שישה שבועות לפני הבדיקה) ומ-turndown (ארבעה חודשים), ובהחלט חי יותר מכלום. עבור ספרייה שממירה HTML לטקסט — בעיה שלא משתנה הרבה — פער של עשרה חודשים מרגיש כמו יציבות ולא כמו נטישה. 95 תקלות פתוחות הן האזהרה הגדולה יותר, ושווה לעבור עליהן כדי לראות אם יש משהו שדומה למקרה השימוש שלכם לפני שמתחייבים.
זיכרון, ומה HTML שבור עושה לו
כאן נמדדות בנפרד שתי שאלות תפעוליות.
הקשר רחב יותר של stress-test נמצא ב-השוואת זיכרון ו-HTML פגום בין עשר ספריות.
שיא זיכרון resident, באמצעות /usr/bin/time -l, תהליך טרי לכל תא — רצפת היבוא היא העלות של הספרייה כשהיא טעונה וממתינה, והפסגות כוללות את המסמך.
| ספרייה | Runtime | רצפת יבוא | שיא 226 KB | שיא 10 MB | |---|---|--:|--:| | html2text | python3.14 | 18.7 | 19.9 | 71.2 | | pyquery | python3.14 | 30.3 | 33.9 | 172.5 | | resiliparse | python3.14 | 20.5 | 25.1 | 225.1 | | markdownify | python3.14 | 23.9 | 28.9 | 278.5 | | goose3 | python3.14 | 44.1 | 52.4 | 398.5 | | cheerio | node22 | 66.8 | 76.5 | 398.5 | | justext | python3.14 | 30.3 | 36.6 | 431.2 | | newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 | | trafilatura | python3.14 | 52.5 | 64.8 | 927.1 | | turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. לא ניתן להשוות ישירות בין בסיסי Python ו-Node; המפרש כלול בשניהם.
html2text הוא הפריט הקל ביותר כאן בשני הצירים שנמדדו. רצפת היבוא שלו, 18.7 MiB, ושיא של 71.2 MiB על ה-fixture של 10 MiB נותנים RSS מצטבר של 52.5 MiB: (71.2 - 18.7) / 10 = 5.25× מגודל ה-fixture. השוו זאת לשורות האבסולוטיות והמצטברות בטבלה, תוך שמירה על אזהרת ה- Python/Node שהוזכרה.
HTML שבור. שנים-עשר מסמכים שכל אחד מהם שובר בדיוק דבר אחד — תגיות לא סגורות, אלמנטים inline מקוננים לא נכון, מאפיינים ללא מרכאות עם רווחים, סוגרי-סיום תועים, בלי <html> בכלל, מאפיינים כפולים, מסמך שנקטע באמצע תג, ישויות לא תקינות, <script> לא סגור, הכרזת charset שקרית, תגובה שמכילה markup, ו-600 רמות קינון — ועוד שני מסמכי בקרה תקינים לחלוטין בגודל תואם, כי "הוא לא החזיר כלום" אומר משהו על פגימות רק אם הספרייה גם שותקת על מסמך תקין באותו גודל.
html2text זרק שגיאה ב-0 מתוך 14 ולא החזיר כלום ב-0, ושיחזר 33/33 סנטינלים בכל ה-fixtures הפגומים (malformed-results.json). Fixture אחד לא נכלל בספירה הזו: לפי HTML5, כל מה שאחרי <script> לא סגור הוא תוכן script, לכן איבוד שלו שם הוא ההתנהגות הנכונה, והשחזור שלו היה הסטייה.
יתרונות וחסרונות
לטובתו. חבילה אחת, 0.2 MiB, בלי תלויות — בפער עצום הקטן ביותר בהשוואה. הפלט הקטן ביותר מבין הארבעה, ובפועל תיקו בטוקנים עם markdownify ו-markitdown. מפיק syntax מזוהה של pipe-table. רץ על Python 3.14. שושלת ארוכה ויציבה.
נגדו. GPL-3.0-or-later, בניגוד לחלופות. ברירת המחדל body_width=78, שעוטפת בכוח את הפלט ומשנה מדידות או diff אלא אם מבטלים אותה. הכי מעט קישורים שנשמרו (545 לעומת 598–611). טבלאות משתמשות בסגנון בלי outer pipes, מה ששובר regex נאיבי downstream. 95 תקלות פתוחות וקצב שחרורים שקט יותר מ-markdownify.
מי צריך להשתמש בו ומי לא
כדאי להשתמש ב-html2text כשתקציב התלויות באמת צפוף, ומודל האינטגרציה וההפצה המתוכנן כבר עבר בדיקת רישיון. חבילה אחת בלי תלויות היא יתרון תפעולי אמיתי: משטח תלויות קטן יותר לבדיקה ולהפצה.
הגדירו body_width = 0 בשורה הראשונה, אלא אם אתם באמת רוצים טקסט שטוח עם שבירת שורות.
דלגו עליו אם אתם מפיצים תוכנה ו-copyleft הוא בעיה — markdownify הוא MIT, מתחרה איתו בטוקנים, ומתאים ל-markitdown בטבלאות בתוספת 1.6 MiB בלבד. דלגו עליו גם אם שמירת קישורים חשובה לכם, כי הוא שמר על הכי מעט. ודלגו עליו אם כלי ההמשך שלכם מניח שורות טבלה עם outer pipes.
איפה API מנוהל נכנס לתמונה
html2text ממיר HTML שכבר יש לכם. הוא לא מביא דפים, לא מרנדר JavaScript, ולא מתמודד עם שכבת anti-bot — ואף אחד מארבעת הממירים לא עושה את זה, וביעדים אמיתיים רבים זה החלק הקשה יותר של העבודה.
לאותם fixtures בכל חמשת הממירים, ראו את השוואת HTML ל-Markdown בחמישה כיוונים.
שירות hosted של fetch/render/extraction, כולל Thunderbit שלנו, פועל בשכבה אחרת. Thunderbit לא נבחן כאן. הגבול הרלוונטי הוא בין המרת HTML שכבר סופק לבין שירות שאוסף ומעבד URL; המאמר הזה לא מספק השוואת איכות, latency או עלות באותו מדד.
המסגור ההוגן: אם ה-HTML כבר אצלכם, אתם רוצים Markdown, והרישיון GPL לא מהווה בעיה עבור אופן ההפצה שלכם — html2text הוא חינמי וקטן באופן מרשים. אם אתם מביאים דפים מהרשת, או צריכים שורות במקום טקסט רציף, זה כבר מוצר אחר.
לתמונה הרחבה יותר, סקירת web scraping APIs שלנו מכסה אפשרויות hosted, ו-עמוד היסוד של open-source scrapers את הפתרונות העצמאיים. המרת HTML ל-Markdown ב-Python היא המדריך המעשי.
נסו את Thunderbit לחילוץ נתוני רשת
האם כדאי להשתמש ב-html2text?
הוא מועמד חזק כשחשוב מאוד לשמור על footprint קטן, כשמכבים עטיפת שורות במכוון, וכשמבחינת ההפצה שלכם הרישיון עובר בדיקה בהצלחה.
ספירת הטוקנים שלו הייתה בתוך 1.3% מ-markdownify ו-markitdown בסט ארבעת הדפים. זה לא אומר שהאיכות הכוללת זהה: html2text שמר פחות קישורים ופחות שורות בטבלת ויקיפדיה הלא-סדירה. שני פרטי תפעול חשובים מיד: body_width = 0, וסגנון הטבלאות בלי outer pipes.
אם בדיקת GPL פוסלת אותו, markdownify הוא MIT, נתן כאן גודל פלט וספירת טוקנים דומים, שמר יותר קישורים ושורות טבלה לא סדירות, ותפס 1.6 MiB יותר בדיסק בסביבה הזו.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם html2text ממיר טבלאות?
כן. המונה הראשון שלי טען שהוא הפיק שורת טבלה אחת מתוך חמישה קבצים, אבל זה היה מונה שגוי — הוא דרש צינורות בתחילת ובסוף, בעוד html2text מפיק Team Name | Year | Wins בלי אותם. זהו Markdown תקני של pipe-table, אף שההרצה הזו לא בדקה תאימות בין renderers שונים. עם המונה המתוקן, html2text הפיק 32 שורות לעומת 36 של markdownify בסט ארבעת הדפים, ו-91 לעומת 98 כשה-fixture המורכב הנפרד כלול.
מה עושה body_width, ולמה לשנות אותו?
הוא עוטף בכוח את הפלט אחרי 78 תווים כברירת מחדל — בחירה סבירה לטקסט קריא במסוף, ורעה כמעט לכל שימוש אחר. העטיפה מוסיפה שורות חדשות באמצע משפטים, שוברת URLs ארוכים, ומשנה טוקניזציה. כל מספר בסקירה הזו חושב עם body_width = 0; עם ברירת המחדל, כולם היו שונים.
האם רישיון GPL הוא מגבלה אמיתית?
זה תלוי במודל האינטגרציה וההפצה המדויק. שימוש פנימי או דרך רשת והפצת תוכנה הם תרחישים שונים לבחינה, אבל המאמר הזה לא קובע את התוצאה המשפטית. צוותים שמפיצים תוכנה צריכים ייעוץ משפטי לגבי תנאי GPL-3.0-or-later; markdownify ו-turndown הם MIT. ביטוי הרישיון של html2text מאומת במטא-דאטה של PyPI, ב-GitHub, ובקובץ METADATA של החבילה המותקנת.
האם שחרור מאפריל 2025 הוא בעיה? כנראה שלא, בפני עצמו. המרת HTML לטקסט היא בעיה יציבה, הספרייה הותקנה ורצה בהצלחה על Python 3.14.2, ויש מאחוריה 41 שחרורים. 95 תקלות פתוחות הן המספר שהייתי בודק בפועל — עברו עליהן וחפשו משהו שדומה לקלט שלכם לפני שמתחייבים, כי מאגר שקט אומר שאולי אתם תהיו אלה שתתקנו אותו.
מה לא נבדק כאן?
ארבעה fixtures של המרה ועוד fixture מורכב אחד של טבלה עדיין מהווים סט קטן. הבדיקה כן כללה שנים-עשר מסמכים סינתטיים פגומים ועוד שני מסמכי בקרה: html2text זרק שגיאה ב-0/14, לא החזיר פלט ריק ב-0/14, ושיחזר את כל 33 הסנטינלים שנמדדו. היא לא כיסתה דפים שבורים אמיתיים מהעולם, דפוסים רחבים יותר של פגימות, רשימות מקוננות, definition lists, הערות שוליים או מתמטיקה. כל מרחב האפשרויות — ignore_links, ignore_images, unicode_snob, single_line_break וכל השאר — נשאר בברירות המחדל מלבד body_width. הפער בקישורים נצפה אך לא נותח, ולא בוצעה בדיקת round-tripping של Markdown.




