
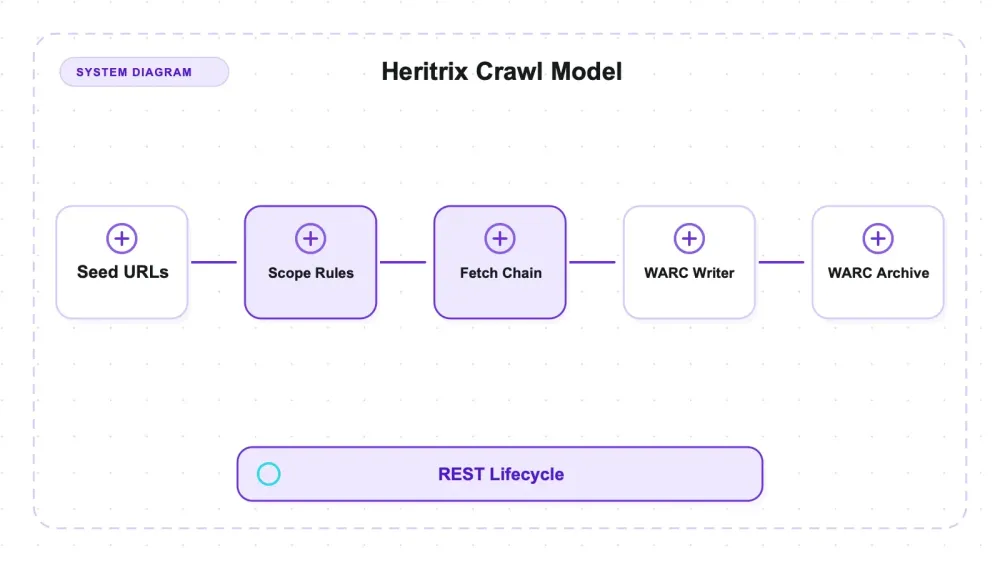
Heritrix הוא ה־crawler הארכיוני בקוד פתוח של Internet Archive — קו התוכנה שמאחורי ה‑Wayback Machine, שפועל כבר שני עשורים. התפקיד שלו הוא ללכוד בצורה מדויקת את מה שהאתר החזיר, אל תוך קובצי WARC שאפשר להשמיע מחדש שנים אחר כך. מתחת למכסה המנוע זהו מנוע Java שבו כל crawl בנוי כגרף של Spring beans שנכתב ב‑XML, וכל מחזור החיים של המשימה נשלט דרך REST API. זה לא scraper: אין תחביר של selectors, אין מיפוי שדות, ואין שורות בסוף.
בדקתי את גרסה 3.16.0 מול fixture מקומי מבוקר וספרתי מה באמת נכתב, רשומה אחר רשומה. מה שבולט כאן הוא השלמות: עשרים URI‑ים שנשלפו יצרו שישים ואחת רשומות WARC, עם payload digest ו‑capture IP בכל response, ועם כל request מקושר חזרה ל‑response שאליו הוא שייך — וכל זה בלי לגעת אפילו בהגדרת קונפיגורציה אחת. החוויה התפעולית היא בדיוק ההפך: 41 MB, 114 קבצי jar (ב־lib/ יש 142 קבצים; 28 נוספים הם קובצי LICENSE ו‑NOTICE מצורפים), וקובץ job config של כ‑750 שורות עוד לפני הבקשה הראשונה — אם כי כאן כל ה‑crawl‑ים רצו headless דרך curl, בלי אף לחיצה על ממשק אינטרנטי.
תוצאת האחסון חשפה ברירת מחדל פחות ברורה. שני URL‑ים ב‑fixture החזירו תוכן זהה לגמרי ברמת הבתים, והפרופיל הסטנדרטי שלף ושמר את שניהם במלואם: שתי רשומות response ואפס רשומות revisit, למרות ששני ה‑response‑ים קיבלו אותו payload digest. דה־דופליקציה לפי content-digest כן עובדת אחרי שמוסיפים את רכיבי היסטוריית העיבוד שלה; היא לא מופעלת בפרופיל ברירת המחדל, והיא חוסכת נפח אחסון ולא רוחב פס.
מה Heritrix באמת הוא
ארכוב הוא לא scraping, וזו בדיוק הבלבול הקטגורי שכדאי לנקות. Heritrix לא נותן לך שורות. אין CSV בסוף. הפלט שלו הוא שיחת ה‑HTTP עצמה — כותרות, גוף והמטא־דאטה של הלכידה — שמורים בפורמט שנועד לשימור, והוא מימוש הייחוס לקטגוריה הזו כולה. לבקש ממנו רשימת מחירי מוצרים זה כמו לבקש מסטנוגרף של בית משפט סיכום.
המספרים העדכניים ל‑27 ביולי 2026: המאגר עומד על 3,285 כוכבים עם 36 issues פתוחים, ו‑3.16.0 היא הגרסה האחרונה, שפורסמה ב‑2026-07-03. זו בדיוק הגרסה שבדקתי, כך ששום דבר כאן אינו תלונה על גרסה ישנה. לרישוי יש פרט קטן: קובץ ה‑LICENSE הוא Apache-2.0 פשוט, אבל המזהה של GitHub עצמו מציג "Other" משום שחלק מהקבצים החיצוניים המצורפים נושאים תנאים משלהם. אם Heritrix נכנס למוצר מסחרי, שווה להקדיש לזה חמש דקות של תשומת לב משפטית ולא להסתפק במבט על ה-badge שבצד.
עובדה מבנית אחת מעצבת את כל השאר: Heritrix לא מפעיל דפדפן. הוא מבצע fetch דרך HTTP ומחלץ קישורים מהבתים שחזרו. האח התאום שלו בארכוב מודרני, Browsertrix Crawler, עושה את ההפך — Chromium אמיתי, ומקליט את מה שהדפדפן באמת עשה. שניהם כותבים WARC, אבל הסקירה הזו מדדה רק את המסלול הלא־דפדפני של Heritrix; היא לא ביצעה benchmark של קנה מידה או throughput של אף אחת מהמערכות.
שרשראות, beans ו‑SURT: איך crawl באמת מורכב
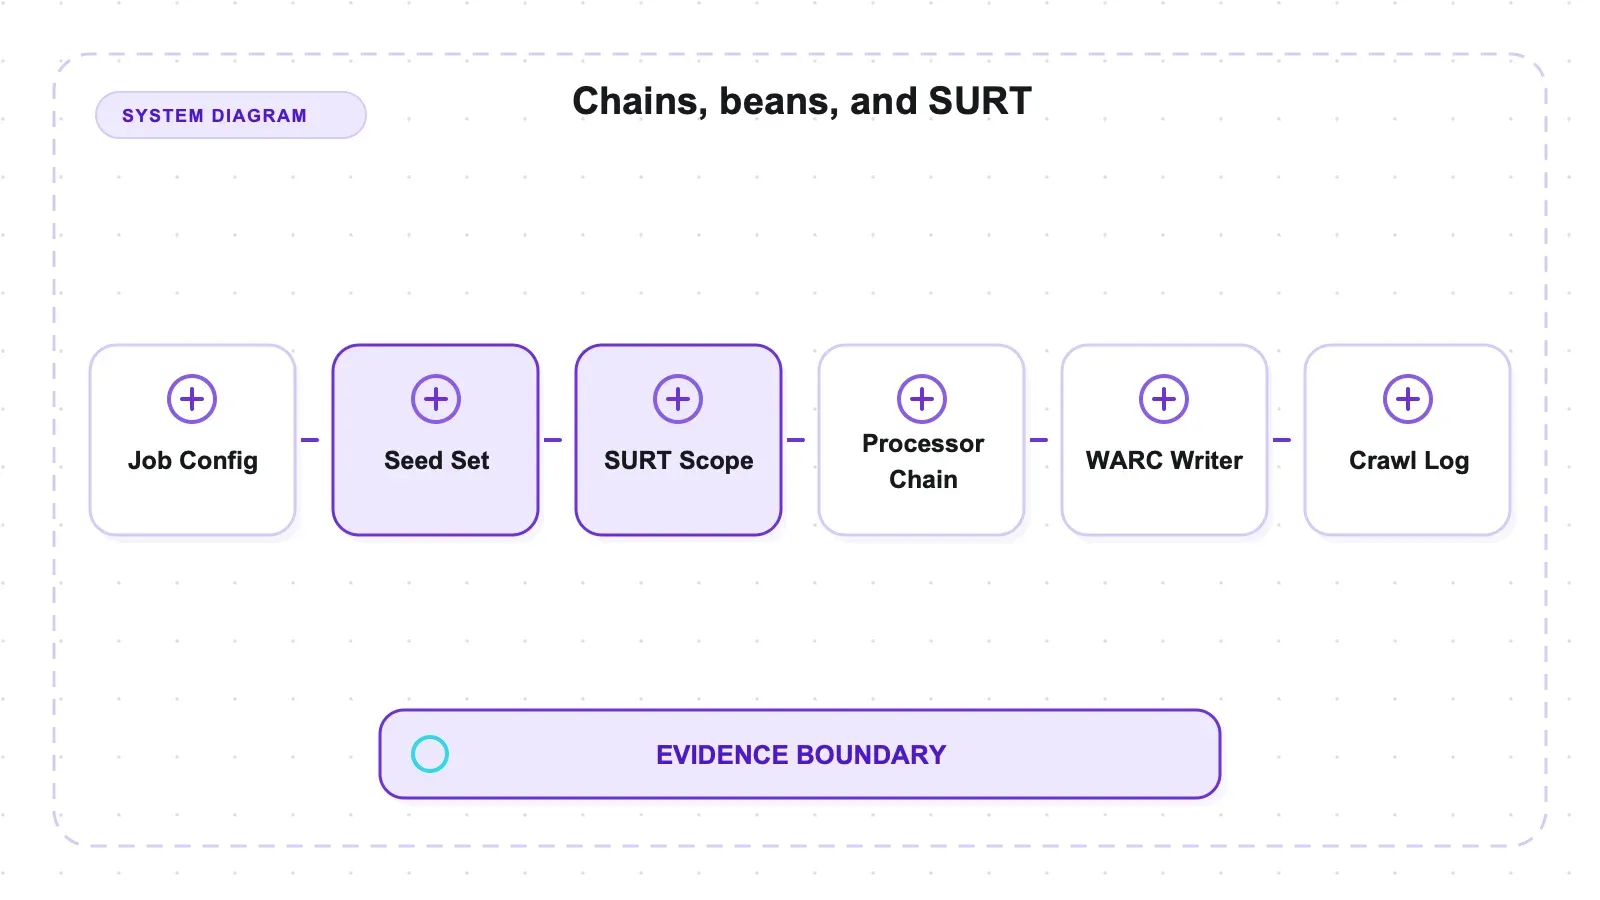
מתחת למכסה המנוע, Job של Heritrix הוא Spring application context. לא "מוגדר עם Spring" — הוא באמת גרף של Spring beans, כתוב ב‑XML, וכל חלק ב‑crawl הוא bean שאפשר להחליף.
The frontier מחזיק את תור ה‑URI‑ים, מחולק לפי host. החלוקה הזו היא הסיבה לכך שה‑politeness עובד כפי שהוא עובד, והיא חשובה בהמשך.
Processor chains עושים את העבודה בשלושה שלבים: candidate chain (האם ה‑URI שהתגלה צריך להישלח לתזמון?), fetch chain (DNS, robots, fetch ב‑HTTP, חילוץ קישורים), ו‑disposition chain (כתיבה ל‑WARC, עדכון מצב). הוספת יכולת ל‑Heritrix בדרך כלל אומרת להכניס processor bean במקום הנכון בשרשרת הנכונה — וזה בדיוק איך הפעלתי dedup.
Scope הוא stack של DecideRules שפועלים על SURT — Sort-friendly URI Reordering Transform, שממיר את http://www.example.com/a ל‑http://(com,example,www,)/a כך שתחיליות של hostname יסתדרו בהיררכיות. ה‑scope ברירת המחדל נוצר מה‑SURT prefixes של ה‑seed‑ים שלך. הכללים מקבלים או דוחים ברצף, וההתאמה האחרונה היא שקובעת.
WARC writer יושב ב‑disposition chain, ו‑politeness חי ב‑frontier כשלושה מספרים: delayFactor, minDelayMs, maxDelayMs. ציות ל‑robots הוא מחרוזת מדיניות ב‑fetcher.
וכל זה ניתן לשליטה דרך REST API, והדבר הזה התברר כמשמעותי הרבה יותר ממה שציפיתי.
ההתקנה היא החלק הכבד ביותר בכל החוויה
מה צריך לפרוס עוד לפני הבקשה הראשונה:
| ממד ההתקנה | Heritrix 3.16.0 |
|---|---|
| קובץ הפצה דחוס | בערך 41 MB |
קבצים ב‑lib/ אחרי חילוץ | 142 בסך הכול: 114 קבצי .jar ו‑28 קובצי LICENSE/NOTICE |
| מה מופעל עם ההפעלה | מנוע Java יחד עם Jetty web UI מובנה ב‑https://localhost:8443 מאחורי תעודה עצמית חתומה |
| זמן עד מוכנות ל‑REST, במכונה שלי | בערך עשר שניות |
קובץ job config סטנדרטי (crawler-beans.cxml) | בערך 750 שורות של XML מסוג Spring bean |
את רוב קובץ ה‑job config הזה לעולם לא תיגעו. אבל אי אפשר לדלג עליו, ושני שדות הם חובה לפני שה‑crawler יתחיל לשלוף משהו: ה‑seed שלך, ו‑metadata.operatorContactUrl. הערך הסטנדרטי הוא placeholder, והוא לא יתחיל crawl עד שתחליף אותו ב‑URL אמיתי שמזהה מי מריץ את הסריקה.
הדרישה הזו יוצרת נקודת אחריות: המפעיל חייב לספק URL ליצירת קשר לפני שה‑crawler רץ. זה לא מוכיח שהזהות מדויקת, שהסריקה מאושרת, או שהיא עומדת בכללים הרלוונטיים, אבל זה כן הופך את פרטי הקשר לחלק מה‑job ולא למוסכמה אופציונלית.
שתי תוצאות בהתקנה הפתיעו אותי באמת.
זה רץ על JDK חדש יותר מהמינימום בתיעוד. מסמכי ה‑Getting Started מבקשים Java 17 או יותר. Heritrix 3.16.0 עלה, שירת את REST API שלו, והשלים כל crawl ב‑fixture הזה על OpenJDK 26.0.1, בלי --add-opens, בלי --enable-preview, ובלי עקיפות ל‑Security Manager. זו תוצאה אחת על macOS arm64, לא מטריצת תאימות, אבל היא כן מאשרת שה-build שנבדק כאן לא הוגבל ל‑JDK 17 על המחשב הזה.
אתה אף פעם לא חייב לגעת בממשק האינטרנטי. מחזור החיים המלא של ה‑job הוא REST, ואוטומטתי את כולו עם curl: יצירת job, PUT לקובץ ה‑beans, בנייה, הפעלה, unpause, polling עד שמצב הבקר מציג FINISHED, סיום ופירוק. זו התשובה האמיתית לשאלה "האם אפשר להפעיל את Heritrix בתוך pipeline" — כן, headlessly, בלי שום לחיצה על הדפדפן. רוב הכתבות מציגות צילומי מסך של Jetty UI ורומזות שזה הממשק. זו נוחות, לא דרישה.
הערת פריסה ספציפית למכונה: ה‑Mac הזה מריץ proxy מערכת דרך Surge. לקוח ה‑Java של Heritrix ירש את ה‑proxy הזה ושלח אפילו תעבורת fixture של 127.0.0.1 דרכו, מה שיצר תגובות 503 למרות רשימת החריגים של מערכת ההפעלה ו‑NO_PROXY. הפעלה של ה‑JVM עם -Djava.net.useSystemProxies=false שינתה את הריצה מ‑2×503 ל‑18×200. זו הייתה אינטראקציה עם הסביבה, לא תקלה ב‑Heritrix; הדגל רלוונטי רק כשלא רוצים לרשת הגדרות proxy מערכתיות.
מה באמת נכנס לארכיון
הרצתי את פרופיל ברירת המחדל הסטנדרטי מול fixture מבוקר — שרת מקומי עם סט endpoints ידוע, כולל עמודי HTML, שרשרת עומק של שלוש רמות, robots.txt ו‑sitemap, וגם מסלולי 404 ו‑500 מכוונים — ואז ניתחתי את קובץ ה‑WARC שנוצר רשומה אחר רשומה במקום לסמוך על שורת סיכום.
עשרים URI‑ים שנשלפו יצרו שישים ואחת רשומות:
| סוג רשומת WARC | כמות | מה היא מכילה |
|---|---|---|
warcinfo | 1 | provenance ברמת ה‑crawl, נכתב פעם אחת לכל קובץ |
response | 20 | תגובת HTTP מלאה, כותרות וגוף |
request | 20 | הבקשה המדויקת ש‑Heritrix שלח |
metadata | 20 | ההערות הפנימיות של Heritrix על הלכידה |
יחס נקי של 1:1:1 בין response/request/metadata לכל URI, כברירת מחדל, בלי שום קונפיגורציה מצדי. וגם השלמות ברמת הרשומה החזיקה מעמד בבדיקה:
| בדיקה ברמת הרשומה | כמות | למה זה חשוב |
|---|---|---|
payload digest עם הקידומת sha1: על תגובות | 20/20 | — |
WARC-IP-Address על תגובות | 20/20 | ה‑IP שממנו התוכן באמת הגיע, וזה מסוג הדברים שאתה נואשות רוצה לדעת שנים אחר כך כשדומיין החליף ידיים |
רשומות request מקושרות ל‑response שלהן דרך WARC-Concurrent-To | 20/20 | לא "רובם מקושרים". כולם. |
וגם סטטוסי HTTP נשמרו מילה במילה, כולל המכוערים: 200 OK, 404 Not Found, ו‑500 Internal Server Error מופיעים בשורות סטטוס אמיתיות בתוך התגובות השמורות, במקום להיזרק ככישלונות.
הנקודה האחרונה הזו מפרידה בין ארכוב ל‑scraping בצורה חדה יותר מכל דבר אחר. scraper מתייחס ל‑500 כאל שגיאה שצריך לנסות שוב או לדלג עליה. ארכיבר מתייחס אליו כאל מה שהשרת אמר באותו רגע, וזו עובדה שכדאי לשמר. ה‑Heritrix Output wiki מתאר את מבנה הרשומות הזה; מה שלא ראיתי בשום מקום היה את הכמות שנמדדה ואת הקישוריות של 20/20 על סט endpoints ידוע. זה אכן מתקיים.
תוצאת הדה־דופליקציה, נמדדת בשתי הדרכים
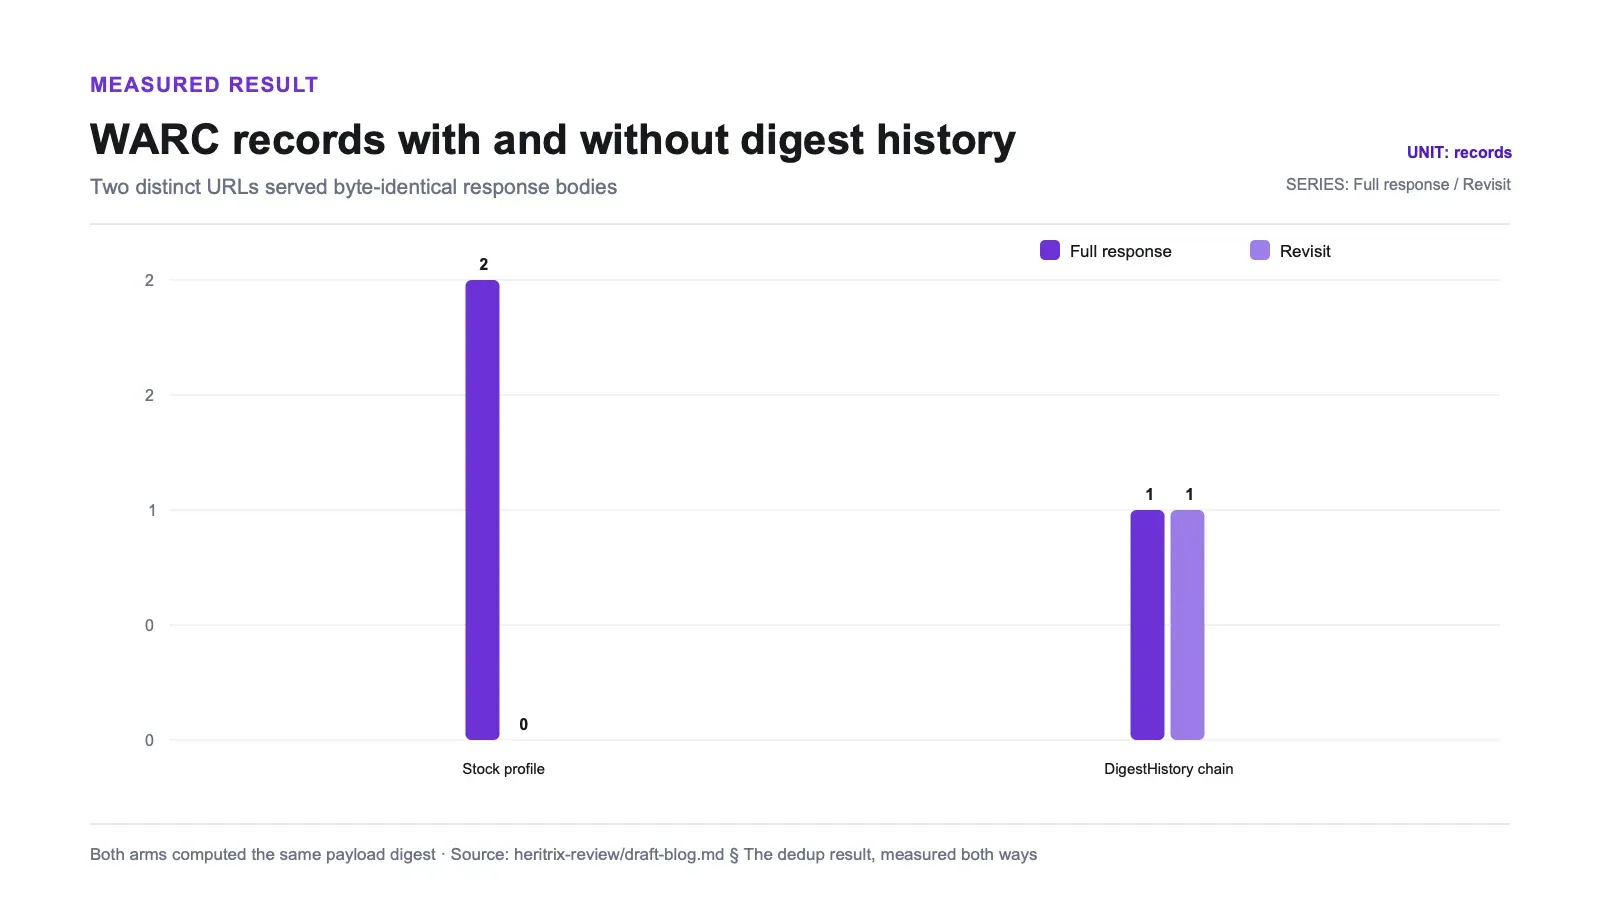
ה‑fixture שלי שירת את /dup/one ואת /dup/two עם bodies זהים ברמת הבתים. URL‑ים שונים, אותו תוכן — בדיוק המקרה ש‑content-digest dedup נועדה לאחד. הרצתי זאת פעמיים: פעם עם פרופיל ברירת המחדל, ופעם אחרי שהכנסתי את שרשרת digest-history (BdbContentDigestHistory, יחד עם ContentDigestHistoryLoader ב‑fetch chain ו‑ContentDigestHistoryStorer אחרי כותב ה‑WARC).
| פרופיל ברירת מחדל סטנדרטי | עם שרשרת ContentDigestHistory | |
|---|---|---|
רשומות response מלאות שנכתבו | 2 | 1 |
רשומות revisit שנכתבו | 0 | 1 |
| payload digest משותף | כן (בשניהם) | כן |
| פרופיל revisit | — | identical-payload-digest |
כברירת מחדל, שני ה‑response‑ים קיבלו אותו digest, אבל שום רכיב היסטוריה לא פעל עליו ושני ה‑payload‑ים נכתבו במלואם. הוספת השרשרת המירה את הלכידה השנייה לרשומת WARC מסוג revisit שמפנה אל ה‑payload digest הזהה, בדיוק ההתנהגות שה‑WARC 1.1 specification מגדיר עבור revisits.
שום דבר מזה אינו סוד. עמוד ה‑wiki של Duplication Reduction Processors אומר במפורש ש‑skipIdenticalDigests מוגדר כברירת מחדל ל‑false, ושדה־dupe אגנוסטי ל‑URL דורש את ה‑loader וה‑storer beans האלה. זו לא התנהגות מוסתרת שגיליתי; כמו כמעט כל דבר שנמדד כאן, זו התנהגות מתועדת של Heritrix עם מספר מהשטח. הפער הוא בין התיעוד לבין מה שאנשים חושבים, ובניסיון שלי ההנחה היא בדרך כלל "Heritrix עושה dedup", נקודה, בלי כוכבית על קונפיגורציה.
שתי מסקנות שכדאי להפנים:
Dedup הוא בזמן כתיבה, לא בזמן רוחב פס. זה כבר עניין של מנגנון יותר מאשר משהו שמדדתי בנפרד, אבל זה נובע ישירות מאופן הפעולה של content digests: אפשר להשוות digest רק אחרי שהבתים כבר הגיעו, ולכן ה‑URL השני עדיין יישלף מהמקור בכל מקרה. הפעלת השרשרת מפחיתה את מה ששומרים, לא את מה שמעבירים ולא את מה שהשרת יעד צריך להגיש. מי שמתקצב dedup כהישג של נימוס או חיסכון ברוחב פס מבין את זה הפוך.
אומדני אחסון שמבוססים על "זה יעשה dedup" יכולים להיות שגויים מאוד. אם אתם מארכבים אתר עם הרבה כפילויות תבנית — קובצי PDF ממותרים, דפי נחיתה גנריים, גרסאות print-view של אותם מאמרים — ותכננתם נפח דיסק בהנחה שגופים זהים יתאחדו, פרופיל ברירת המחדל עלול לצרוך הרבה יותר אחסון מההערכה הזו. ה‑fixture של שני ה‑URL‑ים קובע את התנהגות ברירת המחדל, לא את ההשפעה שלה בקנה מידה של מיליון URI‑ים; ההשפעה הזו תלויה בשיעור הכפילויות, בגודל ה‑payload ובתכנון ה‑recrawl.
Scope ו‑robots עשו בדיוק מה שהובטח
המילה של crawler על מה שהוא לא שלף שווה מעט מאוד, ולכן שניהם נמדדו עם מונה פניות בצד השרת — השרת היעד ספר את הבקשות בעצמו, בלי תלות במה ש‑Heritrix רשם.
| בקרה | תנאי | פניות בצד השרת ליעד | מה יומן ה‑crawl הראה |
|---|---|---|---|
| Scope | scope ברירת מחדל; הזרקתי seed לעמוד שמקשר ל‑host שני עם authority של SURT שונה | 0 | ה‑host מחוץ ל‑scope לא הופיע בכלל — כלומר הוא נדחה כבר בשלב הגילוי, לא נכנס לתור ואז נכשל |
| Robots | מדיניות obey ברירת מחדל; עמוד הבית קישר ל‑/robots-denied/secret, ש‑robots.txt של ה‑fixture אסר | 0 | נרשם כחסום (robots.txt עצמו כן נשלף) |
| Robots | בקרה: robotsPolicyName הוחלף ל‑ignore, והריצה חודשה | 1 | — |
Scope. במקביל, ה‑host שבתחום הסקירה נסרק כרגיל, כך שה‑scope היה ממושמע ולא שה‑crawl נשבר. שווה הסתייגות: כאן הרצתי רק את הזרוע של scope ברירת המחדל, לא בקרה חיובית עם scope מורחב, אז קראו זאת כאימות של התכנון המתועד ולא כהוכחה דו־צדדית.
Robots. הקישור תמיד היה נגיש; רק מדיניות ה‑robots דיכאה אותו. הציות אמיתי, וגם פתח המילוט אמיתי — וזה הסידור הנכון — כי יש מנדטים ארכיוניים שבהם באמת עוקפים robots, וזה צריך לדרוש הקלדה מכוונת של ignore לתוך קובץ הקונפיגורציה.
Politeness: 57.7 שניות כדי לסרוק עשרים עמודים מקומיים
יש מספר אחד שקובע אם Heritrix מתאים לפרויקט שלך.
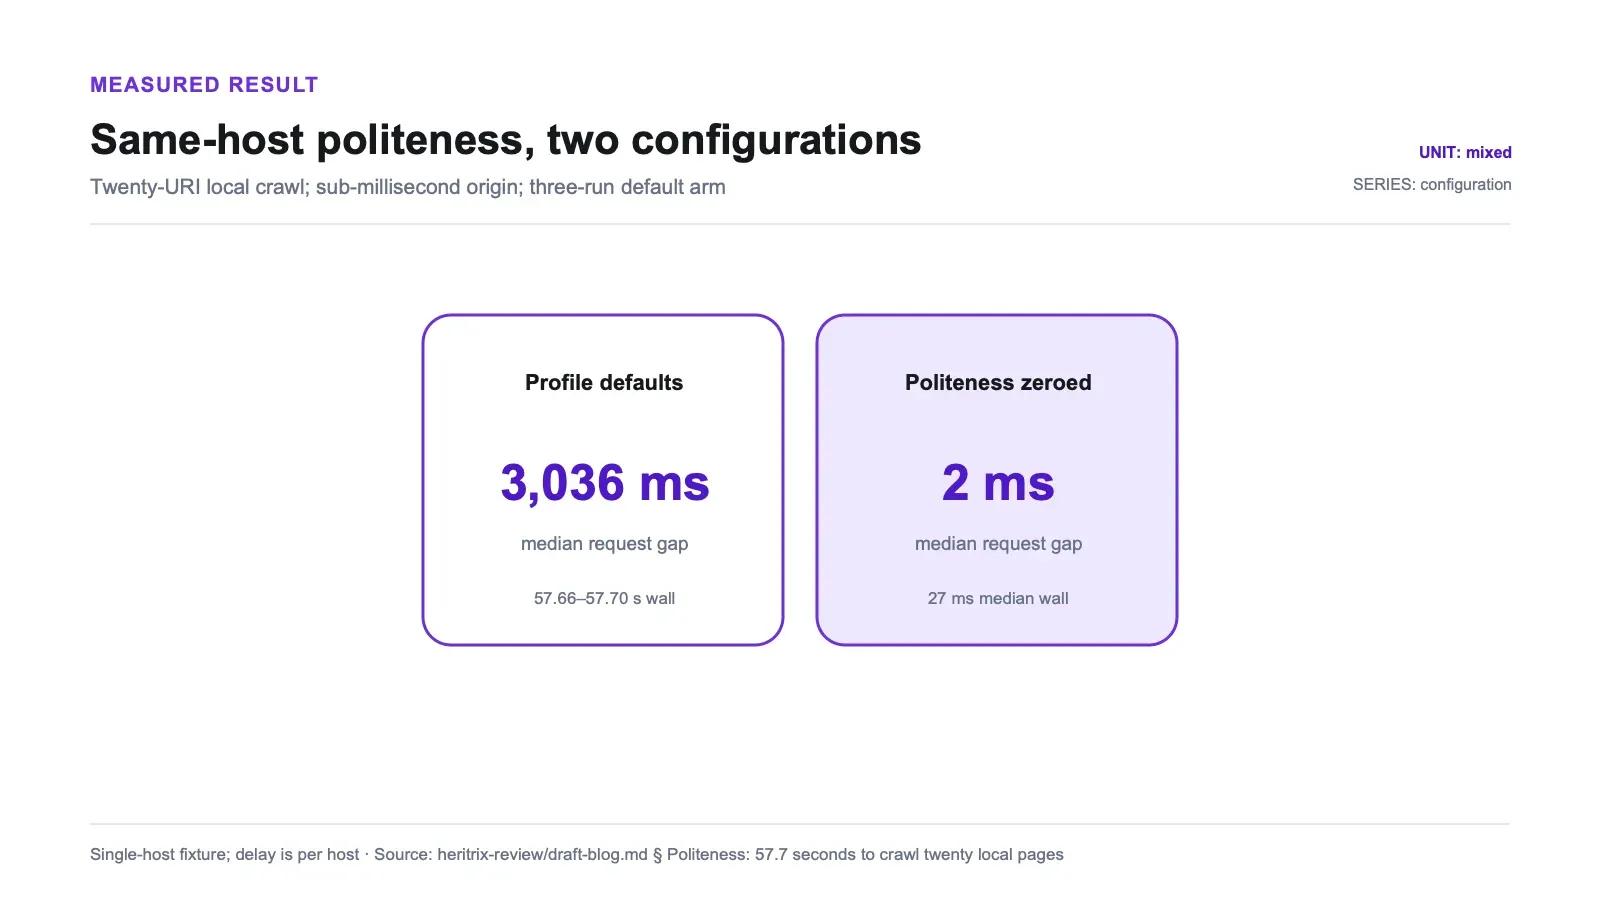
אותו fixture, אותו טיפול של שלוש ריצות, על host מקומי יחיד עם השהיית רשת של פחות ממילישנייה:
| הגדרת Politeness | פער חציוני בין בקשות לאותו host | זמן כולל של crawl מלא עם 20 URI‑ים |
|---|---|---|
ברירות המחדל של הפרופיל (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3,036 ms (מינימום 3,021, מקסימום 9,107, על פני 48 פערים שנמדדו) | 57.66 s / 57.66 s / 57.70 s (שלוש הריצות) |
| פולייטנס מאופס | 2 ms | 27 ms (חציוני) |
השהיה בפועל יושבת בדיוק על רצפת minDelayMs: על מקור עם פחות ממילישנייה, delayFactor × fetch-time זניח, והמינימום שולט לפי התכנון. היחס בין שתי השורות לא ממש שימושי כי המכנה של פולייטנס אפס הוא רק עשרות מילישניות ויש בו תנודות מריצה לריצה. התוצאה היציבה היא הרצפה האבסולוטית: Heritrix ברירת המחדל חיכה בערך שלוש שניות בין בקשות לאותו host ב‑fixture הזה, והפך crawl של עשרים עמודים לדקה בערך של זמן אמת.
דרך מוחשית להרגיש את זה. נניח שספרייה אוניברסיטאית צריכה לארכב אתר ממשלתי של 50,000 עמודים לפני שהוא מפורק, וכולו יושב על host אחד. ברצפת 3 שניות ל‑host, זה 150,000 שניות של המתנה כפויה — בערך 42 שעות, או יום ועוד שלושה רבעים, עוד לפני שסופרים את זמן ה‑fetch. זה חישוב מתוך הרצפה שנמדדה אצלי של 3,036 ms — 50,000 x 3.036 שניות = 151,800 שניות = 42.2 שעות; גם ב‑3,000 ms המוגדרים זה 41.7 שעות, מה שמעוגל ל‑42 ולא ל‑41. לא crawl שנמדד, אבל זה החשבון שתוכנית הפרויקט שלכם צריכה.
למען ההגינות, ה‑politeness של Heritrix הוא לפי host, כי ה‑frontier מחלק תורים לפי host. crawl רחב על פני אלפי דומיינים מקבילי על פני התורים האלה ואינו יורש את התקרה הזו באופן גלובלי. ה‑fixture שלי היה host יחיד, וזה המקרה הגרוע ביותר עבור המספר הזה. אם יעד הארכוב שלכם הוא אתר גדול אחד, המקרה הגרוע הזה הוא המקרה שלכם.
וזו תכונה. ההשהיה היא מה שהופך crawler ארכיוני למשהו שבעל אתר מוכן לסבול במקום לחסום. כיווץ שלה הוא החלטה לגבי השרת של מישהו אחר, והכלי הופך את ההחלטה הזו למפורשת במקום להיות אגרסיבי כברירת מחדל.
מה לא בדקתי
המדידות האלה מכסות משמעת crawl על fixture מבוקר, ולא מעבר לכך. מחוץ לגבול הזה:
- דה־דופליקציה בין crawls ו‑recrawl. מדדתי רק content-digest dedup בתוך אותו crawl. שמירה של מסד נתוני היסטוריית URI בין crawls נפרדים (
FetchHistoryProcessor+PersistLog) היא מנגנון אחר ולא הפעלתי אותו. - קנה מידה ויציבות לאורך זמן. אין frontier של מיליון URI‑ים, אין checkpoint-and-restore, ואין ריצה של כמה ימים. ה‑fixture שלי מודד משמעת, לא סיבולת.
- לכידה עם JavaScript. ברירת המחדל של Heritrix היא ללא דפדפן, וזה מה שמדדתי. ההתנהגויות האופציונליות מבוססות הדפדפן לא נבדקו כאן.
- Politeness מול מקור עם השהיה גבוהה. ההשהיה המקומית היא פחות ממילישנייה, ולכן
minDelayMsשלט לפי התכנון. איךdelayFactorמתנהג מול שרת אמיתי ואיטי לא מבודד בנתונים שלי. - דיוק של sitemap. robots.txt כן נשלף והנחיית ה‑sitemap כן נעקבה, אבל לא בדקתי בנפרד שכל רשומת
<loc>אכן נמצאה.
מה כדאי להבהיר לפני job ראשון בפרודקשן
הפרופיל הסטנדרטי ארוך, אבל ההחלטות שמשנות את משמעות הארכיון הן יחסית מצומצמות. מתחילים ב‑scope. Seeds מייצרים כברירת מחדל prefixes של SURT, ו‑DecideRules יכולים להרחיב או לצמצם אותם ברצף. עברו על סדר הכללים הסופי עם URL‑ים מייצגים מתוך ה‑scope ומחוצה לו, ואז אמתו אותו מול תעבורה בצד השרת או לוג בקשות עצמאי אחר. דוח crawl לבדו לא יכול להוכיח ש‑host מודר לא הוזמן בכלל.
אחר כך מחליטים מה המשמעות של מדיניות robots ושל זהות המפעיל עבור האוסף. ברירת המחדל שנבדקה צייתה לכלל ה‑disallow של ה‑fixture, בעוד שינוי robotsPolicyName ל‑ignore גרם לנתיב החסום להישלף. המעבר הזה פשוט מבחינה מכנית ומשמעותי מבחינה מוסדית. תעדו מי אישר אותו ולמה, יחד עם operatorContactUrl תקין; ה‑URL הנדרש נותן לבעל האתר נתיב חזרה למפעיל, אבל לא מספק את נימוק הסמכות.
תכנון אחסון צריך החלטה מפורשת משלו. אם גופים זהים אמורים להפוך לרשומות revisit, הוסיפו ובחנו את רכיבי היסטוריית ה‑content-digest לפני שמגדירים את גודל הארכיון. השרשרת שנבדקה השפיעה על הייצוג אחרי השליפה, ולכן עדיין צריך לתקצב תעבורת מקור עבור שני ה‑URL‑ים. דה־דופליקציה בין crawls היא מנגנון נפרד, ואין להסיק אותה מתוצאה זו של שני URL‑ים ו‑crawl אחד. crawl אימות קטן עם גופים כפולים ידועים הוא דרך זולה לבדוק שה‑bean graph שנפרס מייצר את סוגי הרשומות הרצויים.
לבסוף, התייחסו ל‑politeness כאל קלט לתזמון ולא ככפתור כיוונון של הרגע האחרון. ב‑fixture המקומי של host יחיד, minDelayMs שלט בזמן הכולל. פרויקט אמיתי צריך לחשב את רצפת ההשהיה המוגדרת לכל host מול מספר ה‑host‑ים היעד והדדליין של האיסוף, ואז לבדוק על השהיה מייצגת. crawls רחבים ו‑site יחיד מעמיסים אחרת על ה‑frontier המחולק לפי host; הסקירה הזו מדדה רק את האחרון. שמרו גם את מחזור החיים של REST ב‑runbook: build, launch, unpause, poll, terminate ו‑teardown הם מצבים נפרדים שכדאי לעקוב אחריהם באוטומציה.
יתרונות וחסרונות
יתרונות
- שלמות הארכוב מצוינת כברירת מחדל: 20/20 responses עם payload digest, capture IP, וקישור מלא request↔response, בלי שום קונפיגורציה.
- שומר תגובות שגיאה כעובדות — שורות סטטוס של 200, 404 ו‑500 נשמרות מילה במילה.
- משמעת scope אומתה מול מונה בצד השרת: אפס שליפות מחוץ ל‑scope בזמן שה‑host שבתחום נסרק כרגיל.
- ציות ל‑robots אכן מדכא את השליפה, עם פתח מילוט מכוון
ignoreכשיש מנדט ארכיוני. - Headless מלא דרך REST — יצירה, בנייה, הפעלה, polling ופירוק, הכול דרך
curl, בלי לחיצה על UI. - רץ נקי על OpenJDK 26.0.1 בלי דגלי JVM, שזה היגיינת Java מודרנית טובה יותר ממה שרוב בסיסי הקוד בני העשרים מצליחים להציג.
operatorContactUrlחובה פירושו שה‑crawler לא יכול לרוץ באופן אנונימי.- כל חלק ב‑crawl הוא bean שניתן להחלפה, ולכן הפעלת dedup הייתה עניין של הוספת שלושה beans ולא fork.
חסרונות
- Content-digest dedup כבוי כברירת מחדל וכותב payload‑ים זהים במלואם — מלכודת אמיתית בתכנון אחסון.
- הפריסה כבדה: הפצה של 41 MB, 114 jars, מנוע Java יחד עם Jetty, וקובץ Spring job config של כ‑750 שורות.
- ה‑politeness ברירת המחדל מטיל רצפה של כ‑3 שניות לכל host; crawl של 20 URI‑ים על host יחיד לקח 57.7 שניות.
- אין רינדור JavaScript בנתיב ברירת המחדל, כך שתוכן שרץ רק בצד הלקוח לא יילכד.
- משטח הקונפיגורציה מתגמל מומחיות ומעניש שימוש מזדמן; אין מסלול של חמש דקות ל‑crawl ראשון.
- שום דבר בפלט אינו נתונים מובנים. הוצאת שדות מתוך WARC היא פרויקט נפרד.
מי צריך להפעיל אותו, ומי עדיף שיוותר
Heritrix מיועד למוסדות ולקבוצות שהמוצר שלהן הוא הארכיון עצמו. ספריות, ארכיונים לאומיים, שימור לצורכי משפט וציות, קבוצות מחקר שמצלמות את ה‑web כמקור ראשי, כל מי שצריך להוכיח בעוד חמש שנים מה הוצג בכתובת URL ביום מסוים. אם המילים "WARC", "replay" ו‑"provenance" כבר נמצאות באוצר המילים שלכם, זה הכלי שסביבו נבנה שאר האקוסיסטם שלכם, והמשקל שלו הוא המחיר של אותה אינטרופרביליות.
ה‑frontier המחולק לפי host והשימוש הארוך שלו בארכוב רשת הופכים אותו למועמד סביר ל‑crawls רחבים על פני דומיינים רבים. זו מסקנה ארכיטקטונית והיסטוריית פרויקט, לא תוצאה של קנה מידה מה‑fixture הזה; throughput לאורך זמן, שחזור checkpoint, והתנהגות של מיליון URI‑ים נשארו כאן לא נבדקים.
דילגו עליו אם אתם רוצים נתונים ולא ארכיון. אם המטרה היא גיליון של מוצרים, רשימות או אנשי קשר, Heritrix יעשה עבודה מושלמת בללכוד עמודים, ורק אחר כך תצטרכו לבנות pipeline נפרד כדי לנתח אותם — ובדרך תשלמו על מנוע Java, קובץ Spring, ורצפת politeness של 3 שניות. דלגו עליו גם אם היעדים שלכם הם יישומי SPA שמרונדרים בצד הלקוח, שבהם fetcher שאינו דפדפן לוכד רק את השלד ולא את התוכן; שם archiver מבוסס דפדפן הוא הכלי הנכון. ודלגו עליו אם אתם צריכים תוצאה ראשונה כבר היום, כי עקומת ההתקנה אמיתית.
חלופות, ואיפה API מנוהל נכנס לתמונה
בתוך עולם הארכוב, המקבילה המודרנית הישירה היא Browsertrix Crawler — ארכיבר מבוסס דפדפן שמפעיל Chromium ומקליט את מה שהדפדפן עשה. הוא יכול ללכוד תוכן שנוצר ב‑JavaScript ונעדר מתגובות ה‑HTTP הסטנדרטיות של Heritrix, אבל מוסיף overhead של פריסת דפדפן וזמן ריצה. הסקירה הזו לא ביצעה benchmark ראש בראש, כך שההחלטה מתחילה בדרישות הלכידה: מצב שנוצר על ידי דפדפן מצביע לארכיבר מבוסס דפדפן; משאבי HTTP רגילים נשארים הנתיב הטבעי של Heritrix.
סקירה קשורה: סקירת Browsertrix Crawler.
לבעיה מסוג אחר לגמרי — אתם לא רוצים ארכיון, אתם רוצים נתונים מובנים מתוך עמודים — כדאי להשוות את Heritrix למערכות extraction לפי הפלט ולא להתייחס אליהן כאל crawlers שקולים. Heritrix הוא חינמי ומאוחסן אצלכם: אתם מריצים את ה‑JVM, מחזיקים את קובץ ה‑beans, מגדירים את נפח הדיסקים ומכוונים politeness. המודל הזה מתאים כשהתוצר הוא שימור.
גילוי נאות: Thunderbit הוא המוצר של המפרסם ולא נבדק ב‑fixture הזה של Heritrix. הוא שייך לקטגוריית extraction מנוהל: הפלט שלו הוא תוכן עמודים או רשומות מובנות, ולא קובצי WARC ברמת שימור. בחרו בארכיבר כשנדרשת לכידה ניתנת להשמעה מחדש ו‑provenance; שקלו שירות extraction כשהתוצר הוא שורות או טקסט עמוד, והפעלה מנוהלת מתאימה לכם.
לארכוב יש גם שאלת הרשאה משלו, והיא לא אותה שאלה כמו ב‑scraping. Heritrix מציית ל‑robots.txt כברירת מחדל ומחייב אתכם להזדהות לפני שהוא שולף בייט אחד, וזה בסיס טוב — אבל crawl שמכבד robots לא הופך אוטומטית למורשה. זכויות יוצרים, תנאי שימוש, מידע אישי והסמכות של המוסד שלכם יושבים מעל זה, ו‑ignore קיים עבור ארגונים שיש להם בסיס משפטי להשתמש בו, לא כמתג נוחות. אם אתם מקימים תוכנית ארכוב, סגרו את היקף ההרשאה לפני שהדיסקים יתמלאו, וקראו על הצד המשפטי של web scraping וארכוב אם זה שטח חדש בשבילכם.
נסו את Thunderbit לחילוץ נתוני אינטרנט
פסק הדין
האם כדאי להשתמש ב‑Heritrix? כן — אם התוצר שלכם הוא ארכיון ויש אצלכם מישהו שמוכן ללמוד Spring beans.
ה‑fixture תומך בהחלטה ברורה: פרופיל ברירת המחדל שמר בצורה עקבית על response, request ומטא־דאטת הלכידה; בקרות scope ו‑robots השפיעו על שליפות בצד השרת כפי שהוגדר; וכל מחזור החיים של ה‑job רץ דרך REST. אלו תכונות שימושיות לצינור ארכיוני, בתוך הגבול הקטן של host יחיד שנבדק כאן.
העלויות התפעוליות ברורות באותה מידה: הפצה מבוססת Java ותצורת Spring גדולה, השהיה מוגדרת לכל host ששלטה בריצה המקומית הזו, ו‑content-digest dedup שדורש רכיבי היסטוריה נוספים. צוותים שצריכים נאמנות ל‑WARC עשויים לקבל את העלויות האלה; צוותים שצריכים שדות מחולצים צריכים להתחיל בקטגוריה אחרת.
לפני crawl בפרודקשן, בדקו את שרשרת ה‑dedup, הגדרות ה‑politeness, ה‑scope, מדיניות ה‑robots, זהות המפעיל והנחות האחסון מול קונפיגורציית ה‑job בפועל. פרופיל ברירת המחדל הוא נקודת התחלה, לא הצהרה משתמעת על הבחירות התפעוליות האלה.
נסו את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם operatorContactUrl הופך crawl למורשה?
לא. הוא מחייב את ה‑job לכלול URL ליצירת קשר, מה שנותן למפעילי האתר נתיב לאחריות, אבל הוא לא קובע אישור, דיוק זהות, סטטוס זכויות יוצרים או עמידה ברגולציה. אלה נשארים החלטות פריסה מחוץ ל‑crawler.
האם content-digest deduplication מפחית בקשות למקור? לא בקונפיגורציה שנבדקה כאן. שני ה‑URL‑ים נשלפו לפני שאפשר היה להשוות את ה‑payload digest שלהם. שרשרת ההיסטוריה שינתה את אופן הייצוג של ה‑payload השני באחסון WARC; היא לא הפכה את ה‑URL השני לבקשת רשת מדולגת.
האם Heritrix יכול לרוץ בלי ממשק אינטרנטי?
כן. מחזור החיים שנבדק — יצירה, העלאת קונפיגורציה, בנייה, הפעלה, unpause, polling, סיום ופירוק — רץ דרך REST API עם curl. ה‑Jetty UI המובנה לא היה נחוץ.
האם פרופיל ברירת המחדל של Heritrix מבצע דה־דופליקציה לתכנים זהים? לא ב‑fixture כפי שהוגדר. פרופיל ברירת המחדל שמר את שתי התגובות הזהות כרשומות response מלאות. הוספת שרשרת ה‑content-digest history שינתה את הלכידה השנייה לרשומת revisit, כך שדה־דופליקציה היא החלטת pipeline שצריך להגדיר ולאמת, לא ברירת מחדל אוטומטית.
איך כדאי לבחור השהיית politeness? התייחסו לזמני הריצה המקומיים כאן כאל בדיקת מנגנון, לא כהמלצה לפרודקשן. קבעו את ההשהיה לפי כללי האתר היעד, הסכמה עם המפעיל, קיבולת השרת, מטרת הסריקה ומדיניות הניסיונות החוזרים/המקביליות שלכם, ואז ודאו בפועל את הפערים בין בקשות לאותו host בלוגים.




