
תשובה קצרה: GDPR לא אוסר על Web Scraping. אבל כש-Scraper אוסף, שומר, מארגן או עושה שימוש חוזר במידע על אנשים שניתן לזהות, הוא מעבד מידע אישי. העובדה שהמידע “היה ציבורי” אינה אסטרטגיית תאימות.
ההבחנה הזו קשה במיוחד להתעלם ממנה כיום. ביולי 2026, מועצת הגנת המידע האירופית (EDPB) אמרה ש-GDPR חל על Scraping כאשר הוא כולל פעולות של עיבוד מידע אישי, והדגישה שמטרת השימוש ושקיפות הן נקודות מפתח. ההנחיות החדשות שלה בנושא Web Scraping עדיין פתוחות להערות ציבור, אבל הכיוון ברור: הפעולה הטכנית של איסוף עמוד היא רק תחילתה של שאלת התאימות. עדכון EDPB
המדריך הזה הוא מסגרת עבודה מעשית, לא ייעוץ משפטי. השתמשו בו כדי לקבל החלטות טובות יותר במוצר ובהנדסה, ואז מערבו יועץ פרטיות או DPO במקרים שיש בהם סיכון ממשי.
קודם כל: להבדיל בין “מותר לסרוק” לבין “מותר להשתמש”
לעיתים קרובות מערבבים יחד שלוש שאלות שונות:
| שאלה | מה היא בודקת |
|---|---|
| גישה | האם יש לכם הרשאה לגשת לאתר ולאסוף את התוכן? |
| הגנת מידע | אם ניתן לזהות אנשים, האם מותר לעבד את המידע לפי GDPR? |
| שימוש חוזר | האם אפשר לשמור, להעשיר, למכור, לאמן מודל, לפרסם או ליצור קשר עם אנשים באמצעותו? |
להצליח באחד המבחנים לא אומר שעוברים את האחרים. עמוד יכול להיות גלוי לציבור, אבל המידע שבו עדיין יכול להיחשב מידע אישי. גם Crawl שעובד טכנית בהצלחה עדיין עלול ליצור בעיות של GDPR, חוזים, קניין רוחני, זכות במאגרי מידע, הגנת צרכן או דיני שיווק.
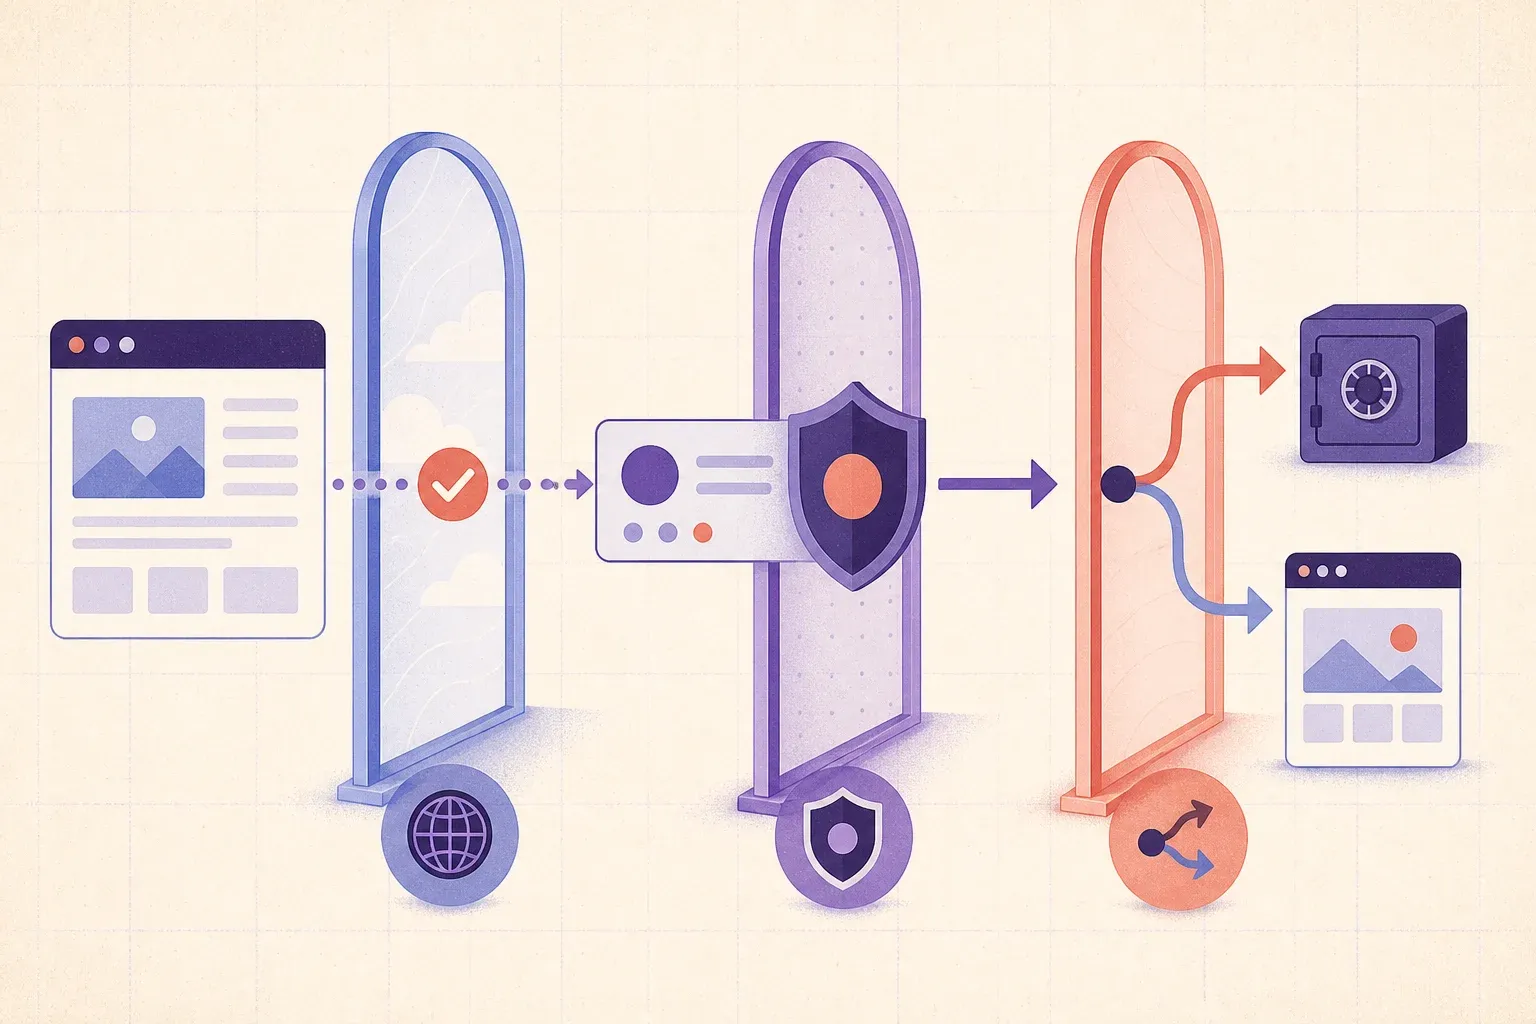
לכן צריך להתייחס לתאימות כאל תהליך עבודה עוד לפני שמתחילים, ולא כאל פסקה במדיניות פרטיות שמוסיפים בדיעבד.
1. קבעו האם GDPR בכלל חל
התחילו משתי שאלות.
האם מערך הנתונים כולל מידע אישי?
מידע אישי רחב הרבה יותר משם או כתובת אימייל. הוא כולל מידע על אדם מזוהה או ניתן לזיהוי, כמו תמונת פרופיל, שם משתמש שניתן לקשר לאדם, מיקום, כתובת IP, היסטוריה מקצועית, ביקורות, או שילוב של שדות שבנפרד נראים תמימים. הגדרת EDPB
נתונים ברמת חברה יכולים להיות לא בעייתיים במקרים מסוימים. אבל רשומת “איש קשר עסקי” יכולה להפוך במהירות למידע אישי כשהיא כוללת עוסק מורשה יחיד בשמו, אימייל ישיר של עובד, מספר נייד או פרופיל מקושר. תכננו לפי מערך הנתונים הריאלי, לא לפי הגרסה האידיאלית שלו.
האם GDPR חל על הארגון ועל המטרה שלכם?
GDPR יכול לחול כאשר העיבוד קשור למוסד או פעילות בתוך האיחוד האירופי. הוא יכול לחול גם על ארגון מחוץ לאיחוד אם הוא מציע סחורות או שירותים לאנשים באיחוד או עוקב אחר ההתנהגות שלהם. סקירה של הנציבות האירופית
אם שתי התשובות הן כן, הניחו שה-Scrape דורש מסלול GDPR מתועד. אם התשובה לא ברורה, אל תתייחסו לאי-הוודאות כאור ירוק — העבירו את הנושא הלאה.
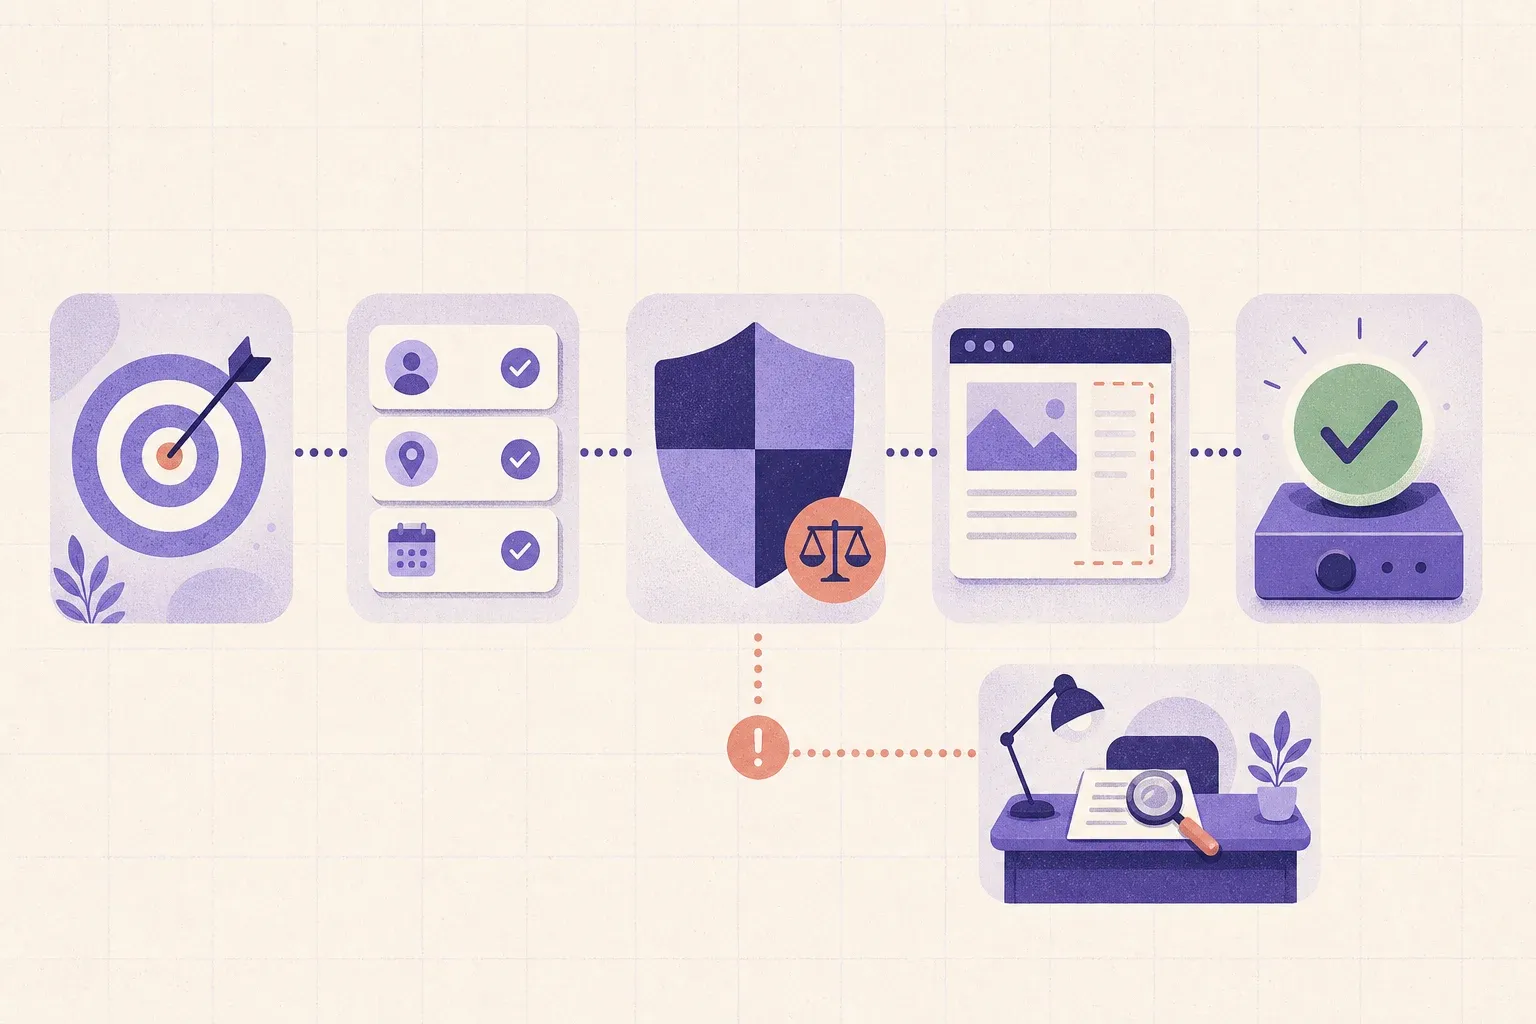
2. כתבו מסמך איסוף בן עמוד אחד לפני שה-Crawler רץ
אמצעי הבקרה הפשוט ביותר הוא גם בעל הערך הגבוה ביותר: הגדירו מה אתם צריכים לפני תחילת האיסוף.
המסמך צריך לענות על:
- מטרה: איזו החלטה, שירות או ניתוח דורשים את המידע הזה?
- אנשים ושדות: אילו קבוצות של אנשים עלולות להופיע, ואילו שדות בדיוק נחוצים?
- מקור וגישה: האם התוכן נגיש בחינם? האם המקור מתנגד לשימוש באמצעות תנאים, בקרות robots, חסימות כניסה או אמצעים טכניים אחרים?
- שימוש ונמענים: מי יראה את התוצאות? האם יעשו העשרה, ייצוא, שיתוף, שימוש לשיווק ישיר או לאימון מודל?
- שימור: מתי יימחקו או ייבדקו שוב הנתונים הגולמיים, קבצי העבודה והרשומות הנגזרות?
- בעלות: מי ה-controller, מי ה-processor, ומי מטפל בבקשות של נושאי מידע?
זו לא בירוקרטיה לשם בירוקרטיה. עקרונות ה-GDPR דורשים מטרה מוגדרת, וכן נתונים הולמים, רלוונטיים ומוגבלים למה שנחוץ. עקרונות הנציבות האירופית
3. בחרו ותעדו בסיס חוקי — אל תניחו שהוא קיים
כל פעילות של עיבוד מידע אישי זקוקה לבסיס חוקי. הסכמה עשויה להתאים לחלק מהמוצרים, אבל היא לא ברירת המחדל כשמדובר בנתוני Web ציבוריים. עבור חלק מהארגונים הפרטיים, אינטרס לגיטימי יכול להיות בסיס אפשרי ל-Scraping מוגבל ומצומצם, בתנאי שיש אמצעי הגנה אמיתיים. זה לא אוטומטי.
הערכה סבירה של אינטרס לגיטימי בוחנת שלוש שאלות:
- האם האינטרס חוקי, ספציפי, ממשי ועכשווי?
- האם האיסוף הזה הכרחי למטרה, או שיש דרך פחות פולשנית להשיג אותה?
- האם האינטרסים, הזכויות או הציפיות הסבירות של האדם גוברים על האינטרס שלכם?
ה-CNIL אומרת שנתונים זמינים לציבור שנאספו באמצעות Scraping נבחנים בדרך כלל דרך עדשת האינטרס הלגיטימי, אך נדרשים צעדים נוספים כדי להפחית את ההשפעה על אנשים. היא גם מדגישה ניתוח לפי מקרה, ולא אישור גורף. הנחיות CNIL
תעדו את הניתוח, ההנחות שלו וההקלות שבחרתם. “הפרופיל היה ציבורי” הוא הקשר לבדיקת האיזון — לא הבדיקה עצמה.
4. הפכו צמצום נתונים לדרישה טכנית
הרשומה התואמת ביותר לעיתים קרובות היא זו שה-Scraper שלכם לא אסף מלכתחילה.
בנו את מנגנוני ההגנה הבאים בתוך עבודת האיסוף:
- רשימת שדות מותרים. הגדירו מראש אילו שדות נדרשים; אל תגרדו כל שדה גלוי רק כי זה קל.
- חסימת קטגוריות רגישות. הוציאו מהאיסוף נתוני בריאות, פוליטיקה, דת, איגודים, חיי מין, נתונים ביומטריים וסימנים אחרים מקטגוריות מיוחדות, אלא אם יועץ משפטי תכנן מסלול חוקי ייעודי. טקסט רגיל יכול לחשוף קטגוריות כאלה באופן לא צפוי.
- החרגת מקורות בסיכון גבוה. תחזקו רשימת החרגה ברירת מחדל לקבוצות תמיכה, פורומים בריאותיים, מרחבים של קטינים והקשרים אחרים שבהם שימוש חוזר עלול להיות מפתיע או מזיק.
- מחיקת עודפים במהירות. אם נקלט מידע אישי לא רלוונטי, יש לבודד ולמחוק אותו ולא לשמור אותו בשקט “למקרה שצריך”.
- תיעוד מקוריות. שמרו עם כל מערך נתונים את כתובת המקור, תאריך האיסוף ותצורת האיסוף הרלוונטית. זה תומך בדיוק, במחיקה ובטיפול בזכויות.
ה-CNIL ממליצה במפורש להחליט מראש על הקטגוריות הרלוונטיות, לסנן מידע מיותר או רגיש, למחוק מידע לא רלוונטי ולכבד התנגדות טכנית או משפטית לאיסוף. אמצעי הגנה של CNIL
5. התייחסו לשקיפות כחלק מהמוצר
נתונים שנאספים מאתר נאספים לרוב בעקיפין. כלומר, ייתכן שחלות חובות השקיפות של סעיף 14: להסביר מי אתם, מהי המטרה, אילו קטגוריות ומקורות נתונים יש, מה הבסיס החוקי, תקופות שימור, נמענים, העברות, וזכויות האנשים.
לפי הסיכום של הנציבות האירופית, כאשר המידע מתקבל ממקור אחר, יש למסור את ההודעה בדרך כלל בתוך חודש, בפנייה הראשונה, או בעת הגילוי הראשון — לפי מה שרלוונטי. יש חריגים, כולל מקרים שבהם הודעה אינה אפשרית או שתצריך מאמץ לא מידתי, אבל הם מותנים ויש לבחון ולתעד אותם במקום להניח שהם חלים. חובות הנציבות האירופית
באיסופים רחבים, הודעה ציבורית ברורה, עמוד נתונים, ערוץ יצירת קשר ייעודי והנחיות קלות לאיתור להתנגדות, גישה, תיקון ומחיקה יכולים להיות משמעותיים יותר מדף משפטי נסתר. הפורמט הנכון תלוי בעיבוד ובסיכון.
6. בנו תהליך מחיקה וזכויות לפני ההשקה
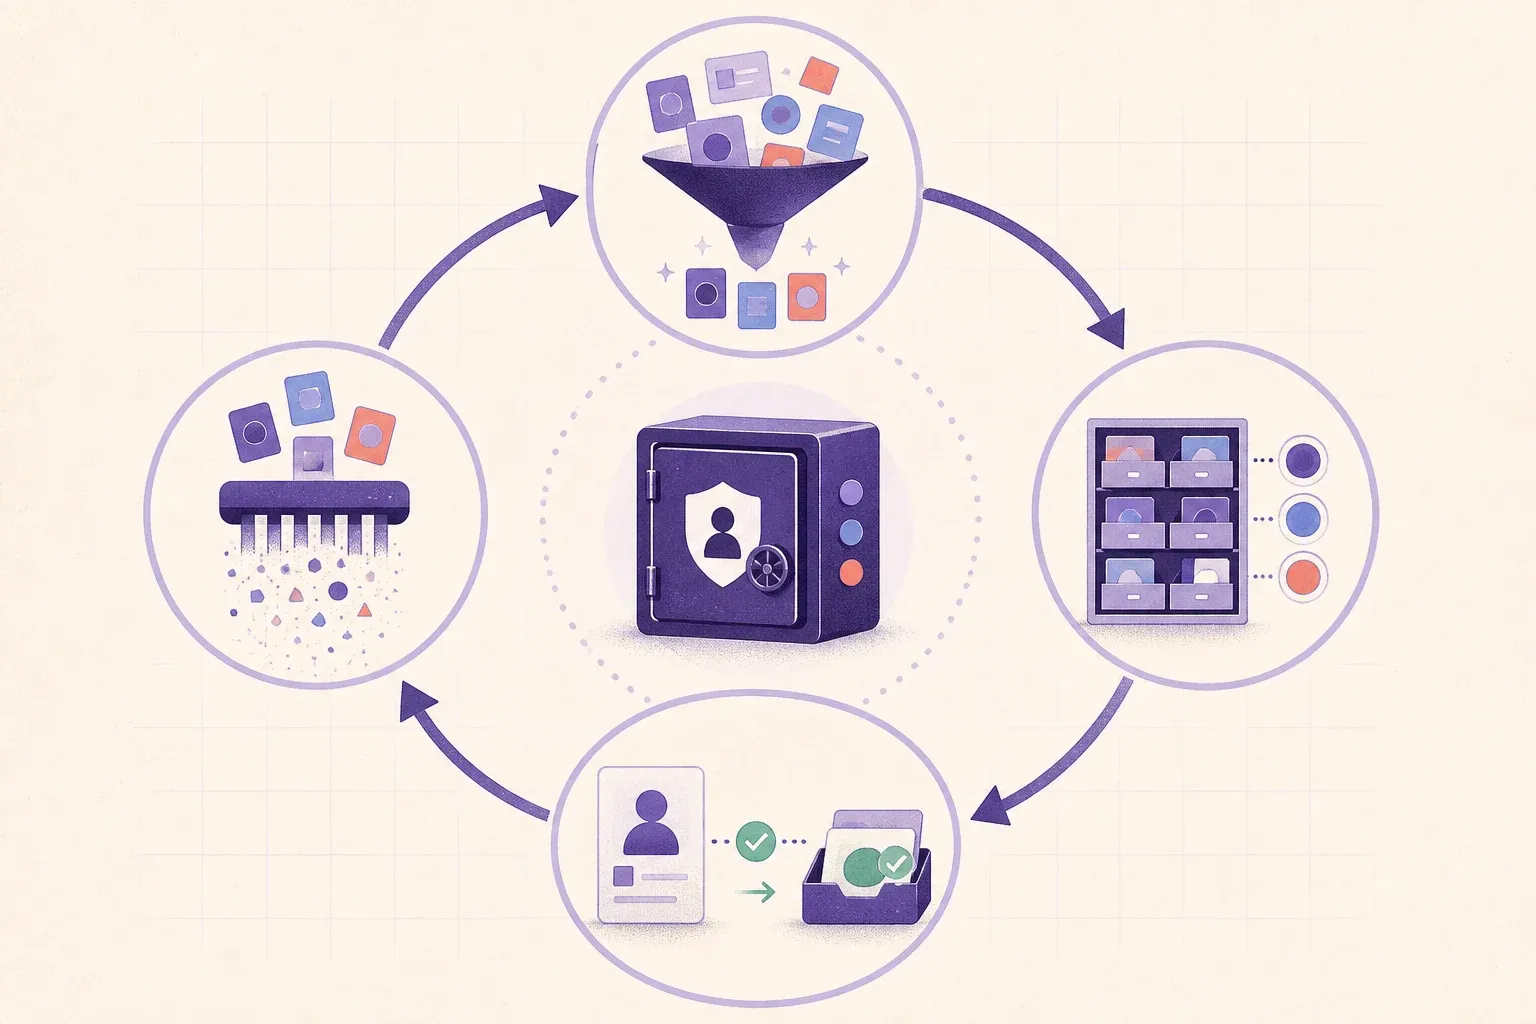
Scraping בקנה מידה גדול הופך ניקוי מאוחר ליקר. תנו למידע מזהה, שמרו מיפוי מבוקר בין מקור לרשומה, ודאו שאתם מסוגלים לאתר ולהסיר או להסתיר את המידע של אדם בכל המערכות: מהעתקים גולמיים, דרך מסדי נתונים וייצוא, ועד אינדקסים ומעבדים משניים.
לכל הפחות, החליטו:
- מי מקבל ומאמת בקשת זכויות;
- כיצד מאתרים רשומה בלי לבקש מידע נוסף מיותר;
- כיצד המחיקה או ההתנגדות מועברות למערכות downstream;
- כיצד מנגנון הסתרה מונע איסוף מחדש בטעות;
- כמה זמן לוגים וגיבויים שומרים את הרשומה, ואיזה תהליך חריג חל.
אם מערך הנתונים ישמש למודל, לגרף העשרה, לפרופיילינג או לשיווק ישיר, יש להקפיד על תכנית מחמירה יותר. ככל שהמידע עובר יותר ידיים, כך קשה יותר לכבד זכויות באופן משמעותי.
7. אבטחו את המידע והעריכו מוקדם מקרים בסיכון גבוה
GDPR דורש אמצעים התואמים את רמת הסיכון, כולל הגנה מפני גישה לא מורשית, אובדן, השמדה ועיבוד בלתי חוקי. פרטיות כברירת מחדל ובעיצוב פירושה לבחור את הבקרות האלה מההתחלה, לא אחרי אירוע אבטחה. חובות הנציבות האירופית
בקרות בסיס שימושיות כוללות הרשאות לפי תפקיד, הצפנה בהעברה ובמנוחה, ניהול סודות, יומני ביקורת, בדיקת ספקים, בקרות על ייצוא נתונים ותהליך אירוע שנבדק בפועל. Pseudonymisation יכולה לצמצם סיכון, אבל היא לא זהה ל-Anonymisation, ובדרך כלל לא מסירה לבדה את חובות ה-GDPR.
יש לשקול DPIA לפני עיבוד שעלול ליצור סיכון גבוה, במיוחד כשמשלבים בין הגורמים הבאים:
- איסוף או ניטור בקנה מידה גדול;
- פרופיילינג או החלטות שמשפיעות על אנשים;
- מידע רגיש או אישי מאוד;
- ילדים או אנשים פגיעים אחרים;
- שילוב מערכי נתונים כדי להסיק מסקנות חדשות;
- זיהוי מתמשך, נתוני מיקום או שימוש חוזר בסגנון data broker;
- אימון AI או מודל שעלול לשנן או לחשוף מידע אישי.
הנציבות מציינת הערכה שיטתית ומקיפה אוטומטית, עיבוד רחב היקף של נתונים רגישים וניטור שיטתי רחב היקף כמקרים המחייבים DPIA. הנחיות DPIA
צ'קליסט השקה לצוותי Web Scraping
לפני הרצת עבודה ב-production, ודאו את כל הבאים:
- אנחנו יודעים האם האיסוף כולל מידע אישי ולמה GDPR חל או לא חל.
- יש לנו מטרה כתובה ומדויקת ורשימת שדות מותרים של השדות הנדרשים.
- תיעדנו בסיס חוקי, ואם רלוונטי — גם הערכת אינטרס לגיטימי.
- החרגנו כברירת מחדל מקורות או קטגוריות רגישות ובסיכון גבוה.
- בחנו מגבלות מקור ולא עוקפים בקרות גישה.
- יש לנו הסבר ציבורי שקוף ודרך מעשית לבקשות זכויות ולהתנגדויות.
- אנחנו יודעים את תפקידי ה-controller/processor ויש לנו תנאי ספק מתאימים.
- יש לנו נהלים לשימור, מחיקה, הסתרה והעברה למערכות downstream.
- יש לנו בקרות אבטחה מתאימות לבסיס הסיכון ובעלות ברורה על אירועים.
- השלמנו DPIA והערכת העברות חוצות-גבולות, או שתיעדנו במכוון למה אין בכך צורך.
השורה התחתונה המעשית
תאימות ל-GDPR עבור Web Scrapers היא לא עניין של מציאת שורה קסומה בקובץ robots או הדבקת דיסקליימר במוצר. מדובר בבנייה של איסוף פרופורציונלי למטרה ברורה, במתן שקיפות ושליטה אמיתיות לאנשים, וביכולת להוכיח אחר כך את הבחירות שעשיתם.
התחילו מצומצם. אספו פחות. שמרו מקורות וחותמות זמן. בנו מחיקה בתוך מודל הנתונים. עצרו וערבו גורמים מתאימים לפני שימושים רגישים, בקנה מידה גדול, לצורכי פרופיילינג או לאימון AI, לפני שהמידע זורם הלאה. ההרגלים האלה הופכים Scraper לאמין יותר — וגם להרבה יותר קל לתפעול כשמגיעה שאלת הפרטיות הראשונה.
מאמר זה מספק מידע כללי בלבד ואינו ייעוץ משפטי. יש לפנות לייעוץ מקצועי לפי נסיבות הארגון, תחומי השיפוט, סוגי המידע והשימוש המתוכנן.
למדו עוד




