
העולם טובע בנתונים—או בעצם, כבר מזמן עבר את שלב הטביעה. אנחנו לא רק שוחים; אנחנו מנסים לגלוש על גל צונאמי של מידע שממשיך לעלות. התחזית האחרונה של IDC ל-2025–2029 עבור DataSphere העריכה שב-2025 נוצרו ברחבי העולם כ-175 זטה-בייט של נתונים, והעקומה ממשיכה לעלות—עם תחזית לכמעט 394 ZB עד 2028. (לשם ההשוואה, זטה-בייט הוא טריליון ג׳יגה-בייט. אני אשאיר לכם את החשבון בזמן שאני הולך לחפש את המחשבון שלי.) אבל הנה הנקודה החשובה: בערך 80% מהנתונים האלה אינם מובְנים—כלומר, דפי אינטרנט מבולגנים, קובצי PDF, תמונות, אימיילים ופוסטים ברשתות חברתיות.
אם אתם עובדים במכירות, בשיווק או בתפעול, אתם מכירים את התחושה: אתם צריכים תשובות, לא ערימות של שחת. ובכל זאת, סקר של Gartner מצא ש-47% מעובדי הדיגיטל עדיין מתקשים למצוא את המידע שהם צריכים כדי לבצע את עבודתם—והממצא הזה ממשיך להופיע גם במחקרי מקום עבודה שלוש שנים אחר כך. לכן חילוץ מידע—האמנות והמדע של שליפת עובדות שימושיות מתוך כאוס—הפך ל״רוטב הסודי״ של זריזות עסקית מודרנית. ובזכות כלי AI חדשים כמו Thunderbit, אפילו צוותים לא טכניים יכולים היום לחלץ, לארגן ולהשתמש במידע במהירות שגורמת לעידן ה־copy-paste הישן להיראות כמו אינטרנט בחיוג.
בואו נפרק מה באמת אומר חילוץ מידע, למה הוא כל כך קריטי, ואיך אפשר להשתמש בטכניקות העדכניות ביותר (כולל AI web scraper של Thunderbit) כדי להפוך עומס מידע לזהב עסקי.
חילוץ מידע: הגדרה פשוטה
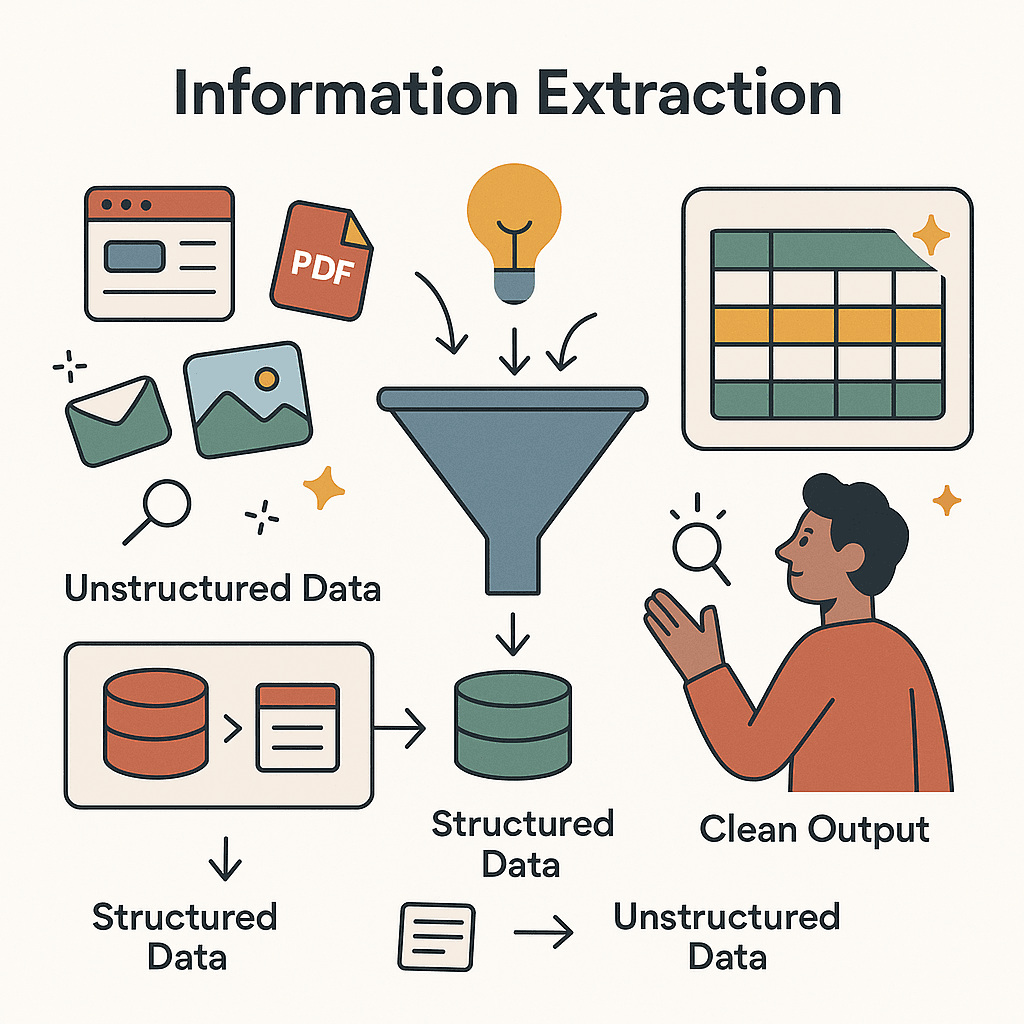
בבסיסו, חילוץ מידע פירושו שליפת נתונים רלוונטיים ממקורות שונים והפיכתם לפורמט מובנה ושימושי. תדמיינו שאתם מעתיקים אימיילים של לקוחות מאתר אינטרנט לגיליון אלקטרוני—זו הצורה הכי בסיסית של חילוץ מידע. אבל בעולם של היום, זה יותר כמו להעסיק עוזר-על מהיר במיוחד שקורא דפי אינטרנט מבולגנים, קובצי PDF או אפילו תמונות, ומחזיר לכם טבלה מסודרת עם העובדות החשובות לכם.
יש שני סוגים עיקריים:
- מקורות מובְנים: נתונים שכבר מאורגנים, כמו בסיסי נתונים או גיליונות אלקטרוניים.
- מקורות לא מובְנים: נתונים בטקסט חופשי, דפי אינטרנט, PDF, תמונות או אימיילים—בקיצור, כל דבר שלא נכנס יפה לשורות ועמודות.
חילוץ מידע מודרני הוא בעיקר הפיכת מידע גולמי לנתונים שימושיים—השלב הראשון בכל תהליך קבלת החלטות מבוסס נתונים (Captain Data, Rivery). בעסקים זה יכול להיות חילוץ מחירי מוצרים מאתרי מתחרים, סיכום משוב לקוחות מביקורות אונליין, או שליפת פרטי קשר מקובץ PDF.
חשבו על חילוץ מידע כמו מציאת מחט התובנה בתוך ערימת נתונים. ועם הכלים הנכונים, לא צריך להיות מתכנת כדי לעשות את זה.
למה חילוץ מידע חשוב לעסקים מודרניים
למה חילוץ מידע הוא כזה עניין גדול? כי בעידן של הצפת מידע, החברות שיודעות למצוא במהירות את המידע הנכון, לארגן אותו ולפעול לפיו הן אלה שמנצחות. כך חילוץ מידע יוצר ערך ממשי לאורך צוותים עסקיים:
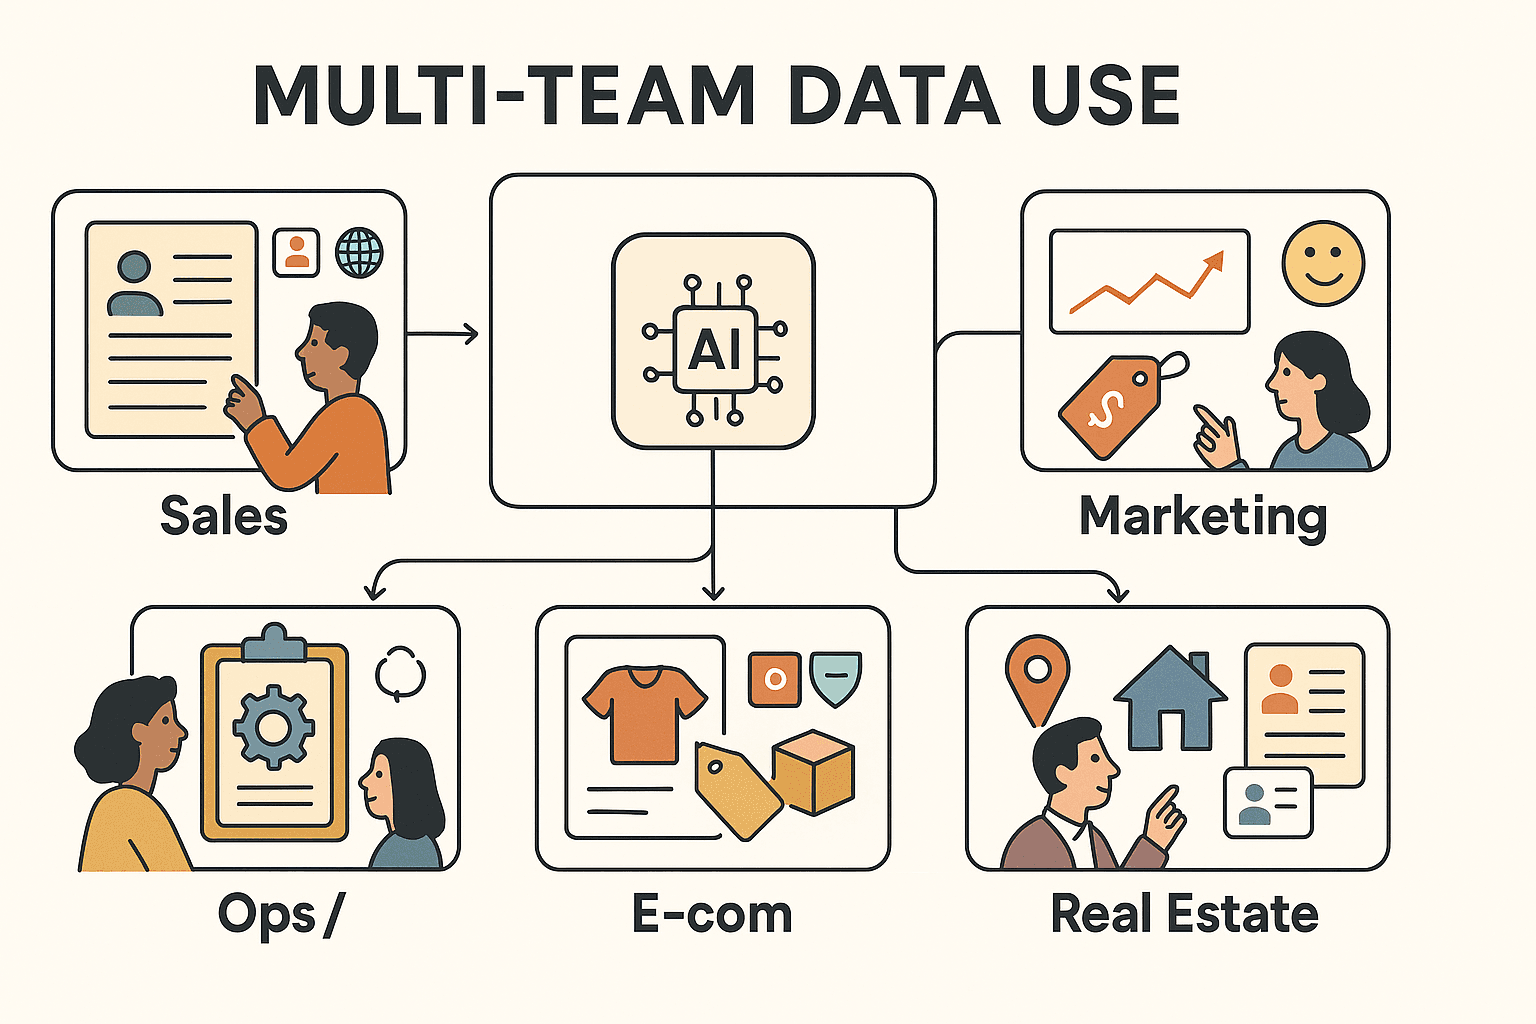
- מכירות: בניית רשימות לידים ממוקדות על ידי חילוץ ממדריכים ציבוריים, רשתות חברתיות או אתרי חברות—בלי לקנות רשימות מיושנות ובלי לבזבז שעות על מחקר ידני. חילוץ אוטומטי יכול להגדיל את תפוקת איתור הלקוחות בכפי 5 ולקצץ את העבודה הידנית ב-80%.
- שיווק: מעקב אחר מחירי מתחרים, ניטור מגמות שוק וניתוח סנטימנט לקוחות בקנה מידה גדול. קמעונאים כמו John Lewis ייחסו לחילוץ מחירים אוטומטי עלייה של 4% במכירות בזכות תמחור חכם יותר.
- תפעול ומחקר: אוטומציה של איסוף נתונים חוזר לדוחות, לוחות בקרה או רשימות ספקים. עובדים עתירי ידע יכולים להחזיר לעצמם עד 30% מהשבוע שלהם שבעבר בוזבזו על עיבוד נתונים ידני.
- E-commerce: מעקב אחר מלאי ומחירים של מתחרים, בדיקת עמידה במדיניות MAP, ואופטימיזציה של אסטרטגיית התמחור שלכם.
- נדל״ן: איסוף רשימות נכסים, שליפת פרטי קשר של בעלי נכסים, ומעקב אוטומטי אחר מגמות שוק.
הנה תמונת מצב קצרה של שימושי חילוץ מידע לפי פונקציה עסקית:
| פונקציה עסקית | מקרה שימוש לחילוץ | ערך/תועלת |
|---|---|---|
| מכירות | חילוץ לידים ממדריכים ורשתות חברתיות; שליפת פרטי קשר מאתרים, PDF או תמונות | יצירת לידים אוטומטית—יותר לידים, פחות עבודה ידנית |
| שיווק | ניטור מחירי מתחרים, איסוף ביקורות ונתוני רשתות חברתיות | מודיעין תחרותי, ניתוח סנטימנט, קמפיינים חכמים יותר |
| תפעול/מחקר | איחוד נתוני ענף, אוטומציה של דוחות | אוטומציה של תהליכים, תובנות בזמן אמת, פחות טעויות |
| E-commerce | מעקב מחירים, ניטור מלאי | תמחור אופטימלי, הגנה על הכנסות |
| נדל״ן | חילוץ רשימות נכסים, אנשי קשר של בעלי נכסים | תמונת שוק מקיפה, פנייה מהירה יותר |
בקיצור: חילוץ מידע הוא מכפיל כוח שמאפשר לצוותים לא טכניים לרתום ביג דאטה לתוצאות עסקיות אמיתיות.
טכניקות מרכזיות לחילוץ מידע
בואו נדבר תכל׳ס: איך אנשים באמת מחלצים מידע? הטכניקות התפתחו במהירות:
1. העתקה והדבקה ידנית
ה״ישן והאמין״ (או אולי ״ישן והכואב״): פותחים דף אינטרנט, מעתיקים את המידע, מדביקים לאקסל, וחוזרים על זה עד שהאצבעות נרדמות. זו שיטה גמישה, אבל איטית, מועדת לטעויות, ובלתי אפשרית להיקף גדול. מחקרים מראים שעובדי ידע מבזבזים כ-30% מהשבוע שלהם רק על חיפוש ואיסוף מידע.
2. כלי Web Scraping מסורתיים
אלה הם ה״כלים העוצמתיים של עשה-זאת-בעצמך״—כותבים סקריפטים (כמו Python עם BeautifulSoup או Scrapy) או משתמשים בתוכנות עם ממשק קליק-קליק כדי להגדיר כללי חילוץ. הם מהירים ויעילים לאתרים מובְנים, אבל דורשים ידע טכני ותחזוקה מתמדת. שינוי קטן בפריסת האתר, וה-scraper עלול להישבר (Solvexia).
3. חילוץ מבוסס AI (הדרך המודרנית)
כאן זה מתחיל להיות מעניין. כלים מונעי AI כמו Thunderbit משתמשים בעיבוד שפה טבעית ובראייה ממוחשבת כדי ״לקרוא״ דפי אינטרנט, PDF או תמונות—בדיוק כמו בן אדם. אתם אומרים לכלי מה אתם רוצים (“חלץ שמות מוצרים ומחירים”), וה-AI כבר מבין את השאר. בלי קוד, בלי תבניות, בלי כאב ראש. הכלים האלה מסתגלים, עמידים בפני שינויים באתר, ונגישים גם למשתמשים לא טכניים (Forbes).
בשורה התחתונה: אנחנו עוברים מצווארי בקבוק ידניים וטכניים לחילוץ מידע ידידותי למשתמש, מונע AI—וכך כל אחד יכול להפוך נתוני אינטרנט לערך עסקי.
Thunderbit: להפוך חילוץ מידע לפשוט לכולם
חילוץ נתונים מכל אתר בעזרת AI Get Started Free
עכשיו, תנו לי לשים לרגע את כובע ה-Thunderbit שלי (שהוא, אם תהיתם, כובע מטאפורי עם ברק). בנינו את Thunderbit כי ראינו כמה זמן והזדמנויות צוותים מאבדים לעבודה ידנית עם נתונים ולכלי scraping מסורבלים.
כך Thunderbit שונה:
- חילוץ AI בשתי לחיצות: פשוט פותחים את תוסף Chrome של Thunderbit, לוחצים על “AI Suggest Fields”, וה-AI שלנו סורק את הדף, מציע עמודות רלוונטיות ומגדיר את החילוץ בשבילכם. בלי קוד, בלי תבניות, רק תוצאות.
- מתמודד עם מקורות מורכבים: Thunderbit לא מיועד רק לדפי אינטרנט. הוא יכול לחלץ גם מ-PDF, תמונות ואפילו מקורות מבולגנים ולא מובְנים. צריך לשלוף פרטי קשר מחוברת PDF או מצילום מסך? Thunderbit מטפל בזה (Thunderbit Docs).
- חילוץ תתי-דפים ודפדוף בין עמודים: ה-AI שלנו יכול לנווט לתתי-דפים (כמו פרטי מוצר או קישורי פרופיל) ולטפל ברשימות שמחולקות לעמודים, כך שתקבלו את כל הנתונים—not רק מהעמוד הראשון.
- פרומפטים בשפה טבעית: אפשר לתאר את מה שאתם צריכים באנגלית פשוטה, וה-AI של Thunderbit ימצא את לוגיקת החילוץ.
- ייצוא מיידי: מייצאים ישירות ל-Google Sheets, Excel, Airtable או Notion—בלי ייבוא ידני ובלי ניקוי נתונים.
- ללא קוד, עם כל העוצמה: Thunderbit מיועד לצוותי מכירות, שיווק ותפעול שרוצים תוצאות בלי חסמים טכניים. (וכן, אמא שלי יכולה להשתמש בזה. היא עדיין עובדת על הסמארטפון שלה, אבל Thunderbit? אין בעיה.)
Thunderbit זוכה לאמון של יותר מ-100,000 משתמשים ברחבי העולם (קישור), ואנחנו רק מתחילים.
נסו את Thunderbit בחינם – חלצו נתונים ב-2 לחיצות
התגברות על האתגרים של חילוץ מידע מנתונים לא מובְנים
מהו Data Scraping ואיך עושים אותו ב-2025 Get Started Free
כאן העניינים מסתבכים: רוב המידע הקריטי לעסק נמצא בפורמטים לא מובְנים—דפי אינטרנט עם פריסות מוזרות, PDF, תמונות או תוכן דינמי. סקרייפרים מסורתיים מתקשים כאן. אבל ה-AI web scraper של Thunderbit בנוי בדיוק עבור הבלגן הזה:
- הבנת הקשר: ה-AI שלנו קורא את הדף כמו אדם, ומזהה הקשר ותבניות—not רק תגיות HTML. אם שדה ה״מחיר״ זז, Thunderbit עדיין מוצא אותו.
- ניווט בתתי-דפים: צריך לעקוב אחרי קישורים כדי לקבל עוד פרטים? חילוץ תתי-הדפים של Thunderbit עושה זאת אוטומטית, ומאחד את כל המידע לטבלה אחת.
- חילוץ מ-PDF ומדימויים: Thunderbit משתמש ב-OCR וב-AI כדי לשלוף נתונים מ-PDF ותמונות, כך שאפשר לחלץ גם מסמכים סרוקים, צילומי מסך ואפילו תמונות של כרטיסי ביקור.
- זיהוי סוגי נתונים: Thunderbit מקצה אוטומטית סוגי נתונים (טקסט, מספר, תאריך, אימייל, טלפון, תמונה), כך שהייצוא נקי ומוכן לשימוש.
- פרומפטים מותאמים אישית ל-AI: רוצים לעצב, לסווג או לסכם נתונים תוך כדי החילוץ? פשוט מוסיפים הנחיה, וה-AI של Thunderbit מטפל בזה בזמן אמת.
דוגמה מהעולם האמיתי: ראיתי צוותי מכירות משתמשים ב-Thunderbit כדי לחלץ מאות לידים מרשימת משתתפים ב-PDF, צוותי שיווק מחלצים מחירי מתחרים מאתרי e-commerce, וצוותי תפעול מושכים נתוני ספקים ממדריכים—משימות שפעם לקחו ימים, היום לוקחות דקות.
אוטומציה של חילוץ מידע ליעילות עסקית
בואו נדבר על הכוח האמיתי: אוטומציה. עם Thunderbit, אפשר להגדיר תהליכי חילוץ מידע שעובדים על טייס אוטומטי:
- חילוץ מתוזמן: מתארים את לוח הזמנים באנגלית פשוטה (“כל יום שני ב-9:00 בבוקר”), ו-Thunderbit יריץ את משימות החילוץ באופן אוטומטי (Thunderbit Blog).
- חילוץ בענן לעומת בדפדפן: בוחרים מצב ענן למהירות (עד 50 דפים בבת אחת) או מצב דפדפן לאתרים שדורשים התחברות.
- ייצוא מיידי: שולחים את הנתונים ישירות ל-Sheets, Notion או Airtable—בלי התעסקות מיותרת עם CSV.
- פחות שגיאות: אוטומציה פירושה פחות טעויות ידניות ונתונים עקביים ואמינים יותר.
התוצאה? צוותים חוסכים שעות (או ימים) בכל שבוע, מקבלים החלטות מהר יותר, ושומרים על צינורות נתונים עדכניים ומדויקים.
מחילוץ מידע לבניית אקוסיסטם נתונים
חילוץ מידע הוא רק הצעד הראשון. הקסם האמיתי קורה כשממירים את הנתונים שחילצתם לחלק חי ונושם בזרימת העבודה העסקית:
- שינוי נתונים בתוך הפלטפורמה: Thunderbit יכול לסכם, לסווג, לתרגם או לעצב נתונים בזמן החילוץ—כך שהפלט מוכן לניתוח.
- שילוב עם אפליקציות עסקיות: ייצוא ישיר לכלים המועדפים עליכם (Excel, Google Sheets, Airtable, Notion), או חיבור דרך API לשילוב עמוק יותר.
- תיוג והעשרה של נתונים: שימוש בפרומפטים של AI כדי לתייג, לנקות או להעשיר נתונים בזמן אמת—בלי עיבוד ידני אחרי החילוץ.
- ניהול ידע: אחסון ושיתוף של נתונים שחולצו במסדי נתונים שיתופיים, כדי שכל הצוות יוכל לגשת אליהם.
דמיינו צוות מכירות שחולץ לידים חדשים בכל שבוע, מעשיר אותם אוטומטית בגודל החברה ומייצא אותם ל-CRM. או צוות שיווק שעוקב אחרי מחירי מתחרים בזמן אמת ומזין את הנתונים ללוח מחירים דינמי. זו העוצמה של אקוסיסטם נתונים המבוסס על חילוץ מידע.
חילוץ מידע: שיטות עבודה מומלצות לצוותי מכירות ותפעול
מוכנים להתחיל? הנה הטיפים שלי לצוותים לא טכניים:
- הגדירו מטרות ברורות: דעו מה אתם רוצים לחלץ ולמה. אל תחלצו סתם כדי לחלץ—התמקדו בנתונים שמניעים החלטות.
- בחרו מקורות אמינים: התמקדו במקורות סמכותיים ועשירים בנתונים. תמיד בדקו אם מותר ואתי לבצע מהם scraping.
- נצלו הצעות AI: השתמשו ב-“AI Suggest Fields” ובתבניות של Thunderbit כדי לזרז את ההקמה ולתפוס את כל המידע הרלוונטי.
- אמתו ונקו נתונים: בדקו מדגמית את התוצאות, השתמשו בסוגי נתונים, ונקו תוך כדי כדי להבטיח איכות.
- כבדו את כללי הציות: חלצו רק נתונים ציבוריים, כבדו חוקי פרטיות (כמו GDPR), ואל תעמיסו על אתרים.
- תעדו את התהליך: שמרו תיעוד של מה מחלצים, מאיפה ובאיזו תדירות. זה עוזר בביקורות ובמעברי ידע בין חברי הצוות.
- שפרו באופן איטרטיבי: התחילו פשוט, ואז שכללו את החילוץ בהתאם למה שעובד הכי טוב לצוות שלכם.
העתיד של חילוץ מידע: לעבר פתרונות נתונים משולבים
לאן כל זה מתקדם? העתיד של חילוץ מידע יהיה חכם יותר, משולב יותר ונגיש יותר מאי פעם:
- AI בכל מקום: צפו שפרסור AI, שאילתות בשפה טבעית וחילוץ חזוי יהפכו לתכונות סטנדרטיות בכל כלי נתונים (Forbes).
- פלטפורמות נתונים אחודות: הגבול בין נתונים פנימיים וחיצוניים ייטשטש—כלי חילוץ יחוברו ישירות לדשבורדים של BI, ל-CRM ולמחסני אנליטיקה.
- חילוץ בזמן אמת וחיזוי: AI יידע לצפות מראש את צורכי הנתונים שלכם, לתזמן חילוצים באופן יזום ולספק תובנות בזמן אמת.
- חילוץ מולטי-מודלי: כלים יחַלצו לא רק טקסט, אלא גם תמונות, וידאו ואודיו—וייהפכו כל מקור נתונים לנכס עסקי.
- אתי ותואם כבר מהעיצוב: צפו ליותר בקרות פרטיות, הגנות ציות ומסגרות אתיות ל-scraping.
ב-Thunderbit אנחנו בונים לקראת העתיד הזה—ומטרתנו להפוך את חילוץ המידע לחלק חלק, טבעי ויומיומי מהעבודה של צוותים עסקיים.
סיכום: פתיחת ערך עסקי באמצעות חילוץ מידע
השורה התחתונה: חילוץ מידע הוא לא רק משימה טכנית—הוא הבסיס לעסק מודרני, מבוסס נתונים. בין אם אתם במכירות, בשיווק, בתפעול או במחקר, היכולת שלכם למצוא, לארגן ולהשתמש במידע היא מה שמבדל אתכם.
עם כלים מונעי AI כמו Thunderbit, חילוץ מידע נגיש עכשיו לכולם. בלי קוד, בלי תבניות, בלי חסמי IT—רק תוצאות. צוותים חוסכים שעות, מקבלים החלטות חכמות יותר ובונים אקוסיסטמים של נתונים שמייצרים ערך אמיתי.
אז תסתכלו על התהליכים הנוכחיים שלכם. איפה אתם עדיין תקועים במצב ידני? מה אפשר להפוך לאוטומטי או לשפר בעזרת כלי חילוץ מידע מודרניים? אני ממליץ לכם לנסות את התוכנית החינמית של Thunderbit, להתנסות בחילוץ מידע ממקור שחשוב לכם, ולראות כמה זמן ותובנות אפשר לפתוח.
כי בעולם מוצף בנתונים, המנצחים הם לא אלה שיש להם הכי הרבה מידע—אלא אלה שיודעים איך לחלץ אותו, להשתמש בו ולפעול לפיו.
לטיפים נוספים, מדריכים וסקירות עומק, בקרו ב-Thunderbit Blog.
נסו AI Web Scraper לחילוץ נתונים ללא מאמץ Get Started Free
שאלות נפוצות
1. מה בעצם אומר “חילוץ מידע”?
חילוץ מידע הוא התהליך של שליפת נתונים רלוונטיים ממקורות שונים—כמו דפי אינטרנט, PDF או תמונות—והפיכתם לפורמט מובנה ושימושי (חשבו: טבלאות מסודרות במקום טקסט מבולגן). זהו השלב הראשון בהפיכת נתונים למשהו שאפשר לפעול לפיו בהחלטות עסקיות.
2. למה חילוץ מידע חשוב לצוותים עסקיים?
כי המידע הנכון, בזמן הנכון, מוביל להחלטות טובות יותר. חילוץ מידע עוזר לצוותי מכירות לבנות רשימות לידים, לצוותי שיווק לעקוב אחרי מתחרים, ולצוותי תפעול לאוטומציה של דוחות—ובכך לחסוך זמן ולהגביר תוצאות.
3. איך Thunderbit הופך את חילוץ המידע לקל יותר?
Thunderbit משתמש ב-AI כדי לקרוא דפי אינטרנט, PDF ותמונות, ואז מציע איזה נתונים לחלץ—הכול בלי צורך בקוד. אפשר לחלץ, לתייג ולייצא נתונים בכמה לחיצות בלבד, אפילו ממקורות מורכבים או לא מובְנים.
4. מהם האתגרים הגדולים ביותר בחילוץ מידע מנתונים לא מובְנים?
נתונים לא מובְנים (כמו דפי אינטרנט, PDF או תמונות) הם מבולגנים ולא עקביים. כלים מסורתיים מתקשים עם שינויים בפריסה, תתי-דפים או תוכן דינמי. ה-AI web scraper של Thunderbit מתגבר על זה באמצעות הבנת הקשר, ניווט בין תתי-דפים וטיפול בכמה סוגי נתונים.
5. מה צופן העתיד לחילוץ מידע?
העתיד הוא מונע-AI, אוטומטי ומשולב. כלים כמו Thunderbit יהיו חכמים עוד יותר—יצפו צרכי נתונים, יחַלצו מכל מקור (טקסט, תמונה, וידאו) ויתחברו ישירות לאפליקציות עסקיות ולפלטפורמות אנליטיקה. חילוץ מידע יהיה שגרתי כמו שליחת אימייל.
מוכנים לפתוח את הכוח של חילוץ מידע? הורידו את Thunderbit והתחילו להפוך נתונים לערך עסקי כבר היום.
קראו עוד




