
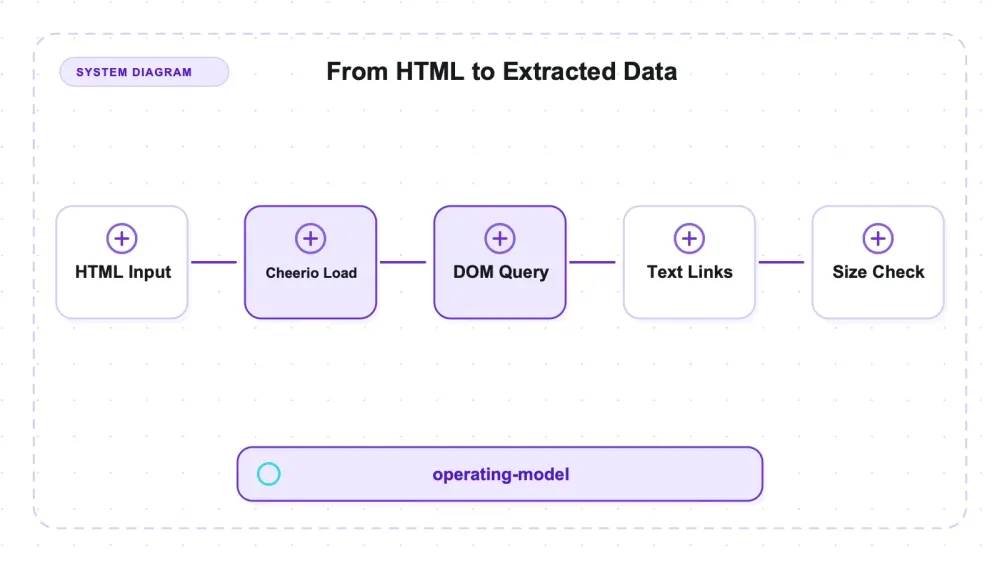
במכונה אחת, cheerio ב-Node ניתח וחילץ כותרות וגם href-ים מתוך מסמך HTML סינתטי בגודל 10 MB בתוך 2,927.89 ms. selectolax, שרץ דרך CPython עם מנתח מבוסס C, השלים את אותה פעולת חילוץ שדות ב-158 ms. טקסט הכותרות והמחרוזות של ה-href-ים, אחרי מיון, תאמו זה לזה. זו השוואה מקצה לקצה בין ערימות ריצה שונות, לא פסיקה מבודדת על אלגוריתם של מנתח כזה או אחר.
בדף של 10 KB הפער הוא פי 2, ואף אחד לא ישים לב. השאלה האמיתית היא איפה הדפים שלכם יושבים על העקומה הזו.
מהו cheerio
cheerio הוא מנתח HTML בסגנון jQuery עבור Node, ובצדק הוא התשובה המובילה באקוסיסטם הזה: 30,449 כוכבי GitHub, רישיון MIT, ודחיפה לריפוזיטורי יום לפני שהרצתי את הבדיקה. גרסה שנבדקה: 1.2.0.
מקור רשמי: המבוא הרשמי של Cheerio.
import * as cheerio from "cheerio";
const $ = cheerio.load(html);
const titles = $("h3.title").map((_, e) => $(e).text()).get();
const hrefs = $("a").map((_, e) => $(e).attr("href")).get();
אם כבר כתבתם jQuery, אתם כבר מכירים את ה-API. ההיכרות הזו היא במידה רבה הסיבה שהוא הצליח כל כך באקוסיסטם שלו.
מתחת למכסה המנוע זה לא מנתח אחד אלא סטאק: htmlparser2 ו-parse5 לניתוח, domhandler ו-domutils לעץ, cheerio-select לבחירת אלמנטים, וגם undici, encoding-sniffer ועוד — 11 תלויות ישירות, שמתורגמות ל-22 חבילות ברמת העליון ו-9.0 MiB על הדיסק. החבילות האלה מספקות יכולות ניתוח וקידוד, וגם מוסיפות לעומס התלויות. הסקירה הזו בדקה פלט על קלט שבור, אבל לא בדקה נכונות קידוד ולא בידדה אף אחד ממנועי הניתוח.
המדידה, ולמה אפשר לסמוך עליה
לבסיס המחקר הזה כבר היה בנצ'מרק למנתחים: חמישה גדלי דפים מ-1 KB עד 10 MB, 50 איטרציות, שלושה סבבים בלתי תלויים, ו—החלק החשוב—שער שוויון שמחשב את ההאש של התוכן שחולץ, כלומר כותרות ממוינות יחד עם href-ים ממוינים, מול מנתח ייחוס. מנתח שמדלג בשקט על עבודה לא יכול להציג זמן מהיר.
הוספת cheerio אליו חייבה שתי בדיקות לפני שסופרים בכלל מספרים.
האם הייחוס נשאר במקום שבו היה קודם? selectolax הורץ שוב באותה סשן ועל אותם פיקסצ'רים. ה-hash של התוכן שלו שוחזר ב-5 מתוך 5 הגדלים, ו-p50 שלו היה בין 0.989× ל-1.079× מהערך שפורסם. כלומר, זו אותה מכונה שהפיקה את הטבלה המקורית.
האם cheerio הפיק את אותם שדות מדורגים? ה-hash של התוכן שלו — שחושב ב-Node לפי אותו כלל, SHA-256 על טקסט כותרות ממוינות ועל href-ים ממוינים — תאם לייחוס ב-5 מתוך 5 הגדלים. זה מוכיח שוויון עבור השדות הממוינים האלה על הפיקסצ'רים הללו, ולא עבור מבנה ה-DOM, סדר המסמך, מאפיינים, נורמליזציית טקסט או שחזור משגיאות.
רק אז הזמנים מתחילים להיות משמעותיים.
| גודל דף | selectolax | lxml | PyQuery | cheerio (Node) | cheerio לעומת selectolax |
|---|---|---|---|---|---|
| 1 KB | 0.0286 ms | 0.0508 | 0.0456 | 0.1147 ms | 4.0× |
| 10 KB | 0.1725 ms | 0.1802 | 0.1728 | 0.3490 ms | 2.0× |
| 100 KB | 1.4855 ms | 1.4145 | 1.4093 | 3.8399 ms | 2.6× |
| 1 MB | 14.97 ms | 15.03 | 14.96 | 59.37 ms | 4.0× |
| 10 MB | 158.10 ms | 165.25 | 162.86 | 2,927.89 ms | 18.5× |
p50 במילישניות, חציון של שלושה סבבים. parser-bench.json. שלושת מנתחי Python רצו בתהליך אחד; cheerio רץ ב-Node 22, מה שאומר שיש כאן גם גבול של runtime וגם גבול של ספרייה — ראו בהמשך.
איך לקרוא את הטבלה בלי לשקר לעצמכם
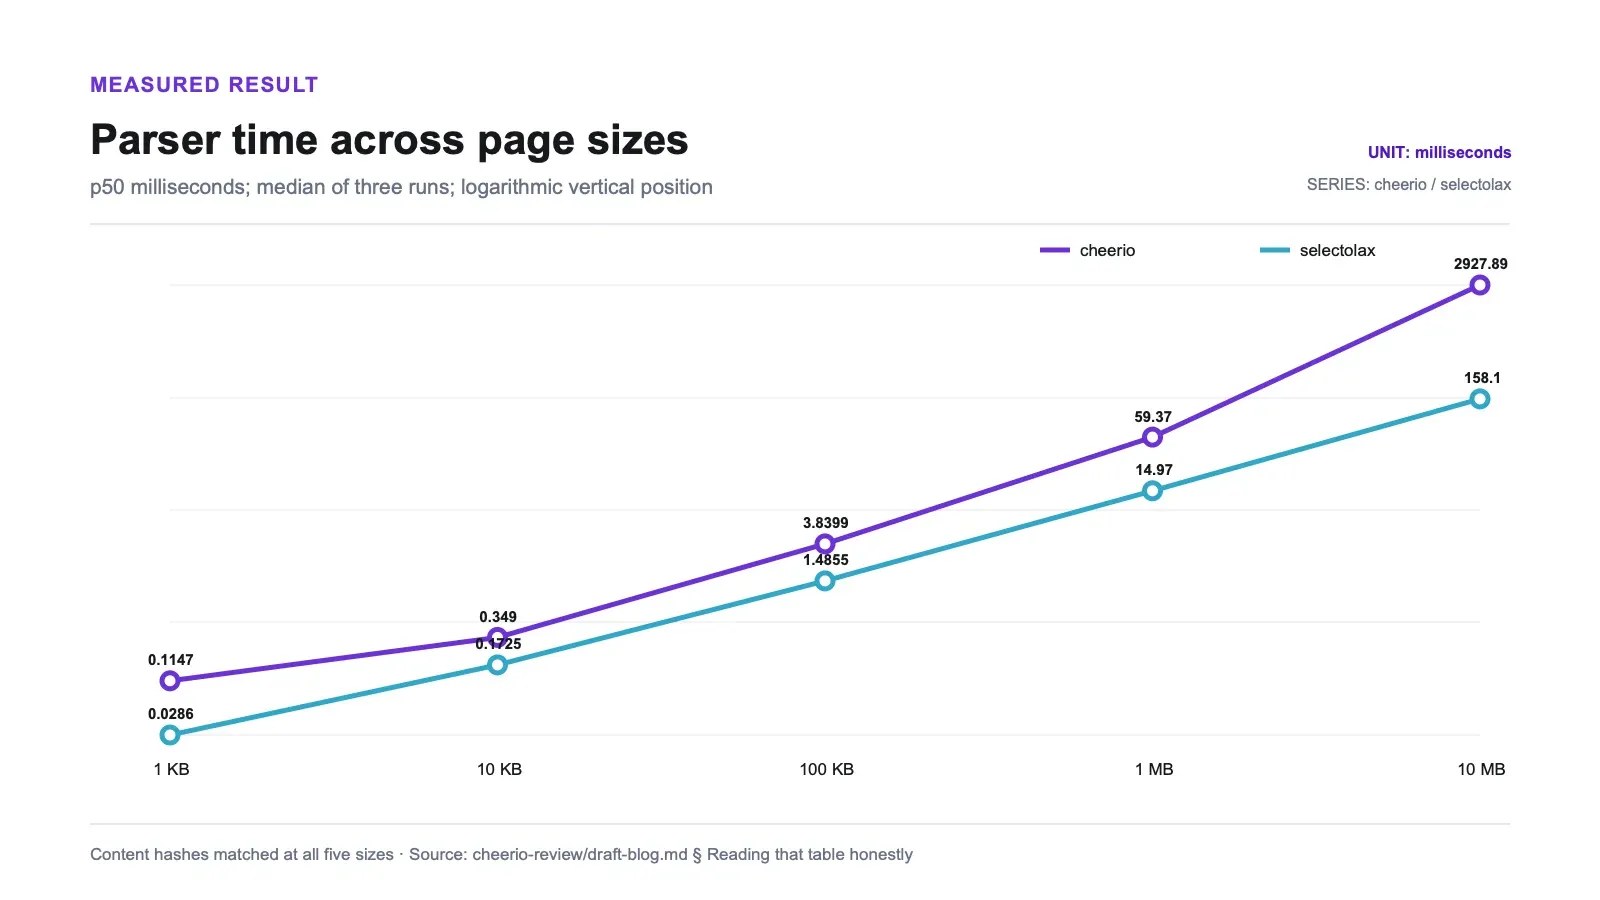
השורה של 1 KB היא רעש. בין שלושת מנתחי Python הפער בגודל הזה היה 77.6%, והריצות הבודדות חופפות בצורה פראית — selectolax נע בין 0.0267 ל-0.0404 ms בשלוש הריצות שלו. ב-28 מיקרו-שניות, רזולוציית הטיימר ותזמון המערכת שולטות. לא הייתי מדרג שום דבר ב-1 KB, כולל cheerio.
האמצע של הטבלה לא דרמטי. פי 2 עד פי 4 בדפים שבין 10 KB ל-1 MB. עבור סקרייפר שמטפל בכמה מאות דפים, זה 45 מילישניות לדף במקום 15, ולא תראו את זה בכלל.
השורה של 10 MB היא לא רעש. שלוש הריצות של cheerio יצאו ב-2,839, 2,928 ו-2,954 ms — צפופות, ומופרדות היטב משאר השורות. התוצאה מקצה לקצה בגודל 10 MB חורגת בחדות מהדפוס של הגדלים הקטנים יותר. חמישה נקודות גודל לא מספיקות כדי לקבוע סיבוכיות אסימפטוטית או לזהות איזה שכבה — runtime, מנתח, selector, הקצאת זיכרון או garbage collection — גרמה לזינוק.
זה נוחת בטווח של BeautifulSoup. הבנצ'מרק שפורסם מדד עוד ארבעה מנתחים על אותו פיקסצ'ר של 10 MB, ולשים את 2,927.89 ms של cheerio לידם הוא הדבר השימושי ביותר במאמר הזה:
| מנתח (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159.93 ms |
| lxml | 172.93 ms |
| parsel | 231.85 ms |
| selectolax (modest) | 247.95 ms |
| BeautifulSoup + lxml | 2,261.56 ms |
| BeautifulSoup + html.parser | 2,788.75 ms |
| cheerio | 2,927.89 ms |
ארבע השורות של Python הן הערכים שפורסמו מתוך bench_parse.json; הערך של cheerio הוא מהריצה הזו. מנתח הייחוס שוחזר בטווח של 0.989×–1.079× בין שתי הריצות, לכן כדאי להתייחס להבדלים קטנים מכ-8% ככאלה שנמצאים בתוך אי-הוודאות הזו — cheerio מול backend של html.parser ב-BeautifulSoup (פער של 5%) נמצא בתוכה, cheerio מול selectolax (פי 18) לא.
BeautifulSoup היא הספרייה שאנשים פונים אליה כשהם רוצים נוחות ומודעים לכך שהיא איטית — זו הספרייה שכל דיון על ביצועי Python אומר לכם להחליף. במסמך של 10 MB, cheerio יושב בתחתית אותו טווח, ולא בטווח של המנתחים שמבוססים על C שאיתם נוטים לשייך אותו.
שאלת ההחלפה בצד Node נשארת פתוחה במאמר הזה. חלופות חדשות יותר ל-Node לא נבדקו, ולכן התוצאה לא יכולה לטעון שהחלפת ספריות היא בלתי אפשרית או לבטל אותן כפחות מבוססות. היא רק מראה את המסלול שנמדד של cheerio מול הסטאקים של Python שצוינו.
זו גם השוואת runtime, לא רק ספרייה. המילישניות של cheerio מגיעות מ-JIT ומ-garbage collector של Node; האחרות מגיעות מ-CPython שקורא למנתחים מבוססי C. ה-hash של התוכן מוכיח שנעשתה אותה עבודה, ושני המספרים הם מה שמפתח שבוחר סטאק באמת חווה — אבל אף אחד לא צריך לקרוא מזה ש"האלגוריתם של cheerio גרוע פי 18 משל selectolax". זה מה שקרה, על המכונה הזו, בתוך ה-runtime הטבעי של כל ספרייה.
מציאות ההתקנה
| ספרייה | חבילות | נפח דיסק | רישיון | כוכבים | push אחרון |
|---|---|---|---|---|---|
| cheerio | 22 (npm) | 9.0 MiB | MIT | 30,449 | 2026-08-11 |
| PyQuery | 3 (pip) | 20.1 MiB | BSD | 2,380 | 2026-07-27 |
מקור רשמי: תיעוד ההגדרות של Cheerio.
metadata-snapshot.json, נשלף ביום הכתיבה.
npm install cheerio לקח פחות משתי שניות והוריד 9.0 MiB. טעינה קרה נמדדה ב-0.056 שניות בהרצת המרה נפרדת על אותה מכונה.
אחת-עשרה תלויות ישירות זה הרבה עבור מנתח, וחשוב לדעת זאת אם אתם מבצעים audit לעץ התלויות שלכם: htmlparser2, parse5, parse5-htmlparser2-tree-adapter, parse5-parser-stream, domhandler, domutils, dom-serializer, cheerio-select, encoding-sniffer, undici ו-whatwg-mimetype. שתי מימושי ניתוח מלאים מגיעים שם יחד, כי cheerio יכול להשתמש בכל אחד מהם לפי מה שמבקשים ממנו.
שלושים אלף כוכבים ודחיפה יום לפני הבדיקה הם סימן תחזוקה טוב מאוד בקטגוריה הזו.
זיכרון, ומה HTML שבור עושה לו
טביעת הזיכרון והתנהגות מול קלט שבור משפיעות על פריסה ועל טיפול בכשלים, ולכן שתיהן נמדדות כאן בנפרד.
ההקשר הרחב יותר של מבחן העומס מופיע ב-השוואת הזיכרון וה-HTML השבור בין עשר ספריות.
זיכרון תהליך שיא, באמצעות /usr/bin/time -l, תהליך חדש לכל תא — רצפת ה-import היא מה שהספרייה צורכת כשהיא נטענת ונשארת סרק, והשיאים כוללים את המסמך.
| ספרייה | runtime | רצפת import | שיא 226 KB | שיא 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. בסיסי Python ו-Node אינם ברי-השוואה ישירה זה לזה; המפרש נמצא בתוך שניהם.
ל-cheerio יש את רצפת ה-import הגבוהה ביותר בטבלה המשולבת הזו — 66.8 MiB, כולל runtime של Node והתלויות. התהליך שלו הגיע לשיא של 398.5 MiB בפיקסצ'ר של 10 MB. השורות האחרות כוללות מנתחים, ממירים ומחלצי מאמרים שעושים עבודה ראשית שונה, ולכן צריך להשתמש בהן כהקשר של footprint תהליכי ולא כדירוגי ביצועים בין שווים. השורה של turndown באותו runtime הגיעה לשיא גבוה יותר, אבל היא מבצעת המרה ולא את חוזה חילוץ הכותרות וה-href-ים שנמדד עבור cheerio.
HTML שבור. שנים-עשר מסמכים, שכל אחד מהם שבר דבר אחד בדיוק — תגיות לא סגורות, רכיבי inline מקוננים לא נכון, מאפיינים בלי מירכאות עם רווחים, סוגרים זרים, בלי <html> בכלל, מאפיינים כפולים, מסמך שנחתך באמצע תג, ישויות פגומות, <script> לא סגור, הצהרת charset שקרית, הערה שמכילה markup, ו-600 רמות של קינון — ועוד שני בקרות תקינות בגודל תואם, כי "הוא לא החזיר כלום" אומר משהו על תקינות שבורה רק אם הספרייה גם שותקת על מסמך נקי באותו גודל.
cheerio זרק שגיאה ב-0 מתוך 14 ולא החזיר כלום ב-0, ושיחזר 11/22 סנטינלים מדורגים על פני הפיקסצ'רים השבורים (malformed-results.json). עבור מנתחים, המדורג בודק סנטינלים של כותרות וקישורים לאורך אחד-עשר מסמכים שבורים שניתן לדרג; הוא לא מדרג את סנטינל הפסקה, והפיקסצ'ר של <script> לא סגור מוחרג. בלי baseline באותו חוזה בחלק הזה, 11/22 הוא לא דירוג איכות. המסקנה הנתמכת היא ש-cheerio החזיר פלט לא ריק בלי לזרוק שגיאה על כל ארבע-עשרה הקלטים השבורים-פלוס-בקרה, ובמקביל שיחזר חצי מהסמנים המדורגים.
יתרונות וחסרונות
לזכותו. תחביר jQuery מוכר. MIT. אות תחזוקה מתוזמן של 30,449 כוכבים ופעילות ריפוזיטורי ביום שלפני הבדיקה. קיימים שני backends לניתוח וחבילות הקשורות לקידוד, אם כי שחזור backend ונכונות קידוד לא בודדו כאן. ה-hash של הכותרות וה-href-ים הממוינים תאם לייחוס בכל גודל פיקסצ'ר.
נגדו. איטי פי 18.5 מ-selectolax על מסמך של 10 MB, ופי 4 על 1 MB. אחת-עשרה תלויות ישירות, כולל שני מימושי ניתוח מלאים. רק Node. ושום דבר בתיעוד שלו לא רומז על גודל שבו הוא מפסיק להיות הבחירה הברורה.
מי צריך להשתמש בו, ומי לא
השתמשו ב-cheerio אם אתם ב-Node, ממשק בסגנון jQuery חשוב לכם, והדפים שאתם עובדים איתם דומים בגדלים שנבדקו עד 1 MB. מגה-בייט אחד הוא הנקודה הגדולה ביותר שנבדקה לפני הזינוק החד של 10 MB; המאמר הזה לא קובע את נקודת החיתוך ביניהם ולא טוען כמה מהאינטרנט נמצא מתחתיה.
בצעו בנצ'מרק לפני השימוש במסמכי HTML גדולים מאוד כמו דוחות שנוצרים אוטומטית, דמפי קטלוגים או דפי רשימות ארוכים. התנהגות מול XML sitemap לא נבדקה. על פיקסצ'ר ה-HTML של 10 MB, 2.9 שניות למסמך הן עלות ממשית שמצטברת.
אם אתם ב-Python, ההשוואה הזו אומרת משהו אחר: selectolax, lxml ו-PyQuery למעשה שווי-ביצועים מ-10 KB ומעלה (בתוך 0.5% עד 5.4%, עם טווחי ריצה חופפים), ולכן כדאי לבחור לפי API ולא לפי מהירות. הפער של cheerio מול שלושתם הוא המספר המעניין, לא ההבדלים ביניהם.
איפה נכנס API מנוהל
cheerio מנתח HTML שכבר יש לכם. הוא לא מבצע fetch, לא מרנדר JavaScript, ולא מתמודד עם שכבת anti-bot — ובמטרות אמיתיות רבות, זה החלק הקשה יותר של העבודה.
שירות מנוהל של fetch/render/extraction, כולל Thunderbit שלנו, יושב בנקודת אחריות אחרת. Thunderbit לא נבחן כאן. ההבחנה הרלוונטית היא בין ניתוח HTML שסופק לכם עם selectors לבין מיקור-חוץ של איסוף, רינדור וחילוץ; המאמר הזה לא מספק השוואת איכות, זמן תגובה או עלות על אותו מדד.
הניסוח ההוגן: אם ה-HTML כבר אצלכם ואתם יודעים את ה-selectors, cheerio הוא חינמי ונעים לשימוש. אם אתם מבצעים איסוף דפים בקנה מידה גדול, או מעדיפים לתאר את הנתונים ולא את ה-DOM, זו כבר רכישה אחרת.
לשדה הרחב יותר, סקירת ה-web scraping APIs שלנו סוקרת פתרונות מתארחים, ו-עמוד העוגן של הסקרייפרים בקוד פתוח עוסק במאוכסנים עצמאית. אם הפלט המנותח מיועד למודל, המרת HTML ל-Markdown ב-Python מסבירה איפה הולכת לאיבוד fidelity.
נסו את Thunderbit לחילוץ נתוני רשת
האם כדאי להשתמש ב-cheerio?
כן, ב-Node, כשהתאמת ה-API חשובה והמסמכים הייצוגיים נשארים קרובים לטווח הקטן עד 1 MB שנבדק.
ההיכרות עם ה-API וסימני התחזוקה הנוכחיים הם שיקולים לגיטימיים לבחירה. הבנצ'מרק לא מוכיח שקיימת תשובת תמיכה מסוימת, ולא שגודל הדפים שנבדק מייצג את הטווח בייצור.
המספר שצריך לזכור הוא זה של 10 MB. איפשהו בין 1 MB ל-10 MB, העלות של cheerio מפסיקה לעקוב אחרי האחרים ומתחילה להתרחב — פי 4 הופך לפי 18.5. אם הקורפוס שלכם כולל מסמכים כאלה, תריצו בנצ'מרק לפני שאתם מתחייבים, כי שום דבר בספרייה לא יזהיר אתכם.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם הוגן להשוות את cheerio מול מנתחי Python?
זו השוואת סטאק, לא השוואת אלגוריתם. כל ארבעת הכלים הפיקו טקסט כותרות ו-href-ים זהים תחת כלל ה-hash ב-5 מתוך 5 גדלי דפים. זה לא מוכיח שקילות מלאה של המנתחים. הזמנים של cheerio כוללים את התנהגות ה-runtime של Node, בעוד האחרים כוללים את CPython שקורא למנתחים מבוססי C; ההשוואה מתארת את הבחירות האלה מקצה לקצה.
למה השורה של 1 KB לא מדורגת?
כי ב-28 מיקרו-שניות המדידה נשלטת על ידי רעש. לאורך שלוש הריצות, מנתחי Python התפזרו ב-77.6%, עם חפיפה בין ריצות בודדות. כל סדר בגודל הזה יהיה תוצר לוואי. מ-10 KB ומעלה הקריאה יציבה מספיק.
מה גורם לזינוק ב-10 MB?
הבדיקה הזו לא אומרת. מה שהיא כן קובעת הוא שהזינוק אמיתי ולא רעש: שלוש הריצות של cheerio נחתו ב-2,839, 2,928 ו-2,954 ms, מופרדות היטב מכל השאר, בעוד הפער ב-1 MB היה פי 4. בידוד הסיבה היה דורש profiling נפרד של ה-backends של המנתח, וזה היה מחוץ להיקף כאן.
כמה תלויות באמת יש לו?
אחת-עשרה ישירות, 22 ברמה העליונה לאחר פתרון, ו-9.0 MiB על הדיסק. שתיים מהן הן מימושי ניתוח מלאים — htmlparser2 ו-parse5 — כי cheerio יכול להשתמש בכל אחד מהם. זה המחיר של תמיכה גם בניתוח סלחני וגם בניתוח תואם-מפרט, וחשוב לדעת זאת אם אתם מבצעים audit לעצי תלויות.
מה לא נבדק כאן?
הבדיקות כיסו שיא זיכרון תהליך על מסמך אחד של 226 KB ועל מסמך אחד של 10 MB, ועוד סט של 14 קלטים שבורים-פלוס-בקרה שבו cheerio לא זרק שגיאה על אף אחד, החזיר פלט לא ריק על כולם, ושיחזר 11/22 סנטינלים מדורגים. לא נבדקו streaming דרך parse5-parser-stream, נכונות קידוד, שחזור ספציפי ל-backend, מיקום קפיצת הביצועים בין 1 ל-10 MB, ניתוח XML, או חלופות חדשות יותר ל-Node.




