
אם אתם בוחנים כלי ווב סקרייפינג ב-2026, כנראה שאתם לא מחפשים שיעור בפילוסופיה. אתם רוצים רשימה מצומצמת שאפשר לסמוך עליה, דרך מהירה להבדיל בין כלים שמתאימים למשתמשים עסקיים לבין פתרונות כבדים למפתחים, ומספיק הוכחות אמיתיות כדי לא לקנות את הדבר הלא נכון. זה בדיוק התפקיד של העמוד הזה.
התשובה הקצרה
אם אתם צריכים רק את כיוון הבחירה, השתמשו בזה:
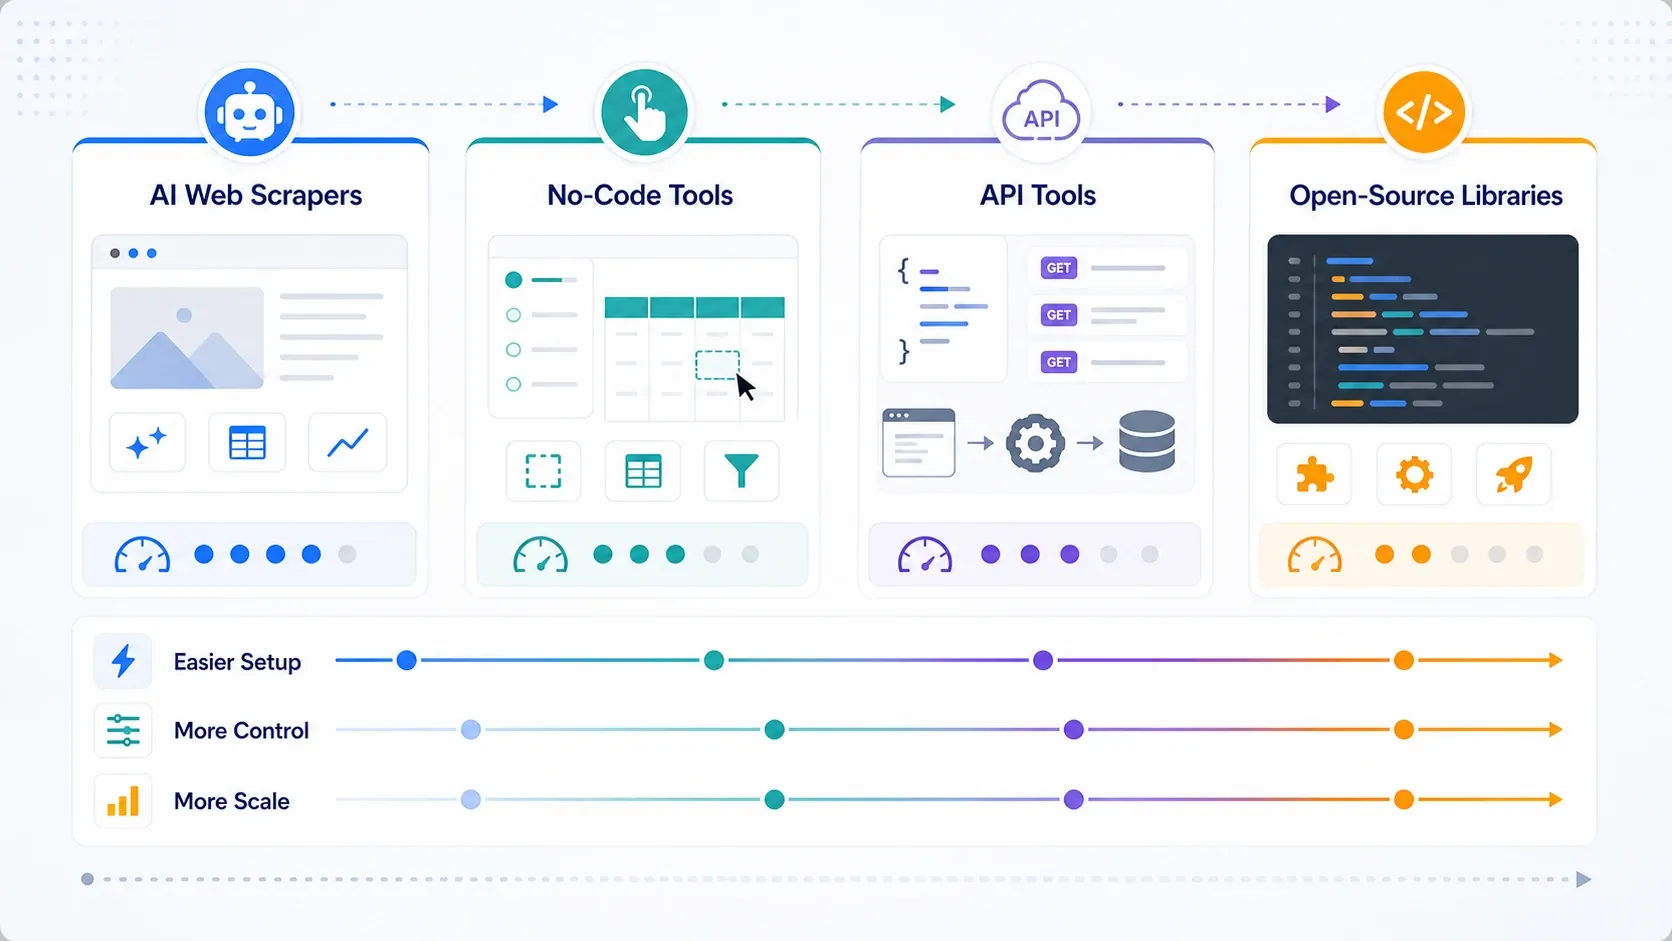
- בחרו AI web scraper אם אתם רוצים את המסלול הכי מהיר מאתר לגיליון נתונים, עם מינימום הגדרה.
- בחרו no-code scraper אם אתם צריכים יותר שליטה במשימות, תזמון, או הרצה בענן בלי לכתוב קוד.
- בחרו API platform אם הצוות שלכם צריך רינדור, סבב פרוקסי, טיפול באנטי-בוט, או שילוב בתוך מוצר פנימי.
- בחרו open-source library אם אתם רוצים שליטה מלאה ויכולים לקחת אחריות על תחזוקה, סלקטורים, תשתית וכשלים.
המאמר הזה שומר את כל 20 הכלים, אבל לוגיקת ההמלצה פשוטה בכוונה: התחילו מהכלי הכי קל שיכול לבצע את העבודה בצורה אמינה, ורק אחר כך רדו לשכבה עמוקה יותר אם תחזוקה, חסימות או סקייל מחייבים זאת.
טבלת השוואה מהירה: כלי הווב סקרייפינג הטובים ביותר ב-2026
המחירים ומודלי התמחור שלהלן נבדקו מול דפי המוצר או התמחור הרשמיים באוגוסט 2026. כשספקים משתמשים בחיוב לפי שימוש או בהצעת מחיר מותאמת לארגונים, אני מתאר את מודל התמחור במקום להעמיד פנים שיש מחיר אחיד אחד שאפשר לסמוך עליו.
| כלי | סוג | מתאים במיוחד ל | למה נכנס לרשימת 2026 | מודל תמחור (נבדק במאי 2026) |
|---|---|---|---|---|
| Thunderbit | AI Web Scraper | מכירות, תפעול, מסחר אלקטרוני, נדל״ן | המסלול הכי מהיר למי שלא כותב קוד; הצעות שדות ב-AI, תתי-עמודים, ייצוא, זרימת עבודה בדפדפן + בענן | שכבה חינמית, מסלולים בתשלום, תמחור מותאם לעסקים |
| Browse AI | AI Web Scraper | משתמשים עסקיים שמנטרים אתרי אינטרנט | רובוטים ללא קוד, ניטור ותוצרים בסגנון גיליון נתונים או API | מסלול חינמי, מסלולים בתשלום, שכבת פרימיום מנוהלת |
| Bardeen | אוטומציה + סקרייפינג ב-AI | תפעול הכנסות וזרימות עבודה בדפדפן | חזק במיוחד כשהסקרייפינג הוא רק שלב אחד בתוך אוטומציה רחבה יותר | מסלול חינמי ומסלולים בתשלום |
| Diffbot | פלטפורמת חילוץ ב-AI | ארגונים וצוותי דאטה | מתאים כשצריך חילוץ ב-AI יחד עם תהליכי דאטה מובנים בקנה מידה גדול | תמחור בסגנון ארגוני |
| Instant Data Scraper | מחלץ דפדפן קל משקל | משתמשים מזדמנים ושליפות מהירות של טבלאות | עדיין אחת הדרכים הכי פשוטות לשלוף רשימה או טבלה גלויה במהירות ל-CSV | חינם |
| Octoparse | מחלץ ללא קוד | אנליסטים וצוותי תפעול עם משימות חוזרות גדולות | בונה ויזואלי בוגר עם חילוץ בענן, מנגנוני anti-blocking ותבניות | מסלול חינמי, בתשלום מ-69 דולר לחודש, מותאם לארגונים |
| ParseHub | מחלץ low-code | אנליסטים שצריכים לוגיקה ושליטה בדסקטופ | לוגיקת פרויקטים גמישה וניווט מקונן, עם עקומת למידה תלולה יותר מכלי AI חדשים יותר | מסלול חינמי ומסלולים בתשלום |
| Web Scraper | מחלץ ללא קוד | מתחילים ומשימות ענן קלות | נקודת כניסה טובה אם אתם אוהבים סקרייפינג מבוסס sitemap והגדרה שמתחילה בדפדפן | תוסף חינמי, מסלולי ענן בתשלום |
| Data Miner | מחלץ דפדפן | חוקרים ואנשי צמיחה | עדיין שימושי לחילוץ מהיר מבוסס-מתכון בתוך הדפדפן | מסלול חינמי ומסלולים בתשלום |
| Apify | פלטפורמת API + Actor | צוותים טכניים ומפעילים היברידיים | אקוסיסטם מצוין של Actors יחד עם runtime מותאם אישית כשגדלים מעבר לתוספי דפדפן | מסלול חינמי, מ-29 דולר לחודש + שימוש, שכבות מתקדמות נוספות |
| ScrapingBee | API לסקרייפינג | מפתחים שגולשים באתרים כבדי JavaScript | בחירה טובה כשצריך רינדור וטיפול בפרוקסי בלי לבנות לבד את שכבת הדפדפן | גרסת ניסיון ומסלולים בתשלום |
| ScraperAPI | API לסקרייפינג | מפתחים שצריכים להגדיל נפח בקצב מהיר | API פשוט, קרדיטים לניסיון, מוצרים מובנים והורדת עומס תשתיתי | ניסיון ל-7 ימים עם 5,000 קרדיטים, בתשלום מ-49 דולר לחודש |
| Bright Data | API ארגוני + פלטפורמת פרוקסי | תהליכים עתירי נפח ורגישות לציות | סט הדאטה-קולקשן הרחב ביותר כשפתרון חסימות, פרוקסי ואיסוף מנוהל חשובים יותר מפשטות | תמחור לפי שימוש ולפי מוצר |
| Oxylabs | API ארגוני + פלטפורמת פרוקסי | צוותים שקונים סקרייפינג כתשתית | חזק במיוחד לאיסוף בקנה מידה גדול, בעיקר למחקר מחירים, SEO ושוק | Web Scraper API החל מ-49 דולר לחודש; תמחור הפרוקסי הרחב משתנה |
| Zyte | API + שכבת anti-bot | צוותי פיתוח ודאטה | מתאים כשמחפשים חילוץ API-first עם רכיבי דפדפן, רוטציה והתחמקות מזיהוי | ניסיון עם 5 דולר קרדיט חינם, התחייבות לפי שימוש |
| Selenium | אוטומציית דפדפן בקוד פתוח | אוטומציה בסגנון QA וזרימות אינטראקציה קשות | עדיין שימושי כשהדיוק של אינטראקציית משתמש חשוב יותר מתפוקה | חינם וקוד פתוח |
| BeautifulSoup4 | פרסר בקוד פתוח | מתחילים ופרסור קל משקל | הכי טוב כפרסר בתוך סטאק פשוט, לא כפלטפורמת סקרייפינג מלאה | חינם וקוד פתוח |
| Scrapy | מסגרת crawling בקוד פתוח | זחלים מותאמים אישית לייצור | האיזון הכי טוב בין עוצמה לבשלות אם אתם רוצים להחזיק את כל ה-pipeline בעצמכם | חינם וקוד פתוח |
| Puppeteer | אוטומציית דפדפן בקוד פתוח | סקרייפינג מבוסס Node וסקריפטים לדפדפן | מצוין אם הצוות שלכם כבר מרגיש בבית באקו-סיסטם של Chrome/Node | חינם וקוד פתוח |
| Playwright | אוטומציית דפדפן בקוד פתוח | אוטומציה מודרנית לריבוי דפדפנים | לרוב הבחירה הכי נקייה לאוטומציית דפדפן מודרנית עם חוויית פיתוח מצוינת | חינם וקוד פתוח |
איך הערכתי את הכלים האלה
השתמשתי בארבעה מסננים:
- הזמן עד לסקרייפ הראשון שעובד
אם מפעיל לא-טכני לא מצליח להוציא דאטה שימושי במהירות, זה חשוב. - עומס התחזוקה
הגדרה מהירה לא שווה הרבה אם הזרימה נשברת בכל פעם שהאתר משתנה. - תקרת סקייל
יש כלים שמתאימים ל-50 עמודים בשבוע ונוראיים ל-5 מיליון בקשות בחודש. - התאמה לזרימת העבודה
הכלי הכי טוב לצוות Revenue Ops כמעט אף פעם אינו הכלי הכי טוב לצוות פלטפורמת דאטה.
התוצאה אינה דירוג אוניברסלי. זהו עמוד החלטה לבחירת סוג הכלי הנכון קודם, ואז המוצר הנכון בתוך אותה קטגוריה.
איזה סוג של כלי ווב סקרייפינג אתם באמת צריכים?
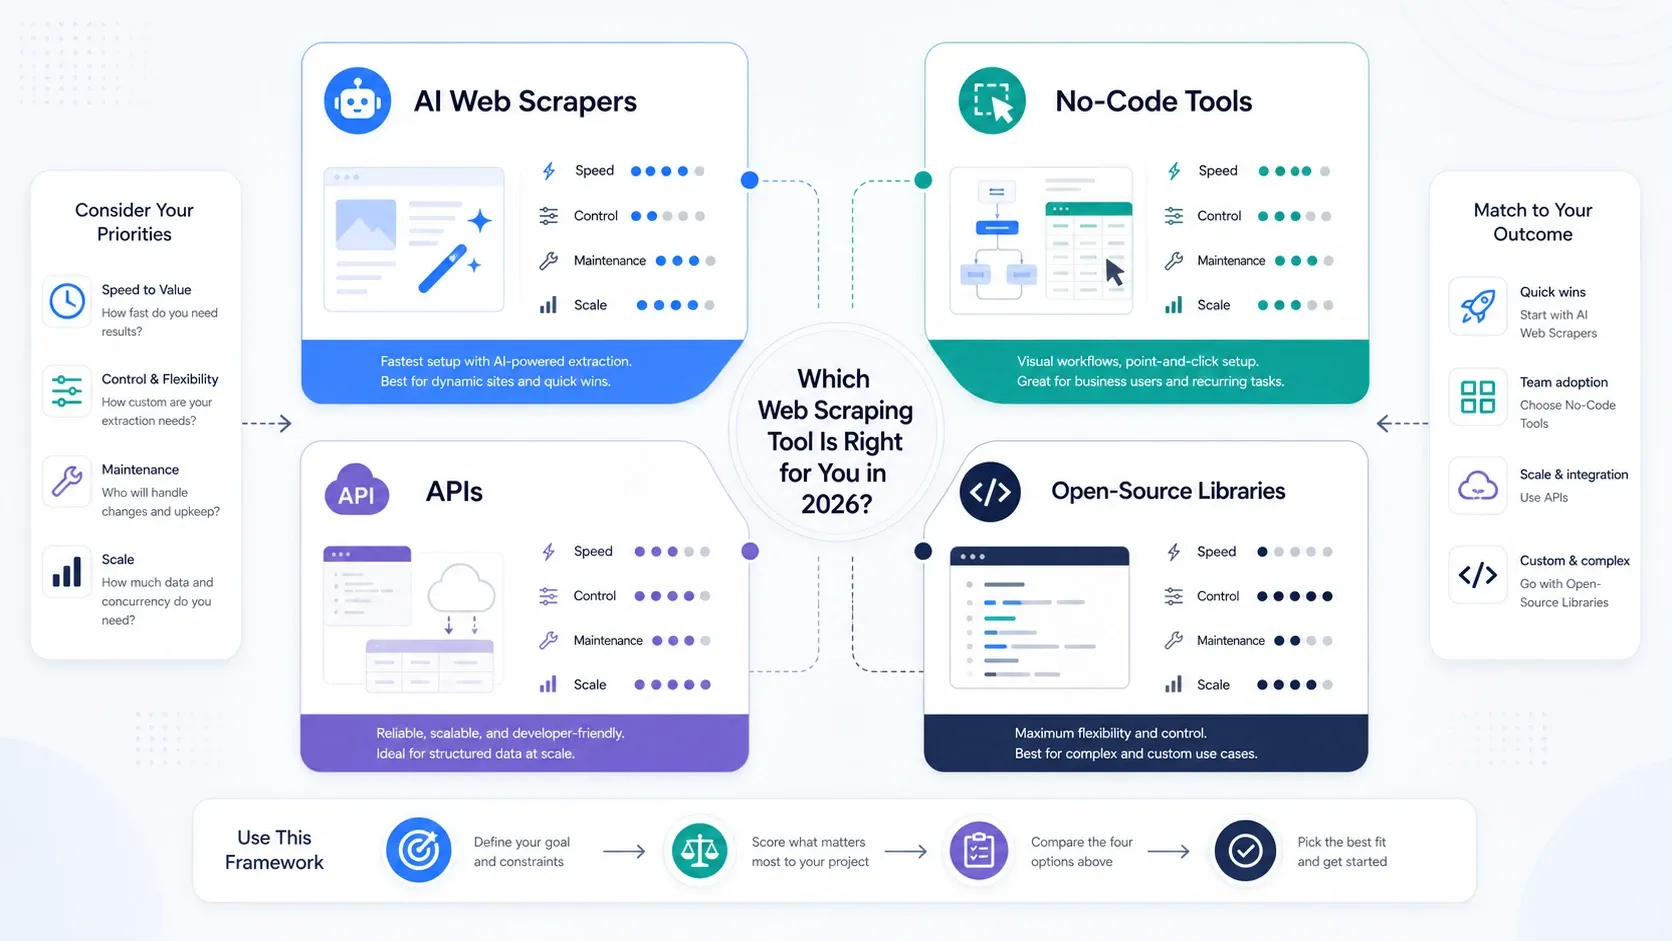
- בחרו AI web scrapers אם המטרה העיקרית שלכם היא מהירות תפעולית.
- בחרו no-code tools אם אתם צריכים יותר חלוקה לעמודים, תזמון ושליטה חוזרת במשימות.
- בחרו APIs and scraping platforms אם רינדור, רוטציה ויכולת עקיפת חסימות הם כבר צוואר הבקבוק.
- בחרו open-source libraries אם הצוות שלכם מעריך שליטה יותר מנוחות ויכול לתחזק את הסטאק פנימית.
אם הצוות שלכם עדיין מתלבט אם הסקרייפינג צריך להיות אצל התפעול או אצל הפיתוח, התחילו קודם מכלי AI או ללא קוד. תבינו מה באמת חשוב מהר יותר דרך הרצה של משימות אמיתיות מאשר דרך תכנון-יתר של הסטאק מראש.
מחלצי הווב ב-AI הטובים ביותר לצוותים עסקיים
אלו הכלים שהייתי בוחן ראשונים אם התוצאה שאתם רוצים היא דאטה מוכן לגיליון, עם מינימום הגדרה.
1. Thunderbit
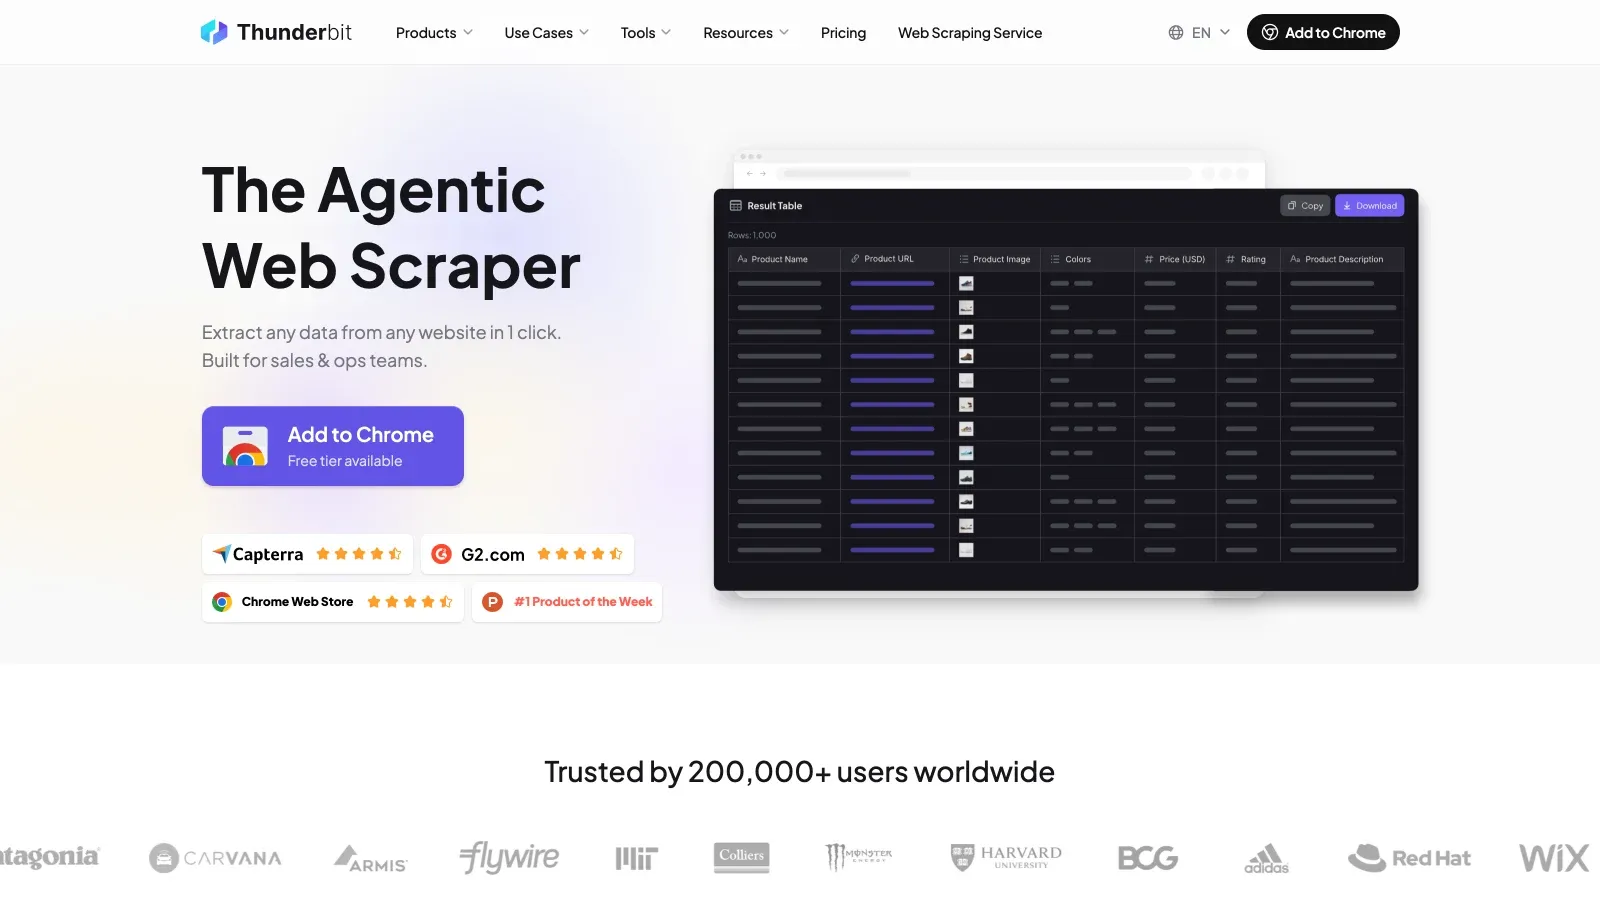
Thunderbit הוא הפתרון הכי פשוט כאן אם הצוות שלכם רוצה לחלץ דאטה מובנה בלי ללמוד סלקטורים, סקריפטינג לדפדפן או תשתית סקרייפינג. הזרימה בנויה סביב הצעות שדות ב-AI, העשרת תתי-עמודים וייצוא ישיר לכלים שכבר נמצאים בשימוש של המשתמשים העסקיים.
- מתאים במיוחד ל: מכירות, תפעול, מסחר אלקטרוני, נדל״ן וצוותים אחרים שעובדים הרבה בדפדפן.
- למה הוא בולט: הוא מקצר את זמן ההגדרה טוב יותר מכל כלי אחר ברשימה הזו עבור מי שלא כותב קוד.
- נקודת זהירות: אם אתם צריכים לוגיקת crawler עמוקה או שליטה הנדסית מאוד ייחודית, בסוף תעברו לשכבה עמוקה יותר.
- מודל תמחור: שכבה חינמית, מסלולים בתשלום בשירות עצמי ותמחור עסקי.
אם אתם רוצים לראות את הזרימה הכי מהירה בפועל לפני שמשווים עוד כלים, ההדרכה הזו היא המקום הכי משתלם להתחיל ממנו:
נסו את Thunderbit על דף אמיתי פתחו כל דף, תנו ל-AI לקרוא אותו, וייצאו טבלה מובנית בלחיצה אחת. Get Started Free
2. Browse AI
Browse AI נשאר בחירה חזקה למשתמשים עסקיים שרוצים הגדרה בקליק וגם ניטור חוזר. מודל הרובוטים שלו שימושי במיוחד כשגם סקרייפינג וגם זיהוי שינויים חשובים באותה מידה.
- מתאים במיוחד ל: ניטור דפי מחירים, דפי מתחרים וחילוץ חוזר של רשימות.
- למה הוא בולט: אונבורדינג מלוטש, רובוטים מוכנים מראש ומסלול ברור מאתר לגיליון או לפלט בסגנון API.
- נקודת זהירות: משימות מורכבות ובעלות נפח גבוה עלולות להפוך ליקרות או מסורבלות תפעולית מהר יותר מאשר בסטאקים API-first.
- מודל תמחור: מסלול חינמי, מסלולים בתשלום, שכבת פרימיום/מנוהלת.
3. Bardeen
Bardeen הוא הכי מעניין כשסקרייפינג הוא רק פעולה אחת בתוך תהליך אוטומציה רחב יותר בדפדפן. אם אתם מעבירים נתונים ל-CRM, לגיליונות או לזרימות outbound, הזווית האוטומטית שלו חשובה יותר מעומק הסקרייפינג עצמו.
- מתאים במיוחד ל: תפעול הכנסות, תהליכי לידים ואוטומציה של משימות בתוך הדפדפן.
- למה הוא בולט: סיפור אוטומציה חזק יותר מכלי חילוץ טהורים.
- נקודת זהירות: הוא לא הבחירה הכי נקייה כשהסקרייפינג עצמו מורכב וקריטי למשימה.
- מודל תמחור: מסלול חינמי ומסלולים בתשלום.
4. Diffbot
Diffbot נמצא כאן עבור צוותים שצריכים חילוץ ב-AI בקנה מידה ארגוני, לא עבור מי שמחפש את המסלול הזול או הפשוט ביותר. הוא הגיוני יותר כשהאיכות של הדאטה המובנה ואיסוף בקנה מידה גדול חשובים יותר משליטה ידנית.
- מתאים במיוחד ל: צוותי דאטה ארגוניים, intelligence על תוכן ותוכניות חילוץ גדולות.
- למה הוא בולט: חילוץ בסגנון computer vision והתמקדות חזקה בפלט מובנה.
- נקודת זהירות: מוגזם עבור צוותים קטנים ומסורבל יחסית אם השימוש שלכם קל משקל.
- מודל תמחור: מסלולים בסגנון ארגוני ותהליך מכירה מותאם.
5. Instant Data Scraper
Instant Data Scraper עדיין ראוי להיות ברשימה, כי יש לא מעט מצבים שבהם פשוט צריך עכשיו את הטבלה, הספרייה או הרשימה הגלויה. זה לא פלטפורמה, אבל לעיתים זה מספיק.
- מתאים במיוחד ל: חילוץ חד-פעמי, רשימות לידים מהירות, ספריות פשוטות וטבלאות גלויות.
- למה הוא בולט: כמעט בלי חיכוך עבור הדפים הנכונים.
- נקודת זהירות: אוטומציה מוגבלת, עומק מוגבל והתאמה חלשה לזרימות עבודה מתקדמות.
- מודל תמחור: חינם.
כלי ווב סקרייפינג ללא קוד הטובים ביותר למשימות חוזרות
ברגע שהמשימה היא יותר מסקרייפ חד-פעמי, בונים ויזואליים והרצה בענן מתחילים להיות משמעותיים.
6. Octoparse
Octoparse נשארת אחת מפלטפורמות ה-no-code החזקות ביותר אם אתם צריכים הרצות בענן, כיסוי תבניות וניהול משימות מתוחכם יותר ממה שתוסף דפדפן יכול להציע.
- מתאים במיוחד ל: אנליסטים, צוותי תמחור ומפעילים שמריצים משימות איסוף חוזרות.
- למה הוא בולט: בונה משימות בוגר, חילוץ בענן, יכולות anti-blocking ואקוסיסטם גדול של תבניות.
- נקודת זהירות: הוא חזק יותר מכלי דפדפן מבוססי AI, אבל זה גם אומר יותר עומס הגדרה.
- מודל תמחור: מסלול חינמי, בתשלום מ-69 דולר לחודש, מותאם לארגונים.
7. ParseHub
ParseHub עדיין רלוונטי למשתמשים שרוצים יותר שליטה ממחלץ AI, אבל לא רוצים לבנות קוד משלהם. הוא מתגמל סבלנות, לא מהירות.
- מתאים במיוחד ל: אנליסטים ומפעילים עם נטייה טכנית שיכולים לסבול עקומת למידה תלולה יותר.
- למה הוא בולט: לוגיקת ניווט גמישה ושליטה טובה יותר מכלי דפדפן קלים.
- נקודת זהירות: חוויית המוצר מרגישה כבדה יותר מאשר אצל שחקנים חדשים יותר, במיוחד עבור צוותי עסקים מהירים.
- מודל תמחור: מסלול חינמי ומסלולים בתשלום.
8. Web Scraper
Web Scraper עדיין מהווה נקודת התחלה סבירה אם אתם אוהבים את מודל ה-sitemap ורוצים משהו שמתחיל בדפדפן ואז מתרחב בהמשך לתזמון בענן.
- מתאים במיוחד ל: מתחילים, פרויקטי תחביב ומשימות חוזרות קטנות.
- למה הוא בולט: זרימת sitemap נגישה ואימוץ קל מהדפדפן.
- נקודת זהירות: הוא נהיה מגביל כשצריך לוגיקת חילוץ אדפטיבית יותר.
- מודל תמחור: תוסף דפדפן חינמי ומסלולי ענן בתשלום.
9. Data Miner
Data Miner הוא למעשה כלי חילוץ מהיר יותר מאשר פלטפורמת סקרייפינג מלאה. הוא עדיין שווה מקום ברשימה כי עבודה מבוססת מתכונים שימושית להרבה משימות מחקר וחיפוש לידים.
- מתאים במיוחד ל: חוקרים, צוותי growth וייצוא מהיר מתוך הדפדפן.
- למה הוא בולט: מודל מתכונים, מעט חיכוך וייצוא קל מהדפדפן.
- נקודת זהירות: לא הכלי הנכון לסקרייפינג רציני ברמת פלטפורמה.
- מודל תמחור: מסלול חינמי ומסלולים בתשלום.
פלטפורמות API הטובות ביותר כשסקייל וחסימות הופכים לבעיה האמיתית
זה השכבה שבה צוותי פיתוח מפסיקים לשאול "איך אני סורק את הדף הזה?" ומתחילים לשאול "איך אני הופך את זה לאמין בנפח גבוה?"
10. Apify
Apify היא הפלטפורמה הגמישה ביותר בקבוצה הזו אם אתם רוצים גם שוק של סקרייפרים מוכנים לשימוש וגם מקום להריץ קוד משלכם. היא מגשרת טוב יותר מרוב המתחרים בין גילוי ללא קוד לבין ביצוע למפתחים.
- מתאים במיוחד ל: צוותים היברידיים, סקרייפינג מובל-מפתחים וזרימות אוטומציה לשימוש חוזר.
- למה הוא בולט: אקוסיסטם של Actors יחד עם runtime מותאם אישית נותן טווח יוצא דופן.
- נקודת זהירות: ברגע שעוברים לקסטום, חוזרים לעולם ההנדסה והיתרון בפשטות מצטמצם.
- מודל תמחור: מסלול חינמי, starter מ-29 דולר לחודש + שימוש, שכבות שימוש וארגון גדולות יותר.
11. ScrapingBee
ScrapingBee היא בחירה טובה כשמה שאתם באמת צריכים הוא "תן לי דף מרונדר ותחסוך ממני את התשתית המגעילה". היא מתאימה היטב ליעדים כבדי JavaScript.
- מתאים במיוחד ל: מפתחים שסורקים אתרים דינמיים ואין להם הרבה רצון לעבוד על תשתית.
- למה הוא בולט: API פשוט סביב רינדור, פרוקסי ואוטומציית דפדפן.
- נקודת זהירות: זו שירות תשתית, כך שעדיין אתם אחראים על הפרסור, לוגיקת retry ואיכות downstream.
- מודל תמחור: גרסת ניסיון ומסלולים בתשלום.
12. ScraperAPI
ScraperAPI עדיין אחת הדרכים הכי קלות להוריד מעליכם ניהול פרוקסי ושיעורי הצלחה של בקשות כשצריך להתרחב מהר.
- מתאים במיוחד ל: מפתחים שצריכים לעבור מפרוטוטייפ לנפח בקצב מהיר.
- למה הוא בולט: API פשוט, קרדיטים לניסיון, מוצרים מובנים ושכבות סקייל.
- נקודת זהירות: כמו כל מוצר API-first, הוא לא מבטל את הצורך בשיקול הנדסי סביב פרסור ואימות דאטה.
- מודל תמחור: ניסיון ל-7 ימים עם 5,000 קרדיטים, בתשלום מ-49 דולר לחודש.
13. Bright Data
Bright Data היא הבחירה הכבדה כשיכולת עקיפת חסימות, מלאי פרוקסי ואיסוף מנוהל חשובים יותר מפשטות הכלי.
- מתאים במיוחד ל: תכניות ארגוניות, איסוף בקנה מידה גדול ורגיש לציות, ואיסוף דאטה מנוהל.
- למה הוא בולט: רוחב של מוצרי פרוקסי, סקרייפר, דפדפן ודאטהסטים.
- נקודת זהירות: יקרה וקל לקנות מעבר לצורך אם הזרימה המרכזית שלכם עדיין יחסית פשוטה.
- מודל תמחור: תמחור לפי שימוש ולפי מוצר עבור APIs, פרוקסי ושירותים מנוהלים.
14. Oxylabs
Oxylabs נשארת בחירה חזקה לצוותים שקונים סקרייפינג כתשתית ולא ככלי דפדפן. היא רלוונטית במיוחד כשאמינות ובשלות רכש חשובות.
- מתאים במיוחד ל: איסוף ארגוני, ניטור מחירים, ניטור SEO ומחקר שוק.
- למה הוא בולט: סיפור תשתיתי חזק, עומק בפרוקסי ותהליך רכישה ארגוני ברור יותר.
- נקודת זהירות: לא אידיאלי אם הצוות שלכם מחפש זרימת self-serve קלילה.
- מודל תמחור: Web Scraper API מתחיל מ-49 דולר לחודש; מוצרים אחרים משתנים לפי יחידה ושימוש.
15. Zyte
Zyte עדיין ראויה לשיקול רציני מצד צוותי פיתוח ודאטה שרוצים anti-detection, פעולות דפדפן, רינדור JavaScript ו-IP rotating בתוך סיפור API-first אחד.
- מתאים במיוחד ל: צוותים טכניים שבונים מערכות חילוץ חוזרות.
- למה הוא בולט: פעולות דפדפן, רינדור JS, רוטציית IP ועמדת anti-bot בתוך סטאק אחד.
- נקודת זהירות: טובה יותר לצוותים עם אחריות הנדסית מאשר למפעילים לא-טכניים.
- מודל תמחור: ניסיון עם 5 דולר קרדיט חינם והתחייבויות חודשיות לפי שימוש.
בדקו זרימה קלה יותר לפני שתבנו מערכת כבדה מדי לפני שאתם מתחייבים לפרוקסי ולקוד, ראו עד כמה מחלץ AI בלחיצה אחת מגיע. Get Started Free
הספריות הפתוחות הטובות ביותר למפתחים שרוצים שליטה מלאה
אם אתם רוצים להחזיק את סטאק הסקרייפינג מקצה לקצה, אלה אבני הבניין הכי שימושיות ב-2026.
16. Selenium
Selenium עדיין שימושי כשצריך דיוק של אינטראקציית QA, תהליכי אוטומציית דפדפן מדור קודם, או שליטה מפורשת מאוד בזרימת המשתמש.
- מתאים במיוחד ל: אוטומציה כבדה באינטראקציה, חפיפה ל-QA ואתרים שבהם התנהגות הדפדפן חשובה יותר מתפוקת crawl.
- למה הוא בולט: אקוסיסטם בוגר ותמיכה רחבה בדפדפנים.
- נקודת זהירות: כבד ואיטי יותר מכלי דפדפן חדשים יותר עבור הרבה עומסי סקרייפינג.
- מודל תמחור: חינם וקוד פתוח.
17. BeautifulSoup4
BeautifulSoup הוא לא פלטפורמת סקרייפינג מלאה, אבל הוא עדיין אחת הדרכים הכי קלות לפרסר HTML מבולגן בזרימות עבודה קלות.
- מתאים במיוחד ל: מתחילים, סקריפטים מהירים ומשימות שמבוססות קודם כל על פרסור.
- למה הוא בולט: API פשוט ועומס קוגניטיבי נמוך.
- נקודת זהירות: צריך לשלב אותו עם request, דפדפן או כלי crawling; לבדו הוא רק פרסר.
- מודל תמחור: חינם וקוד פתוח.
18. Scrapy
Scrapy עדיין התשובה הכי טובה כשצריך מסגרת crawling אמיתית ולא אוסף של סקריפטים.
- מתאים במיוחד ל: זחלים מותאמים אישית לייצור ו-pipelines של דאטה בבעלות פנימית.
- למה הוא בולט: ביצועים גבוהים, pipelines, middleware והרחבה לטווח ארוך.
- נקודת זהירות: יש כאן עומס הנדסי אמיתי, ויעדים כבדי JS לרוב דורשים כלי משלים.
- מודל תמחור: חינם וקוד פתוח.
19. Puppeteer
Puppeteer נשאר התאמה חזקה לצוותי Node-first שרוצים שליטה ישירה ב-Chromium ובסקריפטינג של דפדפן.
- מתאים במיוחד ל: סקרייפינג מבוסס Node, צילומי מסך ומשימות אוטומציית דפדפן.
- למה הוא בולט: שליטה ישירה ועוצמתית בהתנהגות Chromium.
- נקודת זהירות: סיפור דפדפנים מצומצם יותר מ-Playwright ועדיין צורך הרבה משאבים בקנה מידה גדול.
- מודל תמחור: חינם וקוד פתוח.
20. Playwright
Playwright הוא ברירת המחדל שלי לאוטומציית דפדפן מודרנית אם הצוות שלכם כותב קוד ורוצה אבסטרקציה חדשה יותר מ-Selenium.
- מתאים במיוחד ל: אוטומציית דפדפן מודרנית, אתרים כבדי JavaScript וצוותים שאכפת להם מחוויית הפיתוח.
- למה הוא בולט: מודל רב-דפדפנים חזק, התנהגות המתנה אמינה ו-API נקי.
- נקודת זהירות: עדיין אתם אחראים על תשתית הדפדפן, קונקרנציה, drift בסלקטורים ואימות דאטה.
- מודל תמחור: חינם וקוד פתוח.
הרשימה המקוצרת שלי לפי סוג צוות
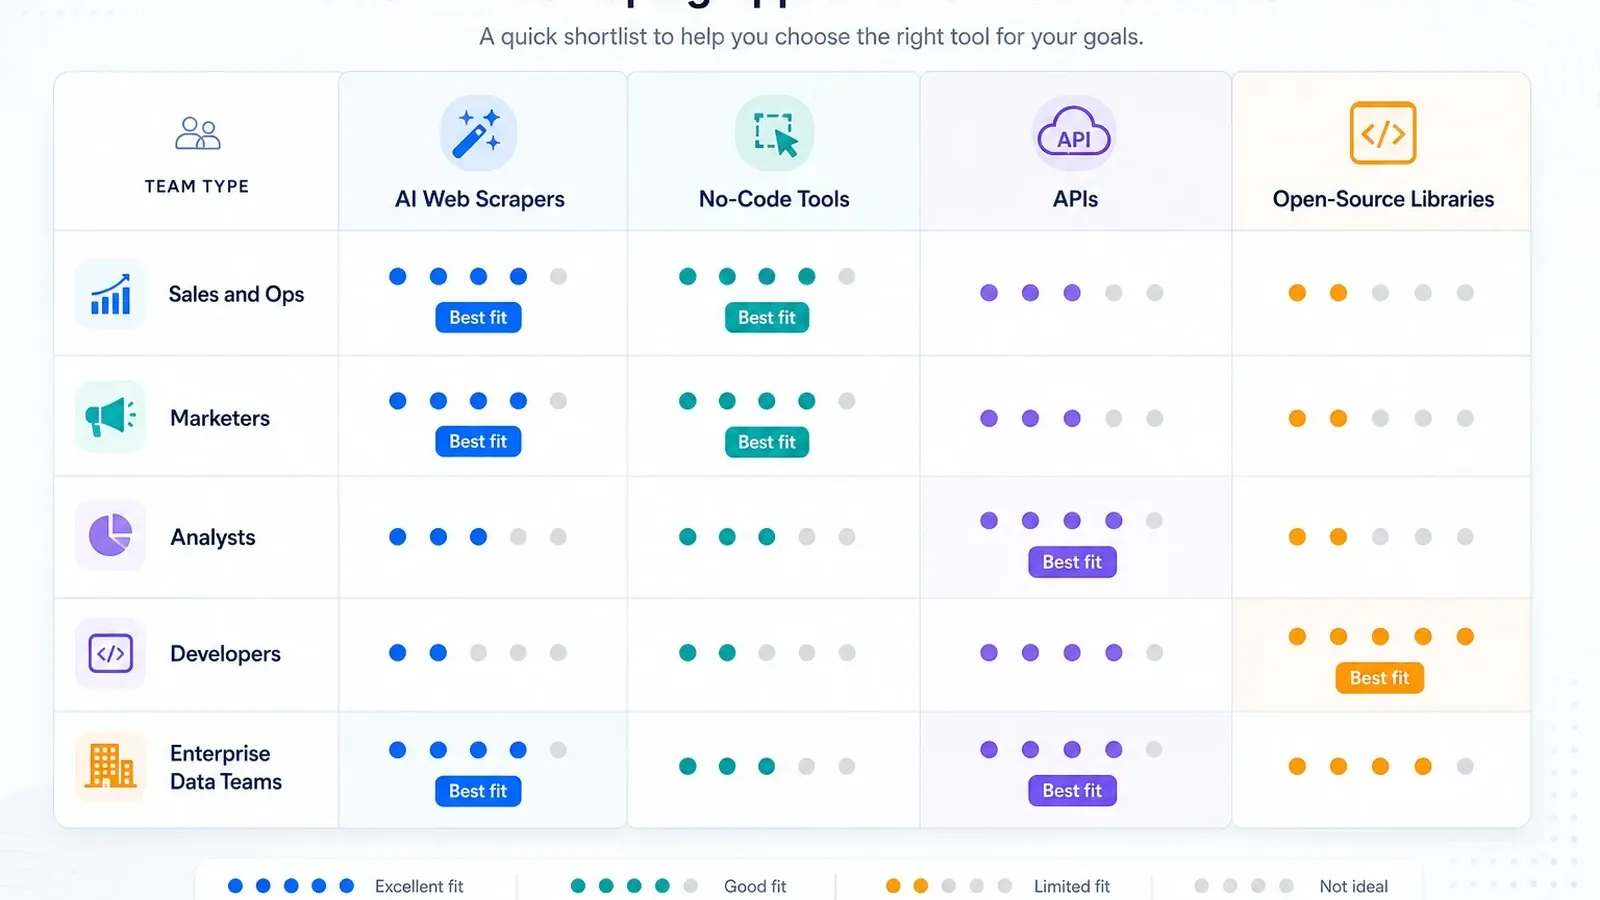
- צוותי מכירות ותפעול: התחילו עם Thunderbit, ואז בדקו את Browse AI אם ניטור חשוב יותר מהעשרת תתי-עמודים.
- אנליסטים וצוותי מחקר: Octoparse קודם כול אם יש לכם יותר מדי משימות חוזרות מכדי שכלי תוסף דפדפן יישאו בנוחות.
- צוותי GTM עתירי אוטומציה: Bardeen אם הסקרייפינג הוא רק שלב אחד בתוך תהליך רחב יותר.
- צוותי פיתוח שבונים כלי פנימי: Apify, Zyte, ScraperAPI או Playwright, תלוי בכמה שליטה על הסטאק אתם רוצים.
- תוכניות דאטה ארגוניות: Bright Data, Oxylabs, Diffbot ו-Zyte הן שיחות התשתית הרציניות.
מתי לרדת לשכבה עמוקה יותר
השתמשו בכלל הזה:
- הישארו עם כלי AI עד שמגיעים למגבלות של חזרתיות או מקרים קיצוניים.
- עברו ל-כלים ללא קוד כשתזמון, חלוקה לעמודים, anti-blocking או הרצה בענן חשובים יותר מפשטות של קליק אחד.
- עברו ל-APIs כששיעור ההצלחה מול חסימות, רינדור JavaScript ו-concurrency הופכים לצווארי הבקבוק האמיתיים.
- עברו ל-open-source libraries כשעלות ההפשטה של ספק הופכת גבוהה יותר מעלות הבעלות על כל הסטאק.
רוב הצוותים יורדים לשכבה עמוקה יותר מוקדם מדי. זו אחת הטעויות הנפוצות ביותר שאני רואה.
מסקנה סופית
עבור רוב הצוותים הלא-טכניים, התשובה הנכונה ב-2026 היא לא "המחלץ החזק ביותר". היא הכלי שמכניס דאטה מדויק לתהליך הבא עם מינימום תחזוקה. זו הסיבה שכלי AI-first ממשיכים לנצח אצל מפעילים, בעוד ש-API וסטאקים בקוד פתוח נשארים ההתאמה הטובה יותר לצוותים טכניים עם דרישות סקייל ברורות.
אם אתם רוצים את המסלול הקצר ביותר מדף לפלט מובנה, התחילו עם Thunderbit. אם אתם כבר יודעים שהעבודה שלכם דורשת תשתית כבדה, קפצו ישר לשכבות ה-API והפיתוח. רק אל תבלבלו בין מורכבות לבין תחכום.
התחילו עם הכלי הכי קל שבאמת יודע לבצע את העבודה Get Started Free
שאלות נפוצות
1. מהו כלי הווב סקרייפינג הטוב ביותר למשתמשים לא-טכניים ב-2026?
עבור רוב המשתמשים הלא-טכניים, כלי AI-first כמו Thunderbit ו-Browse AI מציעים את המסלול הכי מהיר לדאטה שימושי, כי הם מצמצמים עבודה עם סלקטורים, חיכוך בהגדרה ועומס תחזוקה.
2. במה כדאי לבחור אם האתרים שלי כבדי JavaScript או חוסמים בקשות באגרסיביות?
כדאי לעבור לכיוון ScrapingBee, ScraperAPI, Zyte, Bright Data, Oxylabs, Playwright או Selenium, בהתאם לשאלה אם אתם רוצים שירות מנוהל או שליטה הנדסית ישירה.
3. האם כלים ללא קוד עדיין רלוונטיים עכשיו כשמחלצי AI טובים יותר?
כן. כלים ללא קוד כמו Octoparse ו-ParseHub עדיין חשובים כשצריך שליטה מפורשת יותר בלוגיקת המשימה, בהרצה בענן ובניהול חוזר של משימות.
4. אילו כלים הכי הגיוניים לצוותי פיתוח?
Apify, Zyte, ScraperAPI, Scrapy, Playwright, Puppeteer ו-Selenium הן הבחירות הטבעיות ביותר כשהמפתחים מחזיקים בבעלות על הזרימה.
5. איך אפשר לצמצם מהר בלי להעמיק יותר מדי במחקר?
קודם כל בוחרים את סוג הכלי, לא את הספק. מחליטים אם צריך פשטות של AI, שליטה ללא קוד, תשתית API או בעלות בקוד פתוח. אחר כך משווים מוצרים בתוך אותה שכבה.
קריאה קשורה




