
Google מעבדת הרבה יותר מ-8.5 מיליארד חיפושים ביום—יש הערכות שמציבות את המספר קרוב יותר ל-14 מיליארד—והנתון הזה ממשיך לעלות. כל נתוני החיפוש האלה הם מכרה זהב עבור צוותי SEO, צוותי Sales Ops, אנליסטים של ecommerce, וביותר ויותר מקרים גם עבור סוכני AI שזקוקים לראיות עדכניות מהאינטרנט. הבעיה? בחירה ב-SERP API ב-2026 מרגישה פחות כמו בחירת כלי ויותר כמו ניסיון לפענח מבוך של דפי תמחור, מערכות קרדיטים, והבטחות מעורפלות על "JSON מובנה".
במהלך השבועות האחרונים בדקתי לעומק שמונה ספקי SERP API—מדדתי זמני תגובה, נרמלתי תמחור בין מודלים מבלבלים של חיוב, ובדקתי אילו תכונות SERP כל אחד מהם באמת ממיר לשדות מובנים. המטרה: לתת לכם השוואה הוגנת, אחד-על-אחד, שלא תמצאו באף מקום אחר. אנחנו נסקור מהירות, עלות אמיתית בקנה מידה גדול, כיסוי פרסור, מוכנות ל-agentic AI, ואמינות ברמת production. אם נמאס לכם מ"אתם משווים דפי תמחור, לא הוצאה אמיתית" (ציטוט אמיתי מ-שרשור Reddit שמצאתי), המאמר הזה בשבילכם.
למה צריך SERP API ב-2026 (ולמה כל כך קשה לבחור אחד)
SERP API הוא שירות בענן ששולח שאילתת חיפוש למנוע חיפוש ומחזיר את דף התוצאות בפורמט קריא למכונה—בדרך כלל JSON. במקום לבנות בעצמכם רוטציית פרוקסים, טיפול ב-CAPTCHA, רינדור דפדפן ו-parsers, פשוט קוראים ל-endpoint ומקבלים נתונים מובנים. רעיון פשוט, שוק מורכב.
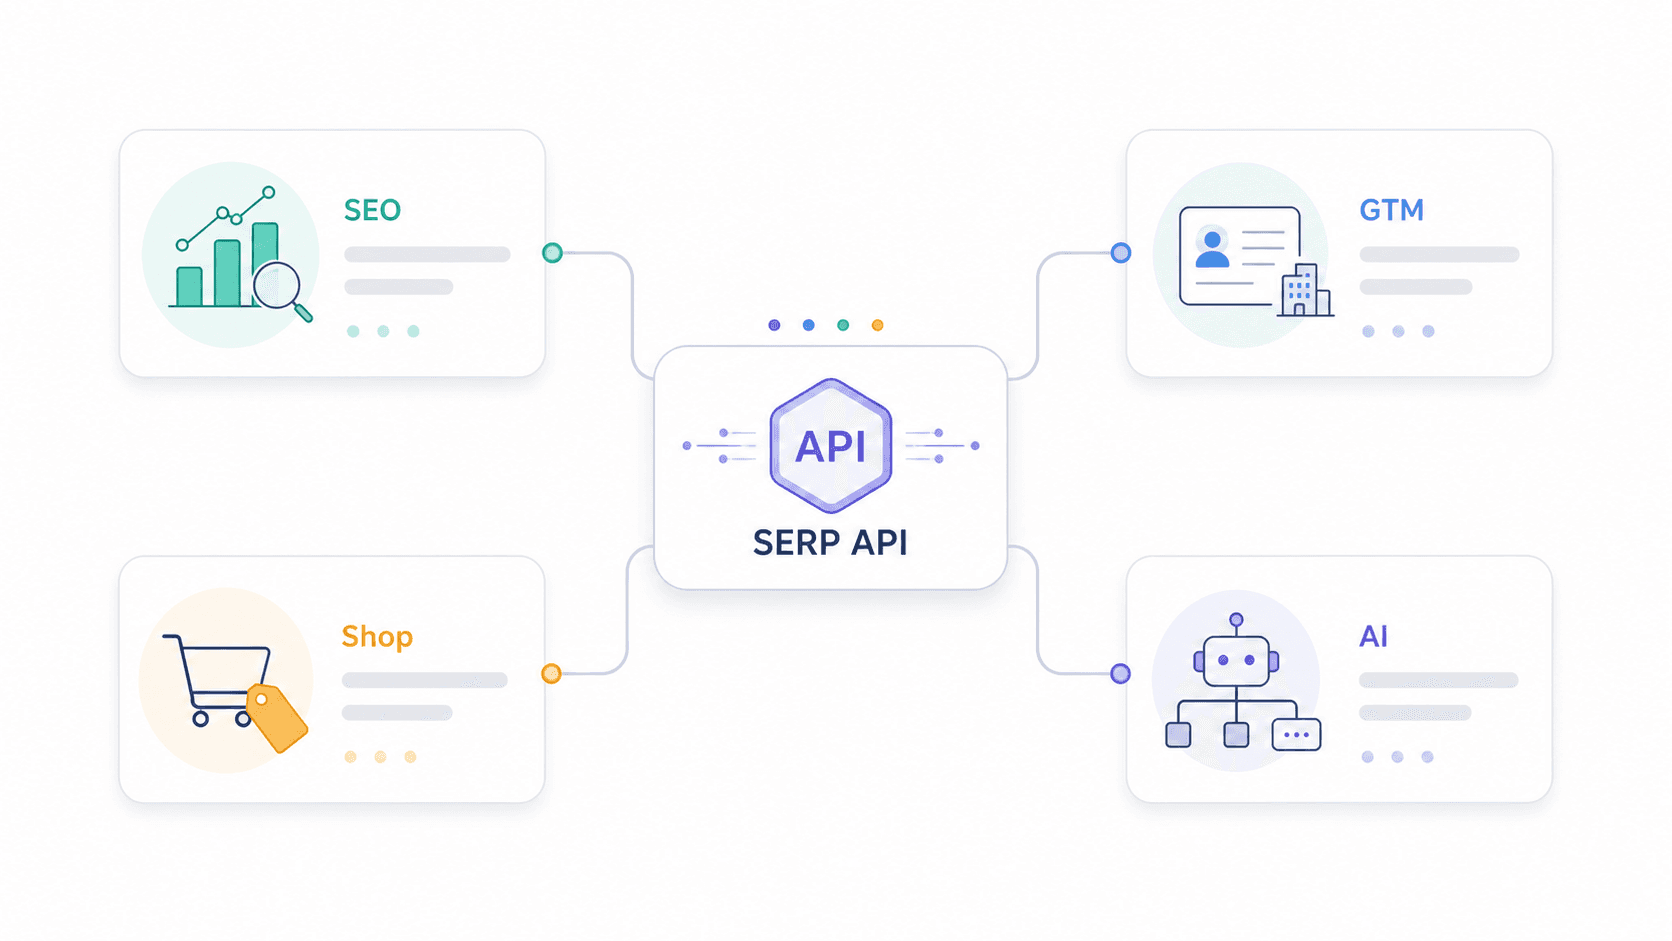
שימושי ה-SERP כבר מזמן חורגים ממעקב דירוגים:
- צוותי SEO צריכים דירוגים, בעלות על snippets, שאלות People Also Ask ונראות מול מתחרים.
- צוותי Sales ו-GTM משתמשים ב-SERP כדי לאתר חברות, דפי ביקורות, ספריות עסקיות ואותות רכישה.
- צוותי ecommerce עוקבים אחרי Google Shopping, מודעות ממומנות ותמחור של מתחרים.
- מפתחי AI מזינים נתוני SERP ל-LLM agents, ל-pipelines של RAG ולכלי workflow כמו n8n ו-LangChain.
שוק ה-web scraping צפוי להגיע ל-2.23 מיליארד דולר עד 2031, עם צמיחה שנתית של כ-13.78%. SERP APIs הם חלק משמעותי מהעוגה הזו.
וזו ליבת התסכול: כל ספק טוען ל-"JSON מובנה", אבל רכיבי ה-SERP שבאמת מפוענחים—PAA, knowledge panels, local packs, shopping ads, featured snippets—שונים מאוד בין ספק לספק. גם התמחור מבולגן באותה מידה. יש שמחייבים לפי חיפוש, יש לפי קרדיט, יש לפי תוצאה, ויש שמחייבים אחרת לפי מהירות או גיאוגרפיה. אחד המשתמשים ב-Reddit ניסח זאת היטב: "SerpApi מחייבת לפי חיפוש מוצלח, ScraperAPI עוטפת הכול בקרדיטים, ו-Serperdev נראה זול עד שממפים את הקרדיטים לעומס האמיתי שלך."
המאמר הזה משלים את החסר שלא מצאתי בשום מקום אחר: מטריצת פרסור שמראה מה כל API באמת מחזיר, תמחור מנורמל ב-1K/10K/100K שאילתות, התאמה ל-AI agents, ונתוני מוכנות ל-production.
איך בדקנו: הקריטריונים לבחירת SERP API הטוב ביותר
הערכתי כל ספק לפי שמונה ממדים שמתחברים ישירות למה שמשתמשי production באמת צריכים. רוב המאמרים המתחרים מכסים שתיים או שלוש מהנקודות האלה בצורה שטחית. אני רציתי את כל שמונה, עם הוכחות.
מהירות וזמן תגובה. הסתמכתי על בנצ'מרקים של צד שלישי—בפרט ההשוואה של HasData—ועל התיעוד של הספקים. מהירות חשובה כשבונים dashboards בזמן אמת או AI agents שמבצעים tool-calling ולא יכולים לחכות 30 שניות לתשובה.
תמחור בקנה מידה גדול (1K, 10K, 100K שאילתות). נרמלתי את התמחור של כל ספק לעלות לכל 1,000 שאילתות מוצלחות. זו הדרך היחידה להשוות בצורה הוגנת בין מודלים מבוססי קרדיטים, מנויים וחיוב לפי שימוש.
אילו תכונות SERP מפוענחות (מעבר לתוצאות אורגניות). בדקתי תיעוד ותגובות לדוגמה כדי לוודא אילו רכיבי SERP כל API מחזיר כשדות מובנים—not רק HTML גולמי.
זמינות של Free Tier ושל Pay-As-You-Go. כניסה עם התחייבות נמוכה חשובה. אם אי אפשר לבדוק ספק על העומס האמיתי שלכם לפני שמתחייבים למאות דולרים, זה דגל אדום.
שילוב עם AI ואוטומציה. ב-2026, יותר צוותים צריכים SERP APIs שמזינים AI agents מאשר dashboards. יציבות סכימה, פלט נקי והמרה ל-Markdown חשובים לצריכה ע"י LLMs בהמשך הדרך.
תמיכה בכמה מנועי חיפוש. רוב המאמרים מתמקדים כמעט רק ב-Google. בדקתי אילו ספקים תומכים גם ב-Bing, Yandex, DuckDuckGo, Baidu ועוד.
Rate Limits ומוכנות ל-production. כמעט אף מאמר מתחרה לא משווה באופן שיטתי מגבלות קצב, מדיניות retry או SLA-ים. אבל צוותים שמתרחבים לאלפי שאילתות ביום צריכים את המידע הזה.
נוחות למפתחים. איכות התיעוד, זמינות SDKs וזמן עד לתוצאה ראשונה.
1. Thunderbit
Thunderbit נוקטת גישה שונה מהותית מ-SERP APIs מסורתיים. במקום להציע endpoints קבועים שמפענחים רכיבי SERP מוגדרים מראש, ה-Extract API של Thunderbit מאפשר לכם להגדיר JSON Schema משלכם—וה-AI מחלץ בדיוק את השדות שאתם מציינים מכל דף תוצאות חיפוש. ה-Distill API ממיר כל URL ל-Markdown נקי ומוכן ל-LLM.
זה אומר ש-Thunderbit עובדת על Google, Bing, Yandex, DuckDuckGo או כל מנוע חיפוש אחר—ה-AI קורא את הדף מחדש בכל פעם במקום להסתמך על selectors מקובעים. מבני SERP משתנים כל הזמן. אתם לא צריכים לחכות שספק יעדכן parser.
תכונות מרכזיות
- Extract API: הגדירו JSON Schema מותאם אישית (תוצאות אורגניות, שאלות PAA, עסקים ב-local pack, מוצרים ב-shopping—כל מה שצריך) וקבלו בדיוק את השדות האלה בחזרה כנתונים מובנים.
- Distill API: המרה של כל דף SERP ל-Markdown נקי—אידיאלי ל-pipelines של RAG ולסיכום באמצעות LLM.
- תמיכה מרובת מנועים כברירת מחדל: עובד על כל דף חיפוש נגיש, לא רק על Google.
- עיבוד באצווה: טיפול במספר URLs במקביל.
- טיפול מובנה ב-anti-bot: פתרון CAPTCHA, רינדור JS ורוטציית פרוקסים כלולים.
- מגבלות קצב לפי מסלול: Free (600 יחידות חד-פעמי, 2 במקביל), Starter (60,000 יחידות לחודש, 30 במקביל), Pro (600,000 יחידות לחודש, 50 במקביל).
תמחור
מודל מבוסס קרדיטים. Distill עולה קרדיט אחד לעמוד; Extract עולה 20 קרדיטים לעמוד. יש קרדיטים חינמיים לבדיקה. לפי חישוב של תכנית שנתית, העלות השולית של Distill יכולה להיות נמוכה עד כ-0.80 דולר ל-1K עמודים, בעוד Extract מגיע לכ-16 דולר ל-1K עמודים בניצול מלא. הערך של Extract הוא שמקבלים בדיוק את הסכימה שהמערכת בהמשך הדרך צריכה—בלי post-processing.
בדקו את Thunderbit Pricing לחבילות העדכניות.
נסו את Thunderbit לחילוץ SERP באמצעות AI
הכי מתאים ל
תהליכי עבודה של AI agents, pipelines של RAG, scraping מרובה מנועים, צוותים שצריכים סכימה גמישה במקום פלט קבוע, וכל מי שנמאס לו לחכות שספק יוסיף תמיכה לתכונת SERP חדשה.
2. SerpApi
SerpApi היא הוותיקה בתחום הזה—פועלת מאז 2016 עם המגוון הרחב ביותר של endpoints ייעודיים ל-Google. היא מכסה Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos ועוד.
תכונות מרכזיות
- Endpoints ייעודיים למוצרי Google שונים עם geotargeting בשל ומדויק (עד רמת עיר).
- פענוח מובנה של PAA, knowledge panels, local pack, ads, תוצאות shopping, featured snippets, answer boxes וחיפושים קשורים.
- תיעוד מתוחזק היטב וספריות לקוח בשפות רבות.
תמחור
250 חיפושים חינם בחודש. תכנית Starter: 25 דולר לחודש עבור 1,000 חיפושים (כלומר 25 דולר ל-1K). תכנית Developer (מסומנת כ-"Most popular"): 75 דולר לחודש עבור 5,000 חיפושים (~15 דולר ל-1K). Big Data: 275 דולר לחודש עבור 30,000 חיפושים (~9.17 דולר ל-1K). אין אפשרות פשוטה של pay-as-you-go—זה מבוסס חבילות מנוי.
מהירות ואמינות
הבנצ'מרק של HasData מדווח על כ-5.49 שניות בממוצע—לא הכי מהיר, אבל יציב. SerpApi מצהירה על SLA של 99.95% uptime במסלולים בתשלום, ומגבלות בקשות במקביל משתנות לפי מסלול.
הכי מתאים ל
צוותים שצריכים את הכיסוי הרחב ביותר למוצרי Google (Maps, Scholar, Shopping, Jobs) עם דיוק גבוה וסכימות יציבות. פרויקטים ארגוניים עם תקציב לתמחור פרימיום.
3. Serper
Serper היא הבחירה של מהירות ועלות. זהו שחקן חדש יחסית שמתמקד ב-scraping מהיר של Google SERP במחיר תחרותי מאוד, והיא הפכה פופולרית בקהילות n8n ו-LangChain לשילוב עם AI agents.
תכונות מרכזיות
- פלט JSON נקי ל-Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents ו-Autocomplete.
- התקנה מינימלית—אפשר להתחיל לשלוף תוצאות תוך פחות מדקה.
- פשוטה מספיק כדי ש-frameworks ל-AI agents ישלבו אותה בצורה טבעית.
תמחור
2,500 שאילתות חינם בהרשמה. מחיר כניסה סביב 0.001 דולר לחיפוש, ויורד לכ-0.00075 דולר בנפח גבוה. נוח מאוד ל-pay-as-you-go. הסתייגות אחת: בקשה ליותר מ-10 תוצאות לשאילתה עשויה לעלות 2 קרדיטים (כדאי לאמת את ההתנהגות הנוכחית בדשבורד שלכם).
מהירות ואמינות
בין המהירים בבנצ'מרקים—HasData מדווחת על כ-2.87 שניות בממוצע. התמיכה היא באימייל בלבד, והצוות שומר על פרופיל ציבורי יחסית נמוך, מה שמרתיע חלק מהמשתמשים. בעומס מקבילי גבוה מאוד, כמה reviewers מציינים חששות לאמינות. אבל לרוב העומסים היא יציבה.
הכי מתאים ל
פרויקטים עם רגישות לתקציב, סטארטאפים, ושילוב AI agents שזקוקים לנתוני Google SERP מהירים וזולים. מעקב דירוגים בהיקף גבוה כשעלות לשאילתה היא המגבלה העיקרית.
4. Scrapingdog
Scrapingdog קיימת בשוק יותר מ-5 שנים ומופיעה באופן עקבי כפתרון המהיר ביותר בבנצ'מרקים של צד שלישי. HasData מדדה אותה בכ-~1.25 שניות זמן תגובה ממוצע עם שיעור הצלחה של 100%.
תכונות מרכזיות
- Google SERP API מחזיר תוצאות אורגניות, PAA, featured snippets, ads ותוצאות מקומיות כ-JSON מובנה.
- זמין גם HTML גולמי וגם JSON מפוענח.
- תיעוד בשפות רבות עם קטעי קוד לרוב שפות התכנות—התחלה תוך דקות, לא שעות.
- תמיכה 24/7.
תמחור
200 קרדיטים חינם בחודש. תכניות בתשלום מתחילות סביב 40 דולר לחודש. תמחור לפי קריאה מתחיל בכ-0.001 דולר ויורד בצורה חדה בנפח גבוה—יש השוואות שמציינות מחירים נמוכים עד 0.000058 דולר ברמות הגבוהות ביותר.
מהירות ואמינות
המספרים של המהירות באמת מרשימים. אם ה-workflow שלכם רגיש ל-latency ואתם מבצעים חילוץ Google SERP בהיקף גבוה ובסכימה קבועה, קשה להתחרות ב-Scrapingdog על זמן תגובה גולמי.
הכי מתאים ל
כלי SEO ומעקב דירוגים בהיקף גבוה שצריכים latency נמוך ועלות נמוכה. צוותים שבונים מערכות production שבהן כל מילישנייה של תגובת API חשובה.
5. DataForSEO
DataForSEO היא לא רק SERP API—זו חבילת APIs שלמה שנועדה לחברות שבונות מוצרי SEO. היא מכסה SERP, מילות מפתח, backlinks, נתוני עסקים, Google Ads, Trends ועוד.
תכונות מרכזיות
- פרסור מקיף במיוחד של תכונות SERP—אורגני, ממומן, local pack, knowledge graph, PAA, featured snippets, shopping, images, videos, top stories ועוד.
- שני מצבים: Live (סינכרוני) ל-dashboards בזמן אמת, ו-Standard (אסינכרוני) ל-workflows באצווה שבהם תורים נשלחים והתוצאות נמשכות מאוחר יותר.
- תמיכה במנועים מרובים: Google, Bing, Yahoo, Baidu, Naver, Seznam ועוד.
תמחור
מודל pay-as-you-go, אבל העלות משתנה לפי endpoint, מנוע, מכשיר, עדיפות ומצב. תמחור SERP נע בדרך כלל סביב 0.0006 עד 0.002 דולר למשימה עבור Google organic, בהתאם ל-standard מול live ולהגדרות העדיפות. התיעוד צפוף—כדאי להתכונן לזמן עם מחשבון התמחור. DataForSEO Pricing.
מהירות ואמינות
מצב Standard האסינכרוני יכול להיות איטי יותר (~10 שניות) כי המשימות נכנסות לתור. מצבי Live/מהירות גבוהה עולים יותר אבל מתאימים ל-dashboards בזמן אמת. ותק רב, יציבות מוכחת, ותמיכה ארגונית זמינה.
הכי מתאים ל
חברות SaaS שבונות פלטפורמות SEO, dashboards למעקב דירוגים וכלי מחקר מילות מפתח. צוותים שנוחים להם לעבוד עם תיעוד מורכב ותשתית ברמת enterprise.
6. Bright Data
Bright Data היא המשקל הכבד של הארגונים. ה-SERP API שלה הוא רק מוצר אחד מתוך רבים—פרוקסים, datasets, Web Unlocker וכלי scraping. הצעת הערך היא סקייל, אמינות ותשתית.
תכונות מרכזיות
- Endpoints ייעודיים ל-Google Maps, Shopping וחיפוש כללי—בנוסף לתמיכה במנועים מרובים באמצעות תשתית פרוקסים שמכסה Bing, Yahoo, Yandex ו-DuckDuckGo.
- טוענת לשיעור הצלחה של 100% עם טכנולוגיית unblocking מובנית.
- המקום שבו Bright Data באמת מצטיינת: geotargeting, concurrency ו-unblocking בקנה מידה ארגוני.
תמחור
מכוון לארגונים. התמחור הציבורי מציג אפשרויות pay-as-you-go ומנויים, והרבה השוואות מציינות התחייבות התחלתית של כ-499 דולר לחודש. עלות לפי קריאה מתחילה סביב 0.005 דולר ויורדת עם הנפח. Bright Data Pricing. יש free tier זמין (5,000 קרדיטים בחודש, בלי כרטיס אשראי).
מהירות ואמינות
בנצ'מרקים מציגים לא פעם 2 עד 5.58 שניות. הסיבה לקנות את Bright Data היא לא זמן תגובה חציוני גולמי—אלא SLA ארגוני, תמיכה ייעודית ותשתית שמטפלת במיליוני בקשות במקביל בלי דעיכה. התיעוד על rate limits ממליץ להעלות עומס בהדרגה.
הכי מתאים ל
צוותי enterprise שאוספים מיליוני SERPs בחודש. ארגונים שצריכים נתוני Google Maps/עסקים מקומיים בקנה מידה גדול. צוותים שכבר משתמשים במוצרי הפרוקסים של Bright Data.
7. ScraperAPI
ScraperAPI היא API כללית ל-web scraping שמציעה גם endpoints מובנים ל-Google SERP. זו הבחירה של "כלי אחד להכול"—קל לשילוב, עם מאגר של 40M+ כתובות IP.
תכונות מרכזיות
- Endpoints לנתונים מובנים עבור Google Search, Shopping, News ו-Jobs.
- אנטי-חסימה מבוסס machine learning ופתרון CAPTCHA, עם רינדור JavaScript כלול ללא תוספת מחיר.
- תמיכה ב-geotargeting לתוצאות מקומיות.
תמחור
ניסיון חינם ל-7 ימים עם 5,000 קרדיטים. תכניות בתשלום מתחילות סביב 49 דולר לחודש. המלכוד: קריאות SERP עשויות לצרוך מספר קרדיטים שונה מבקשות scraping רגילות, לכן תמיד צריך לנרמל לפי מספר שאילתות SERP מוצלחות בפועל. ScraperAPI Pricing.
מהירות ואמינות
והנה החלק הכנה: הבנצ'מרק של HasData מדווח על כ-33.66 שניות בממוצע לשאילתות SERP. זה איטי משמעותית מ-SERP APIs ייעודיים. שיעור הצלחה גבוה (99.9%), אבל ה-latency הופך אותה לפחות מתאימה לאפליקציות בזמן אמת. עדיפה לעיבוד באצווה.
הכי מתאים ל
צוותים שצריכים פתרון web scraping כללי עם SERP כתוספת. פרויקטים שבהם מהירות פחות קריטית מאמינות ונוחות התקנה. מפתחים שכבר משתמשים ב-ScraperAPI למשימות scraping אחרות ורוצים לאחד ספקים.
8. Apify
Apify היא לא SERP API טהור. זו פלטפורמת scraping ואוטומציה שנבנתה סביב "Actors"—סקריפטים לשימוש חוזר למשימות כמו scraping של Google Search, חילוץ Maps ואוטומציית workflows. תחשבו על זה כמו marketplace שבו בוחרים (או בונים) את הסקרייפר שמתאים בדיוק לצורך שלכם.
תכונות מרכזיות
- Marketplace של Google SERP actors מוכנים מראש עם כיסוי תכונות משתנה.
- התאמה אישית גבוהה—אפשר לבנות workflows מותאמים, לחבר actors זה לזה, ולתזמן הרצות.
- פלט JSON; גמישות לפרש תכונות SERP ספציפיות דרך הגדרות ה-actor.
- מתאים במיוחד לשילוב חילוץ SERP עם משימות scraping ואוטומציה נוספות.
תמחור
Free tier עם קרדיטים חודשיים לפלטפורמה (שווי של כ-5 דולר, בערך 1,400 תוצאות). תכניות בתשלום מתחילות סביב 29 דולר לחודש. העלות ברמת actor משתנה—חלק מחייבים לפי תוצאה, חלק לפי יחידת חישוב. השוואות של צד שלישי ממקמות את Apify סביב 0.003 דולר לחיפוש בקנה מידה קטן. Apify Pricing.
מהירות ואמינות
HasData מדווחת על כ-8.2 שניות בממוצע. הארכיטקטורה מבוססת ה-actor מוסיפה overhead לעומת endpoints ייעודיים ל-SERP. מתאים יותר ל-workflows מתוזמנים/באצווה מאשר לשאילתות בזמן אמת.
הכי מתאים ל
צוותים שצריכים scraping מותאם אישית + workflows של אוטומציה מעבר לנתוני SERP בלבד. פרויקטים שמשלבים חילוץ SERP עם משימות web scraping נוספות. מפתחים שרוצים מקסימום גמישות על פני endpoints מוכנים מראש.
מטריצת פרסור תכונות SERP: מה כל API באמת מחזיר
זו ההשוואה שלא הצלחתי למצוא בשום מקום אחר. כל ספק אומר "JSON מובנה", אבל רכיבי ה-SERP שבאמת מפוענחים לשדות ברמת first-class משתנים בצורה דרמטית. בדקתי תיעוד ותגובות דוגמה לכל אחד.
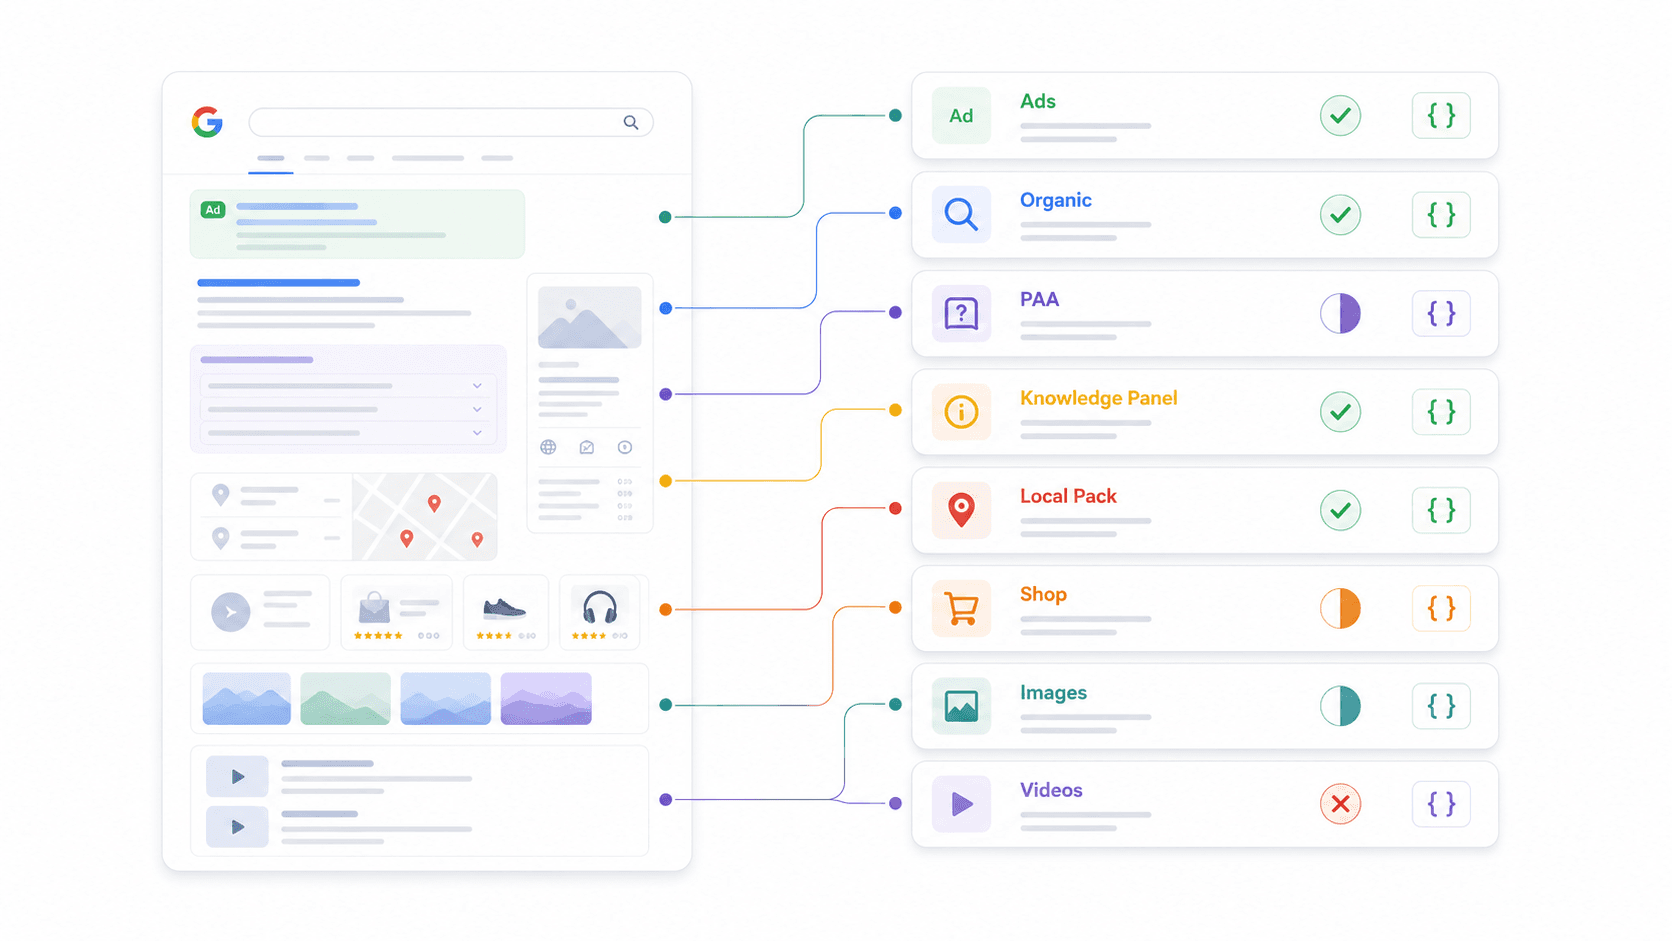
| תכונת SERP | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| תוצאות אורגניות | JSON Schema מותאם | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | תלוי ב-actor |
| People Also Ask | JSON Schema מותאם | ✅ | ✅ | ✅ | ✅ | חלקי | חלקי | תלוי ב-actor |
| Knowledge Panel | JSON Schema מותאם | ✅ | חלקי | חלקי | ✅ | חלקי | חלקי | תלוי ב-actor |
| Local Pack / Maps | JSON Schema מותאם | ✅ | ✅ | חלקי | ✅ | ✅ | חלקי | תלוי ב-actor |
| תוצאות Shopping | JSON Schema מותאם | ✅ | ✅ | חלקי | ✅ | ✅ | ✅ | תלוי ב-actor |
| Featured Snippets | JSON Schema מותאם | ✅ | חלקי | ✅ | ✅ | חלקי | חלקי | תלוי ב-actor |
| מודעות (עליון/תחתון) | JSON Schema מותאם | ✅ | חלקי | ✅ | ✅ | חלקי | חלקי | תלוי ב-actor |
| Image Pack | JSON Schema מותאם | ✅ | ✅ | ✅ | ✅ | חלקי | חלקי | תלוי ב-actor |
| תוצאות וידאו | JSON Schema מותאם | ✅ | ✅ | חלקי | ✅ | חלקי | חלקי | תלוי ב-actor |
מה המשמעות של "JSON Schema מותאם" ב-Thunderbit: במקום להגדיר מראש אילו תכונות SERP ייפענחו, אתם מגדירים JSON Schema משלכם כדי לחלץ בדיוק את השדות שאתם צריכים. רוצים שאלות PAA יחד עם סיכומי תשובות ואותות כוונה מסחרית? מגדירים את הסכימה הזו וה-AI מספק אותה. הגמישות הזו היא הסיבה ש-Thunderbit עובדת על כל מנוע חיפוש—not רק Google.
למה זה חשוב ל-workflow שלכם: אם אתם צריכים נתוני PAA לאסטרטגיית תוכן, ודאו שהספק באמת מפענח אותם. אם אתם עוקבים אחרי מודעות shopping עבור ecommerce, בדקו שיש שדות מובנים של shopping. אל תניחו ש-"JSON מובנה" אומר כיסוי מלא.
עלות אמיתית בקנה מידה גדול: השוואת מחיר לכל שאילתה
מחירים שמופיעים באתר לא מספרים את כל הסיפור. נרמלתי הכול לעלות לכל 1,000 שאילתות מוצלחות בשלושה שלבי נפח.
| ספק | עלות ל-1K שאילתות | עלות ל-10K שאילתות | עלות ל-100K שאילתות | Pay-As-You-Go? | Free Tier |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~0.80–3.20 דולר | ~8–32 דולר | ~80–320 דולר | חבילת קרדיטים | קרדיטים חינם |
| Thunderbit (Extract) | ~16–64 דולר | ~160–640 דולר | ~1,600–6,400 דולר | חבילת קרדיטים | קרדיטים חינם |
| SerpApi | 25 דולר (Starter) | ~150 דולר (Developer) | ~917 דולר (Big Data) | לא (מנוי) | 250/חודש |
| Serper | ~1 דולר | ~10 דולר | ~75–100 דולר | כן | 2,500 שאילתות |
| Scrapingdog | ~1 דולר | ~10 דולר או פחות | יכול לרדת הרבה מתחת ל-10 דולר | מסלול/קרדיט | 200 קרדיטים/חודש |
| DataForSEO | ~0.60–2 דולר | ~6–20 דולר | ~60–200 דולר | כן | קרדיטי ניסיון |
| Bright Data | ~0.50–5+ דולר | תלוי הצעת מחיר | הטוב ביותר בנפח enterprise | כן/מסלול | Free tier (5,000 קרדיטים/חודש) |
| ScraperAPI | תלוי קרדיטים | תלוי קרדיטים | תלוי קרדיטים | מסלול/קרדיט | 5,000 קרדיטי ניסיון |
| Apify | ~3 דולר (קנה מידה קטן) | תלוי ב-actor | תלוי ב-actor | קרדיטים של הפלטפורמה | קרדיטים חודשיים חינם |
עלויות נסתרות שכדאי לשים לב אליהן:
- תשלום אפשרי של 2 קרדיטים ב-Serper עבור יותר מ-10 תוצאות לשאילתה.
- פערי מחיר ב-DataForSEO בין מצבי standard ל-live/high-priority.
- מכפילי קרדיטים ב-ScraperAPI עבור SERP לעומת scraping רגיל.
- התחייבויות מינימום ארגוניות ב-Bright Data.
ערך בכל רמה:
- פרויקטים צדדיים (50 דולר לחודש): Serper או Scrapingdog ל-JSON קבוע של Google SERP.
- צוותים בצמיחה (10K–50K שאילתות בחודש): Serper, Scrapingdog או DataForSEO, בהתאם לעומק הפרסור.
- Enterprise (100K+ שאילתות בחודש): DataForSEO, Bright Data או SerpApi Big Data.
- חילוץ שמתחיל מ-AI: Thunderbit, כי הסכימה תואמת לציפיות של ה-agent downstream בלי post-processing.
ה-SERP API הטוב ביותר ל-AI agents ול-LLM workflows ב-2026
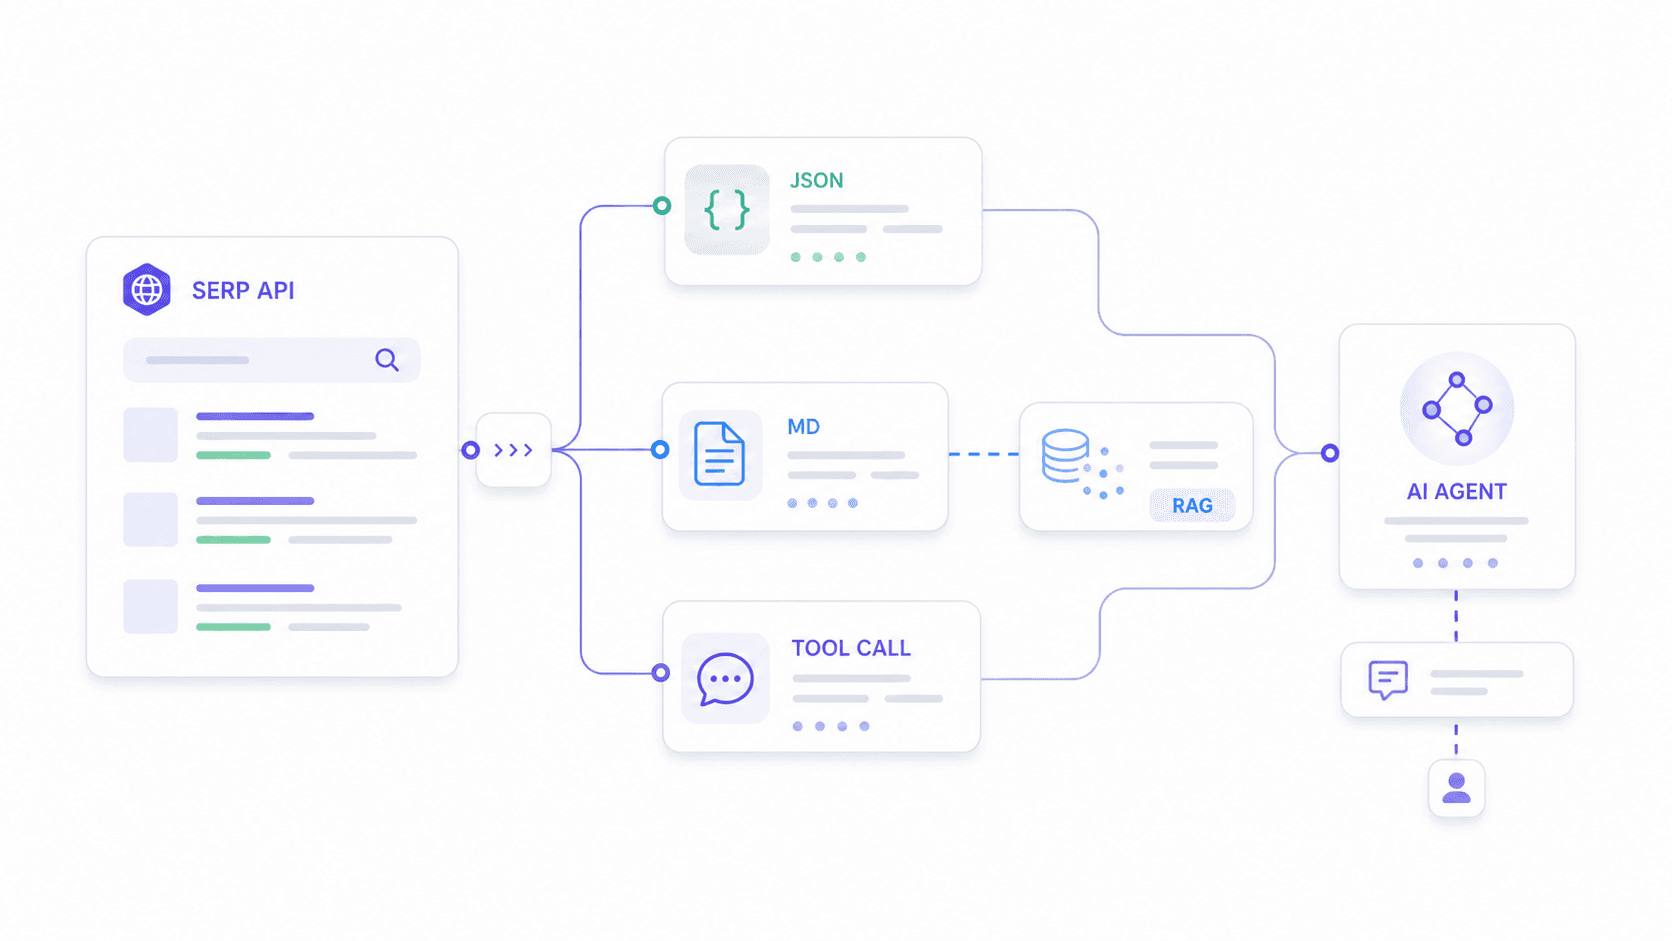
זהו תרחיש שימוש שאף אחד אחר לא מסביר כמו שצריך. מצאתי לפחות שלושה שרשורי Reddit שבהם משתמשים מתארים ניסיונות לשלב SERP APIs עם workflows ב-n8n ועם AI agents, ואחד מהם כתב במפורש ש"לא הצלחתי להבין איך לגרום לזה לעבוד כמו שצריך עם AI agent".
AI agents צריכים דברים שונים מ-dashboards למעקב דירוגים. הם צריכים:
- JSON יציב בסכימה שלא ישבור את הלוגיקה שלהם כשספק משנה את פורמט הפלט.
- שדות פלט מותאמים שמתאימים למה שהמודל downstream מצפה לקבל—not dump גנרי של הכול.
- Markdown או טקסט נקי לפייפליינים של embedding ב-RAG.
- Latency נמוך מספיק ל-tool-calling בזמן אמת.
איך כל ספק משתלב ב-stack של AI agent
| ספק | התאמה ל-AI Agent | למה |
|---|---|---|
| Thunderbit | מצוינת | JSON Schema מותאם (Extract API) + Markdown ל-RAG (Distill API). הכי גמיש לחילוץ ייעודי ל-agent. |
| Serper | טובה מאוד | JSON מהיר ונקי, פופולרי בקהילות n8n/LangChain. פשוט וזול לקריאות חיפוש בסיסיות. |
| SerpApi | טובה | סכימה יציבה, תיעוד מצוין. עובד היטב כשה-agent צריך אנכיים של Google (Maps, Scholar, Shopping). |
| DataForSEO | טובה | הכי מתאים כשה-agent הוא חלק מפייפליין SEO רחב יותר. |
| Scrapingdog | טובה | מהיר וזול; הסכימה יציבה עבור Google SERP. |
| Bright Data | טובה | איסוף נתונים טריים בקנה מידה ארגוני, בין מנועים ואזורים. |
| ScraperAPI | בינונית | טוב יותר כשה-agent צריך גם crawling כללי של האינטרנט. |
| Apify | בינונית עד טובה | גמיש אבל איטי יותר; טוב יותר ל-workflows מתוזמנים באצווה. |
דוגמה מעשית עם Thunderbit: נניח שה-AI agent שלכם צריך לנתח כוונת חיפוש עבור "best CRM for real estate". אתם מגדירים סכימה שמבקשת תוצאות אורגניות (כותרת, URL, snippet, מיקום), שאלות People Also Ask עם סיכומי תשובות, וסיווג של כוונה מסחרית. ה-Extract API של Thunderbit מחזיר בדיוק את המבנה הזה—לא יותר ולא פחות. ה-agent שלכם לא מבזבז טוקנים על פענוח שדות לא רלוונטיים או ניקוי שאריות HTML.
עבור pipelines של RAG, ה-Distill API של Thunderbit ממיר את דף ה-SERP ל-Markdown נקי שמוכן ל-embedding. רוב ה-SERP APIs הייעודיים מחזירים סכימות JSON קבועות; הגישה של Thunderbit מאפשרת למפתחים להתאים את הפלט למה שהמודל downstream שלהם מצפה לקבל.
מטריצת החלטה לפי שימוש: אם אתם צריכים X, בחרו Y
משתתפים בפורומים ממשיכים לבקש המלצות ספציפיות שממופות ל-workflows האמיתיים שלהם—not תשובה כללית של "זה תלוי". אז בניתי את זה.
| Use Case | הבחירה הטובה ביותר | סגנית | למה |
|---|---|---|---|
| מעקב דירוגי SEO (נפח גבוה) | DataForSEO | Scrapingdog | endpoints טבעיים ל-SEO, תמחור לכמות גדולה, פרסור מקיף |
| נתוני Google Maps / עסקים מקומיים | SerpApi | Bright Data | Endpoint בשל ל-Maps; Bright Data מתאימה ל-scraping מקומי בקנה מידה ארגוני |
| AI agent / אוטומציית n8n | Thunderbit | Serper | JSON Schema מותאם + Markdown ל-RAG; Serper מהירה וזולה לקריאות פשוטות |
| MVP בתקציב נמוך / פרויקט צדדי (<50 דולר/חודש) | Serper | Scrapingdog | Free tiers נדיבים, pay-as-you-go, התקנה מינימלית |
| מנועים מרובים (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit עובדת על כל מנוע חיפוש באמצעות AI extraction; ל-DataForSEO יש endpoints מרובי מנועים |
| איסוף חוות דעת מ-Google Reviews | SerpApi | DataForSEO | Endpoints ייעודיים לפרסור ביקורות |
| ecommerce / ניטור shopping | SerpApi | DataForSEO | כיסוי חזק של Google Shopping ושדות מובנים |
| workflows מותאמים של scraping | Apify | ScraperAPI | גמישות של actor; ScraperAPI נוחה ל-scraping כללי + SERP |
מדריך מהיר לפי פרסונה:
- צוות SEO: התחילו עם DataForSEO אם אתם בונים dashboards; השתמשו ב-SerpApi אם כיסוי אנכי של Google ותיעוד חשובים יותר מהמחיר.
- צוות Sales: השתמשו ב-Thunderbit כשה-workflow חוצה SERPs, דפי ספריות ו-enrichment; השתמשו ב-Serper לשאילתות פשוטות של איתור לידים.
- מפתחי כלי AI: Thunderbit לסכימות מותאמות/RAG, Serper לחיפוש מהיר וזול, SerpApi ל-verticals יציבים של Google.
- יזם יחיד: התחילו עם ה-free tiers של Serper, Scrapingdog, SerpApi ו-Thunderbit. הריצו את אותן 20 שאילתות דומות ל-production לפני התחייבות.
השוואת rate limits, אמינות ומוכנות ל-production
הלוואי שהסעיף הזה היה קיים כשבדקתי ספקים לראשונה עבור workflows ב-production. צוותים שמתרחבים לאלפי שאילתות ביום צריכים מגבלות קצב צפויות, retries אוטומטיים והבטחות uptime—וכמעט אף מאמר השוואתי אחר לא מכסה את זה בצורה שיטתית.
| ספק | Rate Limit | בקשות במקביל | Retry על כשל | SLA / Uptime |
|---|---|---|---|---|
| Thunderbit Free | 600 יחידות, חד-פעמי | 2 | מובנה (anti-bot, CAPTCHA) | — |
| Thunderbit Starter | 60,000 יחידות/חודש | 30 | מובנה | — |
| Thunderbit Pro | 600,000 יחידות/חודש | 50 | מובנה | — |
| SerpApi | לפי מסלול (חיפושים/שעה) | לפי מסלול | הספק מטפל בפרוקסים/CAPTCHA | SLA של 99.95% |
| Serper | לפי חשבון/מסלול | לא מפורסם בהרחבה | מומלץ retry ידני בלקוח | אין SLA ציבורי |
| Scrapingdog | לפי מסלול | לבדוק תנאי מסלול | אנטי-חסימה מטופל | לא תמיד מפורסם ציבורית |
| DataForSEO | מתועד לפי endpoint/מצב | משתנה לפי מצב | מצב async תומך polling/retry | תמיכה ארגונית |
| Bright Data | מתועד, יש להעלות עומס בהדרגה | בקנה מידה ארגוני | unblocking מובנה | SLA ארגוני |
| ScraperAPI | קונקרנציה לפי מסלול | תלוי בקרדיטים | מטפל ב-retries/proxies | אפשרויות תמיכה בתשלום |
| Apify | תלוי ב-actor/זיכרון/חישוב | מגבלות פלטפורמה | הגדרה ברמת actor | אמינות פלטפורמה |
צ'קליסט ל-production לפני התחייבות:
- שאלו האם הספק מחייב על בקשות שנכשלו או נחסמו.
- אשרו בדיוק את הקונקרנציה, מספר הבקשות לדקה והתנהגות burst.
- בדקו האם geotargeting, mobile מול desktop ורינדור JS משנים את צריכת הקרדיטים.
- שמרו תגובות JSON לדוגמה עבור 20–50 שאילתות אמיתיות ובדקו הבדלי שמות שדות לאורך ימים כדי לוודא יציבות סכימה.
- הוסיפו retries בצד הלקוח ותקציבי timeout אם נתוני SERP הם קריטיים למשימה.
סיכום מהיר: השוואה בין כל 8 ה-SERP APIs
| ספק | מהירות ממוצעת | עלות ל-1K | Free Tier | כיסוי פרסור | התאמה ל-AI | מנועים מרובים | שורה תחתונה |
|---|---|---|---|---|---|---|---|
| Thunderbit | בינונית (חילוץ AI) | נמוכה (Distill) עד פרימיום (Extract) | כן | מותאם אישית (כל תכונה) | מצוינת | מצוינת | הטוב ביותר לחילוץ SERP מותאם ל-AI ול-RAG |
| SerpApi | ~5.5 שניות | פרימיום | 250/חודש | מצוין (קבוע) | טובה | אנכיים רחבים של Google | הכיסוי הבשל הטוב ביותר ל-Google |
| Serper | ~2–3 שניות | נמוכה מאוד | 2,500 שאילתות | טובה | טובה מאוד | בעיקר Google | ה-API המהיר והזול הטוב ביותר ל-AI/MVP |
| Scrapingdog | ~1.25 שניות | נמוכה מאוד בקנה מידה | 200 קרדיטים/חודש | טובה | טובה | לאמת מנועים | השילוב הטוב ביותר של מהירות/עלות |
| DataForSEO | בינונית–איטית (standard) | נמוכה–בינונית | קרדיטי ניסיון | מצוין | טובה | מצוין | התשתית הטובה ביותר לפלטפורמת SEO |
| Bright Data | ~2–5.5 שניות | Enterprise | Free tier (5,000/חודש) | טובה (תלוי מוצר) | טובה | מצוין | האיסוף הטוב ביותר בקנה מידה ארגוני |
| ScraperAPI | ~33 שניות | תלוי קרדיטים | 5,000 ניסיון | בינונית | בינונית | endpoints של Google | הטוב ביותר אם SERP הוא רק חלק ממערך scraping רחב יותר |
| Apify | ~8 שניות | תלוי actor | קרדיטים חודשיים | תלוי actor | בינונית–טובה | תלוי actor | הטוב ביותר ל-workflows מותאמים של אוטומציה |
איך Thunderbit משתלבת ב-workflow של SERP שלכם
קצת יותר הקשר על למה הצוות שלנו בנה את ה-API של Thunderbit כפי שבנה. מודל ה-SERP API המסורתי—endpoints קבועים, שדות פלט מוגדרים מראש, Google בלבד—עובד יפה למעקב דירוגים פשוט. אבל ברגע שצריך משהו קצת שונה (תשובות PAA עם סנטימנט, תוצאות local pack עם מספרי ביקורות, או נתוני shopping בפורמט שמתאים לסכימת מסד נתונים מסוימת), אתם נתקעים עם post-processing או עם החלפת ספק.
ה-Extract API של Thunderbit הופך את המודל הזה. אתם אומרים מה אתם רוצים דרך JSON Schema, וה-AI מבין איך להביא את זה מכל דף חיפוש שאליו מצביעים. Google היום, Bing מחר, מנוע חיפוש אנכי נישתי בשבוע הבא—אותו API, אותה גישה.
ה-Distill API פותר בעיה אחרת: להפוך דפי SERP מבולגנים ל-Markdown נקי ש-LLMs באמת יכולים לצרוך בלי להיחנק מארטיפקטים של HTML, רכיבי ניווט וסקריפטים למעקב. אם אתם בונים pipeline של RAG שצריך ראיות חיפוש עדכניות, זה המסלול המהיר ביותר מ-"SERP חי" ל-"תוכן מוכן ל-embedding".
שני ה-endpoints כוללים טיפול ב-anti-bot, פתרון CAPTCHA ורינדור JS כברירת מחדל. לא משלמים על זה בנפרד—זה כלול בעלות הקרדיטים.
נסו את תוסף Chrome של Thunderbit
נסו בעצמכם: תוסף Chrome של Thunderbit לחילוץ מתוך הדפדפן, או פנו ישירות ל-API עבור workflows תכנותיים. בערוץ ה-YouTube שלנו יש מדריכים אם אתם רוצים לראות את זה בפעולה לפני כתיבת קוד.
הערה לגבי חוקיות
זה עולה כמעט בכל FAQ, אז הנה הגרסה הקצרה: חוקיות של scraping ל-SERP תלויה בעובדות ובתחום השיפוט. פסק הדין hiQ נגד LinkedIn קבע ש-scraping של נתונים ציבוריים לא בהכרח מהווה עבירה מחשבית, אבל זה לא מעניק אישור גורף. Google תבעה את SerpApi על scraping של SERP, מה שמעיד על לחץ מסחרי פעיל סביב הגישה לנתונים.
עצה מעשית: השתמשו ב-API-ים של הספקים בהתאם לתנאים שלהם, הימנעו מאיסוף מידע אישי אלא אם זה הכרחי, ושאלו את הספקים איך הם מטפלים בציות. אל תניחו ש-scraping של SERP הוא נטול סיכון.
מסקנה
אין ספק אחד שמנצח בכל הממדים—הבחירה הנכונה תלויה בשימוש, בתקציב וב-stack הטכנולוגי שלכם. אחרי נרמול מחירים, בדיקת מהירות, מיפוי כיסוי פרסור והערכת מוכנות ל-AI agents, זהו מסגרת ההחלטה שלי:
- צריך גמישות + מוכנות ל-AI agent? → Thunderbit
- צריך כיסוי רחב למוצרי Google? → SerpApi
- צריך מהירות + מחיר נמוך במיוחד? → Serper או Scrapingdog
- בונים פלטפורמת SEO? → DataForSEO
- צריכים סקייל ארגוני עם SLA? → Bright Data או DataForSEO
- scraping כללי + מדי פעם SERP? → ScraperAPI או Apify
התחילו עם ה-free tiers. הריצו 20–50 שאילתות אמיתיות שמייצגות את עומס ה-production שלכם. השוו את תגובות ה-JSON. בדקו את העלות האמיתית אחרי קרדיטים ומכפילים. ורק אז התחייבו.
המחירים משתנים לעיתים קרובות בשוק הזה—ההשוואה הזו נורמלה לפי דפים ציבוריים עדכניים במאי 2026. אם אתם קוראים את זה חודשים מאוחר יותר, בדקו שוב לפני רכישה.
למידע נוסף על גישות ל-AI web scraping ואיך הן משתוות לשיטות מסורתיות, כתבנו על הנושא בהרחבה. ואם אתם בוחנים web scraping ללא קוד, תוסף Chrome של Thunderbit מטפל גם בזה.
שאלות נפוצות
1. מהו SERP API ומי צריך אותו?
SERP API הוא שירות ששולח שאילתות חיפוש למנועים כמו Google, Bing או Yandex ומחזיר את התוצאות כנתונים מובנים (בדרך כלל JSON). אנשי SEO משתמשים בו למעקב דירוגים, צוותי מכירות לאיתור לידים, צוותי ecommerce למעקב מחירים, ומפתחי AI להזנת נתוני חיפוש חיים ל-agents ול-pipelines של RAG.
2. כמה עולה לחלץ 1,000 תוצאות חיפוש של Google דרך API?
הטווח רחב מאוד—מכ-0.60 דולר ל-1K (DataForSEO ברמת standard) ועד כ-25 דולר ל-1K (תכנית Starter של SerpApi). הנחות בנפח גבוה משתנות מאוד בין ספקים. תמיד נרמל לעלות לכל 1,000 שאילתות מוצלחות במקום להשוות רק את המחיר המוצהר.
3. האם אפשר להשתמש ב-SERP API עם AI agents כמו LangChain או n8n?
כן. Serper פופולרית בקהילת n8n לקריאות חיפוש פשוטות. Thunderbit חזקה במיוחד כשה-agent צריך JSON Schemas מותאמים או Markdown ל-RAG. SerpApi עובדת היטב עבור agents שצריכים נתונים יציבים של verticals ב-Google (Maps, Scholar, Shopping).
4. איזה SERP API נותן את ה-free tier הכי טוב לבדיקה?
Serper מציעה 2,500 שאילתות חינם בהרשמה—הנדיב ביותר מבחינת נפח. SerpApi נותנת 250 בחודש, Scrapingdog מציעה 200 קרדיטים בחודש, ScraperAPI מספקת 5,000 קרדיטי ניסיון (ל-7 ימים), ו-Thunderbit כוללת קרדיטים חינם לפרוטוטייפ. ל-Apify יש קרדיטים חודשיים בשווי של כ-5 דולר.
5. אילו תכונות SERP כדאי לבדוק שהספק באמת מפרש לפני הקנייה?
אל תניחו ש-"JSON מובנה" אומר כיסוי מלא. בדקו האם ה-API מחזיר שדות מובנים עבור: People Also Ask, Knowledge Panel, Local Pack/Maps, תוצאות Shopping, Featured Snippets, מודעות (למעלה ולמטה), Image Pack ותוצאות וידאו. השתמשו במטריצת הפרסור במאמר הזה כצ'קליסט התחלתי, ובדקו עם שאילתות אמיתיות לפני התחייבות למסלול.
נסו את Thunderbit ל-AI Web Scraping Get Started Free
לקריאה נוספת



