Extracteur d'articles pour textes, auteurs et dates









Collectez des données d'articles malgré l'évolution des mises en page
Lisez les champs selon leur signification, planifiez des exécutions récurrentes et utilisez le même workflow sur des sites publics.
Adaptez-vous lorsque la mise en page des articles change
Thunderbit lit, selon leur sens, les titres visibles, signatures, dates, résumés et textes d'articles. Le workflow dépend moins des positions fixes sur la page lorsqu'un site d'actualités modifie sa mise en page.
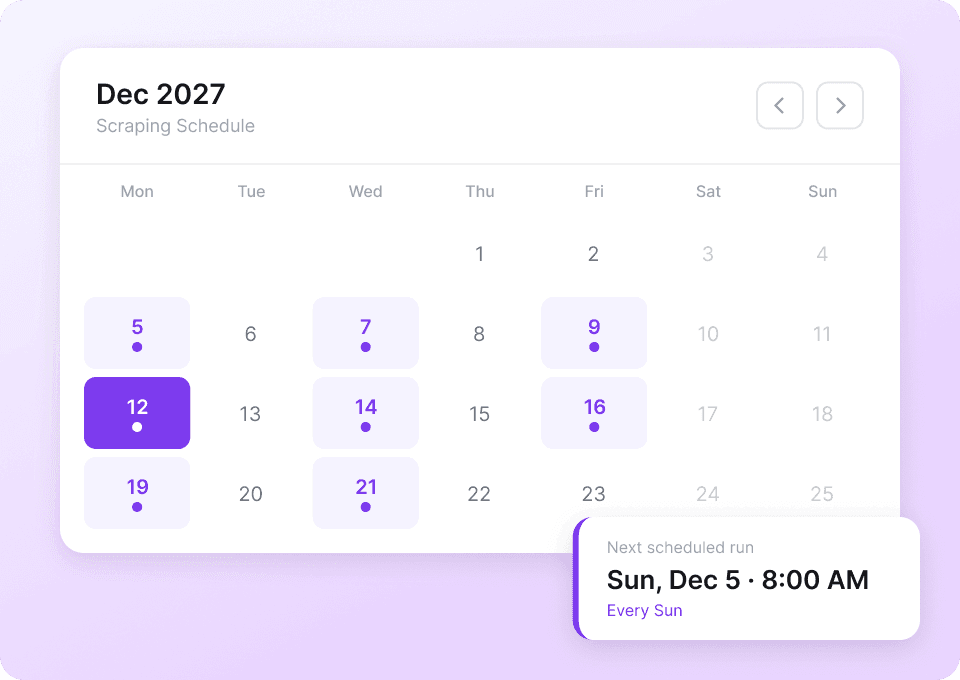
Planifiez l'extraction d'articles
Définissez une exécution récurrente pour une page d'actualités, de blog ou de rubrique publique que vous consultez régulièrement. Thunderbit peut collecter les derniers articles visibles et envoyer de nouvelles lignes vers le fichier ou l'application de votre choix.
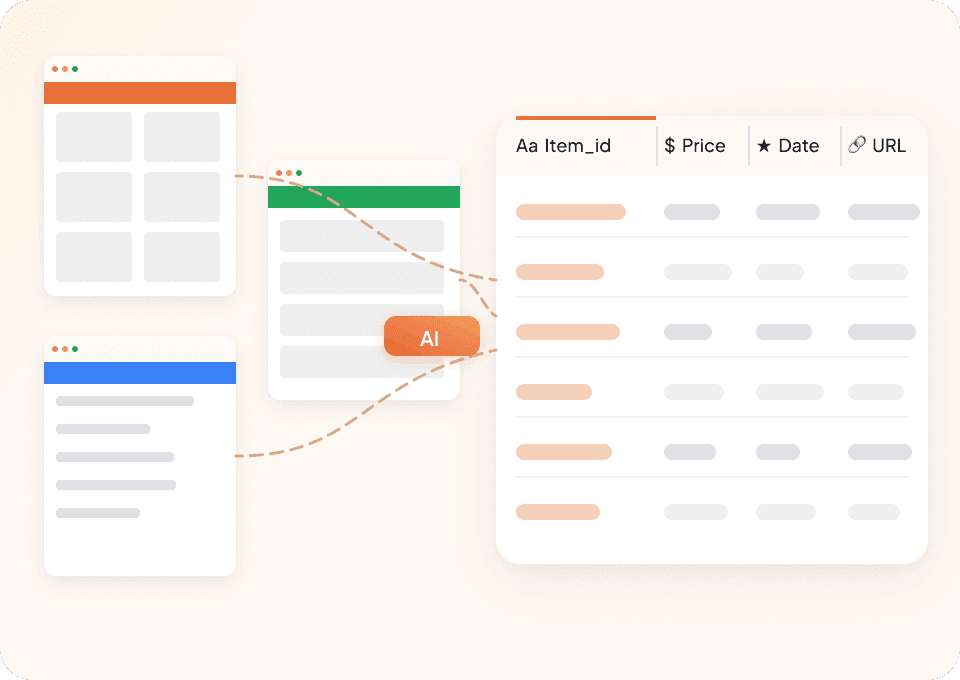
Utilisez un seul workflow sur n'importe quel site public
Utilisez le même workflow sur n'importe quel site public contenant des articles. Nommez les champs dont vous avez besoin, puis laissez Thunderbit placer chaque page dans les mêmes colonnes.
Un seul workflow d'articles pour différentes mises en page
Les sélecteurs fixes suivent les positions. L'IA de Thunderbit recherche les champs d'article que vous avez nommés.
Une carte de sélecteurs pour chaque éditeur
Chaque design de page demande une maintenance séparéeDes champs d'article organisés par Thunderbit
L'enregistrement demandé reste cohérentQuelles données pouvez-vous extraire d'un article ?
Choisissez parmi 30 champs visibles liés au contenu, à l'auteur, à l'éditeur, à la date, aux liens, aux sujets, aux médias et aux métadonnées de page.
- Titre
- Titre alternatif
- Corps de l'article
- Résumé de l'article
- Nom de l'auteur
- URL de l'auteur
- Organisation de l'auteur
- Nom de l'éditeur
- URL de l'éditeur
- Date de publication
- Date de modification
- Section de l'article
- Mots-clés
- Nombre de mots
- Langue
- URL canonique
- URL de l'entité principale
- URL de l'image
- Légende de l'image
- Crédit de l'image
- URL de la vidéo
- URL de l'audio
- Ligne de datation
- Sujets associés
- Mentions
- Liens de citation
- URL de la licence
- Liens vers des articles associés
- Titre de la page
- Méta description
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
Questions sur l'extraction d'articles publics
Les sites d'actualités utilisent des mises en page et des détails de page différents, donc les champs obtenus dépendent de la page d'article que vous capturez.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Extracteur 4PDA
L’Extracteur 4PDA de Thunderbit vous permet de collecter automatiquement les données des articles d’actualité et des discussions du forum 4PDA grâce à l’IA. Rassemblez rapidement les titres, dates de publication, auteurs et contenus de posts pour vos recherches, analyses ou la veille des tendances tech. Parfait pour les passionnés de technologie, chercheurs et marketeurs souhaitant obtenir des données structurées de 4PDA.
En savoir plus ->
Extracteur Ptt
L’Extracteur Ptt de Thunderbit vous permet de récupérer les données des forums et des publications Ptt grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez les noms de forums, liens, popularité, titres de posts, auteurs et commentaires pour vos besoins en recherche, marketing ou analyse de contenu. Parfait pour les professionnels du marketing, les chercheurs et les créateurs de contenu souhaitant obtenir des données Ptt structurées.
En savoir plus ->
Extracteur de Pizza Marketplace
L’Extracteur Pizza Marketplace de Thunderbit vous permet de récupérer les données des actualités et de l’annuaire des fournisseurs sur Pizza Marketplace. Grâce à l’IA, identifiez rapidement les titres d’articles, dates de publication, auteurs, noms de fournisseurs, localisations et coordonnées pour vos besoins de recherche, de marketing ou d’analyse.
En savoir plus ->
Extracteur Failory
L’Extracteur Failory de Thunderbit vous permet de collecter facilement des données structurées issues du cimetière des startups et des articles d’actualité de Failory. Grâce à la suggestion intelligente de champs par l’IA, récupérez les noms de startups, les années, les raisons des échecs, les titres d’articles, les auteurs et bien plus encore pour vos recherches ou analyses. Parfait pour les entrepreneurs, investisseurs et chercheurs en quête d’enseignements à partir de Failory.
En savoir plus ->
Extracteur TechCrunch
Extrayez en 2 clics les articles TechCrunch, les actus startups, les titres, les liens, les dates, les auteurs et les résumés — sans aucune ligne de code. Exportez instantanément vers Excel, Google Sheets ou Notion et transformez des actualités brutes en données structurées et exploitables.
En savoir plus ->
Extracteur ESPN facile
Suivez les noms des athlètes, les dates des matchs et les scores sur ESPN en 2 clics avec l’IA de Thunderbit — sans code, sans configuration. Exportez directement vers Excel, Google Sheets ou Notion et exploitez immédiatement vos données sportives.
En savoir plus ->Prêt à booster votre extraction de données ?
Rejoignez plus de 200 000 professionnels qui utilisent déjà Thunderbit pour automatiser leurs workflows d'extraction web.
L’essai gratuit offre des crédits illimités pour 8 pages web.



