
Le web n’a jamais eu autant soif de données, et en 2026, Node.js donne le tempo aux équipes qui veulent faire du web scraping plus malin, pas plus laborieux. Que tu travailles dans la vente, l’ecommerce ou que tu sois juste un mordu de données comme moi, tu as sûrement déjà remarqué que le scraping ne se résume plus à “récupérer des infos” — il faut aller vite, monter en charge, et éviter que ton IP finisse bannie dans une sorte de prison numérique. Et la demande ne faiblit pas : les données web publiques sont devenues, presque en douce, la matière première sur laquelle s’appuient la plupart des équipes modernes, de l’analyse tarifaire aux pipelines d’entraînement des LLM. Les enjeux — et la concurrence — n’ont jamais été aussi forts.
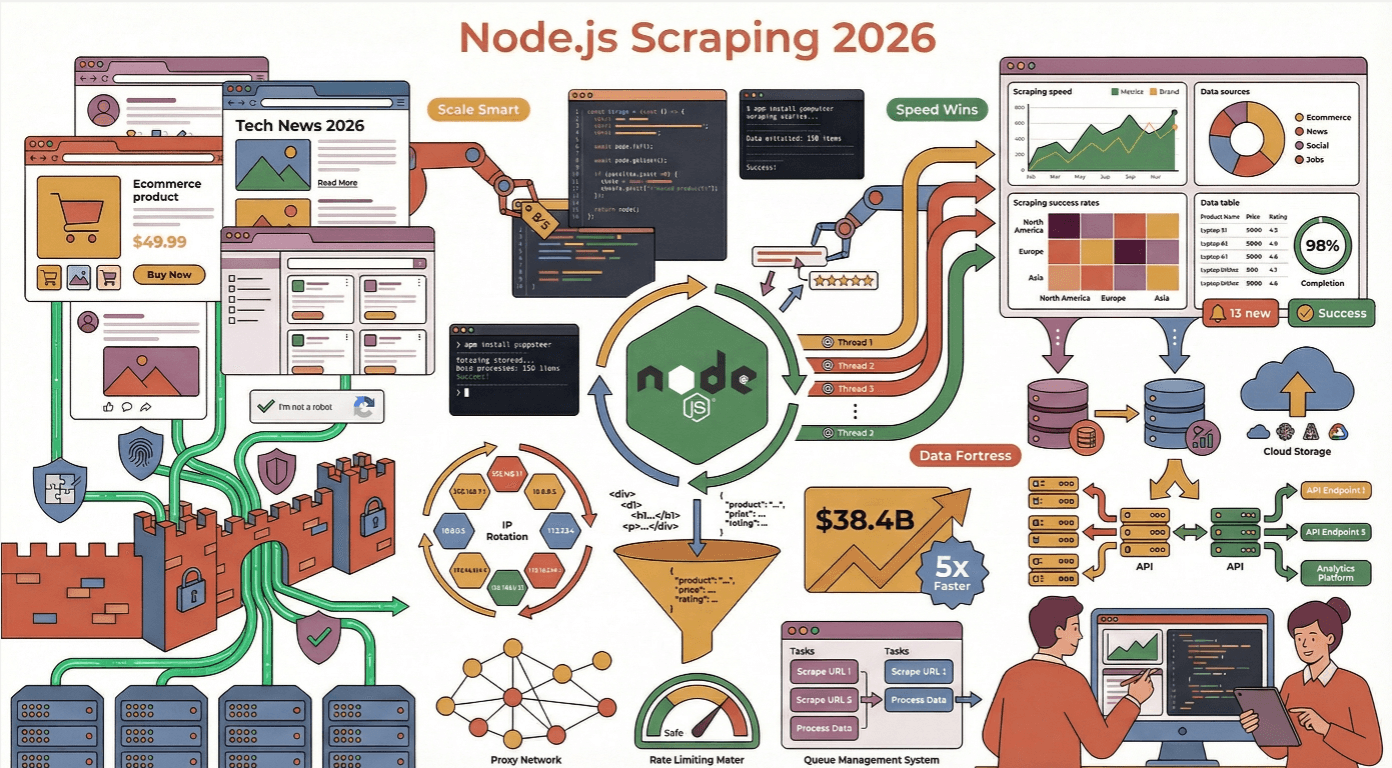
Mais voilà le piège : le web moderne, c’est une vraie forteresse de contenu dynamique, de pièges anti-bot et de mises en page qui changent sans prévenir. J’ai vu plus de scrapers casser que je ne veux l’admettre — le plus souvent parce qu’ils zappaient les bonnes pratiques ou sous-estimaient le niveau d’ingéniosité des systèmes anti-scraping. Alors, allons voir les vraies bonnes pratiques pour rendre le web scraping avec Node.js plus efficace, avec quelques anecdotes, une touche d’humour et surtout beaucoup de conseils concrets.
Pourquoi choisir Node.js pour un web scraping plus efficace ?
Si tu as déjà essayé de scraper des centaines, voire des milliers de pages en même temps, tu sais que la vitesse et la concurrence, c’est la clé. Et c’est exactement là que Node.js fait la différence. Son modèle d’E/S asynchrone et non bloquant est pensé pour gérer un énorme volume de requêtes réseau simultanées — un vrai as du multitâche pour le web (Node.js Docs). Là où d’autres langages s’embourbent en attendant la fin de chaque requête, Node.js continue tranquillement à faire tourner sa boucle d’événements, en jonglant avec les appels comme un artiste de cirque boosté à la caféine.
J’ai vu Node.js dépasser Python et Java dans des cas où les mises à jour en temps réel et les extractions à grande échelle sont indispensables, surtout quand les sites ciblés reposent beaucoup sur JavaScript. D’ailleurs, environ 40 % des développeurs utilisent aujourd’hui Node.js pour le backend et l’automatisation, ce qui en fait la techno web la plus populaire au monde.
Node.js face aux autres frameworks de web scraping
Faisons un petit détour technique. Voilà comment Node.js se place face aux autres :
| Framework | Points forts | Points faibles | Cas d’usage idéaux |
|---|---|---|---|
| Node.js | Asynchrone, excellent pour la concurrence, énorme écosystème npm, JS natif pour les sites dynamiques | Peut consommer pas mal de mémoire, callback hell (si on n’utilise pas async/await) | Scraping en temps réel, sites riches en JS, microservices évolutifs |
| Python | Énormément de bibliothèques de scraping (BeautifulSoup, Scrapy), syntaxe simple | Moins rapide pour une forte concurrence, compliqué avec les sites rendus en JS | HTML statique, recherche, prototypage |
| Java | Typage fort, robuste pour l’entreprise | Verbeux, moins souple pour des scripts rapides | Scraping à grande échelle, usage enterprise |
| Go | Rapide, concurrence efficace | Écosystème plus réduit, courbe d’apprentissage plus raide | Scraping haute performance, faible latence |
Pour la majorité des usages métier, Node.js trouve le bon équilibre : rapide, flexible et parfaitement à l’aise avec le web moderne propulsé par JavaScript (Thunderbit Blog).
Mettre en place un environnement Node.js robuste pour le web scraping
Un bon scraper commence par une base solide. Voilà ma config de référence :
- Structure du projet : garde une architecture modulaire. Utilise des dossiers comme
/src,/libset/config. Range les infos sensibles (clés API, proxys) dans des variables d’environnement avecdotenv(Thunderbit Guide). - Client HTTP : utilise axios, got ou node-fetch pour envoyer les requêtes.
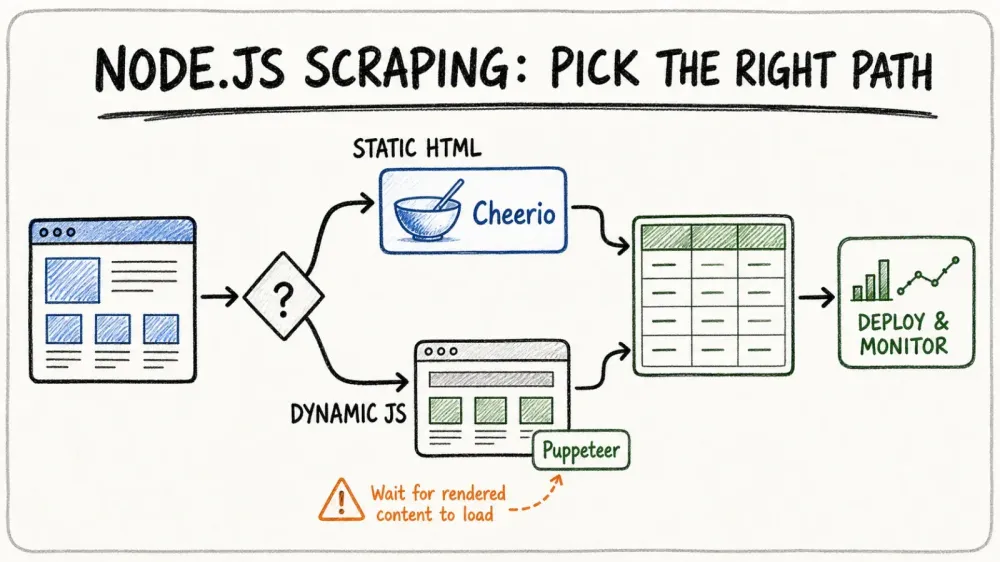
- Analyse HTML : Cheerio pour le HTML statique, Puppeteer ou Playwright pour le contenu dynamique.
- Utilitaires : utilise Lodash pour le traitement des données, ainsi que validator.js ou Joi pour la validation.
- Tests et linting : Mocha pour les tests, ESLint pour la qualité du code (LogRocket).
Bibliothèques Node.js essentielles pour le web scraping
- Clients HTTP (axios / got /
fetchnatif) : pour envoyer les requêtes. Point important : depuis Node.js v18, tu peux utiliserfetchnativement sans rien installer, et Node.js v22 l’a rendu stable. Pour un nouveau projet sur une version récente de Node, tu n’as probablement pas besoin du packagenode-fetch— il suffit d’appelerfetchdirectement. De mon côté, je reviens souvent vers axios quand je veux des interceptors, du JSON automatique et une API de promesses familière à la fois dans Node et dans le navigateur ; got est mon choix quand j’ai besoin de retries, de streams ou de HTTP/2 prêt à l’emploi. Choisis ce qui colle à ta stack ; pour un script rapide,fetchnatif suffit. - Cheerio : analyseur HTML rapide, proche de jQuery. Idéal pour les pages statiques — parsing en environ 0,5 s (Oxylabs).
- Playwright / Puppeteer : automatisation de navigateur headless pour les sites dynamiques et riches en JavaScript. Plus lent (~4 s par page), mais indispensable pour les contenus chargés après l’ouverture de la page (Bright Data). Si tu pars de zéro en 2026, Playwright est la référence par défaut — multi-navigateurs dès le départ (Chromium / Firefox / WebKit), visionneuse de traces intégrée, et l’équipe qui a créé Puppeteer le développe désormais chez Microsoft. Puppeteer reste maintenu pour les cas centrés sur Chrome, mais ses versions ont surtout servi à suivre les compatibilités Chrome plutôt qu’à apporter de nouvelles capacités depuis un moment.
- dotenv : pour gérer les variables d’environnement.
- csv-writer/jsonfile : pour exporter les données.
Éviter les pièges courants du web scraping avec Node.js
J’ai perdu le compte du nombre de fois où j’ai vu des scrapers se faire bloquer, planter, ou tout simplement sortir un gros paquet de données sales. Voici les points à surveiller :
- Ignorer robots.txt et les conditions d’utilisation : vérifie toujours avant de scraper. Les enfreindre peut faire bannir ton IP — ou pire, t’attirer des soucis juridiques (ScraperAPI).
- Surcharger les serveurs : n’arrose pas les sites avec trop de requêtes. Limite le rythme de ton scraper avec des délais aléatoires (1 à 3 secondes), contrôle la concurrence et évite d’agir comme un robot surexcité (ScrapeGraphAI).
- Ne pas gérer les erreurs : entoure toujours tes requêtes de blocs try/catch, traite les erreurs HTTP et journalise les échecs. Réessaie les erreurs temporaires avec un backoff exponentiel (ScrapeGraphAI).
- Oublier les en-têtes de requête : utilise des chaînes User-Agent crédibles et fais-les tourner. Ajoute Accept-Language, Referer et d’autres en-têtes pour imiter un vrai navigateur (ScrapeGraphAI).
Comment contourner les mécanismes anti-scraping
Les sites modernes sont blindés de technologies anti-bot. Voilà comment j’évite les pièges numériques :
- Rotation des proxys/IP : utilise un pool de proxys et fais tourner les IP pour éviter les bannissements (Medium).
- Randomisation des en-têtes : fais tourner User-Agent, Accept-Language et les autres en-têtes à chaque requête.
- Discrétion du navigateur headless : utilise des plugins comme
puppeteer-extra-plugin-stealthpour masquer les empreintes d’automatisation. - Simulation du comportement humain : ajoute des délais aléatoires, des mouvements de souris, du scrolling et même des fautes de frappe (ZenRows).
Simuler un comportement humain dans les scrapers Node.js
C’est là que ça devient amusant — et un peu bizarre. Au lieu de cliquer et de défiler instantanément, programme ton scraper pour :
- Attendre des intervalles aléatoires entre les actions (
await page.waitForTimeout(randomDelay)) - Déplacer la souris par petits à-coups irréguliers (
page.mouse.move(x, y)) - Saisir du texte avec des délais aléatoires et quelques fautes occasionnelles (
page.type(selector, text, {delay: random(100,200)})) - Faire défiler de manière irrégulière, pas seulement jusqu’en bas
Ces astuces peuvent booster nettement ton taux de réussite sur les sites protégés (ScraperAPI).
Simplifier l’extraction de données complexes avec Thunderbit
Extraire des données de n’importe quel site grâce à l’IA Évite toute la partie technique : l’agent de scraping web de Thunderbit lit n’importe quelle page et extrait les données en un clic, sans code Node.js à maintenir. Get Started Free
Parlons maintenant du sujet que tout le monde a en tête : le scraping, c’est compliqué. Mais ça n’est pas obligé de l’être. C’est justement pour ça que nous avons créé Thunderbit.
Thunderbit est une extension Chrome de scraping web agentique qui te permet d’extraire des données de n’importe quel site en langage naturel. Clique simplement sur “One Click Extract”, laisse l’IA comprendre le contenu de la page, puis appuie sur “Scrape”. C’est un peu comme avoir un développeur junior qui ne dort jamais et ne demande jamais d’augmentation.
Mieux encore, Thunderbit propose une API, ce qui te permet de l’intégrer directement à tes workflows Node.js. Au lieu d’écrire des milliers de lignes de code de scraping, tu peux laisser Thunderbit gérer le gros du boulot — contenu dynamique, sous-pages, pagination, tout y passe. Il ne te reste qu’à récupérer des données structurées (CSV, JSON ou export direct vers Google Sheets, Airtable, Notion) et à poursuivre ta journée (Thunderbit Blog).
Essaie gratuitement l’extension Chrome Thunderbit Installe l’extension Chrome gratuite et extrait des données structurées en un clic — ou appelle l’API Thunderbit depuis ton application Node.js. Get Started Free
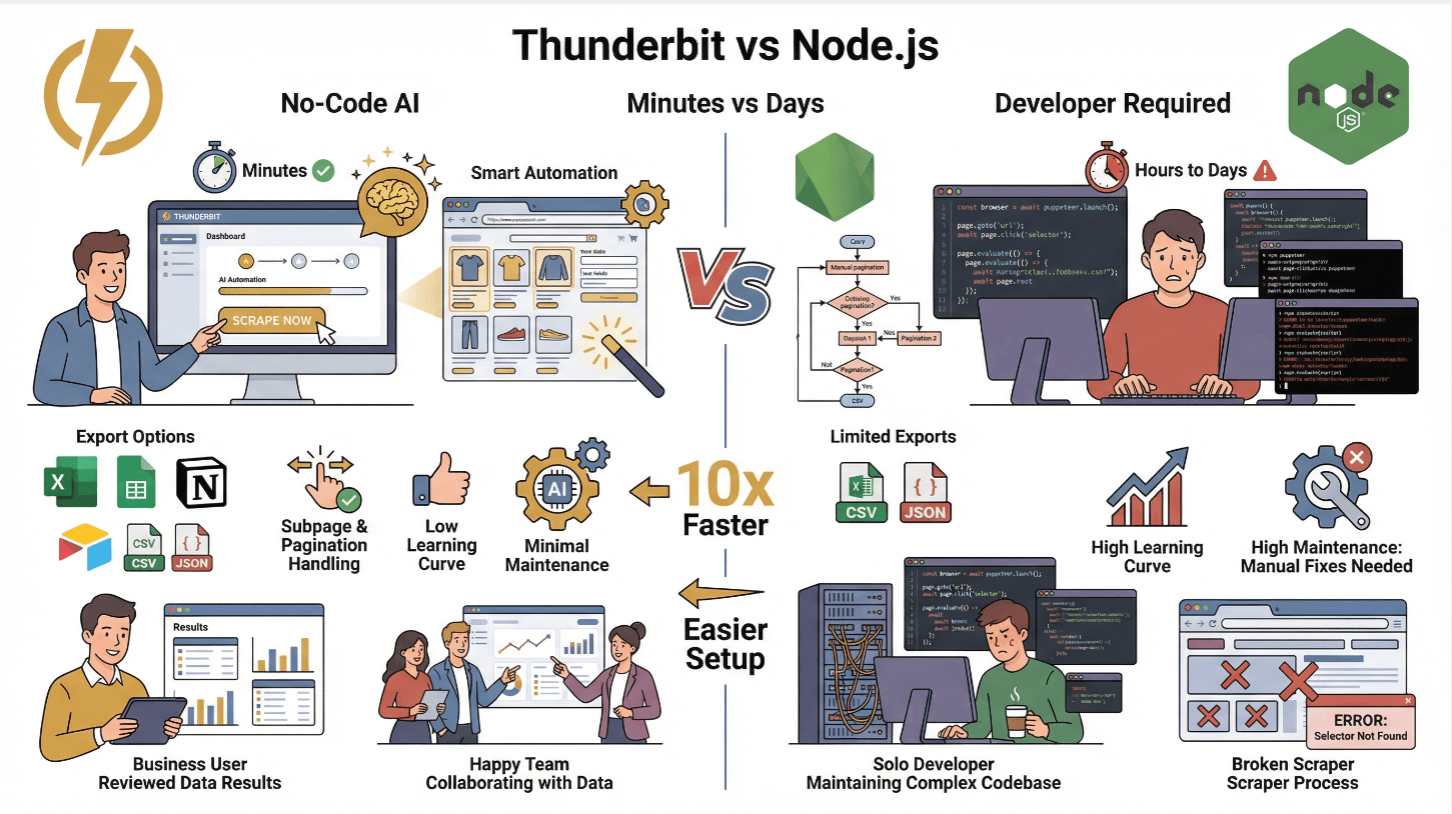
Thunderbit vs scraping Node.js traditionnel
| Fonctionnalité | Thunderbit | Scraper Node.js traditionnel |
|---|---|---|
| Temps de mise en place | Quelques minutes (sans code) | Quelques heures à plusieurs jours (développement, tests) |
| Gestion du contenu dynamique | Oui (IA + navigateur) | Oui (avec Puppeteer/Playwright) |
| Sous-pages et pagination | En 1 clic | Code manuel requis |
| Export des données | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (code personnalisé) |
| Courbe d’apprentissage | Faible (utilisateurs métier) | Élevée (développeurs) |
| Maintenance | Minime (l’IA s’adapte) | Élevée (corrections manuelles à chaque changement de site) |
Thunderbit est idéal pour les équipes non techniques ou pour toute personne qui veut éviter le travail répétitif et se concentrer sur l’analyse. Pour les utilisateurs avancés, tu peux aussi utiliser l’API Thunderbit pour automatiser le scraping à grande échelle (Thunderbit Docs).
Combiner Cheerio et Puppeteer pour le contenu dynamique
C’est mon duo préféré pour le scraping avec Node.js. Voilà comment ça marche :
- Utilise Puppeteer pour charger la page et exécuter JavaScript (attends
networkidlepour t’assurer que tout le contenu est bien chargé). - Récupère le HTML avec
await page.content(). - Analyse avec Cheerio : envoie le HTML à Cheerio pour un parsing ultra-rapide de type jQuery et l’extraction des données.
Cette approche hybride te donne le meilleur des deux mondes : la puissance de Puppeteer pour le contenu dynamique, et la rapidité de Cheerio pour l’analyse (Browserless).
Conseil performance : sélectionne uniquement les éléments dont tu as besoin. Cheerio charge tout le DOM en mémoire, donc évite les sélecteurs trop larges et mets en cache les résultats si tu scrapes les mêmes pages à répétition (Oxylabs).
Optimiser l’analyse HTML et l’extraction des données
- Utilise des sélecteurs précis : évite
$('body *')— cible seulement ce dont tu as besoin. - Diffuse les grosses pages : pour des HTML massifs, pense au streaming ou découpe le traitement.
- Mets en cache le HTML rendu : si tu revisites des URLs, garde le HTML pour éviter des requêtes inutiles.
- Valide et nettoie les données : utilise des bibliothèques de validation pour ne pas remplir ta base avec des données inutiles (ScrapeGraphAI).
Déployer un scraper Node.js à grande échelle dans le cloud
Tu scrapes à grande échelle ? Il est temps de passer au cloud natif.
- Dockerise ton scraper : écris un
Dockerfile, copie ton code, installe les dépendances et définis le point d’entrée. - Déploie dans le cloud : utilise AWS EC2, Google Cloud Compute ou des VM Azure pour les tâches simples. Pour une vraie montée en charge, passe à Kubernetes ou à des services managés comme AWS ECS/EKS, Google Cloud Run ou Azure Kubernetes Service (DigitalOcean).
- Orchestre avec Kubernetes : lance plusieurs pods, auto-scale selon la demande et utilise des load balancers pour répartir les URLs.
- Planifie les tâches : utilise les planificateurs cloud (CloudWatch Events, Cloud Scheduler) ou des tâches cron pour lancer les scrapes à intervalles réguliers.
Dans un exemple concret, passer de 5 à 10 pods Kubernetes a permis de réduire un scraping de 400 pages de plusieurs minutes à moins d’une minute (DigitalOcean).
Surveiller et auto-scaler ton infrastructure de scraping
- Journalisation : envoie les logs vers CloudWatch, Stackdriver ou Datadog. Configure des alertes en cas d’erreur ou de ralentissement.
- Vérifications de santé : utilise Prometheus et Grafana pour suivre des métriques comme les pages scrapées par minute, les taux d’erreur et la santé des pods.
- Auto-scaling : mets en place le HPA (Horizontal Pod Autoscaler) de Kubernetes pour faire évoluer les pods selon le CPU ou le nombre de requêtes.
Implémente toujours des retries avec backoff exponentiel pour récupérer après des soucis réseau ou des blocages temporaires.
Bonnes pratiques de stockage et de post-traitement des données
Une fois les données extraites, il faut les stocker et les nettoyer :
- Petits volumes : exporte vers CSV, JSON, ou pousse vers Google Sheets, Airtable ou Notion (Thunderbit le fait nativement).
- Gros volumes : utilise SQL (MySQL/PostgreSQL) pour les données structurées, ou NoSQL (MongoDB, DynamoDB) pour les schémas semi-structurés ou amenés à évoluer (ScrapeHero).
- Stockage cloud : S3 ou Google Cloud Storage pour les fichiers bruts et les sauvegardes.
- Nettoyage des données : valide toujours les champs, normalise les formats (dates, nombres) et supprime les doublons. Utilise des validateurs de schéma pour garantir la qualité des données (ScrapeGraphAI).
Garde à la fois les données brutes et les données nettoyées — on ne sait jamais quand il faudra les retraiter ou déboguer.
Conclusion : points clés pour améliorer l’efficacité du web scraping avec Node.js
Passe au-dessus du code du scraper Vois comment l’agent de scraping web de Thunderbit se compare au fait d’écrire et de maintenir tes propres scripts de scraping. Get Started Free
Récapitulons l’essentiel :
- Exploite la puissance asynchrone de Node.js pour un scraping massif et concurrentiel — surtout sur les sites très orientés JavaScript.
- Combine les bons outils : utilise axios/got pour les requêtes, Cheerio pour le HTML statique, Puppeteer pour le contenu dynamique, et mélange-les pour gagner en vitesse et en flexibilité.
- Évite les pièges anti-bot : fais tourner les proxys et les en-têtes, simule un comportement humain et respecte robots.txt.
- Simplifie avec Thunderbit : pour les utilisateurs métier ou le prototypage rapide, Thunderbit te permet d’extraire des données complexes avec l’IA et de l’intégrer à ta stack Node.js via API.
- Passe à l’échelle : dockerise, orchestre avec Kubernetes et surveille l’ensemble pour garantir la fiabilité.
- Stocke et nettoie tes données : choisis le bon stockage selon tes besoins, et valide toujours avant d’exploiter.
Le web ne devient pas plus simple, mais avec ces bonnes pratiques, tes scrapers Node.js peuvent rester rapides, fiables et toujours un pas devant la course à l’armement anti-bot. Et si tu en as marre de déboguer des sélecteurs à 2 h du matin, rappelle-toi : l’IA de Thunderbit, elle, ne dort jamais.
Tu veux aller plus loin ? Consulte le Thunderbit Blog pour d’autres analyses poussées, ou essaie l’extension Chrome Thunderbit pour voir à quel point le scraping peut être simple.
Scrape avec l’agent de scraping web Thunderbit L’API Web Scraper de Thunderbit te permet de lancer une extraction depuis ton propre code Node.js, avec une offre gratuite pour démarrer. Get Started Free
FAQ
1. Pourquoi Node.js est-il particulièrement adapté au web scraping en 2025 ?
Le modèle asynchrone et événementiel de Node.js lui permet de gérer des milliers de requêtes simultanées, ce qui en fait un excellent choix pour extraire de gros volumes de données ou des mises à jour en temps réel. Son immense écosystème npm et son support natif de JavaScript sont parfaits pour les sites web modernes très orientés JS (Node.js Docs).
2. Comment éviter d’être bloqué lors d’un scraping avec Node.js ?
Utilise des proxys rotatifs, randomise les en-têtes de requête, limite le rythme avec des délais aléatoires et simule un comportement humain (mouvements de souris, scroll, saisie) avec des outils comme Puppeteer. Respecte toujours robots.txt et les conditions du site (Medium).
3. Quand faut-il utiliser Cheerio plutôt que Puppeteer dans un scraper Node.js ?
Utilise Cheerio pour analyser rapidement du HTML statique, quand les données sont déjà présentes dans le code source. Utilise Puppeteer pour les sites qui chargent le contenu dynamiquement avec JavaScript. Pour de meilleurs résultats, sers-toi de Puppeteer pour rendre la page, puis de Cheerio pour analyser le HTML (Bright Data).
4. Comment Thunderbit simplifie-t-il le web scraping avec Node.js ?
Thunderbit te permet d’extraire des données structurées de n’importe quel site grâce à l’IA et à des instructions en langage naturel — sans coder. Il gère le contenu dynamique, les sous-pages et la pagination, et propose une API pour l’intégration dans Node.js. Les données peuvent être exportées directement vers Excel, Google Sheets, Airtable ou Notion (Thunderbit Blog).
5. Quelle est la meilleure façon de faire évoluer et surveiller des scrapers Node.js dans le cloud ?
Dockerise ton scraper, déploie-le sur Kubernetes ou sur des services cloud managés, puis utilise l’auto-scaling pour absorber les pics de demande. Surveille les logs et les métriques avec des outils comme CloudWatch ou Prometheus, et configure des alertes en cas d’erreur ou de ralentissement (DigitalOcean).
Prêt à passer au niveau supérieur en web scraping ? Essaie Thunderbit, et que tes scrapers soient rapides, discrets et toujours un pas devant.
Essaye l’agent de scraping web Get Started Free
En savoir plus
- Maîtriser le web scraping avec Node pour débutants : guide étape par étape
- Comment extraire efficacement des données de sites web avec les meilleurs outils
- Comment crawler un site web efficacement : guide étape par étape
- Maîtriser le crawling JavaScript : guide pour débutants
- Maîtriser le web scraping pour la comparaison de prix en 2026




