
Le mois dernier, l’intégration Stripe d’un ami s’est mise à renvoyer en douce des erreurs 503 un vendredi à 23 h. Personne ne s’en est rendu compte avant le samedi matin — quand la boîte mail du support a explosé avec plus de 200 e-mails furieux de clients dont les paiements avaient échoué.
Ce genre d’histoire n’a rien d’exceptionnel. Un benchmark largement cité estime le coût moyen d’une interruption à 5 600 $ par minute, et les pannes à fort impact peuvent atteindre plusieurs millions par heure. Le chiffre exact dépend du trafic, du taux de conversion, du panier moyen, des SLA et du coût de remise en service — mais la conclusion reste la même : des API non surveillées sont un risque business, pas un souci technique. Avec 131 API tierces en moyenne par organisation et seulement 16 % déclarant une forte capacité à réduire ce risque, la supervision n’est plus optionnelle. Ce guide fait ce que je n’ai pas vu ailleurs : classer par votre cas d’usage, évaluer la qualité des alertes (pas seulement leur présence), montrer les tarifs réels 2026 et mesurer le temps pour devenir opérationnel. Pas une énième liste de logos.
Un dernier point : si votre travail API consiste à collecter des données web, alimenter des LLM, construire des systèmes RAG, surveiller des pages concurrentes ou extraire des données de prix, la discussion « outils API » ne doit pas s’arrêter à la disponibilité. Il faut aussi transformer de façon fiable des pages web bancales en données structurées. C’est là qu’intervient Thunderbit Open API : ce n’est pas un moniteur de disponibilité, mais l’un des moyens les plus rapides de convertir des sites en Markdown propre ou JSON structuré via une API.
Qu’est-ce que la supervision d’API (et pourquoi votre équipe devrait-elle s’y intéresser) ?
La supervision d’API consiste à vérifier en continu que vos points de terminaison sont disponibles, rapides et renvoient les bonnes données. Pas seulement « le serveur répond-il ? » — un bon moniteur valide aussi les codes HTTP, le contenu de la réponse, la latence, les certificats SSL, les workflows multi-étapes (connexion → recherche → achat) et la conformité du schéma.
C’est différent de la supervision classique d’un site web (qui vérifie si une page se charge) et de l’APM (Application Performance Monitoring), qui inspecte les traces au niveau du code, les requêtes base de données et les mécanismes internes à l’exécution. La supervision d’API se situe à l’interface : elle teste ce que vos utilisateurs, partenaires et intégrations vivent réellement en appelant vos endpoints.
Il existe aussi une catégorie connexe : les API de données web. Elles ne surveillent pas la santé de votre API ; elles aident votre produit à collecter des données web externes de façon fiable. Thunderbit Open API peut transformer une page web en Markdown propre, extraire des champs structurés en JSON et lancer des lots sur de nombreuses URL. Si votre projet « API » dépend de données fraîches sur des fournisseurs, pages produit, annonces publiques ou documentation, ce type d’API d’extraction peut être aussi stratégique qu’un contrôle de disponibilité.
Pourquoi les non-techniciens devraient-ils s’en préoccuper ? Parce que les API représentent 71 % du trafic web dynamique et 62 % des professionnels de l’API disent qu’elles génèrent directement du chiffre d’affaires. Quand une passerelle de paiement, un service d’authentification ou une API d’expédition tombe en panne, ce n’est pas un problème d’infrastructure abstrait : c’est du revenu perdu, des contrats cassés, des tickets support qui explosent, une confiance qui s’érode. Équipes produit, commerciales, ops et customer success sont toutes concernées.
Métriques clés à surveiller :
- Taux de disponibilité : part du temps pendant laquelle un endpoint est disponible
- Temps de réponse / latence : durée nécessaire à l’endpoint pour répondre (moyenne, p95, p99)
- Taux d’erreur : part des requêtes renvoyant des 5xx, des timeouts ou des échecs de validation
- Débit : nombre de requêtes par seconde/minute
- Exactitude : l’API renvoie-t-elle les bonnes données, pas seulement un 200 OK ?
Comment nous avons évalué les meilleurs outils de supervision d’API pour 2026
La plupart des articles « meilleurs outils de supervision d’API » se contentent d’empiler des noms de fournisseurs. Je voulais être plus rigoureux dans les critères de sélection — en partie parce que j’ai lu beaucoup de forums de développeurs, et en partie parce que l’équipe Thunderbit m’a aidé à extraire en masse les tarifs et fonctionnalités des sites fournisseurs pour construire une vraie comparaison (j’y reviens plus loin).
Voici ce que nous avons pondéré :
| Critère | Pourquoi c’est important |
|---|---|
| Simplicité de mise en route / temps jusqu’à la première alerte | Les petites équipes ont besoin d’une couverture immédiate, pas d’un projet plateforme |
| Intelligence des alertes & réduction du bruit | Si les alertes sont bruyantes, les équipes les ignorent et ratent les vrais incidents |
| Générosité de l’offre gratuite | Projets annexes et jeunes startups démarrent souvent gratuitement |
| Transparence des tarifs | Les factures d’observabilité peuvent exploser avec hôtes, sièges, logs, exécutions synthétiques et ingestion de données |
| Largeur des intégrations | Les alertes doivent arriver là où les équipes travaillent déjà (Slack, PagerDuty, etc.) |
| Scalabilité & profondeur des données | Les équipes matures ont besoin de traces, logs, APM, RBAC, SSO et rétention |
| Qualité de la communauté & du support | Les équipes open source ont besoin d’un bon rythme de release ; les entreprises ont besoin de SLA |
| Capacité d’extraction de données web | Applis IA, workflows RAG et outils de veille marché ont souvent besoin de données externes propres, pas seulement de disponibilité d’un endpoint |
Nous avons aussi segmenté les recommandations par cas d’usage — développeur solo, startup, e-commerce/SaaS, entreprise, puriste open source, équipe produit API et équipe web data/IA — pour aller droit à votre contexte plutôt que de lire 14 résumés en espérant deviner lequel s’applique. L’enquête 2025 de Grafana montre 46 % citant l’interopérabilité et 35 % la facilité de changement futur comme critères, confirmant que ce ne sont pas de simples bonus.
Meilleurs outils de supervision d’API par cas d’usage : le tableau express
Voici le raccourci. Repérez votre ligne, puis allez voir les sections détaillées des outils plus bas.
| Cas d’usage | Outils recommandés | Différenciateur clé |
|---|---|---|
| Équipes web data / applis IA | Thunderbit Open API, Moesif, Apitally | Transformer des sites en Markdown propre ou JSON structuré pour LLM, RAG, prix et recherche |
| Développeur solo / projet perso | UptimeRobot, Uptime Kuma, Gatus | Gratuit ou auto-hébergé, config minimale, prise en main rapide |
| Startup (équipe de 5 à 15 personnes) | Checkly, Better Stack, Postman | Alertes intelligentes, mise en route rapide, prix abordable, pages de statut |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Métriques business, APM/tracing, profondeur SDK, synthetics multi-étapes |
| Entreprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Tracing distribué, conformité, hybride, RBAC/SSO |
| Puristes open source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Contrôle total, natif OTel, pas de verrouillage fournisseur |
| Équipes produit API | Moesif, Apitally, New Relic | Usage par client, tendances endpoint, alertes d’anomalie |
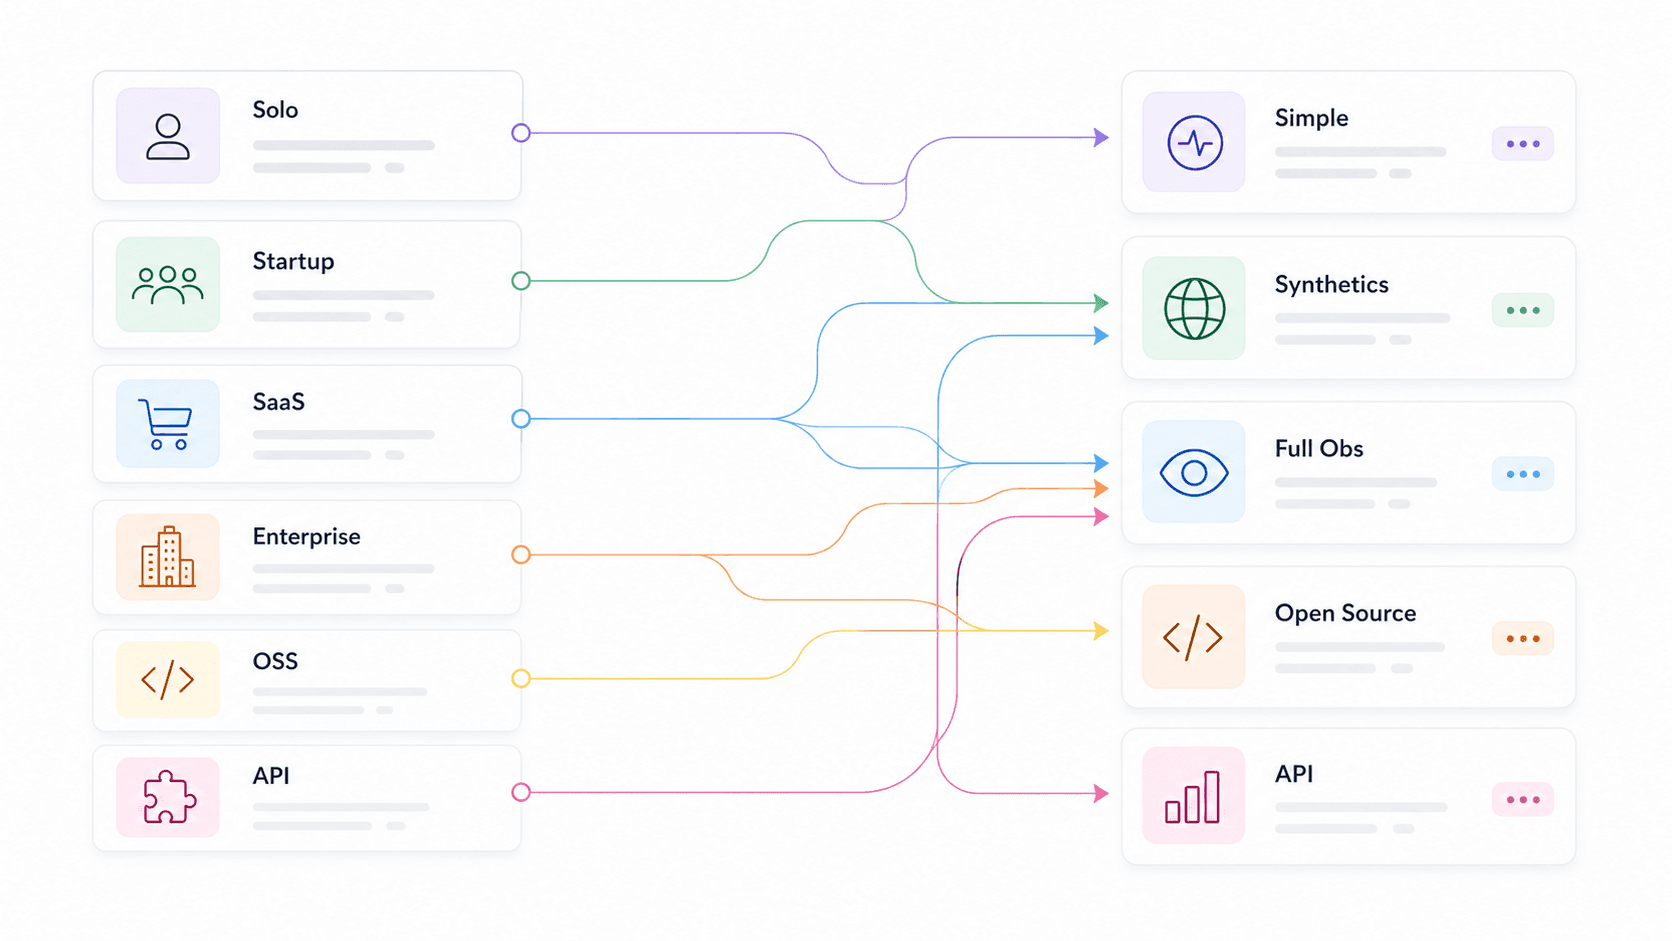
Le grand enseignement : les outils les plus rapides à déployer sont souvent plus légers en analytique, tandis que les plateformes les plus complètes demandent plus de configuration et de discipline budgétaire. Ce n’est pas un défaut — c’est un arbitrage à connaître. Thunderbit se situe ailleurs : il est le plus rapide quand la mission consiste à transformer des pages web en données prêtes pour une API, pas à alerter des ingénieurs sur une panne.
Thunderbit Open API : idéal pour transformer des sites web en données API structurées
Commencez à construire avec Thunderbit Open API Convertissez des pages en Markdown, extrayez du JSON structuré et traitez des URL par lots sans maintenir d’infrastructure de scraping. Get Started Free
Thunderbit Open API est l’API que je mettrais en priorité pour les équipes dont la « supervision » ou la recherche dépend de données web externes. Ce n’est pas un outil de supervision de disponibilité traditionnel comme Checkly ou UptimeRobot. Thunderbit transforme plutôt n’importe quelle page web en données structurées que vos applications, agents, dashboards et pipelines LLM peuvent réellement exploiter.
L’API propose trois workflows. Distill convertit une page en Markdown propre, prêt pour les LLM. Extract prend un schéma et renvoie des champs JSON structurés : nom du produit, prix, disponibilité, taille de l’entreprise, stade de financement ou note d’avis. Batch traite jusqu’à 100 URL de manière asynchrone avec des webhooks, utile pour surveiller pages tarifaires, catalogues concurrents, documentation fournisseur ou longues listes de recherche.
Cet outil mérite sa place dans un guide API car les équipes sous-estiment souvent l’infrastructure requise pour « juste extraire cette page » : rendu pour les sites très JavaScript, routage géographique, nettoyage du HTML (menus, pubs, modales) avant exploitation par un LLM, sélecteurs qui cassent au moindre changement de mise en page. Rotation de proxy, gestion anti-bot, retries et files d’attente peuvent transformer un petit workflow data en projet de maintenance. Thunderbit absorbe l’essentiel de cette complexité derrière une seule API.
Idéal pour : créateurs d’apps IA, équipes RAG, ops e-commerce, sales, growth, analystes marché et développeurs qui veulent des données web via API sans stack de scraping à maintenir.
Tarifs : Gratuit : 600 unités API offertes une seule fois, incluant jusqu’à 600 pages Distill ou 30 pages Extract, avec 2 requêtes simultanées. Starter : 16 $/mois en annuel pour 60 000 unités API/an et 30 requêtes simultanées. Pro : 40 $/mois en annuel pour 600 000 unités API/an et 50 requêtes simultanées.
Vitesse de mise en route : ~5 à 15 minutes pour obtenir une clé API et lancer une première requête Distill ou Extract avec cURL, les SDK ou le Thunderbit CLI.
Limites : Thunderbit ne remplacera pas Datadog, New Relic, Better Stack ou Checkly pour les contrôles de disponibilité, l’escalade d’incidents, les traces, les logs ou le routage on-call. Voyez-le comme l’API pour collecter et structurer des données web — tarifs fournisseurs, documentation, pages concurrentes, fiches produit ou jeux de données publics — pas comme le système qui réveille votre astreinte.
Datadog : le meilleur pour la visibilité full stack
Datadog est l’outil que je vois le plus souvent dans les stacks d’entreprises et de SaaS mid-market, et pour de bonnes raisons. Ce n’est pas seulement de la supervision d’API — c’est une plateforme d’observabilité complète qui relie tests synthétiques, traces distribuées, logs, métriques d’infrastructure et monitoring utilisateur réel dans une vue unique.
Pour la supervision d’API, Datadog prend en charge HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC et les tests API multi-étapes. Ses moniteurs de détection d’anomalies apprennent les patterns attendus et alertent sur les écarts plutôt que sur des seuils statiques — un vrai progrès face à « alerter quand la latence > 500 ms ». Il propose aussi des moniteurs de prévision et des moniteurs composites combinant plusieurs conditions.
Idéal pour : équipes e-commerce, SaaS et entreprise qui veulent une vision unifiée des API, de l’infrastructure, des logs et des traces.
Tarifs : l’offre gratuite varie selon le produit. Infrastructure Pro commence à 15 $/hôte/mois ; les tests synthétiques API sont à 5 $ pour 10 000 exécutions. Plus de 800 intégrations.
Vitesse de mise en route : ~15 à 30 minutes pour installer l’agent et créer un test synthétique de base.
Limites : peut devenir coûteux à grande échelle — les « factures qui font mal » reviennent souvent sur Hacker News et Reddit. Le nombre de SKU (hôtes, logs, métriques personnalisées, synthetics, utilisateurs) implique qu’il faut surveiller la facture, pas seulement les dashboards. La prise en main de la plateforme complète demande du temps.
Checkly : le meilleur pour des checks synthétiques pensés pour les développeurs
Checkly est l’outil que je donnerais à une startup qui veut des checks API près de son code. Son principe central : le « monitoring as code » — définir les checks API et navigateur par programme, les exécuter depuis des emplacements globaux, les intégrer au CI/CD et tout gérer via Git.
L’angle qualité des alertes est fort. La logique de retries de Checkly est présentée comme la « première ligne de défense » contre les faux positifs — configurez des retries fixes, linéaires ou exponentiels, depuis le même ou un autre emplacement, avec une durée max avant déclenchement. L’outil distingue aussi les états dégradé, en échec et rétabli, ce qui réduit les pages inutiles.
Idéal pour : startups et équipes dev qui veulent des checks API programmables, des checks navigateur basés sur Playwright, une intégration CI/CD et une mise en route rapide.
Tarifs : un plan gratuit avec 10 moniteurs de disponibilité, 1 000 checks navigateur et 10 000 checks API. Starter autour de 24 $/mois en annuel — vérifiez la page tarifaire officielle avant achat.
Vitesse de mise en route : ~10 à 20 minutes pour un premier check API et une chaîne d’alerte.
Limites : centré sur les checks synthétiques. Ce n’est pas un remplacement pour un APM profond, l’analytique des logs ou le tracing distribué. Pour corréler une panne d’API avec un goulot d’étranglement base de données, il faudra un autre outil à côté.
UptimeRobot : le meilleur pour un suivi simple et abordable de la disponibilité
UptimeRobot, c’est la Honda Civic de la supervision d’API. Il fait une chose, et il la fait bien : vous créez un moniteur HTTP, mot-clé, ping, port, SSL ou heartbeat, choisissez un intervalle, et recevez une alerte en cas d’échec. C’est tout.
Idéal pour : développeurs solo, petites équipes, agences ou toute personne ayant besoin d’un suivi basique de disponibilité et de latence sans complexité.
Tarifs : Gratuit : 50 moniteurs, intervalles de 5 minutes. Offre Solo payante autour de 7 $/mois en annuel. Pas de carte bancaire requise pour l’offre gratuite. Vitesse de mise en route : ~2 à 5 minutes — la plus rapide de cette liste.
Limites : intelligence d’alerte limitée. Alertes de seuils basiques, pas de détection d’anomalies, pas de tracing distribué, pas d’analytique avancée. Si vous devez comprendre pourquoi un endpoint est lent (et pas seulement qu’il est lent), UptimeRobot ne suffira pas.
Uptime Kuma : le meilleur outil gratuit et auto-hébergé pour superviser des API
Uptime Kuma est la coqueluche de la communauté self-hosting, et les chiffres GitHub parlent d’eux-mêmes : 86 637 étoiles, 7 831 forks, 1 060 contributeurs, version 2.3.2 en mai 2026. Sous licence MIT, il prend en charge HTTP(s), mot-clé, requête JSON, WebSocket, TCP, ping, DNS, push, Docker, plusieurs pages de statut et plus de 90 services de notification.
Idéal pour : développeurs solo et équipes qui veulent un contrôle total, de la confidentialité et zéro coût SaaS récurrent — à condition d’avoir un serveur.
Tarifs : gratuit. Le vrai coût, c’est votre VM/conteneur, les sauvegardes, les mises à jour et le fait de vous assurer que le moniteur reste lui-même disponible. Vitesse de mise en route : ~5 à 15 minutes avec Docker pour un check basique ; 15 à 30 minutes avec notifications et page de statut bien réglées.
Limites : vous assumez la maintenance. Et voici le piège critique : si vous hébergez Uptime Kuma sur la même infrastructure qu’il surveille, une panne cloud ou DNS fait tomber à la fois votre application et votre moniteur. Hébergez-le ailleurs ou combinez-le avec une vérification SaaS.
Better Stack : le meilleur pour une réponse rapide aux incidents
Better Stack (souvent encore appelé Better Uptime) combine supervision de disponibilité, gestion d’incidents, planification d’astreinte, politiques d’escalade et pages de statut en une seule plateforme. Sa force n’est pas tant l’analytique que le workflow d’incident autour de la supervision.
Les politiques d’escalade définissent qui est alerté, dans quel ordre et avec quels délais, jusqu’à accusé de réception. Le routage basé sur les métadonnées envoie les incidents selon leur criticité ou leur propriétaire. L’outil s’intègre à Slack, Teams, webhooks et Zapier.
Idéal pour : startups et équipes de taille moyenne qui veulent supervision + réponse aux incidents + pages de statut sans assembler trois outils différents.
Tarifs : offre gratuite : 10 moniteurs/heartbeats, 1 page de statut. Team autour de 29 $/mois en annuel. Vitesse de mise en route : ~5 à 10 minutes via un assistant graphique.
Limites : moins de profondeur dans l’analyse des payloads API, le tracing distribué ou l’analyse des KPI business que Datadog, New Relic ou Moesif.
Prometheus + Grafana : la meilleure stack open source pour la supervision d’API
C’est le combo open source de référence. Prometheus récupère et stocke les métriques de séries temporelles. Grafana (73 705 étoiles GitHub, 3 010 contributeurs) fournit tableaux de bord et alerting. Alertmanager gère routage, regroupement, déduplication, silence et inhibition. Pour les endpoints API, les équipes ajoutent Blackbox Exporter : HTTP, HTTPS, DNS, TCP, ICMP, gRPC.
Idéal pour : puristes open source, équipes Kubernetes/SRE et organisations déjà standardisées sur Prometheus.
Tarifs : gratuit en auto-hébergé. Grafana Cloud propose une offre gratuite (100 000 exécutions de tests API/mois) et des plans payants selon l’usage.
Vitesse de mise en route : 1 à 4 heures pour un Blackbox + Prometheus + Grafana + Alertmanager de base. Des jours pour une production HA et un réglage fin des alertes.
Limites : PromQL, YAML, relabeling, conception de dashboards, rétention, stockage, haute dispo et tuning des alertes représentent un vrai travail opérationnel. L’arbitrage récurrent : « moins d’interface, plus de YAML ». C’est la stack pour les équipes qui raisonnent déjà en métriques et veulent une seule couche de contrôle — pas pour celles qui veulent un système prêt avant le déjeuner.
New Relic : le meilleur pour la performance des applications SaaS
New Relic combine APM, supervision d’infrastructure, logs, tracing distribué, supervision synthétique, alertes, tableaux de bord et analyse d’incidents assistée par IA. Son offre gratuite — 100 Go/mois d’ingestion et 1 utilisateur full platform — est généreuse pour les petites équipes.
L’intelligence des alertes est là où New Relic se distingue dans le débat sur la fatigue d’alerte. Ses fonctions d’incident intelligence incluent corrélation d’événements, détection d’anomalies, alertes prédictives, analyse des causes racines et suppression du flap. New Relic cite 97,2 % d’efficacité de suppression de flap, soit 28 problèmes visibles pour 1 000 incidents — un chiffre concret de réduction du bruit.
Idéal pour : équipes SaaS et plateformes e-commerce qui veulent une supervision d’API étroitement liée aux traces applicatives, aux erreurs, au débit et à l’impact utilisateur.
Tarifs : gratuit : 100 Go/mois, 1 utilisateur complet. Le payant repose sur la tarification par utilisateur et par volume de données.
Vitesse de mise en route : ~15 à 30 minutes pour l’installation de l’agent et la configuration guidée.
Limites : la tarification peut devenir complexe à grande échelle. La configuration des alertes a une courbe d’apprentissage — la plateforme est puissante, mais pas immédiatement évidente.
Moesif : le meilleur pour l’analytique API et les métriques business
Moesif n’est pas un moniteur de disponibilité classique. C’est de l’analytique API et de l’intelligence produit : comprendre l’usage de l’API par client, endpoint, cohorte, entreprise, géographie, SDK, offre et comportement. Si votre question est « quel client est impacté ? » plutôt que « l’endpoint est-il en ligne ? », Moesif est fait pour ça.
Il prend en charge les alertes à seuil fixe et les alertes d’anomalie dynamiques pour des métriques comme les pics/chutes de trafic, la latence et les changements de comportement. Les alertes dynamiques ont besoin de quelques jours de données comportementales pour bâtir un modèle, mais une fois entraînées, elles détectent des variations que les règles statiques ratent.
Idéal pour : équipes produit API, entreprises SaaS et plateformes e-commerce qui veulent relier la performance API au revenu, à l’engagement et à la rétention.
Tarifs : offre gratuite/essai disponible ; les plans payants évoluent selon le volume d’événements API. Les montants en libre-service n’étaient pas entièrement récupérables dans mes recherches — vérifiez la page actuelle.
Vitesse de mise en route : ~20 à 45 minutes (l’intégration SDK/proxy/gateway est plus profonde qu’un simple ping externe).
Limites : plus orienté analytique que supervision de disponibilité traditionnelle. Il est probable que vous vouliez le combiner avec Checkly, UptimeRobot ou Datadog synthetics pour les contrôles d’accessibilité externes.
Splunk : le meilleur pour l’analyse de logs et la conformité en entreprise
Splunk est l’outil vers lequel on se tourne quand agrégation des logs, recherche, corrélation, auditabilité conforme et prise en charge hybride/multi-cloud ne sont pas négociables. Splunk Observability Cloud couvre l’infrastructure, l’APM, les synthetics, le real user monitoring, les logs et la réponse aux incidents. ITSI/Event Analytics regroupe les événements notables en épisodes et réduit le bruit entre silos.
La recherche 2025 de Splunk sur l’observabilité est sans détour : 73 % des répondants ITOps/ingénierie déclarent des pannes dues à des alertes ignorées ou supprimées, 59 % luttent avec trop d’outils disparates et 52 % avec de fausses alertes.
Idéal pour : équipes entreprise et multi-cloud avec des exigences strictes de conformité, sécurité, audit et recherche dans les logs.
Tarifs : usage-based et très orienté devis. Pas d’offre gratuite simple pour la production.
Vitesse de mise en route : l’onboarding cloud peut être plus rapide, mais un déploiement entreprise prend souvent plusieurs jours à plusieurs semaines.
Limites : cher à grande échelle. Configuration complexe. Surdimensionné pour les développeurs solo et les petites startups.
Postman : le meilleur pour les équipes qui testent déjà des API
Postman est avant tout une plateforme de développement et de test d’API, mais son produit de monitoring permet de planifier des collections Postman et de les exécuter depuis des emplacements cloud. Son principal avantage, c’est la réutilisation : si votre équipe QA ou dev a déjà des collections avec assertions, les transformer en moniteurs est une suite logique.
Idéal pour : équipes dev et QA qui utilisent déjà des collections Postman et veulent des checks planifiés sans acheter un outil synthétique séparé.
Tarifs : offre gratuite disponible. Dépassements de monitoring à 0,75 $ pour 1 000 appels ; pack additionnel de 50 000 appels pour 20 $/mois. Vérifiez la page de l’offre actuelle — le packaging Postman change souvent.
Vitesse de mise en route : ~10 minutes si les collections existent déjà.
Limites : les capacités de monitoring sont plus légères que celles d’outils dédiés comme Checkly, Datadog ou New Relic. Les options d’alerte sont basiques.
Autres outils de supervision d’API à regarder
Gatus : tableau de bord de santé léger, auto-hébergé et piloté par la configuration. 10 906 étoiles GitHub, supporte HTTP, ICMP, TCP, DNS, des métriques compatibles Prometheus et des badges de disponibilité. Idéal pour les développeurs solo qui veulent plus simple que Prometheus, mais préfèrent YAML/config-as-code à l’interface d’Uptime Kuma.
Apitally : outil plus récent centré sur l’analytique du trafic API et le suivi de la qualité pour les startups. Annonce une mise en place en moins de 5 minutes avec des alertes personnalisées sur 14 métriques. Bon choix pour une analytique API légère sans adopter une plateforme d’observabilité complète.
Sematext : supervision full stack avec logs, synthetics et visibilité infra. Synthetics autour de 2 $ par moniteur HTTP, 7 $ par moniteur navigateur, minimum 5 $/mois. Alternative moins chère à Datadog pour les équipes mid-market.
Uptrace : backend APM, tracing, métriques et logs natif OpenTelemetry. 4 198 étoiles GitHub. Pas un simple checker de disponibilité, mais idéal pour les équipes standardisées sur OTel qui veulent un backend de tracing open source.
Build vs Buy : faut-il fabriquer sa propre supervision d’API ?
« Je peux juste écrire un script qui ping mes endpoints, non ? »
Cette question revient sans cesse dans les forums de développeurs. J’ai lu assez de discussions Reddit pour voir le schéma : les équipes commencent avec curl + cron, ça fonctionne un temps, puis elles changent quand il leur faut des dashboards, de l’historique, des checks multi-régions, un routage fiable des alertes ou une visibilité transversale.
Une matrice de décision honnête :
| Facteur | Script maison | Outil spécialisé |
|---|---|---|
| Temps de mise en place | 1 à 4 heures (basique) ; jours (robuste) | 5 à 30 minutes |
| Maintenance | Vous en êtes responsable à vie | Le fournisseur gère les mises à jour |
| Qualité des alertes | Basique (en ligne/hors ligne) | Intelligente (tendances de latence, anomalies, retries) |
| Coût | Gratuit (votre temps) | 0 à 500 $+/mois |
| Dashboard | À construire de zéro | Préconstruit, personnalisable |
| À privilégier quand… | ≤3 endpoints, équipe très technique, projet loisir | 5+ endpoints, équipe ops/produit, enjeu de revenu |
Le point clé des forums : ceux qui construisent leur propre solution le regrettent souvent dès qu’ils ont besoin de dashboards, d’historique ou de visibilité inter-équipes. Et il y a le problème méta : « il faut surveiller la surveillance ». Un moniteur auto-hébergé, sa base de données, ses sauvegardes, son réseau et son fournisseur d’alertes doivent aussi être fiables.
Faites-le vous-même si vous avez 2 endpoints et que vous aimez bricoler. Achetez une solution si vous avez un produit à livrer.
La même logique s’applique à l’extraction de données web. Vous pouvez écrire un scraper, lancer des navigateurs headless, faire tourner des proxys, maintenir des sélecteurs, nettoyer du HTML et construire une file de traitement. Mais pour alimenter de façon fiable un produit API, un agent IA ou un workflow de recherche, utiliser Thunderbit Open API est généralement plus rapide que de reconstruire toute l’infrastructure vous-même.
Fatigue d’alerte : pourquoi la qualité des alertes compte plus que leur quantité
C’est peut-être le critère le plus sous-estimé lorsqu’on choisit un outil de supervision d’API. La fatigue d’alerte survient lorsque les équipes reçoivent tant d’alertes bruyantes, dupliquées ou non actionnables qu’elles finissent par toutes les ignorer — et ratent les vrais incidents.
Les chiffres sont parlants. Le rapport 2025 de BigPanda indique qu’une organisation médiane génère 2 350 alertes par jour et 803 406 alertes par an. L’actionnabilité médiane des incidents n’était que de 18 % — moins d’une alerte sur cinq menait à une vraie action. L’enquête 2026 de NeuBird montre que 77 % des équipes on-call reçoivent au moins 10 alertes par jour et que 80 % estiment que la moitié ou moins de ces alertes sont actionnables.
Le meilleur outil de supervision est celui dont les alertes vous inspirent réellement confiance. Comparaison des méthodes d’intelligence d’alerte :
| Outil | Type d’alerte | Méthode de réduction du bruit | Canaux d’alerte |
|---|---|---|---|
| Datadog | Anomalie ML, prévision, composite | Bandes d’anomalie historiques, lignes de base dynamiques, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Seuil + dégradation | Retry avant déclenchement, retries même/autre emplacement | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | Groupement d’incidents IA, anomalie, prédictif | Corrélation d’événements, suppression du flap, cause racine | Slack, PagerDuty, Teams, webhooks |
| Moesif | Anomalie comportementale | Modèles dynamiques après plusieurs jours de comportement | Slack, PagerDuty, e-mail, SMS |
| Better Stack | Disponibilité / incident / on-call | Politiques d’escalade, routage par propriétaire, délais | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Alertes de règles PromQL | Regroupement, déduplication, silence, inhibition | E-mail, PagerDuty, Opsgenie, webhooks |
| Splunk | Événements, épisodes, santé de service | ITSI Event Analytics, regroupement d’épisodes, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Pas une plateforme d’alerting | À utiliser avec votre propre ordonnanceur, workflow tool ou stack de supervision | Webhooks pour les batchs ; alertes gérées à l’extérieur |
Conseil pratique : commencez avec moins d’alertes, mais plus de confiance. Utilisez les retries avant déclenchement, la confirmation multi-région, les alertes SLO basées sur le burn rate, la déduplication et le routage par propriétaire. Alertez sur l’impact utilisateur et les flux critiques (échec du checkout, échec d’auth, 5xx de paiement), pas sur chaque symptôme interne.
Tarifs et offres gratuites 2026 : ce que vous payez vraiment
Les pages de tarification changent. Les offres gratuites évoluent. Les coûts cachés (hôtes, sièges, logs, exécutions synthétiques, ingestion de données) peuvent surprendre. Voici la section que j’aurais aimé voir dans chaque article « meilleurs outils ». Snapshot 2026 :
| Outil | Offre gratuite | À partir de | Carte bancaire requise ? | Meilleur cas d’usage gratuit |
|---|---|---|---|---|
| Thunderbit Open API | 600 unités API uniques | ~16 $/mois en annuel | Non | Extraction de données web pour LLM, RAG, prix et recherche |
| Uptime Kuma | Illimité (auto-hébergé) | — | Non | Supervision complète, votre propre serveur |
| UptimeRobot | 50 moniteurs, intervalles de 5 min | ~7 $/mois | Non | Checks de disponibilité basiques |
| Better Stack | 10 moniteurs, 1 page de statut | ~29 $/mois | Non | Disponibilité startup + page de statut |
| Checkly | 10 uptime, 10k checks API | ~24 $/mois | Oui | Checks synthétiques API |
| Postman | Compte gratuit + quota monitoring | ~14 $/utilisateur/mois | Non | Réutiliser les collections existantes |
| Prometheus + Grafana | Illimité (auto-hébergé) | — | Non | Métriques + visualisation |
| Grafana Cloud | 100k exécutions de tests API/mois | 29 $/mois plateforme + usage | Vérifier | Essai de synthetics managé |
| New Relic | 100 Go/mois, 1 utilisateur complet | Par utilisateur + données | Certains plans | APM + observabilité de base |
| Datadog | Essai/variable selon le produit | 15 $/hôte/mois (Infra Pro) | Souvent oui | Évaluation full stack |
| Moesif | Offre gratuite/essai disponible | Selon le volume | Vérifier | Évaluation analytique API |
| Splunk | Essais disponibles | Sur devis | Parcours commercial | Preuve de concept entreprise |
| Gatus | Illimité (auto-hébergé) | — | Non | Tableau de statut piloté par YAML |
| Apitally | Offre gratuite/essai disponible | Vérifier | Vérifier | Analytique API légère |
| Sematext | Essai/gratuit variable | ~2 $/moniteur HTTP | Vérifier | Synthetics/logs moins chers |
| Uptrace | Gratuit en auto-hébergé | Les offres cloud varient | Vérifier | Évaluation APM OTel |
Note sur les coûts cachés : les outils auto-hébergés (Uptime Kuma, Prometheus, Gatus) sont « gratuits » côté licence, mais une petite VM, les sauvegardes, le temps de maintenance et le basculement externe peuvent vite devenir le vrai coût. Pour les API de données web, le coût caché est souvent différent : maintenance de navigateurs headless, sélecteurs cassés, pools de proxys, contournements anti-bot et nettoyage HTML.
Estimation petite équipe : pour 10 endpoints API et 3 membres, la voie SaaS la moins chère est souvent UptimeRobot gratuit/peu coûteux, Better Stack gratuit/Team, ou Checkly si le volume convient. Datadog et New Relic restent abordables pour une évaluation, mais la facture réelle dépend des hôtes, utilisateurs, logs, traces et du volume de synthetics. Si votre projet a besoin de données web via API, les unités gratuites de Thunderbit suffisent pour tester avant de passer au payant.
Scorecard de complexité de mise en route : à quelle vitesse obtenir votre première alerte
Aucun article concurrent que j’ai trouvé n’évalue le time-to-value — le temps entre l’inscription et la première alerte réellement utile. Pour les petites équipes, c’est souvent plus important que la profondeur fonctionnelle.
| Outil | Temps jusqu’à la première alerte | Niveau technique requis | Approche de configuration |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minutes | Faible à moyen | Clé API, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minutes | Faible | Interface graphique, ajout en un clic |
| Better Stack | ~5–10 minutes | Faible | Assistant graphique |
| Checkly | ~10–20 minutes | Faible à moyen | Code ou GUI |
| Postman | ~10 minutes (avec collections) | Faible à moyen | Planificateur de collections |
| Uptime Kuma | ~5–30 minutes | Moyen | Docker + GUI |
| Gatus | ~15–45 minutes | Moyen | YAML + Docker |
| Datadog | ~15–30 minutes | Moyen | Installation de l’agent + GUI |
| New Relic | ~15–30 minutes | Moyen | Agent + configuration guidée |
| Moesif | ~20–45 minutes | Moyen | Intégration SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 minutes | Moyen | GUI, Terraform en option |
| Prometheus + Grafana | 1 à 4 heures | Moyen à élevé | YAML, PromQL |
| Uptrace | 30–90 minutes | Moyen à élevé | Intégration SDK OTel |
| Splunk | De quelques heures à plusieurs semaines | Élevé | Onboarding entreprise |
Si la supervision doit être en production avant la fin de la journée, commencez par la moitié supérieure du tableau. Si l’objectif est une observabilité durable, prévoyez un projet séparé pour la moitié inférieure. Et si votre premier jalon est « récupérer des données propres de 100 pages web vers une application », commencez par Thunderbit avant de bâtir une infrastructure de scraping sur mesure.
Comparatif des meilleurs outils de supervision d’API : vue d’ensemble
Un seul tableau à consulter avant de trancher :
| Outil | Meilleur cas d’usage | Offre gratuite | Intelligence des alertes | Temps de mise en route | Hébergement | Fonction phare |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Extraction de données web / pipelines API | 600 unités API | Pas un outil d’alerte | 5–15 min | Cloud | Convertit en Markdown ou JSON basé sur schéma |
| Datadog | Enterprise/SaaS full stack | Essai/variable | Anomalie, prévision, IA | 15–30 min | Cloud | Corrèle synthetics avec logs/traces/infra |
| Checkly | Synthetics orienté dev | Generous checks-based | Retries, dégradation | 10–20 min | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Disponibilité simple | 50 moniteurs | Seuils basiques | 2–5 min | Cloud | Moniteur basique rapide et peu coûteux |
| Uptime Kuma | Auto-hébergé gratuit | Illimité | Statut/seuils basiques | 5–30 min | Auto-hébergé | UI propre, pas de frais SaaS |
| Better Stack | Réponse aux incidents / pages statut | 10 moniteurs | Escalade, routage | 5–10 min | Cloud | Supervision + on-call + page de statut |
| Prometheus + Grafana | Stack open source de métriques | Illimité (auto-hébergé) | Regroupement Alertmanager | 1–4 h | Auto-hébergé/cloud | Profondeur de l’écosystème PromQL |
| New Relic | APM SaaS + checks API | 100 Go/mois, 1 utilisateur | Groupement IA, suppression flap | 15–30 min | Cloud | Bon APM + synthetics ensemble |
| Moesif | Analytique API / métriques business | Gratuit/essai | Anomalies comportementales | 20–45 min | Cloud | Comportement API par client |
| Splunk | Logs entreprise / conformité | Essai | Épisodes ITSI, AIOps | Jours et + | Cloud/auto-géré | Recherche de logs, gouvernance entreprise |
| Postman | Équipes qui testent déjà des API | Compte gratuit | Alertes de monitoring basiques | 10 min | Cloud | Réutilise les collections de tests API |
Comment Thunderbit peut accélérer votre évaluation des outils API
Transparence totale : Thunderbit n’est pas un outil de supervision d’API — c’est un scraper web agentique et une Open API qui transforme des pages web en Markdown propre ou en JSON structuré. D’où son utilité ailleurs dans la décision : collecter tarifs fournisseurs, limites de plan, promesses fonctionnelles, documentation et intégrations avant de choisir une plateforme.
Au lieu d’ouvrir manuellement plus de 10 pages tarifaires et de copier noms de plans, limites, intervalles de vérification, intégrations et exigences de carte bancaire dans un tableur, nous avons utilisé l’extension Chrome Thunderbit pour extraire des données structurées des pages tarifaires et fonctionnalités de chaque outil. L’IA lit chaque page et suggère les champs — nom du plan, offre gratuite, prix payant, intégrations — puis structure le résultat dans un tableur exportable.
Pour les workflows développeur, Thunderbit Open API propose la même logique de façon programmatique. Utilisez Distill pour un Markdown propre destiné aux LLM ou au RAG. Utilisez Extract pour des champs précis renvoyés en JSON. Utilisez Batch pour traiter une liste de pages tarifaires, d’URL de documentation, de pages produit ou concurrentes et recevoir les résultats de façon asynchrone.
Le workflow :
- Ouvrir la page tarifaire d’un fournisseur (Datadog, Checkly, UptimeRobot, etc.)
- Cliquer sur « One Click Extract » — l’IA de Thunderbit lit la page, en comprend la structure et remplit le tableau en une passe
- Extraire les sous-pages tarifaires, fonctionnalités et documentation de chaque fournisseur
- Exporter vers Google Sheets, Excel, Airtable, Notion ou CSV
Pour les équipes API-first, le workflow via API est tout aussi direct :
- Obtenir une clé API gratuite chez Thunderbit
- Appeler l’endpoint Distill pour du Markdown propre depuis n’importe quelle page publique
- Appeler l’endpoint Extract avec des descriptions de schéma pour du JSON structuré
- Utiliser Batch et les webhooks pour des listes d’URL plus larges
- Envoyer le résultat vers votre application, tableur, entrepôt de données, base vectorielle ou workflow de supervision
Pour une comparaison de plus de 10 fournisseurs, le copier-coller manuel peut prendre 2 à 3 heures en comptant sous-pages tarifaires, documentation et intégrations. Thunderbit a réduit notre première passe à ~15 à 30 minutes, le reste servant à la vérification et aux arbitrages. Si votre équipe ops, achats, recherche ou produit IA évalue des outils sous contrainte de temps, c’est un raccourci pratique. Voyez notre guide scraping web sans coder, découvrez la tarification API de Thunderbit ou notre chaîne YouTube.
Comment choisir le meilleur outil de supervision d’API pour votre équipe
Le « meilleur » outil dépend de la taille de votre équipe, de votre profondeur technique, de votre budget et de ce que signifie un échec pour votre produit.
Un développeur solo n’a pas besoin de Splunk. Une entreprise réglementée ne devrait pas dépendre d’un cron job. Une équipe produit API peut avoir davantage besoin d’analytique client type Moesif que de simples pings. Une équipe e-commerce devrait prioriser les checks du chemin critique : connexion, recherche, ajout au panier, checkout, autorisation de paiement. Une équipe IA ou data peut avoir besoin d’abord d’extraction de données web façon Thunderbit, avant l’observabilité complète.
Trois principes confirmés dans toute ma recherche :
- Adaptez l’outil au cas d’usage. Le tableau express existe pour une raison — commencez par là.
- Privilégiez la qualité des alertes à la quantité. Si votre équipe ignore les alertes, vous n’avez pas de supervision. Vous avez du bruit.
- Ne sous-estimez pas la vitesse de mise en place. Un moniteur actif aujourd’hui et fiable vaut mieux qu’un plan de plateforme parfait qui laisse le checkout non surveillé un mois de plus.
Si vous comparez plusieurs outils en parallèle et voulez accélérer la recherche, essayez Thunderbit pour extraire en masse les données fournisseurs dans un seul tableur. Si vous construisez un produit API, un pipeline RAG, un agent IA ou un workflow d’intelligence marché qui a besoin de données web propres, commencez avec Thunderbit Open API. Il ne choisira pas l’outil à votre place — mais il vous amènera plus vite à la décision, et peut fournir à votre produit une couche de données web fiable.
FAQ sur les meilleurs outils de supervision d’API
Quel est le meilleur outil gratuit de supervision d’API en 2026 ?
Pour une approche SaaS simple, UptimeRobot propose 50 moniteurs gratuits à intervalle de 5 minutes, sans carte bancaire. Pour un contrôle auto-hébergé, Uptime Kuma est open source, illimité, avec une interface propre et plus de 90 services de notification. Pour les équipes qui veulent de la profondeur métrique et ont déjà les compétences techniques, Prometheus + Grafana + Alertmanager est la meilleure stack open source — même si la configuration prend des heures, pas des minutes.
Si votre objectif n’est pas la supervision de disponibilité mais l’extraction de données web via API, Thunderbit Open API propose une offre gratuite de 600 unités API uniques, suffisante pour tester la conversion page → Markdown ou l’extraction JSON basée sur schéma avant de monter en charge.
Quelle est la différence entre la supervision d’API et l’APM ?
La supervision d’API vérifie de l’extérieur disponibilité, temps de réponse, erreurs et exactitude — elle simule ce qu’un utilisateur ou une intégration ressent. L’APM (Application Performance Monitoring) va plus loin dans l’application : traces au niveau du code, requêtes base de données, erreurs d’exécution, latence des files, dépendances de services. Datadog et New Relic couvrent les deux ; UptimeRobot et Uptime Kuma se concentrent sur la disponibilité externe.
Thunderbit Open API est différent des deux : c’est une API d’extraction de données web. Elle aide à transformer des sites externes en Markdown ou en JSON structuré, utile pour les applis LLM, les workflows de recherche, l’intelligence tarifaire et les pipelines data.
À quelle fréquence dois-je superviser mes API ?
Les API de production critiques pour le revenu (checkout, auth, paiement) doivent généralement être contrôlées toutes les minutes. Les API internes ou à faible trafic peuvent souvent être vérifiées toutes les 5 minutes. Mais la fréquence n’est pas tout : utilisez retries, plusieurs régions et assertions pertinentes pour que chaque contrôle soit rapide et fiable. Un check d’une minute qui génère de faux positifs est pire qu’un check de 5 minutes fiable.
Pour les workflows d’extraction de données web, la fréquence dépend de la vitesse d’évolution de la source. Les pages tarifaires peuvent nécessiter une extraction quotidienne ou hebdomadaire. Des données d’inventaire, de voyage ou de place de marché qui bougent vite peuvent demander une actualisation horaire, voire plus fréquente. L’API Batch et les webhooks de Thunderbit sont utiles pour traiter de nombreuses URL selon un calendrier.
Puis-je superviser des API sans écrire de code ?
Oui. UptimeRobot, Better Stack et Uptime Kuma s’utilisent entièrement via interfaces graphiques. Checkly prend en charge une configuration graphique et par code. Postman repose sur une interface à base de collections. Prometheus/Grafana nécessite généralement du YAML et du PromQL. Datadog et New Relic démarrent via une configuration guidée, mais deviennent plus puissants avec une instrumentation poussée.
Si vous voulez extraire des données web sans écrire de code, l’extension Chrome de Thunderbit est la voie no-code. Pour automatiser ce même workflow depuis une application, Thunderbit Open API fournit aux développeurs les endpoints Distill, Extract et Batch.
Comment réduire la fatigue d’alerte liée à la supervision d’API ?
Choisissez des outils à alerte intelligente : détection d’anomalies (Datadog, New Relic), retries avant déclenchement (Checkly), anomalies comportementales (Moesif) ou regroupement/suppression (Prometheus Alertmanager). Commencez avec moins d’alertes, mais plus fiables, centrées sur l’impact utilisateur. Utilisez des alertes SLO basées sur le burn rate plutôt que des seuils statiques, dédupliquez entre services, routez selon la propriété et mesurez l’actionnabilité — si moins de 20 % de vos alertes débouchent sur une action réelle, réduisez d’abord le bruit.
Essayez Thunderbit Open API pour l’extraction de données web Get Started Free
En savoir plus



