
Trustpilot reúne 361 millones de reseñas activas de 1,27 millones de empresas, y la mayoría de los scrapers creados para extraer esos datos dejaron de funcionar hace meses. Si has intentado sacar reseñas últimamente, seguro que te has topado con el ya famoso muro de acceso del login en la página 10 y has visto cómo tu herramienta te devolvía solo errores.
Durante las últimas semanas he estado probando, investigando y comparando herramientas que todavía pueden extraer datos de reseñas de Trustpilot de forma fiable en 2026. El panorama ha cambiado bastante: las protecciones antibots de Trustpilot son más agresivas, su frontend en Next.js genera nombres de clase que cambian con cada despliegue y —lo más importante— ahora el acceso sin autenticación se corta después de solo 10 páginas de reseñas. Un hilo de Reddit de finales de 2025 resumía perfecto la frustración: «ninguno de los actores de la tienda funciona».
Entonces, ¿qué herramientas sí funcionan? Evalué cinco teniendo en cuenta cómo manejan el muro de acceso, las medidas antibot, la carga de mantenimiento y las necesidades prácticas tanto de marketers como de desarrolladores.
Por qué extraer reseñas de Trustpilot es más difícil de lo que parece en 2026
Trustpilot no es un sitio estático sencillo al que le puedas hacer una petición HTTP básica y analizar con BeautifulSoup. Es una plataforma moderna y renderizada de forma dinámica sobre Next.js, y sus defensas se han endurecido bastante durante el último año.
Esto es a lo que realmente te enfrentas:
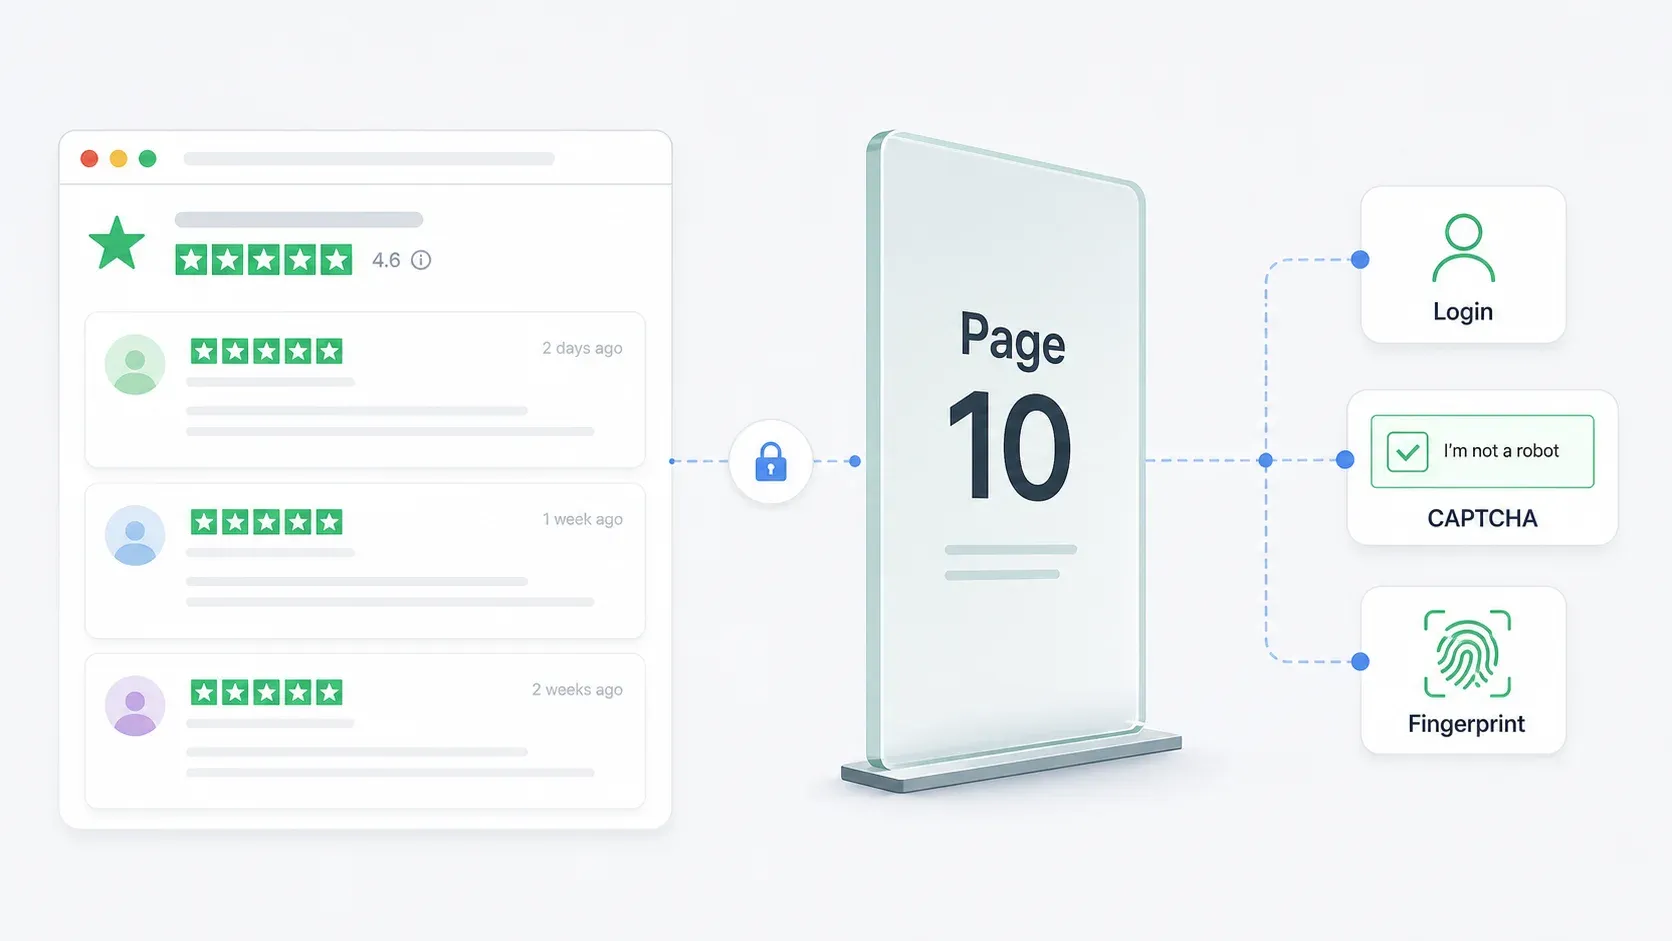
El muro de login en la página 10. Este es el mayor dolor de cabeza. La guía propia de Web Scraper sobre Trustpilot de marzo de 2026 confirma que Trustpilot solo permite acceder a las primeras 10 páginas de reseñas antes de mostrar un aviso de inicio de sesión. Para una empresa con 2.000 reseñas (unas 100 páginas si hay 20 reseñas por página), te quedas sin acceso al 90% de los datos salvo que tengas una sesión autenticada.
Protecciones antibot. Trustpilot usa reCAPTCHA, bloqueos basados en sesión, filtrado de solicitudes a nivel de CDN y fingerprinting del navegador. Su página About indica explícitamente que el sitio está «protegido por reCAPTCHA» y recopila señales del dispositivo y de interacción.
Nombres de clase CSS dinámicos. Como Trustpilot usa Next.js con CSS modules, nombres como styles_reviewCardInner__EwDq2 se generan en compilación y cambian cada vez que Trustpilot despliega una actualización. El propio tutorial de ScraperAPI depende de estos selectores exactos, lo que significa que cualquier código basado en ese tutorial se romperá la próxima vez que Trustpilot cambie el frontend.
Cambios en la estructura del DOM. Más allá de los nombres de clase, también puede cambiar la jerarquía HTML real. Los elementos se anidan de otra forma, aparecen nuevos contenedores y los componentes de paginación se reestructuran.
Los scrapers basados en selectores CSS —ya sean Actors de Apify, flujos de Octoparse o scripts personalizados en Python— son frágiles por naturaleza en Trustpilot. Funcionan hasta que dejan de hacerlo. Y ese «hasta que dejan de hacerlo» suele medirse en semanas, no en meses.
Qué buscamos en los mejores extractores de reseñas de Trustpilot
No evalué estas herramientas con el criterio genérico de «¿puede extraer una página web?». Todas las herramientas de esta lista pueden sacar datos de una página HTML sencilla.
La pregunta real es: ¿puede con Trustpilot específicamente, con todas sus particularidades, en 2026?
Esto fue lo más importante:
| Criterio | Por qué importa en Trustpilot |
|---|---|
| Gestión del muro de login (página 10+) | La mayoría de las empresas tiene mucho más de 200 reseñas. Un límite de 10 páginas significa perder la mayor parte del histórico. |
| Enfoque para saltar medidas antibot | reCAPTCHA, bloqueos de sesión y filtrado por CDN detendrán en seco a scrapers ingenuos. |
| Resistencia de selectores / mantenimiento | Los nombres de clase generados rompen con frecuencia las herramientas basadas en selectores. ¿La herramienta se repara sola? |
| Soporte de paginación | Las reseñas pueden abarcar cientos de páginas. Extraer página por página manualmente no es viable. |
| Sin código vs. con código | Los marketers necesitan una solución de apuntar y hacer clic; los desarrolladores quieren control total. |
| Precio / plan gratuito | Los equipos con presupuesto ajustado necesitan claridad antes de comprometerse. |
| Opciones de exportación | Los usuarios de negocio necesitan Google Sheets, Airtable, Notion, no solo JSON en bruto. |
El muro de login es lo que marca la diferencia.
Si una herramienta no puede pasar de la página 10 —o al menos no ofrece una vía clara para acceder con autenticación— no es un scraper viable para Trustpilot en 2026.
Los mejores extractores de reseñas de Trustpilot, de un vistazo
La comparación completa:
| Herramienta | Nivel técnico | Gestión del muro de login | Enfoque antibot | Paginación | Plan gratuito | Opciones de exportación |
|---|---|---|---|---|---|---|
| Thunderbit | Sin código | Modo navegador (usa tu sesión de Chrome iniciada) | La extracción semántica con IA se adapta a cambios de diseño | Auto-detección, múltiples páginas | 6 páginas gratis/mes | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Bajo código | Depende del Actor; algunos requieren cookies para páginas >10 | Rotación de proxies integrada, específico de cada Actor | Configurable por Actor | Créditos gratis de plataforma por 5 $/mes | JSON, CSV, Excel, XML, RSS |
| Octoparse | Sin código (visual) | Configuración manual de cookies/sesión | Rotación de IP, proxies residenciales, resolución de CAPTCHA (de pago) | Flujo de clics/scroll | Plan gratis + prueba premium de 14 días | CSV, Excel, JSON, HTML, XML, bases de datos |
| Web Scraper | Sin código (sitemap) | Limitado: su propia guía documenta el tope de 10 páginas | Nube + proxy en planes de pago | Configurable; se recomienda clic con JS | Extensión gratuita de Chrome | CSV, XLSX |
| ScraperAPI | Para desarrolladores (Python) | Gestión de sesión/cookies a nivel de código | Más de 40M de proxies residenciales, renderizado JS, gestión de CAPTCHA | Basado en código | Prueba de 7 días, 5.000 créditos API | Lo que defina tu código (CSV, JSON, etc.) |
1. Thunderbit

Thunderbit es una extensión de Chrome impulsada por IA, pensada para equipos de negocio que necesitan datos estructurados de sitios web sin escribir código. En el caso concreto de Trustpilot, ofrece una plantilla dedicada para extraer reseñas que obtiene nombre del revisor, puntuación, título, texto de la reseña, fecha y respuesta de la empresa con un solo clic.
Aquí tengo cierto sesgo —trabajo aquí—, pero la razón por la que construimos Thunderbit así está directamente relacionada con por qué es tan difícil extraer datos de Trustpilot. Nuestra IA lee las páginas de forma semántica en lugar de depender de selectores CSS. Cuando Trustpilot cambia los nombres de clase o reestructura el DOM, Thunderbit se adapta porque busca el significado de los elementos de la página, no su dirección HTML exacta.
Prueba Thunderbit para extraer Trustpilot
Cómo resuelve Thunderbit el muro de login de la página 10
Aquí es donde importa el modo navegador. Thunderbit funciona dentro de tu navegador Chrome, el mismo donde ya tienes iniciada sesión en Trustpilot. Cuando cambias al modo de extracción en navegador, la extensión lee las páginas visibles en tu sesión autenticada. Sin trucos con proxies. Sin inyección de cookies. Sin pools de sesiones con Playwright.
El flujo práctico es sencillo: inicia sesión en Trustpilot en Chrome, entra en la página de reseñas que quieras y abre la extensión. Un clic y la IA identifica qué campos de reseña contiene la página y hace la extracción por sí sola. ¿Quieres otro formato de datos? Descríbelo y la IA se ajusta a eso. A partir de ahí, la paginación ocurre automáticamente: Thunderbit recorre todas las páginas a las que tu sesión del navegador puede acceder.
Por qué Thunderbit no se rompe cuando Trustpilot cambia
Nuestra página de plantilla de Trustpilot lo compara directamente: los scrapers tradicionales fallan cuando cambian los diseños y hay que actualizar selectores CSS. Thunderbit usa IA semántica que entiende el contenido sin depender de CSS concreto, maneja contenido dinámico y gestiona la auto-paginación.
Compáralo con el código del tutorial de ScraperAPI, que analiza por nombres de clase como styles_reviewCardInner__EwDq2. Ese selector se romperá la próxima vez que Trustpilot despliegue cambios. La IA de Thunderbit pregunta «¿dónde está el texto de la reseña en esta página?» en lugar de «¿qué hay dentro de este div con esta clase exacta?».
Funciones clave para extraer Trustpilot
- Campos detectados por IA: la extensión detecta por sí sola los campos de reseña (nombre, puntuación, fecha, título, texto, respuesta de la empresa) sin configuración manual —o, si tienes un conjunto concreto en mente, se lo indicas y lo usa
- Flujo de un clic: un clic → la tabla lista. Y ya.
- Modo navegador para páginas con login: funciona dentro de tu sesión autenticada de Chrome para acceder a la página 10+
- Auto-paginación: gestiona conjuntos de reseñas de múltiples páginas sin intervención manual
- Extracción de subpáginas: puede visitar perfiles individuales de revisores para enriquecer datos
- Extracción programada: configura monitorización semanal o mensual de reseñas para seguimiento de reputación
- Exportaciones: Google Sheets, Airtable, Notion, CSV, JSON — todo incluido gratis
Precio
- Plan gratuito: 6 páginas/mes, sin tarjeta de crédito
- Sistema por créditos: 1 crédito = 1 fila de salida
- Planes de pago: 15 $/mes, o ~9 $/mes con facturación anual (página de precios)
Ideal para: equipos de marketing, operaciones y usuarios de negocio que necesitan reseñas de Trustpilot sin tocar código —y que no quieren mantener un scraper que se rompe cada pocas semanas.
2. Apify
Apify es una plataforma de scraping en la nube con un marketplace de «Actors» preconstruidos: plantillas de scraping creadas por otros usuarios y por el propio equipo de Apify. Para Trustpilot, la tienda incluye varios Actors mantenidos por la comunidad con fiabilidad variable.
La desventaja de Apify es que puede ser potente, pero está fragmentado. Algunos Actors funcionan. Otros están obsoletos. Algunos requieren cookies para la página 10+. Y las quejas de Reddit sobre que «ninguno de los actores de la tienda funciona» son reales: reflejan lo rápido que los cambios de Trustpilot pueden romper la lógica específica de cada Actor.
Actors de Trustpilot y limitaciones conocidas
El Apify Store incluye varios Actors para Trustpilot. Al menos uno (del desarrollador «burbn») documenta explícitamente que hace falta introducir una cookie para páginas más allá de la 10. Otros tienen valoraciones de 0,0, muy pocos usuarios o fechas de modificación muy recientes, señales de que el mantenimiento sigue activo y la fiabilidad varía.
También merece la pena mencionar los Actors obsoletos. Uno de los más antiguos leía directamente el JSON incrustado __NEXT_DATA__ de Trustpilot, un enfoque ingenioso que era más rápido que analizar el DOM, pero que igualmente se rompió cuando Trustpilot cambió su estructura de datos.
Gestión del muro de login y antibot
- Muro de login: depende por completo del Actor que elijas. Algunos admiten inyección de cookies para la página 10+; otros no.
- Antibot: la plataforma de Apify incluye rotación de proxies e infraestructura basada en unidades de cómputo. Los proxies residenciales están disponibles a 8 $/GB en los planes Free/Starter.
- Mantenimiento: variable. Cuando un Actor se rompe, o esperas a que quien lo mantiene lo arregle, o cambias a otro Actor, o encargas un Actor privado personalizado.
Precio
- Plan gratuito: 5 $/mes en uso prepago, sin tarjeta de crédito
- Starter: 9 $/mes + pago por uso
- Scale: 99 $/mes + pago por uso
- Exportaciones: JSON, CSV, Excel, XML, RSS (según el Actor)
Ideal para: usuarios con cierto nivel técnico que pueden evaluar varios Actors, configurar cookies y solucionar problemas cuando algo falla. No es la mejor opción para equipos que buscan una solución de configurar y olvidarse.
3. Octoparse
Octoparse es un scraper sin código basado en escritorio con un constructor visual de flujos de trabajo de apuntar y hacer clic. Se sitúa entre la simplicidad de un clic de Thunderbit y el control total para desarrolladores de ScraperAPI: ofrece configuración visual sin código, pero sigues teniendo que construir y mantener un flujo.
Cómo configurar una extracción de Trustpilot en Octoparse
El proceso es bastante directo, aunque manual:
- Pega una URL de reseñas de una empresa en Trustpilot
- Selecciona visualmente los elementos de la reseña (título, cuerpo, puntuación, fecha, nombre del revisor)
- Define un bucle de paginación usando el botón de la siguiente página
- Configura los tiempos de espera (se recomiendan 2–5 segundos para evitar reCAPTCHA)
- Ejecuta localmente para muestras pequeñas o en la nube para trabajos más grandes
La configuración toma entre 10 y 15 minutos para alguien que ya conoce la herramienta. El problema es que, como Octoparse usa selectores visuales ligados a elementos del DOM, tendrás que actualizar el flujo cada vez que Trustpilot cambie su estructura de página.
Gestión del muro de login y antibot
- Muro de login: requiere configuración manual de login/cookies/sesión. No lo gestiona automáticamente.
- Antibot: los planes de pago incluyen rotación de IP, proxies residenciales (3 $/GB) y resolución automática de CAPTCHA (1–1,5 $ por mil).
- Mantenimiento: moderado. Espera reconstruir o ajustar el flujo cuando Trustpilot actualice el frontend.
Precio
- Plan gratuito: gratis para siempre, 10 tareas, 1 dispositivo, extracción local, hasta 50.000 filas/mes
- Standard: 69 $/mes (facturación anual)
- Professional: 149 $/mes
- Prueba premium de 14 días: incluye extracción en la nube, programación, API y plantillas
- Exportaciones: Excel, CSV, JSON, HTML, XML; bases de datos y Google Sheets en planes superiores
Ideal para: usuarios que quieren control visual del flujo, no les importa invertir tiempo en la configuración inicial y se sienten cómodos manteniendo procesos cuando las páginas cambian. Buena opción para equipos que necesitan más personalización que una herramienta de un clic, pero menos complejidad que escribir Python.
4. Web Scraper
Web Scraper es una extensión de Chrome y una plataforma en la nube con un enfoque basado en sitemaps para extraer datos. Su propuesta más fuerte para Trustpilot es una plantilla preconstruida para páginas de empresas que extrae datos a nivel de compañía: nombre de la empresa, categoría, dirección, puntuación, número de reseñas, TrustScore y URL del sitio web.
Para extraer reseñas concretas, Web Scraper tiene una limitación documentada que conviene señalar.
Plantilla preconstruida vs. configuración personalizada
La plantilla del marketplace funciona bien para descubrir empresas: extrae perfiles de negocio en distintas categorías de Trustpilot. Para una extracción personalizada de reseñas, el Sitemap Wizard te permite crear un scraper visualmente dentro de la extensión de Chrome.
La guía propia de Web Scraper de marzo de 2026 recomienda usar paginación con clics por JavaScript en lugar de paginación basada en URL, porque Trustpilot puede reordenar dinámicamente el contenido entre páginas y provocar desplazamientos en los resultados.
Gestión del muro de login y antibot
Aquí la transparencia importa: la guía oficial de Web Scraper indica explícitamente que Trustpilot solo permite las primeras 10 páginas de reseñas antes de mostrar un aviso de login. La guía documenta esto como una limitación conocida en lugar de ofrecer una solución.
- Muro de login: gestión limitada. El tope de 10 páginas está documentado en su propia guía.
- Antibot: los planes en la nube incluyen soporte de proxies; la guía recomienda retrasos de 2–5 segundos y reducir la concurrencia.
- Paginación: configurable, pero en la práctica limitada a las primeras 10 páginas de reseñas para acceso sin autenticación.
Precio
- Extensión gratuita de Chrome: scraping local, funcionalidad limitada
- Project: 50 $/mes (5.000 créditos de URL)
- Professional: 100 $/mes (20.000 créditos de URL)
- Scale: desde 200 $/mes (créditos de URL ilimitados con condiciones)
- Prueba gratis de 7 días en planes de pago en la nube
- Exportaciones: CSV, XLSX
Ideal para: usuarios que quieren una plantilla lista para usar para extraer perfiles de empresa de Trustpilot, o que solo necesitan reseñas de las primeras 10 páginas. No es la opción adecuada si necesitas el histórico completo de reseñas de empresas con muchas opiniones.
5. ScraperAPI
ScraperAPI es infraestructura de scraping para desarrolladores, no una herramienta de apuntar y hacer clic, sino una capa de proxies/renderizado que gestiona medidas antibot mientras tú escribes la lógica de análisis. Su página de solución para Trustpilot anuncia renderizado JS, gestión de CAPTCHA y más de 40M de proxies.
Si eres desarrollador Python y quieres control total sobre la lógica de extracción, ScraperAPI te da la parte de infraestructura.
Pero el mantenimiento también corre por tu cuenta.
Crear un scraper personalizado de Trustpilot con ScraperAPI
El tutorial de ScraperAPI de enero de 2026 muestra un flujo de trabajo en Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
El código final del tutorial establece pages_to_scrape = 10, reconociendo de forma implícita el límite público de páginas. Para la página 10+, los desarrolladores tienen que gestionar por su cuenta las sesiones autenticadas, cookies y tokens.
Gestión del muro de login y antibot
- Muro de login: se requiere gestión de sesión/cookies a nivel de código. ScraperAPI se encarga de proxies y renderizado; tú te ocupas de la lógica de autenticación.
- Antibot: pool de proxies residenciales con rotación automática de IP, renderizado JS mediante
render=true, y gestión de CAPTCHA mediante rotación inteligente de proxies. Disponible en todos los planes. - Mantenimiento: cuando Trustpilot cambia los nombres de clase (algo frecuente), debes actualizar tu código de análisis. El selector
styles_reviewCardInner__EwDq2del tutorial ya es una cuenta atrás.
Precio
- Prueba de 7 días: 5.000 créditos API gratis, sin tarjeta de crédito
- Hobby: 49 $/mes (100.000 créditos API)
- Startup: 149 $/mes (1.000.000 de créditos)
- Business: 299 $/mes (3.000.000 de créditos)
- Exportaciones: lo que produzca tu código (normalmente CSV, JSON o escritura en bases de datos)
Ideal para: desarrolladores que quieren máxima personalización, pueden mantener sus propios scripts de análisis y necesitan control programable sobre la gestión de sesiones, la lógica de paginación y la estructura de los datos. No es para usuarios no técnicos.
Por qué los scrapers de Trustpilot siguen rompiéndose y cómo elegir uno que aguante
Este es el factor más infravalorado al elegir un scraper para Trustpilot. La pregunta no es «¿funciona hoy?». Es «¿seguirá funcionando dentro de tres semanas?».
Los scrapers se rompen en Trustpilot por cuatro motivos recurrentes:
-
Cambios en nombres de clase CSS generados. Los CSS modules de Next.js producen nombres como
styles_reviewCardInner__EwDq2. Cambian con cada despliegue del frontend. Cualquier scraper que apunte a esas clases se rompe. -
Cambios en la estructura del DOM. Trustpilot puede reestructurar su jerarquía HTML: anidar de otra manera las tarjetas de reseñas, cambiar elementos contenedores o mover metadatos a otras posiciones.
-
Cambios en los disparadores antibot. Los umbrales de reCAPTCHA se mueven. La rotación de tokens de sesión se vuelve más agresiva. Se actualizan las reglas de filtrado de CDN.
-
Cambios en autenticación/sesión. El muro de login de la página 10 se introdujo —o se reforzó— a finales de 2025. En el futuro pueden aparecer nuevas restricciones de acceso en cualquier momento.
La diferencia arquitectónica fundamental está entre la extracción basada en selectores y la extracción semántica:
-
Herramientas basadas en selectores (Actors de Apify, flujos de Octoparse, scripts de ScraperAPI, sitemaps de Web Scraper) preguntan: «encuentra el elemento en esta ruta CSS exacta». Cuando la ruta cambia, fallan en silencio o devuelven datos vacíos.
-
Herramientas semánticas o con IA (Thunderbit) preguntan: «encuentra el texto de la reseña, la puntuación y la fecha en esta página». La IA interpreta el contenido por su significado, no por su dirección. Los cambios de diseño no la rompen porque el significado sigue siendo el mismo.
Mi recomendación:
- ¿No toleras mantenimiento? → basado en IA (Thunderbit)
- ¿Aceptas algo de mantenimiento y quieres automatización en la nube? → Apify (con selección y monitoreo de Actors)
- ¿Quieres control visual con mantenimiento moderado? → Octoparse
- ¿Basado en plantillas y con alcance limitado? → Web Scraper
- ¿Control total y te encargas de todo? → ScraperAPI
Qué hacer con las reseñas de Trustpilot extraídas
Extraer reseñas es solo el primer paso. La pregunta que veo constantemente en foros es: «Ya tengo los datos, ¿y ahora qué?»
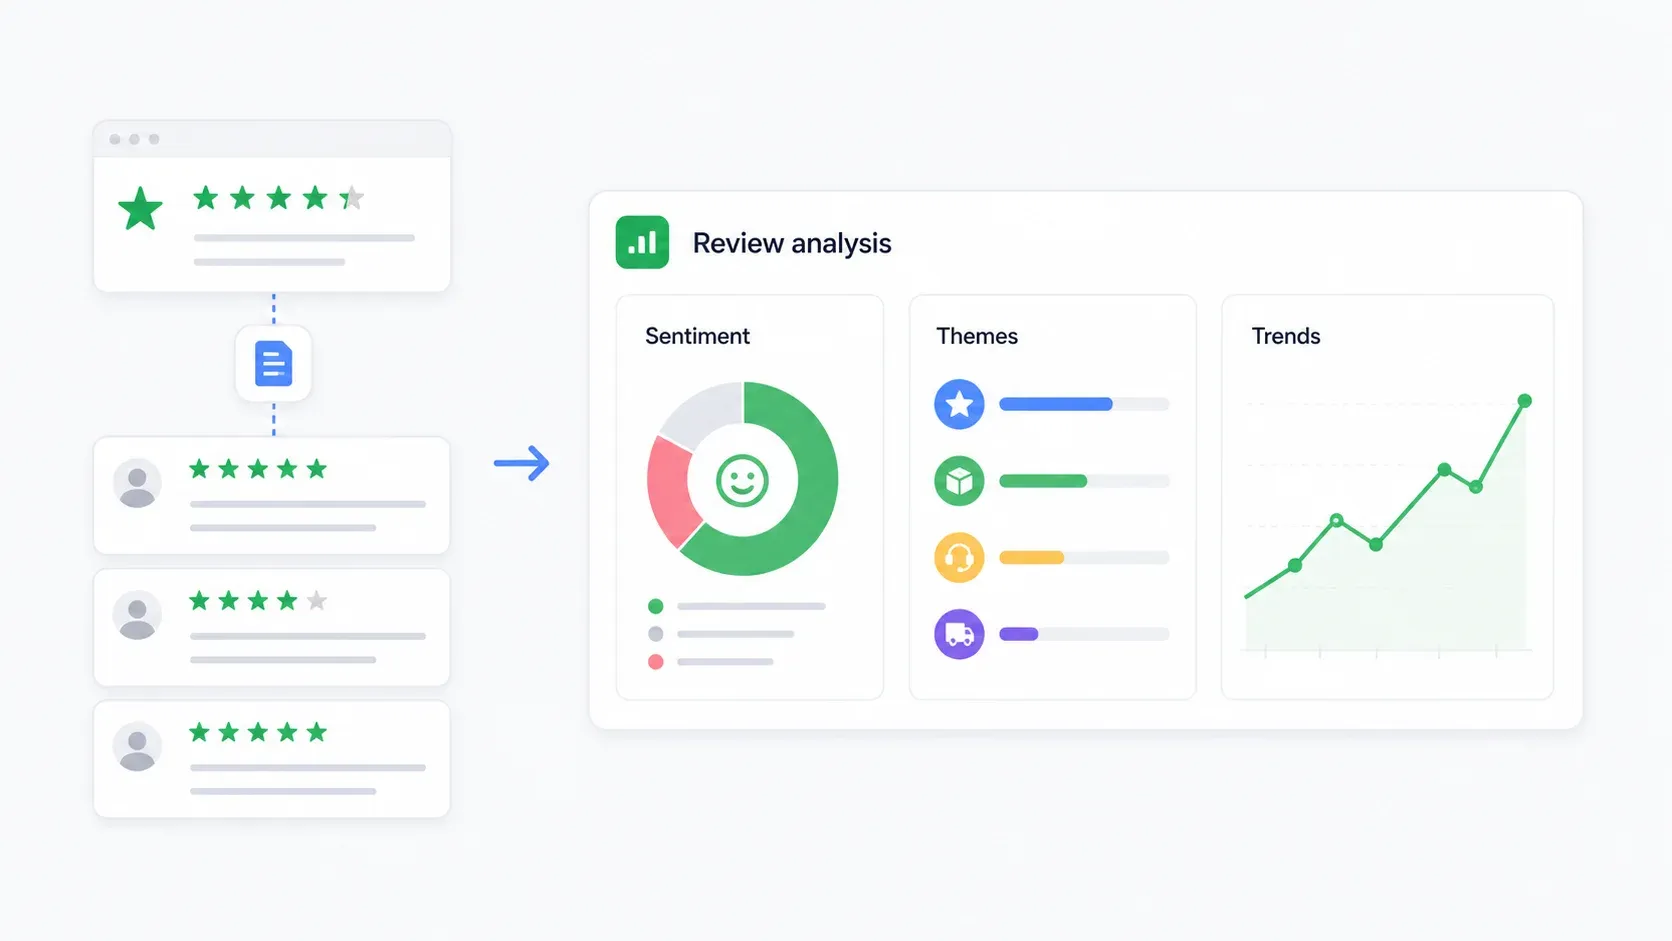
Análisis de sentimiento
El flujo más sencillo: exporta las reseñas a Google Sheets y usa una herramienta de IA (ChatGPT, Claude o una función de IA en Sheets) para clasificar cada reseña como positiva, neutra o negativa. Añade columnas para categoría de queja, urgencia y prioridad de acción sugerida.
Para conjuntos de datos más grandes, sube el CSV a ChatGPT y pídele un resumen: «Clasifica estas reseñas por sentimiento e identifica los 5 temas de queja principales con citas representativas».
Monitorización de la competencia
Usa la extracción programada de Thunderbit para recopilar reseñas de competidores cada semana o cada mes. Haz seguimiento de:
- Tendencia de la puntuación media en el tiempo
- Porcentaje de reseñas de 1 y 2 estrellas
- Cambios en el volumen de reseñas (¿están recibiendo más o menos?)
- Temas de queja más frecuentes
- Tasa y velocidad de respuesta de la empresa
Un panel sencillo de Google Sheets con tablas dinámicas por puntuación y fecha te da un feed de inteligencia competitiva que se actualiza automáticamente.
Extracción de temas
Agrupa las reseñas por categorías comunes: envío/entrega, atención al cliente, devoluciones, calidad del producto, facturación, facilidad de uso de la app, precio/valor y preocupaciones por fraude. El resultado debería ser una tabla con: tema, cantidad, puntuación media, citas representativas y acción empresarial sugerida.
Esto es más útil que una nube de palabras. Te dice qué está impulsando realmente la satisfacción o la insatisfacción.
Análisis masivo de varias empresas
Para investigación a nivel de categoría, extrae reseñas de varias empresas dentro de la misma categoría de Trustpilot. Compara volúmenes de reseñas, puntuaciones, distribución de estrellas y presencia de temas en todo un segmento de mercado. La plantilla de listados de empresas de Web Scraper es útil para descubrir compañías; Thunderbit o ScraperAPI pueden encargarse de la muestra de reseñas de cada una.
Consideraciones legales y éticas al extraer datos de Trustpilot
No soy abogado y esto no es asesoramiento legal. Pero la realidad del cumplimiento importa.
Los Términos de uso de Trustpilot son claros. Prohíben a los usuarios acceder o recopilar contenido «por cualquier medio distinto de los proporcionados o aprobados específicamente por Trustpilot», y mencionan expresamente el text mining, el data mining y el web scraping sin permiso explícito.
El nivel de riesgo se ve así:
- Riesgo más bajo: exportar las reseñas de tu propia empresa para análisis interno, especialmente usando las herramientas oficiales de negocio o la API de Trustpilot.
- Riesgo moderado: extraer páginas públicas de competidores con bajo volumen para investigación de mercado. Sigue sujeto a los Términos de uso y a obligaciones de privacidad.
- Riesgo más alto: extraer contenido de la página 10+ protegida por autenticación, eludir controles técnicos, redistribuir datos de revisores o usar reseñas extraídas para entrenar modelos de IA.
Consideraciones GDPR: el nombre del revisor, los enlaces al perfil, el texto de la reseña y los datos de ubicación pueden considerarse datos personales según la normativa de privacidad de la UE. Entre las medidas prácticas están recopilar solo los campos necesarios, hashear los nombres de los revisores para analítica interna, definir períodos de retención y no republicar texto de reseñas en bruto a gran escala.
Datos públicos vs. autenticados: hay una diferencia legal y ética real entre extraer páginas que cualquiera puede ver (las primeras 10 páginas de reseñas) y extraer datos detrás de un muro de autenticación. Las herramientas que operan solo con datos públicos implican menos riesgo de cumplimiento que las que requieren credenciales de acceso.
Esto debería influir en tu elección de herramienta. El modo navegador de Thunderbit trabaja con las páginas visibles en tu propia sesión; no elude la autenticación por su cuenta. ScraperAPI da a los desarrolladores control total, pero también responsabilidad total sobre la legalidad de la gestión de sesiones.
Cómo elegir el extractor de reseñas de Trustpilot adecuado
Marco de decisión según el perfil:
- Marketer no técnico que necesita reseñas sin código → Thunderbit. Un clic, la IA hace el resto, exportación a Sheets/Notion/Airtable.
- Usuario low-code cómodo configurando y depurando → Apify. Elige un Actor, configura cookies para la página 10+, vigila si se rompe.
- Constructor visual que quiere control del flujo → Octoparse. Configuración por clics, pero espera mantenimiento cuando Trustpilot cambie.
- ¿Necesitas datos a nivel de empresa o solo reseñas de las primeras 10 páginas? → Web Scraper. Buenas plantillas preconstruidas para perfiles de negocio.
- Desarrollador que quiere personalización total → ScraperAPI. Hazte cargo de la lógica de análisis, la gestión de sesiones y el pipeline de datos.
Si tu principal preocupación es el mantenimiento, el espectro va de Thunderbit (mantenimiento casi nulo) a ScraperAPI (tú lo mantienes todo). En cuanto al presupuesto, todas las herramientas de esta lista tienen una vía de entrada gratis: empieza por ahí antes de comprometerte.
Conclusión
Los datos de reseñas de Trustpilot son realmente valiosos para inteligencia competitiva, monitorización de reputación y conocimiento del cliente.
Pero en 2026, extraerlos de forma fiable exige una herramienta que pueda lidiar con el muro de login de la página 10, adaptarse a cambios en el DOM y gestionar protecciones antibot sin intervención manual constante.
Para la mayoría de los usuarios de negocio, Thunderbit es el camino con menos fricción: un clic, detección de campos con IA, modo navegador para páginas autenticadas y cero mantenimiento cuando Trustpilot cambia su frontend. Puedes probarlo gratis con 6 páginas al mes y sin tarjeta de crédito.
Para desarrolladores que quieren control total, ScraperAPI ofrece la infraestructura. Para todos los demás, Apify, Octoparse y Web Scraper cubren nichos concretos. La clave está en hacer coincidir la herramienta con tu nivel técnico, tolerancia al mantenimiento y requisitos de cumplimiento.
Si quieres ver cómo Thunderbit maneja Trustpilot en concreto, tenemos un tutorial en nuestro canal de YouTube. Y para ampliar contexto sobre web scraping sin programar o sobre qué es realmente el web scraping, esas guías cubren los fundamentos.
Preguntas frecuentes
1. ¿Se pueden extraer reseñas de Trustpilot más allá de la página 10?
Sí, pero solo mediante una ruta autenticada. Trustpilot bloquea el acceso sin iniciar sesión después de las primeras 10 páginas de reseñas. El modo navegador de Thunderbit funciona dentro de tu sesión iniciada en Chrome, así que puede acceder a las páginas que tú puedes ver. ScraperAPI requiere gestión de sesión/cookies a nivel de código. Los Actors de Apify necesitan configuración de cookies. Octoparse requiere configuración manual de login/cookies. La propia documentación de Web Scraper reconoce el límite de 10 páginas sin ofrecer un método integrado para evitarlo.
2. ¿Es legal extraer reseñas de Trustpilot?
Los Términos de uso de Trustpilot prohíben la recopilación automatizada de datos sin permiso explícito. El riesgo legal varía según el método y el caso de uso: extraer tus propias reseñas públicas implica menos riesgo que saltarse un muro de autenticación para extraer datos de competidores. El GDPR se aplica a los datos de revisores de la UE. Esto no es asesoramiento legal: consulta con un abogado para proyectos de scraping a gran escala o comerciales.
3. ¿Qué datos se pueden extraer de Trustpilot?
Los campos habituales incluyen: nombre del revisor, puntuación por estrellas, título de la reseña, texto de la reseña, fecha de publicación, fecha de la experiencia, estado de compra verificada, ubicación del revisor, texto de respuesta de la empresa, nombre de la empresa, TrustScore, total de reseñas, distribución de estrellas y URL de la reseña.
4. ¿Con qué frecuencia se rompen los scrapers de Trustpilot?
Las herramientas basadas en selectores (Actors de Apify, flujos de Octoparse, scripts personalizados en Python) pueden romperse cada vez que Trustpilot cambia sus clases CSS o la estructura del DOM, algo que puede ocurrir varias veces al mes. Las herramientas de IA semántica como Thunderbit se adaptan automáticamente porque interpretan el significado de la página en vez de apuntar a selectores concretos. Aun así, ninguna herramienta es inmune a grandes cambios de control de acceso como el muro de login de la página 10.
5. ¿Puedo extraer reseñas de Trustpilot gratis?
Todas las herramientas de esta lista tienen una entrada gratuita: Thunderbit ofrece 6 páginas gratis al mes, ScraperAPI da 5.000 créditos de prueba durante 7 días, Web Scraper tiene una extensión gratuita de Chrome para uso local, Octoparse tiene un plan gratuito para siempre (10 tareas, 50.000 filas/mes) y Apify incluye 5 $/mes en créditos gratuitos de la plataforma. Para pruebas o extracciones pequeñas, cualquiera de ellas funciona sin pagar.
Prueba Thunderbit para extraer reseñas de Trustpilot Get Started Free
Más información



