
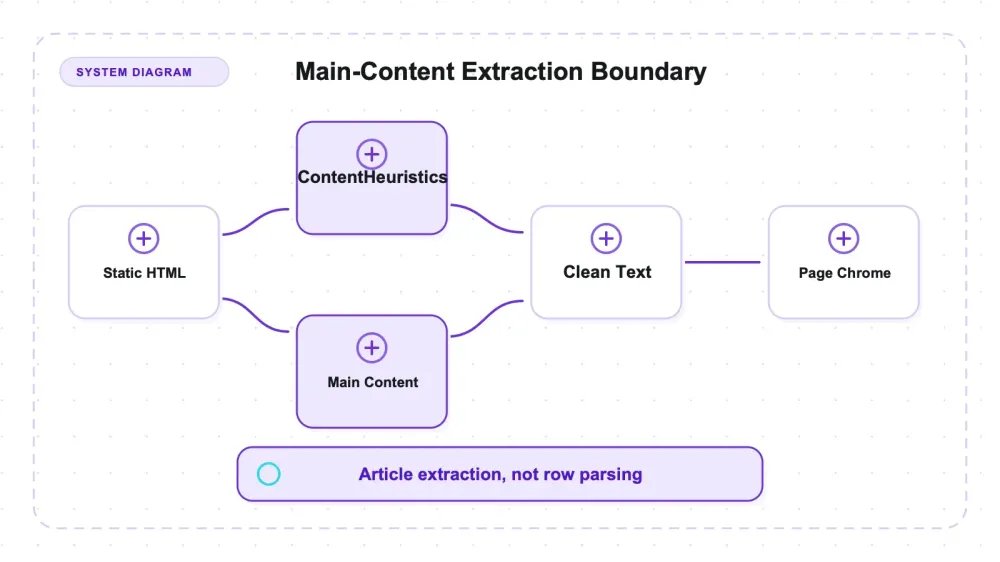
trafilatura je Pythonový extraktor obsahu bez potřeby prohlížeče. V označených testovacích vzorcích v tomto článku má mezi nástroji se stejným HTML a bez prohlížeče jako jediného skutečného soupeře Mozilla Readability: trafilatura propustila jeden z 17 označených boilerplate bloků, zatímco Readability pět. Nástroje závislé na prohlížeči se objevují jen v souvislosti s nároky na nasazení a na těchto stránkách nebyly testovány z hlediska kvality.
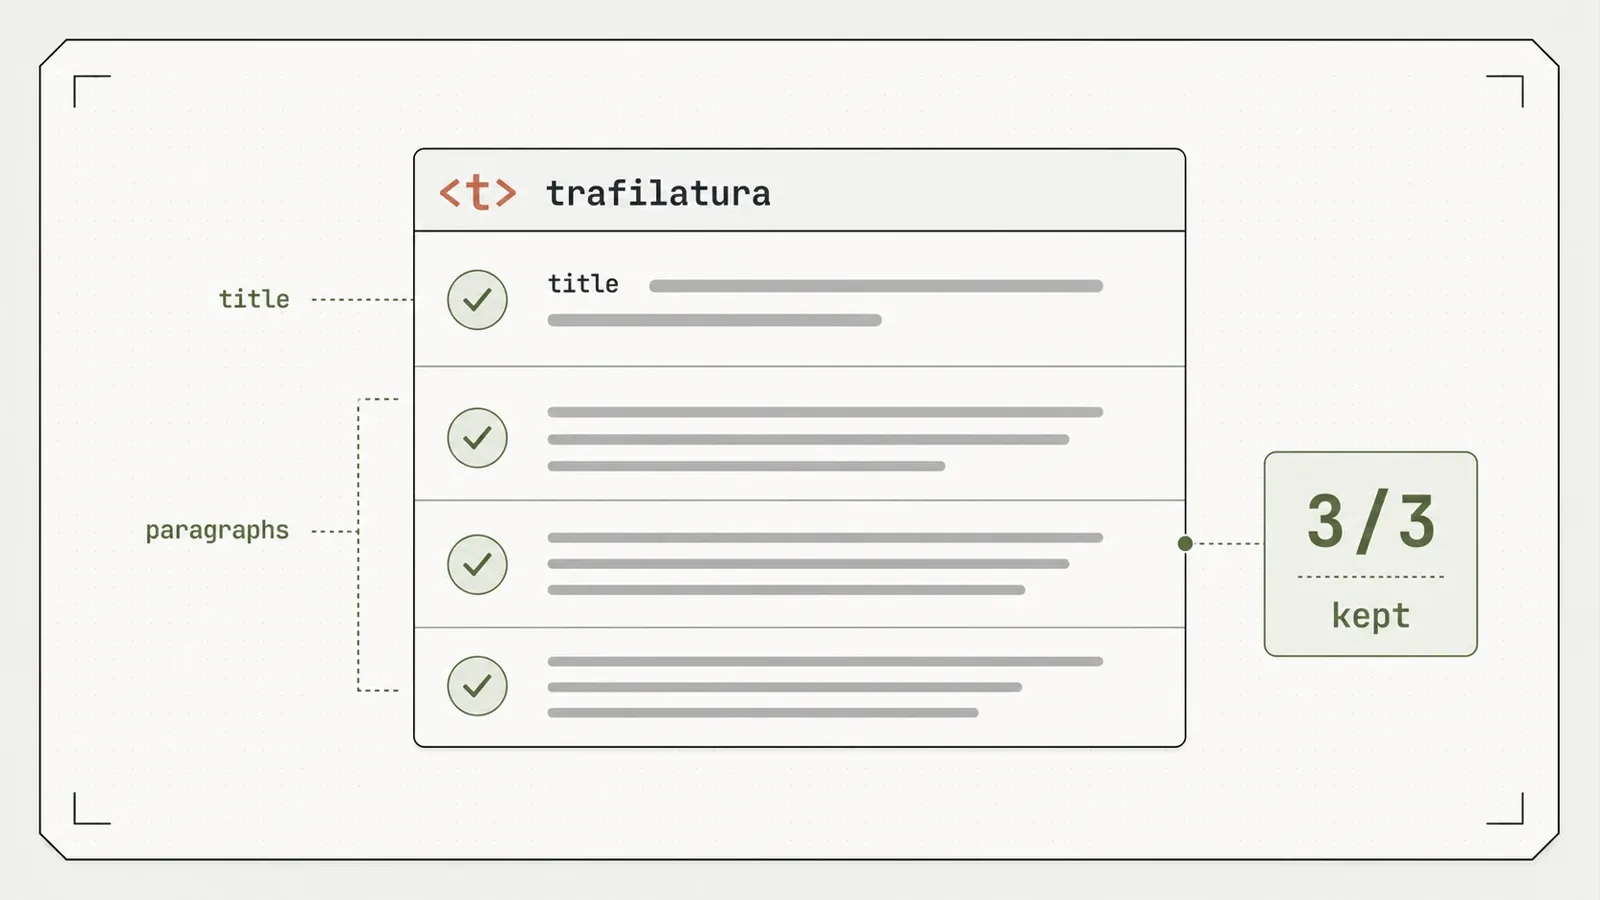
Jejím hlavním úkolem je extrakce hlavního obsahu: vezme HTML a vrátí text a metadata zaměřená na článek, přičemž okolní prvky stránky odfiltruje heuristikami. Umí výstup serializovat jako JSON i do dalších formátů, ale nevytváří uživatelem definované řádkové schéma ani opakované typované záznamy z katalogu. Testována byla verze 2.1.0. Nevykonává JavaScript a srovnání s Readability ukazuje spíš kompromis mezi přesností a zachováním obsahu než jednoznačné vítězství napříč kategoriemi.
Kam trafilatura zapadá a co odmítá dělat
trafilatura se popisuje jako Pythonový a příkazový nástroj pro sběr textu a metadat z webu — pro crawling, scraping i extrakci — s výstupem do CSV, JSON, HTML, Markdownu, TXT nebo XML. To zní velmi široce. V praxi je ale její silná stránka užší a přesnější: vezme HTML dokument a vrátí hlavní obsah bez okolních prvků stránky.
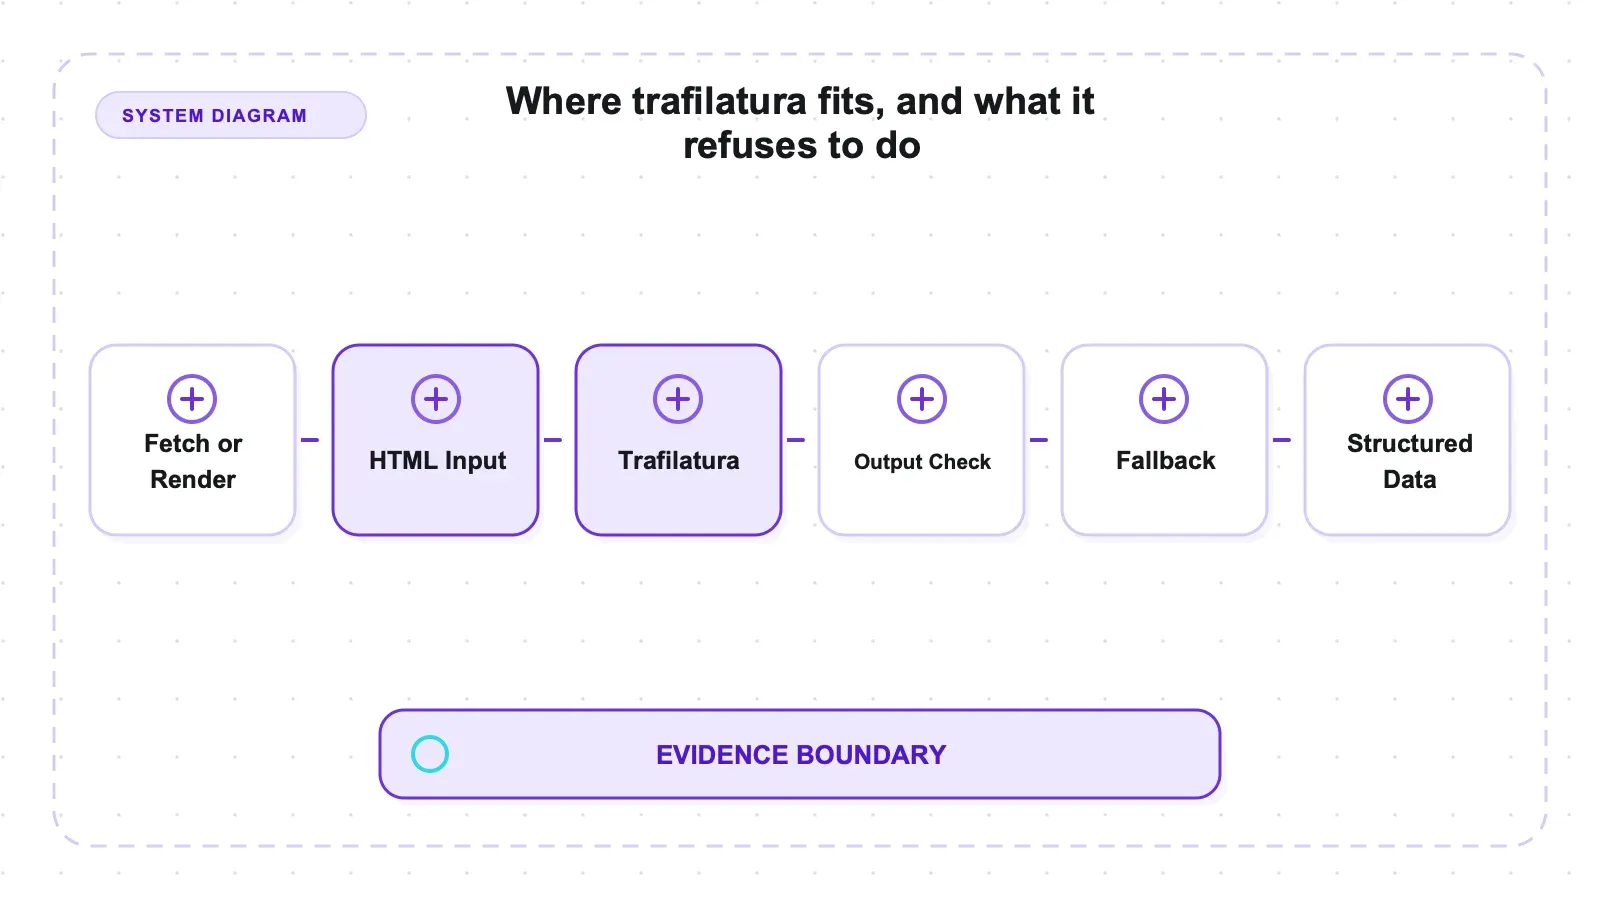
Tady je mentální model, protože vysvětluje jak sílu, tak hranice. Většina scraperů, které na stránku nasadíte, je založená na selektorech — řeknete jim „vezmi prvek s třídou product-price“ a vrátí, co na té adrese je. trafilatura funguje obráceně. Přečte celý dokument a sama rozhodne, které bloky jsou skutečný článek a které jen boilerplate, a to pomocí heuristik obsahu, ne vámi napsaného selektoru. Proto nepotřebuje pro každou stránku vlastní pravidla čištění. A právě proto vám nemůže rovnou vrátit strukturovaný katalog: není tam schéma, nejsou typované řádky, jen „tady je smysluplný text“. Je to extraktor, ne parser, kterému byste zadávali cíle.
Také nevyžaduje samostatně stažené běhové prostředí prohlížeče. Strom závislostí zahrnuje platformní wheels jako lxml, takže „bez stažení prohlížeče“ neznamená totéž co instalace jen ze zdrojových kódů nebo bez nativních komponent.
Instalace: malý balík závislostí, bez instalace prohlížeče
pip install trafilatura v čistém virtualenvu na Pythonu 3.14 nainstalovalo 17 balíčků; největší zaznamenaný wheel byl lxml s 8,6 MB, podle pip-install-trafilatura.log. Nebyla potřeba žádná samostatná instalace prohlížeče ani následný příkaz pro jeho doinstalování.
Pro srovnání: balík Scrapling ve stejné výzkumné základně potřeboval čtyři samostatné pip spouště, aby byly fetchery funkční, a skončil na 26 balíčcích, z nichž dva byly 42,2 MB Playwright driver wheels (tools/scrapling/artifacts/logs/pip-install-scrapling.log) — a to ještě před stažením samotného prohlížeče. Balík Crawlee změřil samostatné stažení Chromia na zhruba 81,7 MiB (tools/crawlee/research-materials.md). Tyto nástroje řeší větší úlohu, takže to není férový souboj na schopnosti; ukazuje to jen to, co uvidí váš disk a CI cache. A verze, kterou mi pip dal (2.1.0), odpovídá aktuálnímu vydání, takže u žádného z čísel níže není hvězdička typu „testovali jste starou verzi“.
Prakticky: co extraktor skutečně vrátil
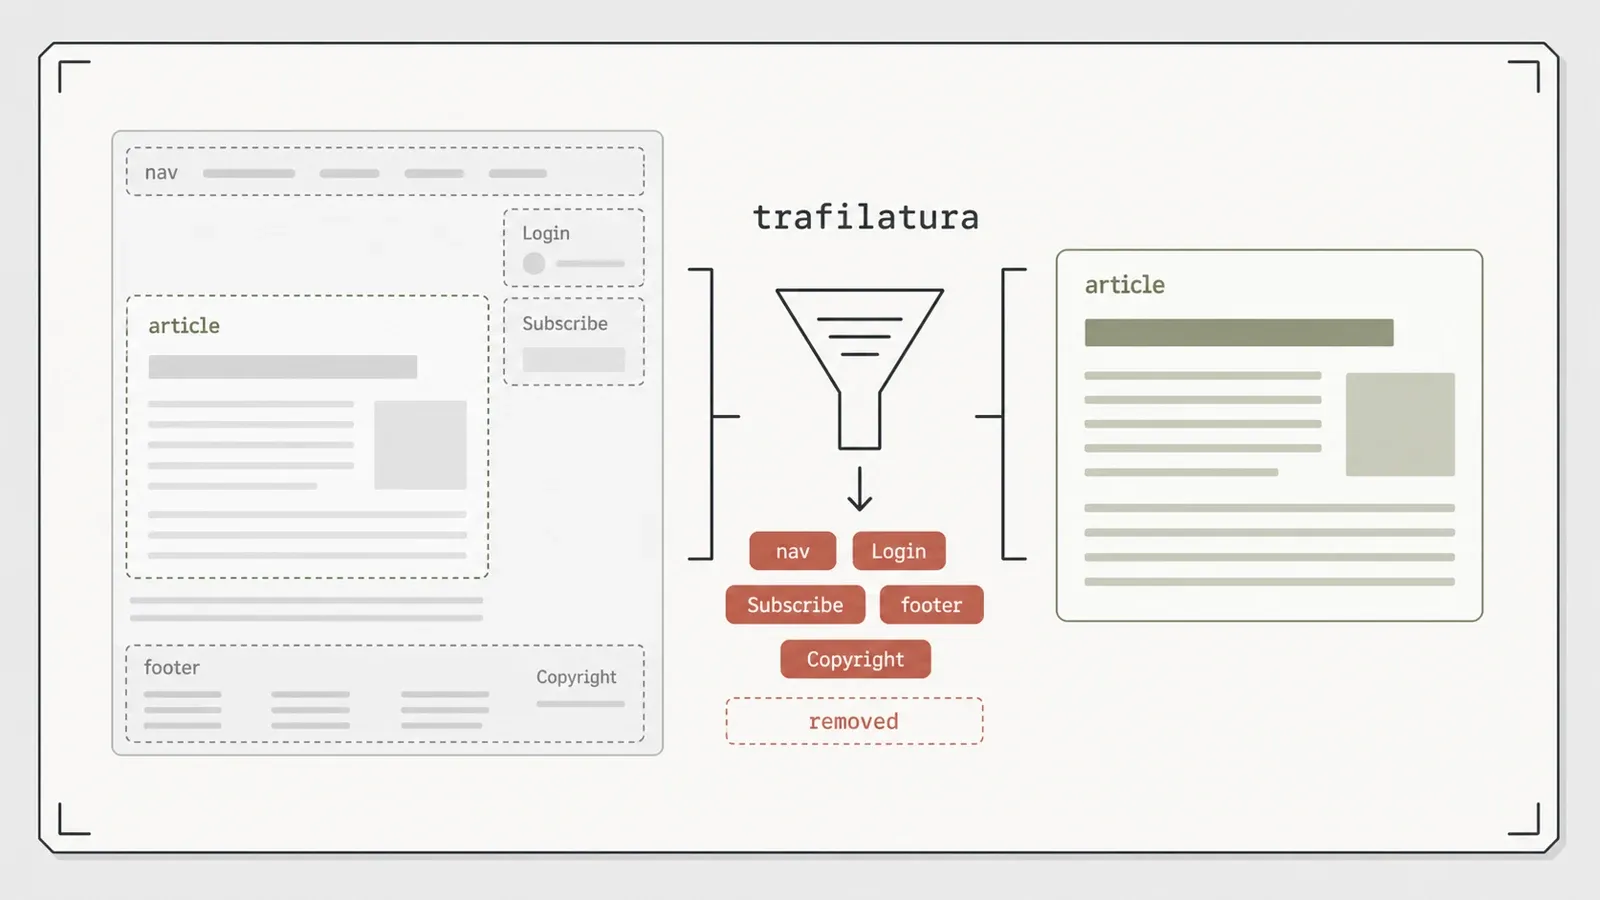
Otestoval jsem ji na vzorcích, které měly zasáhnout jak její silnou stránku, tak její limit, a syrové výstupy jsou uložené v repozitáři benchmarku. Test s článkem byl ten, který mě přesvědčil.
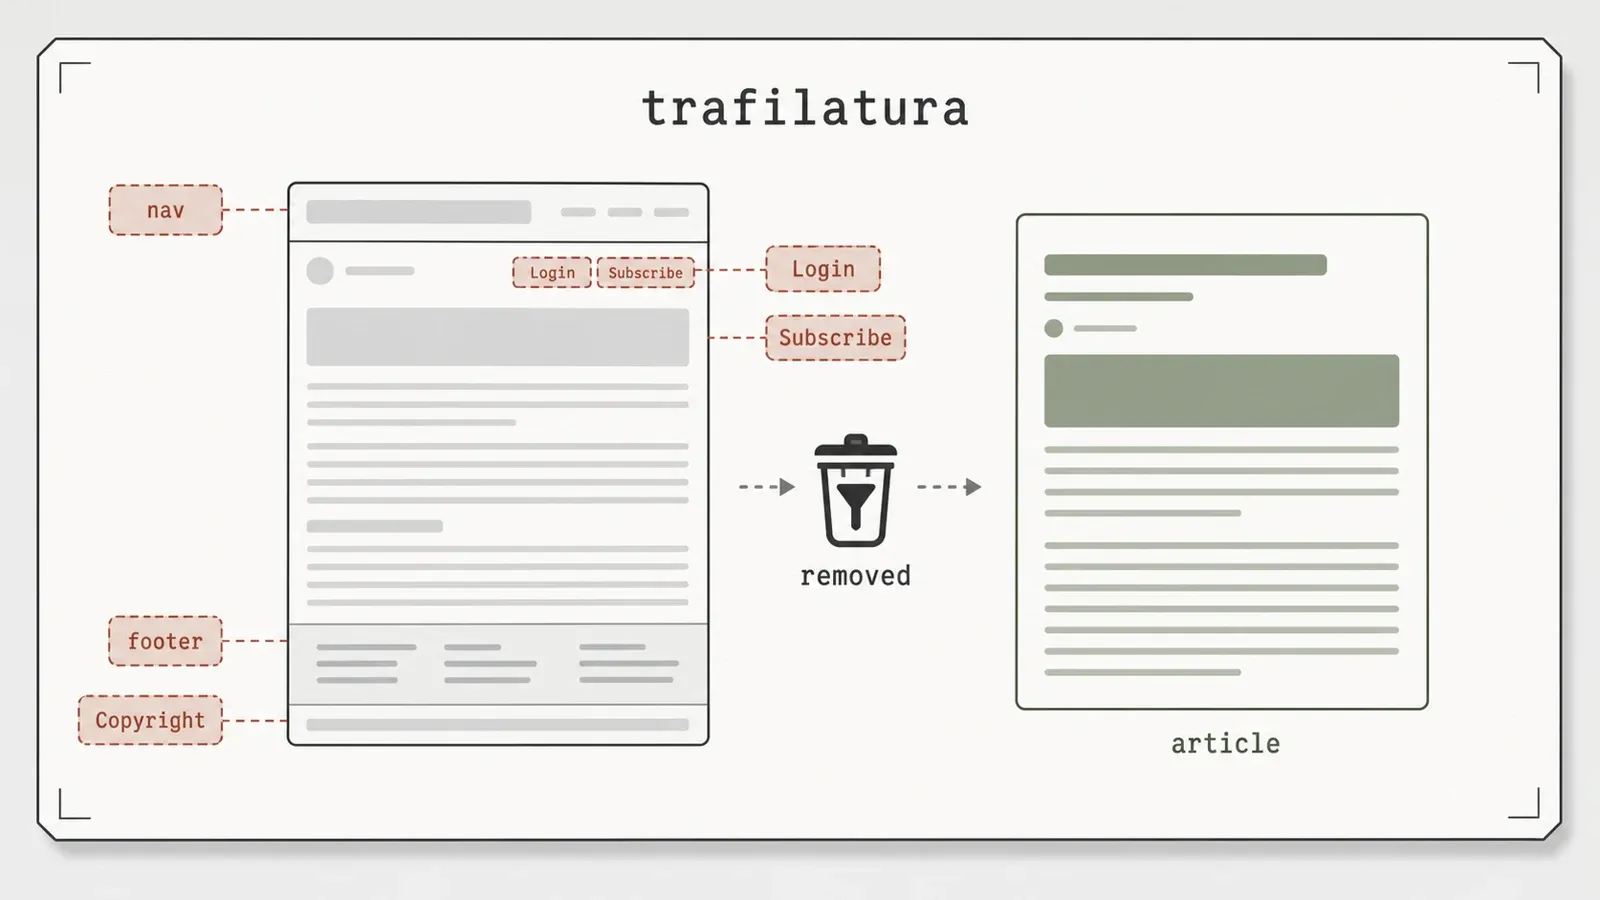
Vzal jsem lokální testovací článek a obalil skutečný obsah šumem: výzvou k přihlášení, nápisem „Subscribe“, navigačními odkazy, copyright patičkou — tedy standardním boilerplate, který naivní scraper stáhne spolu s tělem stránky. trafilatura vrátila titulek plus všechny 3 ze 3 odstavců těla a všechny boilerplate značky — Login, Subscribe, Copyright — z výstupu zmizely. Navíc správně vytáhla autora a datum z metadat stránky. Celý výsledek ve formátech .txt, .md a .json je v results/local_article.json.
Stejné uložené HTML bylo exportováno jako prostý text, Markdown i JSON. Článek ale neprokazuje, že všechny tři formáty vznikly jedním současným voláním; jde o alternativní serializace stejné extrakční cesty. JSON zde balí extrahovaný text a metadata, nikoli uživatelem definované opakované záznamy.
Tady je celý první běh na jednom místě, abyste si mohli tvrzení ověřit, místo abyste jim museli věřit:
| Vzorek | Co se vrátilo | Čas běhu | Důkaz |
|---|---|---|---|
| Lokální článek obalený nav / login / subscribe / copyright | titulek + 3/3 odstavce, bez úniku boilerplate sekcí, autor Thunderbit Research Lab, datum 2026-07-09 | 0.007 s | local_article.json |
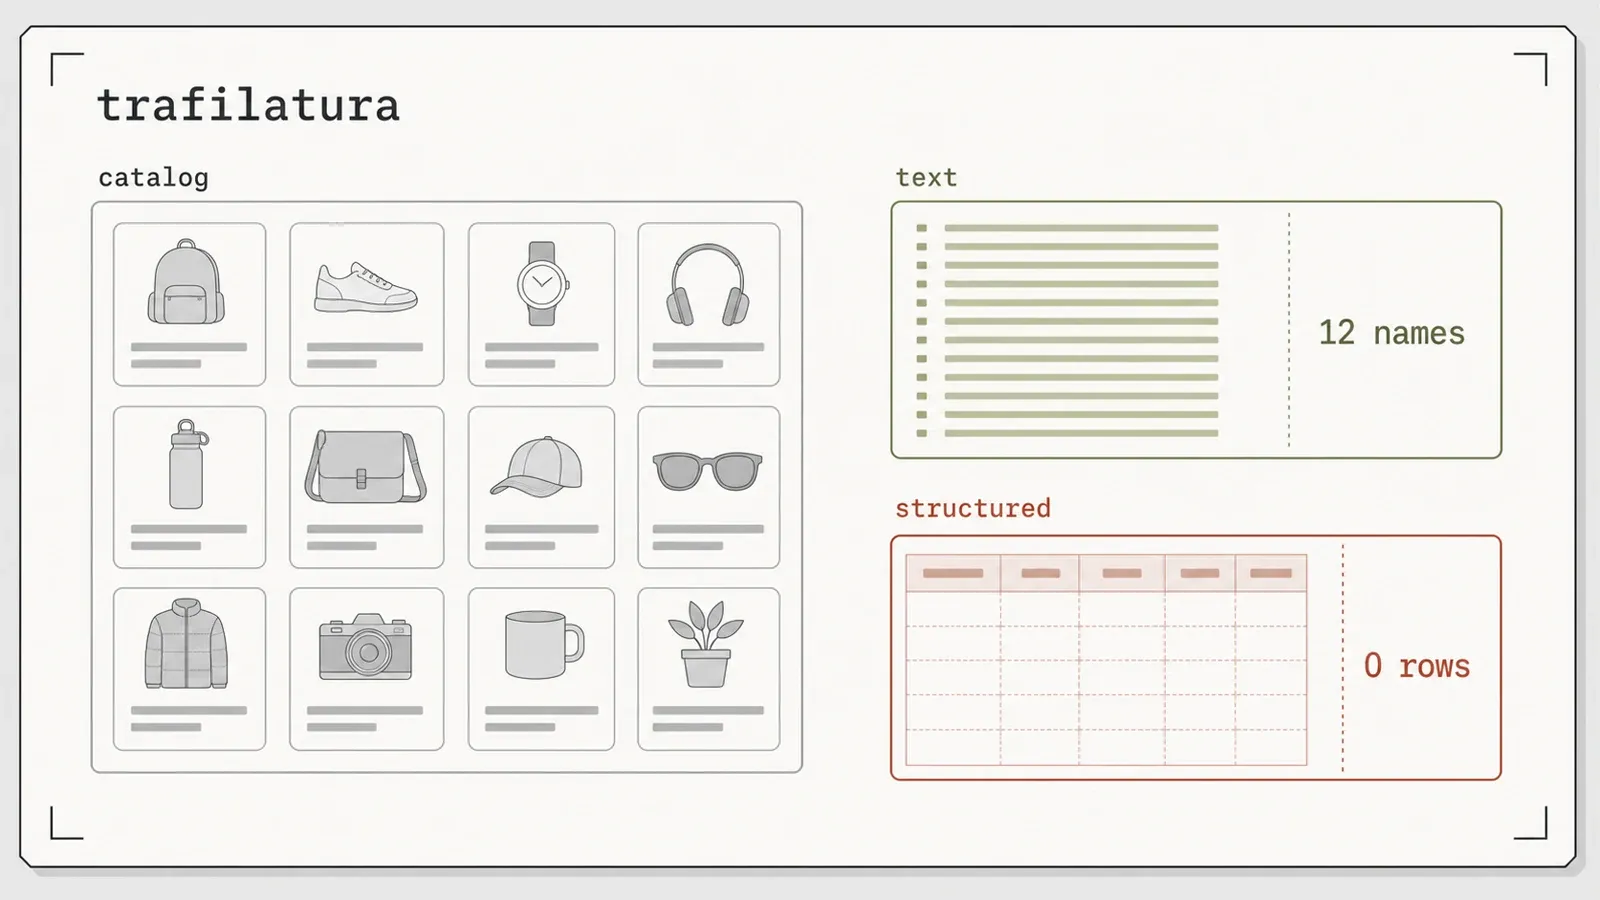
| Lokální produktový katalog | 12 názvů produktů a jejich 12 cen jako plochý text, 0 strukturovaných řádků, 478 znaků | 0.064 s | local_catalog_extraction.txt |
| Stránka vracející HTTP 500 | fetch_url vrátil None, bez vyvolání výjimky | 30.012 s | local_failure_500.json |
| Stránka produktu Books to Scrape (veřejná) | 1 324 znaků čistého textu, plus Markdown varianta | 0.753 s | public_books_product.txt / .md |
Každý řádek vychází z artifacts/raw/trafilatura-test-summary.json v balíku trafilatura — trafilatura 2.1.0, Python 3.14, macOS arm64, jeden běh na jednom stroji. Časy berte jako pozorování, ne jako benchmark.
U vzorku s HTTP 500 vrátil fetch_url po zhruba 30 sekundách None, zatímco blízké lokální endpointy byly rychlé. Běh potvrzuje zpoždění, ne to, zda ho způsobil retry/backoff, pevný timeout nebo jiná interní cesta. Tento článek neověřoval podporovaný parametr timeoutu na úrovni jednotlivého volání pro fetch_url; prokázanou kontrolou je stáhnout obsah klientem pod vaší kontrolou a následně předat výsledné HTML do trafilatury.
Stejné testy zároveň odhalují tři hranice.
Zaprvé a nejdůležitější: trafilatura je extraktor obsahu, ne strukturovaný scraper. Spustil jsem ji na testovacím vzorku produktového katalogu. Vrátila všech 12 názvů produktů — jako text — a přesně 0 strukturovaných řádků (478 znaků plochého textu, podle results/local_catalog_extraction.txt). Ceny se dostaly ven také, od $18.00 po $51.00, a každá stála na vlastním řádku pod názvem produktu. Všechno, co jste chtěli, je uvnitř výstupu; nic z toho ale není pole. Pokud potřebujete [{name, price, rating}, …], je tohle špatný nástroj a žádná konfigurace to nezmění — je to volba návrhu, ne chyba.
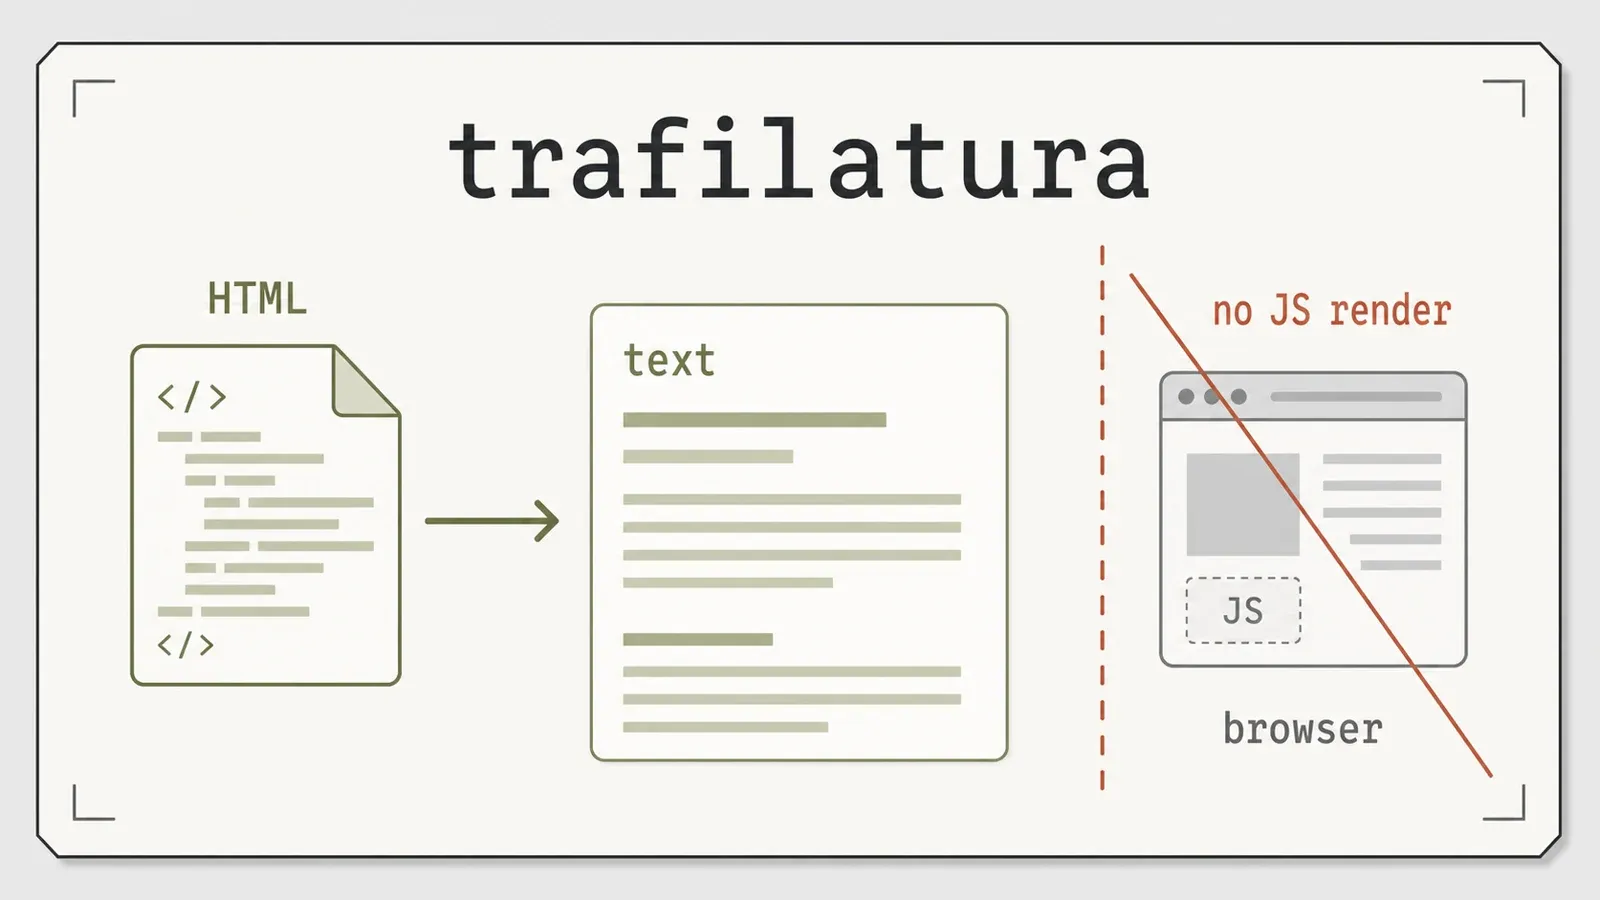
Zadruhé: nerenderuje JavaScript. Pracuje se statickým HTML. Když na něj pošlete stránku renderovanou až v prohlížeči, dostanete jen to, co server poslal před spuštěním JS, což bývá často k ničemu. Pokud jsou vaše cíle silně JS-based, spojte ho s rendererem; trafilatura tuto polovinu práce neudělá.
Zatřetí, poznámka k mým vlastním důkazům: první veřejný extrakční test používal blok s popisem produktu, ne skutečný news článek, protože veřejný sandbox žádné news stránky nemá. Výsledek čištění článku výše pochází z kontrolovaného lokálního vzorku. Věřím mu — odstranění boilerplate je zcela jasné — ale nechtěl jsem vydávat produktovou stránku za důkaz extrakce na úrovni redakčního webu, takže balík to vedl jako otevřenou mezeru. Následný běh z 2026-07-14 ji uzavřel a výsledky jsou v další sekci.
Kontrola boilerplate na reálných stránkách
Dvě reálné stránky byly jednou staženy, uloženy jako offline vzorky s hashi SHA-256 a znovu spuštěny bez síťového přístupu. Nebyl zaznamenán žádný timing ani označený ground truth. Jde o kontrolu boilerplate na reálných stránkách, ne o skóre přesnosti.
| Vzorek reálného článku | Syrové HTML | Extrahované tělo | Tělo/syrové | Odstraněné značky okolních prvků | title | date | hostname | author | sitename |
|---|---|---|---|---|---|---|---|---|---|
| Wikipedia, "Web scraping" | 230 049 bajtů | 26 673 bajtů | 0.116 | 4 ze 4 | ano | 2005-09-17 | wikipedia.org | null | null |
| Wikinews, "7th Heaven" (archivované) | 79 716 bajtů | 2 200 bajtů | 0.028 | 5 z 5 | ano | 2005-11-29 | wikinews.org | null | null |
Oba řádky pocházejí z artifacts/results/trafilatura-fidelity-summary.json. Kontrolované značky byly „Jump to content“, „Privacy policy“, „Powered by MediaWiki“, „This page was last edited“ a na stránce Wikinews také „free news source“ — všechny byly odstraněny, nic neuniklo na žádné z obou stránek.
Poměr body/raw měří redukci, ne přesnost; vynechaný obsah článku nebyl bodově hodnocen. author a sitename byly u těchto dvou šablon MediaWiki null, zatímco kontrolovaný lokální vzorek autora poskytl. Jde o miss specifický pro MediaWiki, pozorovaný v testu, nikoli o důkaz obecné spolehlivosti byline. Extrahovaná data o datu jsou uvedena tak, jak přišla, a nebyla porovnána s ground truth.
Dva extraktory, stejné HTML bajty, jeden hodnoticí skript
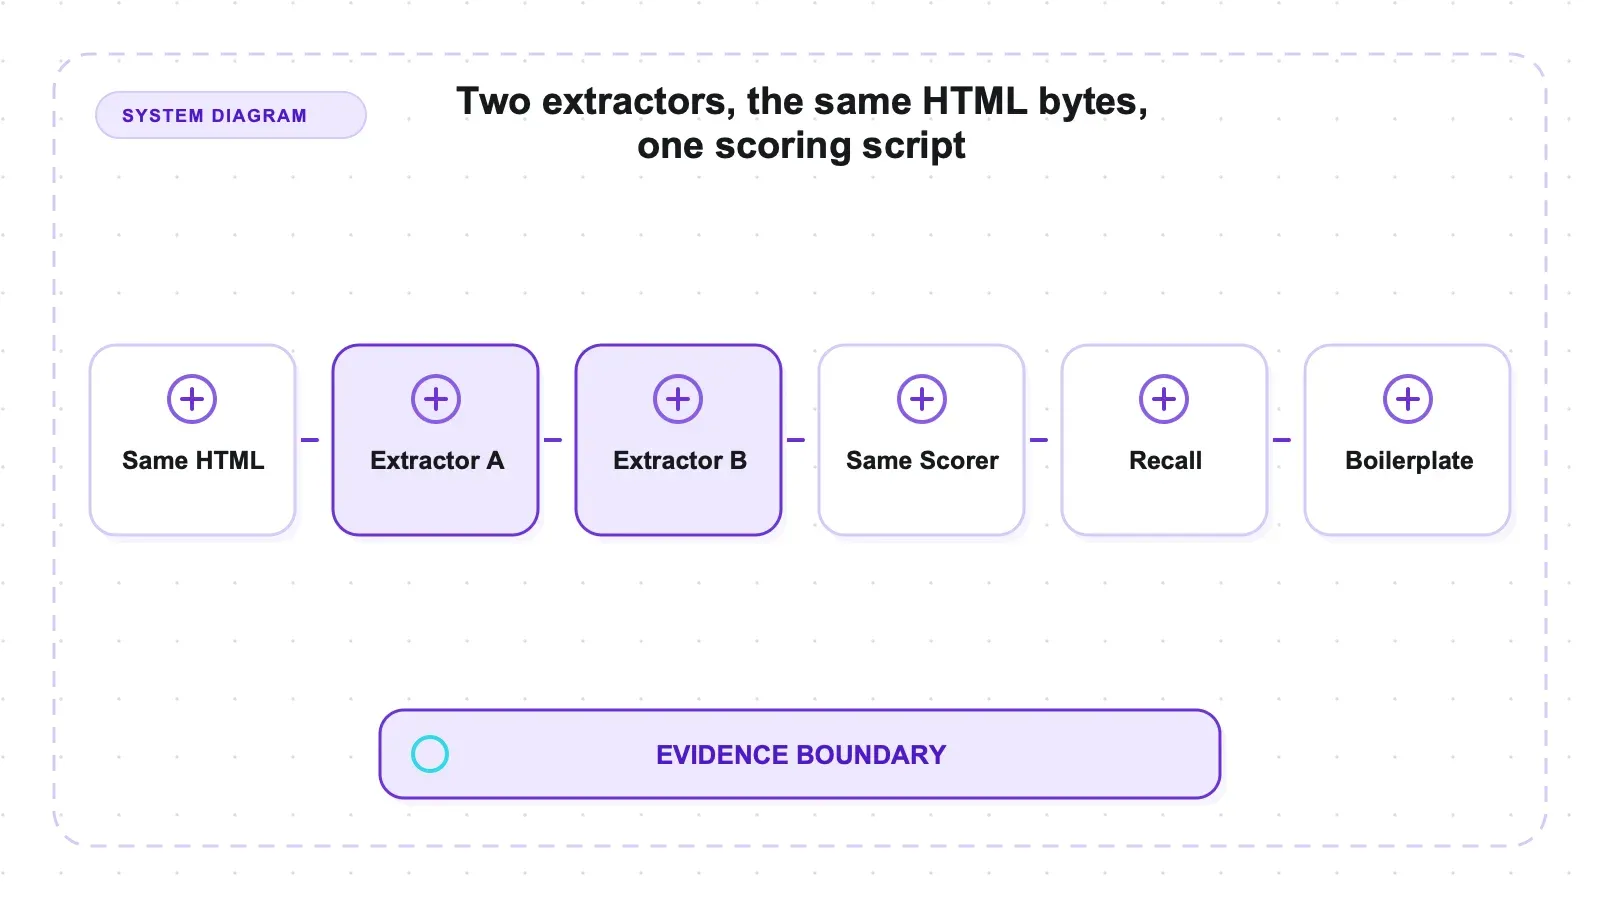
V této výzkumné základně existuje přesně jedno srovnání trafilatury ve stejném testbedu a její vlastní balík ho nevytvořil. Udělal to balík mozilla-readability jako kontrolní větev: 22 ručně označených vzorků, kde je každý textový blok tagován jako ARTICLE nebo BOILERPLATE a každé slovo nese unikátní sentinel token, takže extrahované slovo lze přesně přiřadit zpět k jedinému označenému bloku. Oba nástroje dostaly identické HTML bajty. Readability běžela pod jsdom 29.1.1 na Node v22.22.3; trafilatura používala vlastní parser.
| Metrika (micro-averaged, content-fidelity set) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | Důkaz |
|---|---|---|---|
| Obnovené article units | 40 z 40 | 40 z 40 | comparison.json |
| Uniklé boilerplate units | 1 z 17 | 5 z 17 | comparison.json |
| Boilerplate tokeny kontaminující výstup | 3 | 41 | comparison.json |
| Token precision | 0.939 | 0.902 | comparison.json |
| Token F1 | 0.969 | 0.948 | comparison.json |
Recall neprozaického obsahu, vzorek f6_nonprose | 7 z 8 | 8 z 8 | comparison.json |
Velmi krátký článek, F1 vzorku f3_short_120 | 0.571 | 0.800 | comparison.json |
Zdroj: tools/mozilla-readability/artifacts/raw/comparison.json v této výzkumné základně — 11 vzorků v sadě content-fidelity, 40 article units a 17 boilerplate units. Jde o syntetické vzorky záměrně nakloněné k adversariálním případům, takže je čtěte jako mechanismus, ne jako pořadí na reálném korpusu.
Ani jeden nástroj to nepročistí dokonale a právě ten rozdíl je zajímavý. trafilatura drží stránky čistší — jeden uniklý blok proti pěti u Readability, tři kontaminující tokeny proti 41. To je přesnostní část „čistého článkového textu“ a právě ona rozhoduje, jestli se vám kontextové okno LLM zaplní odkazy z postranního panelu. Ale Readability zachycuje obsah, který trafilatura zahodí: u neprozaického vzorku trafilatura odřízla <figcaption>, které Readability ponechala, a u velmi krátkého článku dosáhla 0.571 proti Readability 0.800. Agresivní čištění je kompromis, ne zadarmo získané vítězství. Pokud je váš korpus plný krátkých textů, popisků a stránek s tabulkami, otočí se ten kompromis proti vám.
Jak z porovnání udělat výběrový test
Začněte tím, že si určíte, která chyba je pro váš pipeline dražší. Pokud okolní prvky stránky spotřebovávají downstream tokeny nebo znečišťují výsledky vyhledávání, zaslouží si větší váhu únik boilerplate jednotek a kontaminující tokeny. Pokud je nepřijatelné ztratit popisek, krátký post nebo neprozaický blok, má větší váhu recall podle tvaru stránky. Společná sada vzorků ten trade-off ukazuje, ale neurčuje váhy pro newsroom archiv, dokumentační korpus ani retrieval pipeline.
Širší kontext zátěžových testů najdete v porovnání paměti a malformovaného HTML u deseti knihoven.
Sestavte srovnání z uloženého HTML, ne z živých URL, aby oba extraktory dostaly identické bajty. Zahrňte běžné dlouhé články, krátké oznámení, texty s množstvím popisků, dokumenty s tabulkami nebo kódem a šablony od každého vydavatele, ze kterého skutečně odebíráte data. Před spuštěním nástroje si označte malý počet povinných obsahových jednotek a známých boilerplate bloků. Pak vyhodnocujte zvlášť prázdný výstup, obnovu povinných jednotek, únik nežádoucích jednotek a metadata. Jedno souhrnné „quality“ skóre může zamaskovat právě ten režim selhání, na kterém záleží.
Také si ověřte výstupní kontrakt v následující části pipeline. JSON trafilatury může nést extrahovaný obsah a metadata, ale JSON serializace není totéž co typované řádkové schéma. U textu článku kontrolujte minimální délku těla a povinné značky, místo abyste přijali jakýkoli neprázdný výstup. U metadat rozlišujte absenci od nesprávné hodnoty a uchovávejte zdrojovou URL i verzi extrakce, aby šlo misses zopakovat.
Stahování testujte jako samostatnou vrstvu. Pozorování 30sekundového lokálního selhání patří k fetch_url, ne k extrakci z HTML, které už máte v ruce, a jeho interní mechanismus nebyl zjištěn. Pokud záleží na deadlinu, retriích, autentizaci nebo proxy politice, použijte klienta, jehož chování ovládáte, zaznamenejte finální response bytes a ty pak předejte extraktoru. Tím oddělíte selhání získání stránky od selhání výběru obsahu a porovnání bude opakovatelné.
Nakonec měřte vlastnosti nasazení na cílové platformě. Instalace pro Python 3.14 s 17 balíčky nepotřebovala samostatný prohlížeč, ale to samo neurčuje propustnost, růst paměti, dostupnost wheelů na všech architekturách ani chování při souběžných workerech. Článek ukazuje užitečný mechanismus přesnost/retence vůči Readability; vhodnost do produkce ale pořád závisí na korpusu a runtime testech.
Pro externí kontrolu, která není výsledkem této sady, trafilatura má vlastní evaluační stránku a veřejný ScrapingHub article-extraction-benchmark ji na word-F1 přes zhruba 181 reálných stránek dávají nad readability-lxml — tedy stejným směrem jako tabulka výše. Jedno upozornění, které většina textů citujících ten benchmark přeskakuje: často citované F1 trafilatury (~0.945) patří ke starší řadě 0.5.1, ne k testované 2.1.0.
Výhody a nevýhody
Výhody:
- Menší únik označeného boilerplate než Readability na společné sadě: 1 blok z 17 oproti 5.
- Na lokálním vzorku správně vytáhla autora a datum a na obou reálných článcích title, date a hostname.
- Stejné HTML lze serializovat jako text, Markdown nebo JSON.
- Instalace s 17 balíčky bez samostatného běhového prostředí prohlížeče.
- Selhání je tiché:
fetch_urlna HTTP 500 vrátíNonemísto výjimky. - Testovaná verze odpovídá aktuální (2.1.0) — žádný drift verze.
- Licence Apache-2.0 — permissivní a vhodná pro komerční použití.
Nevýhody:
- Není to strukturovaný scraper: test katalogu vrátil 12 názvů a 12 cen jako text a 0 typovaných řádků. Žádné schéma, žádná pole.
- Bez renderování JavaScriptu — jen statické HTML; pro klientsky renderované stránky je potřeba samostatný renderer.
authorasitenamebyly na obou reálných MediaWiki stránkáchnull, takže extrakce autora není samozřejmá.- Agresivní čištění má cenu: odstranila
<figcaption>, které Readability ponechala, a na velmi krátkém článku dosáhla 0.571 proti 0.800 u Readability. - To tiché 500 trvalo 30.012 sekundy, než vrátilo
None; pokud záleží na řízení deadlinu, použijte fetcher pod svou kontrolou. - Vestavěný crawler/sitemap spider a formáty CSV/XML nebyly v tomto průchodu testovány, takže o nich netvrdím nic.
Pro koho je a kdo by ji měl přeskočit
trafilatura míří na extrakci hlavního obsahu orientovaného na články. Je to kandidát pro tvorbu textových korpusů, čitelných archivů nebo NLP vstupů ze statického HTML, když je přijatelné heuristické čištění. Porovnání na společných vzorcích podporuje menší únik boilerplate než u Readability, zatímco Readability zachovala víc u krátkých a neprozaických případů.
Přeskočte ji, pokud skutečně potřebujete strukturovanou extrakci — řádky produktů s cenou, typované záznamy, pole key: value — protože vám vrátí text, ne tabulky (test katalogu obnovil všech 12 názvů i všech 12 cen a 0 řádků). Přeskočte ji také, pokud váš cíl renderuje obsah v prohlížeči a nechcete přidat samostatný renderer, protože trafilatura čte jen statické HTML a tam končí. A zvažte to ještě jednou, pokud je váš korpus hlavně z krátkých úryvků, obrazových popisků a tabulkových stránek: na označených vzorcích je to přesně místo, kde její čištění ukusuje z reálného obsahu (0.571 F1 na velmi krátkém článku, vynechaný <figcaption>). Vyberte nástroj podle práce: plný text článků ano; strukturovaný JSON, JS stránky nebo stostránkové stuby hledejte jinde.
Alternativy, včetně toho, kde dává smysl Thunderbit
trafilatura je self-hosted knihovna s licencí Apache-2.0 bez poplatků za jednotlivé volání; náklady na výpočet, bandwidth, fetching, monitoring a údržbu ale zůstávají na provozovateli. Z HTML, které jí předáte, umí dělat článkově orientovanou extrakci, nikoli však spouštět prohlížeč ani vytvářet uživatelem definovaná opakovaná řádková schémata.
Pro stejnou sadu vzorků napříč všemi šesti extraktory viz srovnání šesti knihoven pro extrakci.
Managed služba může získávání, renderování i tvarování schématu schovat za hranici vendoru. My stavíme Thunderbit, ale na těchto vzorcích jsme ho nespustili, takže tento článek nenabízí žádné srovnání kvality, renderování, latence, anti-bot nebo ceny. Rozhodnutí je tedy mezi self-hosted HTML-to-content kontrolou a hostovanou hranicí pro získání a strukturovanou extrakci.
Související benchmark review: úplné srovnání open-source scraperů, review Crawl4AI s prohlížečem a alternativou a self-hosted Markdown review Firecrawl.
Vyzkoušejte Thunderbit pro extrakci webových dat
Verdikt
Zvažte trafilaturu, když je úkolem extrakce článkového obsahu ze statického HTML a prioritou je odfiltrování označeného boilerplate. Na společných vzorcích propustila jeden označený boilerplate blok oproti pěti u Readability. Tato výhoda ale přišla s nižším zachováním obsahu u velmi krátkých a neprozaických vzorků, takže volbu by měl určovat tvar korpusu.
Nevykonává JavaScript ani nevypisuje uživatelem definované opakované řádky. Na dvou stránkách MediaWiki byly author a sitename null, což je pozorování omezené na dané šablony. Readability zachovala popisek, který trafilatura vynechala, a na vzorku označeném f3_short_120 dosáhla vyššího skóre; viditelné důkazy podporují tvrzení „nižší F1 na velmi krátkém vzorku“, ne počet znaků ani tvrzení, že byl výstup zmršený.
Vyzkoušejte Thunderbit pro extrakci webových dat Get Started Free
Nejčastější dotazy
Jakou strukturu trafilatura vrací? Umí serializovat extrahovaný obsah a metadata jako JSON, Markdown, text, HTML, XML nebo CSV. To je strukturovaná serializace, ale ne uživatelem definované opakované řádkové schéma typu název produktu, cena a hodnocení. Vzorek katalogu vrátil hodnoty jako plochý obsah, ne jako typované řádky.
Umí trafilatura vypsat produktový katalog do strukturovaných řádků? Ne. Je to extraktor obsahu, ne strukturovaný scraper. Na vzorku katalogu vrátila všech 12 názvů produktů jako plochý text a 0 strukturovaných řádků — názvy jsou ve výstupu, ale nejsou to pole. Pokud potřebujete typované záznamy jako name/price/rating, použijte parser založený na selektorech nebo API pro extrakci podle schématu.
Umí trafilatura renderovat JavaScript? Ne. Pracuje jen se statickým HTML. Když ji nasměrujete na stránku renderovanou na klientovi, dostanete to, co server poslal před spuštěním JavaScriptu, což často není obsah, který chcete. U JS-heavy cílů ji doplňte samostatným rendererem.
Je trafilatura náročná na instalaci?
V testovaném virtualenvu s Pythonem 3.14 instalace stáhla 17 balíčků a nevyžadovala samostatné běhové prostředí prohlížeče. Největší zaznamenaný wheel byl lxml s 8,6 MB. Samostatně: jedno lokální volání na 500 trvalo 30.012 sekundy, než vrátilo None; pokud potřebujete ověřený deadline, použijte HTTP klienta pod svou kontrolou.
Je trafilatura zdarma pro komerční použití? Je licencovaná pod Apache-2.0, což je permissivní a komerčně přívětivé. Jako vždy si před nasazením ověřte aktuální licenci v repozitáři.




