
Každý průvodce typu „Scrapy vs. Selenium“ na internetu v zásadě tvrdí pořád to samé: Scrapy je rychlejší, Selenium zvládne JavaScript, vyberte si podle toho, co zrovna potřebujete. Směr je většinou správný, ale univerzální řeči o tom, kolik stránek dáte za minutu, už tak přesné nejsou. Propustnost totiž závisí na cílovém webu, síti, souběžnosti, životním cyklu prohlížeče, čekáních i anti-bot ochraně.
Tenhle průvodce porovnává architekturu a provozní kompromisy, které opravdu obstojí napříč různými projekty. Zároveň se věnuje i tomu, co většina srovnání vynechává: jak automatizace prohlížeče mění nároky na zdroje, proč často dává větší smysl selektivní renderování než plný crawl přes prohlížeč, a kdy je spravované API pro extrakci vhodnější než kterýkoli z těchto frameworků.
Rychlý verdikt: Scrapy vs. Selenium v roce 2026
Stručně řečeno: Scrapy vyhrává na rychlosti, škálování a efektivitě zdrojů všude tam, kde stačí serverově renderovaný obsah. Selenium boduje ve chvíli, kdy potřebujete skutečný prohlížeč dělat skutečné prohlížečové věci — klikat, psát, čekat na animující se modální okno. Ani jeden z nich ale dnešní moderní anti-bot obrany z krabice moc nezvládá a Playwright potichu převzal většinu případů použití, kvůli kterým lidé dřív sahali po Selenium.
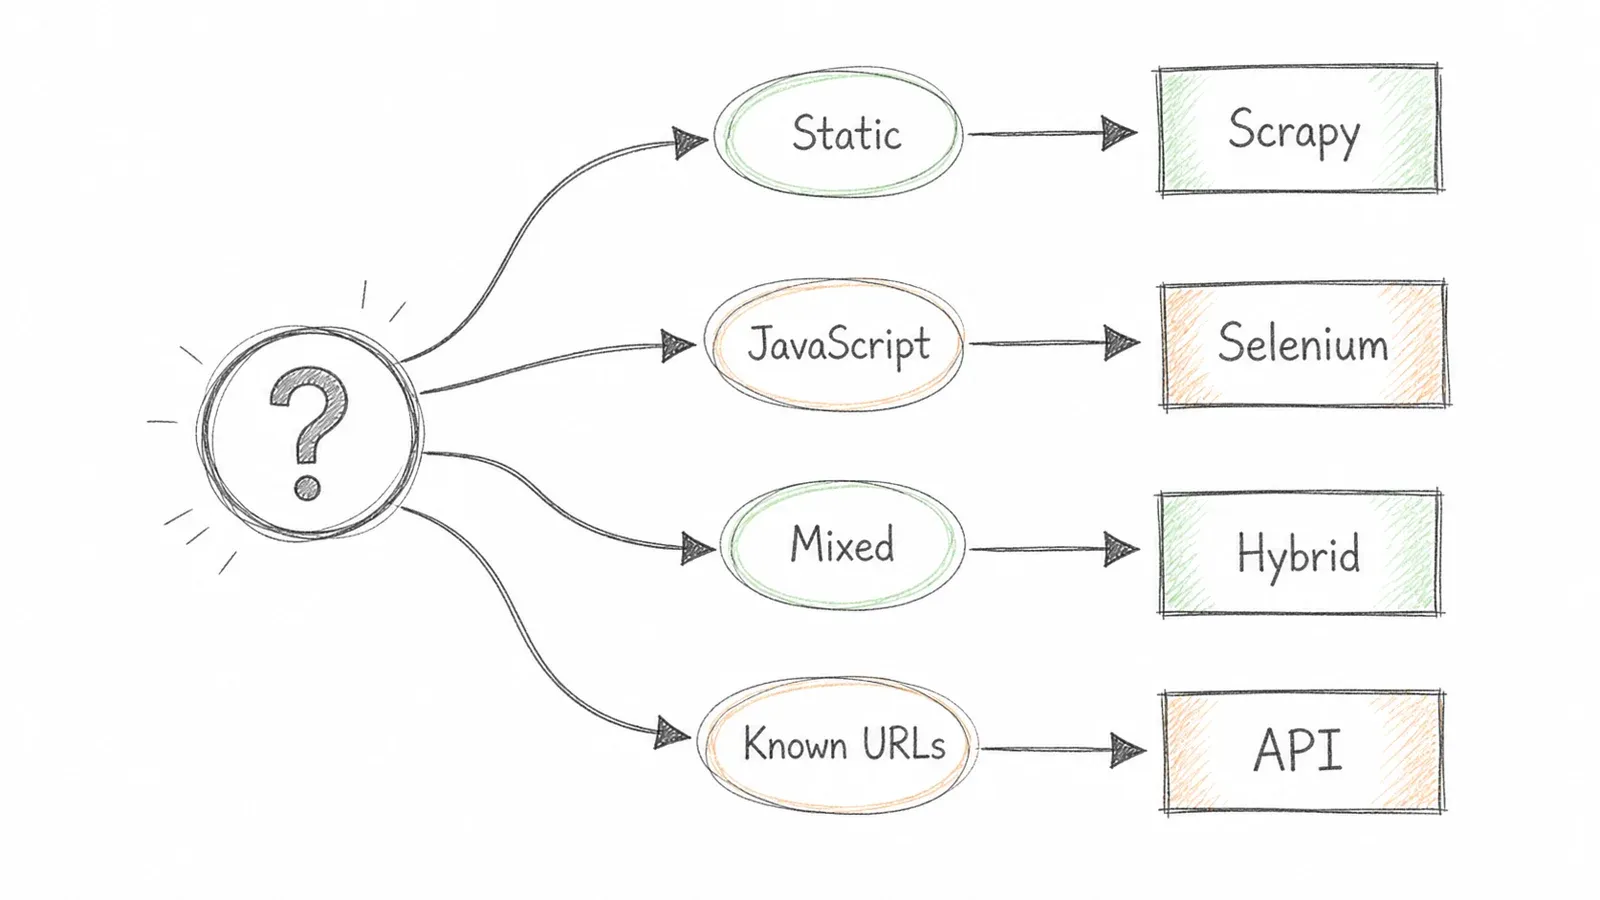
Tady je rozhodovací matice, kterou opravdu používám:
| Vaše situace | Zvolte |
|---|---|
| Statické nebo serverově renderované stránky, vysoký objem | Scrapy |
| SPA s těžkým JavaScriptem, přihlašováním, klikáním a více kroky | Selenium nebo Playwright |
| Smíšený web — převážně statický, ale s několika JS-only sekcemi | Hybrid Scrapy-Playwright |
| Známá URL a potřebujete jen strukturovaná data s minimální údržbou | AI API pro extrakci (Thunderbit a podobné) |
K polovině roku 2026 je k dispozici Scrapy 2.17.0, Selenium 4 dál rozšiřuje podporu WebDriver BiDi a scrapy-playwright nabízí udržované řešení, jak posílat vybrané požadavky ze Scrapy do prohlížeče. Tu rozhodovací matici si klidně nechte po ruce — zbytek článku vysvětluje proč funguje.
Co jsou Scrapy a Selenium (a proč se o nich vývojáři pořád přou)
Porovnání Scrapy se Selenium je trochu jako srovnávat dodávku s autem. Obě věci něco přepraví z bodu A do bodu B, ale jedno bylo postavené na efektivní převoz objemu a druhé pro řízení člověkem, který musí s autem aktivně pracovat. Tahle debata se drží dál, protože oba nástroje můžou scrapovat — jen jsou navržené na úplně jiné úlohy a spousta týmů sáhne po tom špatném dřív, než si to stihne uvědomit.
Scrapy: asynchronní crawlingový engine
Scrapy je framework v Pythonu postavený na event-driven, neblokujícím I/O modelu Twistedu. Není to prohlížeč — nikdy nebyl — jen posílá HTTP požadavky a parsuje HTML, které se vrátí. A to je celé kouzlo. Protože nemusí čekat, až prohlížeč něco vyrenderuje, umí bez blokování vypálit desítky požadavků najednou.
Scrapy má už v základu spiders, item pipelines, feed exportery, retry middleware a rate limiting. Není to framework ve stylu „všechno si musíte postavit sami“ — hodně produkčních věcí už řeší za vás. Architektonická dokumentace Scrapy rozděluje Engine, Scheduler, Downloader a Item Pipeline na samostatné, zaměnitelné komponenty, a právě proto framework tak dobře stárne: můžete přidávat funkce bez přepisování jádra.
Háček? Bez prohlížeče není žádné spouštění JavaScriptu. Pokud se data načítají až přes client-side fetch po renderu stránky, Scrapy je neuvidí. Čte jen počáteční HTML odpověď, nic víc.
Selenium: prohlížeč, který můžete programovat
Selenium ovládá skutečné prohlížeče — Chrome, Firefox, Edge — přes W3C WebDriver protokol, což je standardizovaná specifikace, díky níž Selenium není závislé ani na jednom jazyku, ani na jednom prohlížeči. Umí renderovat JavaScript, spouštět AJAX volání a klikat, scrollovat i psát stejně, jako by to dělal člověk.
Proto je Selenium správná volba pro všechno, co stojí na interakci: vícekroková přihlášení, průvodce, nekonečný scroll, rozbalovací nabídky, které spouštějí API volání. Jenže každá taková browser session je těžká. Samotné doporučení pro dimenzování Selenium Gridu počítá orientačně s asi 1 GB RAM na jednu session už jen pro plánování — a to je ještě před tím, než započtete zátěž CPU při skutečném renderování stránek.
Jedna z věcí, na které lidé narážejí pořád: dokončení načtení stránky neznamená, že je UI připravené. Vlastní dokumentace Selenium navíc varuje před kombinováním implicitních a explicitních čekání, protože časové limity pak začnou být nepředvídatelné. Pokud je váš Selenium skript nestabilní, bývá to často právě tím.
Scrapy vs. Selenium: výkon bez falešných univerzálních čísel
Důvěryhodný benchmark musí zveřejnit cílové stránky, stav cache, síťové podmínky, míru souběžnosti, strategii znovupoužití prohlížeče, podmínky čekání i kompletní kód. Bez toho je údaj o počtu stránek za minutu spíš marketing než důkaz. Architektonické srovnání ale pořád dává smysl:
| Charakteristika workloadu | Scrapy | Selenium | Scrapy-Playwright |
|---|---|---|---|
| HTML renderované na serveru | Přímá HTTP cesta | Plná cesta přes prohlížeč | Použít přímou cestu Scrapy |
| Obsah renderovaný v JavaScriptu | Vyžaduje další renderer | Nativní běh v prohlížeči | Selektivní renderování v prohlížeči |
| Model souběžnosti | Asynchronní scheduler požadavků | Browser sessions řízené vaším kódem nebo Gridem | Scheduler Scrapy + browser contexty |
| Nároky na zdroje | Bez režie renderování prohlížeče | Zátěž CPU a paměti prohlížeče | Náklady prohlížeče jen pro označené požadavky |
| Nejlepší metrika | Položky za minutu při bezpečné chybovosti | Dokončené flow za minutu při bezpečné chybovosti | Oddělená propustnost pro statické a renderované požadavky |
Výchozí nastavení souběžných požadavků ve Scrapy je horní limit, ne zaručená propustnost. Skutečnou rychlost určují latence, omezení na doménu, throttling, retry pokusy, velikost odpovědí, parsovací práce i to, jakou rychlost ještě cílový web toleruje. Selenium umí browser session znovu použít, takže není nutně omezené na jeden nový prohlížeč na jednu stránku, ale každá aktivní session pořád vykresluje a provozuje celé prohlížečové prostředí.
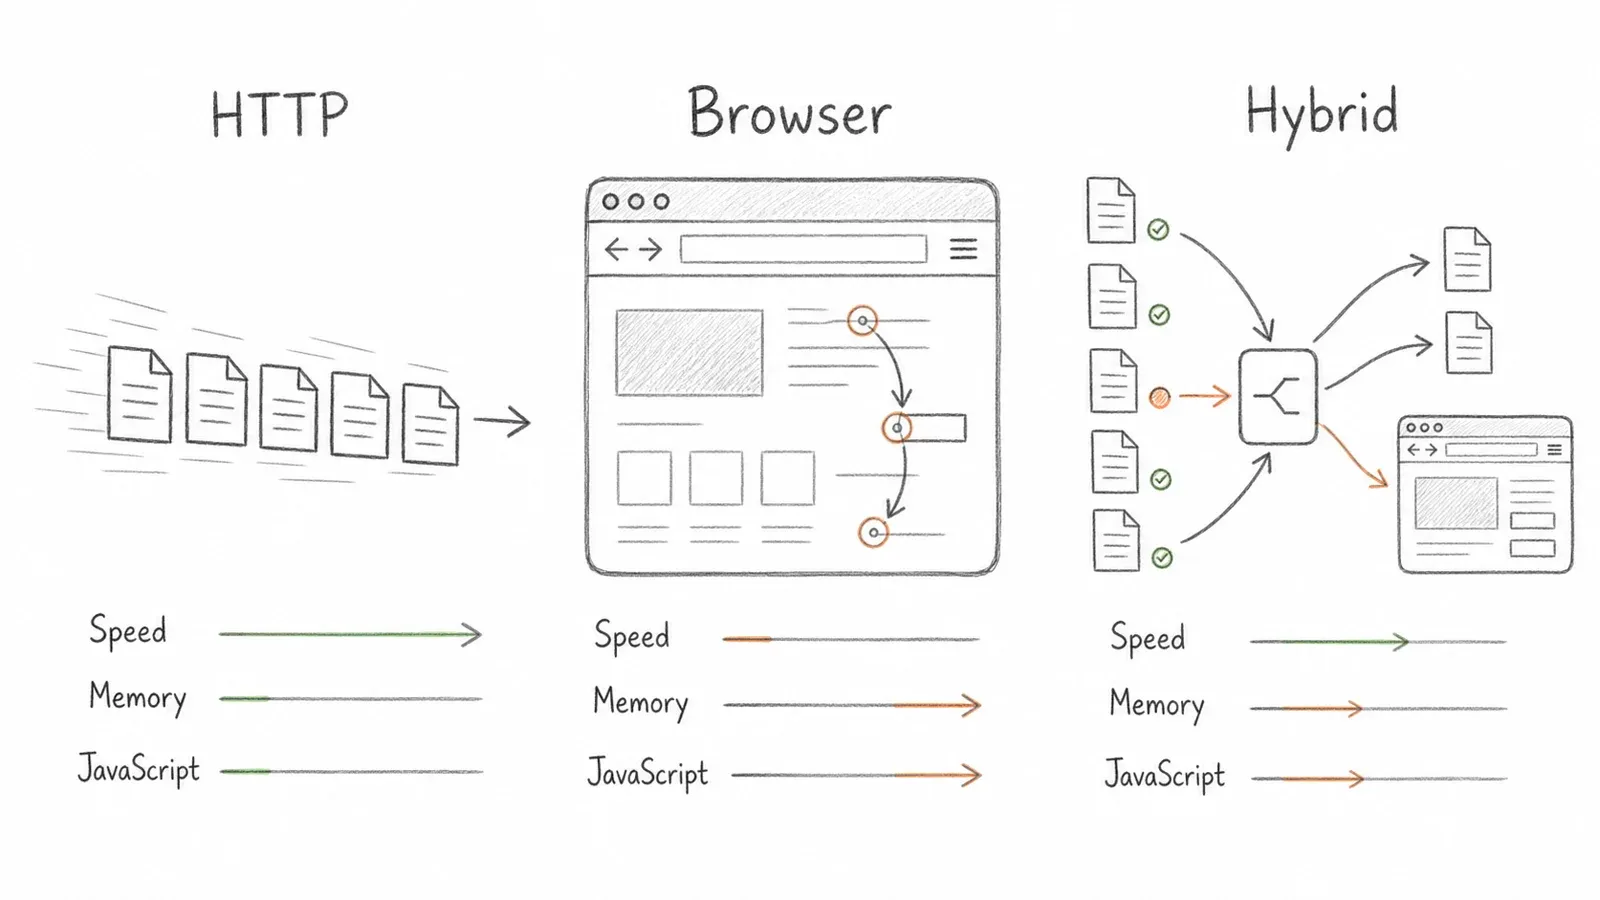
Hybridní model je lákavý, protože běžné požadavky nechá na rychlé HTTP cestě Scrapy a do prohlížeče posílá jen stránky, které render potřebují. To většinou snižuje zátěž prohlížeče, ale samo o sobě to neznamená, že bude rychlejší: měřte zvlášť statické i renderované cesty, započítejte chybovost a retry a nastavujte souběžnost s ohledem jak na bezpečnost vůči cílovému webu, tak na dostupnou paměť.
Zásadní rozdíly, které ovlivní vaše rozhodnutí
Rychlost není jediná proměnná. Jakmile to pustíte do produkce, stejně důležitých začne být několik dalších praktických faktorů.
JavaScript rendering a dynamický obsah
Scrapy samo o sobě nevidí nic, co se vyrenderuje na klientovi. Selenium vidí všechno, protože je to skutečný prohlížeč. Zlatá střední cesta — starší Scrapy-Splash s možností skriptování v Lua a moderní, doporučovaný scrapy-playwright — umožňuje renderovat jen vybrané JS stránky uvnitř crawl smyčky Scrapy, místo abyste kvůli každému požadavku spouštěli celý prohlížeč. Pokud je 80–90 % cílových stránek statické HTML a jen pár z nich potřebuje JavaScript, je selektivní renderování jasná volba. Renderovat všechno přes prohlížeč jen proto, že některé stránky ho potřebují, je zbytečné plýtvání výkonem.
Škálování a souběžnost
Zvětšit Scrapy z 1 000 na 1 000 000 stránek je hlavně otázka kapacity — přidáte více souběžných požadavků, případně to rozdistribuujete přes worker nodes s Redisem. Škálování Selenium znamená lineárně přidávat instance prohlížeče, což lineárně zvyšuje spotřebu RAM a CPU, a rázem spravujete browser farmu se Selenium Gridem a řešíte obnovu po pádu. Nejde o to, že by Selenium škálovat neumělo — jde o to, že škálování z něj dělá infrastrukturní projekt, ne jen změnu konfigurace.
Datové pipeline a export
Item pipeline ve Scrapy řeší validaci, deduplikaci a export do JSON, CSV nebo databáze jako vestavěnou funkci. Selenium vám z toho nedá nic — serializaci i ukládání si píšete sami od nuly. Pokud vám záleží na kvalitě dat a napojení na další systémy, je to pro Scrapy velmi užitečný náskok zdarma.
Údržba a dlouhodobá spolehlivost
Jeden vzorec se mi potvrzuje pořád: Scrapy spiders obvykle stárnou docela dobře, protože middleware architektura vnucuje určitou strukturu. Selenium skripty bývají křehčí — aktualizace prohlížeče rozbíjejí drivery, timing problémy dělají flaky běhy a každá změna DOM znamená úpravu selektorů. Na fórech jsem už viděl vývojáře, kteří naprosto otevřeně říkali, že Selenium-based scraper „asi není nejlepší volba pro něco, co budeme klientovi prodávat“, a upřímně: ten instinkt je správný, pokud má projekt vydržet déle než pár měsíců bez zásahu.
Realita anti-bot ochrany: jak si jednotlivé nástroje vedou proti obranám v roce 2026
Tohle je ta část, kterou ostatní srovnání často přecházejí, ale ve skutečnosti rozhoduje o tom, jestli váš scraper vůbec poběží. Ani Scrapy, ani Selenium nebyly navržené s moderní anti-bot infrastrukturou v hlavě, a předstírat opak jen připravuje půdu pro nepříjemné překvapení v produkci.
| Vrstva obrany | Scrapy | Selenium | Scrapy-Playwright | Thunderbit API |
|---|---|---|---|---|
| Renderování JS | ❌ Potřebuje middleware | ✅ | ✅ | ✅ Vestavěno |
| TLS fingerprint | ⚠️ Detekovatelné | ⚠️ Detekovatelné | ⚠️ Lepší, ale ne vyřešené | ✅ Řešeno |
| CAPTCHA | ❌ Ručně | ❌ Ručně | ❌ Ručně | ✅ Vestavěno |
| Rotace rate limitů | ⚠️ Vlastní proxy | ⚠️ Vlastní proxy | ⚠️ Vlastní proxy | ✅ Spravováno |
Scrapy neprojde kontrolou browser fingerprintu, protože žádný browser vlastně nepoužívá — je to jen HTTP klient a řada anti-bot vendorů označí provoz, který nevypadá jako skutečný prohlížeč. Selenium projde základními JS kontrolami, protože skutečný prohlížeč je, ale je detekovatelné přes signály jako navigator.webdriver, což je standardizovaný příznak, který je při automatizaci nastavený na true. Patche jako undetected-chromedriver se to snaží maskovat, ale je to jen hra na kočku a myš proti vendorům, kteří své detekční signatury pravidelně aktualizují.
Stealth závody ve zbrojení (a proč je DIY křehké)
Nepříjemná pravda o anti-detection patchích je, že nejsou řešení, ale běhací pás na údržbu. undetected-chromedriver a playwright-stealth fungují do chvíle, než Cloudflare Turnstile nebo DataDome vydá aktualizaci, která odhalí použitou techniku. Pak musíte patchovat znovu. Viděl jsem týmy, které strávily víc inženýrského času udržováním stealth vrstvy při životě než samotnou stavbou scraperu.
Samostatně si zaslouží zmínku i rate limiting. Když server vrátí 429 Too Many Requests, hlavička Retry-After je doporučení, ne rozkaz — spousta webů ji neposílá vůbec a jiné vás zpomalují úplně jinými signály. AutoThrottle ve Scrapy pomáhá tím, že upravuje zpoždění podle pozorované latence, ale reaguje až na situaci, nepreventuje ji.
Právě tady se spravované API pro extrakci vyplácí — anti-bot řešení je pak problém někoho jiného, ne váš. K tomu se ještě vrátím.
Faktor Playwright: proč už „Scrapy vs. Selenium“ není celý příběh
Představit to jako souboj dvou nástrojů míjí to, co se ve scrapingové komunitě v posledních pár letech opravdu stalo. Fóra jsou plná lidí, kteří říkají něco ve smyslu „přešel jsem ze Selenium na Playwright a jsem dost spokojený“ — a přitom většina srovnávacích článků Playwright zmíní jen letmo, pokud vůbec.
Playwright od Microsoftu ovládá Chromium, Firefox i WebKit přes jedno API. Jeho model actionability čeká, až jsou elementy viditelné, stabilní a skutečně interaktivní, než provede akci — což výrazně snižuje problémy s timingem, které trápí řadu Selenium skriptů. Efektivněji také pracuje s browser contexts, takže můžete vytvářet izolované sessions bez toho, abyste pokaždé spouštěli celý nový browser.
Kdy Playwright Selenium nahradí úplně
Pro samotné scrapování — ne pro testování prohlížečů s existující Selenium infrastrukturou — je Playwright v roce 2026 často prostě lepší volba. Rychlejší vytváření contextů, nižší nároky na zdroje na stránku, nativní async podpora a vestavěná network interception. Pokud začínáte nový scrapingový projekt a nemáte co zachovávat z existující Selenium testovací sady, není moc důvodů sahat nejdřív po Selenium.
Výjimka: pokud váš tým už má Selenium testovací infrastrukturu, nebo potřebujete velmi specifické nastavení browser profilu, které Playwright nepodporuje tak čistě, Selenium si svou roli pořád obhájí.
Jak funguje scrapy-playwright
scrapy-playwright je download handler pro Scrapy, který posílá jen požadavky označené meta={"playwright": True} přes skutečný prohlížeč — všechno ostatní zůstává na rychlé, asynchronní HTTP cestě Scrapy. Tady je zjednodušený spider, který prochází stránkovaný katalog, kde se produktové karty renderují přes client-side JS:
import scrapy

class CatalogSpider(scrapy.Spider):
    name = "catalog"

    def start_requests(self):
        yield scrapy.Request(
            "https://example.com/products?page=1",
            meta={"playwright": True, "playwright_include_page": True},
        )

    async def parse(self, response):
        page = response.meta["playwright_page"]
        products = response.css("div.product-card")
        for product in products:
            yield {
                "title": product.css("h3::text").get(),
                "price": product.css(".price::text").get(),
            }

        next_page = response.css("a.next::attr(href)").get()
        if next_page:
            yield scrapy.Request(
                response.urljoin(next_page),
                meta={"playwright": True, "playwright_include_page": True},
            )
        await page.close()
Do prohlížeče jdou jen stránky, které opravdu potřebují renderování. To je přesně smysl hybridního přístupu — neplatíte browser daň za každý jednotlivý request, jen za ty, které ji skutečně vyžadují.
Scrapy-Splash vs. Scrapy-Playwright: jaké middleware použít
Scrapy-Splash vyžaduje samostatnou Splash Docker službu a psaní Lua skriptů pro interakce — funguje, ale je to těžší a starší řešení. scrapy-playwright se integruje přímo do asynchronní smyčky Scrapy, podporuje všechny tři hlavní browser engine a zvládá složité interakce bez toho, aby bylo potřeba přidávat další skriptovací jazyk. Pokud v roce 2026 startujete nový projekt, není moc důvodů se k Splash vracet.
Hybridní architektura připravená na produkci
Většina článků řekne „můžete Scrapy a Selenium zkombinovat“ a skončí. To není architektura. To je poznámka. Takhle vypadá skutečné produkční nasazení.
Tok je následující: Scrapy scheduler posílá požadavky přes URL router, který rozhoduje, zda je stránka statická nebo dynamická. Statické requesty jdou rovnou přes standardní Scrapy downloader. Dynamické requesty se označí a pošlou do Playwright middleware, který spravuje pool browser contextů. Obě cesty se pak setkají ve stejné item pipeline pro validaci, deduplikaci a export — ať už data přišla z čistého HTML, nebo vyrenderovaného DOMu, skončí ve stejném JSON, CSV nebo databázovém výstupu.
Pár poznámek k nasazení, pokud to chcete dostat do produkce: zabalte to do Dockeru, aby se Playwright browser binárky chovaly konzistentně napříč prostředími, omezte počet souběžných Playwright contextů podle dostupné RAM (na běžném stroji s 4 GB bych nešel nad 8–10 contextů) a plánované úlohy spusťte přes cron nebo CI/CD pipeline, místo aby proces běžel donekonečna.
Tahleta sestava vám dává maximální kontrolu. Zároveň ale znamená, že odpovídáte za aktualizace browser binárek, chyby v lifecycle contextů (neuzavřené stránky umí crawl zastavit), rotaci proxy a veškeré anti-bot patche, které budete muset přidat. To je reálný inženýrský závazek a je fér si to přiznat dřív, než do toho půjdete.
Pro týmy, které chtějí strukturovaný výstup bez správy vlastní infrastruktury, zkouší Thunderbit CLI ten samý problém jinak:
thunderbit batch extract --schema schema.json --file urls.txt
Stejný strukturovaný JSON výstup. Žádný spider kód, žádný pool prohlížečů, žádná anti-bot infrastruktura na údržbu. Vyměníte část možnosti přizpůsobení za rychlost nasazení — a to je legitimní kompromis, ne univerzální upgrade. Záleží čistě na tom, kolik kontroly váš projekt skutečně potřebuje.
Cesta „vynechte framework“: kdy AI API na scraping porazí oba přístupy
V určité chvíli si vývojář uvědomí, že vlastně nepotřebuje crawlingový framework. Potřebuje strukturovaná data z 500 známých URL a stavba spideru, poolu prohlížečů a anti-bot vrstvy kvůli tomu působí přestřeleně — protože většinou opravdu je.
Právě tuhle mezeru má vyplnit Thunderbit. Hned na úvod ale řeknu: není to náhrada za Scrapy při složitých, rekurzivních crawlích s vlastní logikou. Je to jiný nástroj pro jiný, užší problém.
Open API: POST /extract přijímá JSON Schema a vrací strukturovaná data odpovídající tomu schématu — ne syrové HTML, ne hromadu Markdownu, kterou si musíte sami parsovat. POST /distill dělá opačnou práci a vrací čistý Markdown připravený pro RAG pipeline nebo LLM. Spravovaná služba podporuje renderování JavaScriptu i anti-bot handling, takže tu infrastrukturu nemusíte řešit sami. Aktuální průvodce Distill vs. Extract uvádí 1 kredit na Distill stránku a 20 kreditů na Extract stránku; před plánováním si vždy zkontrolujte živou dokumentaci, protože podmínky se mohou měnit.
MCP Server: pro AI agenty jako Claude nebo Cursor zpřístupňuje Thunderbit MCP server distillaci, strukturovanou extrakci, návrhy polí i dávkové úlohy jako nástroje, takže agent si může během práce načíst čerstvá webová data, aniž by opustil své prostředí.
CLI: zdokumentované Thunderbit CLI podporuje příkazy jako thunderbit extract <url> --schema schema.json a dobře zapadá do terminálových workflow i plánovaných úloh. Můžete také poslat distillovaný Markdown do jiného nástroje pro rychlý jednorázový průzkum.
Pokud chcete vynechat i kód, Thunderbit Chrome Extension pokrývá stejný prostor přes klikací rozhraní, což stojí za pozornost hlavně tehdy, když váš tým zahrnuje i neprogramátory, kteří potřebují data bez práce v terminálu. O širším kontextu jsem psal také v článcích o AI web scrapingu a scrapingu bez programování, pokud chcete celý obrázek.
Buďte k sobě upřímní, do které skupiny patříte: Scrapy je pořád správná volba pro složité crawly přes více webů s vlastní logikou a rekurzivním následováním odkazů. Selenium nebo Playwright zase pro interakčně náročné flow. Ale „potřebuju strukturovaná data z těchto známých URL“ je užší problém, než pro který byly oba nástroje původně navržené, a API může opravdu odstranit potřebu spider kódu, anti-bot vrstvy i průběžné údržby, která s vlastnictvím takové infrastruktury přichází.
Scrapy vs. Selenium vs. Playwright vs. AI API: přehled vedle sebe
| Funkce | Scrapy | Selenium | Scrapy-Playwright | Thunderbit API |
|---|---|---|---|---|
| Podpora jazyků | Jen Python | Python, Java, C#, JS, Ruby | Python | REST (libovolný jazyk) |
| Renderování JS | Ne (potřebuje middleware) | Ano | Ano | Ano, vestavěné |
| Async/souběžnost | Nativní, vysoká | Omezená na instanci | Nativní přes Scrapy | Spravováno na serveru |
| Anti-bot handling | DIY | DIY | Částečně | Vestavěno |
| Datová pipeline/export | Vestavěno | DIY | Vestavěno | Strukturovaný JSON výstup |
| Složitost nastavení | Střední | Nízká na začátku, vysoká ve velkém | Střední až vysoká | Minimální |
| Náročnost údržby | Nízká až střední | Vysoká | Střední | Téměř nulová |
| Nejlepší pro | Vysokoobjemové statické crawlly | Flow s vysokou interakcí | Smíšené statické/dynamické weby | Známé URL, strukturovaný výstup |
Pokud zvažujete i jiné možnosti mimo tyto čtyři nástroje, stojí za to podívat se i na to, jak si vedou alternativy k Instant Data Scraper a nejlepší AI web scrapery — tenhle prostor už je hodně nabitý a ne každý nástroj řeší stejný problém.
Právní a etické poznámky k web scrapingu v roce 2026
Budu stručný, protože to není hlavní téma článku, ale je to důležité. Nastavení ROBOTSTXT_OBEY ve Scrapy donutí spider respektovat pravidla robots.txt — je to dobrá praxe, ale stojí za to vědět, že samotný Robots Exclusion Protocol výslovně říká, že jeho pravidla nejsou právním oprávněním k přístupu. Selenium ani Playwright nemají žádnou vestavěnou podporu robots.txt vůbec — to je čistě na vás. Bez ohledu na nástroj si před scrapováním a opětovným použitím dat zkontrolujte podmínky použití webu a platné zákony ve vaší jurisdikci; „je to veřejně viditelné“ není automaticky právní souhlas všude.
Jak vybrat správný nástroj pro váš scrapingový projekt v roce 2026
Rozhodnutí se v zásadě točí kolem čtyř otázek: jaký typ obsahu máte, v jakém měřítku pracujete, kolik interakcí potřebujete a kolik průběžné údržby jste ochotni si vzít na sebe. Statické stránky ve skutečném objemu? Scrapy. JavaScriptem nabité stránky se skutečnou interakcí? Selenium nebo Playwright. Směs obojího? Postavte hybrid. Známé URL, kde chcete jen strukturovaná data s minimální údržbou? API jako to od Thunderbit vám pravděpodobně ušetří víc času, než kolik stojí.
„Scrapy vs. Selenium“ nikdy nebyla celá otázka — jen to byl dřív jediný dostupný rámec. Playwright změnil prostřední cestu a AI API pro extrakci vytvořila úplně novou stopu pro lidi, kteří zjistili, že ve skutečnosti staví infrastrukturu místo řešení business problému. Vyplatí se vyzkoušet bezplatnou verzi, než se zavážete k jedné z cest — suggest-fields je zdarma a distill spotřebuje jen jeden kredit, takže si můžete ověřit, jestli API cesta dává smysl, ještě než napíšete jediný řádek spider kódu.
Časté dotazy
Je Scrapy rychlejší než Selenium pro web scraping? Podle mých testů ano — často i o řád na statických stránkách, protože asynchronní architektura Scrapy úplně obchází režii prohlížeče. Ten rozdíl se zmenšuje, když Scrapy používá Playwright middleware pro JS-heavy stránky, ale Scrapy si pořád drží výhodu v celkové propustnosti u smíšených workloadů, protože ne-JS stránky zůstávají na rychlé cestě.
Umí Scrapy pracovat se stránkami renderovanými v JavaScriptu?
Ne samo o sobě — Scrapy vidí jen počáteční HTML odpověď. Přidáním scrapy-playwright nebo staršího Scrapy-Splash jako middleware můžete vybrané požadavky renderovat přes skutečný prohlížeč, zatímco zbytek crawlu poběží na nativní, rychlejší cestě Scrapy.
Kdy mám použít Selenium místo Scrapy? Když potřebujete plnou interakci s prohlížečem — vícekroková přihlášení, proklikávání průvodců, vyplňování formulářů — a počet stránek je spíš střední než masivní. Je to také rozumná volba, pokud už máte Selenium testovací infrastrukturu, kterou chcete pro scraping znovu využít.
Je Playwright v roce 2026 lepší než Selenium pro scraping? Pro samotný scraping obecně ano — Playwright obvykle nabízí lepší výkon, vestavěné auto-wait a nižší nároky na zdroje na jeden browser context. Selenium ale pořád dává smysl týmům, které provozují zavedené cross-browser testovací sady, jež Playwright nebyl navržený nahradit.
Co je AI scraping API a kdy nahrazuje Scrapy nebo Selenium? AI scraping API, jako je Open API od Thunderbit, zvládá renderování JS, anti-bot obranu i extrakci dat na serveru a vrací strukturovaný JSON odpovídající vámi definovanému schématu. Je to správná volba, když máte známé URL a potřebujete strukturovaný výstup bez budování nebo údržby crawl infrastruktury — není to náhrada za Scrapy u složitých, rekurzivních crawlů s vlastní logikou.
Zjistit více




