
Pokud jste se někdy snažili sestavit cílený seznam prodeje, prozkoumat nové trhy nebo porovnat konkurenci, víte, že Google Maps jsou skutečný zlatý důl. A tady je háček: s více než 1,5 miliardy vyhledávání „v okolí“ každý měsíc a tím, že 76 % místních uživatelů vyrazí do firmy do 24 hodin (thinkwithgoogle.com), nebyla poptávka po aktuálních firemních datech založených na lokaci nikdy vyšší.
Ať už pracujete v prodeji, marketingu nebo provozu, získávání strukturovaných dat z Google Maps může být rozdíl mezi studeným obvoláváním a vřelým leadem s vysokou mírou konverze.
Věnuji se SaaS a automatizaci už roky a na vlastní oči jsem viděl, jak týmy používají Python (a dnes i nástroje s AI, jako je Thunderbit) k tomu, aby z Google Maps udělaly strategický asset.
V tomhle průvodci vám krok za krokem ukážu, jak v roce 2026 získávat data z Google Maps pomocí Pythonu — včetně kódu, tipů ke compliance a srovnání s řešeními bez kódu. Ať už jste Python profík, nebo jen hledáte nejrychlejší cestu k použitelným datům, jste na správném místě.
Co znamená získávat data z Google Maps pomocí Pythonu?
Začněme od základu: získávání dat z Google Maps pomocí Pythonu znamená programově extrahovat firemní informace — například názvy, adresy, hodnocení, recenze, telefonní čísla a souřadnice — z Google Maps, abyste je mohli analyzovat, filtrovat a exportovat pro firemní využití.
Existují dva hlavní způsoby, jak to dělat:
- Google Maps Places API: Oficiální a licencovaná cesta. Pomocí API klíče posíláte dotazy na servery Googlu a dostáváte zpět strukturovaná JSON data. Je to stabilní, předvídatelné a (z větší části) v souladu s pravidly, ale přichází to s limity a náklady.
- Web scraping HTML: Automatizujete prohlížeč (pomocí nástrojů jako Playwright nebo Selenium), načítáte Google Maps, provádíte vyhledávání a parsujete vykreslenou stránku. Je to flexibilnější, ale křehké — Google často mění strukturu webu a scraping HTML může porušovat podmínky Googlu.
Typická data, která můžete získat:
- název firmy
- kategorie/typ
- úplná adresa (včetně města, státu, PSČ a země)
- zeměpisná šířka a délka
- telefonní číslo
- URL webu
- hodnocení a počet recenzí
- cenová úroveň
- stav firmy (otevřeno/zavřeno)
- otevírací doba
- Place ID (jedinečný identifikátor Googlu)
- URL Google Maps
Proč je to důležité? Protože tahle data pohánějí všechno od lead generation a plánování území přes benchmark konkurence až po průzkum trhu. Klíčem je cílit na správná data podle vašich obchodních cílů — nescrapujte naslepo.
Proč týmy prodeje a marketingu získávají data z Google Maps pomocí Pythonu
Pojďme prakticky. Proč jsou v roce 2026 data z Google Maps takovým tématem pro tolik obchodních a marketingových týmů?
- Lead generation: Sestavte vysoce cílené seznamy místních firem včetně kontaktních údajů a hodnocení pro outreach kampaně.
- Plánování teritorií: Zmapujte obchodní teritoria, rozvozové zóny nebo servisní oblasti podle skutečné hustoty firem a jejich typů.
- Monitoring konkurence: Sledujte konkurenty v čase — jejich lokace, hodnocení a recenze — a odhalte trendy i příležitosti.
- Průzkum trhu: Analyzujte kategorie firem, otevírací dobu a sentiment v recenzích a využijte to při go-to-market strategii.
- Výběr lokality: V real estate a retailu vyhodnoťte možné lokace podle okolní občanské vybavenosti, návštěvnosti a konkurence.
Reálný dopad: Podle HubSpot 2025 State of Sales plánuje 92 % obchodních organizací navýšit investice do AI/dat, a týmy pracující s cílenými lokálními daty dosahují až 8× vyšší konverze než ty, které spoléhají na obecné studené seznamy (martal.ca). Jedna studie o lead generation pro franšízy ukázala 15 dolarů nových tržeb za každý 1 dolar utracený za seznamy leadů založené na Google Maps.
Přehled propojení obchodních cílů a polí Google Maps:
| Obchodní cíl | Potřebná pole z Google Maps |
|---|---|
| Seznam místních leadů | název, adresa, telefon, web, kategorie |
| Plánování teritoria | název, lat/lng, business_status, opening_hours |
| Porovnání s konkurencí | název, hodnocení, userRatingCount, priceLevel, reviews |
| Výběr lokality | kategorie, lat/lng, hustota recenzí, openingDate |
| Sentiment / přehled o nabídce | reviews, editorialSummary, photos, types |
| Oslovení přes email / telefon | nationalPhoneNumber, websiteUri (pak případně doplnit další data) |
Nastavení Python scraperu pro Google Maps: nástroje a požadavky
Než začnete scrapovat, budete si muset připravit Python prostředí a správné nástroje. Tohle je to, co v roce 2026 potřebujete:
1. Nainstalujte Python a potřebné knihovny
Doporučená verze Pythonu: 3.10 nebo novější.
Nainstalujte klíčové knihovny:
pip install \
  requests==2.33.1 httpx==0.28.1 \
  beautifulsoup4==4.14.3 lxml==6.0.3 \
  pandas==2.3.3 \
  selenium==4.43.0 playwright==1.58.0 \
  googlemaps==4.10.0 google-maps-places==0.8.0 \
  schedule==1.2.2 APScheduler==3.11.2 \
  python-dotenv==1.2.2 tenacity==9.1.4
playwright install chromium
K čemu slouží:
requests,httpx: HTTP požadavky (API volání)beautifulsoup4,lxml: Parsování HTML (pro web scraping)pandas: Čištění dat, analýza, exportselenium,playwright: Automatizace prohlížeče (pro HTML scraping)googlemaps,google-maps-places: Klientské knihovny pro Google Maps APIschedule,APScheduler: Plánování úlohpython-dotenv: Bezpečné načítání API klíčů z.envsouborůtenacity: Logika opakování pro ošetření chyb
2. Získejte API klíč pro Google Maps (pro scraping přes API)
- Přejděte do Google Cloud Console.
- Vytvořte nebo vyberte projekt.
- Zapněte fakturaci (je vyžadována i pro bezplatnou úroveň).
- V sekci APIs & Services > Library zapněte „Places API (New)“.
- Přejděte do Credentials > Create Credentials > API Key.
- Pro jistotu omezte klíč na konkrétní API a IP adresy.
- Uložte API klíč do souboru
.env(nikdy ho necommitujte do kódu):
GOOGLE_MAPS_API_KEY=your_actual_api_key_here
Poznámka: Od března 2025 Google už nenabízí univerzální měsíční kredit 200 dolarů. Místo toho jsou pro jednotlivé API vrstvy k dispozici bezplatné měsíční limity (viz oficiální ceník).
Jak získávat data z Google Maps pomocí Pythonu: průvodce krok za krokem
Rozeberme si oba hlavní přístupy — přes API a HTML scraping — abyste si mohli vybrat ten, který vám sedí.
Přístup 1: Použití Google Maps Places API (doporučeno)
Krok 1: Nainstalujte a importujte potřebné knihovny
import os
import httpx
import pandas as pd
from dotenv import load_dotenv
Krok 2: Bezpečně načtěte API klíč
load_dotenv()
API_KEY = os.environ["GOOGLE_MAPS_API_KEY"]
Krok 3: Sestavte vyhledávací dotaz
K nalezení firem odpovídajících vašim kritériím použijete endpoint Text Search.
URL = "https://places.googleapis.com/v1/places:searchText"
FIELD_MASK = ",".join([
    "places.id", "places.displayName", "places.formattedAddress",
    "places.location", "places.rating", "places.userRatingCount",
    "places.priceLevel", "places.types",
    "places.nationalPhoneNumber", "places.websiteUri",
    "nextPageToken",
])
Krok 4: Odeslání API požadavku
def text_search(query, lat, lng, radius=3000, min_rating=4.0):
    body = {
        "textQuery": query,
        "minRating": min_rating,  # server-side filtr
        "includedType": "restaurant",
        "openNow": False,
        "pageSize": 20,
        "locationBias": {
            "circle": {
                "center": {"latitude": lat, "longitude": lng},
                "radius": radius,
            }
        },
    }
    headers = {
        "Content-Type": "application/json",
        "X-Goog-Api-Key": API_KEY,
        "X-Goog-FieldMask": FIELD_MASK,  # Vždy nastavte!
    }
    r = httpx.post(URL, json=body, headers=headers, timeout=30)
    r.raise_for_status()
    return r.json()
Krok 5: Zpracujte stránkování a sesbírejte výsledky
def collect_all_results(query, lat, lng, radius=3000, min_rating=4.0):
    results = []
    next_page_token = None
    while True:
        data = text_search(query, lat, lng, radius, min_rating)
        places = data.get('places', [])
        results.extend(places)
        next_page_token = data.get('nextPageToken')
        if not next_page_token:
            break
    return results
Krok 6: Export dat pomocí Pandas
df = pd.DataFrame(collect_all_results("coffee shops in Brooklyn", 40.6782, -73.9442))
df.to_csv("brooklyn_coffee_shops.csv", index=False)
Praktické tipy:
- Vždy nastavte hlavičku
X-Goog-FieldMask, abyste měli pod kontrolou náklady. Pokud si vyžádáte recenze nebo fotografie, cena za 1 000 požadavků může vzrůst z 5 na 25 dolarů (podrobnosti o cenách). - Používejte serverové filtry (například
minRating,includedType,locationBias), abyste neplýtvali kredity na irelevantní výsledky. - Hodnoty
place_idukládejte do mezipaměti pro deduplikaci a budoucí aktualizace.
Přístup 2: Web scraping HTML z Google Maps (pro jednorázové nebo vzdělávací použití)
Varování: Google Maps je single-page aplikace. Musíte použít automatizaci prohlížeče (Playwright nebo Selenium) a scraping HTML může porušovat podmínky Googlu. Používejte to pro výzkum, ne pro produkci.
Krok 1: Nainstalujte Playwright a spusťte prohlížeč
from playwright.sync_api import sync_playwright
import time, re

def scrape_maps(query, max_results=100):
    with sync_playwright() as pw:
        browser = pw.chromium.launch(headless=True)
        ctx = browser.new_context(
            user_agent="Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
            locale="en-US",
        )
        page = ctx.new_page()
        page.goto("https://www.google.com/maps", timeout=60_000)
        page.fill("#searchboxinput", query)
        page.click('button[aria-label="Search"]')
        page.wait_for_selector('div[role="feed"]')
        feed = page.locator('div[role="feed"]')
        prev = 0
        while True:
            feed.evaluate("el => el.scrollBy(0, el.scrollHeight)")
            time.sleep(2)
            count = page.locator('div[role="feed"] > div > div[jsaction]').count()
            if count == prev or count >= max_results:
                break
            prev = count
            if page.locator("text=You've reached the end of the list").count():
                break
        rows = []
        cards = page.locator('div[role="feed"] > div > div[jsaction]')
        for i in range(cards.count()):
            c = cards.nth(i)
            name = c.locator("div.fontHeadlineSmall").inner_text() if c.locator("div.fontHeadlineSmall").count() else ""
            rating_el = c.locator('span[role="img"]').first
            raw = rating_el.get_attribute("aria-label") if rating_el.count() else ""
            m = re.search(r"([\d.]+)\s+stars?\s+([\d,]+)\s+Reviews", raw or "")
            rating  = float(m.group(1)) if m else None
            reviews = int(m.group(2).replace(",", "")) if m else None
            rows.append({"name": name, "rating": rating, "reviews": reviews})
        browser.close()
        return rows
Tipy:
- Google náhodně mění CSS třídy každých pár týdnů, takže tenhle kód může vyžadovat pravidelné úpravy.
- Používejte lidsky působící prodlevy a nescrapujte příliš rychle, abyste snížili riziko zablokování.
- Nikdy se nesnažte obejít CAPTCHy nebo systém SearchGuard od Googlu — může vás to vystavit právnímu riziku.
Nescrapujte naslepo: jak přesně zacílit data, která potřebujete
Scrapovat všechno je recept na ztrátu času a nafouklé datasety. Takhle můžete cílit jen na data, na kterých záleží:
- Generujte cílené seznamy URL: Využijte vlastní filtry Google Maps (kategorie, lokace, hodnocení, otevřeno nyní) a zúžte výsledky ještě před scrapováním.
- Používejte shodu frází: Hledejte přesné typy firem nebo klíčová slova (např. „vegan bakery in Austin“).
- Filtry podle lokace: Pro přesnost zadejte město, čtvrť nebo i souřadnice a rádius.
- Serverové filtrování (API): V těle API požadavku použijte
minRating,includedTypealocationBias. - Filtrování na straně klienta (Python): Po scrapingu použijte pandas k filtrování firem s hodnocením nad 4,0, více než 50 recenzemi nebo konkrétními kategoriemi.
Příklad: Filtrování jen restaurací na Manhattanu s hodnocením nad 4,0
df = pd.DataFrame(results)
filtered = df[(df['rating'] >= 4.0) & (df['types'].apply(lambda x: 'restaurant' in x))]
filtered.to_csv("manhattan_top_restaurants.csv", index=False)
Použití Python knihoven k organizaci a exportu dat z Google Maps
Jakmile data získáte, je čas je vyčistit, analyzovat a exportovat pro váš tým.
Čištění a strukturování dat pomocí Pandas
import pandas as pd

df = pd.read_json("brooklyn_restaurants.json")
df = (
    df.dropna(subset=["name", "address"])
      .drop_duplicates(subset=["place_id"])
      .assign(
          name=lambda d: d["name"].str.strip(),
          phone=lambda d: d["phone"].astype(str)
              .str.replace(r"\D", "", regex=True)
              .str.replace(r"^1?(\d{10})$", r"+1\1", regex=True),
          rating=lambda d: pd.to_numeric(d["rating"], errors="coerce"),
          user_ratings_total=lambda d: pd.to_numeric(
              d["user_ratings_total"], errors="coerce"
          ).fillna(0).astype("int32"),
      )
)
Analýza a shrnutí dat
Příklad: Průměrné hodnocení podle čtvrti
by_neighborhood = (
    df.groupby("neighborhood", as_index=False)
      .agg(avg_rating=("rating", "mean"),
           n_places=("place_id", "nunique"),
           median_reviews=("user_ratings_total", "median"))
      .sort_values("avg_rating", ascending=False)
)
Export do Excelu nebo CSV
df.to_csv("brooklyn_top.csv", index=False)
df.to_excel("brooklyn_top.xlsx", index=False, sheet_name="Top Rated")
Velké datasety? Použijte formát Parquet pro rychlost a úsporu místa:
df.to_parquet("brooklyn_top.parquet", compression="zstd")
Thunderbit: AI alternativa k Python scraperu pro Google Maps
Jestli si teď říkáte: „Tohle je na jednoduchý seznam leadů dost nastavování,“ nejste sami. Právě proto jsme vytvořili Thunderbit — AI no-code web scraper, díky kterému je získávání dat z Google Maps (a mnohem víc) snadné na pár kliknutí.
Proč Thunderbit?
- Bez kódování a bez API klíčů: Stačí otevřít rozšíření Thunderbit pro Chrome, přejít na Google Maps a kliknout na „AI Suggest Fields“.
- Detekce polí pomocí AI: AI od Thunderbitu přečte stránku a navrhne správné sloupce — název, adresa, hodnocení, telefon, web a další.
- Scraping podstránek: Chcete obohatit tabulku o data z webu každé firmy? Thunderbit umí navštívit jednotlivé podstránky a automaticky stáhnout další informace.
- Export do Excelu, Google Sheets, Airtable nebo Notion: Žádné další ladění pandas — stačí kliknout na „Export“ a data jsou připravená pro váš tým.
- Plánované scrapování: Nastavte opakující se úlohy pro sledování konkurence nebo automatickou aktualizaci seznamu leadů.
- Minimální údržba: AI v Thunderbitu se přizpůsobuje změnám na webu, takže nemusíte neustále opravovat rozbité skripty.
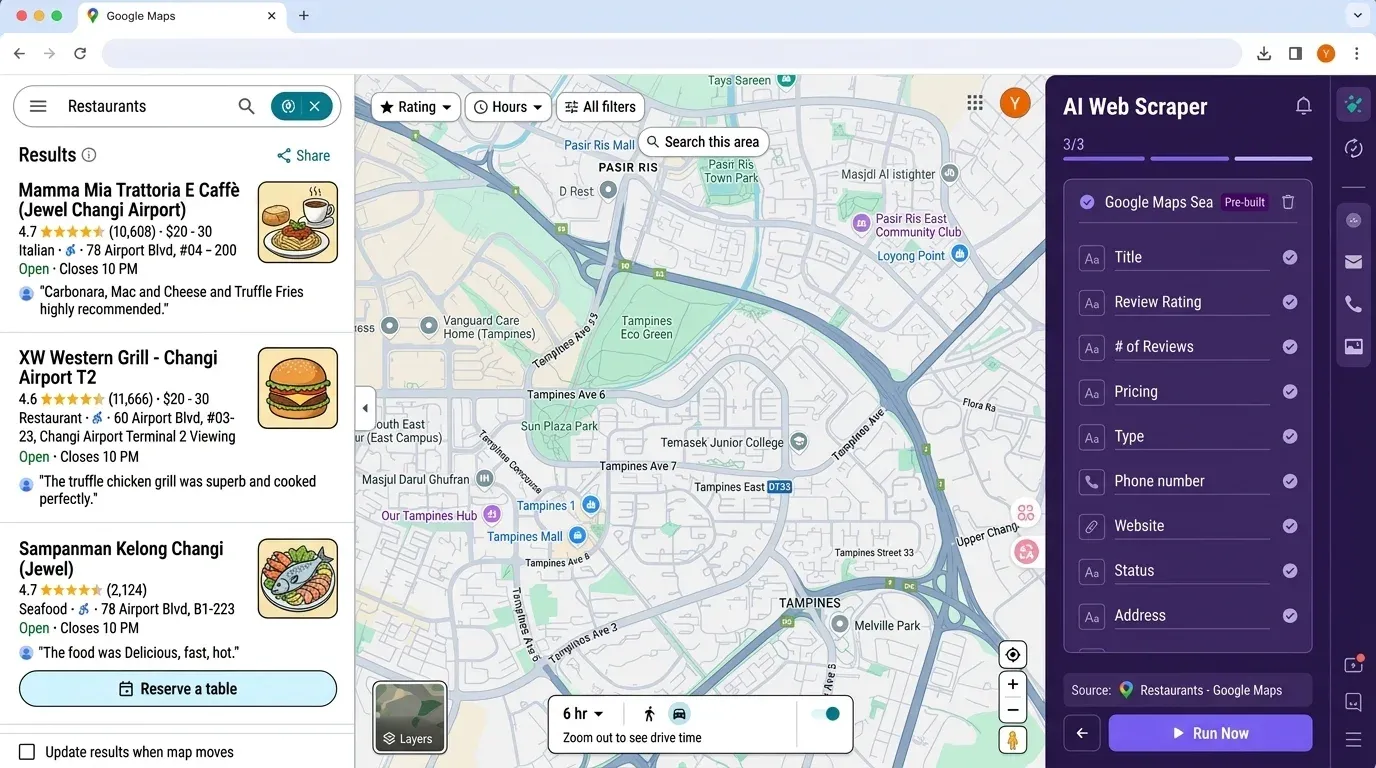
Workflow Thunderbit vs Python:
| Krok | Python scraper | Thunderbit |
|---|---|---|
| Instalace nástrojů | 30–60 min (Python, pip, knihovny) | 2 min (Chrome Extension) |
| Nastavení API klíče | 10–30 min (Cloud Console) | Není potřeba |
| Výběr polí | Ruční kód, field masky | AI Suggest Fields (1 kliknutí) |
| Extrakce dat | Psaní/spouštění skriptů, řešení chyb | Klikněte na „Scrape“ |
| Export | pandas do CSV/Excelu | Export do Excelu/Sheets/Notion |
| Údržba | Ruční úpravy při změnách webu | AI se automaticky přizpůsobí |
Bonus: Thunderbit používá přes 30 000 uživatelů po celém světě a bezplatná verze vám umožní scrapovat až 6 stránek (nebo 10 se zkušebním bonusem) zdarma.
Dodržování pravidel: podmínky používání Google Maps a etika scrapingu
Tady se většina Python tutoriálů nebezpečně zastavuje v čase. Tohle potřebujete vědět v roce 2026:
- Google Maps Platform ToS §3.2.3 striktně zakazuje scraping, ukládání do mezipaměti i export dat mimo oficiální API (cloud.google.com). Jediná výjimka: zeměpisné souřadnice lze ukládat do mezipaměti maximálně 30 dní; Place ID lze ukládat bez omezení.
- Uživatelé API jsou smluvně vázáni: Pokud používáte API klíč, souhlasili jste s podmínkami Googlu — i když získáváte jen veřejná data.
- Obcházení technických bariér (CAPTCHA, SearchGuard) může být od nynějška potenciálním porušením DMCA §1201, které může nést i trestní postih (ppc.land).
- GDPR a soukromí: Pokud z Google Maps sbíráte osobní údaje (emaily, telefonní čísla, jména recenzentů), musíte mít právní základ a respektovat žádosti o výmaz. Francouzská CNIL uložila v roce 2024 společnosti KASPR pokutu 200 000 € za scraping kontaktů z LinkedIn (edpb.europa.eu).
- Osvědčené postupy:
- Pokud je to možné, používejte výchozí Places API.
- Omezujte rychlost požadavků (≤10 QPS pro API, 1–2 požadavky za sekundu pro HTML scraping).
- Nikdy neobcházejte CAPTCHA ani technické blokace.
- Nepřerozdělujte nascrapovaná osobní data.
- Respektujte žádosti o odhlášení a smazání.
- Vždy si ověřte místní zákony — GDPR, CCPA a další jsou aktivně vymáhány.
Shrnutí: Pokud vám jde o compliance, držte se API a sbírejte jen minimum dat. Pro většinu firemních uživatelů snižuje no-code nástroj jako Thunderbit riziko (žádný API klíč, žádné přerozdělování dat).
Plánování a automatizace scrapingu Google Maps pomocí Pythonu
Pokud chcete, aby byla data stále čerstvá — třeba pro týdenní monitoring konkurence nebo měsíční aktualizaci seznamu leadů — automatizace je váš přítel.
Jednoduché plánování pomocí schedule
import schedule, time
from my_scraper import run_job

schedule.every().day.at("03:00").do(run_job, query="restaurants in Brooklyn")
schedule.every(6).hours.do(run_job, query="coffee shops in Manhattan")

while True:
    schedule.run_pending()
    time.sleep(30)
Produkční plánování pomocí APScheduler
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.triggers.cron import CronTrigger

sched = BackgroundScheduler(timezone="America/New_York")
sched.add_job(
    run_job,
    CronTrigger(hour=3, minute=15, jitter=600),  # 3:15 ráno ± 10 min
    kwargs={"query": "restaurants in Brooklyn"},
    id="brooklyn_daily",
    max_instances=1,
    coalesce=True,
    misfire_grace_time=3600,
)
sched.start()
Tipy pro bezpečnou automatizaci
- Do rozvrhu přidejte náhodné zpoždění, aby vzorce nepůsobily podezřele.
- U HTML scrapingu nikdy nepřekračujte 1–2 požadavky za sekundu.
- Při používání API sledujte kvótu a nastavte upozornění na fakturaci.
- Vždy logujte chyby a u neúspěšných požadavků si veďte „dead-letter“ soubor.
Bonus od Thunderbitu: S Thunderbit můžete opakované scrapování plánovat přímo v rozhraní — žádný kód, žádný cron, žádné nastavování serveru.
Hlavní závěry: efektivní, cílené a compliant získávání dat z Google Maps
Shrňme si to nejdůležitější:
- Google Maps jsou zdrojem č. 1 pro data o firemních lokacích, která pohánějí vše od lead gen až po průzkum trhu.
- Scraping v Pythonu nabízí flexibilitu a kontrolu, ale přináší nastavení, údržbu i compliance zátěž — zvlášť s tím, jak Google zpřísňuje ochranu proti botům a vymáhání pravidel.
- Extrakce přes API je pro většinu týmů nejbezpečnější a nejškálovatelnější cesta. Vždy používejte field masky a serverové filtry, abyste měli náklady pod kontrolou.
- HTML scraping je křehký a riskantní — používejte ho jen pro jednorázový výzkum a nikdy neobcházejte technické překážky.
- Zacílení dat je klíčové: Využívejte shodu frází, lokální filtry a workflow v pandas, abyste získali jen to, co opravdu potřebujete.
- Thunderbit je pro near-programátory nejrychlejší cesta: AI, žádné nastavování, okamžitý export a vestavěné plánování.
- Na compliance záleží: Dodržujte podmínky Googlu, zákony na ochranu soukromí i rate limity, ať se vyhnete právním problémům.
Další návody a tipy najdete na Thunderbit Blogu a na našem YouTube kanálu.
FAQ
1. Je v roce 2026 legální získávat data z Google Maps pomocí Pythonu?
Scraping Google Maps přes oficiální API je v rámci podmínek Googlu povolený, pokud dodržujete kvóty a nepřerozdělujete omezená data. HTML scraping Google Maps je podmínkami Googlu výslovně zakázaný a nese právní riziko, zvlášť pokud obcházíte technické bariéry nebo bez souhlasu sbíráte osobní údaje. Vždy si ověřte místní zákony (GDPR, CCPA atd.) a držte se osvědčených postupů pro compliance.
2. Jaký je rozdíl mezi Google Maps API a web scrapingem HTML?
API je stabilní, licencované a navržené pro extrakci dat, ale vyžaduje API klíč a podléhá kvótám i nákladům. HTML scraping používá automatizaci prohlížeče k získání dat z vykreslené stránky, ale je křehký (web se často mění), může porušovat podmínky a z právního hlediska je rizikovější. Pro většinu firemního použití je doporučenou cestou API.
3. Kolik stojí získávání dat z Google Maps pomocí Pythonu v roce 2026?
Ceník Google Places API je nastavený za 1 000 požadavků a pohybuje se od 5 dolarů (Essentials) do 25 dolarů (Enterprise+Atmosphere) podle polí, která požadujete. Existují bezplatné měsíční limity (10 000 pro Essentials, 5 000 pro Pro, 1 000 pro Enterprise), ale při větším objemu se náklady rychle nasčítají. Pro kontrolu nákladů vždy používejte field masky a serverové filtry.
4. Jak si Thunderbit stojí ve srovnání s Python scraperem pro Google Maps?
Thunderbit je no-code AI web scraper, který vám umožní získávat data z Google Maps (a mnohem víc) bez programování, API klíčů a údržby. Je ideální pro obchodní a marketingové týmy, které chtějí rychlý a spolehlivý export do Excelu, Google Sheets, Airtable nebo Notion. Pro technické uživatele, kteří potřebují vlastní logiku, nabízí Python větší flexibilitu, ale vyžaduje více nastavování a správy compliance.
5. Jak mohu automatizovat opakované získávání dat z Google Maps?
V Pythonu použijte plánovací knihovny jako schedule nebo APScheduler a spusťte scraper v pravidelných intervalech (denně, týdně atd.). Přidejte náhodné zpoždění, abyste snížili riziko detekce, a hlídejte kvótu API. S Thunderbit můžete opakované scrapování plánovat přímo v rozhraní — bez kódu a bez nastavování serveru.
Jste připraveni proměnit Google Maps ve svou superpower pro prodej a marketing? Ať už jste nadšenec do Pythonu, nebo chcete nejrychlejší no-code řešení, v roce 2026 už jsou nástroje k dispozici. Vyzkoušejte Thunderbit pro okamžité AI scrapování — nebo si vyhrňte rukávy a ponořte se do API. Ať tak či tak, ať jsou vaše seznamy leadů čerstvé, exporty čisté a kampaně plné lokálních kontaktů s vysokou mírou konverze. Příjemné scrapování!
Zjistit více




