
Mozilla's Readability je samostatný JavaScriptový port extraktoru, který stojí za Firefox Reader View. Vydává se jako balíček Apache-2.0 @mozilla/readability a z živého DOMu vybírá obsah článku. V prostředí Node proto potřebuje DOM implementaci, například jsdom. Nestahuje stránky, nespouští jejich JavaScript ani neprovádí extrakci schémat.
Testovaná verze je npm latest 0.6.0, vydaná 3. března 2025; při kontrole 27. července 2026 měl repozitář 11 361 hvězdiček (poslední push byl 9. července 2026, takže main je už výrazně napřed oproti publikovanému balíčku). Spustil jsem ji na jsdom 29.1.1 a Node v22.22.3 na macOS arm64 proti 22 označeným HTML fixturem vytvořeným pro tento účel a všechna měření v tomto textu vycházejí právě z tohoto setupu. V praxi je to v téhle kategorii nejméně náročný nástroj: dvě minuty na instalaci, žádné binárky, žádný prohlížeč uložený v cache, při každém opakování stejný výstup. Zajímavý není ani tak jeho provoz — ale to, že selhání jsou předvídatelná z několika konstant ve zdrojáku, a jedna z nich rozhoduje víc, než napovídá dokumentace.
Napříč 22 kontrolovanými syntetickými fixturemi Readability obnovil všech 74 označených bloků článku. Tenhle ohraničený výsledek ale neznamená, že nikdy neztratí text článku: veřejný benchmark na reálných stránkách uvádí recall 0,982 a známé typy chyb se tady nereprodukovaly. Nejviditelnější selhání ve fixturech bylo přijetí navíc přilepeného sourozeneckého obsahu kvůli link-density bráně ve zdrojáku nastavené na 0,25. Jeho zdánlivá závažnost se mění podle testovacího prostředí.
Co vlastně readability.js je a tři věci, které není
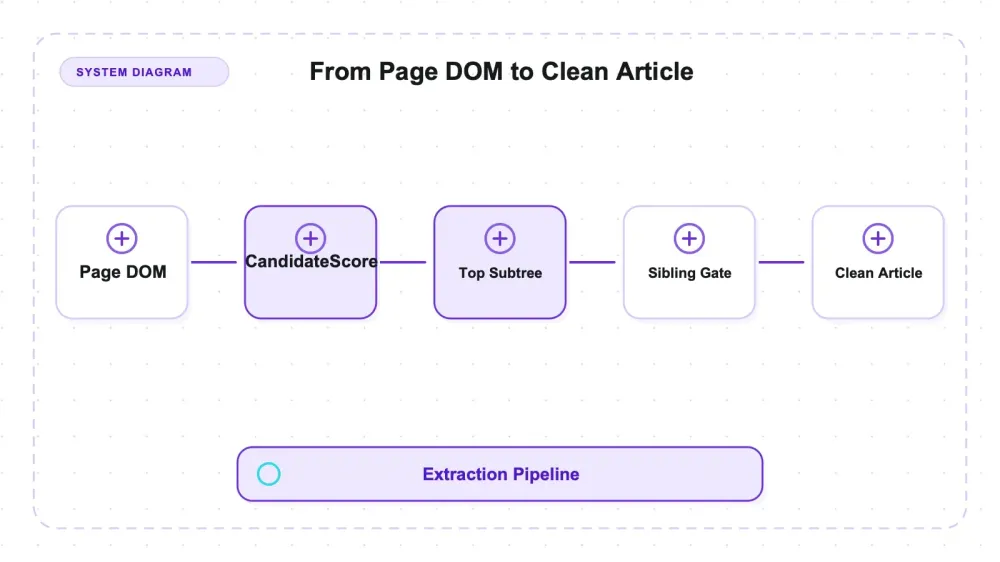
Readability je pravidly řízený scoring nad DOMem. Prochází kandidátní elementy, každému přiřadí content score, tyhle hodnoty propaguje do rodičů, vybere podstrom s nejvyšším skóre a pak spustí úklidové průchody, které odstraňují to, co vypadá jako „nástavba“ stránky. To je celý přístup k extrakci článků — žádný model, žádná trénovací data, žádná pravidla pro jednotlivé weby. Právě proto funguje i na stránce, kterou nikdy předtím neviděl — a právě proto jsou jeho chyby předvídatelné ze zdrojáku, což je na tom to zajímavé.
Tři věci to není a všechny tři lidi pletou:
- Není to fetcher. Bere
document, ne URL. Stahování, retry, anti-bot ochrana i hlavičky jsou na vás. - Není to renderer. Žádné spouštění JavaScriptu. Vidí jen to, co je v DOMu, který mu předáte.
- Není to strukturovaný extraktor. Dostanete
title,byline,excerpt,content(HTML),textContent,length,siteName. Žádné schéma, žádné typované řádky, žádné{name, price}.
Čtyři konstanty dělají většinu práce
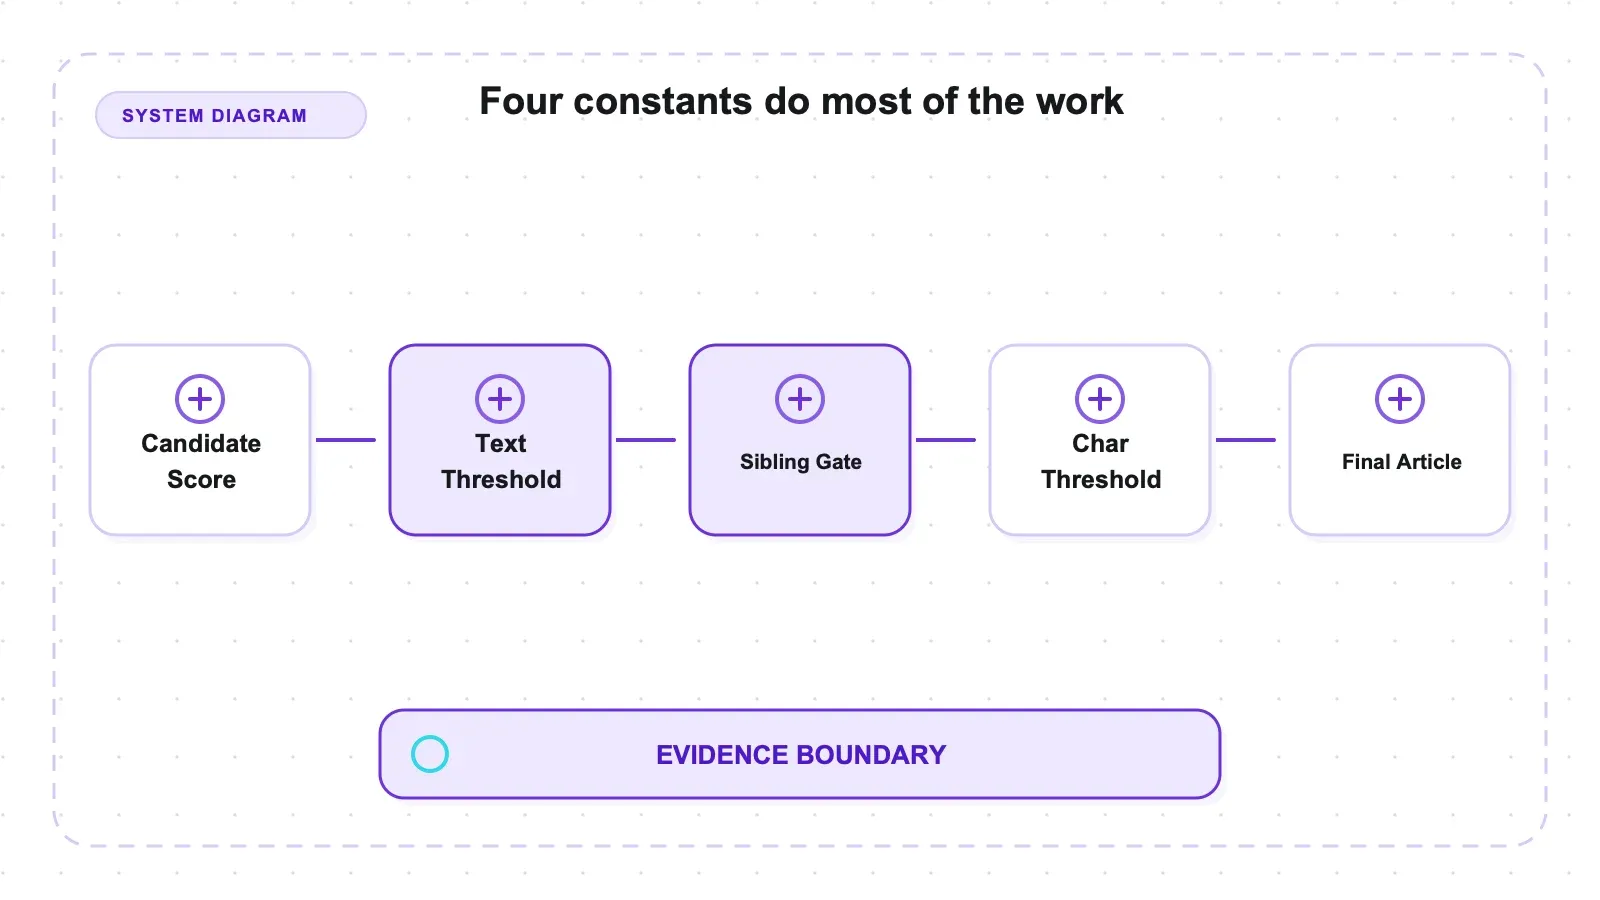
Když si přečteš Readability.js v node_modules, zjistíš o chování víc než z jakékoli stránky dokumentace. O většinu toho, co knihovna dělá, se starají čtyři mechanismy:
- Content score za odstavec:
1 + (počet_čárek + 1) + min(floor(délka / 100), 3). Odstavce kratší než 25 znaků se vůbec nepočítají. Skóre se propisuje do předků s dělením — rodič dostane plné skóre, prarodič polovinu a hlubší předcilevel · 3. DEFAULT_CHAR_THRESHOLD = 500— minimální délka článku pro „úspěšný“ parse. Pod touto hranicí se znovu spustí průchod s menším množstvím úklidových zásahů.- Regulární výraz
unlikelyCandidates— matchuje části class a id jakocomment,footer,menu,related,sidebar,social,sponsor. Odpovídající uzly se před scoringem zahodí. - Brána pro připojení sourozenců v
grabArticle— po výběru top kandidáta se zvažují jeho sourozenci. Sourozenec se připojí, pokud jeho vlastní skóre překročí práh, nebonodeLength > 80 && linkDensity < 0.25, nebonodeLength < 80 && nodeLength > 0 && linkDensity === 0 && obsahuje tečku.
Link density je Σ(délkaTextuOdkazu · koeficient) / délkaTextu, kde koeficient = 0,3 pro holé # odkazy a 1 jinak. Právě tahle brána vysvětluje úniky sourozeneckého obsahu naměřené v tomhle testu; není to celý algoritmus extrakce.
Setup a závislost, která v prezentaci chybí
npm install @mozilla/readability jsdom a můžeš začít. Dvě minuty, žádné binárky, žádný post-install download, žádný prohlížeč v cache. Z hlediska instalace je to skoro ideální.
Ale tvrzení o „nulových závislostech“ se týká algoritmu, ne runtime. Readability pracuje nad živým document, a v Node to znamená, že DOM musíš dodat sám — v mém případě jsdom ve verzi 29.1.1. jsdom není malý a ve většině pipeline bude dominantní náklad smyčky, ne samotná extrakce. S tím je potřeba počítat.
Ještě jedna past, kvůli které jsem musel běh opakovat: Readability.parse() mutuje DOM, který dostane. Když parse spustíš nad stejným jsdom dokumentem dvakrát, druhé volání už pracuje s dokumentem, který první průchod rozebral. Každý parse v mém testovacím harnessu proto vytváří nový jsdom. Jestli při zpracování stránek kvůli úspoře času znovu používáš stejný document, přesně tenhle bug budeš brzy řešit.
Jak jsem to testoval
Nesměřoval jsem to na živé zpravodajské weby. U živých stránek sice dostaneš skóre, ale nevíš proč — a u heuristiky je právě to „proč“ nejdůležitější. Místo toho jsem vygeneroval 22 HTML fixtureů obsahujících 91 označených bloků (74 článkových, 17 boilerplate), kde každé slovo v bloku začíná unikátním sentinel řetězcem daného bloku. Slovní zásoby jednotlivých bloků jsou navzájem disjunktní, takže každý extrahovaný token lze přiřadit právě k jednomu bloku a „obnovené“ či „uniklé“ je přesný membership test, ne vágní shoda.
Samotná extrakce a scoring jsou záměrně oddělené. Node runner vrací jen syrový extrahovaný text, boolean hodnoty isProbablyReaderable a naměřené link densities. Veškerá precision i recall se dopočítává až potom z tohohle syrového textu proti štítkům pomocí samostatného skriptu. Žádná metrika není v harnessu ručně zapsaná, což je jediný způsob, jak věřím vlastním číslům.
Pak jsem identické bajty poslal i do trafilatura 2.1.0, abych měl srovnání na stejném testbedu. Každý fixture byl parsován třikrát; všech 22 vrátilo v každém běhu byte-identický text.
Každou fázi si můžeš zkontrolovat sám, nemusíš věřit jen souhrnné tabulce. tests/build_fixtures.mjs vytváří anotované HTML a ground truth; tests/run_readability.mjs zaznamenává výstup extrakce i prediktoru; a tests/metrics.py tahle data zpětně vyhodnocuje. Syrový výstup Readability, spočtené metriky i srovnání nad stejnými vstupy jsou uložené v artifacts/raw/. To oddělení je důležité ve chvíli, kdy výsledek vypadá podezřele: poznáš, jestli parser vrátil nečekaný text, jestli byl špatně štítek, nebo jestli selhal vyhodnocovací skript. Reprodukce na tomhle balíčku ověřuje tvrzení z textu, ale pořád jde jen o kontrolu harnessu — ne o důkaz, že produkční mix reálných stránek má stejné rozložení chyb.
Limit rozsahu je skutečný a zásadní: jde o syntetické, kontrolované stránky, ne o reálný korpus. Autoritativní čísla pro reálné stránky pocházejí z veřejného article-extraction-benchmark, který hodnotí readability_js 0.6.0 — tedy přesně tu verzi, kterou jsem testoval — na word-F1 0.947 ± 0.005 (precision 0.914 ± 0.008, recall 0.982 ± 0.003) napříč zhruba 181 reálnými stránkami. To cituji; nereprodukoval jsem to.
Použité jsou řádky benchmarku pro aktuální vydání; zastaralé historické řádky byly vyřazeny. Kontrolované fixture navíc přidávají rozklad po blocích, který ukazuje, jaký typ obsahu spouští které pravidlo, místo aby nahrazoval veřejný korpus reálných stránek.
Recall byl v syntetickém balíčku dokonalý
74 ze 74. Napříč všemi 22 fixturemi Readability neztratil ani jeden označený blok článku — a na jedenácti čistých syntetických fixturech, které kombinovaly článek a boilerplate, vyšla mikroprůměrovaná token recall na 1,000. Nezmizela ani jedna věta článku.
K tomu ale patří dvě poznámky:
Jde o čisté, jednosloupcové syntetické stránky. Reálné články bývají hlouběji zanořené, reklamy se mohou vkládat doprostřed těla textu a někdy se první odstavec ztratí kvůli scoring artefaktu — tenhle typ missů je evidovaný v trackeru (#437, #901 a ztráty obsahu před tabulkou v #922). Moje fixture žádný z těchhle případů nespustily, takže netvrdím, že jsou opravené — jen říkám, že můj test se k nim nedostal. Na reálných stránkách je recall pro tuhle verzi 0,982, ne 1,000.
Důležitý je ale směr výsledku. Problém Readability není v tom, že zahazuje váš článek. Problém je v tom, co si bere s sebou.
Číslo precision a proč potřebuje tři štítky
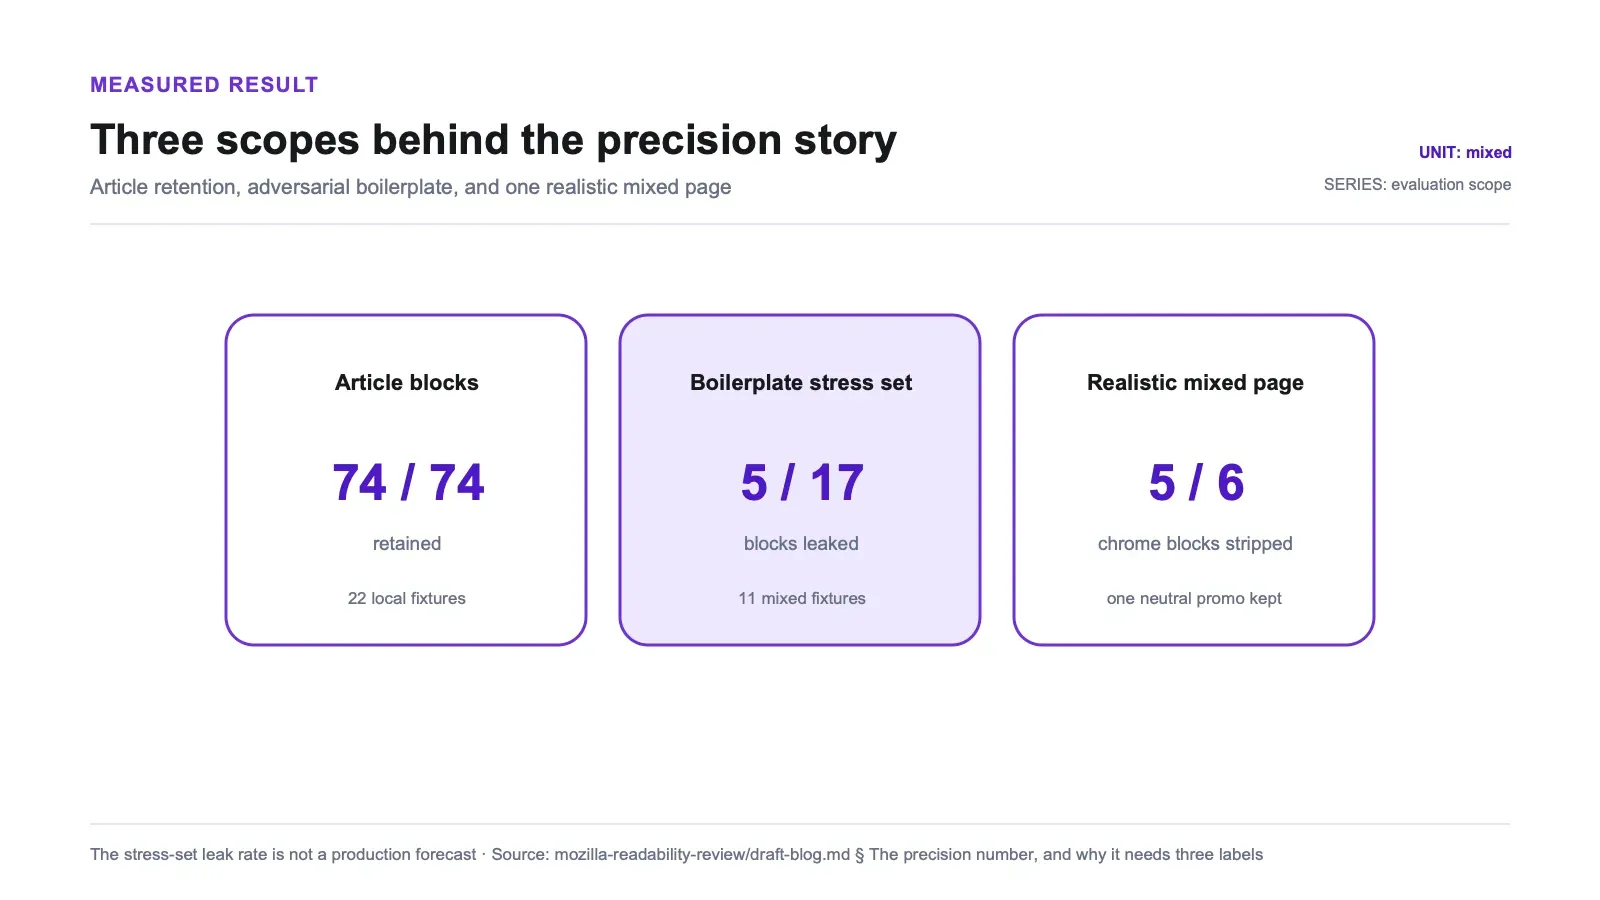
Jedno číslo se dobře cituje, ale hůř obhajuje. Na jedenácti smíšených fixturech si Readability ponechal 5 z 17 boilerplate bloků — míra úniku 0,294.
To ale není reálná míra úniku. Tři různé setupy měří tři různé věci a jen jeden z nich popisuje běžné stránky:
| Co číslo měří | Výsledek |
|---|---|
| Adverzárně vážená sada fixtureů — 6 z 11 smíšených stránek bylo záměrně navrženo tak, aby porazily sibling gate | 5 z 17 boilerplate bloků ponecháno (0,294) |
Jedna realistická stránka — tělo v <article> obklopené navigací, reklamním bannerem, sidebar, komentáři, patičkou a jedním promo blokem s neutrální třídou | 5 ze 6 chrome bloků odstraněno; 1 ponechán |
| ~181 reálných stránek, veřejný benchmark (ne můj běh) | precision 0,914, recall 0,982, word-F1 0,947 — readability_js 0.6.0 |
První řádek ber jako zátěžový test, ne jako předpověď. Readability v praxi neuniká 29 % boilerplate. Na realistické stránce bylo všechno s class, kterou matchuje regex unlikelyCandidates — nav-menu, ad-banner, sidebar, comments, site-footer — odstraněno čistě, všech pět bloků. Jediný přeživší byl blok, který jsem navrhl tak, aby tomuto regexu unikl.
Brána 0,25: kde se zastaví odstraňování boilerplate
Pravidlo pro připojení sourozenců je ve zdrojáku popsané. Co ale podle mých znalostí nikdo přesně nezměřil, je bod, kde se překlápí. Proto jsem vytvořil gradient: jeden neutrálně classovaný <p class="teaser-block"> mimo <article>, čtyřodstavcový článek, který má jistě vyhrát jako top kandidát, a měnila se jen délka promo textu a link density. Density jsou počítané podle vlastní formule Readability, měřené za běhu, ne odhadnuté:
| Promo blok | Délka vnitřního textu | Nad 80 znaků | Naměřená link density | Výsledek |
|---|---|---|---|---|
| Bez odkazů | 126 | ano | 0,000 | ponecháno |
| Jeden krátký odkaz | 126 | ano | 0,143 | ponecháno |
| Jeden delší odkaz | 126 | ano | 0,278 | odstraněno |
| Polovina textu jako odkaz | 126 | ano | 0,476 | odstraněno |
| Jediná věta končící tečkou | 60 | ne | 0,000 | ponecháno |
| Stejný text bez tečky | 59 | ne | 0,000 | odstraněno |
Podmínka ve zdrojáku používá práh 0,25; naměřené vzorky jej obkročily, protože 0,143 prošlo a 0,278 bylo odstraněno. Samostatná větev ponechala 60 znaků dlouhou větu končící tečkou a odstranila verzi o 59 znacích bez tečky. Recall článku zůstal v obou větvích 4/4, takže tyhle vzorky izolují efekt na precision.
Mimo testovací harness tahle brána v podstatě říká: dlouhá, málo odkazovaná, neutrální próza vedle článku je článek. To ale popisuje spoustu věcí, které článkem nejsou — třeba odstavec „Související čtení“, newsletter pitch, poznámku editora nebo sponzorovaný teaser, který marketing napsal celými větami a odkazy odstranil kvůli trackingu.
V RAG indexu se takový nízko-linkový promo odstavec může stát extrahovaným chunkem a model nebo retriever ho pak může považovat za součást článku. Zdrojové pravidlo tenhle failure mode dělá uvěřitelným; tahle recenze ale neprováděla end-to-end evaluaci retrievalu ani citování modelem.
Pro tvrdý site-specific filtr je lepší předfiltrovat známé DOM kontejnery ve zdroji, před serializací zachovat ancestry zdrojového uzlu kvůli porovnání, nebo následně aplikovat pečlivě validované text-pattern filtrování. Samotné vrácené HTML už nemusí spolehlivě říct, jestli uzel původně ležel mimo primární kontejner. Sibling gate nejde v public options ladit.
Tři předpoklady, které fixture vyvrátily
Fixture vyvrátily tři předpoklady: že charThreshold odmítá krátké články, že jsou nutné sémantické tagy a že krátký neprozaický obsah se zahazuje. Níže je relevantní důkaz; není potřeba žádné preregistrační tvrzení.
charThreshold = 500 není útes
Lidová interpretace říká, že článek pod 500 znaky vrátí null. Nevrací. Projel jsem délku těla od 120 do 1500 znaků proti hodnotám charThreshold 200, 500 a 1000:
| Délka těla | Parse uspěl při každém thresholdu | Extrahovaná délka |
|---|---|---|
| 120 | ano | 161 |
| 300 | ano | 342 |
| 460 | ano | 509 |
| 520 | ano | 569 |
| 800 | ano | 841 |
| 1500 | ano | 1555 |
Plochý výsledek. Při všech třech nastaveních thresholdu vyšla na každé délce těla stejná extrahovaná délka. Threshold neřídí návratovou hodnotu — rozhoduje o tom, jestli se grab spustí znovu s vypnutými cleanup flagy, a na čisté stránce není co odstraňovat, takže sieve vrátí tentýž obsah v obou případech. Skutečná hranice pro null je „žádný extrahovatelný text“.
A právě tady se objevil skutečný problém, a je horší než falešné null. Poslal jsem mu skoro prázdnou stránku — navbar a čtyřslovný popisek. Parse proběhl úspěšně a „článek“, který vrátil, obsahoval i navigaci. Když na stránce není skutečný článek, Readability vám vrátí boilerplate označený jako článek. Pokud crawluješ ve velkém a bereš nenulový výsledek jako „ta stránka měla obsah“, je to špatný předpoklad.
Sémantické tagy nedělají hlavní práci
Čekal jsem pokles recallu, když odstraním kostru. Stejný text článku, dvě podoby: jedna s <main><article><h1> a popisnými class jmény, druhá s <div class="x1"> a odstavci jako holými <div>. Výsledek: 4 ze 4 bloků článku obnoveny v obou případech, žádný boilerplate neunikl ani v jednom. Když je článek jasně nejhustší textový blok na stránce, scoring podle délky a čárek ho najde i bez sémantické pomoci. Tvrzení „Readability potřebuje <article> tagy“ je folklór.
Poctivý limit toho tvrzení: moje stránka měla jeden zcela zřejmý blok obsahu. Kde by sémantika mohla skutečně pomoct, je stránka se dvěma konkurenčními hustými podstromy — a to jsem netestoval.
Neprozaický obsah přežívá v plném rozsahu
Pravidlo „odstavce pod 25 znaků se nepočítají“ mě vedlo k očekávání ztrát u tabulek a popisků. Zase špatně — tohle pravidlo ovlivňuje scoring kandidátů, ne jejich uchování. Jakmile vyhraje kontejner, všechno uvnitř jde s ním:
| Typ obsahu uvnitř článku | Readability | trafilatura |
|---|---|---|
| Prozaické odstavce (×2) | ponecháno | ponecháno |
| Buňky datové tabulky (×2) | ponecháno | ponecháno |
Kódový blok <pre> | ponecháno | ponecháno |
Jednořádkový <p> kratší než 25 znaků (×2) | ponecháno | ponecháno |
<figcaption> | ponecháno | odstraněno |
| Celkem | 8/8 | 7/8 |
To je osa, na které prohrává těžší čistič. Pokud jsou tvoje stránky dokumentace, tutoriály nebo cokoli s code blocky a popsanými obrázky, chování Readability „ponechám celý vítězný podstrom“ je spíš výhoda.
isProbablyReaderable říká ne, zatímco parse() říká ano
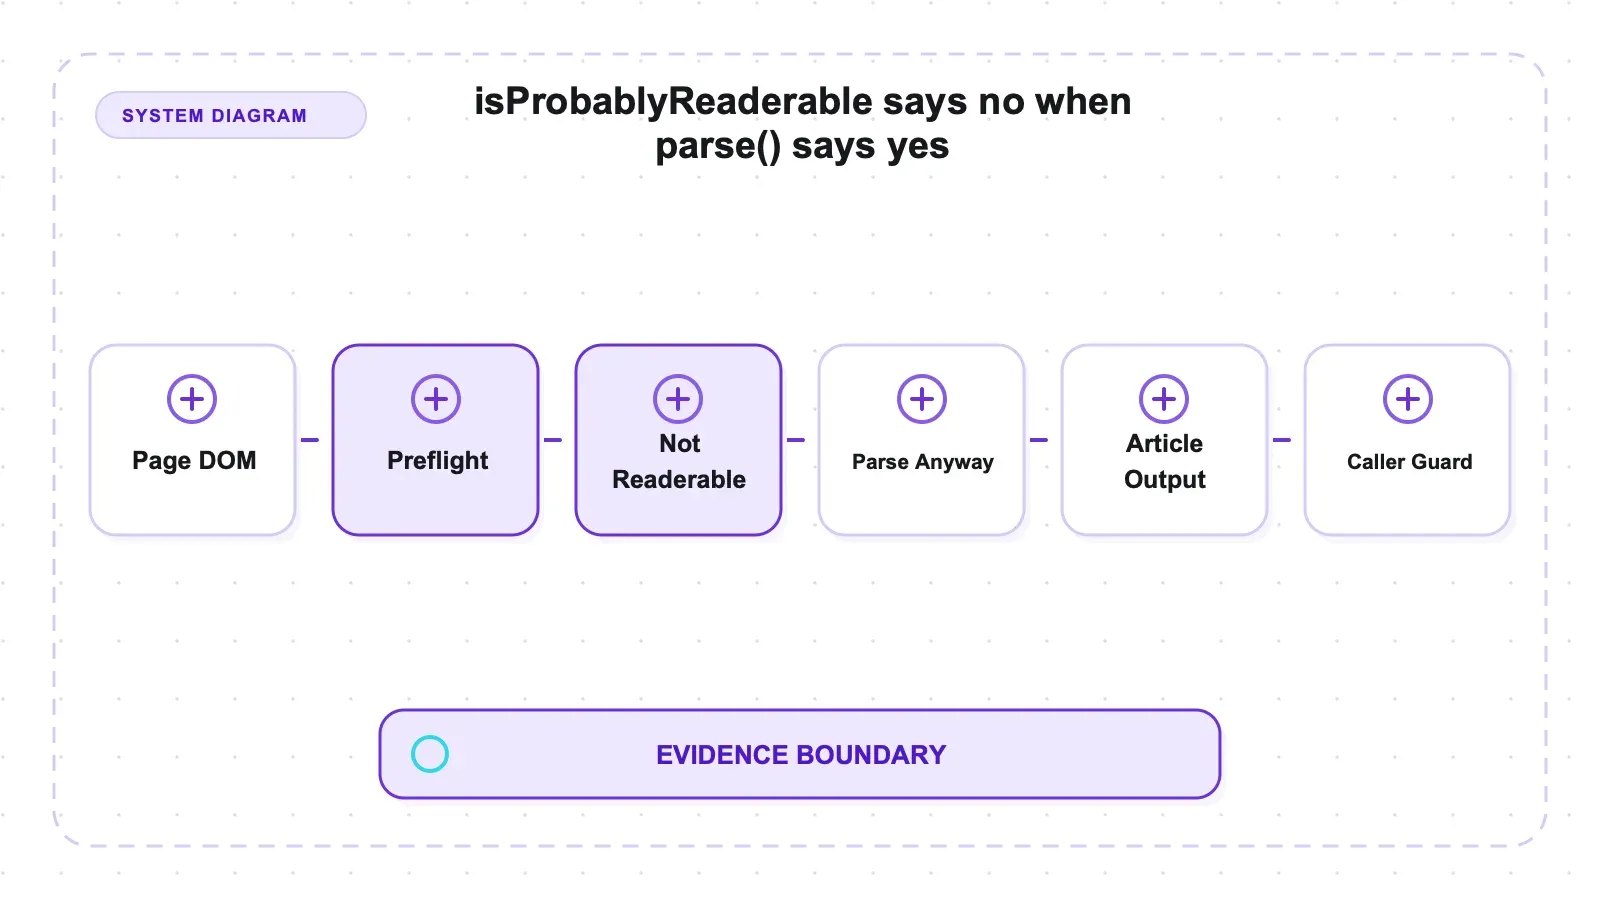
README doporučuje před plným parse volat isProbablyReaderable(doc) jako levnou předběžnou kontrolu. V mých testech tahle brána odmítla tři různé tvary stránek, které pak parse() zpracoval bez problémů:
| Tvar stránky | Verdikt prediktoru | parse() | Která páka to opraví |
|---|---|---|---|
Obsah jen v prvcích <li> | false | uspěje | žádná — false při každém minScore 1–80 i každém minContentLength 40–200 |
| Deset odstavců, každý pod 140 znaky | false | uspěje | minContentLength ≤ 100 (minScore nic neřeší) |
| Jeden odstavec o délce 408 znaků | false | uspěje | minScore ≤ 10 (skóre je ≈16,4) |
| Běžný článek (kontrola) | true | uspěje | — |
Ty tři chyby mají tři různé příčiny a jen dvě z nich jde ladit. Případ s <li> je strukturální: prediktor skóruje jen uzly p, pre a article (plus rodiče div > br), takže stránka, jejíž obsah žije v položkách seznamu, nic neshodí, dostane nulu a žádné ladění prahu to neopraví — tenhle tvar je už nahlášený v issue #662. Případ s mnoha krátkými odstavci je brána minContentLength, která před scoringem přeskočí každý odstavec zvlášť, takže deset solidních odstavců dohromady dá nulu; nižší hodnota to opraví a minScore s tím nic neudělá. Případ s jedním odstavcem je aritmetika: skóre je sqrt(408 − 140) ≈ 16,4, tedy pod výchozím minScore 20 — samotný odstavec potřebuje na překročení hranice 540 znaků (140 + 20²).
README sice varuje, že prediktor dává falešně negativní výsledky. Praktické pravidlo, které bych doplnil, je: nepoužívejte ho jako jediné síto. Pokud na stránce záleží, prostě ji parseujte a zkontrolujte délku výsledku. Parse není vzhledem k tomu, co už stejně platíte za build jsdom, nijak drahý.
Stejné bajty, dva extraktory
Spuštění trafilatura 2.1.0 nad identickými fixturemi dává čistší srovnání než stavět vedle sebe dvě čísla z různých testbedů, protože vstup je bajt po bajtu stejný:
| Metrika (11 smíšených fixtureů) | @mozilla/readability | trafilatura |
|---|---|---|
| Recall bloků článku | 1,000 | 1,000 |
| Ponechané boilerplate bloky | 5/17 (0,294) | 1/17 (0,059) |
| Token F1 (micro) | 0,948 | 0,969 |
| Recall neprozaického obsahu | 8/8 | 7/8 |
| Velmi krátký článek (120 znaků), token F1 | 0,800 | 0,571 |
Ani jeden z nich nad těmi to fixturemi jasně nedominuje. Trafilatura ponechala méně sourozeneckých bloků, zatímco Readability zachytila víc krátkého a neprozaického obsahu. Absolutní token precision u obou nástrojů snižuje neoznačený text nadpisů, takže blokový počet úniků je čistší přímý signál. Veřejný benchmark na reálných stránkách je sice řadí podobně i podle word-F1, ale korpusy i metriky jsou jiné a nejde o validaci napříč testbedy.
Stručně k robustnosti: spustil jsem záměrně poškozenou dvojní verzi kanonické stránky (neuzavřené <p>, špatně zanořené <b>/<i>, a zbloudilé </div>) a recall byl 3/3 se zero leaks, stejně jako u dobře utvořené verze. Zasloužený kredit tady patří jsdom, které HTML5 strom opraví dřív, než ho Readability vůbec uvidí. Žádný fixture parser nesrazil.
Klady a zápory
Klady
- Recall článků je silná stránka: 74/74 označených bloků obnoveno napříč 22 syntetickými fixturemi, token recall 1,000 na smíšené sadě.
- Stránkové dekorace rozpoznané regulárním výrazem mizí spolehlivě — navigace, reklamní banner, sidebar, komentáře i patička byly na realistické stránce pryč (5 ze 6).
- Neprozaický obsah se zachovává celý: tabulky, kód v
<pre>, popisky obrázků i řádky kratší než 25 znaků přežily (8/8), zatímco trafilatura popisek odstranila. - Není závislé na sémantickém markup — neutrální
<div>článek měl stejné skóre jako varianta s<article>/<main>. - Krátké články nejsou falešně odmítané: čistý obsah se obnovil už od 120 znaků a výsledek byl shodný pro
charThreshold200/500/1000. - Plně deterministické: všech 22 fixture vrátilo ve třech bězích identický text.
- Instalace trvá dvě minuty, licence je Apache-2.0 a verze na npm je ta samá, kterou jsem testoval (0.6.0), takže nic z toho není zastaralé.
Zápory
- Brána pro připojování sourozenců je zneužitelná: dlouhá, málo linkovaná, neutrálně classovaná promo próza je od článku nerozlišitelná a přilepí se, když má
linkDensity < 0,25. - Na stránkách s málo obsahem vrací boilerplate jako článek místo
null— skoro prázdný fixture přišel zpět i s navbar jako tělem. isProbablyReaderabledává falešně negativní výsledek na tři různé tvary stránek, z nichž jeden nepůjde opravit žádným laděním.- Běh vyžaduje plný DOM — řeči o „žádných závislostech“ zakrývají cenu jsdom, která je ve smyčce dominantní.
parse()mění vstupní dokument, takže pro každou stránku musíš DOM znovu sestavit.- Žádné stahování, žádný JavaScript rendering, žádný strukturovaný výstup. Je to jen jedna fáze pipeline, ne celá pipeline.
- Chyby na reálných stránkách, popsané v trackeru (ztráta úvodního odstavce a obsah před tabulkou), se na mých fixturech nereprodukovaly, takže nemůžu říct, jestli jsou vzácné, nebo jestli se mé stránky prostě nikdy nedostaly do stejného režimu selhání.
Pro koho je a kdo by měl sáhnout jinam
Po Readability sáhni, pokud už HTML máš v ruce a chceš z něj v čistém JavaScriptu dostat článek v Node službě, kde by přidání Python závislosti bylo nepraktické. (Neudělal jsem plnohodnotné měření času jako distribuci, takže si netroufám tvrdit nic víc než to, že smyčku dominuje build jsdom, ne samotná extrakce.) Reader mode funkce, offline archivace článků, e-mailové newslettery, tlačítka „clean view“, rozšíření do prohlížeče, dokumentační pipeline s code blocky a popisky — to je jeho doména a čísla recallu ukazují, že v ní funguje dobře. Jeho chování je navíc čitelné přímo ze zdrojáku, což se zdá jako drobnost, ale ve chvíli, kdy kolegovi vysvětluješ, proč prošel právě tenhle konkrétní blok, to má velkou cenu.
Naopak se mu vyhni, pokud jsi hodnocený za precision při odstraňování boilerplate, a hlavně pokud plníš LLM index, kde se náhodný promo odstavec může stát dohledatelným chunkem. Vyhni se mu, pokud stránky renderují obsah na klientovi, protože čte jen DOM, který mu předáš, a JavaScript nespouští. Vyhni se mu, pokud potřebuješ {title, price, sku} místo prózy — žádná konfigurace neudělá z content extraktoru schema-driven nástroj. A pokud zpracováváš stránky, kde je reálně otázka „byl na té stránce vůbec nějaký článek“, nespolehej na nenulový návrat jako na odpověď.
Alternativy a kde zapadá Thunderbit stack
Tohle není útok na bezplatnou knihovnu Apache-2.0, kterou spravuje Mozilla — Readability je infrastruktura, ve Firefoxu běží už roky a pro reader-mode extrakci je referenční implementací z dobrého důvodu. Pokud chceš širší přehled trhu, průběžně ho držím v open-source scrapers roundup a širší přehled v the best web scraping tools.
Pro stejnou sadu fixture napříč všemi šesti extraktory se podívej na six-library extraction comparison.
Poznámka autora: Thunderbit je naše spravovaná varianta pro renderování a extrakci z URL. Na těchto fixturech spuštěný nebyl, takže z toho neplyne žádné tvrzení o shodné kvalitě. Podstatná hranice je, jestli už DOM máš a chceš lokální extrakci článku, nebo jestli chceš fetch, render a strukturovaný výstup jako službu. Self-hosting sice eliminuje vendor fee, ale stále s sebou nese infrastrukturu i údržbu.
Upřímný trade-off: Readability je zdarma, transparentní a běží na vašem serveru — můžeš si přečíst přesnou bránu, která rozhodla o výstupu, což u spravovaného API nemáš. Spravovaný stack stojí peníze a schovává mechanismus, ale pokrývá fetch-render-structure kroky, které bys si jinak skládal sám. Pokud chceš AI-odpovídající konec toho spektra, psal jsem jinde o scraping any website with AI i o AI crawlers. Vyber si podle toho, které fáze opravdu chceš vlastnit.
Vyzkoušet Thunderbit pro extrakci webových dat
Verdikt
Readability dává smysl, pokud už máš DOM, běžíš v JavaScriptu/Node a raději sneseš občasný přebytečný sourozenecký obsah než agresivní vynechání. V tomhle balíčku fixture obnovil všech 74 označených bloků článku a zachoval tabulky, kód i popisky. Ten výsledek je ale omezen syntetickými jednosloupcovými stránkami; veřejný recall na reálných stránkách je 0,982, známé missy u úvodního odstavce a tabulek se nereprodukovaly a stránky s málo obsahem mohou vracet boilerplate jako článek.
Jen správně odhadni slabinu. Hlavní problém v těchto fixturech je precision a leží na konkrétním, zdrojákem popsaném místě: sourozenec delší než 80 znaků s link density pod 0,25 se připojí k článku, ať už do něj patří, nebo ne. Viděl jsem ten přechod na stejném textu mezi 0,143 a 0,278. Veřejný benchmark uvádí precision 0,914 a recall 0,982. Pokud posíláš extrahovaný text do indexu, ze kterého bude model později citovat, kontroluj jak ponechaný boilerplate, tak vynechaný text těla, místo abys předpokládal, že jedna z těchto chyb neexistuje.
Vyzkoušet Thunderbit pro extrakci webových dat Get Started Free
Časté dotazy
Odstraňuje Mozilla Readability veškerý boilerplate?
Ne, a číslo hodně závisí na tom, co přesně měříš. Ve veřejném benchmarku na reálných stránkách dosahuje readability_js 0.6.0 precision 0,914 — takže zhruba 8,6 % toho, co vrací, není tělo článku. Na jedné mé realistické testovací stránce odstranil 5 ze 6 chrome bloků (navigaci, reklamní banner, sidebar, komentáře i patičku), a nechal jen neutrálně classovaný promo odstavec. Na sadě fixture, kterou jsem záměrně zatížil bloky navrženými tak, aby heuristiku porazily, ponechal 5 ze 17 — to poslední číslo je zátěžový test, ne reálná míra.
Potřebuji pro používání readability.js v Node jsdom?
Ano, nebo jinou DOM implementaci. Readability je čistý JavaScript, ale pracuje nad živým objektem document, takže v Node musíš DOM dodat sám — v mém setupu to bylo jsdom 29.1.1. Popis „bez závislostí“ se týká algoritmu, ne runtime. Navíc parse() mění dokument, který dostane, takže pro každou stránku vytvářej nový DOM místo znovupoužití jednoho.
Co vlastně dělá volba charThreshold?
Ne to, co si většina lidí myslí. Nedělá z krátkých článků null — čisté články jsem obnovil už od 120 znaků a extrahovaná délka byla stejná pro charThreshold 200, 500 i 1000. Threshold řídí to, jestli parser zopakuje grab s vypnutými cleanup flagy; na čisté stránce není co odstraňovat, takže výsledek je v obou případech stejný. Skutečný případ null nastane až u stránky bez extrahovatelného textu — a dokonce i stránka jen s navigací se vrátila nenulová, protože navigace byla označená jako článek.
Mám před parse() volat isProbablyReaderable?
Používej ho jako nápovědu, ne jako bránu. Vrhl false na tři typy stránek, které pak parse() bez problémů zvládl: obsah uvnitř prvků <li>, deset odstavců kratších než 140 znaků a jeden odstavec o délce 408 znaků. Případ <li> nejde opravit laděním, protože prediktor skóruje jen uzly p, pre a article; případ s mnoha krátkými odstavci potřebuje nižší minContentLength; případ s jedním dlouhým odstavcem potřebuje nižší minScore, protože samotný odstavec musí mít 540 znaků, aby překonal výchozí práh. Pokud na stránce záleží, parseuj ji a výsledek zkontroluj.
Readability nebo trafilatura pro extrakci článků?
Na identických bajtech fixture udržela trafilatura méně boilerplate (1/17 bloků proti 5/17), zatímco Readability zachytila víc krátkého obsahu a ponechala <figcaption>, který trafilatura odstranila. Vyber podle tolerance chyb a runtime. Veřejný benchmark je samostatný kontext, ne validace tohohle výsledku na fixturech.




