
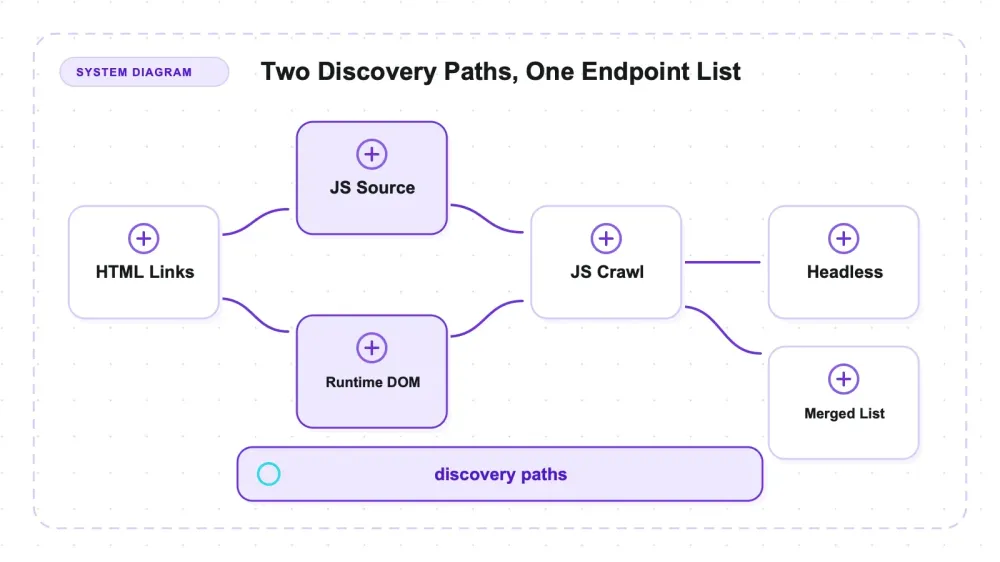
Katana je crawler pro objevování endpointů od ProjectDiscovery — Go binárka s licencí MIT, která vezme cílovou adresu a vrátí URL a endpointy pro další nástroj v pipeline. Umí fungovat v bezprohlížečovém HTTP režimu nebo s -headless, který spouští Chromium. Oficiální doporučení popisuje headless režim jako variantu s vyšším pokrytím; tenhle test ukazuje, že stejně důležitý jako počet je i typ endpointu.
Postavil jsem malý web se třemi záměrně odlišnými třídami endpointů a změřil jsem, který režim je na verzi v1.6.1 při -d 4 objevil. Běžné HTML se ve všech čtyřech konfiguracích dostalo na 4/4 odkazů i na celý tříkrokový řetězec. Rozdíl se objevil u endpointů exponovaných přes JavaScript source versus změny DOM až za běhu.
Na tomhle testovacím webu headless našel třídu runtime-DOM, kterou testované bezprohlížečové režimy minuly, zatímco standardní režim s -jc našel JavaScriptové string literály, které oba headless běhy minuly. Žádný řádek ve čtyřpříkazové matici nepokryl obě třídy zároveň. Scope, resume a chování známých souborů přidaly další praktické hranice.
Co Katana vlastně je
Crawler katana — projectdiscovery/katana na GitHubu — je napsaný v Go a má licenci MIT. Testoval jsem v1.6.1 dne 27. července 2026; na verzi záleží, protože zjištění o pokrytí a známých souborech níže jsou pozorování závislá na konkrétním buildu.
Štítek kategorie tu hraje větší roli než obvykle. Crawler pro objevování endpointů není nástroj na extrakci dat z polí. Pokud chceš Go web crawler, který ti vrátí názvy produktů a ceny jako strukturované JSON, Katana je úplně jinde — klidně ti řekne, že /products/1138 existuje, ale o tom, co je na té stránce, neřekne vůbec nic. Je to tak záměrně; hodnotit ho podle extrakce by bylo jako recenzovat detektor kovů podle toho, jak umí oceňovat šperky.
Jeho doménou je průzkum pro offensive security a automatizační pipeline: vstup přes STDIN, výstup jako URL, a pak to pošleš do dalšího nástroje. Tím se dostáváme k důležitému upozornění — všechna měření tady proběhla proti lokálnímu testovacímu webu na 127.0.0.1, který jsem sám napsal. Nasazujte Katanu jen na hosty, které vlastníte nebo k nim máte výslovné povolení k testování, a na nic jiného. Tohle není o obcházení ochran; jde o to, kolik z endpointového povrchu daného webu konkrétní příkaz skutečně vyjmenuje.
Tři režimy a co každý z nich vidí
Standardní režim je Go HTTP klient. Stahuje, parsuje HTML, sleduje href a nikdy nespouští prohlížeč. Je rychlý, levný a slepý vůči čemukoli, co existuje až po spuštění JavaScriptu.
-jc (-js-crawl) přidává na bezprohlížečovou cestu JavaScript parser. Stahuje připojené .js soubory a ze zdrojového kódu vytahuje string literály připomínající URL. Žádné spouštění, jen čtení. Existuje i -jsl (jsluice), popsaný v README jako těžší, paměťově náročnější parser — netestoval jsem ho, takže nemůžu říct, jestli mění obraz pokrytí.
-headless spouští Chromium a vykonává skripty stránky. Na tomhle testovacím webu to byl jediný testovaný režim Katany, který získal cestu sestavenou z fragmentů a vloženou do runtime DOM. Ten výsledek ale neříká nic o tom, co by uměl zachytit každý parser nebo budoucí režim Katany.
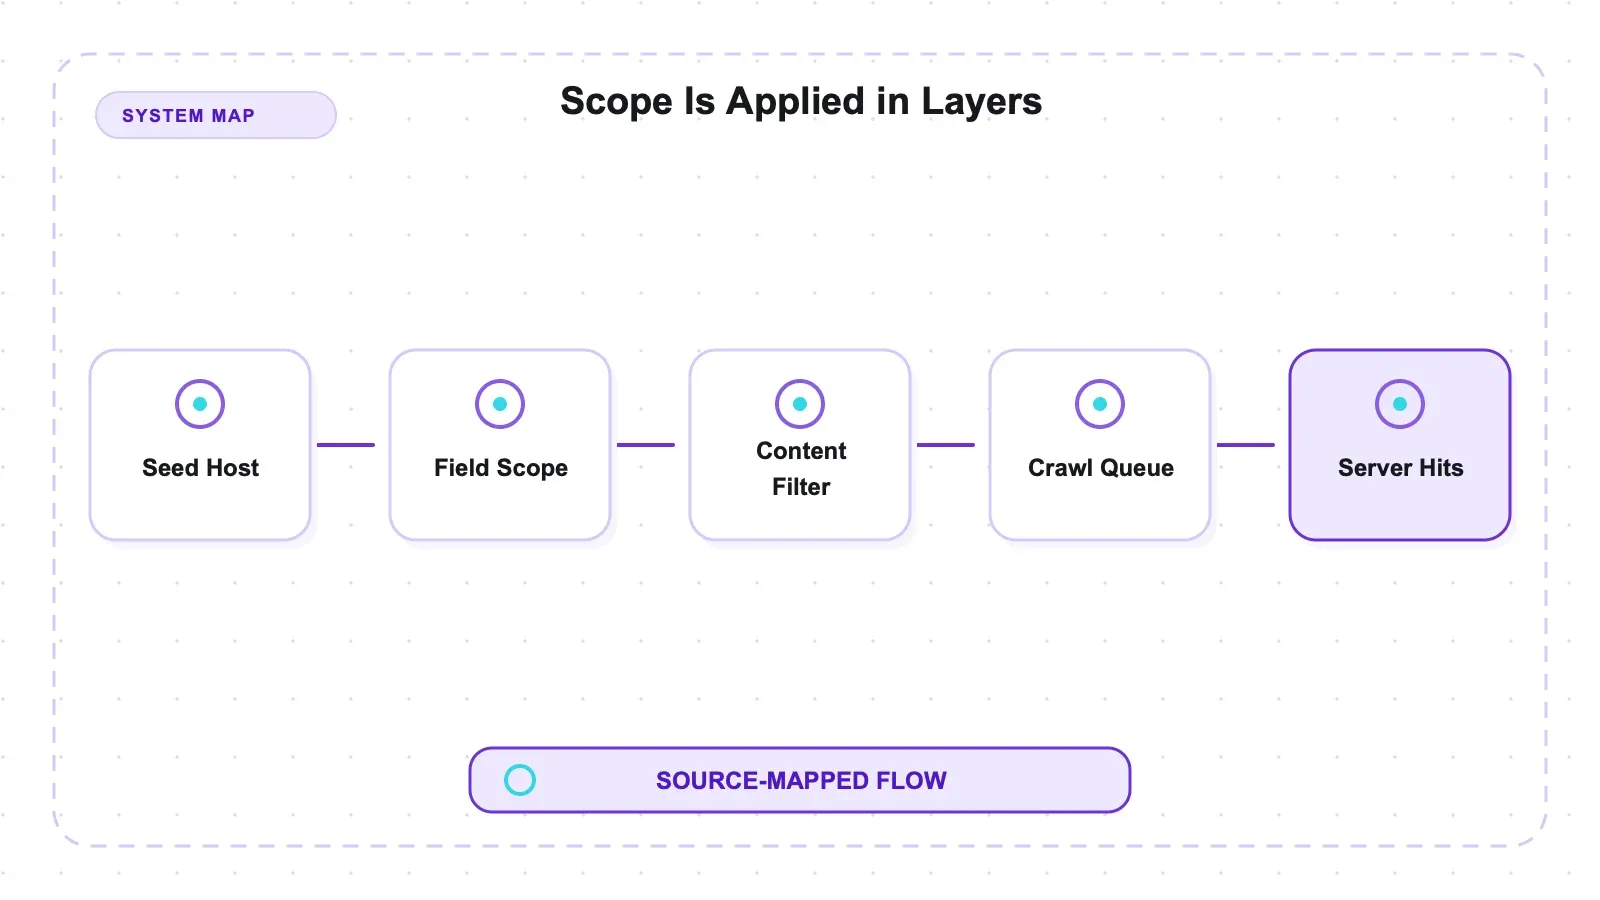
Pak je tu model scope, a to je část, kterou bych si zafixoval dřív, než něco zadáš do produkce.
| Přepínač | Co řídí | Hodnoty / výchozí stav |
|---|---|---|
-fs (field scope) | které hosty bere v úvahu | dn, rdn, fqdn nebo vlastní regex — výchozí je rdn |
-cs a -cos | URL regexy, které filtrují uvnitř daného field scope | — |
-kf | známé soubory: robots.txt a sitemap.xml | README uvádí, že potřebuje minimální hloubku 3 |
-d | hloubka | výchozí 3 |
-resume | pokračuje v přerušeném crawl | — |
Pořadí není kosmetika: rozhoduje o tom, jestli regex na hosta crawl rozšíří, nebo ho tiše vyprázdní.
Nastavení: jedna binárka, jedna hvězdička
Tři cesty instalace a jen jedna z nich chce toolchain:
| Způsob instalace | Co je potřeba |
|---|---|
Ze zdrojů: go install github.com/projectdiscovery/katana/cmd/katana@latest | Požadavek je Go 1.25 nebo novější |
| Předkompilované binárky na stránce release | žádný toolchain |
| Docker image | žádný toolchain |
Mně to skončilo v ~/go/bin/katana a při každém spuštění to hlásilo Current version: v1.6.1. Zatím klasický příjemný Go příběh: jeden soubor, žádný runtime.
Tou hvězdičkou je headless, kde je prohlížeč samostatná závislost vedle binárky:
Kde běží -headless | Co potřebuje |
|---|---|
| Můj počítač | Katana automaticky našla už nainstalovaný Chromium; verzi prohlížeče jsem si nezapsal a žádnou cestu k browseru jsem neposkytl |
| Holý server, podle vlastních Ubuntu instrukcí projektu | před headless je potřeba apt install google-chrome-stable |
| Cesta přes Docker | headless běží s -system-chrome |
Na holém serveru tahle pohoda mizí. Jakmile se do příkazu objeví -headless, plánujte kromě binárky i prohlížeč.
Ještě jedna drobnost, která se hodí, pokud to běží v CI: Katana při startu kontroluje verzi na GitHubu. -duc to vypíná. Na notebooku je to jen hluk; na air-gapped nebo rate-limited runneru je to síťová odbočka navíc, kterou jste si neobjednali. Moje časové testy používají -duc, aby čísla měřila crawl, ne telefonování domů.
Jak jsem to testoval
Tři třídy endpointů, vybrané záměrně tak, aby režimy oddělily. Všechno běží na lokálním testovacím serveru a ground truth byl sepsán předtím, než proběhl první crawl, takže recall měřím vůči pevně dané sadě, ne vůči tomu, co zrovna Katana vypsala.
- Třída A — prosté HTML.
/page/a,/page/b,/page/ca tříkrokový řetězec/depth/1 → /depth/2 → /depth/3. To by měl zvládnout každý crawler. - Třída B — literály v JS souboru.
/api/js-endpoint-7a/api/js-endpoint-8existují jen jako string literály v připojeném/static/app.js. Čitelné bez prohlížeče, pokud si někdo dá práci ten JS přečíst. - Třída C — pouze runtime-DOM. Jedna cesta poskládaná za běhu z fragmentů (
'endpoint' + (6 * 7)) a vložená do DOM skriptem. Řetězec/runtime-only/endpoint42se nikdy v žádném kuse bajtů, který server pošle, neobjeví souvisle — ani v HTML, ani ve zdroji JS. Odhalí ho až spuštění.
K tomu robots.txt, sitemap.xml se dvěma <loc> endpointy, které se nikde jinde nevyskytují, route vracející 500, mrtvý odkaz a odkaz mimo scope mířící na druhý server na jiném hostname.
Stejně důležitý je i samotný instrument: server počítá co se skutečně stáhlo, takže tvrzení o scope a resume stojí na pravdě o requestech, ne na vlastním stdoutu Katany. Raw běhy jsou uložené v benchmark repu, pokud si chceš ověřit moje počty.
Rozdíl v pokrytí, který nikdo nečísluje
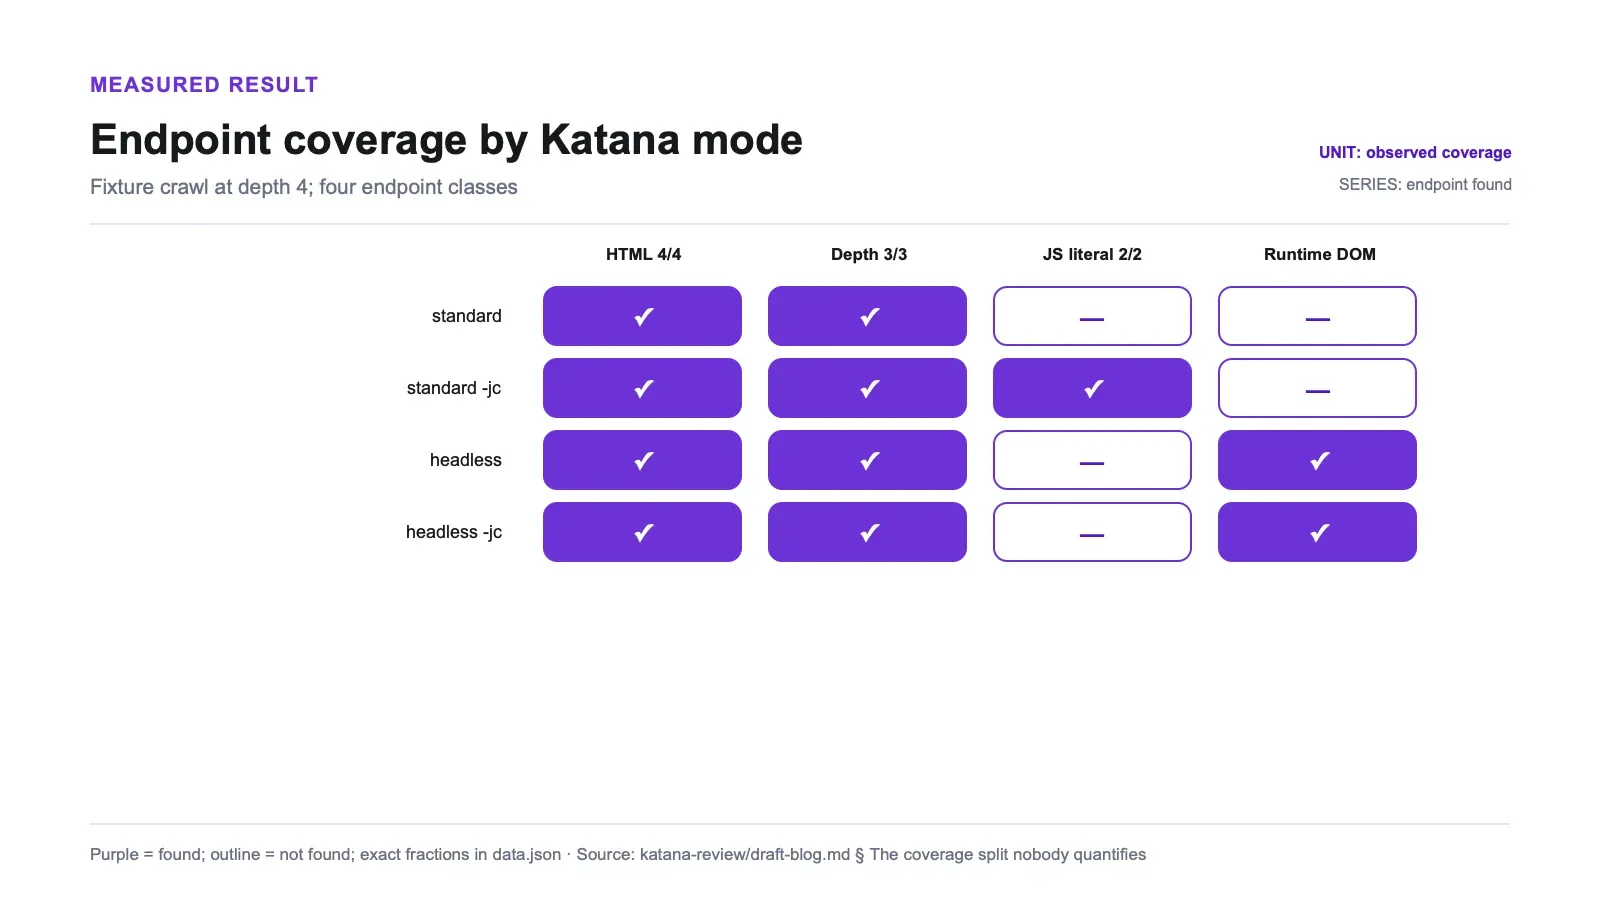
Matice režim × třída endpointu při -d 4:
| Režim | HTML odkazy (A) | Depth chain (A) | JS-soubor literály (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | nenalezeno |
standard -jc | 4/4 | 3/3 | 2/2 | nenalezeno |
-headless | 4/4 | 3/3 | 0/2 | nalezeno |
-headless -jc | 4/4 | 3/3 | 0/2 | nalezeno |
Když čteš poslední dva sloupce jako dvojici, problém vyskočí sám. Třídu B našla přesně jedna konfigurace: standardní režim s -jc. Třídu C našly přesně dvě: oba headless běhy. Neexistuje řádek, který by trefil oba sloupce zároveň. Celá matice je v discovery-summary.json, kde vypočtené pole headless_jc_covers_both má hodnotu false.
Praktický důsledek: tvrzení „prostě použij headless, budeš mít lepší pokrytí“ je pro tenhle test neúplné. Headless nepřidal třídu B nad rámec standardního výsledku; místo toho získal třídu C, ale třídu B minul. Úplné pokrytí všech záměrně vložených tříd v tomhle testu vyžadovalo dva crawly a merge:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
Řádek -headless -jc je ten, na který bych nejradši dostal odpověď upstream. Přidání JavaScript parseru k headless běhu nepřineslo nic nového — pořád 0/2 na třídě B, ve všech bězích, včetně čerstvé reprodukce. Popisuju chování, netvrdím, že jsem rozebral mechanismus; neinstrumentoval jsem interní logiku Katany, abych zjistil, proč browser path přestává přispívat JS-soubor literály. Ber to jako reprodukovatelné pozorování a dobrý GitHub issue, ne jako diagnózu. (Stojí za zmínku i to, že kombinace -hl -jc proběhla na v1.6.1 na macOS ARM čistě s návratovým kódem 0, což historicky ne vždy platilo.)
Oficiální dokumentace popisuje headless jako režim s lepším pokrytím, a tady to platilo pro runtime-rendered třídu. Ověřené doporučení ale tenhle split mezi source literály a runtime-DOM výslovně nepopisovalo, takže tu matici ber jako důvod testovat oba přístupy proti vlastním třídám endpointů, ne jako univerzální taxonomii.
Kolik headless stojí v reálném čase
Tři po sobě jdoucí běhy na režim na jinak nečinném stroji:
| Režim | p50 | min–max | průměr |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
To je poměr 5,1× s intervaly, které se ani zdaleka nepřekrývají — můj nejpomalejší standard běh (13.17s) pořád porazil můj nejrychlejší headless běh (66.78s) o víc než 53 sekund (cost-summary.json). To není šum měření.
Jediná poznámka k těm 13 sekundám: můj testovací web záměrně obsahuje route s 500 a mrtvý odkaz, a standardní režim si na obou odsedí defaultní -timeout 10 retry tail. Timeout jsem neladil tak, aby standardní režim vypadal líp, takže s jemněji nastaveným timeoutem by se mezera spíš zvětšila než zmenšila.
Poměr je lokální signál kapacity, ne predikce produkce. Reálné cíle se liší latencí, chybovostí, skriptovou prací a plánováním, zatímco tenhle testovací web obsahuje výchozí timeout tail. Naměřený rozdíl 5,1× použij k rozhodnutí, zda headless potřebuje vlastní rozpočet a vlastní podmnožinu cílů, a pak ten plán otestuj na reprezentativních autorizovaných hostech.
Scope držel, ale jeden přepínač tiše nic neudělal
Test scope používal dva servery: hlavní na 127.0.0.1 a druhý dostupný jako localhost na jiném portu, který obsluhoval cestu, jež existuje jen tam. Takže zásah do té cesty je důkaz, že host mimo scope byl skutečně stažen, ne jen vypsán.
| Konfigurace | Byl stažen host mimo scope? | Počet hitů na druhém serveru |
|---|---|---|
výchozí (-fs rdn) | ne | 0 |
-fs fqdn | ne | 0 |
-cs localhost | ne | 0 |
| `-fs '(127.0.0.1 | localhost)'` | ano |
Disciplína scope je dobrá zpráva: ve výchozím stavu Katana zůstala doma a k rozšíření bylo potřeba explicitní akce. To je správné chování pro nástroj, který se používá proti cizí infrastruktuře.
Zajímavý řádek je -cs localhost. Nezvětšil crawl na druhý host — a zároveň nevypsal vůbec žádné URL. Protože -cs filtruje uvnitř field scope, a field scope zůstal na primárním hostu, regex nenašel nic a crawl místo chyby vrátil prázdnou množinu. Pokud jsi někdy napsal regex pro crawl scope, který jmenoval host, jenž jsi chtěl zahrnout, a koukal na prázdný výstupní soubor, je tohle ten mechanismus (scope-summary.json). Přidat host znamená nastavit -fs. Zúžit uvnitř hostů, které už máš, znamená použít -cs/-cos.
Resume je hrubší, než přepínač naznačuje
README popisuje přepínač jako -resume string resume scan using resume.cfg, což zní jako soubor odložený v pracovním adresáři. Není to tak. U mě se checkpoint zapisoval do ~/.config/katana/resume-<xid>.cfg — změřeno, ne přečteno z dokumentace, protože dokumentace cestu neuvádí.
A hlavně je zajímavé, co v tom je. Soubor obsahoval mapu InFlightUrls s přesně jednou položkou: seed URL. Ne navštívenou množinu, ne frontier. Takže tohle se stalo, když jsem crawl po třech sekundách přerušil SIGINT a pak ho obnovil:
| Běh | Počet různých cest |
|---|---|
| Plný baseline crawl | 11 |
| Staženo před přerušením | 10 |
| Znovu staženo resume během obnovy | všech 11, včetně všech 10, které už byly hotové |
Resume došlo ke stejné finální sadě endpointů, takže nic není rozbité. Ale granularita checkpointu je na úrovni vstupního seedu, ne na úrovni jednotlivé URL — deduplikace v paměti se nikdy neukládá, takže obnova jednoho seedu ten seed znovu proleze od začátku (resume-summary.json). Pokud Katanu krmíš seznamem 500 hostů, resume by ti mělo ušetřit hosty, které už doběhly celé; tohle chování pro víc seedů plyne z uloženého stavu, ale já měřil jen případ s jedním seedem. Pokud se noříš do jednoho obrovského webu, resume ti kupuje správnost, ne čas.
Known files: nejdřív požádá, pak pustí k vodě
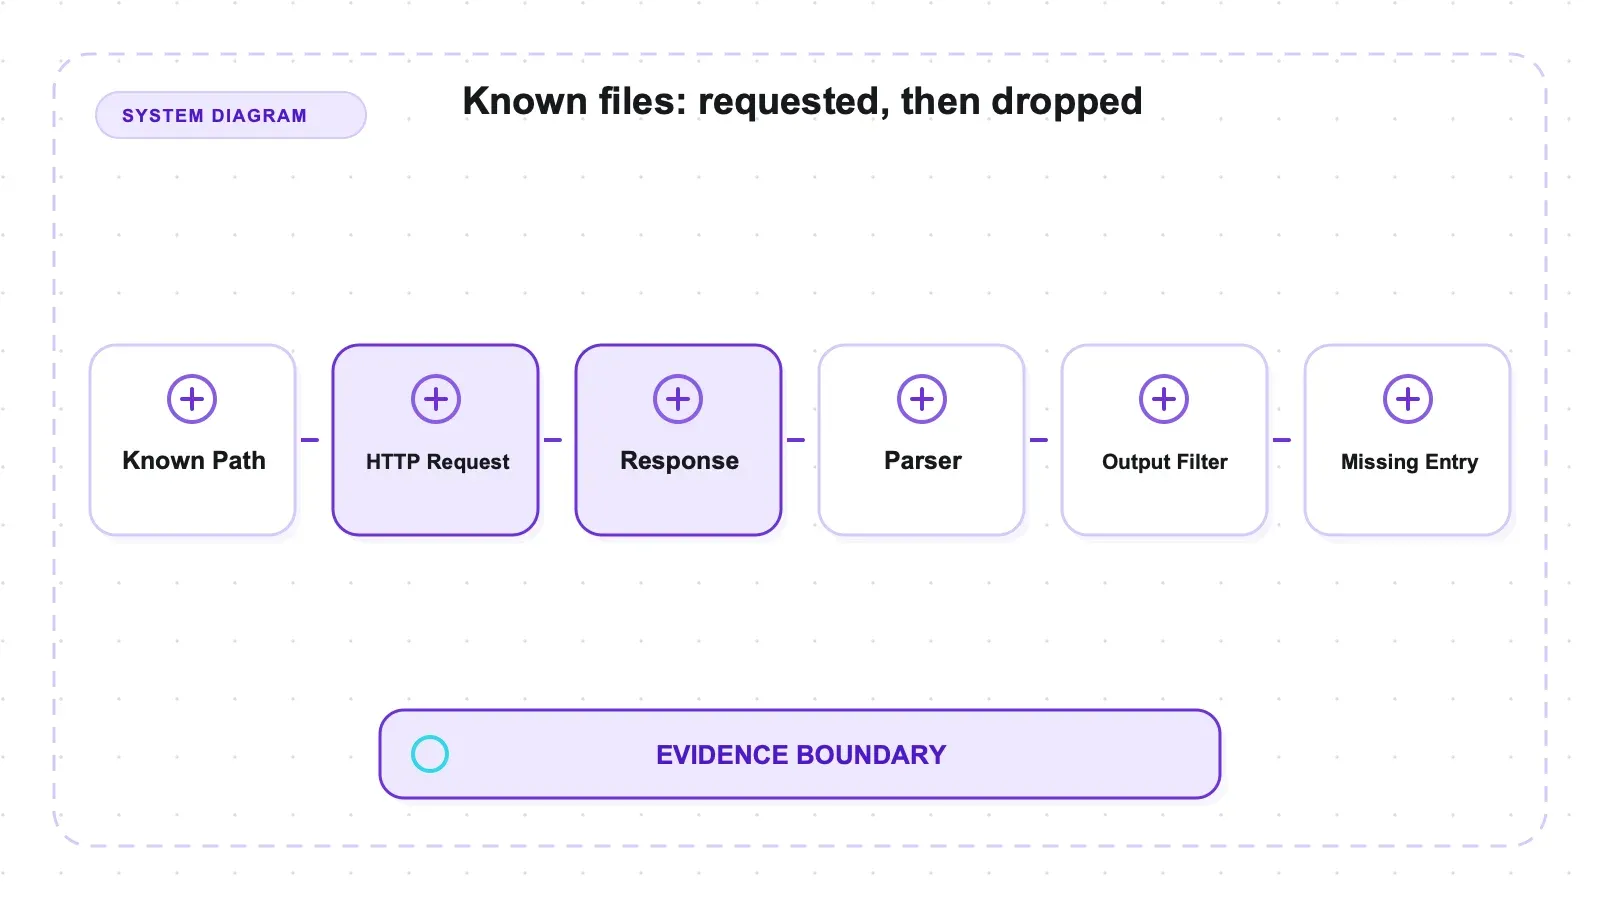
-kf all -d 3 si skutečně vyžádal oba soubory — robots.txt i sitemap.xml se objevily v logu serverových hitů — a pak získal 0 z 2 endpointů uvedených v <loc> elementech té sitemap. Recall 0.0.
Než jsem to označil za limit, zkusil jsem, jestli to není moje chyba. Všechna variantní nastavení dopadla stejně:
| Vyzkoušená varianta | Obnovené endpointy z sitemap <loc> |
|---|---|
-kf all | 0/2, recall 0.0 |
-kf sitemapxml | 0/2, recall 0.0 |
-kf robotstxt | 0/2, recall 0.0 |
| depth 3 | 0/2, recall 0.0 |
| depth 4 | 0/2, recall 0.0 |
| depth 5 | 0/2, recall 0.0 |
s přidaným -jc | 0/2, recall 0.0 |
seed přímo na /sitemap.xml | 0/2, recall 0.0 |
Dokumentovaná podmínka — použít -kf a jít alespoň tři úrovně hluboko — byla pokaždé splněna. Tohle není příběh o chybějícím přepínači.
Užitečné rozhodnutí je předem: na tomhle IP-literal testovacím webu nepředpokládej, že když si vyžádáš známé soubory, jejich <loc> URL se automaticky přidají do crawl. Ověř recall, nebo si ty URL vytáhni a seedař je sám.
Cesta v kódu v1.6.1 odpovídá tomu, co jsem pozoroval, ale během běhu jsem ji neinstrumentoval. V sitemapxml.go ve v1.6.1 NewNavigationRequestURLFromResponse vytváří navigační požadavky z <loc> bez naplněného RootHostname. Požadavek pak projde do ValidateScope; v scope.go ve v1.6.1 může IP-literal větev porovnat URL host s prázdným rootem a odmítnout ji. Vlastní příkaz -fs '(127.0.0.1|localhost)' prošel v samostatném scope testu jinou větví scope, takže jde o zdrojově předpovězené záchranné řešení, ne o změřený workaround pro -kf. Potvrzení zablokovalo občasné navazování spojení v klientovi pro známé soubory na tomhle hostu; hlášený výsledek tedy zůstává 0/2.
Co bych v produkci dělal já, dokud to někdo nepotvrdí: stáhnout sitemap sám, vytáhnout z ní <loc> URL a předat je Katane jako seznam seedů. Dvě řádky shellu, bez scope validace.
Jedna věc se chovala přesně podle očekávání a stojí za jednu větu: route s 500 a mrtvý odkaz byly staženy, zalogovány a crawler je bez problémů přeskočil. Každý bezprohlížečový běh skončil s návratovým kódem 0. Crawler, který spadne na první špatnou odpověď, je k ničemu bez dozoru — a Katana nepadá.
Kontrola pokrytí před nasazením, vázaná na konkrétní cíl
Matice z testu je nejužitečnější jako šablona pro tvoje vlastní autorizované cíle. Před spuštěním Katany si definuj třídy endpointů: prosté odkazy, literály v připojených skriptech, cesty vytvořené až po spuštění a položky ze známých souborů jsou čtyři rozumné výchozí koše. Pro každou třídu si ponech malý ground-truth vzorek. Bez předchozího seznamu může větší stdout soubor vypadat jako lepší pokrytí, i když se nějaká třída ve skutečnosti ztratila.
Nejprve měř browserless a headless jako samostatné běhy. Ulož přesné příkazy, verzi Katany, build prohlížeče, návratové kódy a výstupy. Endpointové množiny normalizuj a diffuj, nesrovnávej jen počty řádků. Pokud standardní -jc na tvém vzorku nepřidá nic unikátního, může stačit jen headless; pokud se množiny rozcházejí jako tady, drž oba průchody odděleně a merge udělej až po sběru. Není dobré předpokládat, že přidání obou přepínačů do jednoho příkazu se rovná sjednocení, dokud to neprokáže diff podle konkrétního cíle.
Scope validuj důkazy mimo výstup Katany. Dej na host, který má zůstat vyloučený, canary URL a zkontroluj serverový request log. Pokud se crawl má rozšířit, otestuj i zamýšlený druhý host. Spuštění -cs localhost tady vyprodukovalo prázdný výstup, protože content-scope filtrování nerozšířilo field scope; vlastní volání -fs '(127.0.0.1|localhost)' se na druhý server skutečně připojilo. Zapsat přesný regulární výraz je důležité, protože změna jednoho znaku může změnit regex, nejen jeho formát.
Přerušení a známé soubory testuj odděleně od recallu z objevování. U resume přeruš reprezentativní seed po několika stránkách, ulož vygenerovanou cestu ke checkpointu a spočítej, kolik hotových URL se stáhne znovu. U -kf ověř jak to, že robots/sitemap byly požadovány, tak to, že záměrně vložené <loc> URL se opravdu naplánovaly ke crawl. To jsou dvě různé věci. V tomhle testu se soubory stáhly, ale dvě sitemapové endpointy chyběly, takže bylo potřeba mít jak request logy, tak endpoint output, aby byla hranice vidět.
Nakonec si stanov lokální baseline ceny pomocí po sobě jdoucích běhů na jinak nečinném stroji a pak to zopakuj na reprezentativních hostech. Uchovávej minimum, maximum i medián, ne jen násobek. Hodnota 5,1× tady zahrnuje chování tohohle testovacího webu při chybách a timeoutech; říká ti, že headless si zaslouží vlastní rozpočet, ne to, jak dlouho bude trvat inventarizace v produkci.
Klady a zápory
Klady:
- Perfektní recall na běžném HTML ve všech režimech — 4/4 odkazů a celý depth chain 3/3, bez nutnosti konfigurace.
-jcskutečně funguje bez prohlížeče: 2/2 endpointů obnovených ze string literálů v připojeném JS souboru, bez nákladů na browser.-headlessje jediný režim, který našel endpoint sestavený až za běhu — třídu, která je ze zdrojového parsování z principu neviditelná.- Výchozí scope je konzervativní. Host mimo scope se nikdy nestáhl při defaultu,
-fs fqdnani-cs. - Jedna Go binárka, licence MIT, předkompilované buildy i Docker image, I/O ve stylu pipeline.
- Odolnost vůči chybám: 500 ani mrtvé odkazy crawl nezastaví.
Zápory:
- Žádné jediné spuštění nepokrylo současně JS-soubor a runtime-DOM endpointy. Pro plné pokrytí jsou potřeba dva běhy a merge.
-jcpod-headlessnepřidalo nic — 0/2 na třídě B ve všech headless bězích.- Headless stojí 5,1× víc času na wall clock (p50 66.82s vs 13.08s, bez překrývajících se intervalů).
-resumeznovu prochází hotové stránky v rámci jednoho seedu. Obnoví endpoint set, ne tvůj ušetřený čas.- Known files si vyžádaly robots.txt a sitemap.xml, ale z IP cíle získaly 0/2 sitemap
<loc>endpointů. - Headless si potichu žádá Chromium na stroji; příběh o „jedné binárce“ končí u browseru.
- Jen discovery. Žádná strukturovaná extrakce, žádná konverze obsahu, žádné schéma polí.
Netestováno, a proto mimo rozsah těchto čísel: -jsluice, samostatný test cutoffu hloubky na -d 1/-d 2, multi-seed resume, automatické vyplňování formulářů a jakýkoli skutečný JavaScript-heavy nebo chráněný produkční web. Všechna čísla pocházejí z jednoho stroje (macOS arm64) proti lokálnímu testovacímu webu.
Pro koho to je a kdo by to měl přeskočit
Pokud je tvým úkolem vytvořit inventory endpointů pro infrastrukturu, na kterou máš oprávnění sáhnout, Katana má správný tvar pipeline: STDIN/STDOUT, distribuovatelnou binárku a browserless i browser-backed režimy. Dvoufázový merge byl pro třídy vložené do testu nutný; jestli tvoje cíle potřebují oba průchody, je třeba zjistit na reprezentativních stránkách.
Přeskoč to, pokud chceš data místo adres. Katana ti nikdy nedá tabulku produktů; dá ti URL, kde ty produkty možná leží, a o extrakci se postará něco jiného. Přeskoč to i tehdy, pokud potřebuješ, aby jeden příkaz byl kompletní — dvoufázový merge je v pipeline v pořádku, ale u promptu otravný. A pokud tvoje enumerace stojí na sitemap <loc> endpointů při cílení na IP, ověř si, co vlastně dostáváš, než výstupu uvěříš, protože na mém testovacím webu tudy neprošlo nic.
Alternativy a hranice extrakce
Katana je zdarma, s licencí MIT a self-hosted. Discovery, volbu režimu, nasazení prohlížeče i merge výsledků nechává na tvé straně hranice.
V open source se hodí srovnávat spíš podle úkolu než podle jazyka. Colly je další Go varianta, ale je to knihovna, kterou si sestavíš s vlastními callbacky, a JavaScript vůbec nerespektuje. Crawl4AI běží v reálném prohlížeči a pro LLM pipeline produkuje Markdown, což je úplně jiný výstup. Pokud zvažuješ víc těchto nástrojů najednou, naše shrnutí open-source scraperů dává kategorie pěkně vedle sebe.
Disclosure: Thunderbit je produkt vydavatele a v tomhle testu Katany nebyl zkoušen. Patří do spravované extrakce downstream, kde se stránky převádějí na text nebo strukturované záznamy, místo aby se pouze vyjmenoval endpointový povrch autorizovaného cíle. Workflow může používat obě kategorie, ale tahle recenze přináší důkazy jen o discovery chování Katany.
Vyzkoušet Thunderbit pro extrakci webových dat
Verdikt
Použij Katanu tehdy, když je výsledkem seznam endpointů pro cíle, které máš oprávnění crawl, a když můžeš na těchto cílech ověřit pokrytí režimů. V tomhle testu standardní -jc získalo záměrně vložené JavaScriptové literály, zatímco headless získal endpoint vložený do runtime DOM; testované bezprohlížečové režimy Katany ten runtime path nezachytily. Výchozí scope navíc nenechal stáhnout druhý host a bezprohlížečové běhy pokračovaly i přes 500 a mrtvý odkaz.
Provozní háčky jsou jasné: pro smíšené třídy endpointů může být potřeba dvoufázový merge, headless trval zhruba pětkrát déle na lokálním wall time, single-seed resume znovu stáhlo hotové cesty a known-files recall byl proti IP cíli 0/2. To jsou výsledky testu v1.6.1 na testovacím webu, ne záruka pro každý web. Ale stačí k tomu, aby definovaly kontroly, které by měl produkční evaluation zopakovat.
Vyzkoušet Thunderbit pro extrakci webových dat Get Started Free
FAQ
Kam Katana ukládá resume soubor a přeskočí při obnovení stránky, které už jsem prolezl?
Checkpoint skončil v ~/.config/katana/resume-<xid>.cfg, ne v resume.cfg v pracovním adresáři, jak napovídá nápověda přepínače. A ne, hotové stránky nepřeskakuje: soubor ukládá jen in-flight seed URL, takže obnovený crawl s jedním seedem znovu stáhl všech 11 baseline cest včetně 10, které už byly hotové. Dostaneš stejnou finální sadu endpointů, jen ne ušetřený čas.
Proč mi -kf all stáhlo sitemap.xml, ale necrawlovalo URL uvnitř?
Pro IP target je výsledek konzistentní se scope-validací, ne s chybou v přepínači. V kódu v1.6.1 Katana parser sitemap vytváří každý <loc> request bez předání root hostname dál, a DNS-scope check pro IP-literal hosty může takovou URL odmítnout; během běhu jsem ten mechanismus neinstrumentoval. Ve všech variantách přepínačů, hloubek a seedů, které jsem zkusil, zůstalo recall na 0. Vlastní regex hosta v -fs prochází jinou validační větví a je to řešení, které predikuje zdrojový kód — na mém stroji jsem to ale nedokázal potvrdit proti -kf, takže to ber jako netestované. Dnes bych důvěřoval tomu, že si <loc> URL vytáhnu sám a seednu jimi Katanu.
Co mám uvádět při reportování testu pokrytí Katany?
Zapiš přesnou verzi Katany a příkaz, včetně regexu -fs doslova po znacích; definuj třídy endpointů před spuštěním; ukládej server-side hit logy vedle stdout; a odděluj změřené chování od hypotéz založených na zdrojáku. U headless běhů uveď i verzi browseru — tenhle test ji neuváděl, což omezuje reprodukovatelnost.
Mám použít -jc, -headless, nebo obojí?
Vyber podle tříd endpointů, které potřebuješ. V tomhle testu standardní -jc našlo literály uložené v JavaScript souboru, zatímco headless našel endpoint vložený do runtime DOM. Ani jeden režim nepokryl obě třídy sám, takže dvoufázový běh následovaný deduplikací byl pro smíšené cíle obhajitelnou volbou.
Zastaví crawl jedna chybná URL? V tomhle kontrolovaném běhu ne. Katana pokračovala i po odpovědi 500 a po mrtvém odkazu a pořád vrátila ostatní dosažitelné cesty. To ale nenahrazuje produkční evidenci chyb: veď logy neúspěšných requestů a nastav přijatelnou míru selhání, aby se částečně úspěšný crawl nepletl s kompletním pokrytím.




