
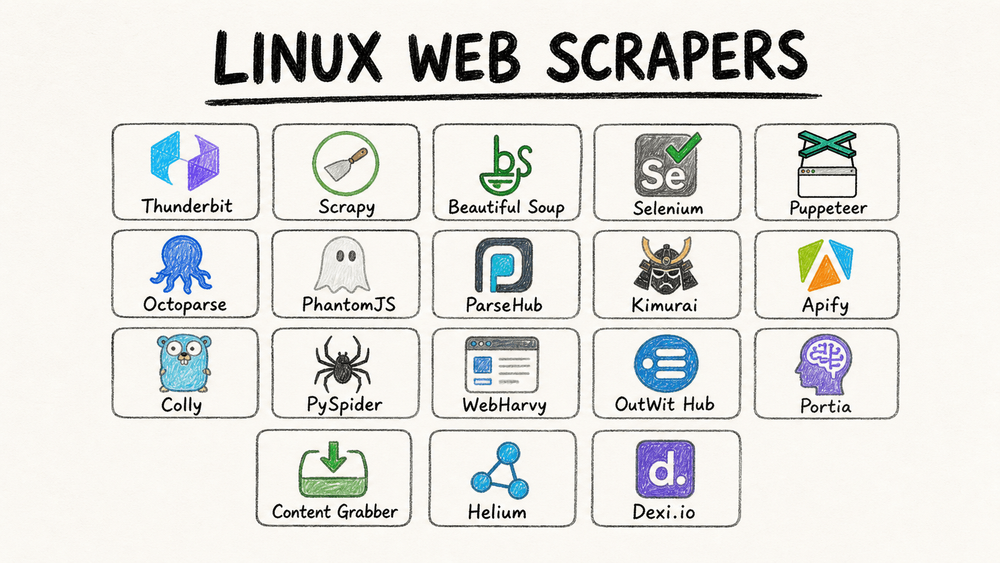
Web je nabitý daty a řekněme si to na rovinu — nikdo nemá čas ručně kopírovat tisíce produktových nabídek nebo cenových stránek konkurence. Pokud běžíte na Linuxu (stejně jako já při většině automatizací a vývojářské práce), víte, že tahle platforma je pro datově řízené týmy naprostý tahoun. Ve skutečnosti systémy z rodiny Unix pohánějí 91,9 % webů, u nichž je operační systém známý, přičemž Linux je zdaleka nejrozšířenější identifikovanou variantou. Háček je ale v tom, že najít správný web scraper pro Linux, který fakt sedne vašemu workflow — ať už jste netechnický byznysový uživatel, nebo ostřílený programátor — může připomínat hledání jehly v kupce sena.
Proto jsem dal dohromady tenhle podrobný přehled 18 nejlepších Linux web scraping nástrojů pro rok 2026. Od AI řešení bez kódu, jako je Thunderbit (ano, ten, který jsme postavili já a můj tým), až po klasické vývojářské frameworky jako Scrapy nebo Beautiful Soup — tenhle seznam vám ušetří spoustu času při výběru nejlepšího Linux web scrapera pro vaše potřeby, bez nekonečného zkoušení a zklamání.
Proč jsou Linux web scraping nástroje důležité pro byznysové uživatele
Než si vyberete nástroj, ušetřete si ruční kopírování Thunderbit běží v Chromu na vašem Linuxu — žádné balíčky, žádné ovladače, jen přehledná tabulka na 1 kliknutí. Get Started Free
Pojďme si říct pravdu: ruční sběr dat je zabiják produktivity. Studie ukazují, že týmy spoléhající na kopírování a vkládání ztrácejí každý týden hodiny a chybovost se blíží 5 % — což je recept na drahé omyly a promarněné příležitosti (Thunderbit Blog). Linux díky své stabilitě, bezpečnosti a flexibilitě patří mezi platformy, na kterých dává smysl provozovat scrapery běžící 24/7 — ať už na desktopu, serveru nebo v cloudu.
Typické firemní scénáře pro Linux web scraping nástroje:
- Generování leadů: Obchodní týmy stahují z adresářů, sociálních sítí nebo recenzních webů čerstvé kontakty a vyhýbají se ruční dřině (Thunderbit Blog).
- Sledování cen: E-commerce týmy automaticky sbírají ceny konkurence a skladovou dostupnost, aby měly vlastní cenotvorbu pořád přesnou a aktuální.
- Analýza konkurence: Marketing a provoz sledují produktové novinky, recenze a SEO klíčová slova — žádné další „střílení naslepo“.
- Market intelligence: Analytici agregují zprávy, fóra a data ze sociálních sítí, aby v reálném čase odhalovali trendy.
- Automatizace workflow: Některé nástroje (hlavně ty s AI) dokážou automatizovat i webové procesy, třeba vyplňování formulářů nebo práci s dashboardy, přímo z vašeho Linuxu.
A to nejlepší? Správný Linux web scraping nástroj může otevřít cestu i netechnickým uživatelům — nejen programátorům — aby mohli s webovými daty pracovat chytřeji a rychleji při rozhodování.
Jak jsme vybírali nejlepší web scraper pro Linux
Ne všechny scrapery jsou stejné, zvlášť na Linuxu. Tady jsou kritéria, podle kterých jsem vybíral:
- Kompatibilita s Linuxem: Každý nástroj tady běží nativně na Linuxu, přes prohlížeč nebo s jednoduchým workaroundem (například Wine či cloudový přístup).
- Snadnost použití: Od AI promptů v přirozeném jazyce až po vizuální rozhraní typu point-and-click jsem upřednostnil nástroje, které dovolí i necoderům rychle získat výsledky — ale nezapomněl jsem ani na power users, kteří chtějí plnou kontrolu.
- Síla extrakce dat: Zvládne dynamický obsah, stránkování, podstránky a různé datové typy? Udrží se i proti anti-scraping trikům?
- Škálovatelnost a automatizace: Plánování úloh, cloud scraping, distribuovaný crawling — to jsou nutnosti pro seriózní datové projekty.
- Integrace a export: CSV, Excel, Google Sheets, API — pokud data nedostanete ven, k čemu to celé je?
- Cena a licence: Zdarma, open-source nebo placené — od sólo zakladatelů až po enterprise týmy si vybere každý.
- Komunita a podpora: Aktivní uživatelská základna, dobrá dokumentace a svižná podpora dělají velký rozdíl, když narazíte na problém.
Zahrnul jsem také reálnou zpětnou vazbu uživatelů, recenze z oboru i vlastní praktické zkušenosti s těmito nástroji. Pojďme se do seznamu pustit.
1. Thunderbit
 Thunderbit je moje první volba pro byznysové uživatele, kteří chtějí web scraper pro Linux, který se používá fakt snadno. Jako AI poháněné rozšíření pro Chrome běží na Linuxu bez problémů (stačí otevřít Chrome nebo Chromium) a umožní vám extrahovat data z libovolného webu na jedno kliknutí.
V čem Thunderbit vyniká:
- Prompty v přirozeném jazyce: Stačí popsat, co chcete („Extrahuj z této stránky všechny názvy produktů a ceny“) a AI Thunderbitu se postará o zbytek.
- AI návrh polí: Jedno kliknutí a Thunderbit projde stránku, navrhne sloupce i datové typy — bez ručního vybírání polí.
- Scraping podstránek a stránkování: Potřebujete víc detailů? Thunderbit může navštívit každou podstránku (třeba detail produktu) a automaticky obohatit vaši tabulku.
- Cloud nebo lokální scraping: V cloudu zvládne až 50 stránek najednou, nebo můžete použít režim v prohlížeči pro weby, které vyžadují přihlášení.
- Okamžitý export: Jedním kliknutím do Excelu, Google Sheets, Airtable, Notion, CSV nebo JSON — vždy zdarma.
- Bonusové nástroje: Extrakce e-mailů, telefonních čísel a obrázků na jedno kliknutí. AI autofill dokáže dokonce automatizovat vyplňování formulářů.
Cena: Bezplatný tarif (6 stránek/měsíc), placené plány začínají na 15 USD/měsíc za 500 řádků (Thunderbit Pricing). Uživatelé oceňují „nulovou křivku učení“ a to, jak „mění hodiny práce v minuty“ (Product Hunt Reviews). U větších úloh možná budete muset práci rozdělit na menší dávky, ale pro většinu byznysových scénářů je to obrovská úspora času.
Kompatibilita s Linuxem: 100 %. Stačí Chrome/Chromium na Linux desktopu nebo serveru.
Nejlepší pro: Netechnické byznysové uživatele (sales, marketing, operations), kteří chtějí co nejrychlejší a nejsnazší start.
Vyzkoušejte Thunderbit zdarma na Linuxu Běží v Chromu na jakémkoli Linuxu — žádné balíčky ke kompilaci, žádné ovladače k instalaci, extrakce na 1 kliknutí. Get Started Free
2. Scrapy
 Scrapy je zlatý standard pro Python vývojáře, kteří chtějí flexibilní a škálovatelný web scraper pro Linux. Je open-source, extrémně rychlý (asynchronní crawling) a zvládne vše od jednoduchých scrapů až po obří distribuované sběry.
Klíčové funkce:
- Asynchronní, vysokorychlostní crawling — ideální pro scraping tisíců stránek.
- Vysoce rozšiřitelný: pluginy pro proxy, CAPTCHA a další.
- Integrace s Python datovým stackem: výstup do JSON, CSV, databází nebo pandas.
- Zvládá cookies, sessions a automatické throttlingy.
Cena: 100% zdarma a open-source.
Kompatibilita s Linuxem: Nativní (instalace přes pip). Skvěle běží na serverech i v kontejnerech.
Nejlepší pro: Vývojáře budující vlastní scrapeři ve velkém měřítku.
Poznámka: Pro netechnické uživatele je tu vyšší křivka učení, ale pokud umíte Python, Scrapy se poráží těžko.
3. Beautiful Soup
 Beautiful Soup je lehká Python knihovna pro parsování HTML a XML. Je to oblíbená volba pro rychlé, jednoduché scrapingy nebo čištění nepořádných webových stránek.
Klíčové funkce:
- Jednoduché a přehledné API — skvělé pro začátečníky.
- Dobře funguje s requests při stahování stránek.
- Bez problémů si poradí s rozbitým HTML.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: 100 % (čistý Python).
Nejlepší pro: Vývojáře a data science týmy pro malé až středně velké scrapingové nebo parsovací úlohy.
Omezení: Nezvládá JavaScript ani dynamický obsah — pokud to potřebujete, zkombinujte ho se Selenium nebo Puppeteer.
4. Selenium
 Selenium je klasický framework pro automatizaci prohlížeče. Umožňuje ovládat Chrome, Firefox nebo jiné prohlížeče pro scraping dynamických webů s JavaScriptem.
Klíčové funkce:
- Automatizuje reálné prohlížeče — umí se přihlásit, klikat, scrollovat a interagovat jako člověk.
- Podpora pro Python, Java, C# a další.
- Headless režim pro běh na Linux serverech.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Plná podpora (stačí nainstalovat správný browser driver).
Nejlepší pro: QA inženýry, scraping vývojáře a kohokoli, kdo potřebuje simulovat chování uživatele.
Poznámka: Je náročnější na zdroje a pomalejší než čistě HTTP scrapery, ale někdy je to jediná cesta k potřebným datům.
5. Puppeteer
 Puppeteer je Node.js knihovna od Googlu pro ovládání headless Chrome/Chromium. Je podobný Selenium, ale má moderní JavaScript API a úzkou integraci s funkcemi Chromu.
Klíčové funkce:
- Spouští JavaScript, zvládá dynamický obsah a pořizuje screenshoty.
- Rychlý, stabilní a pro Node.js vývojáře velmi přehledný.
- Odchytává síťové požadavky a blokuje nežádoucí zdroje.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Instaluje Chromium automaticky; ve výchozím nastavení běží headless.
Nejlepší pro: Vývojáře scrapující moderní webové aplikace nebo single-page weby.
6. Octoparse
 Octoparse je no-code web scraper s rozhraním typu drag-and-drop a spoustou předpřipravených šablon. Desktopová aplikace je sice jen pro Windows/Mac, ale uživatelé Linuxu mohou Octoparse používat přes cloudovou platformu v prohlížeči nebo spustit Windows verzi přes Wine.
Klíčové funkce:
- Více než 100 hotových scraping šablon pro weby jako Amazon, eBay, Zillow a další.
- Vizuální návrhář workflow — klikáním vytvoříte vlastního scrapera.
- Cloud scraping a plánování úloh — servery Octoparse udělají těžkou práci.
- Export do Excelu, CSV, JSON a databází.
Cena: Bezplatný tarif (10 úloh, cca 50 tisíc řádků/měsíc). Placené plány začínají na 69 USD/měsíc u Standard plánu (účtováno ročně); Professional stojí 249 USD/měsíc. (Octoparse Pricing)
Kompatibilita s Linuxem: Cloud/web přístup; desktopová aplikace přes Wine.
Nejlepší pro: Necodery, kteří rychle potřebují data z e-commerce nebo marketplace platforem.
7. PhantomJS
 PhantomJS je headless WebKit prohlížeč, který býval oblíbenou volbou pro lehkou automatizaci prohlížeče. Dnes je ale zastaralý, i když na Linuxu stále funguje pro starší nebo jednodušší úlohy.
Klíčové funkce:
- Skriptování v JavaScriptu.
- Zvládá běžný JavaScript a umí pořizovat screenshoty/PDF.
- Bez GUI.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Nativní binárka.
Nejlepší pro: Legacy projekty nebo prostředí, kde nelze instalovat Chrome.
Upozornění: Oficiálně byl označen za deprecated v roce 2017 a vývoj se zastavil v březnu 2018; poslední vydání bylo v2.1.1. Žádné bezpečnostní záplaty, žádný moderní JS engine a na většině současných webů už nefunguje správně. Pro nové projekty raději použijte Puppeteer nebo Playwright. Zmiňuju ho tady proto, že se pořád objevuje ve starších Linux scraping stackech, které můžete zdědit.
8. ParseHub
 ParseHub je vizuální web scraper napříč platformami s nativní Linux aplikací. Je skvělý pro necodery, kteří potřebují scrapovat složité a dynamické weby.
Klíčové funkce:
- Rozhraní typu point-and-click — vybíráte prvky a workflow stavíte vizuálně.
- Zvládá dynamický obsah, mapy, nekonečné scrollování a další.
- Cloudové spuštění a plánování úloh.
- Export do CSV, JSON nebo přes API.
Cena: Bezplatný plán (5 projektů), placené plány od 189 USD/měsíc.
Kompatibilita s Linuxem: Nativní aplikace pro Linux, Windows i Mac.
Nejlepší pro: Analytiky a semi-technické uživatele, kteří chtějí kontrolu bez psaní kódu.
9. Kimurai
 Kimurai je Ruby framework pro web scraping, který nativně podporuje Linux. Je to v podstatě Scrapy pro Ruby vývojáře.
Klíčové funkce:
- Podpora více prohlížečů: Headless Chrome, Firefox, PhantomJS nebo čisté HTTP.
- Asynchronní zpracování pro vysokou souběžnost.
- Čisté Ruby DSL pro psaní spiderů.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: 100 % (Ruby).
Nejlepší pro: Ruby vývojáře nebo Rails týmy, které potřebují vlastní scraping ve vysoké souběžnosti.
10. Apify
 Apify je cloudová platforma pro web scraping s open-source SDK a marketplace hotových „actorů“. Scrapery můžete spouštět na svém Linux stroji nebo v cloudu.
Klíčové funkce:
- SDK pro Node.js, Python a další.
- Marketplace předpřipravených scraperů.
- Cloudové spuštění, plánování a integrace přes API.
Cena: Bezplatný tarif, cloudové použití podle spotřeby.
Kompatibilita s Linuxem: CLI/SDK běží na Linuxu; cloudová platforma je dostupná přes prohlížeč.
Nejlepší pro: Vývojáře, kteří chtějí kombinaci vlastního kódu a hotové cloudové infrastruktury.
11. Colly
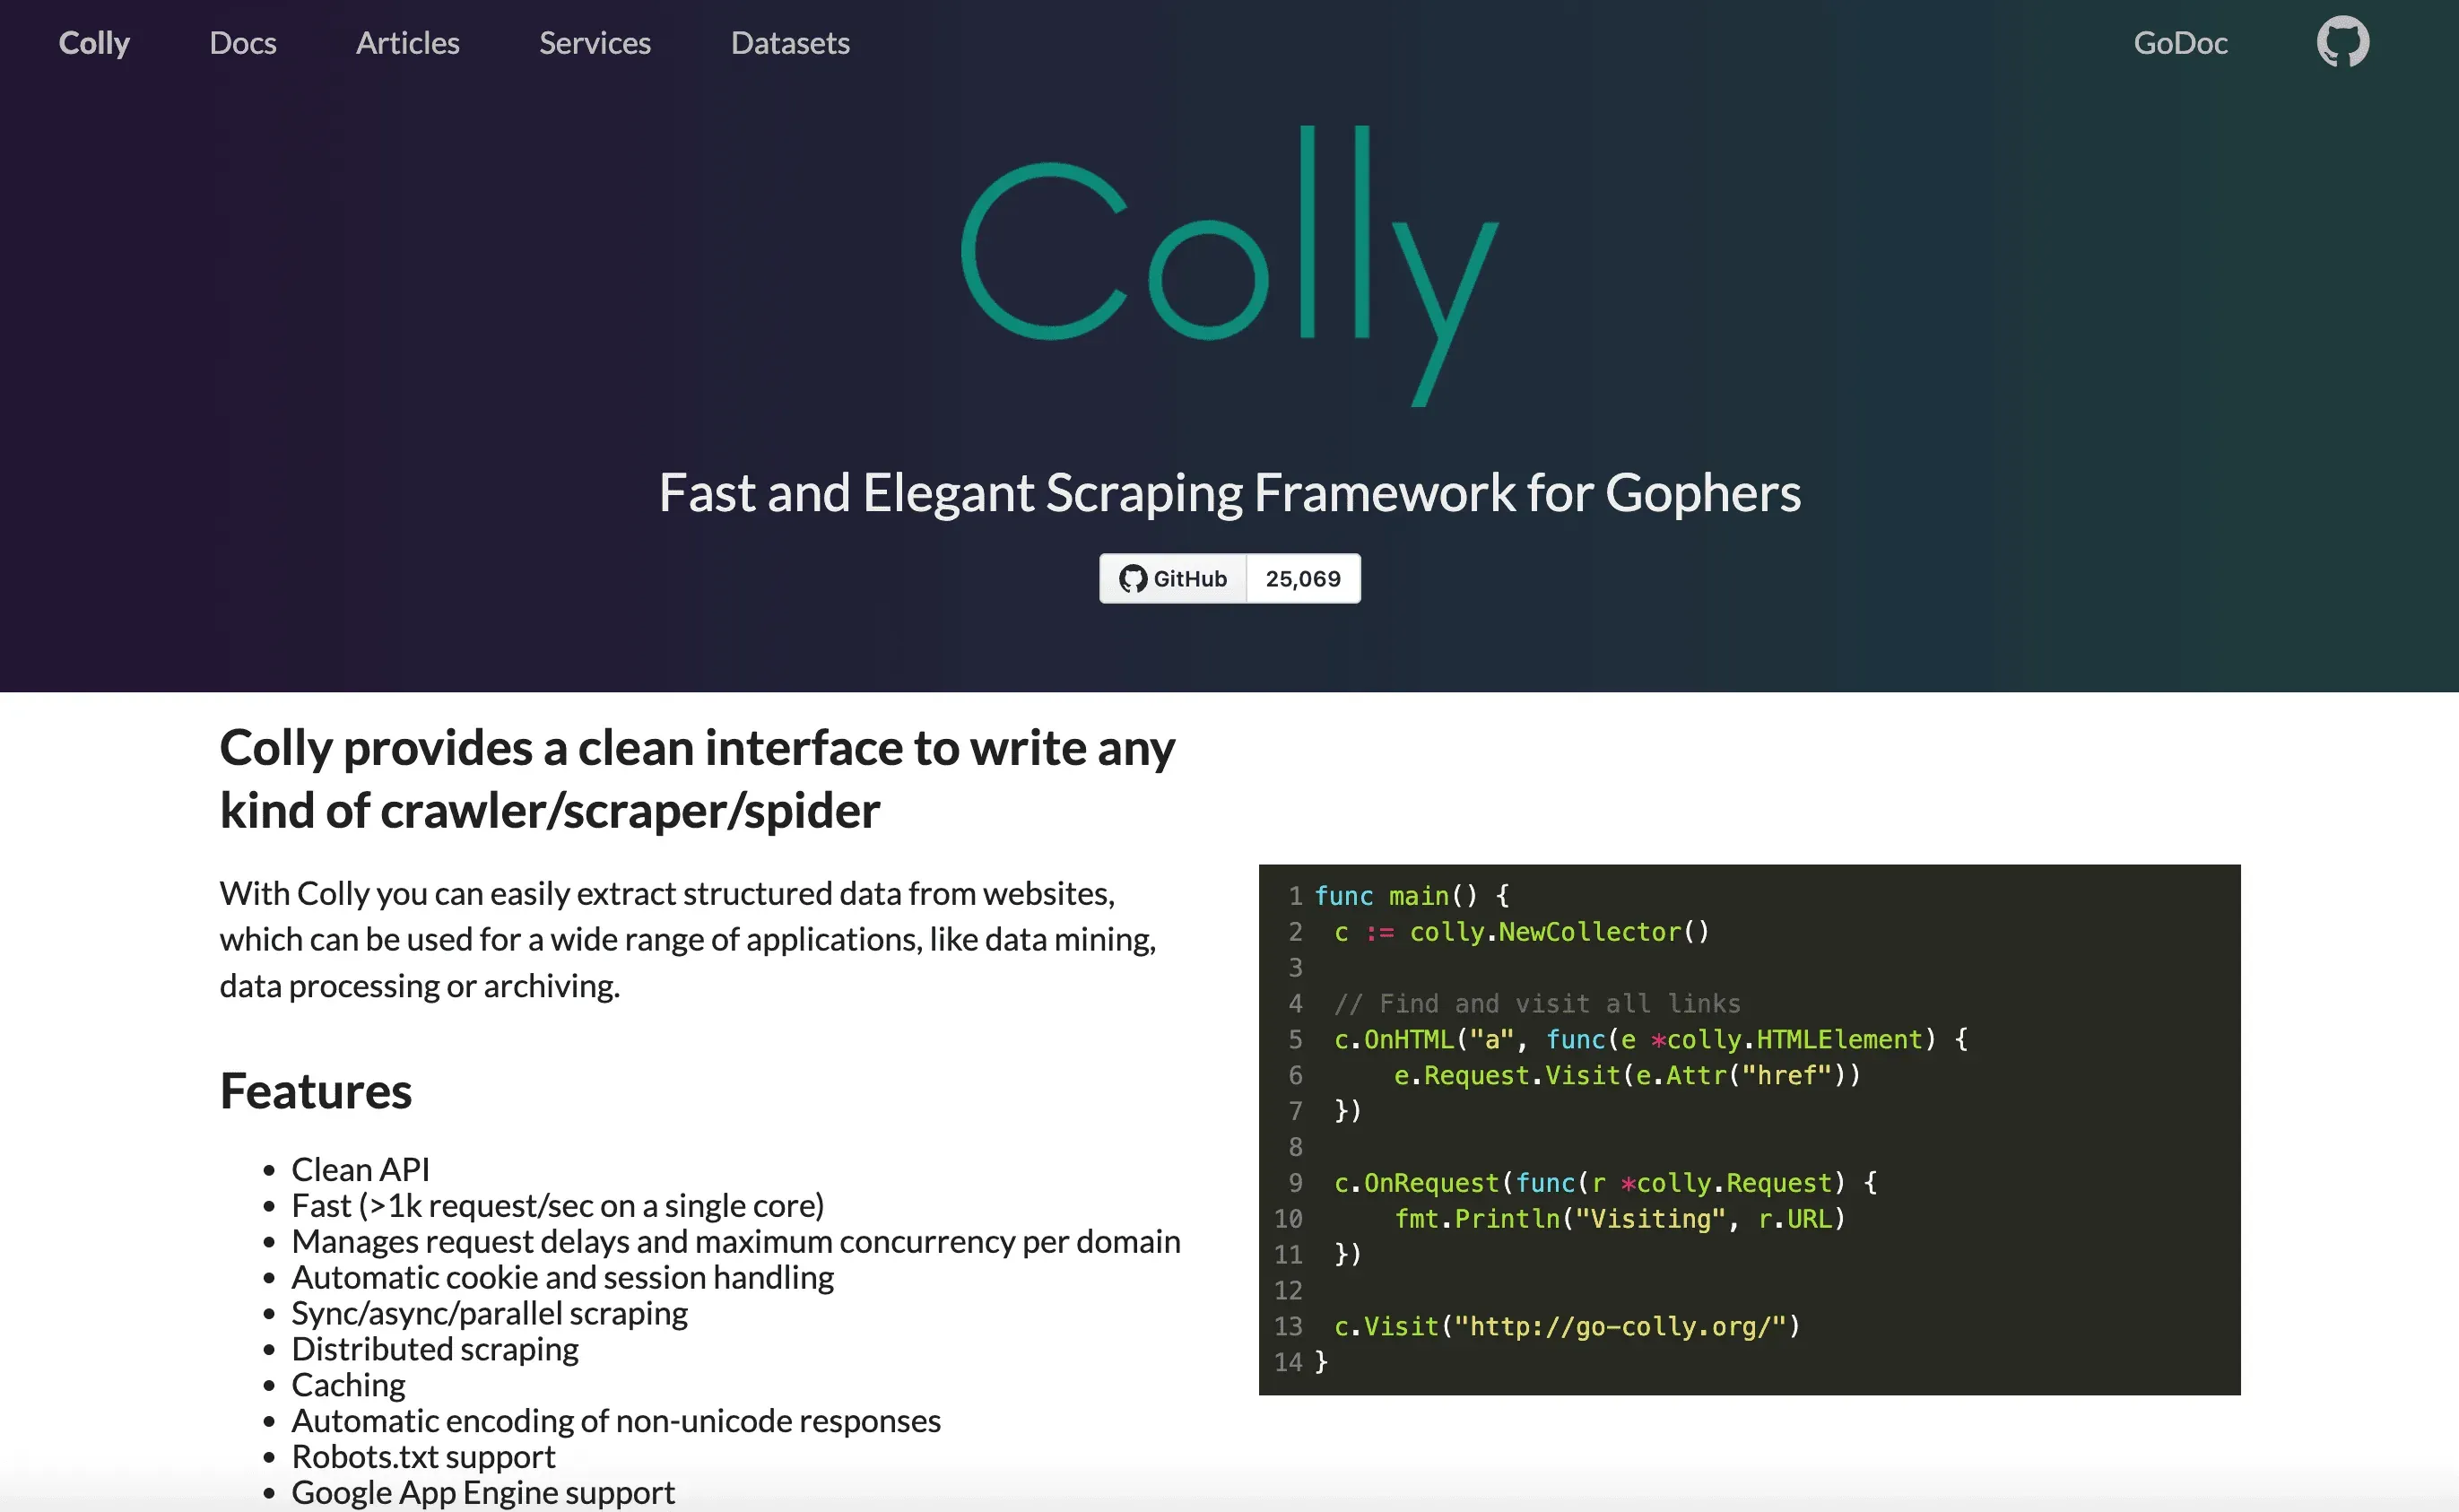 Colly je web scraping framework v Go postavený na rychlosti a efektivitě. Pokud vyvíjíte v Go, tohle je nástroj přesně pro vás.
Klíčové funkce:
- Extrémně rychlé, paralelní scrapování — přes 1 000 požadavků za sekundu na jednom jádru.
- Slušné crawling chování (respektuje robots.txt), správa session a cookies.
- Nízká paměťová náročnost.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Nativní Go binárky.
Nejlepší pro: Go vývojáře, kteří potřebují vysoký výkon.
12. PySpider
 PySpider je Python crawler systém s webovým UI — spravovat, plánovat i monitorovat crawl můžete přímo v prohlížeči. Na rovinu ale upozorním: repozitář je na GitHubu označen jako veřejný archiv a původní autor už nevydává nové verze, takže platí stav „co vidíš, to dostaneš“. Pokud jen potřebujete jeho UI/dashboard vzor na Linuxu, pořád funguje; pro cokoli, na čem chcete dlouhodobě záviset, ho berte jako legacy.
Klíčové funkce:
- Webové rozhraní pro skriptování a monitoring.
- Distribuovaný crawling, plánování a retry logika.
- Integrace s databázemi a message queue.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Navrženo pro nasazení na Linuxu.
Nejlepší pro: Týmy, které jsou v pohodě s forkem a vlastním udržováním webového UI pro více scraping projektů (nečekejte opravy od upstreamu).
13. WebHarvy
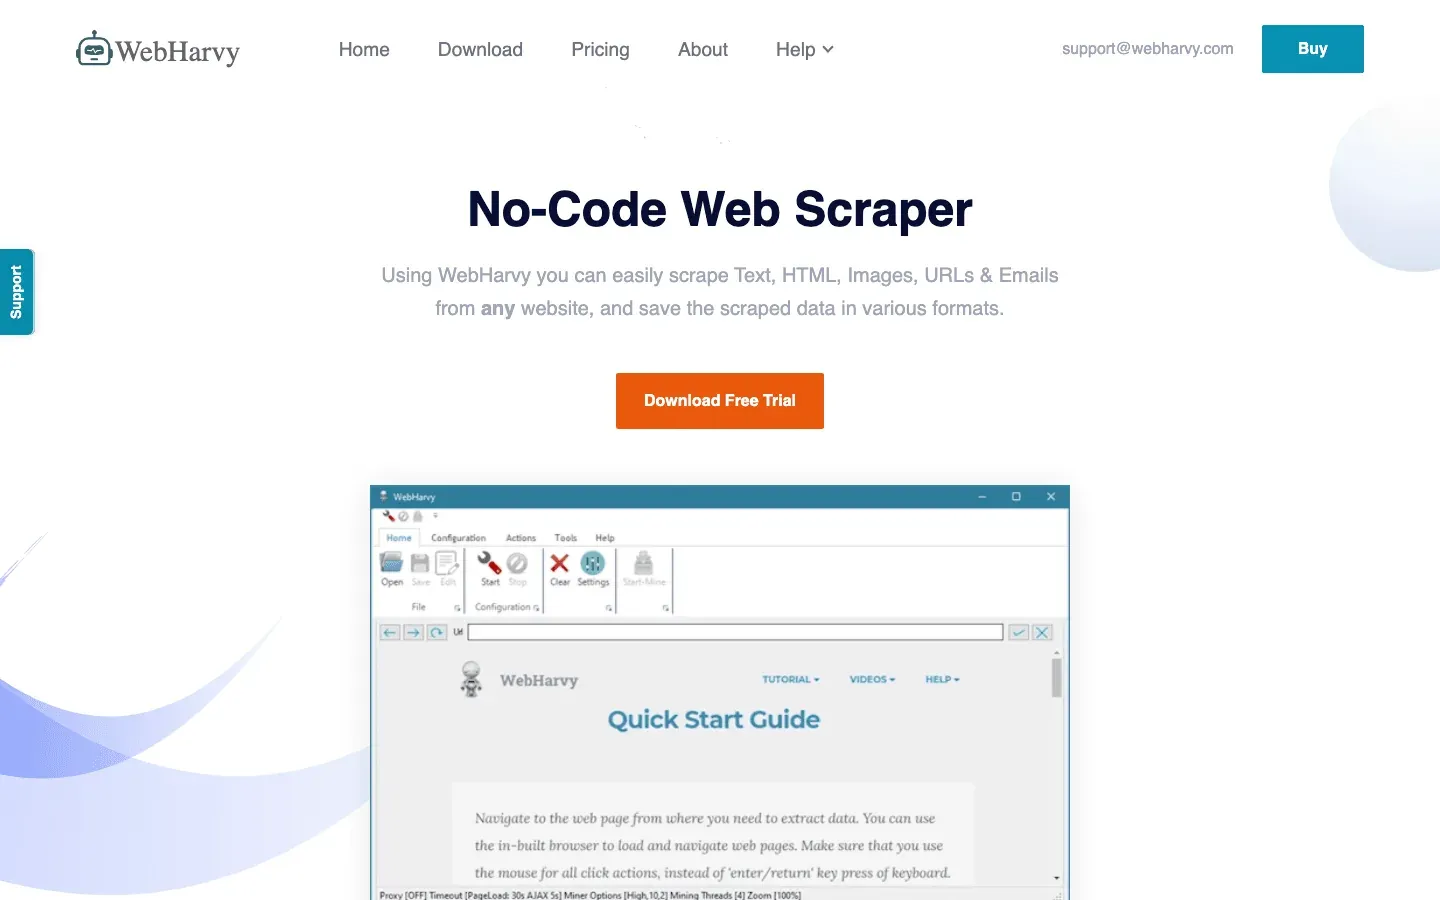 WebHarvy je vizuální scraper typu point-and-click pro Windows, ale uživatelé Linuxu ho mohou spustit přes Wine. Je známý rozpoznáváním vzorů a modelem jednorázové licence.
Klíčové funkce:
- Prohlížení a klikání pro výběr dat — bez programování.
- Automatické rozpoznávání vzorů v seznamech.
- Export do CSV, JSON, XML, SQL.
Cena: Přibližně 129 USD jednorázová licence.
Kompatibilita s Linuxem: Běží přes Wine nebo ve virtuálním stroji.
Nejlepší pro: Začátečníky nebo sólo profesionály, kteří chtějí rychlý a vizuální scraper.
14. OutWit Hub
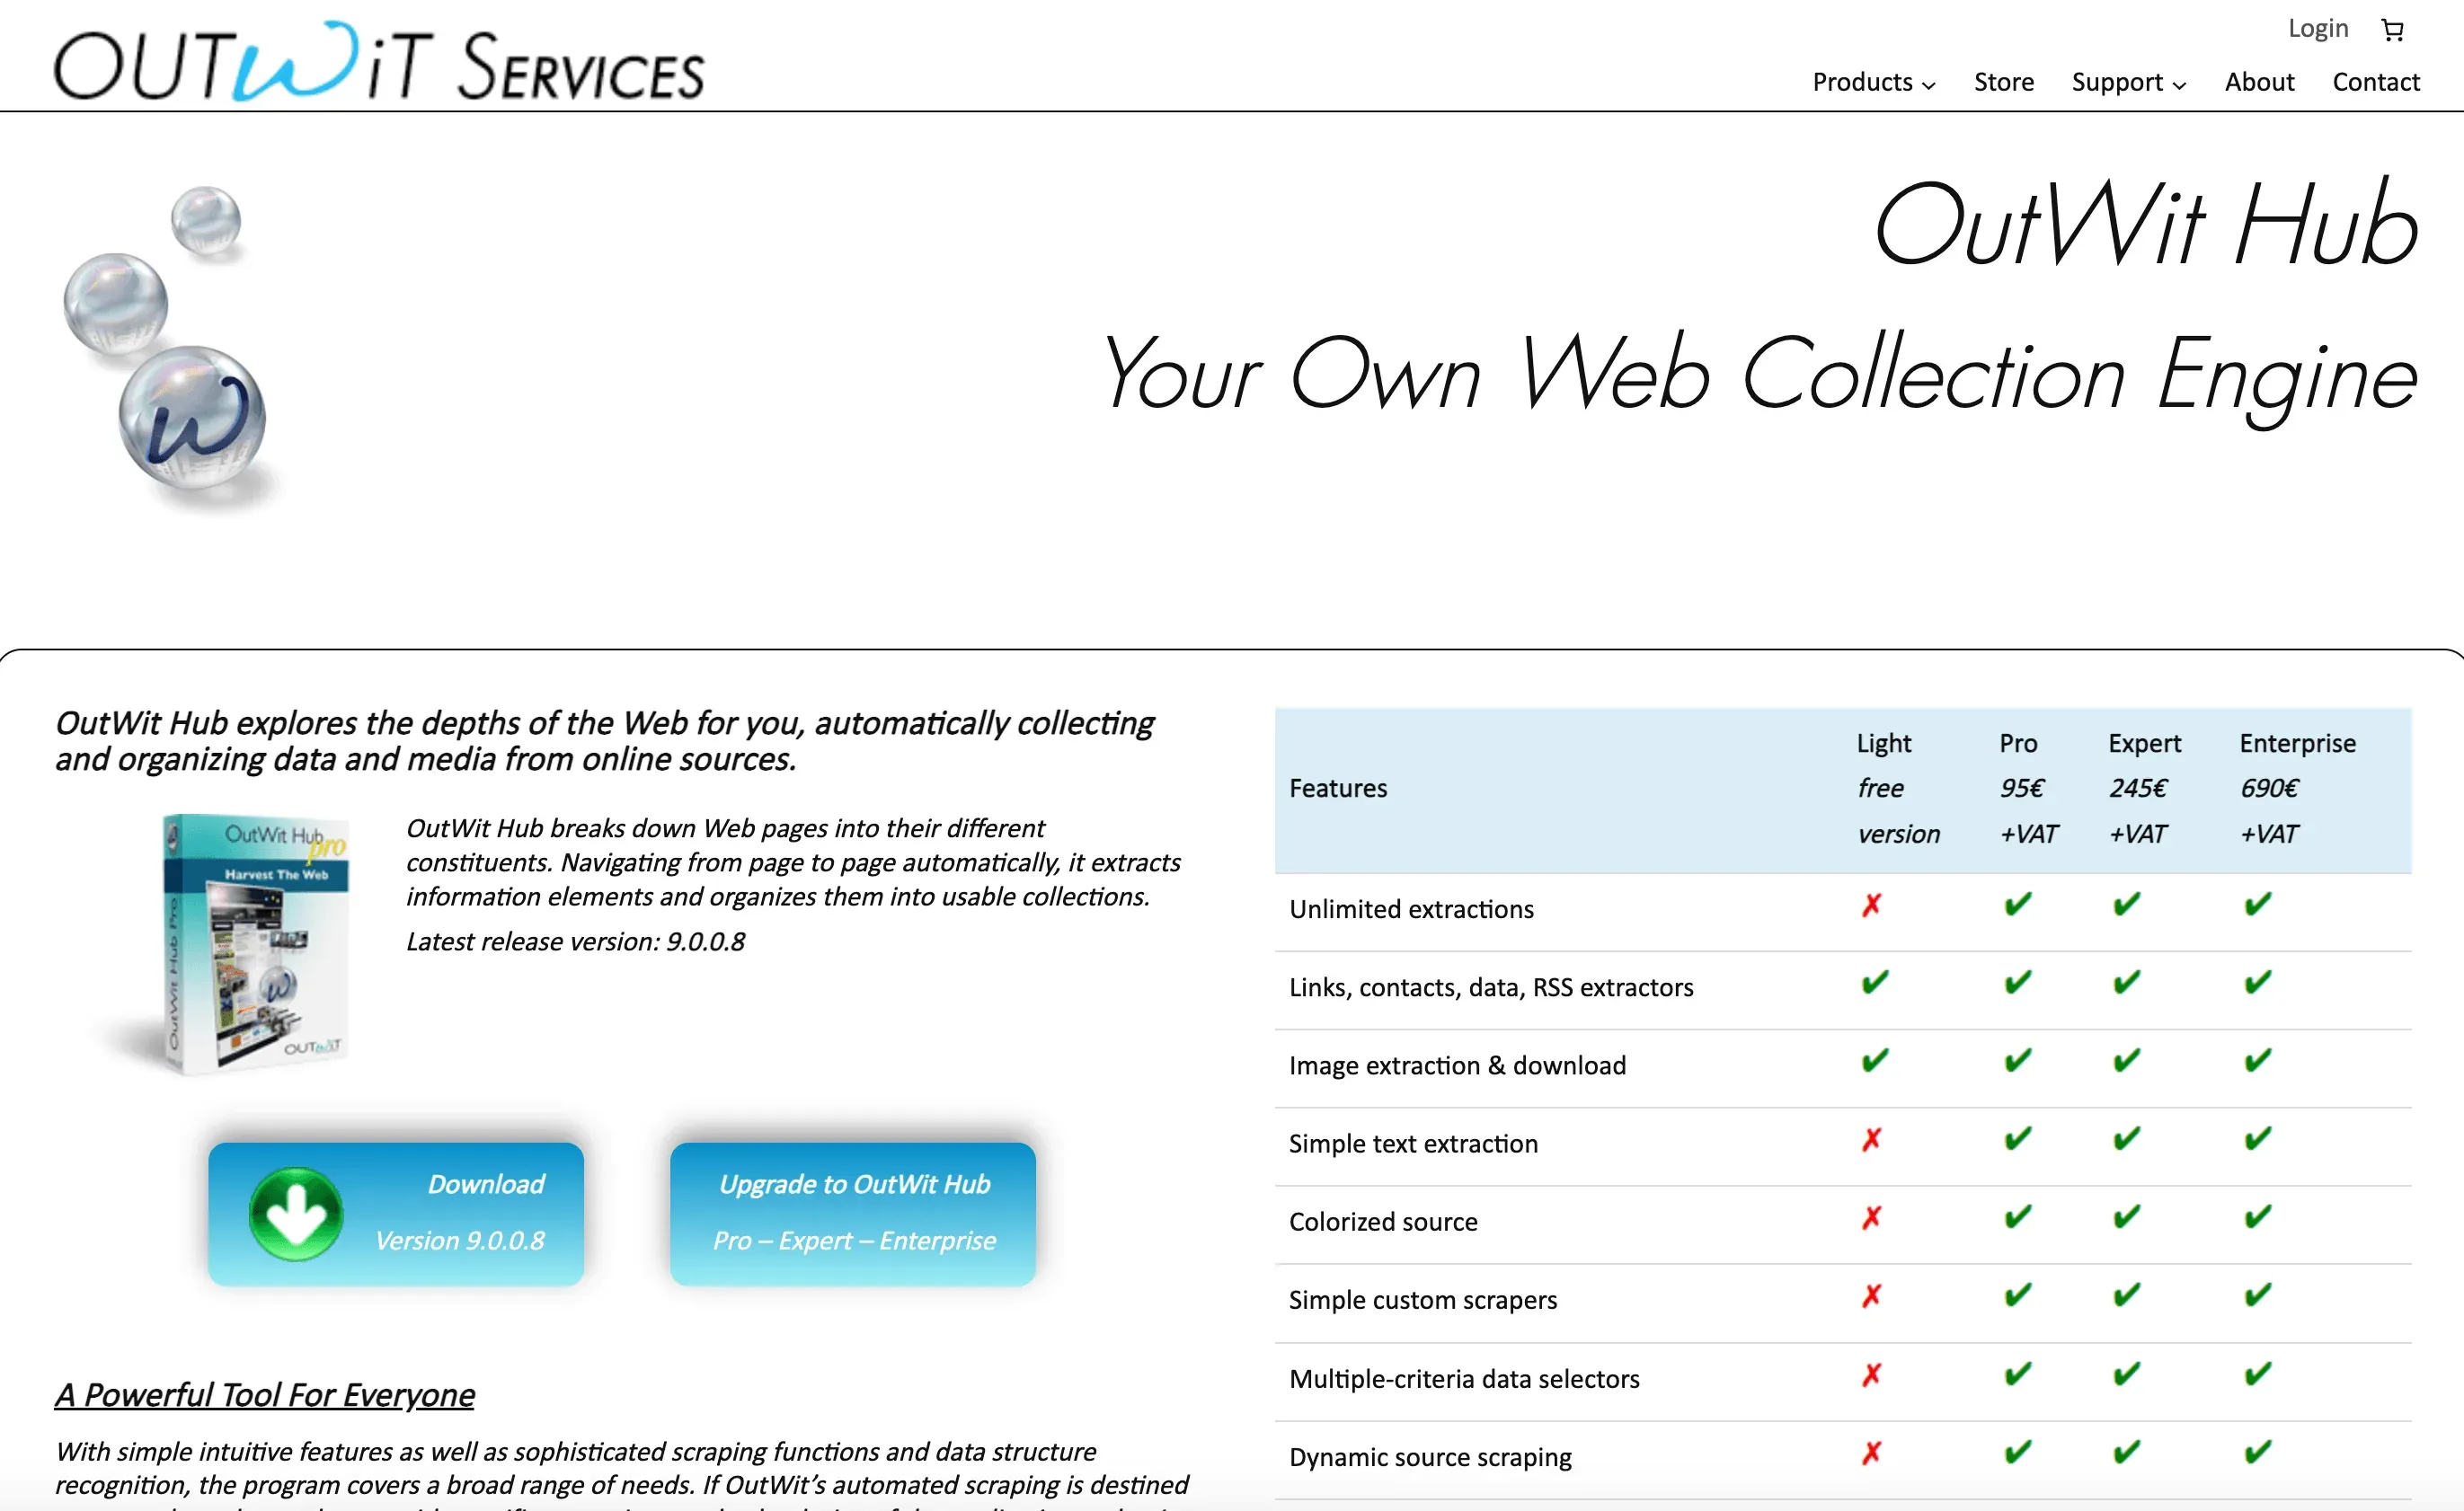 OutWit Hub je nativní Linux GUI aplikace pro web scraping. Automaticky rozpoznává datové vzory a nabízí silné možnosti extrakce i automatizace.
Klíčové funkce:
- Automaticky detekuje odkazy, obrázky, tabulky, e-maily a další.
- Editor skriptů pro vlastní extrakci.
- Makro automatizace a plánování úloh.
Cena: Bezplatná verze (omezená); placená Pro licence — aktuální cenu ověřte v obchodě dodavatele.
Kompatibilita s Linuxem: Nativní aplikace pro Linux, Windows i Mac.
Nejlepší pro: Necodery s lehce technickým myšlením, kteří chtějí desktopové GUI řešení.
15. Portia
 Portia je open-source vizuální web scraper od Scrapinghubu. Běží v prohlížeči a umožňuje anotovat stránky pro trénování scraperů — ale pozor, repozitář už více než rok neprošel žádným výraznějším vývojem, takže spadá do kategorie „používejte na vlastní riziko“. Pokud chcete vizuální anotace s aktivním vývojem v zádech, čistší volbou je ParseHub nebo Thunderbit.
Klíčové funkce:
- Rozhraní v prohlížeči pro vizuální extrakci.
- Integrace se Scrapy pro vlastní projekty.
- Open-source a rozšiřitelný.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Přes prohlížeč; funguje na libovolném OS.
Nejlepší pro: Uživatele, kteří chtějí open-source vizuální scraping s integrací do Scrapy.
16. Sequentum Enterprise (dříve Content Grabber)
 Sequentum Enterprise je enterprise vizuální scraper pro Windows, ale dá se provozovat na Linuxu přes Wine nebo virtualizaci.
Klíčové funkce:
- Vizuální editor plus skriptování v C# pro pokročilou logiku.
- Správa více agentů a plánování.
- Integrace s databázemi, API a dalšími systémy.
Cena: Enterprise licence, cena na vyžádání podle nasazení.
Kompatibilita s Linuxem: Přes Wine nebo VM.
Nejlepší pro: Agentury a velké týmy spravující mnoho scraping projektů.
17. Helium
 Helium je Python knihovna, která zjednodušuje Selenium automatizaci. Je navržená tak, aby bylo skriptování prohlížeče přirozenější a přívětivější.
Klíčové funkce:
- Intuitivní příkazy jako
click("Login")nebowrite("email"). - Automatizuje Chrome i Firefox.
- Skvělé pro rychlé skriptování a automatizační úkoly.
Cena: Zdarma a open-source.
Kompatibilita s Linuxem: Funguje na Linuxu (postavené na Selenium).
Nejlepší pro: Python uživatele, kterým Selenium připadá příliš těžkopádné.
18. Dexi.io
 Dexi.io je cloudová platforma pro extrakci dat a automatizaci. Funguje v prohlížeči, takže ji mohou uživatelé Linuxu používat bez instalace čehokoli navíc.
Klíčové funkce:
- Vizuální návrhář workflow pro scraping a automatizaci.
- Plánování úloh, transformace dat a integrace přes API.
- Škálování a podpora na enterprise úrovni.
Cena: Nově prodáváno pod Mozenda: bezplatná 14denní zkušební verze, Pilot za 500 USD/měsíc, enterprise cena na vyžádání.
Kompatibilita s Linuxem: Webová aplikace — funguje na jakémkoli OS.
Nejlepší pro: Profesionály a firmy, které potřebují škálovatelnou, integrovanou extrakci webových dat.
Rychlá srovnávací tabulka: Linux web scraping nástroje přehledně
| Nástroj | Typ / klíčové vlastnosti | Ideální pro | Cena | Kompatibilita s Linuxem |
|---|---|---|---|---|
| Thunderbit | AI rozšíření pro Chrome, 1 kliknutí, podstránky, cloud/lokálně | Netechnické byznysové uživatele | Zdarma, od 15 USD/měsíc | ✔ Chrome na Linuxu |
| Scrapy | Python framework, async, CLI, vysoce rozšiřitelný | Vývojáře, velké vlastní scrapery | Zdarma | ✔ Nativní |
| Beautiful Soup | Python knihovna, jednoduché parsování HTML/XML | Vývojáře, data science, malé úlohy | Zdarma | ✔ Nativní |
| Selenium | Automatizace prohlížeče, weby s JavaScriptem | QA, vývojáře, dynamický obsah | Zdarma | ✔ Nativní |
| Puppeteer | Node.js, headless Chrome, rendering JS | Node vývojáře, moderní webové aplikace | Zdarma | ✔ Nativní |
| Octoparse | No-code, drag-and-drop, cloud šablony | Necodery, e-commerce | Zdarma, od 69 USD/měsíc | ◐ Cloud/Wine |
| PhantomJS | Headless WebKit, JavaScript scripting | Legacy, lehké projekty, bez Chromu | Zdarma | ✔ Nativní |
| ParseHub | Vizuální, multiplatformní, point-and-click | Analytiky, semi-technické uživatele | Zdarma, od 189 USD/měsíc | ✔ Nativní |
| Kimurai | Ruby framework, více prohlížečů, async | Ruby vývojáře, vysoká souběžnost | Zdarma | ✔ Nativní |
| Apify | Cloudová platforma, SDK, marketplace | Vývojáře, hybrid custom/cloud | Zdarma tarif, dle spotřeby | ✔ Nativní/Cloud |
| Colly | Go framework, rychlý, paralelní | Go vývojáře, vysoký výkon | Zdarma | ✔ Nativní |
| PySpider | Python, web UI, plánování, distribuované | Týmy, více projektů | Zdarma | ✔ Nativní |
| WebHarvy | Vizuální, rozpoznávání vzorů, jednorázová licence | Začátečníky, sólo profesionály | ~129 USD jednorázově | ◐ Wine/VM |
| OutWit Hub | Nativní GUI, automatická detekce dat, skriptování | Necodery, desktop GUI | Zdarma; placená Pro (ověřte u dodavatele) | ✔ Nativní |
| Portia | Open-source, vizuální, v prohlížeči | Open-source, integrace se Scrapy | Zdarma | ✔ Prohlížeč |
| Sequentum Enterprise | Enterprise, vizuální, skriptování, multi-agent | Agentury, velké týmy | $$$, cena na vyžádání | ◐ Wine/VM |
| Helium | Python, zjednodušené Selenium, intuitivní API | Python uživatele, rychlá automatizace | Zdarma | ✔ Nativní |
| Dexi.io | Cloud, vizuální workflow, plánování, API | Enterprise, škálovatelná automatizace | Od 500 USD/měsíc (přes Mozenda) | ✔ Prohlížeč |
Jak vybrat správný web scraper pro Linux: klíčové faktory
Nejste si jistí, jaký tarif potřebujete? Začněte od nejjednodušší varianty Pokud nechcete udržovat selektory, nechte AI určit pole za vás — 1 kliknutí a export do Sheets, Excelu, Airtable nebo Notion. Get Started Free
Výběr správného nástroje je hlavně o tom, aby seděl vašim potřebám i dovednostem:
- Úroveň technických znalostí: Necodery by měli sáhnout po Thunderbit, ParseHub, Octoparse nebo OutWit Hub. Vývojáři získají větší sílu se Scrapy, Puppeteer, Colly nebo Kimurai.
- Složitost dat: Pro statické stránky jsou Beautiful Soup nebo Colly rychlé a jednoduché. Pro dynamické weby s JavaScriptem budete chtít Selenium, Puppeteer nebo vizuální nástroj, který JS podporuje.
- Měřítko a frekvence: Pro jednorázové úlohy stačí no-code nástroje nebo cloudové scrapery. Pro plánované, velkoobjemové crawlery volte Scrapy, PySpider nebo Apify.
- Potřeby integrace: Potřebujete export do Excelu, Sheets nebo databáze? Zkontrolujte, že váš nástroj podporuje váš workflow.
- Rozpočet: Pro programátory je spousta bezplatných open-source možností. Pro byznysové uživatele nabízejí Thunderbit a ParseHub dostupný vstup, zatímco enterprise týmy mohou investovat do Dexi.io nebo Sequentum Enterprise.
- Podpora a komunita: Open-source nástroje mají velké komunity; komerční nástroje zase dedikovanou podporu.
Tip navíc: Nebojte se nástroje kombinovat. Thunderbit můžete použít na prototypování a rozpoznání datových vzorů, a pak přejít na Scrapy pro produkční crawl ve velkém měřítku. Nebo použijte Selenium pro přihlášení a získání session cookies, a pak předáte scraping Colly nebo Scrapy pro vysokorychlostní sběr dat.
Závěr: Najděte si nejlepší Linux web scraping nástroj pro rok 2026
Uživatelé Linuxu mají v roce 2026 opravdu z čeho vybírat. Ať už chcete no-code AI nástroj, který vám dá výsledky během pár minut (Thunderbit), robustní vývojářský framework (Scrapy, Colly), nebo enterprise platformu (Dexi.io), existuje web scraper pro Linux, který sedne vašim potřebám i workflow.
Hlavní poznatky:
- Linux je páteří moderní datové infrastruktury — většina špičkových scraperů běží nativně nebo přes prohlížeč.
- AI a no-code nástroje demokratizují web scraping pro byznysové uživatele.
- Vývojářské frameworky dál vedou v pružnosti, rychlosti a škálování.
- Než koupíte, vyzkoušejte — většina nástrojů nabízí free tarify nebo trialy.
Připravení začít? Stáhněte si Thunderbit nebo se podívejte na Thunderbit Blog pro další návody k web scrapingu, automatizaci a růstu založenému na datech.
Objevte AI Web Scraper od Thunderbit Přeskočte skriptování i cron úlohy — nechte AI přečíst stránku a vrátit vám tabulku na 1 kliknutí. Get Started Free
Často kladené dotazy
1. Jaký je nejjednodušší web scraper pro Linux, pokud neumím programovat?
Thunderbit je nejlepší volba pro netechnické uživatele. Funguje jako rozšíření do Chromu na Linuxu, využívá AI pro automatizaci všeho a umožní vám extrahovat data jedním kliknutím.
2. Který Linux web scraper je nejlepší pro velké, vlastní projekty?
Scrapy je jasná volba pro vývojáře. Je rychlý, škálovatelný a vysoce přizpůsobitelný — ideální pro rozsáhlé a opakované crawly.
3. Můžu na Linuxu scrapovat weby náročné na JavaScript nebo dynamické stránky?
Ano! Použijte Selenium nebo Puppeteer pro ovládání reálných prohlížečů a extrakci dynamického obsahu. Vizuální nástroje jako ParseHub a Thunderbit dynamické weby také podporují.
4. Existují bezplatné Linux web scraping nástroje pro byznysové využití?
Rozhodně. Scrapy, Beautiful Soup, Selenium, Colly, PySpider a Kimurai jsou zdarma a open-source. Thunderbit a ParseHub nabízejí bezplatné tarify pro menší úlohy.
5. Jak se rozhodnout mezi no-code a kódovanými Linux scrapery?
Pokud chcete rychlost a jednoduchost, jděte do no-code varianty (Thunderbit, ParseHub, Octoparse). Pokud potřebujete flexibilitu, automatizaci nebo integraci s dalšími systémy, kódované nástroje (Scrapy, Puppeteer, Colly) jsou lepší volba.
Přeji hodně úspěchů při scrapingu — ať vaše datové projekty na Linuxu běží hladčeji než čerstvá instalace Ubuntu. Pokud chcete víc tipů k web scrapingu, podívejte se na Thunderbit Blog nebo se přihlaste k odběru našeho YouTube kanálu s praktickými návody.
Vyzkoušejte AI Web Scraper pro Linux Get Started Free
Zjistit více



