
Web roste rychleji než moje závislost na kávě – a věřte mi, to už něco znamená. V roce 2026 není extrakce webových dat jen okrajovou dovedností pro datové nadšence; je to páteř business intelligence, tréninku AI a automatizace. Ať už sledujete tržní trendy, poháníte svůj LLM nové generace, nebo se jen snažíte držet krok s cenami konkurence, potřeba strukturovaných webových dat v reálném čase nikdy nebyla vyšší. A v srdci této datové horečky? Python. Díky svému obrovskému ekosystému a přístupné syntaxi zůstává Python hlavním jazykem pro web scraping, pohánějícím vše od rychlých jednorázových skriptů po průmyslové crawlery.
Ale tady je ten háček: výběr správných balíčků Python pro web scraping může váš projekt buď posunout, nebo zničit. Viděl jsem týmy, jak ztrácely dny bojem s anti-bot ochranou se špatným nástrojem, nebo trávily hodiny parsováním chaotického HTML, když by chytřejší knihovna udělala práci za pár minut. Takže jako někdo, kdo strávil roky v SaaS, automatizaci a AI (a vytvořil Thunderbit, aby usnadnil scraping všem), jsem shromáždil 12 nejlepších balíčků Python pro web scraping pro rok 2026 – každý s vlastními silnými stránkami, zvláštnostmi a ideálními případy použití. Pojďme se ponořit a najít to pravé pro vaše další datové dobrodružství.
Proč záleží na správných balíčcích Python pro web scraping
Získejte data z jakékoli webové stránky pomocí AI Get Started Free
Pojďme si to říct na rovinu: ne všechny projekty web scrapingu jsou si rovny. Někdy stačí získat pár cen produktů ze statické stránky. Jindy se potýkáte s webem plným JavaScriptu, který je tvrdohlavější než kočka při koupání. Správný balíček vám může ušetřit hodiny (nebo dny), snížit chyby a pomoci vám vyhnout se běžným nástrahám, jako jsou blokování anti-bot systémy nebo poškozené HTML.
Popularita Pythonu ve web scrapingu není jen humbuk. Knihovny jako requests a urllib3 zaznamenávají přes 1 miliardu stažení měsíčně a téměř každý hlavní nástroj pro scraping je primárně v Pythonu. Ale s velkou mocí přichází velká zodpovědnost: vyberte špatný nástroj a můžete se ocitnout v projektu, který je pomalejší než dial-up internet. Vyberte moudře a budete se topit v čistých, strukturovaných datech dříve, než vám vychladne káva.
Jak jsme vybrali nejlepší balíčky Python pro web scraping
Neházel jsem jen šipky na graf PyPI. Zde je, jak jsem hodnotil každý balíček:
- Výkon a souběžnost: Dokáže rychle načíst stovky (nebo tisíce) stránek?
- Snadné použití: Je přátelský pro začátečníky, nebo vyžaduje doktorát z informatiky?
- Síla parsování HTML: Zvládá poškozené značky, podporuje selektory XPath/CSS a usnadňuje extrakci dat?
- Podpora dynamického obsahu: Dokáže se vypořádat s weby plnými JavaScriptu, nebo je striktně určen pro statické stránky?
- Komunita a dokumentace: Existuje prosperující uživatelská základna a solidní dokumentace, nebo se budete potýkat s peklem Stack Overflow?
- Nejlepší případ použití: Je určen pro rychlé skripty, rozsáhlé crawlery, nebo něco mezi tím?
Zohlednil jsem také zpětnou vazbu od vývojářů z reálného světa, nedávné benchmarky a mé vlastní (někdy bolestivé) zkušenosti v oboru. Nyní se pojďme podívat na uchazeče.
1. Thunderbit
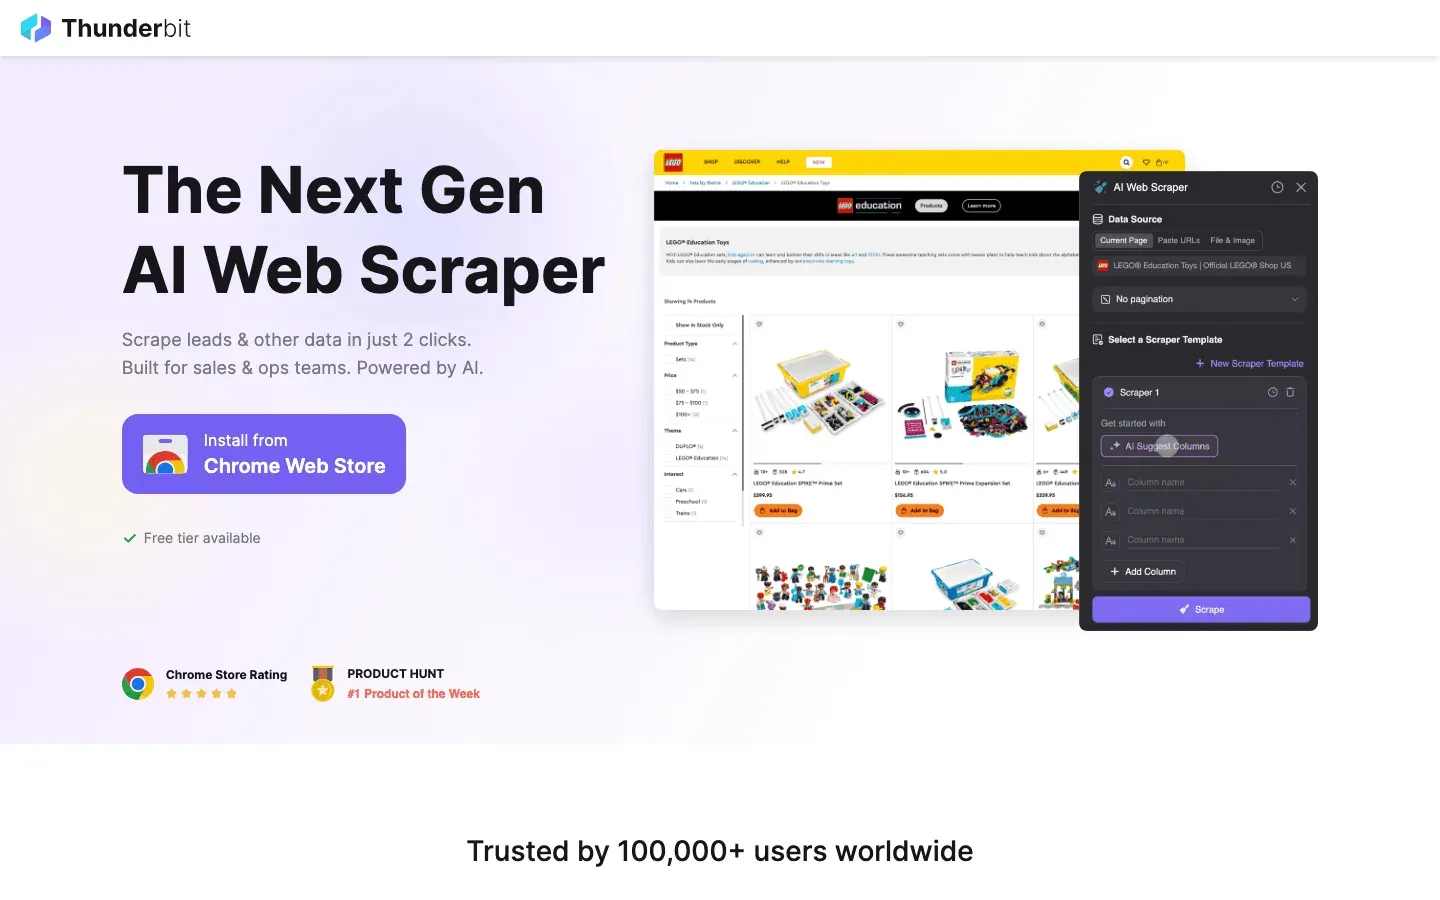 Thunderbit není typická knihovna Pythonu – je to rozšíření Chrome poháněné AI, které mění pravidla hry pro web scraping, zejména pro vývojáře Pythonu, kteří chtějí rychlost, přesnost a dotek AI magie. Čím se Thunderbit odlišuje? Umožňuje vám používat instrukce v přirozeném jazyce, abyste AI řekli, jaká data chcete, a pak se postará o všechno: návrhy polí, navigaci na podstránky, stránkování a dokonce i export do Excelu, Google Sheets, Notion nebo Airtable.
Thunderbit je záchranou pro scraping složitých, nestrukturovaných dat – představte si chaotické adresáře, seznamy produktů nebo weby, kde je HTML spíše „abstraktní umění“ než „strukturovaný dokument“. Jeho funkce AI Suggest Fields čte stránku a navrhuje nejlepší sloupce, zatímco Subpage Scraping vám umožňuje obohatit váš datový soubor automatickým navštěvováním propojených detailních stránek. A pokud vás unavují problémy s anti-bot systémy, Thunderbitovy možnosti prohlížečového a cloudového scrapingu vás pokryjí.
Vývojáři Pythonu milují Thunderbit pro rychlé prototypování, generování leadů a průzkum trhu. Jeho výstup můžete použít přímo ve svém datovém pipeline v Pythonu, nebo dokonce automatizovat scrapingové pracovní postupy pomocí jeho API. Není to tradiční knihovna kódu, ale rychle se stává oblíbeným nástrojem pro každého, kdo chce trávit méně času kódováním a více času analýzou dat.
Klíčové vlastnosti:
- AI-poháněné návrhy polí a extrakce dat
- Zvládá podstránky, stránkování a dokonce i PDF/obrázky
- Exportuje do CSV, Excelu, Google Sheets, Notion, Airtable
- Nevyžaduje kódování – ideální pro netechnické uživatele i profesionály v Pythonu, kteří chtějí rychle postupovat
- K dispozici je bezplatná verze; placené plány se škálují podle vašich potřeb
Nejlepší pro: Generování leadů, průzkum trhu, rychlé prototypování a scraping složitých nebo chaotických webových dat.
Vyzkoušejte Thunderbit AI Web Scraper zdarma
2. Beautiful Soup
 Beautiful Soup je OG parsování HTML v Pythonu. Pokud teprve začínáte nebo potřebujete extrahovat data ze statických webových stránek, je to váš nejlepší přítel. Beautiful Soup vyniká v navigaci a parsování špatně strukturovaného HTML („tag soup“), což z něj činí záchranu pro scraping webů, které se neřídí pravidly.
API je přátelské pro začátečníky – představte si .find(), .select() a .text – a perfektně se páruje s requests pro načítání webových stránek. Pod kapotou si můžete vybrat různé parsery (například lxml pro rychlost nebo html5lib pro maximální kompatibilitu). Dokumentace je špičková a komunita je obrovská.
Klíčové vlastnosti:
- Intuitivní, Pythonic API pro navigaci v HTML/XML
- Elegantně zvládá poškozené nebo nekonzistentní značky
- Pracuje s více parsery pro rychlost nebo kompatibilitu
- Obrovská komunita a spousta tutoriálů
Nejlepší pro: Rychlé skripty, scraping statických stránek a začátečníky, kteří chtějí mírnou křivku učení.
3. Scrapy
 Scrapy je těžká váha pro rozsáhlé, automatizované webové procházení. Pokud potřebujete scrapovat stovky nebo tisíce stránek, spravovat pipeline nebo plánovat opakované úlohy, Scrapy je framework, na který se většina týmů spoléhá. Stále běží na Twisted reaktoru, ale od verze 2.14 byla velká část jeho asynchronních interních mechanismů přepsána jako nativní
asyncio korutiny a nyní existují vstupní body AsyncCrawlerProcess / AsyncCrawlerRunner, které dobře spolupracují se zbytkem moderního asynchronního ekosystému Pythonu. Je rychlý, podporuje souběžné procházení, item pipeline pro čištění dat a exportuje do JSON, CSV nebo databází.
Scrapy je rozšiřitelný, s pluginy pro proxy, cachování a dokonce i omezené vykreslování JavaScriptu (prostřednictvím integrace Splash nebo Selenium). Křivka učení je strmější než u Beautiful Soup, ale pokud to s webovými daty ve velkém myslíte vážně, Scrapy je to, do čeho se vyvinete.
Klíčové vlastnosti:
- Asynchronní procházení přes Twisted reaktor + nativní
asynciokorutiny (Scrapy 2.14+, Python 3.10+) - Vestavěné pipeline pro čištění a ukládání dat
- Export do více formátů (JSON, CSV, DB)
- Velká, aktivní komunita a ekosystém pluginů
Nejlepší pro: Rozsáhlé, opakované scrapingové projekty, datové pipeline a každého, kdo potřebuje rychlost a spolehlivost.
4. Selenium
 Selenium je nástroj pro scraping webů s velkým množstvím JavaScriptu nebo interaktivních stránek. Automatizuje skutečné prohlížeče (Chrome, Firefox atd.), což vám umožňuje simulovat uživatelské akce, jako jsou kliknutí, posouvání a odesílání formulářů. Pokud se data, která potřebujete, objeví až po spuštění JavaScriptu, Selenium je dokáže získat – bez ohledu na to, jak tvrdohlavý je web.
Nevýhoda? Selenium je pomalé a náročné na zdroje. Pro každý scrape spouštíte plnohodnotný prohlížeč, takže nečekejte, že zpracujete tisíce stránek za minutu. Ale pro ty scénáře „žádný jiný nástroj to nedokáže“ je Selenium záchranou.
Klíčové vlastnosti:
- Plná automatizace prohlížeče (podporuje Chrome, Firefox, Edge atd.)
- Zvládá obsah vykreslený JavaScriptem a interaktivní prvky
- Podporuje bezhlavý režim pro rychlejší scraping bez UI
- Velká komunita a rozsáhlá dokumentace
Nejlepší pro: Scraping dynamických webů s velkým množstvím JavaScriptu, automatizaci přihlašovacích toků a zpracování CAPTCHA nebo složitých uživatelských interakcí.
Přečtěte si více o silných a slabých stránkách Selenium
5. PyQuery
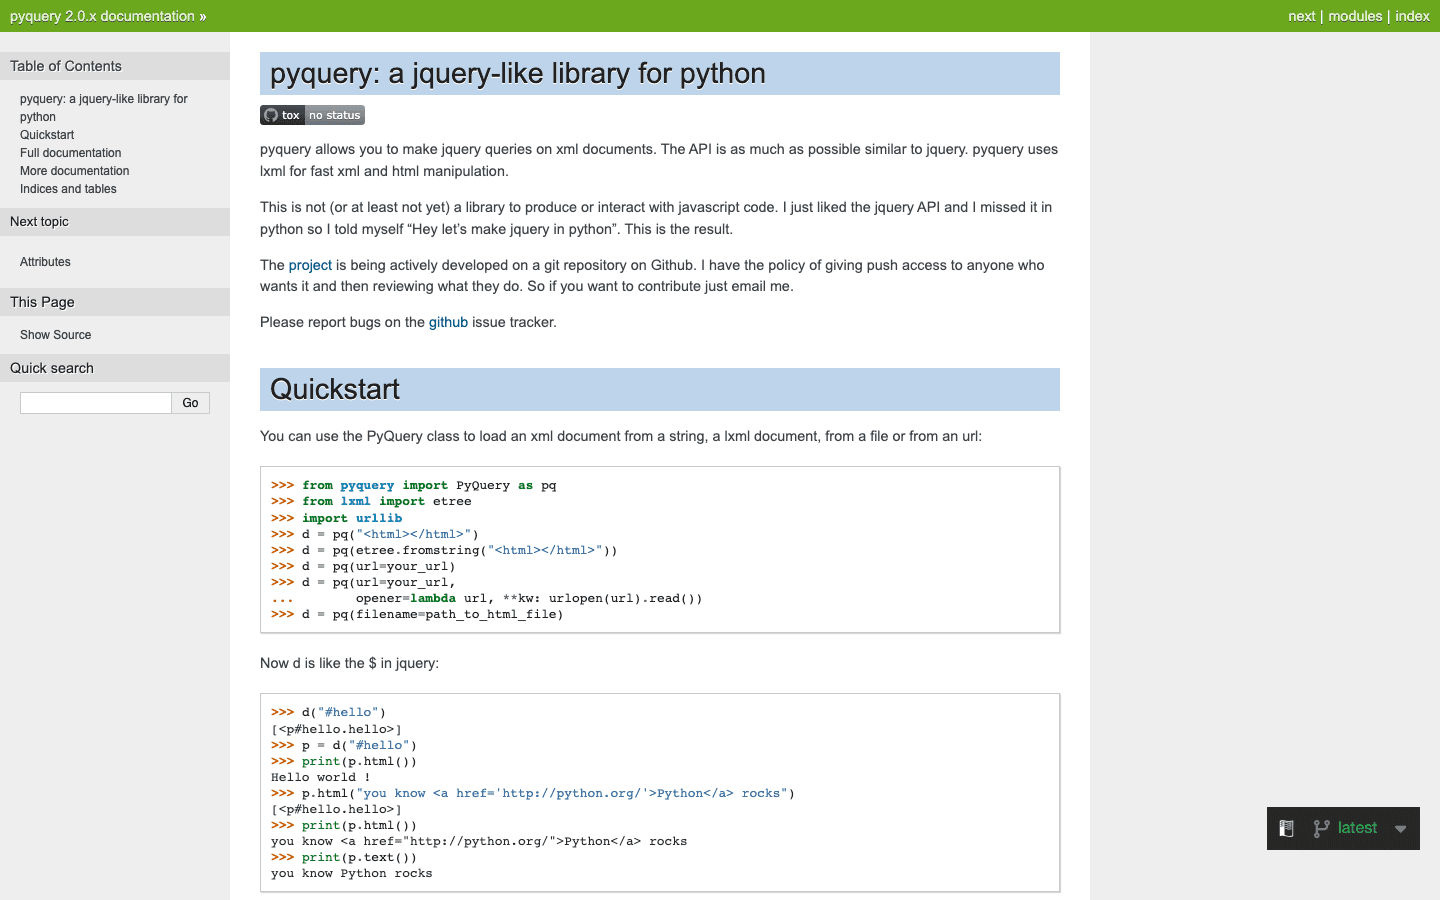 PyQuery přináší syntaxi ve stylu jQuery do Pythonu, takže parsování HTML je známé každému, kdo pracoval s jQuery v JavaScriptu. Zabaluje rychlý parser
lxml a umožňuje vám používat CSS selektory jako $('div.classname') k nalezení prvků.
PyQuery je skvělý pro rychlé prototypování a pro vývojáře, kteří chtějí stručný, čitelný kód. Je rychlejší než Beautiful Soup pro složité dotazy a snadno se integruje s asynchronními nástroji nebo Selenium pro pokročilejší pracovní postupy.
Klíčové vlastnosti:
- Selektory a syntaxe podobné jQuery v Pythonu
- Rychlé parsování s backendem lxml
- Skvělé pro vývojáře přecházející z JavaScriptu
- Podporuje řetězení a stručné dotazy
Nejlepší pro: Prototypování, fanoušky jQuery a každého, kdo chce psát méně kódu pro parsování HTML.
PyQuery tutoriál a srovnání
6. LXML
 LXML je rychlostní démon parsování HTML a XML v Pythonu. Postavený na C knihovnách
libxml2 a libxslt, je známý svým výkonem a silnou podporou selektorů XPath a CSS. Pokud pracujete s velkými dokumenty nebo potřebujete spouštět složité dotazy, lxml je vaše nejlepší volba.
Lze jej použít přímo nebo jako backend pro Beautiful Soup nebo PyQuery. API je trochu pokročilejší, ale rychlost a flexibilita stojí za to pro velké úlohy.
Klíčové vlastnosti:
- Nejrychlejší parsování dostupné v Pythonu
- Plná podpora selektorů XPath a CSS
- Efektivně zpracovává velké a složité dokumenty
- Lze použít samostatně nebo jako parser pro jiné knihovny
Nejlepší pro: Vysoce výkonné parsování, rozsáhlý scraping a projekty vyžadující pokročilé dotazování.
7. Requests
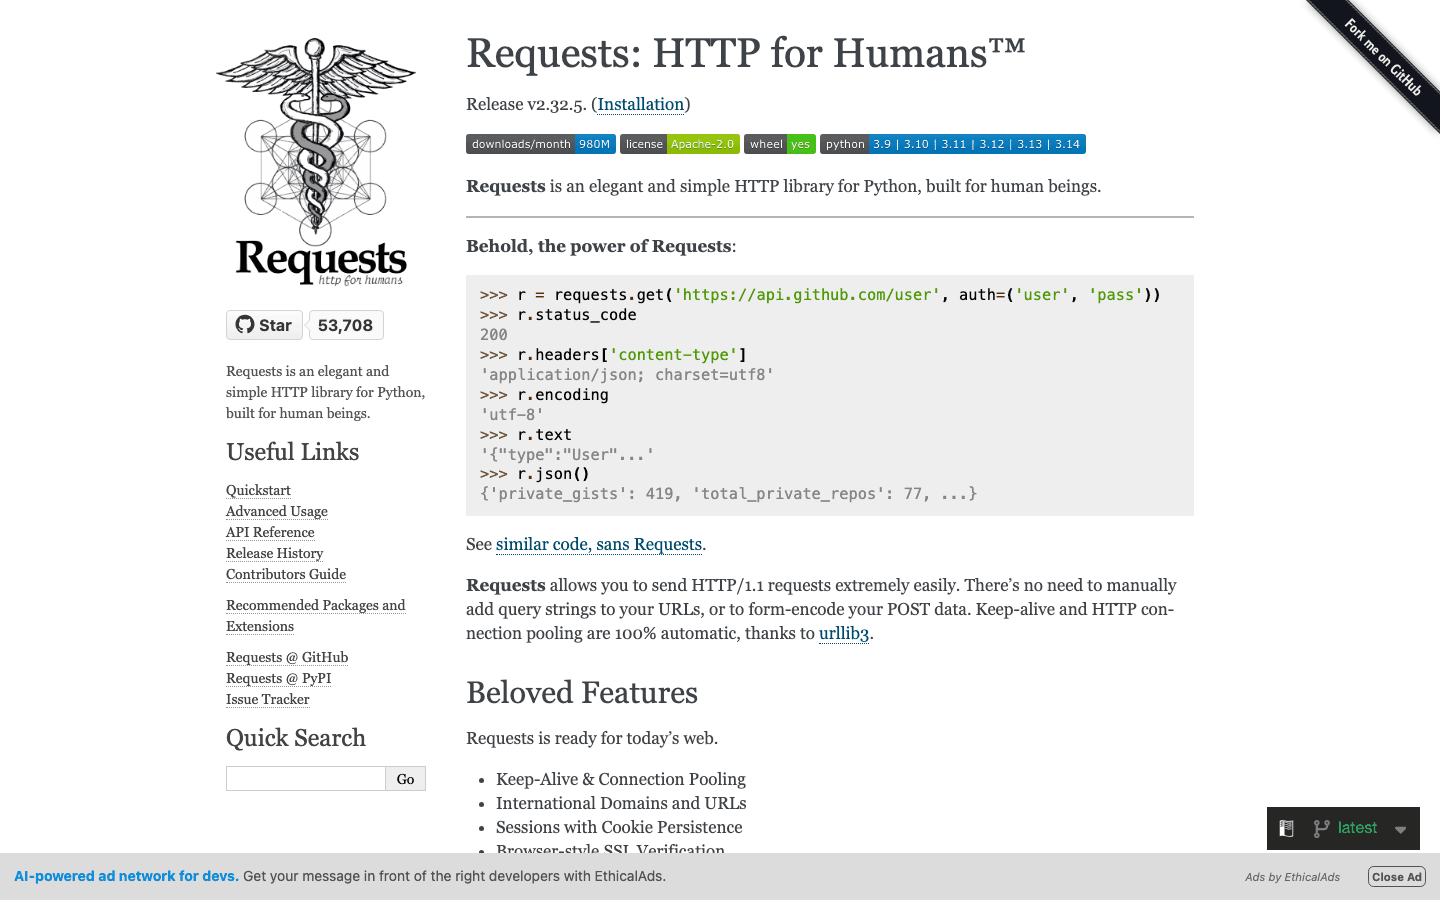 Requests je de facto standard pro provádění HTTP požadavků v Pythonu. Jeho čisté, intuitivní API usnadňuje načítání webových stránek stejně snadno jako
requests.get(url). Zpracovává cookies, sessions a dokonce i dekódování JSON přímo z krabice.
Zatímco Requests je synchronní (každý požadavek čeká na dokončení), je ideální pro rychlé skripty a malý scraping. Spárujte ho s Beautiful Soup nebo lxml pro klasický scrapingový pracovní postup.
Klíčové vlastnosti:
- Jednoduché, Pythonic API pro HTTP požadavky
- Zpracovává cookies, sessions a přesměrování
- Bezproblémově se integruje s parsovacími knihovnami
- Obrovská komunita a dokumentace
Nejlepší pro: Jednoduché skripty, scraping statických stránek a začátečníky, kteří chtějí rychle začít.
Proč je Requests tak populární
8. MechanicalSoup
 MechanicalSoup je lehká knihovna, která automatizuje jednoduché interakce s prohlížečem – jako je vyplňování formulářů nebo navigace v přihlašovacích tocích s více kroky – aniž by spouštěla plnohodnotný prohlížeč. Zabaluje
requests a Beautiful Soup, což ji činí mnohem rychlejší a lehčí než Selenium pro weby, které se silně nespoléhají na JavaScript.
Pokud se potřebujete přihlásit, odeslat formuláře nebo proklikat se několika stránkami (a web není příliš dynamický), MechanicalSoup je skvělým kompromisem.
Klíčové vlastnosti:
- Automatizuje vyplňování formulářů a navigaci
- Postaveno na Requests a Beautiful Soup
- Lehké a rychlé (žádná režie prohlížeče)
- Snadné použití pro mírnou interaktivitu
Nejlepší pro: Weby vyžadující přihlášení nebo odeslání formuláře, jednoduché automatizační úkoly a každého, kdo se chce vyhnout režii Selenium.
Tutoriál MechanicalSoup
9. Aiohttp
 Aiohttp je asynchronní síla pro vysokorychlostní, souběžné webové požadavky. Pokud potřebujete rychle scrapovat stovky stránek, aiohttp vám umožní spouštět požadavky paralelně, což dramaticky snižuje celkovou dobu běhu. V jednom benchmarku trvalo scrapování 50 stránek s aiohttp pouhé 3 sekundy, ve srovnání s 16 sekundami při použití synchronních požadavků (viz rozdíl ve výkonu).
Aiohttp vyžaduje psaní kódu async def a použití await, ale rychlostní zisky stojí za to pro rozsáhlé úlohy.
Klíčové vlastnosti:
- Asynchronní HTTP klient/server framework
- Podporuje sessions, cookies a HTTP/2
- Masivní zrychlení pro souběžné požadavky
- Integruje se s asynchronními parsovacími knihovnami
Nejlepší pro: Vysokorychlostní, rozsáhlý scraping, sběr dat z API a každého, kdo je obeznámen s asynchronním programováním.
10. Twisted
 Twisted je síťový engine řízený událostmi, který pohání Scrapy. I když to není scrapingová knihovna sama o sobě, pokročilí uživatelé mohou Twisted použít přímo k vytváření vlastních crawlerů, zpracování ne-HTTP protokolů nebo implementaci hyper-souběžných spiderů.
Twisted je výkonný, ale má strmou křivku učení. Je nejlepší pro vysoce specifické scénáře nebo při vytváření frameworků od nuly.
Klíčové vlastnosti:
- Síťování řízené událostmi pro HTTP, WebSockets, SSH a další
- Podporuje SSL, souběžnost a vlastní protokoly
- Podporuje asynchronní engine Scrapy
- Vysoce flexibilní pro pokročilé případy použití
Nejlepší pro: Vlastní protokoly, vytváření scrapingových frameworků a pokročilé uživatele, kteří potřebují maximální kontrolu.
11. Grab
 Grab je all-in-one scrapingový toolkit, který kombinuje HTTP požadavky, parsování, automatizaci, rotaci proxy a zpracování CAPTCHA. Je podobný Scrapy, ale snaží se být snazší na učení a použití, s vestavěnou podporou pro proxy, cachování a asynchronní spidery.
Výraznou funkcí Grab je jeho systém Grab:Spider, který dokáže spouštět tisíce požadavků paralelně pomocí multicurl. Pokud potřebujete all-in-one řešení s menším nastavením než Scrapy, Grab stojí za zvážení.
Klíčové vlastnosti:
- Vestavěná podpora pro proxy, rotaci user-agentů a cachování
- Asynchronní systém spiderů pro vysokou souběžnost
- Parsování XPath a modulární architektura
- Používáno v produkci pro rozsáhlý scraping
Nejlepší pro: All-in-one scrapingové projekty, úkoly náročné na proxy a uživatele, kteří chtějí výkon bez složitosti Scrapy.
12. Urllib3
 Urllib3 je nízkoúrovňový HTTP engine, který pohání mnoho klientů Pythonu, včetně Requests. Nabízí sdružování připojení, bezpečnost vláken, opakování a jemnou kontrolu nad HTTP připojeními. Zatímco většina vývojářů jej používá nepřímo, urllib3 je vaše volba, když potřebujete maximální výkon nebo vytváříte knihovny vyšší úrovně.
Není tak přátelský pro začátečníky jako Requests, ale je prověřený v boji a vysoce spolehlivý.
Klíčové vlastnosti:
- Sdružování připojení a bezpečnost vláken
- Jemná kontrola nad HTTP připojeními
- Používáno jako základ pro mnoho dalších knihoven
- Vysoký výkon pro opakované požadavky
Nejlepší pro: Vlastní HTTP klienty, vícevláknové crawlery a vývojáře, kteří staví na Python HTTP stacku.
Srovnávací tabulka: Balíčky Python pro web scraping na první pohled
| Balíček | Snadnost použití | Výkon | Dynamický obsah | Síla parsování | Komunita/Dokumentace | Nejlepší pro |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Rychlý (cloud/lokální) | Ano (přes AI) | Automatická pole, podstránky | Rostoucí (trend AI) | Generování leadů, průzkum trhu, uživatelé bez kódu |
| Beautiful Soup | ★★★★★ (snadné) | Střední | Ne | HTML/XML, tolerantní | Obrovská | Statické stránky, začátečníci |
| Scrapy | ★★☆☆☆ (strmé) | ★★★★★ (velmi vysoký) | Pouze pluginy | CSS/XPath, pipeline | Velká, aktivní | Rozsáhlý, opakovaný scraping |
| Selenium | ★★☆☆☆ (střední) | ★☆☆☆☆ (pomalé) | Ano (plné) | Plné DOM, JS | Zralá | Weby s velkým množstvím JS, interaktivní weby |
| PyQuery | ★★★★☆ (jQuery) | Rychlý (lxml) | Ne* | Selektory jQuery | Střední | Prototypování, vývojáři jQuery |
| LXML | ★★★☆☆ (pokročilé) | ★★★★★ (nejrychlejší) | Ne | XPath/CSS, XML | Střední | Velké dokumenty, pokročilé dotazy |
| Requests | ★★★★★ (velmi snadné) | ★★☆☆☆ (synchronní) | Ne | HTTP, JSON | Masivní | Jednoduché skripty, statické stránky |
| MechanicalSoup | ★★★★☆ (snadné) | ★★☆☆☆ (synchronní) | Ne | Formuláře, navigace | Malá | Přihlašovací toky, automatizace formulářů |
| Aiohttp | ★★☆☆☆ (asynchronní) | ★★★★★ (souběžné) | Ne | Asynchronní HTTP | Velká (asynchronní) | Vysokorychlostní, souběžný scraping |
| Twisted | ★☆☆☆☆ (komplexní) | ★★★★★ (vlastní) | Ne | Síťování, protokoly | Nika | Vlastní frameworky, pokročilí uživatelé |
| Grab | ★★★☆☆ (modulární) | ★★★★☆ (asynchronní) | Ne | Proxy, XPath | Malá | All-in-one, náročné na proxy/captcha |
| Urllib3 | ★★★★☆ (nízkoúrovňové) | ★★★★☆ (sdružené) | Ne | HTTP, sdružování | Masivní | Vlastní klienti, vícevláknové crawlery |
*PyQuery lze kombinovat se Selenium pro dynamické weby.
Jak vybrat správný balíček Python pro web scraping pro vaše potřeby
Co je scraping dat a jak na něj v roce 2026 Get Started Free
Takže, který balíček byste si měli vybrat? Zde je můj tahák:
- Statické stránky, malé úlohy, nebo jste noví ve scrapingu: Začněte s Requests + Beautiful Soup.
- Rozsáhlý, opakovaný nebo produkční scraping: Scrapy nebo Grab (pro all-in-one potřeby).
- Weby s velkým množstvím JavaScriptu nebo interaktivní weby: Selenium (nebo Thunderbit, pokud chcete scraping poháněný AI bez kódu).
- Vysokorychlostní, souběžný scraping: Aiohttp (pokud jste obeznámeni s asynchronním programováním).
- Automatizace formulářů nebo přihlašovací toky: MechanicalSoup (pro jednoduché weby), Selenium (pro složité JS).
- Pokročilé parsování nebo masivní dokumenty: LXML nebo PyQuery.
- Vlastní síťování nebo práce s protokoly: Twisted.
- Rychlé prototypování, generování leadů nebo chaotická/nestrukturovaná data: Thunderbit.
A nebojte se kombinovat – mnoho pracovních postupů kombinuje tyto nástroje pro maximální efektivitu. Například můžete použít Selenium k vykreslení stránky a poté předat HTML Beautiful Soup nebo PyQuery k parsování.
Závěr: Zrychlete svůj web scraping pomocí správných nástrojů Pythonu
Web scraping v roce 2026 je výkonnější – a potřebnější – než kdy jindy. Se správnými balíčky Python pro web scraping můžete chaos webu proměnit v čistá, použitelná data pro vaše podnikání, výzkum nebo další velký nápad. Ať už jste zkušený vývojář nebo teprve začínáte s daty, na tomto seznamu je nástroj, který vyhovuje vašim potřebám.
Pokud chcete vidět, jak vypadá scraping poháněný AI bez kódu, vyzkoušejte Thunderbit. A pokud toužíte po dalších tipech, hloubkových analýzách a tutoriálech, podívejte se na Thunderbit Blog pro nejnovější informace o web scrapingu, automatizaci a datově řízených pracovních postupech.
Vyzkoušejte Thunderbit AI Web Scraper
Šťastný scraping – a ať se vaše selektory vždy shodují, vaše proxy nikdy neselžou a vaše data jsou stejně čistá jako váš kód.
Často kladené otázky
1. Jaký je nejlepší balíček Python pro web scraping pro začátečníky?
Pro většinu začátečníků je kombinace Requests a Beautiful Soup nejsnadnější způsob, jak začít. Oba mají intuitivní API, spoustu tutoriálů a zvládnou většinu úloh scrapingu statických stránek.
2. Jak scrapovat weby s velkým množstvím JavaScriptu pomocí Pythonu?
Použijte Selenium k automatizaci skutečného prohlížeče, nebo vyzkoušejte Thunderbit pro scraping poháněný AI bez kódu, který zvládne dynamický obsah. Pro rozsáhlé potřeby lze Scrapy kombinovat se Splash nebo Selenium.
3. Který balíček je nejlepší pro rozsáhlý, vysokorychlostní scraping?
Scrapy je navrženo pro rozsáhlé, asynchronní procházení. Pokud potřebujete ještě větší rychlost a jste obeznámeni s asynchronním kódem, aiohttp je špičkovou volbou pro souběžné požadavky.
4. Mohu tyto balíčky kombinovat ve svém pracovním postupu?
Rozhodně! Mnoho vývojářů používá Requests nebo Selenium k načítání stránek a poté parsuje pomocí Beautiful Soup, lxml nebo PyQuery. Výstupy Thunderbitu lze vkládat do skriptů Pythonu pro další analýzu.
5. Je Thunderbit knihovna Pythonu nebo samostatný nástroj?
Thunderbit je rozšíření Chrome a platforma poháněná AI, nikoli tradiční knihovna Pythonu. Jeho výstup (CSV, Excel, Sheets, Notion, Airtable) se však bezproblémově integruje do datových pipeline Pythonu, což z něj činí výkonného společníka pro vývojáře Pythonu.
6. Nahrazují AI kódovací agenti knihovny Python pro scraping v roce 2026? Zatím ne, ale stojí za to o nich vědět. Nástroje jako Claude Code a OpenAI Codex dokážou během několika sekund vygenerovat funkční skript Requests + Beautiful Soup nebo Scrapy z jednoduchého anglického dotazu, což je skutečně užitečné pro jednorázové úlohy a prototypování. Pro toky prohlížeče v přirozeném jazyce (přihlášení, dynamický JS, vícestupňová navigace) je Browser Use open-source možností, po které lidé sahají, a Firecrawl je populární, když je cílem dodávat čistý markdown do LLM. Žádný z nich neodstraňuje ty těžké části – stále platí anti-bot obrana, omezení rychlosti a TOS – a pro produkční crawlery ve velkém měřítku Scrapy + aiohttp stále vítězí v nákladech a kontrole. Považujte AI agenty za rychlejší způsob, jak napsat scraper, nikoli za přímou náhradu knihoven na tomto seznamu.
Chcete zůstat v obraze ve světě web scrapingu? Přihlaste se k odběru Thunderbit YouTube Channel a sledujte Thunderbit Blog pro další průvodce, srovnání a tipy pro automatizaci.
Vyzkoušejte Thunderbit AI Web Scraper zdarma Get Started Free
Zjistěte více




