
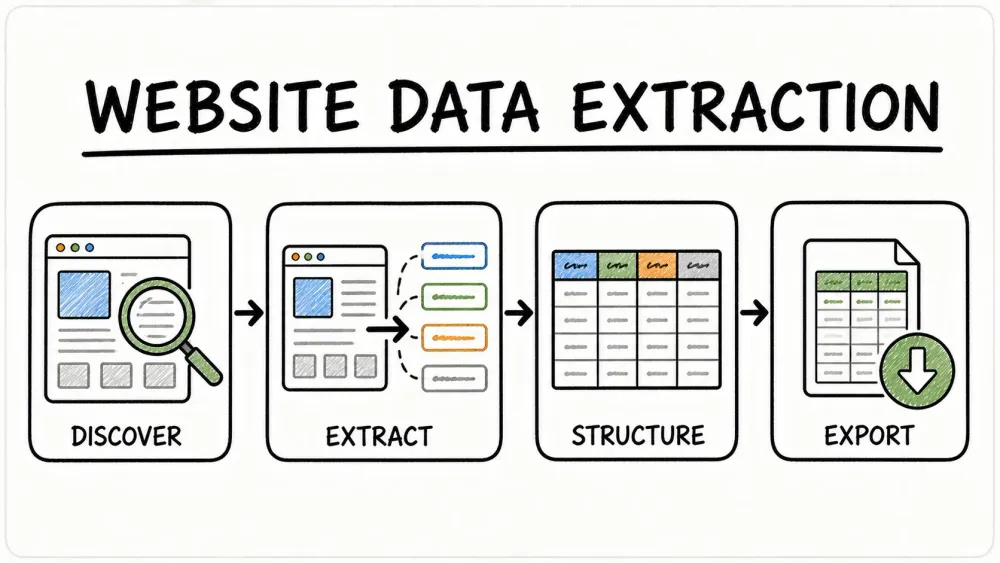
Web je přeplněný informacemi, ale proměnit tenhle chaos v použitelná byznysová data? Právě tam leží skutečná výzva — a zároveň i příležitost. Během let, kdy jsem stavěl SaaS a automatizační nástroje, jsem sledoval, jak se svět posouvá od rozhodování „od oka“ k řízení založenému na datech. Už nejde jen o technologické giganty; i malé týmy dnes závodí o to, jak získávat data z webových stránek pro podporu sales, marketingu, cenotvorby i produktových rozhodnutí. Jenže čím je web chaotičtější a dynamičtější, tím víc se z něj stává úplně nová disciplína: dostat z něj čistá, legální a opravdu užitečná data.
Pojďme na to prakticky: ukážu vám, proč je extrakce dat z webových stránek pro moderní firmy tak důležitá, jaké největší překážky vás čekají a jaké osvědčené postupy — včetně několika lekcí, které jsme si v Thunderbit poctivě odpracovali — vám pomohou dělat to správně, efektivně, bezpečně a ve velkém. Ať už pracujete s nestrukturovaným obsahem, řešíte GDPR, nebo už máte dost nekonečného kopírování a vkládání do tabulek, tenhle průvodce je přesně pro vás.
Proč je získávání dat z webových stránek pro moderní firmy tak důležité
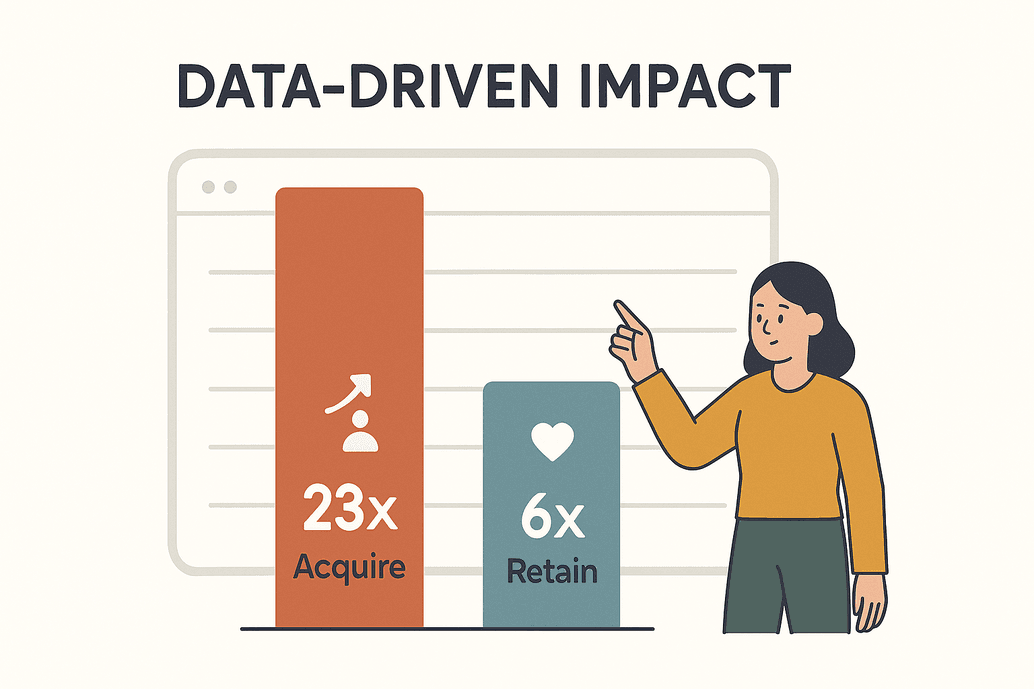 Data nejsou jen módní slovo — dnes jsou doslova krví konkurenčního byznysu. Podle průzkumu McKinsey mají organizace řízené daty 23× vyšší pravděpodobnost získání zákazníků a 6× vyšší pravděpodobnost jejich udržení. To není jen působivé — to je rozdíl mezi růstem a stagnací. Do roku 2025 budou firmy denně stahovat miliardy webových stránek, aby napájely analytiku, AI modely a rozhodování v reálném čase (kanhasoft.com).
Jak to vypadá v praxi? Tady je jen pár scénářů, které vídám každý týden:
| Byznysové využití | Popis a přínos | Příklad / statistika |
|---|---|---|
| Sledování cen | Sledujte ceny konkurence, skladovost a akce v reálném čase a upravujte vlastní strategii, abyste zůstali napřed. | Více než 80 % největších online prodejců denně získává ceny konkurence (kanhasoft.com). |
| Generování leadů | Získávejte z adresářů, sociálních sítí nebo recenzních webů nové kontakty a údaje o potenciálních zákaznících. | Automatizovaná extrakce dat plní CRM rychleji než jakýkoli ruční průzkum. |
| Analýza trendů na trhu | Shromažďujte recenze, fóra a zpravodajství, abyste včas odhalili trendy nebo změny nálady publika. | 26 % scrapingových aktivit se zaměřuje na sociální sítě kvůli trendovým insightům (blog.apify.com). |
| Agregace obsahu | Sběr novinek, produktových nabídek nebo událostí z více webů pro snadný přístup. | Mediální týmy kurátorsky skládají feedy pro své publikum. |
| Produktová a výzkumná data | Získávejte detaily produktů, recenze nebo výzkumné podklady pro analýzu a vývoj. | 67 % investičních poradců používá alternativní webová data (scrap.io). |
| Data pro AI trénink | Stahujte velké objemy textů, obrázků nebo záznamů pro trénování AI modelů. | Přibližně 70 % velkých AI modelů spoléhá na webová data získaná scrapingem (kanhasoft.com). |
Pokud data z webových stránek nezískáváte, nejste jen pozadu — pro svůj trh jste prakticky neviditelní. Viděl jsem e-commerce týmy, které během šesti měsíců ztrojnásobily ROI jen tím, že zautomatizovaly sběr cen konkurence (kanhasoft.com). Pointa je jasná: webová data jsou strategické aktivum a umět je dobře získávat je dnes naprostý základ.
Hlavní výzvy při získávání dat z libovolného webu
Samozřejmě, není to jen slunce a CSV soubory. Web je divoké prostředí a získávání dat z webových stránek přináší reálné překážky:
- Nestrukturovaná data: Přibližně 80 % online dat je nestrukturovaných — schovaných v nepřehledném HTML, rozptýlených na více stránkách nebo ukrytých za interaktivními prvky. Převést to do čisté tabulky není žádná maličkost (scrapingapi.ai).
- Měnící se weby: Stránky neustále mění rozložení. Viděl jsem scrapery, které přestaly fungovat 15× za jediný měsíc jen proto, že cílový web upravil design (scrap.io).
- Objem a škálování: Firmy potřebují získávat data ze stovek nebo tisíců webových stránek — často podle plánu. Ruční copy-paste to prostě nestíhá.
- Ochrany proti scrapingu: CAPTCHA, rate limit, přihlašovací brány… Weby jsou čím dál chytřejší v blokování botů. Už více než třetina veškerého webového provozu tvoří boti (scrap.io), a anti-bot technologie se rychle vyvíjejí.
- Ruční chyby: Lidské kopírování je pomalé a náchylné k chybám. Jediný špatný selektor a taháte nesprávná data — nebo žádná.
Tradiční přístupy prostě nejsou škálovatelné. Proto se stále více týmů obrací ke chytřejším a automatizovaným řešením (a proto jsem tak velký fanoušek AI nástrojů).
Právní, compliance a bezpečnostní postupy pro získávání dat z webu
Řekněme si to na rovinu: jen proto, že můžete z webu data získat, neznamená to, že byste měli — alespoň ne bez zohlednění právních a etických souvislostí. Tady je to, co by měl vědět každý byznys:
- Veřejná vs. soukromá data: Scraping veřejně dostupných informací je na mnoha místech obecně legální. Ale cokoli za přihlášením? To už je mimo hranice. Obcházení autentizace je jasné ne (xbyte.io).
- Podmínky použití: Vždy si zkontrolujte ToS daného webu. Pokud je scraping zakázaný, riskujete žalobu nebo blokaci. Když si nejste jistí, požádejte o povolení nebo použijte oficiální API.
- Pravidla ochrany soukromí (GDPR, CCPA): Pokud sbíráte osobní údaje, musíte mít právní základ (například oprávněný zájem), minimalizovat rozsah sběru a být připraveni data smazat na žádost. Nedodržení může znamenat vysoké pokuty (xbyte.io).
- Respektujte robots.txt: Není právně závazný, ale je to dobré chování. Dodržujte crawl-delay a nepřetěžujte servery.
- Bezpečnost dat: Ke scraped datům přistupujte jako k citlivým. Uchovávejte je bezpečně, omezte přístup a před použitím je vyčistěte.
Kontrolní seznam pro compliance:
| Oblast | Doporučený postup |
|---|---|
| Právní přístup | Získávejte pouze veřejná data; nikdy neobcházejte přihlášení (xbyte.io). |
| Podmínky použití | Projděte a respektujte ToS webu; pokud je scraping zakázaný, použijte API. |
| Osobní údaje | Pokud možno se jim vyhněte; pokud jsou nutné, minimalizujte je a dodržujte GDPR/CCPA. |
| robots.txt a crawl delay | Respektujte pravidla webu; omezte frekvenci požadavků. |
| Bezpečnost dat | Šifrujte, omezte přístup a mažte, když už data nejsou potřeba. |
Zvyšování efektivity: jak AI vylepšuje extrakci dat z webových stránek
Tady to začíná být opravdu zajímavé. AI úplně změnila pravidla hry při získávání dat z webových stránek. Místo zápasu se selektory nebo psaní křehkých skriptů můžete dnes použít AI nástroje, které stránku „přečtou“ a samy vymyslí, co z ní vytáhnout — často doslova na pár kliknutí.
Co to znamená v praxi?
- Minimální nastavení: AI scrapery jako Thunderbit umí automaticky rozpoznat pole. Stačí kliknout na „One Click Extract“ a nástroj navrhne správné sloupce — bez kódu a bez pokusů a omylů.
- Přizpůsobivost: AI scrapery nevidí jen pevné rozložení, ale rozpoznávají vzory. Když se web změní, AI se často přizpůsobí sama. To znamená méně údržby a méně nočních krizí.
- Přesnost: AI umí odfiltrovat šum, odstraňovat duplicity a dokonce čistit nepořádná data už během scrapingu. Některé týmy uvádějí přesnost až 99,5 % u AI extractorů (scrapingapi.ai).
- Dynamický obsah: AI scrapery zvládnou weby postavené na JavaScriptu, nekonečný scroll i extrakci textu z obrázků nebo PDF.
- Zpracování za běhu: Potřebujete data během scrapingu přeložit, zařadit do kategorií nebo shrnout? AI to zvládne v jednom průchodu.
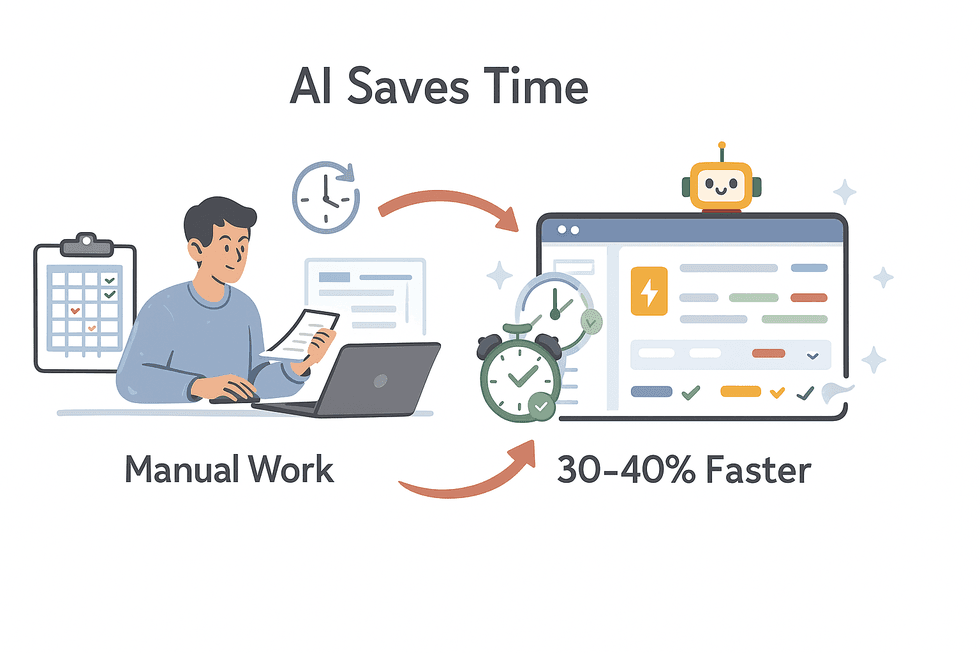 Viděl jsem týmy, které po přechodu na AI nástroje ušetřily 30–40 % času na extrakci dat (scrapingapi.ai). To není jen vyšší produktivita — to je konkurenční výhoda.
Získejte data z libovolného webu pomocí AI Agentic web scraper od Thunderbit sám přečte libovolný web a postupně vybere pole k extrakci jedním kliknutím po druhém. Get Started Free
Thunderbit je o tom, aby bylo získávání dat snadné, přesné a dostupné — i pro lidi, kteří nikdy nenapsali ani řádek kódu. (A ano, moje máma ho umí používat. Jen ještě trochu bojuje s Netflixem.)
Thunderbit Agentic Web Scraper: klíčové funkce pro byznys uživatele
Trochu se pochlubím tím, co jsme v Thunderbit vytvořili (hej, mám na to právo, ne?). Thunderbit je navržený pro byznys uživatele — sales, operations, marketing, reality — kteří chtějí výsledky, ne starosti. Tady je, čím vyniká:
- One Click Extract: Kliknete jednou a AI Thunderbitu projde stránku, navrhne sloupce a připraví scraper za vás. Žádné ladění selektorů.
- 2-Click Scraping: Jakmile jsou pole nastavená, stačí kliknout na „Scrape“ a získáte čistou tabulku — bez kódování a bez konfigurace.
- Scraping podstránek: Potřebujete víc detailů? Thunderbit může automaticky projít každou podstránku (například produktové nebo profilové stránky) a obohatit tabulku o další informace.
- Předpřipravené šablony: Pro populární weby (Amazon, Zillow, Instagram, Shopify atd.) stačí vybrat šablonu a můžete začít — bez nastavování.
- Export kamkoli: Bezplatný export do Excelu, Google Sheets, Airtable, Notion nebo CSV. Bez skrytých poplatků.
- Naplánované scrapování: Automatizujte opakované sběry — stačí popsat interval („každé pondělí v 8:00“) a Thunderbit se postará o zbytek.
- Scraping v cloudu nebo v prohlížeči: Použijte cloudové servery Thunderbitu pro rychlost, nebo vlastní prohlížeč u webů, které vyžadují přihlášení.
- Vícejazyčná podpora: Získávejte data ve 34 jazycích, včetně angličtiny, španělštiny, čínštiny a dalších.
Vyzkoušejte Thunderbit Agentic Web Scraper zdarma Bezplatný tarif zahrnuje 6 stránek měsíčně, bez nutnosti platební karty — ideální způsob, jak otestovat extrakci na vašem cílovém webu. Get Started Free
Automatizace a škálování: jak využít plánování a integrační nástroje pro získávání dat
Ruční scraping je tak rok 2015. Skutečná hodnota vzniká ve chvíli, kdy extrakci dat zautomatizujete a zapojíte do svých workflow:
- Plánované scrapování: Nastavte Thunderbit tak, aby spouštěl scraping denně, týdně nebo v jakémkoli intervalu, který potřebujete. Ideální pro sledování cen, lead generation nebo agregaci zpráv.
- Přímá integrace: Exportujte data rovnou do Google Sheets, Excelu, Airtable nebo Notion. Žádné stahování a znovunahrávání souborů.
- Integrace s CRM a analytikou: Posílejte data do CRM nebo BI nástrojů pro dashboardy v reálném čase, upozornění nebo automatizovaný outreach.
Příklad: automatizovaný workflow pro sledování cen
- Nastavíte Thunderbit na produktové stránce konkurence.
- Pomocí „One Click Extract“ zachytíte název produktu, cenu a URL.
- Naplánujete scraping na každé ráno v 7:00.
- Výsledky exportujete do Google Sheets napojených na dashboard.
- Pricing manažer zkontroluje změny a upraví strategii ještě dřív, než se konkurence probudí.
S automatizací nejste jen rychlejší — máte vždy aktuální data.
Nejlepší postupy pro práci s nestrukturovanými daty při získávání z webu
Přiznejme si to: většina webových dat není hezky srovnaná. Jsou nestrukturovaná, nekonzistentní a někdy prostě podivná. Takhle je dostanete pod kontrolu:
- Nechte AI definovat strukturu: Použijte One Click Extract nebo šablonu, aby do dat vnesly pořádek — AI si určí sloupce a datové typy a vy je případně doladíte.
- Field AI Prompts: Thunderbit vám dovolí přidat pro každé pole vlastní instrukce. Chcete produkty kategorizovat, formátovat telefonní čísla nebo překládat popisy? Stačí AI říct, co má udělat.
- Využijte NLP: U recenzí, komentářů nebo článků použijte vestavěné NLP funkce pro shrnutí, analýzu sentimentu nebo extrakci klíčových slov.
- Normalizujte data: Upravujte formáty (datumy, ceny, telefonní čísla) už při scrapingu, ne až potom. Konzistence je klíčová.
- Odstraňujte duplicity a validujte: Mažte duplicity a výsledky průběžně kontrolujte. Když něco nesedí, upravte prompty nebo nastavení.
Field AI Prompts: přizpůsobení extrakce dat pro lepší výsledky
Tohle je jedna z mých nejoblíbenějších funkcí. Pomocí AI promptů na úrovni jednotlivých polí můžete:
- Označovat a kategorizovat: „Zařaď tento produkt jako Electronics, Furniture nebo Clothing podle jeho popisu.“
- Vynutit formáty: „Výstupní datum ve formátu YYYY-MM-DD.“ „Vytáhni pouze číselnou cenu.“
- Překládat za běhu: „Přelož popis produktu do angličtiny.“
- Čistit šum: „Vytáhni uživatelský bio text a ignoruj odkazy typu ‚Read more‘ nebo reklamy.“
- Slučovat pole: „Spoj řádky adresy do jednoho pole.“
Je to, jako by váš scraper měl vestavěného junior analytika — jen bez stížností na pauzy na kávu.
Jak zajistit kvalitu a konzistenci dat při extrakci z webových stránek
Skvělé získávání dat nekončí kliknutím na „Export“. Takhle udržíte data čistá a spolehlivá:
- Validační kontroly: Používejte kontrolu rozsahu, povinná pole a unikátní klíče k odhalení chyb.
- Audit vzorků: Ručně porovnejte vzorek scraped dat se zdrojovým webem — hlavně po nastavení nebo po změnách webu.
- Zpracování chyb: Logujte neúspěšné scrapování a nastavte upozornění na anomálie (například náhlý pokles počtu řádků).
- Průběžné čištění: Používejte tabulkové nástroje nebo skripty k odstranění mezer, opravě kódování a normalizaci textu.
- Konzistence schématu: Udržujte názvy polí a formáty stabilní v čase. Změny dokumentujte, aby váš tým nemusel hádat.
Důvěra ve data je všechno. Trocha pečlivosti na začátku ušetří spoustu starostí později.
Podívejte se, jak si Thunderbit vede ve srovnání Podívejte se, kam Thunderbit se svou AI a extrakcí na jedno kliknutí zapadá mezi ostatní nástroje pro web scraping na trhu. Get Started Free
Srovnání nástrojů pro extrakci: na co se zaměřit při výběru řešení
Ne všechny nástroje pro web scraping jsou stejné. Tohle byste měli zvažovat:
| Nástroj | Silné stránky | Na co myslet |
|---|---|---|
| Thunderbit | Nejsnazší pro netechnické uživatele; AI rozpoznávání polí; scraping podstránek; předpřipravené šablony; bezplatný export; dostupné plány (Thunderbit Blog). | Není určen pro extrémně velké projekty s těžkým zapojením vývojářů; používá kreditní systém. |
| Browse AI | Bez kódu, dobré pro sledování změn; integrace s Google Sheets; hromadná extrakce. | Dražší vstupní plány; nastavení může zabrat čas. |
| Octoparse | Výkonný, zvládá dynamické weby; pokročilé funkce pro technické uživatele. | Strmější křivka učení; vyšší cena. |
| Web Scraper (webscraper.io) | Zdarma pro menší projekty; vizuální nastavení; silná komunita. | Ruční konfigurace může být matoucí; omezenější AI pomoc. |
| Diffbot | AI řešení přes API, které parsuje nestrukturované stránky; skvělé pro vývojáře. | Drahé, API-based, nevhodné pro netechnické uživatele. |
Moje rada: Pokud jste byznys uživatel a chcete rychlé a přesné výsledky, Thunderbit je skvělá volba. Pro power users nebo vývojáře může stát za zvážení Octoparse nebo Diffbot, i když jsou složitější. Než se rozhodnete, vždy si vyzkoušejte free verzi nebo trial.
Závěr: jak uvést osvědčené postupy extrakce dat z webu do praxe
Získávání dat z webových stránek už dávno není „hezké plus navíc“ — je to nutnost pro každou firmu, která chce zůstat konkurenceschopná. Tohle je to hlavní, co si z článku odnést:
- Hodnota: Webová data pohánějí chytřejší a rychlejší rozhodování. Nenechávejte je ležet ladem.
- Překonání výzev: Používejte AI nástroje pro práci s nestrukturovanými daty, objemem i změnami webu.
- Zůstaňte legální: Respektujte zákony o ochraně soukromí, pravidla webů i bezpečnost dat.
- Automatizujte: Naplánujte a integrujte extrakci do každodenních workflow.
- Kvalita na prvním místě: Data validujte, čistěte a sledujte, aby byla dlouhodobě důvěryhodná.
Chcete si vyzkoušet, jak snadné to může být? Stáhněte si rozšíření Thunderbit pro Chrome a otestujte ho na svém dalším datovém projektu. A pokud chcete jít ještě hlouběji, podívejte se na Thunderbit Blog, kde najdete další návody, tipy a reálné příklady.
Přeji úspěšný scraping — a ať jsou vaše data vždy strukturovaná, v souladu s pravidly a připravená k akci.
Začněte získávat data s Thunderbit Nainstalujte si bezplatné rozšíření Thunderbit pro Chrome a začněte jedním kliknutím získávat strukturovaná data z libovolné stránky. Get Started Free
Často kladené dotazy
1. Je legální získávat data z libovolného webu?
Obecně je scraping veřejně dostupných dat v mnoha jurisdikcích legální, ale nesmíte obcházet přihlášení nebo bezpečnostní opatření. Vždy si projděte podmínky webu a dodržujte zákony na ochranu soukromí, jako jsou GDPR a CCPA (xbyte.io).
2. Jak AI zlepšuje proces získávání dat z webových stránek?
AI nástroje jako Thunderbit umí automaticky rozpoznat pole, přizpůsobit se změnám rozložení, čistit a formátovat data a zvládnout i dynamický obsah nebo překlady — to vše s minimálním nastavením a vysokou přesností (scrapingapi.ai).
3. Jaké jsou nejlepší postupy pro práci s nestrukturovanými daty?
Předem si definujte datovou strukturu, používejte AI prompty na úrovni polí pro řízení extrakce, normalizujte formáty už během scrapingu a výsledky ověřujte. Nástroje jako Thunderbit usnadňují kategorizaci, formátování i popis dat za běhu.
4. Jak mohu automatizovat a škálovat získávání dat z webu?
Používejte plánování pro pravidelné spouštění scrapingu a výstupy napojujte přímo do nástrojů jako Google Sheets, Airtable nebo vaše CRM. Automatizace zajistí, že data budou čerstvá, a zároveň sníží ruční práci.
5. Jak zajistím kvalitu a konzistenci získaných dat?
Zaveďte validační kontroly, pravidelně auditujte vzorky, chybové stavy řešte elegantně a dlouhodobě držte konzistentní schéma. Průběžné zlepšování a monitoring jsou klíčem ke spolehlivým datům.
Chcete si tyto postupy vyzkoušet v praxi? Vyzkoušejte bezplatnou verzi Thunderbit a uvidíte, jak snadné, legální a škálovatelné může být získávání webových dat.
Vyzkoušejte Agentic Web Scraper Get Started Free
Zjistěte více




