
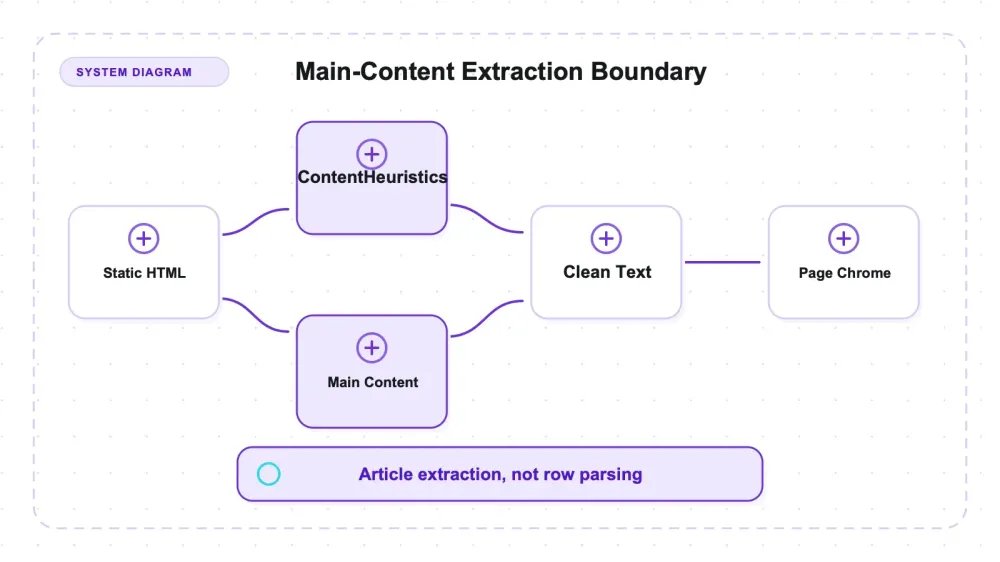
trafilatura هو مستخرج محتوى بلغة Python يعمل بلا متصفح. وفي الملفات التجريبية الموسومة في هذا المقال، منافسه الوحيد على جودة الاستخراج من نفس HTML هو Mozilla Readability: سرّب trafilatura وحدة واحدة فقط من أصل 17 وحدة boilerplate موسومة، بينما سرّبت Readability خمس وحدات. الأدوات المعتمدة على متصفح ظهرت فقط في سياق البصمة النشرية ولم تُختبر جودتها على هذه الصفحات.
مهمته الأساسية هي استخراج المحتوى الرئيسي: تُدخل HTML وتحصل على نص موجّه للمقالة وبيانات وصفية، مع تصفية عناصر الصفحة الزائدة عبر قواعد استدلالية (heuristics). يمكنه تسلسل المخرجات كـJSON وصيغ أخرى، لكنه لا ينتج مخططًا صفيًا يحدده المستخدم ولا سجلات كتالوج مكررة ومصنّفة. تم اختبار الإصدار 2.1.0. لا يشغّل جافاسكريبت، وتُظهر مقارنته مع Readability مقايضة بين الدقة والاحتفاظ بالمحتوى، لا تفوقًا شاملًا في كل الفئات.
أين يقع trafilatura، وما الذي يرفض القيام به
يصف trafilatura نفسه كأداة Python وسطر أوامر لجمع النصوص والبيانات الوصفية من الويب، عبر الزحف والاستخراج والكشط، مع مخرجات بصيغة CSV أو JSON أو HTML أو Markdown أو TXT أو XML. هذا عرض واسع. لكن عمليًا، الجزء الذي يحمل الأداة أضيق وأوضح: يأخذ مستند HTML ويعيد المحتوى الرئيسي فقط، بعد تجريده من عناصر الصفحة المحيطة.
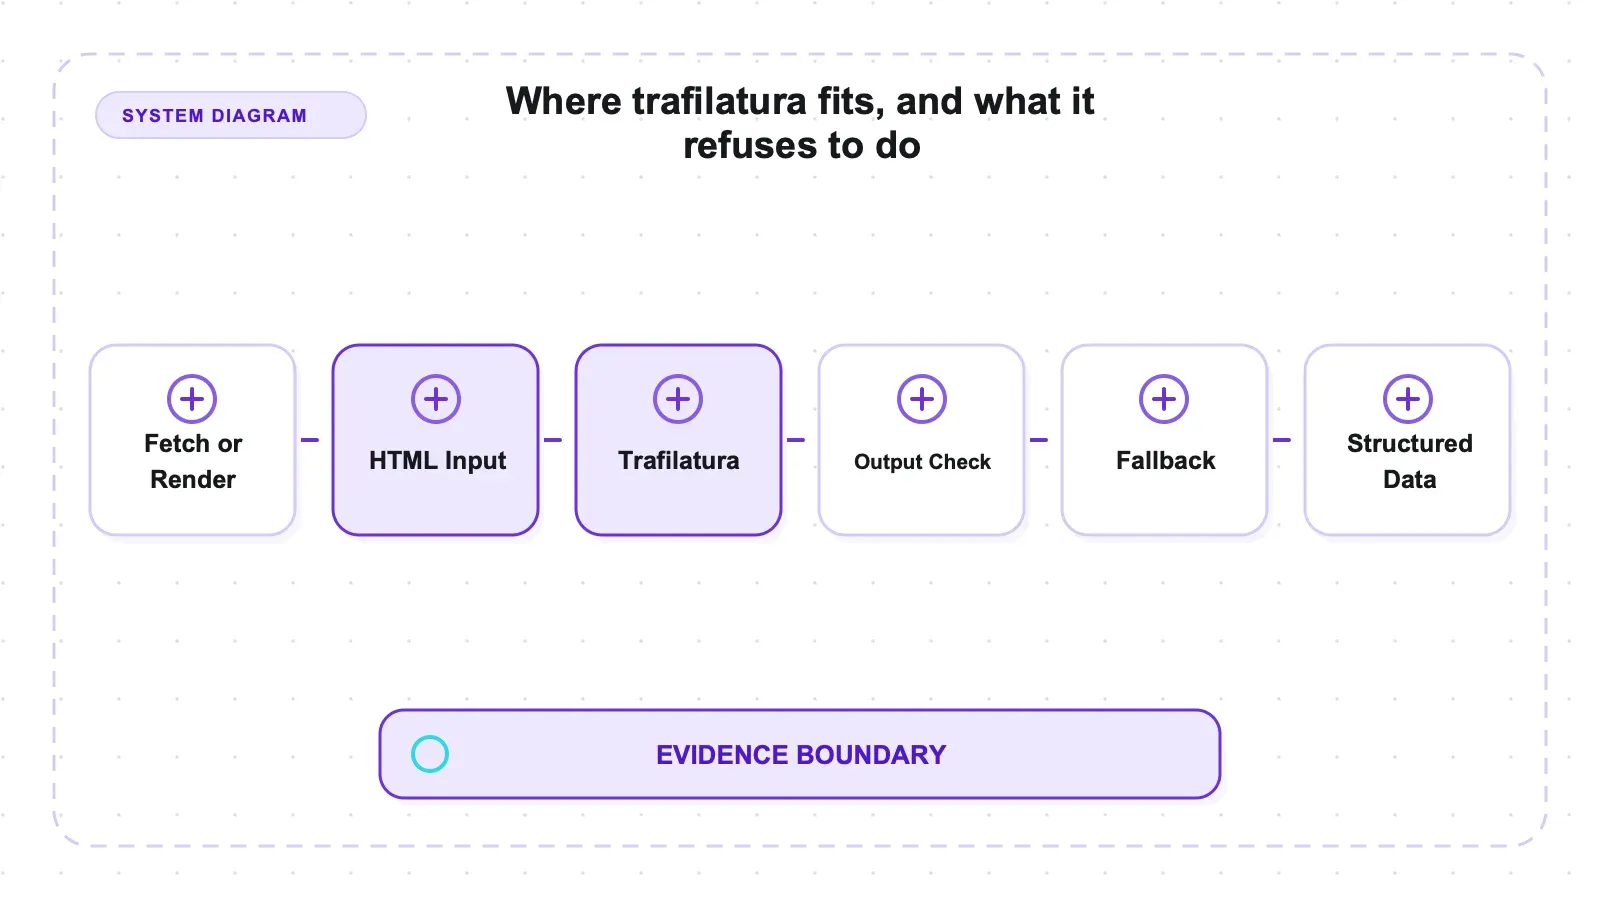
إليك النموذج الذهني، لأنه يفسّر القوة والحد معًا. معظم أدوات الكشط التي توجهها نحو صفحة تعتمد على محددات (selectors): تخبرها "أحضر العنصر ذا الفئة product-price"، فتعيد لك أيًا كان الموجود في ذلك الموضع. أما trafilatura فيعمل بالاتجاه المعاكس: يقرأ المستند بأكمله ويقرر أي الكتل هي المقالة الفعلية وأيها مجرد عناصر زائدة، معتمدًا على قواعد استدلالية للمحتوى لا على محدد كتبته أنت. لهذا لا يحتاج قواعد خاصة بكل موقع لتنظيف صفحة. ولهذا السبب بالتحديد لا يمكنه تسليمك كتالوجًا منظمًا: لا يوجد مخطط، ولا صفوف مصنّفة، فقط "هذا هو النص المهم". إنه مستخرج، لا مُحلِّل توجّهه أنت.
كما أنه لا يتطلب تنزيل بيئة تشغيل متصفح منفصلة. شجرة الاعتماديات تتضمن حزم منصّة مثل lxml، لذا لا ينبغي الخلط بين "لا تنزيل متصفح" وبين تثبيت مصدري بحت أو خالٍ من الكود الأصلي.
الإعداد: بصمة اعتماديات صغيرة، بلا تثبيت متصفح
تنفيذ pip install trafilatura في بيئة افتراضية جديدة على Python 3.14 ثبّت 17 حزمة؛ وكان أكبر wheel مسجّل هو lxml بحجم 8.6 ميغابايت، وفق سجل pip-install-trafilatura.log. لم يُطلب أي تثبيت منفصل لمتصفح ولا أي أمر متصفح بعد التثبيت.
للمقارنة، احتاجت حزمة Scrapling في قاعدة البحث نفسها أربع استدعاءات pip منفصلة لتشغيل أدوات الجلب لديها، وانتهت عند 26 حزمة، اثنتان منها wheels لمشغّل Playwright بحجم 42.2 ميغابايت (tools/scrapling/artifacts/logs/pip-install-scrapling.log)، وهذا قبل تنزيل أي ملف تنفيذي للمتصفح. أما حزمة Crawlee فقاست تنزيل Chromium المنفصل عند نحو 81.7 ميبيبايت (tools/crawlee/research-materials.md). تلك الأدوات تؤدي عملًا أكبر، فهذه ليست منافسة عادلة من حيث القدرات؛ إنها فقط ما يظهر فعليًا في قرصك وذاكرة تخزين CI المؤقتة. والإصدار الذي أعطاني إياه pip (2.1.0) يساوي أحدث إصدار حاليًا، فلا توجد أي ملاحظة "اختبرت شيئًا قديمًا" على أي من الأرقام أدناه.
التجربة العملية: ماذا أعاد المستخرج فعليًا
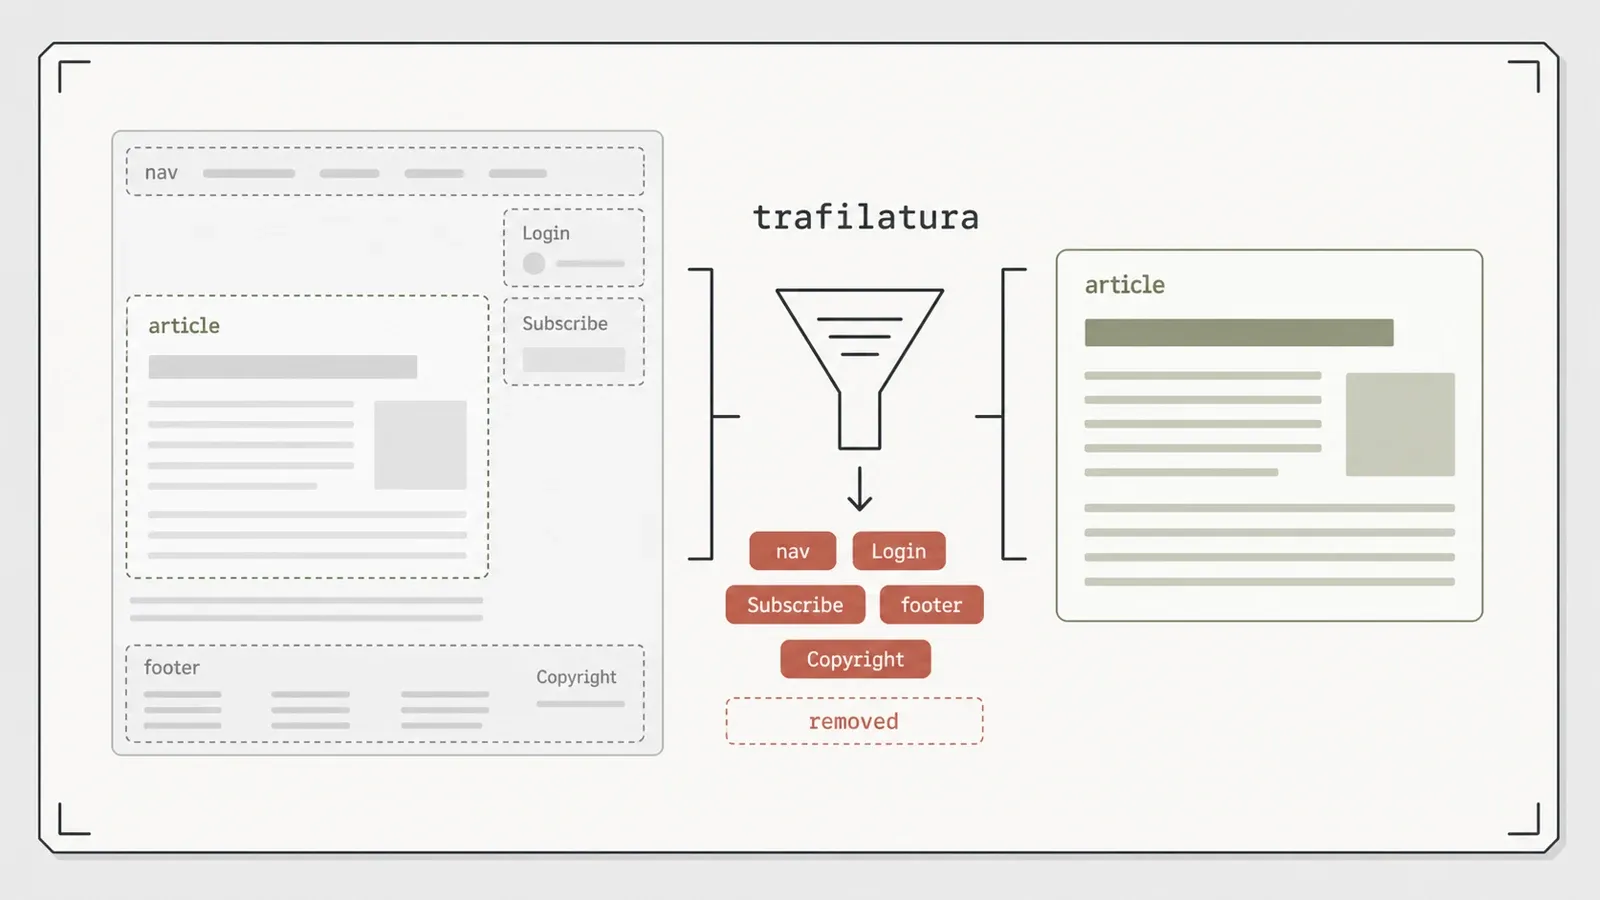
شغّلته على ملفات تجريبية مصممة لاختبار نقطة قوته وحدوده معًا، مع حفظ المخرجات الخام في مستودع القياس المرجعي. اختبار المقالة هو ما أقنعني فعلًا.
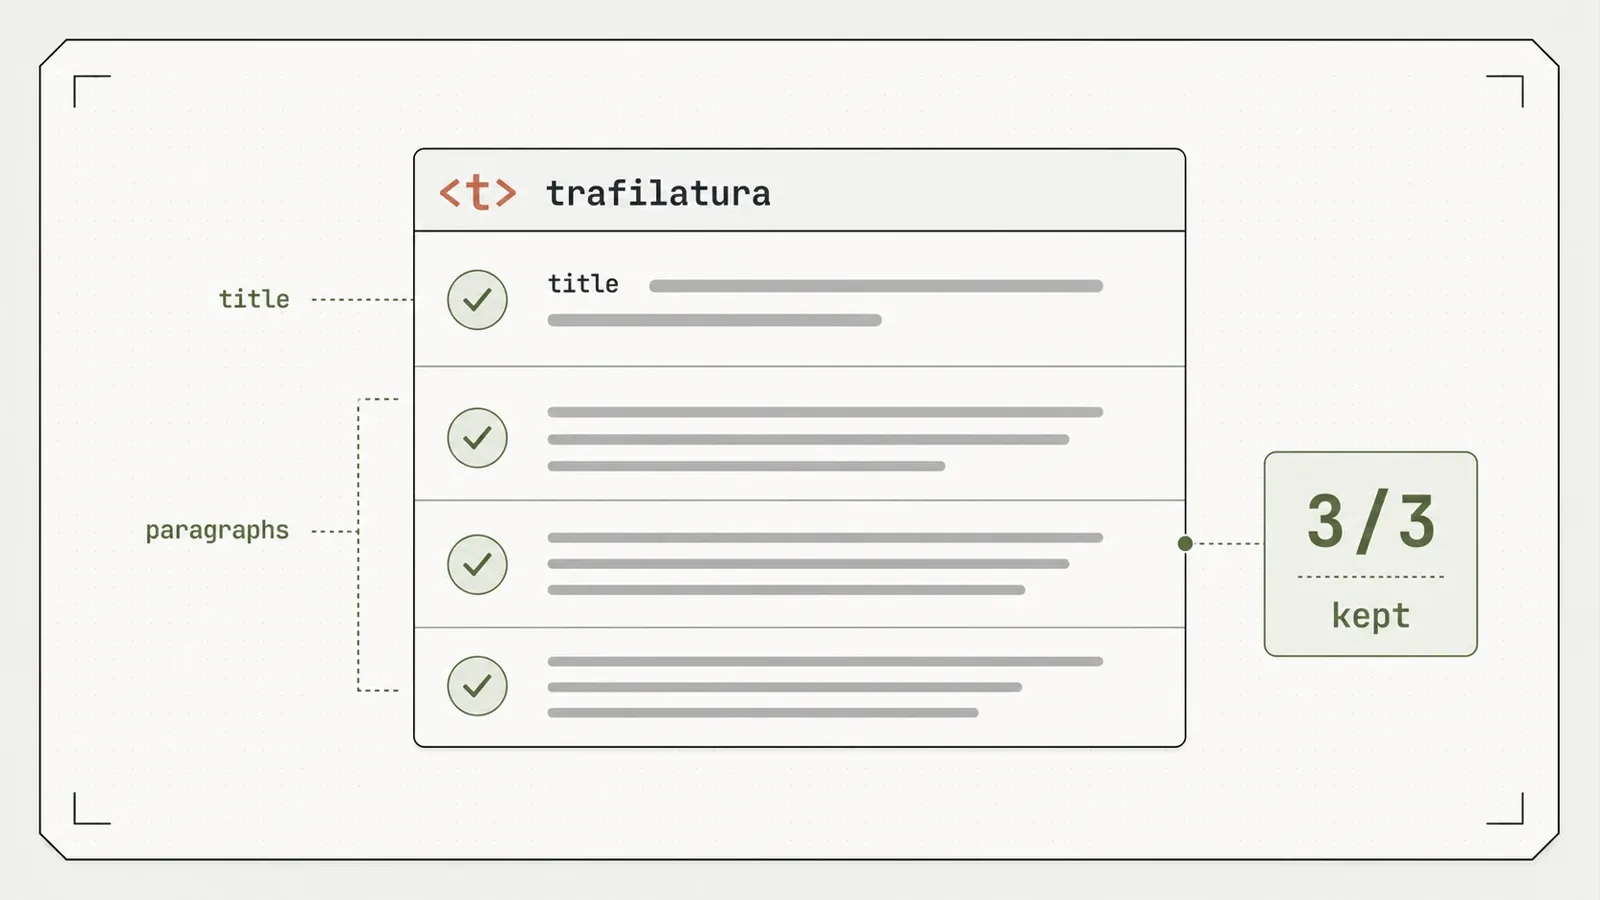
أخذت ملف مقالة محلية وغلّفت المحتوى الحقيقي بضجيج: مطالبة تسجيل دخول، تنبيه "اشترك"، روابط تنقّل، تذييل حقوق النشر؛ وهي العناصر الزائدة القياسية التي تجرها أداة ساذجة مع النص الأساسي. أعاد trafilatura العنوان بالإضافة إلى الفقرات الثلاث من أصل ثلاث كاملة، وكل واحدة من علامات العناصر الزائدة تلك — تسجيل الدخول، الاشتراك، حقوق النشر — اختفت من المخرجات. وفوق ذلك، استخرج الكاتب والتاريخ بشكل صحيح من البيانات الوصفية للصفحة. النتيجة الكاملة، عبر صيغ .txt و.md و.json، موجودة في results/local_article.json.
صُدِّر نفس ملف HTML المحفوظ كنص عادي وMarkdown وJSON. لا يثبت المقال أن الصيغ الثلاث نتجت عن استدعاء واحد متزامن؛ بل هي تمثيلات بديلة لمسار الاستخراج نفسه. الـJSON هنا يحزم النص والبيانات الوصفية المستخرجة، لا سجلات مكررة يحددها المستخدم.
إليك التشغيلة الأولى كاملة في مكان واحد، لتتحقق من الادعاءات أعلاه بنفسك بدلًا من تصديقها فقط:
| الملف التجريبي | ما الذي عاد | زمن التنفيذ | الدليل |
|---|---|---|---|
| مقالة محلية، مغلفة بتنقّل / تسجيل دخول / اشتراك / حقوق نشر | العنوان + 3/3 فقرات، صفر تسريب لعناصر زائدة، الكاتب Thunderbit Research Lab، التاريخ 2026-07-09 | 0.007 ثانية | local_article.json |
| كتالوج منتجات محلي | 12 اسم منتج و12 سعرًا كنص مسطّح، 0 صفوف منظمة، 478 حرفًا | 0.064 ثانية | local_catalog_extraction.txt |
| صفحة تعيد HTTP 500 | fetch_url أعاد None، بلا استثناء | 30.012 ثانية | local_failure_500.json |
| صفحة منتج من Books to Scrape (عامة) | 1,324 حرفًا من نص نظيف، بالإضافة إلى نسخة Markdown مطابقة | 0.753 ثانية | public_books_product.txt / .md |
كل صف مأخوذ من artifacts/raw/trafilatura-test-summary.json داخل حزمة trafilatura — الإصدار 2.1.0، Python 3.14، macOS arm64، تشغيلة واحدة على جهاز واحد. عامل الأوقات كملاحظات لا كقياس مرجعي رسمي.
في ملف 500، أعاد fetch_url القيمة None بعد نحو 30 ثانية بينما استجابت نقاط النهاية المحلية القريبة بسرعة. تثبت هذه التجربة وجود تأخير، لا سببه، سواء كان إعادة محاولة أو backoff أو مهلة ثابتة أو مسارًا داخليًا آخر. لم يتحقق هذا المقال من وجود معامل مهلة مدعوم لكل استدعاء في fetch_url؛ الضابط المُثبت هو الجلب عبر عميل يتحكم فيه المستدعي ثم تمرير HTML الناتج إلى trafilatura.
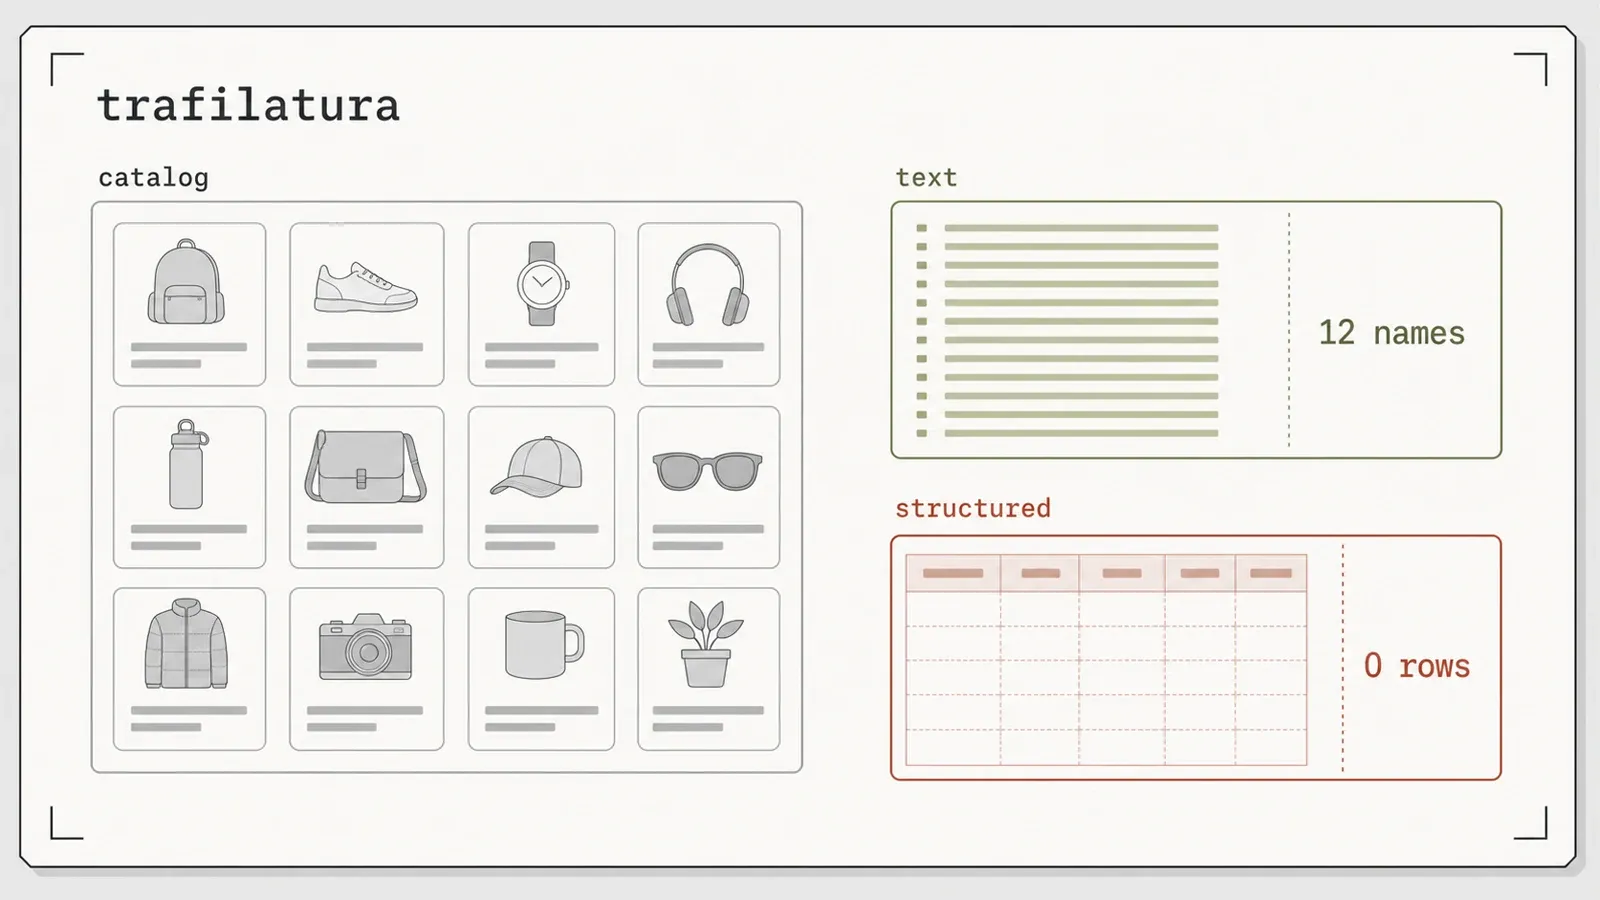
الاختبارات نفسها تكشف أيضًا ثلاثة حدود.
الأول والأهم: trafilatura مستخرج محتوى، لا أداة كشط منظمة. شغّلته على ملف تجريبي لكتالوج منتجات. أعاد كل 12 اسم منتج — كنص — وصفر صفوف منظمة بالضبط (478 حرفًا من نص مسطّح، وفق ملف results/local_catalog_extraction.txt). ظهرت الأسعار أيضًا، من $18.00 إلى $51.00، على سطور منفصلة تحت كل اسم. كل ما تريده موجود في المخرجات؛ لكن لا شيء منه حقل. إن كنت تحتاج [{name, price, rating}, …]، فهذه ليست الأداة المناسبة، ولا يغيّر أي إعداد هذه الحقيقة؛ إنه خيار تصميم، لا خلل.
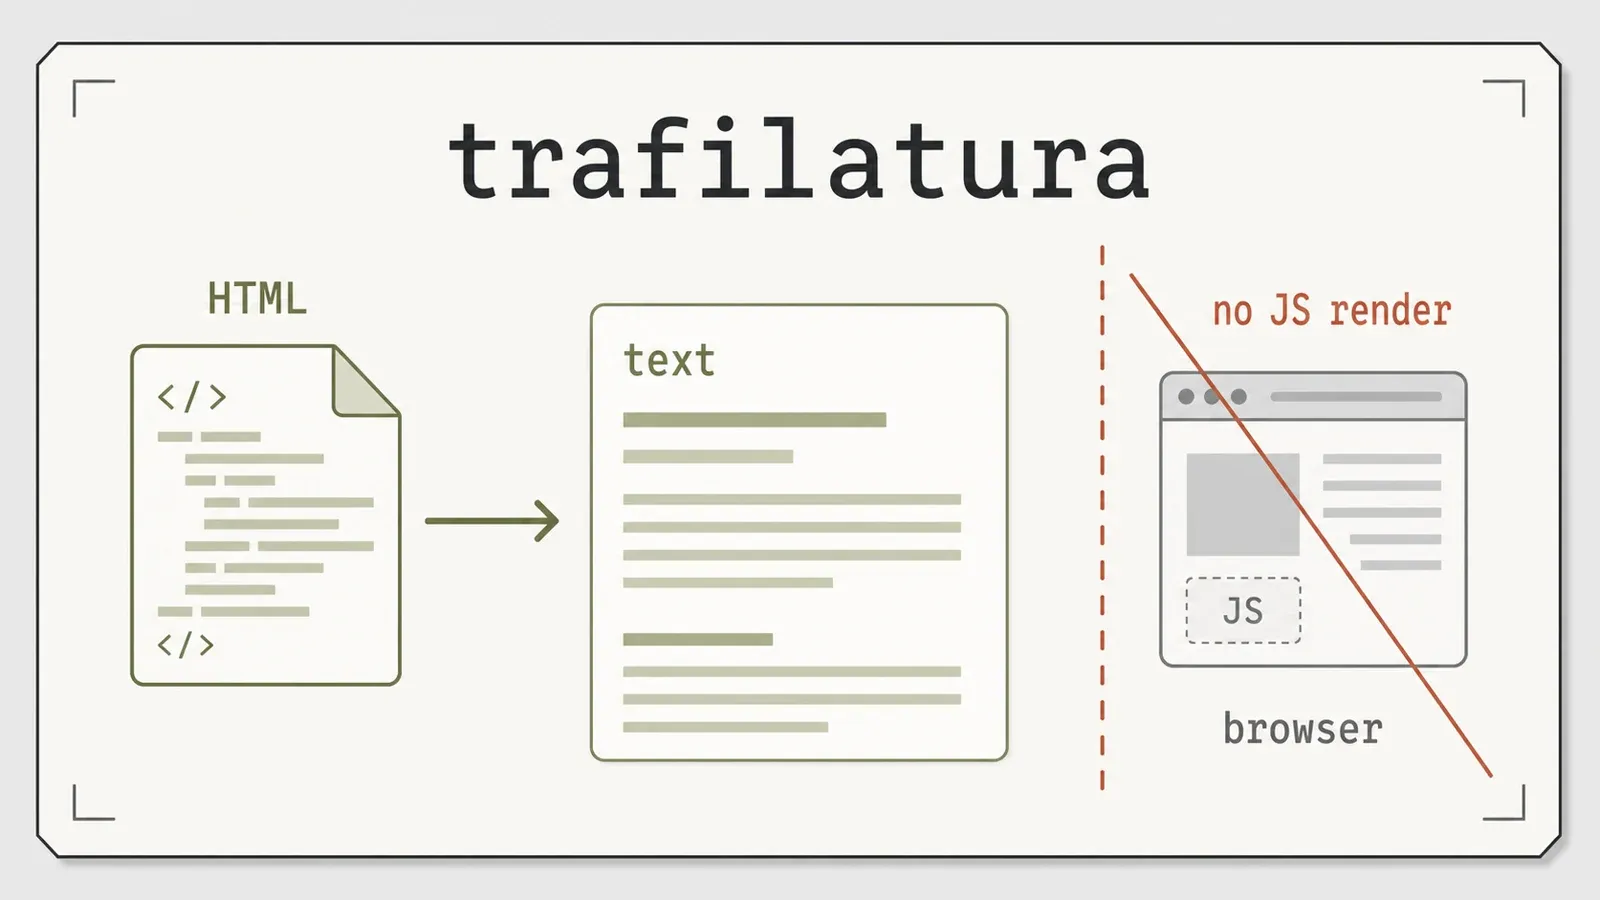
الثاني: لا يعرض جافاسكريبت. يستهلك HTML الثابت فقط. وجّهه إلى صفحة تُعرض من جهة العميل وستحصل على ما أرسله الخادم قبل تشغيل الجافاسكريبت، وهو غالبًا لا شيء مفيد. اقرنه بمحرّك عرض إن كانت أهدافك تعتمد بكثافة على JS؛ فـtrafilatura لن يقوم بذلك النصف من العمل نيابةً عنك.
ثالثًا، تحفظ على دليلي الخاص: أول اختبار استخراج عام استخدم كتلة وصف منتج، لا مقالة إخبارية حقيقية، لأن بيئة الاختبار العامة لا تحتوي صفحات أخبار. نتيجة تنظيف المقالة أعلاه جاءت من ملف تجريبي محلي مضبوط. أثق بها؛ فإزالة العناصر الزائدة كانت واضحة لا لبس فيها؛ لكنني لم أكن مستعدًا لتقديم صفحة منتج كدليل على استخراج بمستوى غرفة الأخبار، لذا بقيت هذه الحزمة فجوة مفتوحة. تشغيلة متابعة في 2026-07-14 أغلقت هذه الفجوة، والنتائج في القسم التالي.
فحص سلامة إزالة العناصر الزائدة على صفحات حقيقية
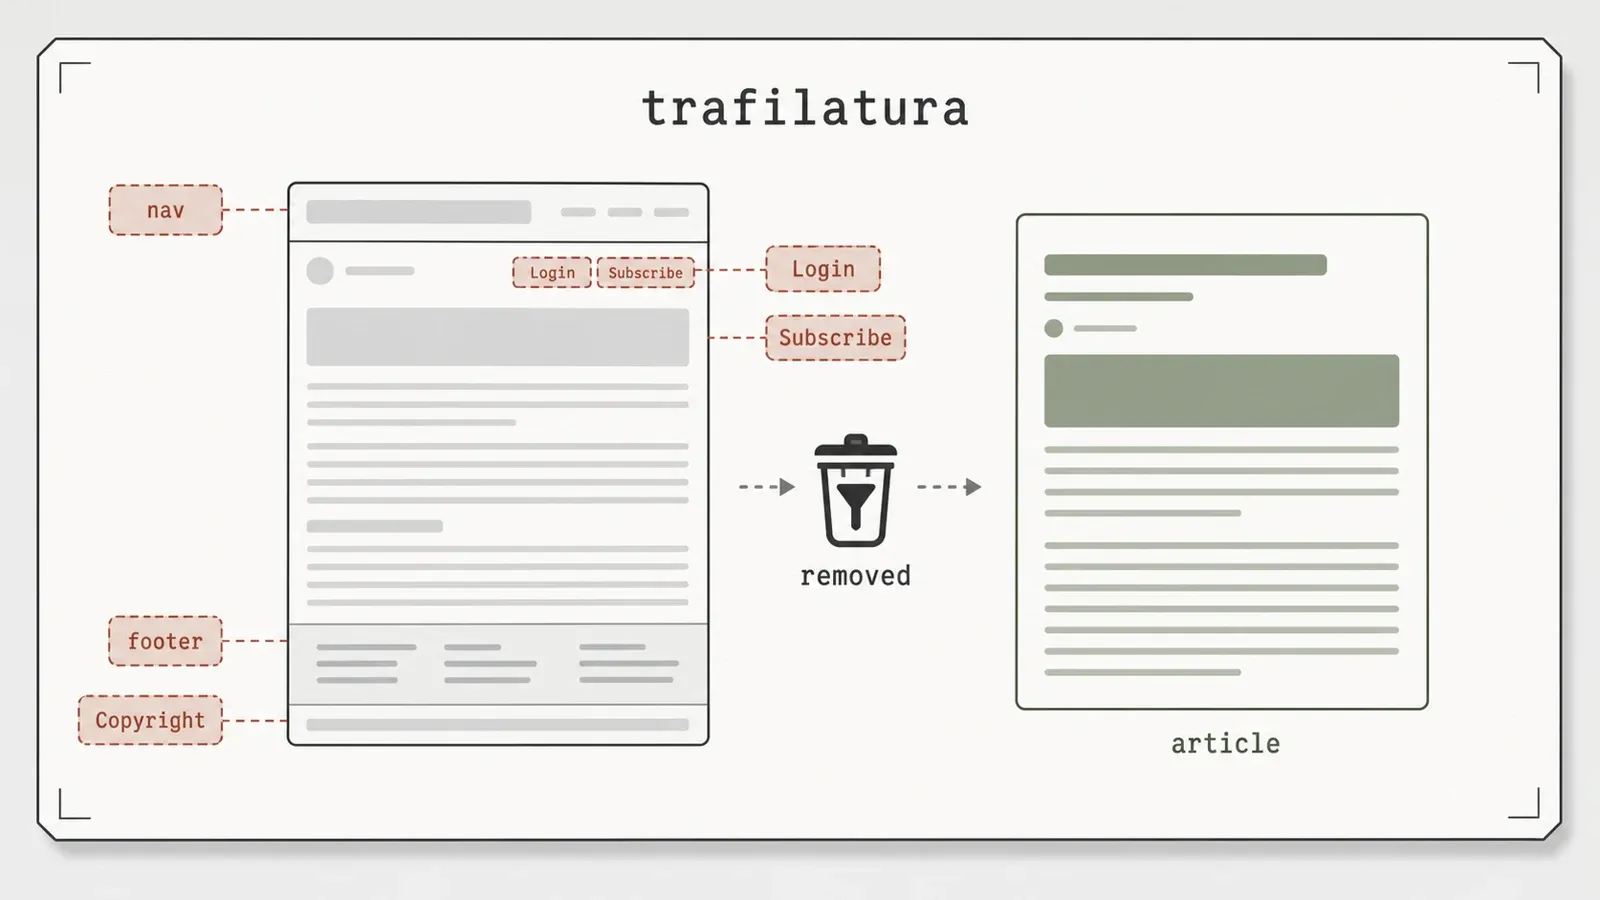
جُلبت صفحتان حقيقيتان مرة واحدة، وحُفظتا كملفات تجريبية دون اتصال بتجزئات SHA-256، وأُعيد تشغيلهما دون وصول للشبكة. لم يُسجَّل أي توقيت ولا حقيقة ميدانية موسومة. هذا فحص سلامة لإزالة العناصر الزائدة على صفحة حقيقية، لا درجة دقة.
| الملف التجريبي الحقيقي | HTML الخام | المحتوى المستخرج | نسبة المحتوى/الخام | علامات عناصر الصفحة المُزالة | العنوان | التاريخ | المضيف | الكاتب | اسم الموقع |
|---|---|---|---|---|---|---|---|---|---|
| ويكيبيديا، "Web scraping" | 230,049 بايت | 26,673 بايت | 0.116 | 4 من 4 | نعم | 2005-09-17 | wikipedia.org | null | null |
| ويكي نيوز، "7th Heaven" (مؤرشفة) | 79,716 بايت | 2,200 بايت | 0.028 | 5 من 5 | نعم | 2005-11-29 | wikinews.org | null | null |
كلا الصفين مأخوذ من artifacts/results/trafilatura-fidelity-summary.json. العلامات التي جرى فحصها كانت "Jump to content" و"Privacy policy" و"Powered by MediaWiki" و"This page was last edited"، بالإضافة إلى "free news source" على صفحة ويكي نيوز — جميعها أُزيلت، ولم يتسرب أي منها في الصفحتين.
نسبة المحتوى/الخام تقيس التقليص لا الدقة؛ لم يُقيَّم المحتوى المحذوف من المقالة. كان author وsitename فارغَين (null) في قالبَي MediaWiki هذين، بينما وفّر الملف التجريبي المحلي المضبوط اسم كاتب. هذا إخفاق خاص بقالب MediaWiki لوحظ في الاختبار، لا دليل على موثوقية استخراج الكاتب عمومًا. التواريخ المستخرجة مذكورة كما أعادها البرنامج ولم تُتحقَّق مقابل حقيقة ميدانية.
مستخرجان، نفس بايتات HTML، سكربت تسجيل واحد
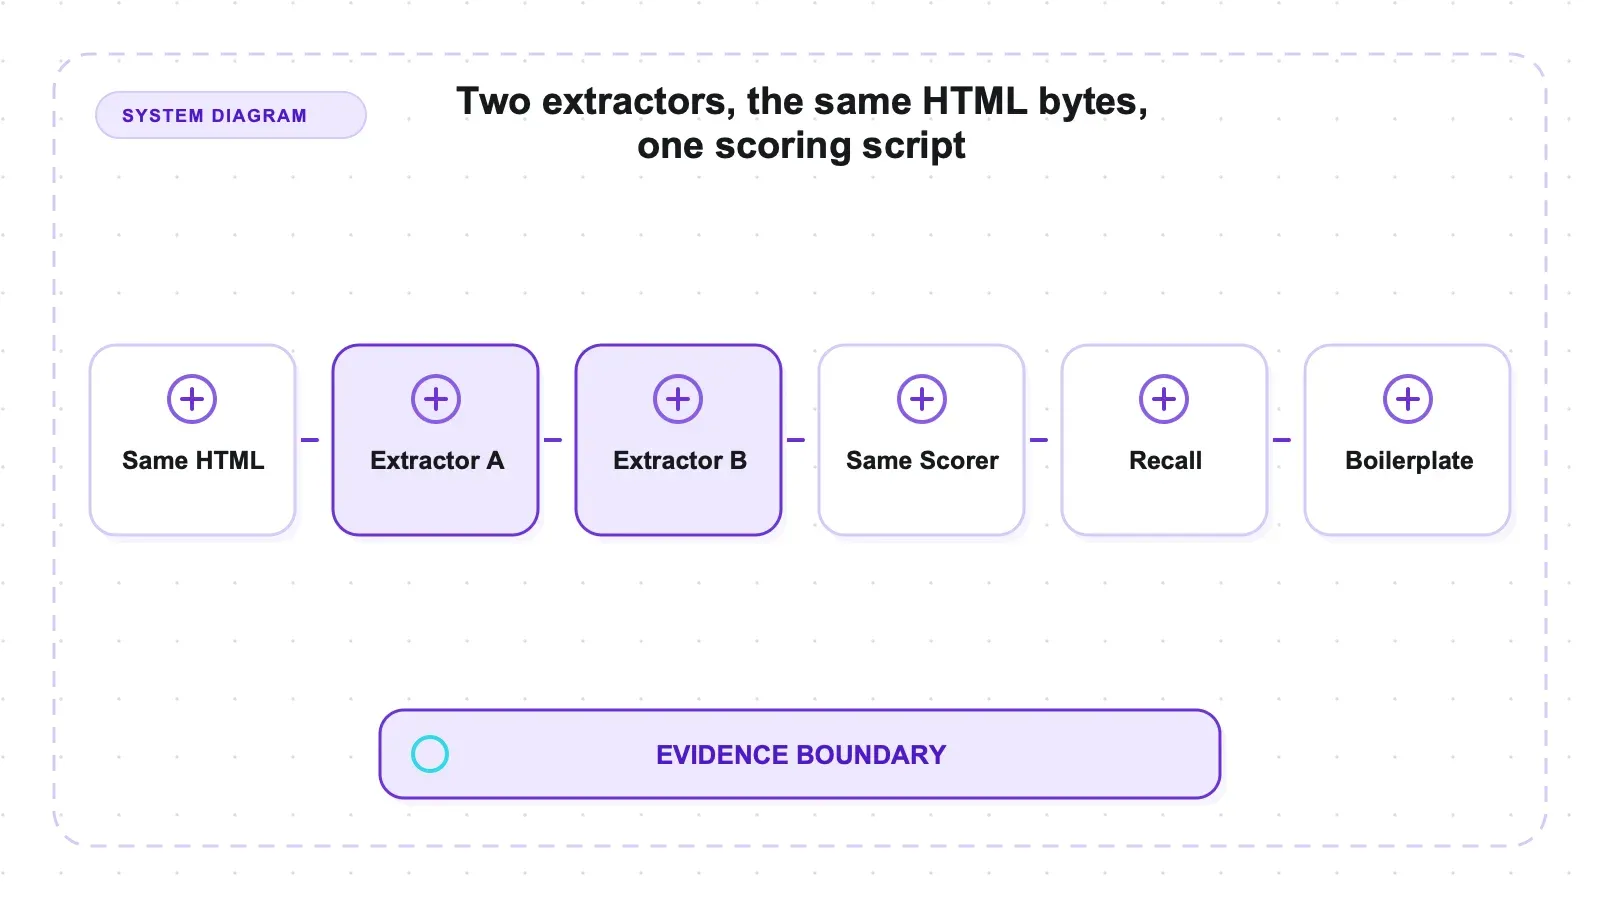
توجد مقارنة واحدة فقط بين trafilatura وأداة أخرى على نفس بيئة الاختبار في قاعدة البحث هذه، ولم تبنِها حزمة trafilatura نفسها. من بناها هي حزمة mozilla-readability، كذراع تحكّم: 22 ملفًا تجريبيًا موسومًا يدويًا حيث تُوسم كل كتلة نصية بـARTICLE أو BOILERPLATE، وتحمل كل كلمة رمزًا فريدًا، بحيث تُرجَع كل كلمة مستخرجة إلى الكتلة الموسومة المحددة التي جاءت منها. كلا الأداتين تلقتا بايتات HTML متطابقة. عمل Readability تحت jsdom 29.1.1 على Node v22.22.3؛ بينما استخدم trafilatura محلله الخاص.
| المقياس (متوسط دقيق، مجموعة دقة المحتوى) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | الدليل |
|---|---|---|---|
| وحدات المقالة المستعادة | 40 من 40 | 40 من 40 | comparison.json |
| وحدات العناصر الزائدة المسرّبة | 1 من 17 | 5 من 17 | comparison.json |
| رموز العناصر الزائدة الملوِّثة للمخرجات | 3 | 41 | comparison.json |
| دقة الرموز | 0.939 | 0.902 | comparison.json |
| F1 للرموز | 0.969 | 0.948 | comparison.json |
استدعاء المحتوى غير النثري، ملف f6_nonprose | 7 من 8 | 8 من 8 | comparison.json |
مقالة قصيرة جدًا، F1 لملف f3_short_120 | 0.571 | 0.800 | comparison.json |
المصدر: tools/mozilla-readability/artifacts/raw/comparison.json في قاعدة البحث هذه — 11 ملفًا تجريبيًا في مجموعة دقة المحتوى، و40 وحدة مقالة و17 وحدة عناصر زائدة. هذه ملفات تجريبية اصطناعية موزونة عمدًا نحو الحالات العدائية، فاقرأها كآلية عمل لا كترتيب على مجموعة بيانات حقيقية.
لا تتخلص أي أداة من كل الضجيج، والفارق بينهما هو الجزء المثير للاهتمام. يبقي trafilatura العناصر الزائدة خارج المخرجات أكثر: كتلة واحدة مسرّبة مقابل خمس لدى Readability، وثلاثة رموز ملوِّثة مقابل 41. هذا هو نصف "الدقة" من معادلة "نص المقالة النظيف"، وهو النصف الذي يقرر ما إذا كانت نافذة سياق نموذجك اللغوي ستمتلئ بروابط الشريط الجانبي. لكن Readability يستعيد محتوى يتخلص منه trafilatura: في الملف غير النثري، أسقط trafilatura وسم <figcaption> الذي احتفظ به Readability، وفي مقالة قصيرة جدًا سجّل 0.571 مقابل 0.800 لدى Readability. التنظيف العدواني مقايضة، لا مكسب مجاني. إن كانت مجموعتك مليئة بالمقتطفات والتسميات التوضيحية والصفحات كثيفة الجداول، فهذه المقايضة تعمل ضدك.
كيف تحوّل هذه المقارنة إلى اختبار اختيار
ابدأ بتحديد أي خطأ أكثر كلفة لخط معالجتك. إذا كانت عناصر الصفحة الزائدة تستهلك رموزًا في المراحل اللاحقة أو تلوّث نتائج البحث، فيستحق تسريب وحدات العناصر الزائدة وعدد الرموز الملوِّثة وزنًا أكبر. وإذا كان إسقاط تسمية توضيحية أو منشور قصير أو كتلة غير نثرية أمرًا غير مقبول، فيستحق استدعاء المحتوى حسب شكل الصفحة وزنًا أكبر. مجموعة الملفات التجريبية المشتركة تجعل هذه المقايضة مرئية، لكنها لا تختار الأوزان المناسبة لأرشيف غرفة أخبار أو مجموعة وثائق أو خط استرجاع.
السياق الأوسع لاختبار الضغط موجود في مقارنة الذاكرة وHTML المشوَّه عبر عشر مكتبات.
ابنِ اختبار المقارنة من HTML محفوظ لا من روابط حية، حتى يتلقى المستخرجان البايتات نفسها. أدرج مقالات طويلة عادية، وإشعارات قصيرة، وقطعًا كثيفة التسميات التوضيحية، ومستندات كثيفة الجداول أو الكود، وقوالب من كل ناشر تستهلك محتواه فعليًا. صنّف عددًا صغيرًا من وحدات المحتوى المطلوبة وكتل العناصر الزائدة المعروفة قبل تشغيل أي أداة. ثم قيّم المخرجات الفارغة، واستعادة الوحدات المطلوبة، وتسريب الوحدات غير المرغوبة، وحقول البيانات الوصفية كل على حدة. درجة "جودة" إجمالية واحدة قد تخفي نمط الفشل الدقيق الذي يهم تشغيليًا.
تحقق أيضًا من عقد المخرجات في المراحل اللاحقة. يمكن لـJSON الخاص بـtrafilatura أن يحمل المحتوى والبيانات الوصفية المستخرجة، لكن تسلسل JSON ليس نفس الشيء كمخطط صفوف مصنّف. لنص المقالة، تحقق من الحد الأدنى لطول المحتوى والعلامات المطلوبة بدلًا من قبول أي مخرجات غير فارغة. أما بالنسبة للبيانات الوصفية، فميّز بين الغياب والقيم الخاطئة، واحتفظ برابط المصدر وإصدار الاستخراج حتى يمكن إعادة تشغيل الحالات الفاشلة.
يجب اختبار الجلب كطبقة مستقلة بذاتها. ملاحظة الفشل المحلي البالغة 30 ثانية تعود إلى fetch_url، لا إلى الاستخراج من HTML محفوظ مسبقًا، ولم تُثبَت آليتها الداخلية. إن كانت المهل الزمنية أو إعادة المحاولة أو المصادقة أو سياسة الوكيل مهمة، فاستخدم عميلًا تتحكم في سلوكه، وسجّل بايتات الاستجابة النهائية، ومرّرها إلى المستخرج. هذا يعزل إخفاقات الجلب عن إخفاقات اختيار المحتوى ويجعل المقارنات قابلة للتكرار.
أخيرًا، قِس خصائص النشر على المنصة المستهدفة فعليًا. تثبيت Python 3.14 بـ17 حزمة لم يحتج متصفحًا منفصلًا، لكن ذلك لا يحدد الإنتاجية، أو نمو الذاكرة، أو توفر wheels على كل معمارية، أو السلوك تحت عمّال متزامنين. يثبت هذا المقال آلية دقة/احتفاظ مفيدة مقابل Readability؛ لكن الملاءمة للإنتاج تبقى معتمدة على اختبارات المجموعة وبيئة التشغيل.
كتحقق خارجي مستقل عن عمل هذه القاعدة، فإن صفحة التقييم الخاصة بـtrafilatura ومعيار article-extraction-benchmark العام من ScrapingHub يضعانه كلاهما متقدمًا على readability-lxml من حيث word-F1 عبر نحو 181 صفحة حقيقية، بنفس اتجاه الجدول أعلاه. تحفظ واحد تغفله معظم المقالات التي تستشهد بذلك المعيار: قيمة F1 المقتبسة على نطاق واسع لـtrafilatura (~0.945) مرتبطة بسلسلة إصدار أقدم هي 0.5.1، وليس بالإصدار 2.1.0 المختبر هنا.
الإيجابيات والسلبيات
الإيجابيات:
- تسريب أقل للعناصر الزائدة الموسومة مقارنةً بـReadability على مجموعة الملفات المشتركة: كتلة واحدة من أصل 17 مقابل خمس.
- استخرج الكاتب والتاريخ بشكل صحيح على الملف التجريبي المحلي، وكذلك العنوان والتاريخ والمضيف على صفحتَي المقالة الحقيقيتين.
- يمكن تسلسل نفس HTML كنص أو Markdown أو JSON.
- تثبيت بـ17 حزمة فقط دون بيئة تشغيل متصفح منفصلة.
- الفشل صامت: يعيد
fetch_urlالقيمةNoneعند HTTP 500 بدلًا من رفع استثناء. - الإصدار المختبر يساوي الأحدث (2.1.0)؛ لا انحراف في الإصدار.
- مرخّص بموجب Apache-2.0؛ ترخيص متساهل وودود تجاريًا.
السلبيات:
- ليس أداة كشط منظمة: أعاد اختبار الكتالوج 12 اسمًا و12 سعرًا كنص و0 صفوف مصنّفة. لا مخطط، لا حقول.
- بلا عرض جافاسكريبت؛ HTML ثابت فقط، ويحتاج محرك عرض منفصل للصفحات من جهة العميل.
- عاد
authorوsitename فارغَين (null) في كلتا صفحتَي MediaWiki الحقيقيتين، فاستخراج اسم الكاتب ليس مضمونًا دائمًا. - التنظيف العدواني له تكلفة: أسقط وسم
<figcaption>احتفظ به Readability، وسجّل 0.571 مقابل 0.800 لدى Readability في مقالة قصيرة جدًا. - استغرق ذلك الفشل الصامت عند 500 مدة 30.012 ثانية لإعادة
None؛ استخدم أداة جلب يتحكم فيها المستدعي حين تهم المهلة الزمنية. - لم تُختبر عناكب الزحف/خريطة الموقع المدمجة وصيغ CSV/XML للمخرجات في هذه الجولة، فلا ادعاءات بشأنها هنا.
لمن يناسب — ومن عليه تجاوزه
يستهدف trafilatura استخراج المحتوى الرئيسي الموجّه للمقالات. إنه مرشح لبناء مجموعات نصية أو أرشيفات قابلة للقراءة أو مدخلات لمعالجة اللغة الطبيعية من HTML ثابت عندما يكون التنظيف الاستدلالي مقبولًا. تدعم مقارنة الملفات المشتركة تسريبًا أقل للعناصر الزائدة مقارنةً بـReadability، بينما احتفظ Readability بمزيد من الحالات القصيرة وغير النثرية.
تجاوزه إن كان ما تحتاجه فعليًا هو استخراج منظم — صفوف منتجات مسعّرة، سجلات مصنّفة، حقول key: value — لأنه يسلّمك نصًا لا جداول (استعاد اختبار الكتالوج كل الأسماء الـ12 وكل الأسعار الـ12، وصفر صفوف). تجاوزه أيضًا إن كانت أهدافك تعرض محتواها في المتصفح ولست مستعدًا لإضافة محرك عرض منفصل، لأن trafilatura يقرأ HTML الثابت فقط ويتوقف عند ذلك. وفكّر مرتين إن كانت مجموعتك أغلبها مقتطفات قصيرة وتسميات توضيحية للصور وصفحات كثيفة الجداول: في الملفات الموسومة، هذا بالضبط ما يقتطعه تنظيفه من المحتوى الحقيقي (F1 عند 0.571 في المقالة القصيرة جدًا، وإسقاط لوسم <figcaption>). طابق الأداة مع المهمة: نص مقالة كامل، نعم؛ JSON منظم أو صفحات JS أو مقتطفات من 100 كلمة، ابحث في مكان آخر.
البدائل، بما فيها موقع Thunderbit
trafilatura مكتبة ذاتية الاستضافة برخصة Apache-2.0 بلا رسوم لكل استدعاء من مزوّد، لكن الحوسبة وعرض النطاق والجلب والمراقبة والصيانة تبقى تكاليف يتحملها المشغّل. يتعامل جيدًا مع الاستخراج الموجّه للمقالات من HTML مُزوَّد، لكنه لا يقوم بتشغيل المتصفح ولا بإنشاء مخططات صفوف مكررة يحددها المستخدم.
لنفس الملفات التجريبية عبر جميع المستخرجات الستة، راجع مقارنة مكتبات الاستخراج الست.
يمكن لخدمة مُدارة أن تضع الجلب والعرض وتشكيل المخطط خلف حدود المزوّد. نحن نبني Thunderbit، لكننا لم نشغّله على هذه الملفات التجريبية، فهذا المقال لا يدعم أي مقارنة في الجودة أو العرض أو زمن الاستجابة أو مقاومة الحظر أو التكلفة. القرار هو بين تحكم ذاتي الاستضافة من HTML إلى محتوى، مقابل حدود جلب واستخراج منظم مُستضافة.
مراجعات قياس مرجعي ذات صلة: مقارنة المستخرجات مفتوحة المصدر الكاملة، ومراجعة Crawl4AI المعتمدة على متصفح لـMarkdown، ومراجعة Firecrawl ذاتية الاستضافة لـMarkdown.
جرّب Thunderbit لاستخراج بيانات الويب
الحكم النهائي
فكّر في trafilatura عندما تكون المهمة استخراجًا موجّهًا للمقالات من HTML ثابت وأولويتك رفض العناصر الزائدة الموسومة. في الملفات المشتركة، سرّب وحدة واحدة من العناصر الزائدة الموسومة مقابل خمس لدى Readability. جاءت هذه الميزة مع احتفاظ أقل في الملفات القصيرة جدًا وغير النثرية، لذا يجب أن يقرر شكل مجموعتك الاختيار.
لا يشغّل جافاسكريبت ولا ينتج صفوفًا مكررة يحددها المستخدم. في صفحتَي MediaWiki، كانت author وsitename فارغتين (null)، وهي ملاحظة مرتبطة بالقالب. احتفظ Readability بالتسمية التوضيحية التي أسقطها trafilatura، وسجّل درجة أعلى على الملف الموسوم f3_short_120؛ الدليل المرئي يدعم "F1 أقل على الملف القصير جدًا"، لا عدّ أحرف أو ادعاءً بأن المخرجات كانت مشوَّهة.
جرّب Thunderbit لاستخراج بيانات الويب Get Started Free
الأسئلة الشائعة
ما نوع البنية التي يعيدها trafilatura؟ يمكنه تسلسل المحتوى والبيانات الوصفية المستخرجة كـJSON أو Markdown أو نص أو HTML أو XML أو CSV. هذا تسلسل منظم، لكنه ليس مخطط صفوف مكررة يحدده المستخدم مثل اسم المنتج والسعر والتقييم. أعاد ملف الكتالوج التجريبي القيم كمحتوى مسطّح لا كصفوف مصنّفة.
هل يمكن لـtrafilatura كشط كتالوج منتجات إلى صفوف منظمة؟ لا. إنه مستخرج محتوى، لا أداة كشط منظمة. في ملف كتالوج تجريبي، أعاد كل الأسماء الـ12 كنص مسطّح و0 صفوف منظمة؛ الأسماء موجودة في المخرجات لكنها ليست حقولًا. إن كنت تحتاج سجلات مصنّفة مثل الاسم/السعر/التقييم، استخدم بدلًا منه محللًا قائمًا على المحددات أو واجهة استخراج قائمة على مخطط.
هل يعرض trafilatura جافاسكريبت؟ لا. يستهلك HTML الثابت فقط. وجّهه إلى صفحة تُعرض من جهة العميل وستحصل على ما أرسله الخادم قبل تشغيل الجافاسكريبت، وغالبًا ليس المحتوى الذي تريده. اقرنه بمحرك عرض منفصل إن كانت أهدافك تعتمد بكثافة على JS.
هل تثبيت trafilatura صعب؟
في بيئة Python 3.14 الافتراضية المختبرة، سحب التثبيت 17 حزمة ولم يتطلب بيئة تشغيل متصفح منفصلة. أكبر wheel مسجّل كان lxml بحجم 8.6 ميغابايت. بشكل منفصل، استغرق أحد استدعاءات 500 المحلية 30.012 ثانية لإعادة None؛ استخدم عميل HTTP تتحكم فيه إن احتجت مهلة زمنية موثوقة.
هل trafilatura مجاني للاستخدام التجاري؟ نعم. مرخّص بموجب Apache-2.0، وهو ترخيص متساهل وودود تجاريًا. وكالعادة، تأكد من الترخيص الحالي في المستودع قبل البناء عليه.




