
يتألق زاحف Scrapy لديك على 100 صفحة تجريبية، ثم ينهار عند 10,000. هذه ليست بالضرورة مشكلة في الاستخراج — بل غالبًا مشكلة شبكة ترتدي قناع مشكلة استخراج. الحل الذي يلجأ إليه الجميع هو استخدام وكيل، وإضافته إلى request.meta لا يستغرق سوى نحو ثلاثين ثانية.
لكن المشكلة أن هذا الحل السريع هو المكان الذي تتوقف عنده كثير من الشروحات الأساسية. فهي تعرض لك meta={"proxy": "http://IP:PORT"}، وربما فئة وسيط middleware، ثم تنتهي القصة. وغالبًا ما تتجاهل ما يحدث عندما يتعطل هذا الوكيل في منتصف عملية الزحف، أو كيف تتسرب بيانات الاعتماد إلى سجل Git، أو لماذا قد يعيد الإعادة استخدام الوكيل نفسه الفاشل. هذه هي اعتبارات الإنتاج التي يغطيها هذا الدليل: إعدادات fail-closed، وإدارة الأسرار، واختيار الوكيل بشكل متعمد عند إعادة المحاولة، وحدود البروتوكولات، ومفاضلات التكلفة القابلة للقياس.
ما هو وسيط الوكيل في Scrapy؟
وسيط الوكيل هو جزء من الشفرة يجلس داخل مسار التنزيل في Scrapy ويقرر من أي عنوان IP يجب أن يبدو أن الطلب قادم منه قبل أن ينتقل عبر الشبكة. يأتي Scrapy مع وسيط مدمج اسمه HttpProxyMiddleware، يقرأ مفتاح proxy من request.meta، ويضيف مصادقة الوكيل عند الحاجة، ثم يمرر الطلب إلى معالج التنزيل الذي يفتح الاتصال فعليًا. الوسيط المخصص لا يستبدل خطوة النقل هذه — بل يعمل كـ محدد يقرر أي وكيل سيتم استخدامه قبل أن تتولى الآلية المدمجة المهمة. هذا الفرق أهم مما يبدو، وهو السبب وراء معظم تقارير الأخطاء من نوع "وسيطك المخصص لا يعمل".
لماذا تهم الوكلاء في مشاريع Scrapy الإنتاجية
الوكيل يغيّر مسار الشبكة وعنوان IP الظاهر. وهذا قد يساعد في الاختبار الجغرافي المشروع، وتوزيع حركة الطلبات المصرح بها، وعزل أعطال الشبكة. لكنه لا يمنح إذنًا، ولا يتجاوز حدود المعدل، ولا يضمن الوصول. ما إذا كان الزحف يحتاج إلى وكيل أصلًا يعتمد على الهدف، وشروطه، ومعدل الطلبات، ومتطلبات الاعتمادية للعمل.
ليست كل الوكلاء متساوية، واختيار الطبقة الخطأ قد يكون بحد ذاته حادثة إنتاج:
| نوع الوكيل | الاعتمادية | السرعة | خطر الاكتشاف | التكلفة النموذجية |
|---|---|---|---|---|
| الوكلاء العامة المجانية | متغيرة جدًا | متغيرة | غالبًا مرتفع | بلا رسوم، لكن مع مخاطر أمنية وتشغيلية كبيرة |
| وكلاء مراكز البيانات | يعتمد على المزود والهدف | غالبًا سريعة | يعتمد على الهدف | غالبًا تُسعّر حسب GB أو IP |
| الوكلاء السكنية | يعتمد على المزود والهدف | متغيرة | يعتمد على الهدف | غالبًا تُسعّر حسب GB |
| وكلاء ISP | يعتمد على المزود والهدف | متغيرة | يعتمد على الهدف | خاصة بالمزوّد |
تستحق الوكلاء المجانية ذكرًا خاصًا لأن المخاطر المقاسة فيها كبيرة. فقد تابعت دراسة Free Proxies Unmasked على مدى 30 شهرًا أكثر من 640,000 عنوان من 11 مزودًا: كان 34.5% منها نشطًا مرة واحدة على الأقل، و16,923 قام بتعديل المحتوى. هذه العينة تدعم تحذيرًا أمنيًا قويًا تجاه القوائم العامة؛ لكنها ليست معدل فشل قابلًا للتعميم على كل قائمة حالية، أو كل مجموعة مدفوعة، أو كل هدف، أو كل عبء عمل.
كما أن الوكلاء لا تتجاوز تلقائيًا أنظمة كشف الروبوتات الحديثة. فخدمات مثل Cloudflare تقيم الطلبات باستخدام عشرات الإشارات — بصمات TLS، وتناسق الرؤوس، وتنفيذ JavaScript، والأنماط السلوكية — ويكون عنوان IP مجرد عامل واحد بينها. حتى وكيل سكني نظيف مع رؤوس غير متناسقة وبدون cookie jar سيظل عرضة للتمييز. لذا لا تبنِ بنية كاملة على فكرة "فقط غيّر الـ IP".
قبل أن تبدأ
- المستوى: متوسط
- الوقت المطلوب: نحو 30–45 دقيقة للإعداد الإنتاجي الكامل، ونحو 5 دقائق للاختبار السريع
- ما ستحتاجه: Python 3.9+، وScrapy مثبت (تم اختبار هذا الدليل على Scrapy 2.17.0 الصادر في يوليو 2026)، وزاحف يعمل من خلال
scrapy startproject، وواحد على الأقل من نقاط نهاية الوكيل (تجربة مجانية من أي مزود وكلاء مراكز بيانات تكفي للاختبار)
الخطوة 1: اختبار وكيل باستخدام معلمة Request Meta
أسرع طريقة للتأكد من أن الوكيل يعمل هي تجاوز كل بنية الوسطاء واختباره مباشرة.
الوسيط المدمج في Scrapy HttpProxyMiddleware يقرأ مفتاح proxy مباشرة من request.meta ويوجه الطلب عبره. لا تغييرات في الإعدادات، ولا فئة middleware — فقط وسيط واحد.
import scrapy

class ProxyTestSpider(scrapy.Spider):
    name = "proxy_test"
    start_urls = ["https://httpbin.org/ip"]

    def start_requests(self):
        for url in self.start_urls:
            yield scrapy.Request(
                url,
                meta={"proxy": "http://203.0.113.10:8080"},
                callback=self.parse,
            )

    def parse(self, response):
        self.logger.info(response.text)
شغّله عبر scrapy runspider proxy_test.py. إذا كان الوكيل يعمل، فسيُظهر httpbin.org/ip عنوان IP الخاص بالوكيل بدلًا من عنوانك — وهذا هو التأكيد. وإذا علِق الرد ثم انتهى بخطأ TCP connection timed out، فالوكيل معطل أو غير قابل للوصول، وهو أمر يحدث — وكشفًا للسر — أكثر مما تحب شركات الوكلاء الاعتراف به.
هذه الطريقة مناسبة للزواحف لمرة واحدة أو للاختبارات السريعة. لكنها تنهار بمجرد أن يكون لديك أكثر من زاحف واحد، لأنك حينها ستضع نفس سلسلة الوكيل داخل خمسة ملفات مختلفة.
الخطوة 2: بناء وسيط وكيل مخصص
إذا كان لديك أكثر من زاحف واحد، فأنت تريد تجميع منطق الوكيل في مكان واحد. أنشئ فئة ProxyMiddleware داخل ملف middlewares.py في مشروعك:
from scrapy.exceptions import NotConfigured

class ProxyMiddleware:
    def __init__(self, proxy_url):
        self.proxy_url = proxy_url

    @classmethod
    def from_crawler(cls, crawler):
        proxy_url = crawler.settings.get("PROXY_URL")
        if not proxy_url:
            raise NotConfigured("PROXY_URL مطلوب؛ نرفض الرجوع الصامت إلى الاتصال المباشر")
        return cls(proxy_url=proxy_url)

    def process_request(self, request, spider):
        if "proxy" not in request.meta:
            request.meta["proxy"] = self.proxy_url
ثم سجّلها في settings.py:
import os

PROXY_URL = os.environ.get("PROXY_URL")

DOWNLOADER_MIDDLEWARES = {
    "myproject.middlewares.ProxyMiddleware": 350,
}
لاحظ استخدام from_crawler بدلًا من __init__ عادي. هذا هو النمط الذي يوصي به Scrapy فعليًا لقراءة الإعدادات، وهو نفس المدخل الذي سنعتمد عليه مرة أخرى في الخطوة 4 عند الحديث عن الأسرار. الميزة هنا بسيطة: غيّر إعدادًا واحدًا، وسيلتقطه كل زاحف في المشروع. لا حاجة بعد الآن للبحث في خمسة ملفات لاستبدال IP معطل.
الخطوة 3: افهم ترتيب تنفيذ الوسطاء حتى لا يتوقف وكيلك بصمت
هنا الجزء الذي تتجاوزه معظم الشروحات بعبارة "فقط اضبط الأولوية على 350، وثق بي". يعمل Downloader Middleware في Scrapy بترتيب محدد ويمكن التنبؤ به، وإذا لم تفهمه، ستظهر لك مشكلات تبدو بعيدة تمامًا عن الوكلاء.
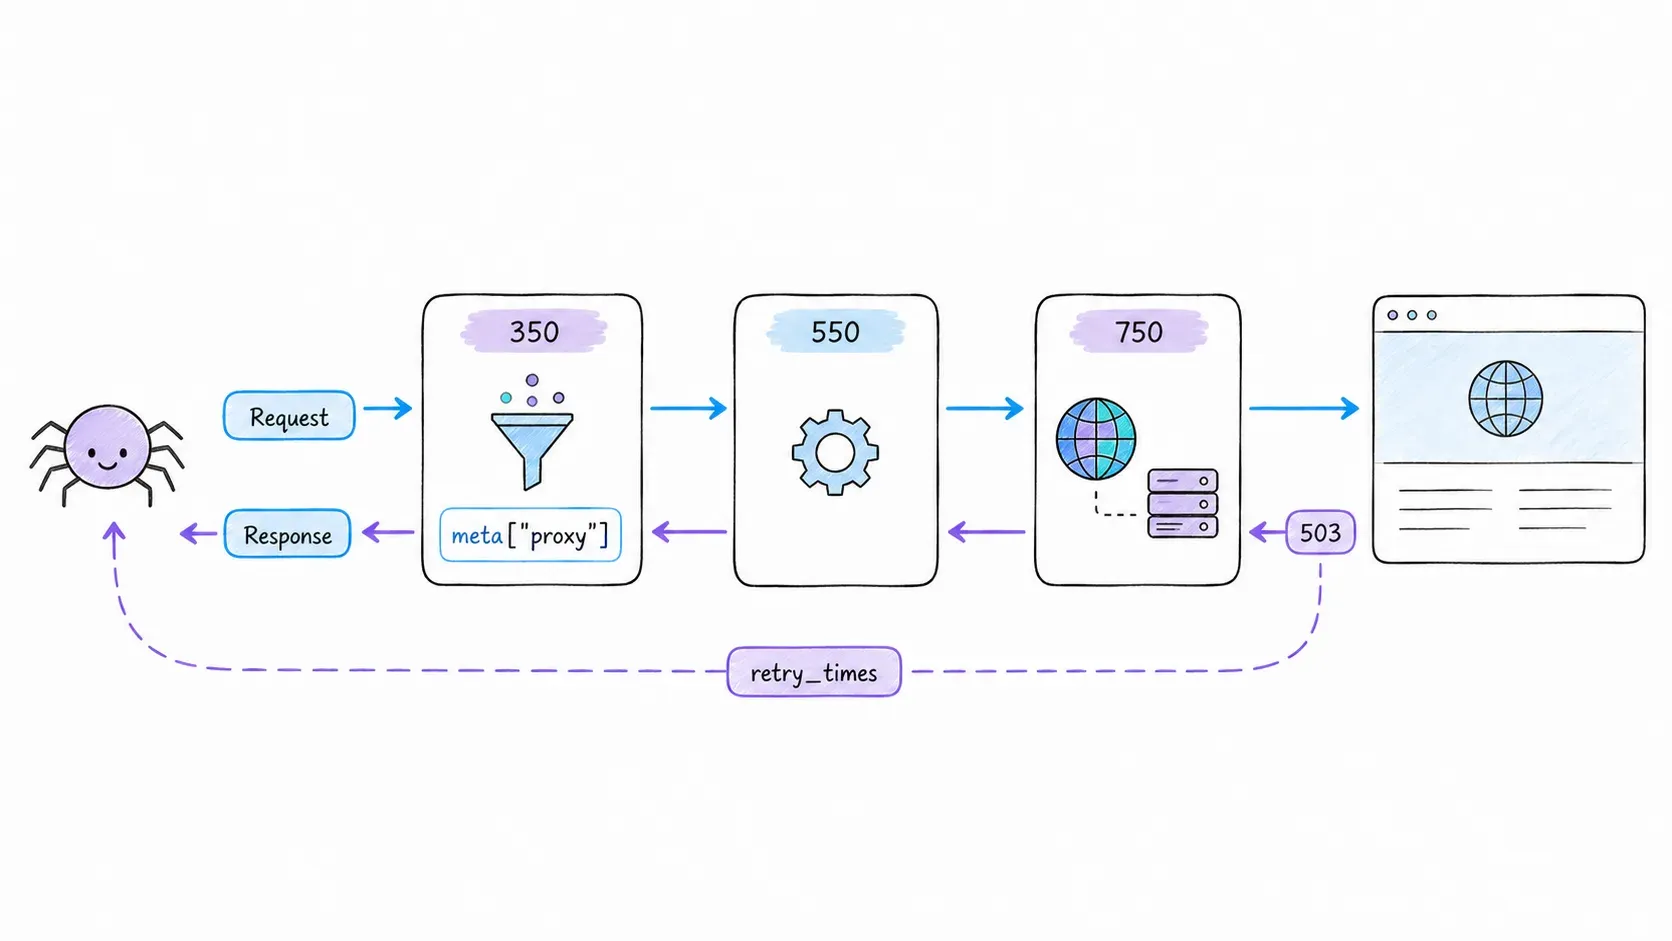
تعمل خطافات الطلب (process_request) بترتيب تصاعدي للأولوية — الرقم الأصغر أولًا. بينما تعمل خطافات الاستجابة (process_response وprocess_exception) بترتيب تنازلي — الرقم الأكبر أولًا، ثم تتراجع عبر السلسلة.
تدفق الطلب (تصاعدي):
  Spider → [100] RobotsTxt → [300] HttpAuth → [350] وسيط الوكيل الخاص بك
         → [500] UserAgent → [550] Retry → [700] Cookies → [750] HttpProxy
         → Downloader

تدفق الاستجابة (تنازلي):
  Downloader → [750] HttpProxy → [700] Cookies → [550] Retry
             → [500] UserAgent → [350] وسيط الوكيل الخاص بك → [300] HttpAuth
             → [100] RobotsTxt → Spider
وهنا جدول الأولويات الافتراضي الحالي لوسطاء Scrapy المدمجين (تم التحقق منه على 2.17.0):
| الوسيط | الأولوية الافتراضية |
|---|---|
| RobotsTxtMiddleware | 100 |
| HttpAuthMiddleware | 300 |
| DownloadTimeoutMiddleware | 350 |
| DefaultHeadersMiddleware | 400 |
| UserAgentMiddleware | 500 |
| RetryMiddleware | 550 |
| RedirectMiddleware | 600 |
| CookiesMiddleware | 700 |
| HttpProxyMiddleware | 750 |
| DownloaderStats | 850 |
| HttpCacheMiddleware | 900 |
عندما يقرر RetryMiddleware إعادة المحاولة، فإنه ينسخ الطلب الفاشل — بما في ذلك بياناته الوصفية — ثم يدخل هذا الطلب الجديد من جديد في سلسلة الوسطاء. العلاقة العددية للمحدد مع الأولوية 550 لا تضمن التدوير. يحدث التدوير فقط عندما يتعرّف منطق المحدد على إعادة المحاولة ويستبدل عمدًا القيمة المنسوخة في meta["proxy"]. تعد الأولوية 350 مكانًا مناسبًا للمحدد لأنه يعمل قبل خطوة النقل المدمجة عند 750، لكنها ليست آلية تدوير بحد ذاتها.
أخطاء شائعة في ترتيب الوسطاء
- وضع وسيطك على نفس أولوية
HttpProxyMiddleware(750): هذا يخلق حالة سباق حيث يحدد ترتيب القواميس في Scrapy — وليس منطقك — أي وسيط يعالج الطلب أولًا. العَرَض: سلوك وكيل متقطع وغير مفهوم. - استخدام
setdefault()أوif "proxy" not in request.metaداخل محدد متناوب: هذا يجعل إعادة المحاولة المنسوخة تحتفظ بالوكيل القديم. العَرَض: كل إعادة محاولة تكرر نفس المسار الفاشل. الحل: اكتشف إعادة المحاولة (مثلًا عبرretry_times > 0) واستبدل قيمة الوكيل المملوكة للمحدد صراحةً. - تعطيل
HttpProxyMiddlewareبالكامل: بعض الشروحات تقول لك أن تضبط"scrapy.downloadermiddlewares.httpproxy.HttpProxyMiddleware": Noneلأن "الوسيط المخصص سيتولى الأمر". لكنه لا يفعل ذلك — فوسيطك المخصص هو محدد وليس طبقة نقل. تعطيل الوسيط المدمج يعني أن رؤوس مصادقة الوكيل لن تُضاف، وقد تخرج طلباتك بدون مصادقة (أو لا تخرج أصلًا).
الخطوة 4: توقف عن ترميز بيانات اعتماد الوكيل داخل الشفرة
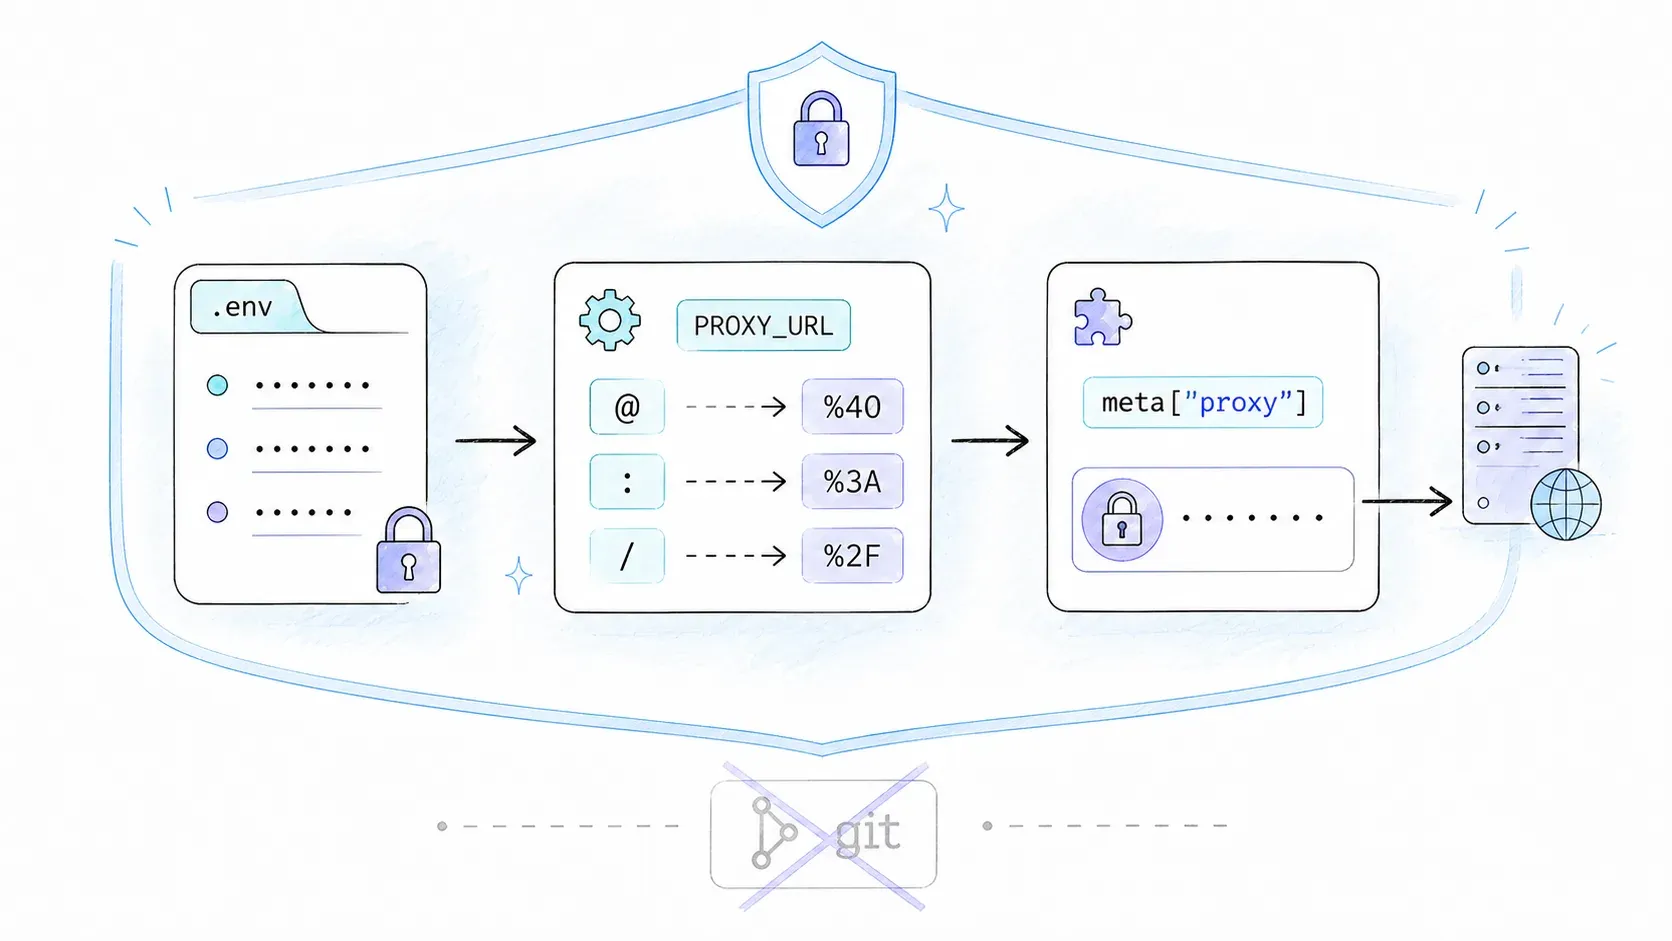
كل شروحات Scrapy الخاصة بالوكلاء التي وجدتها تقريبًا تكتب http://username:password@proxy.example.com:8080 مباشرة داخل ملف Python. هذه بيانات اعتماد تبقى إلى الأبد في سجل Git، وتظهر في كل نسخة مستنسخة، وكل fork، وكل dump للسجلات إذا أساء أحدهم استخدام print().
هناك في الواقع ثلاث مستويات للتعامل مع هذا الأمر:
| الطريقة | الأمان | المرونة | الأنسب لـ |
|---|---|---|---|
| ترميزها داخل spider/settings.py | ضعيف — الأسرار داخل المستودع | منخفض | اختبار محلي سريع فقط |
متغير البيئة http_proxy (مدعوم أصلاً في Scrapy) | أفضل — خارج الشفرة | منخفض (وكيل واحد) | خطوط CI/CD، وDocker |
ملف .env + python-dotenv + from_crawler | الأفضل — خارج الشفرة، وبحسب البيئة | عالٍ (عدة وكلاء، وتدوير) | الزواحف الإنتاجية |
الخيار الثالث يستحق أن تبنيه بشكل صحيح. ثبّت python-dotenv، وأنشئ ملف .env (وأضفه فورًا إلى .gitignore — أعني ذلك، افعل هذا الآن):
PROXY_USER=myuser
PROXY_PASSWORD=my$ecret!Pass
PROXY_HOST=proxy.example.com
PROXY_PORT=8080
ثم حمّله في أعلى settings.py:
from dotenv import load_dotenv
import os

load_dotenv()

PROXY_USER = os.getenv("PROXY_USER")
PROXY_PASSWORD = os.getenv("PROXY_PASSWORD")
PROXY_HOST = os.getenv("PROXY_HOST")
PROXY_PORT = os.getenv("PROXY_PORT")
ثم اقرأه بأمان داخل الوسيط باستخدام from_crawler — هذا هو النمط الذي يحل الإرباك نفسه الذي رأيته في المنتديات حيث يسأل الناس: "كيف أحدد هذا قبل تشغيل scrapy crawl إذا كانت بيانات الاعتماد تتغير مع كل تشغيل؟":
import os
from urllib.parse import quote

class SecureProxyMiddleware:
    def __init__(self, user, password, host, port):
        self.user = quote(user, safe="")
        self.password = quote(password, safe="")
        self.host = host
        self.port = port

    @classmethod
    def from_crawler(cls, crawler):
        settings = crawler.settings
        return cls(
            user=settings.get("PROXY_USER"),
            password=settings.get("PROXY_PASSWORD"),
            host=settings.get("PROXY_HOST"),
            port=settings.get("PROXY_PORT"),
        )

    def process_request(self, request, spider):
        proxy_url = f"http://{self.user}:{self.password}@{self.host}:{self.port}"
        request.meta["proxy"] = proxy_url
لاحظ استخدام urllib.parse.quote() حول بيانات الاعتماد. إذا احتوى كلمة المرور على @ أو : أو / (ومولّدات كلمات المرور تحب إدخال هذه الرموز)، فسيتعطل تحليل الرابط ما لم يتم ترميزها أولًا. هذا إصلاح من سطر واحد ينقذك من ساعة محرجة من البحث عن خطأ "invalid proxy URL" لا علاقة له بكون الوكيل غير صالح فعلًا.
احتفظ ببيانات الاعتماد بعيدًا عن السجلات، واختبر الترميز percent-encoding بقيم حقيقية — ولكن وهمية — تمثل حالتك. التوجيه عبر HTTPS، وSOCKS5، وبيانات الاعتماد غير اللاتينية لها حدود خاصة بالمعالجات؛ لا تفترض أن نمطًا واحدًا للمصادقة يعمل معها جميعًا دون اختبار تكاملي مثبت.
الخطوة 5: أضف تدوير الوكلاء
وكيل واحد — حتى لو كان جيدًا — يرسل 5000 طلب إلى الموقع نفسه سيُكتشف في النهاية. أنت بحاجة إلى مجموعة.
الخيار A — ابنِه بنفسك. هذا في الحقيقة بسيط جدًا:
import random

class RotatingProxyMiddleware:
    def __init__(self, proxy_pool):
        self.proxy_pool = proxy_pool

    @classmethod
    def from_crawler(cls, crawler):
        return cls(proxy_pool=crawler.settings.getlist("PROXY_POOL"))

    def process_request(self, request, spider):
        request.meta["proxy"] = random.choice(self.proxy_pool)
هذا ينجح للاستخدامات الأساسية، لكنه لا يعرف أي الوكلاء ما زالت تعمل فعليًا. أنت تقامر في كل طلب.
الخيار B — استخدم scrapy-rotating-proxies. هذه الحزمة الخارجية تضيف كشف الحظر والتراجع التلقائي من البداية:
pip install scrapy-rotating-proxies
وسأكون صريحًا هنا: آخر إصدار على PyPI هو 0.6.2، بتاريخ 2019، والمشروع موسوم Alpha. ليس بالضرورة أن يكون مكسورًا مع Scrapy الحديث، لكن "لم تتم صيانته نشطًا منذ 2019" ليس نفسه "مجرّب ميدانيًا لحركة إنتاج 2026". ثبّت الإصدار، واختبره ضد المواقع المستهدفة فعلًا، ولا تفترض أنه يدعم نقاط نهاية الوكيل ذات المصادقة — فهو في الغالب لا يفعل.
الخطوة 6: ابنِ وسيط وكيل يتحمل الأعطال (اكتشاف الوكيل الميت)
هذا هو القسم الذي تتجاهله معظم الشروحات المنافسة بالكامل، وهو الفارق بين عرض تجريبي وبين شيء يصمد أمام زحف مدته 6 ساعات دون مراقبة.
| السيناريو | ما تعرضه أغلب الشروحات | ما يضيفه هذا الوسيط |
|---|---|---|
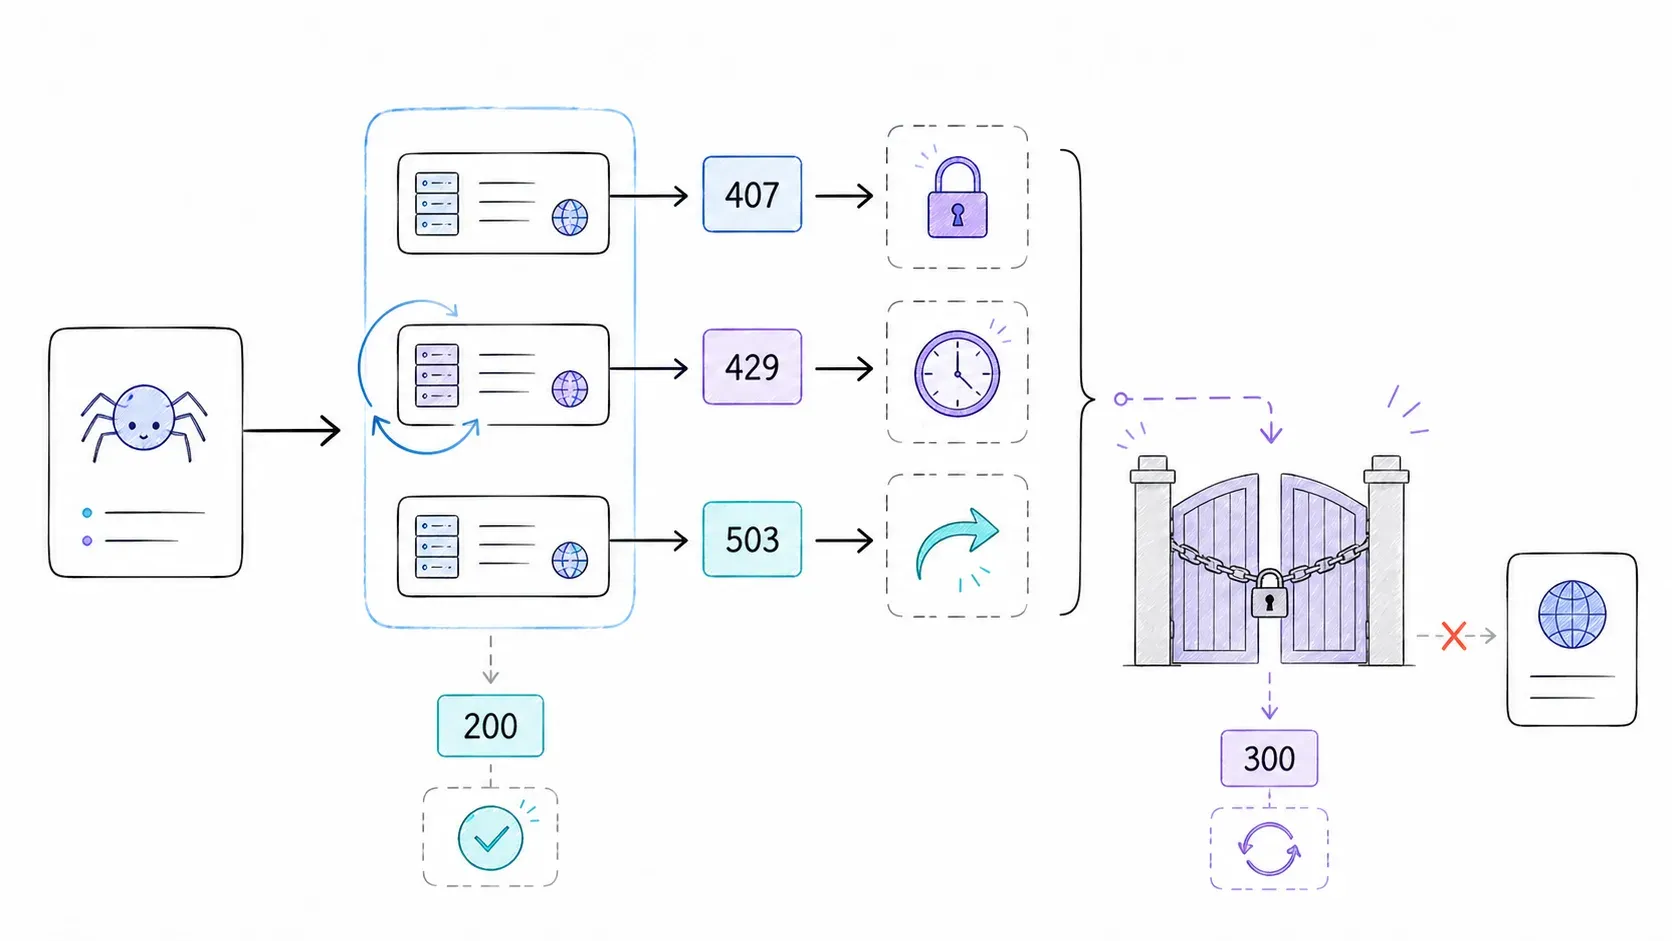
| الوكيل يعيد 407 | غير مغطى | يعامله كفشل مصادقة للوكيل |
| الهدف يعيد 403/429 | غالبًا تُجمع معًا | يفصل ردود السياسة/الحد من المعدل عن صحة الوكيل |
| الوكيل ينتهي وقته | غير مغطى | حد مهلة قابل للضبط، وتراجع في درجة الصحة |
| كل الوكلاء متعطلون | غير مغطى | رجوع سلس أو إيقاف مؤقت للزحف مع تحذير مسجّل |
| الوكيل يتقلب (متقطع) | غير مغطى | فترة تهدئة قبل إعادته إلى المجموعة |
import time
import random
from scrapy.exceptions import IgnoreRequest

class FaultTolerantProxyMiddleware:
    MAX_FAILURES = 3
    COOLDOWN_SECONDS = 300

    def __init__(self, proxy_pool):
        self.pool = {p: {"failures": 0, "banned_until": 0} for p in proxy_pool}

    @classmethod
    def from_crawler(cls, crawler):
        return cls(proxy_pool=crawler.settings.getlist("PROXY_POOL"))

    def _healthy_proxies(self):
        now = time.time()
        return [p for p, s in self.pool.items() if s["banned_until"] < now]

    def process_request(self, request, spider):
        healthy = self._healthy_proxies()
        if not healthy:
            spider.logger.warning("جميع الوكلاء غير صالحين — يتم إيقاف الزحف مؤقتًا")
            raise IgnoreRequest("لا توجد وكلاء سليمة متاحة")
        request.meta["proxy"] = random.choice(healthy)

    def process_response(self, request, response, spider):
        proxy = request.meta.get("proxy")
        if proxy and response.status == 407:
            self._mark_failure(proxy)
        return response

    def process_exception(self, request, exception, spider):
        proxy = request.meta.get("proxy")
        if proxy:
            self._mark_failure(proxy)

    def _mark_failure(self, proxy):
        state = self.pool[proxy]
        state["failures"] += 1
        if state["failures"] >= self.MAX_FAILURES:
            state["banned_until"] = time.time() + self.COOLDOWN_SECONDS
            state["failures"] = 0
بعض الملاحظات من البناء الفعلي: لا تتعامل مع كل 403 على أنه دليل على أن الوكيل نفسه معطّل — فـ RFC 9110 يعرّف 403 بأنه "الخادم فهم الطلب لكنه يرفضه"، وقد يعني ذلك ببساطة أن الرؤوس أو الجلسة تبدوان مشبوهتين، بغض النظر عن الوكيل. أما 407 فهو يعني أن الوكيل نفسه يرفض المصادقة — وهذه إشارة أقوى وأكثر تحديدًا. جمع هذه الإشارات في سلة واحدة هو كيف ينتهي الأمر بالناس إلى حرق وكلاء سليمة بلا سبب.
اجعل قيم إعادة المحاولة المؤقتة في Scrapy واضحة في الإنتاج حتى يتمكن المراجعون من رؤية السياسة:
RETRY_HTTP_CODES = [500, 502, 503, 504, 522, 524, 408, 429]
RETRY_TIMES = 2
هذه هي القيم الافتراضية في Scrapy 2.17. لا تضف 403 أو 407 بشكل شامل: فـ 403 هو رفض من الهدف وله أسباب كثيرة محتملة، بينما 407 مشكلة مصادقة للوكيل لن تُحل بإعادة المحاولة العامة. إذا كانت هناك حالة تعاقدية محددة تبرر إعادة محاولة رمز حالة آخر، فوثّق السبب واختبره بشكل منفصل.
الخطوة 7: نمط مدروس لاستخدام الوكيل عند إعادة المحاولة
قد تُرجع بعض الأهداف المصرح بها محتوى صالحًا مباشرة، وتحتاج إلى وكيل فقط بعد ردّ عابر موثق. قد يقلل ذلك من البايتات المارة عبر الوكلاء، لكن لا توجد نسبة عامة قابلة للدفاع عنها أو معدل نجاح مباشر قابل للنقل بين الحالات. قِس عبء العمل الخاص بك قبل اعتماد هذا النمط.
استخدم المساعد العام get_retry_request() في Scrapy، وحافظ على التصعيد محصورًا في الحالات الخاصة بالهدف التي صنفتها صراحةً. هذا المثال يعامل 429 و503 كإشارات ضغط قابلة لإعادة المحاولة؛ ويتجاهل عمدًا 403 و407.
from scrapy.downloadermiddlewares.retry import get_retry_request

class CostAwareEscalationMiddleware:
    def process_response(self, request, response, spider):
        if response.status not in {429, 503}:
            return response

        retry = get_retry_request(
            request,
            spider=spider,
            reason=f"proxy_escalation_{response.status}",
            max_retry_times=2,
        )
        if retry is None:
            return response

        current_tier = request.meta.get("proxy_tier", "direct")
        if current_tier == "direct":
            retry.meta["proxy"] = spider.settings["DATACENTER_PROXY"]
            retry.meta["proxy_tier"] = "datacenter"
        elif current_tier == "datacenter":
            retry.meta["proxy"] = spider.settings["RESIDENTIAL_PROXY"]
            retry.meta["proxy_tier"] = "residential"
        else:
            return response
        return retry
سجّل معدل المحتوى الصالح المباشر، ومعدل المحتوى الصالح عبر الوكيل، والبايتات لكل سجل ناجح، وعدد مرات إعادة المحاولة لكل نجاح، والزمن الإضافي. لا يكون التصميم المباشر أولًا مقبولًا إلا عندما يكون الوصول المباشر مصرحًا به، وعندما يفشل النظام بشكل مغلق كلما كان الوكيل مطلوبًا. التوفير هو الانخفاض المقاس في حركة المرور عبر الوكلاء — وليس نسبة مفترضة.
متى لا تكون إدارة الوكلاء بنفسك تستحق الجهد
أريد أن أكون صريحًا هنا بدلًا من التظاهر بأن بقية المقال كانت عديمة الفائدة: كل ما سبق هندسة حقيقية ومفيدة، وفي كثير من المشاريع — الزحف عالي الحجم، وخطوط المعالجة المخصصة، وأي شيء تحتاج فيه إلى تحكم كامل في جدولة الطلبات — فهو القرار الصحيح.
لكن إذا كان هدفك الفعلي هو "الحصول على بيانات منظمة من هذه الصفحة" بدلًا من "تشغيل بنية وكلاء"، فقد تكون واجهة استخراج API حدًا أفضل. تستقبل وثائق Thunderbit الحالية الخاصة بـ POST /extract عنوان الصفحة ومخطط JSON اختياري؛ وعند حذف المخطط، يمكن للخدمة توليده من محتوى الصفحة. كما يعرض هذا الطرف أوضاع none وbasic وfull، بالإضافة إلى عناصر تحكم في المهلة والانتظار بعد التحميل. الاستخراج المعتمد على البرومبت فقط ليس جزءًا من سطح الطلب المدعوم حاليًا، لذا ابنِ تكاملات الإنتاج حول عقد المخطط الموثق. هذا ينقل واجهة الاستخراج خلف طلب واحد؛ لكنه لا يبرر وعدًا عالميًا بشأن كل أهداف مكافحة الروبوتات أو CAPTCHA.
| العامل | Scrapy + وكلاء يدويًا | الاستخراج عبر API (مثل Thunderbit) |
|---|---|---|
| جهد الإعداد | عالٍ — وسيط، وتدوير، ومنطق إعادة محاولة | منخفض — استدعاء API واحد مع مخطط |
| سلوك الشبكة/العرض | أنت تضبط المعالجات، والوكلاء، والرؤوس، والتأخيرات | يتم التحكم به عبر خيارات API الموثقة |
| الصيانة | أنت تتحمل السيلاتورز، وصحة المجموعة، وتغييرات الهدف | أنت تتحمل جودة المخطط، والتحقق، وسلوك التكامل |
| نموذج التكلفة | رسوم الوكلاء + الحوسبة + وقت الهندسة | توضح الوثائق الحالية 20 وحدة لكل صفحة (تم التحقق 2026-08-10) |
| التحكم | كامل — خطوط معالجة مخصصة، وسلسلة وسطاء | محدود بما توفره الـ API |
| الأنسب لـ | الزحف المعقد، والحجم الكبير، والمنطق المخصص | الاستخراج المحدد، والنمذجة الأولية، والإثراء |
إذا كنت تستخرج صفحات منظمة غالبًا لقوائم العملاء المحتملين أو بيانات المنتجات أو الأبحاث، فجرب تجربة ممثلة باستخدام Thunderbit Chrome Extension أو الـ API، وقارن بين السجلات الصالحة، والزمن، والوحدات، ووقت الصيانة. وإذا كان مشروعك يحتاج إلى رسوم زحف مخصصة والتحكم في خط المعالجة، فـ Scrapy يظل الخيار الأقوى.
تعرّف على المزيد
- ما هو استخراج بيانات الويب
- استخراج بيانات الويب باستخدام الذكاء الاصطناعي
- أفضل أدوات استخراج بيانات الويب بالذكاء الاصطناعي
نصائح وأخطاء شائعة
- نصيحة: اختبر الوكلاء على
httpbin.org/ipقبل توجيهها إلى هدف حقيقي. إنها أسرع طريقة للتأكد من أن التوجيه يعمل قبل إضافة التعقيد فوقه. - خطأ شائع: وضع الوكيل في
request.headersبدلًا منrequest.meta. هذا خطأ شائع جدًا بسبب تشابه الكتابة —HttpProxyMiddlewareيقرأ فقطmeta["proxy"]، وأي محاولة عبر الهيدر ستفشل بصمت دون رسالة واضحة. - خطأ شائع: افتراض أن إعداد وكلاء HTTP وHTTPS يتم بالطريقة نفسها. عادةً ما يعمل عنوان وكيل HTTP مع وجهة HTTPS عبر CONNECT tunneling ضمن معالج متوافق، لكن استخدام
https://كنسق لنقطة نهاية الوكيل نفسها هو إعداد مختلف وأقل دعمًا — لا تخلط بينهما. - نصيحة: إذا كنت تحتاج إلى دعم SOCKS5، فتحقق أولًا من قدرات معالج التنزيل في إصدار Scrapy لديك. أضاف معالج Httpx التجريبي في Scrapy 2.17 دعم SOCKS5 عبر
httpx[socks]، لكنه ما يزال موسومًا كتجريبي — لا تبنِ عليه اعتمادًا إنتاجيًا دون اختبارك الخاص.
طرق بديلة
إلى جانب scrapy-rotating-proxies, تقوم بعض الفرق بتمرير كل منطق الوكلاء عبر بوابة مزود — أي عنوان وكيل واحد يتولى فيه المزود التدوير، وثبات الجلسة، والتوجيه الجغرافي خلف الكواليس. هذا يبدّل جزءًا من التحكم بمقدار كبير من تقليل شيفرة الوسطاء، ومن المفيد مقارنة تكلفته مقابل مجموعة تديرها بنفسك قبل أن تبني كل شيء من الصفر.
الخلاصة
إعداد وكيل في Scrapy لا يتطلب سوى سطر واحد. لكن جعل هذا الإعداد يصمد أمام زحف إنتاجي حقيقي يتطلب سياسة فشل واضحة، وبيانات اعتماد محمية، وحدودًا مختبرة للمعالجات، ومنطق محدد يستبدل عمدًا بيانات الوكيل المنسوخة عند إعادة المحاولة. إذا خرجت بعادتين فقط من هذا المقال، فلتكن: افشل بشكل مغلق عندما يكون الوكيل مطلوبًا، ولا تلتزم أبدًا بكلمة مرور وكيل داخل ملف Python.
الأسئلة الشائعة
كيف أعد وكيلًا مخصصًا في Scrapy مع المصادقة؟
استخدم صيغة عنوان protocol://username:password@host:port، لكن قم بترميز اسم المستخدم وكلمة المرور باستخدام urllib.parse.quote() أولًا إذا احتوتا على أحرف خاصة. وفي الإنتاج، اقرأ هذه البيانات عبر from_crawler من متغيرات البيئة بدلًا من كتابتها داخل الشفرة.
ما رقم الأولوية الذي يجب استخدامه لوسيط الوكيل المخصص في Scrapy؟
350 هي أولوية شائعة للمحدد لأنها تعمل قبل HttpProxyMiddleware ذي الأولوية 750. لكنها لا تضمن التدوير. لا يحصل طلب الإعادة على وكيل جديد إلا إذا تعرّف المحدد على الطلب المعاد وحذف القيمة السابقة في meta["proxy"] واستبدلها.
كيف أتعامل تلقائيًا مع الوكلاء المعطلة في Scrapy؟
ابنِ وسيطًا يتتبع عدد الإخفاقات لكل وكيل في process_response وprocess_exception، ويزيل الوكلاء من المجموعة النشطة بعد تجاوز حد معين، ثم يعيدها بعد فترة تهدئة بدلًا من حظرها نهائيًا.
هل يمكنني استخدام Scrapy مع وكلاء SOCKS5؟
يدعم HttpxDownloadHandler التجريبي في Scrapy 2.17 SOCKS5 عند تثبيت httpx[socks]. أما معالج HTTP/1.1 الافتراضي فلا يدعم SOCKS. ثبّت المعالج/الإصدار، وأجرِ اختبار تكامل قبل اعتبار هذا المسار جاهزًا للإنتاج.
كم يمكن أن يوفر نمط الوكيل عند إعادة المحاولة فعليًا في تكاليف الوكلاء؟ لا توجد نسبة قابلة للتعميم. قِس نسبة الطلبات المصرح بها التي تُرجع محتوى صالحًا مباشرة، والبايتات المرسلة عبر كل طبقة وكيل، وعدد مرات إعادة المحاولة لكل سجل ناجح، والزمن الإضافي. الانخفاض المقاس في البايتات عبر الوكلاء هو التوفير الفعلي؛ وإذا لم يكن الوصول المباشر مصرحًا به أو صالحًا، فلا تستخدم هذا النمط.



