
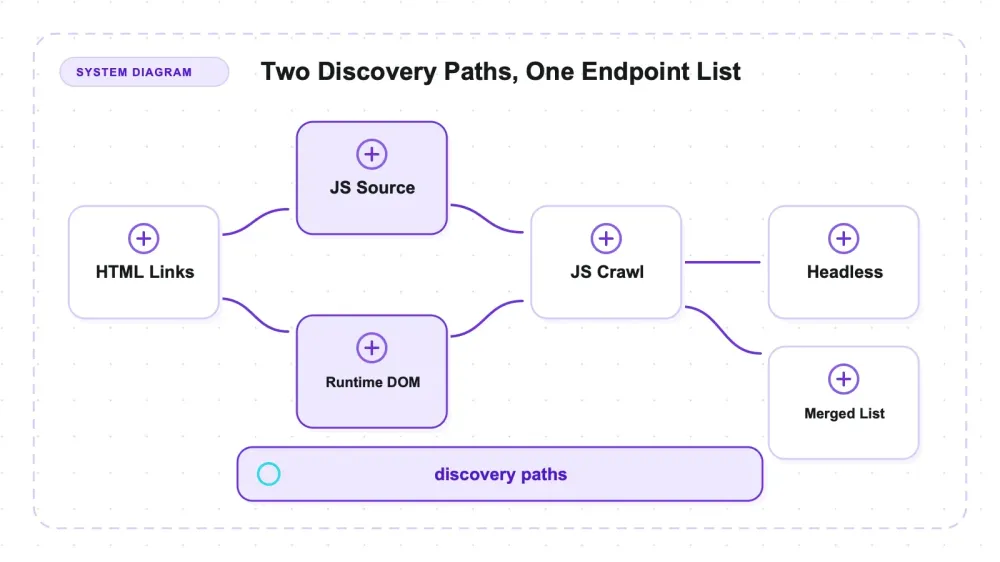
Katana هي أداة زحف مخصّصة لاكتشاف نقاط النهاية (endpoint discovery) من ProjectDiscovery — ملف تنفيذي مكتوب بلغة Go، مرخّص بموجب MIT، يأخذ هدفًا ويُعيد روابط ونقاط نهاية لتُمرَّر إلى الأداة التالية في خط المعالجة. تزحف الأداة إما في وضع HTTP بلا متصفح (browserless)، أو عبر -headless الذي يشغّل Chromium. التوثيق الرسمي يقدّم الوضع headless باعتباره الخيار الأوسع تغطية؛ لكن هذا الاختبار العملي يوضّح أن نوع نقطة النهاية لا يقل أهمية عن عددها.
بنيتُ موقعًا صغيرًا يحتوي على ثلاث فئات مختلفة عمدًا من نقاط النهاية، وقِسْت أي وضع يعثر على كل منها في الإصدار v1.6.1 عند -d 4. وصل HTML العادي إلى 4/4 روابط وسلسلة الثلاث قفزات كاملةً في التكوينات الأربعة جميعها. أما الانقسام فظهر بين نقاط النهاية المكشوفة عبر كود JavaScript المصدري مقابل تلك التي تنشأ من تغييرات DOM أثناء التشغيل.
في هذا الاختبار، عثر الوضع headless على فئة runtime-DOM التي فاتت الأوضاع بلا متصفح التي جُرِّبت، بينما عثر الوضع القياسي مع -jc على السلاسل الحرفية داخل ملفات JavaScript التي فاتت كلا تشغيلتَي headless. لم يغطِّ أي صف واحد في مصفوفة الأوامر الأربعة الفئتين معًا. وقد قدّم سلوك النطاق (scope) والاستئناف (resume) والملفات المعروفة (known files) حدودًا عملية أخرى.
ما هي katana فعليًا
أداة الزحف katana — projectdiscovery/katana على GitHub — مكتوبة بلغة Go ومرخّصة بموجب MIT. اختبرتُ الإصدار v1.6.1 في 27 يوليو 2026؛ والإصدار مهم لأن نتائج التغطية والملفات المعروفة أدناه هي ملاحظات خاصة بهذا الإصدار تحديدًا.
تصنيف الأداة هنا أهم من المعتاد. أداة اكتشاف نقاط النهاية ليست أداة استخراج حقول. إن كنت تريد زاحف ويب بلغة Go يمنحك أسماء منتجات وأسعارًا كبيانات JSON منظّمة، فإن katana ليست الخيار المناسب إطلاقًا — ستخبرك بسعادة أن /products/1138 موجود، ولن تخبرك بأي شيء عمّا في تلك الصفحة. هذا تصميم مقصود، وتقييم الأداة على أساس الاستخراج أشبه بتقييم كاشف معادن بناءً على قدرته على تثمين المجوهرات.
مجالها الطبيعي هو الاستطلاع الأمني الهجومي وخطوط الأتمتة: يدخل STDIN، وتخرج الروابط، ثم تُمرَّر إلى الأداة التالية. وهذا يقودني إلى تنويه واضح: كل قياس هنا أُجري على بيئة اختبار محلية على 127.0.0.1 كتبتُها بنفسي. وجّه katana فقط نحو مضيفين تملكهم أو لديك تفويض كتابي لاختبارهم، ولا شيء غير ذلك. لا علاقة لهذا بالتحايل على دفاعات أحد؛ بل بمعرفة أي مقدار من سطح نقاط نهاية الموقع يستطيع أمر معيّن اكتشافه فعليًا.
الأوضاع الثلاثة، وما يمكن أن يراه كل منها
الوضع القياسي (standard) هو عميل HTTP بلغة Go. يجلب الصفحات، ويحلّل HTML، ويتبع روابط href، ولا يشغّل متصفحًا أبدًا. سريع ورخيص، لكنه أعمى تمامًا عن أي شيء لا يظهر إلا بعد تنفيذ JavaScript.
-jc (أي -js-crawl) يضيف محلِّل JavaScript فوق ذلك المسار بلا متصفح. يُنزّل ملفات .js المرتبطة ويستخرج منها السلاسل النصية التي تشبه الروابط. لا تنفيذ هنا، مجرّد قراءة. وهناك أيضًا -jsl (jsluice)، الموصوف في ملف README بأنه محلِّل أثقل يستهلك ذاكرة أكبر — لم أختبره، لذا ليس لديّ ما أقوله عمّا إذا كان يغيّر صورة التغطية.
-headless يشغّل Chromium وينفّذ سكربتات الصفحة. في هذا الاختبار، كان الوضع الوحيد من بين أوضاع Katana المختبَرة الذي استرجع المسار المُجمَّع من أجزاء والمُدرَج في DOM أثناء التشغيل. هذه النتيجة لا تثبت ما يمكن لأي محلِّل أو وضع مستقبلي في Katana استرجاعه.
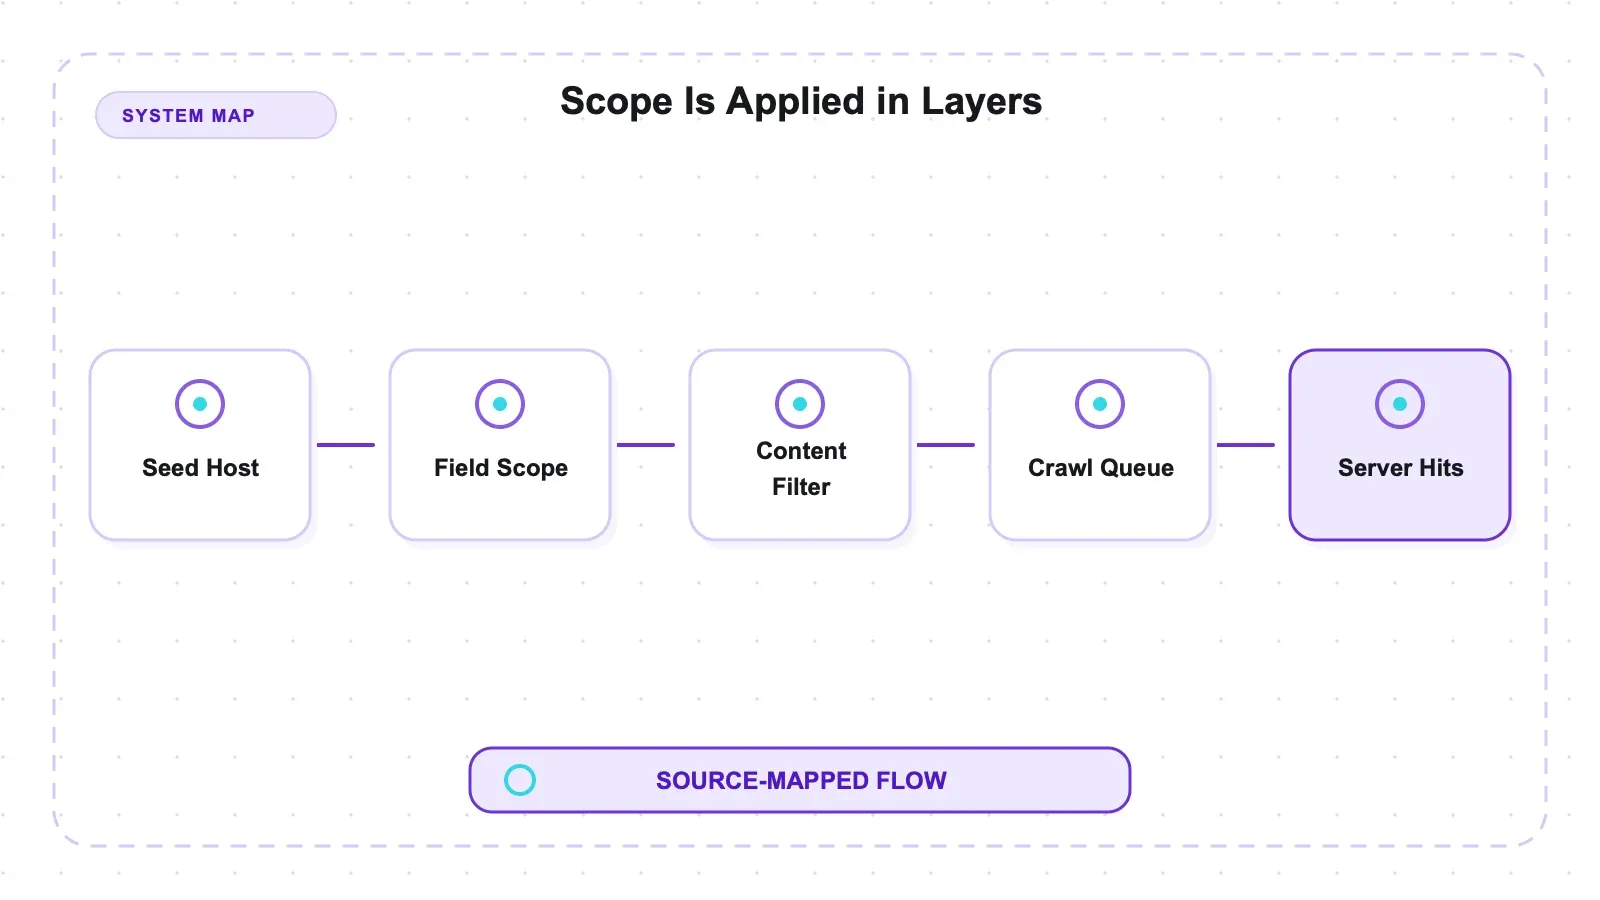
ثم يأتي نموذج النطاق (scope)، وهو الجزء الذي أنصح باستيعابه جيدًا قبل كتابة أي أمر في بيئة إنتاج.
| الخيار | ما الذي يتحكم فيه | القيم / الافتراضي |
|---|---|---|
-fs (field scope) | أي مضيفات تدخل ضمن النطاق | dn, rdn, fqdn, أو تعبير نمطي مخصّص — الافتراضي هو rdn |
-cs و -cos | تعبيرات نمطية للروابط تُصفّي داخل نطاق الحقل ذاك | — |
-kf | الملفات المعروفة: robots.txt وsitemap.xml | يقول README إنه يحتاج عمقًا لا يقل عن 3 |
-d | العمق | الافتراضي 3 |
-resume | يستأنف عملية زحف مقطوعة | — |
الترتيب هنا ليس شكليًا: فهو يحدّد ما إذا كان تعبير نمطي لمضيف يوسّع الزحف أم يفرغه بصمت.
الإعداد: ملف تنفيذي واحد، واستثناء واحد
ثلاث طرق للتثبيت، واحدة منها فقط تحتاج سلسلة أدوات (toolchain):
| طريقة التثبيت | المتطلب المسبق |
|---|---|
من المصدر: go install github.com/projectdiscovery/katana/cmd/katana@latest | المتطلب المعلن هو Go 1.25 أو أحدث |
| ملفات تنفيذية جاهزة على صفحة الإصدارات | بلا سلسلة أدوات |
| صورة Docker | بلا سلسلة أدوات |
استقرت نسختي في ~/go/bin/katana وأظهرت Current version: v1.6.1 في كل تشغيلة. حتى هذه النقطة، القصة المعتادة الممتعة لـ Go: ملف واحد، بلا بيئة تشغيل إضافية.
الاستثناء هو headless، حيث يصبح المتصفح متطلبًا منفصلاً عن الملف التنفيذي نفسه.
أين يعمل -headless | ما الذي يحتاجه |
|---|---|
| جهازي الخاص | اكتشفت katana تلقائيًا نسخة Chromium مثبَّتة مسبقًا؛ لم أسجّل إصدار المتصفح ولم أحدّد مسارًا له |
| خادم فارغ، حسب تعليمات المشروع الخاصة بـ Ubuntu | يلزم apt install google-chrome-stable قبل أن يعمل headless إطلاقًا |
| مسار Docker | يشغّل headless مع -system-chrome |
على خادم فارغ تتلاشى هذه الراحة. احسب حساب متصفح كامل لا ملف تنفيذي فقط، بمجرد أن يدخل -headless سطر الأوامر لديك.
أمر أصغر يستحق المعرفة إن كنت تشغّل هذا داخل CI: تُجري katana عند البدء استدعاءً للتحقق من الإصدار إلى GitHub. -duc يعطّل ذلك. على جهاز محمول هذا مجرد ضجيج؛ لكن على بيئة معزولة عن الشبكة أو محدودة المعدل، فهو طلب شبكة إضافي لكل تشغيلة لم تطلبه. تشغيلاتي الخاصة بقياس الزمن تستخدم -duc، حتى تقيس الأرقام الزحف نفسه لا الاتصال بالخارج.
كيف اختبرتها
ثلاث فئات من نقاط النهاية، اخترتها تحديدًا لأنها تفرّق بين الأوضاع. كل شيء موجود على خادم اختبار محلي، وكُتبت الحقيقة الأرضية (ground truth) قبل أي عملية زحف، بحيث يُقاس الاسترجاع مقابل مجموعة ثابتة، لا مقابل أي شيء طبعته katana بالمصادفة.
- الفئة A — HTML عادي.
/page/a، و/page/b، و/page/c، بالإضافة إلى سلسلة ثلاث قفزات/depth/1 → /depth/2 → /depth/3. يُفترض أن يعثر أي زاحف على هذه. - الفئة B — سلاسل حرفية داخل ملفات JavaScript. يوجد
/api/js-endpoint-7و/api/js-endpoint-8فقط كسلاسل نصية داخل ملف/static/app.jsالمرتبط. يمكن قراءتها بلا متصفح، إن كلّف أحد نفسه عناء قراءة ملف JS. - الفئة C — runtime-DOM فقط. مسار واحد يُجمَّع أثناء التشغيل من أجزاء (
'endpoint' + (6 * 7)) ويُحقَن في DOM عبر سكربت. السلسلة/runtime-only/endpoint42لا تظهر متجاورة في أي بايت يرسله الخادم — ليست في HTML، وليست في كود JavaScript المصدري. لا يكشفها إلا التنفيذ الفعلي.
أضفتُ أيضًا ملف robots.txt، وملف sitemap.xml يحمل عنصرَي <loc> لا يظهران في أي مكان آخر، ومسارًا يعيد 500، ورابطًا معطّلاً، ورابطًا خارج النطاق يشير إلى خادم ثانٍ على اسم مضيف مختلف.
الأداة المستخدمة للقياس لا تقل أهمية عن بيئة الاختبار نفسها: يعدّ الخادم ما تم جلبه فعليًا، بحيث تستند ادعاءات النطاق والاستئناف إلى حقيقة الوصول الفعلي لا إلى مخرجات katana نفسها. التشغيلات الخام موثَّقة في مستودع القياس المرجعي إن أردت التحقق من حساباتي.
انقسام التغطية الذي لا أحد يقيسه رقميًا
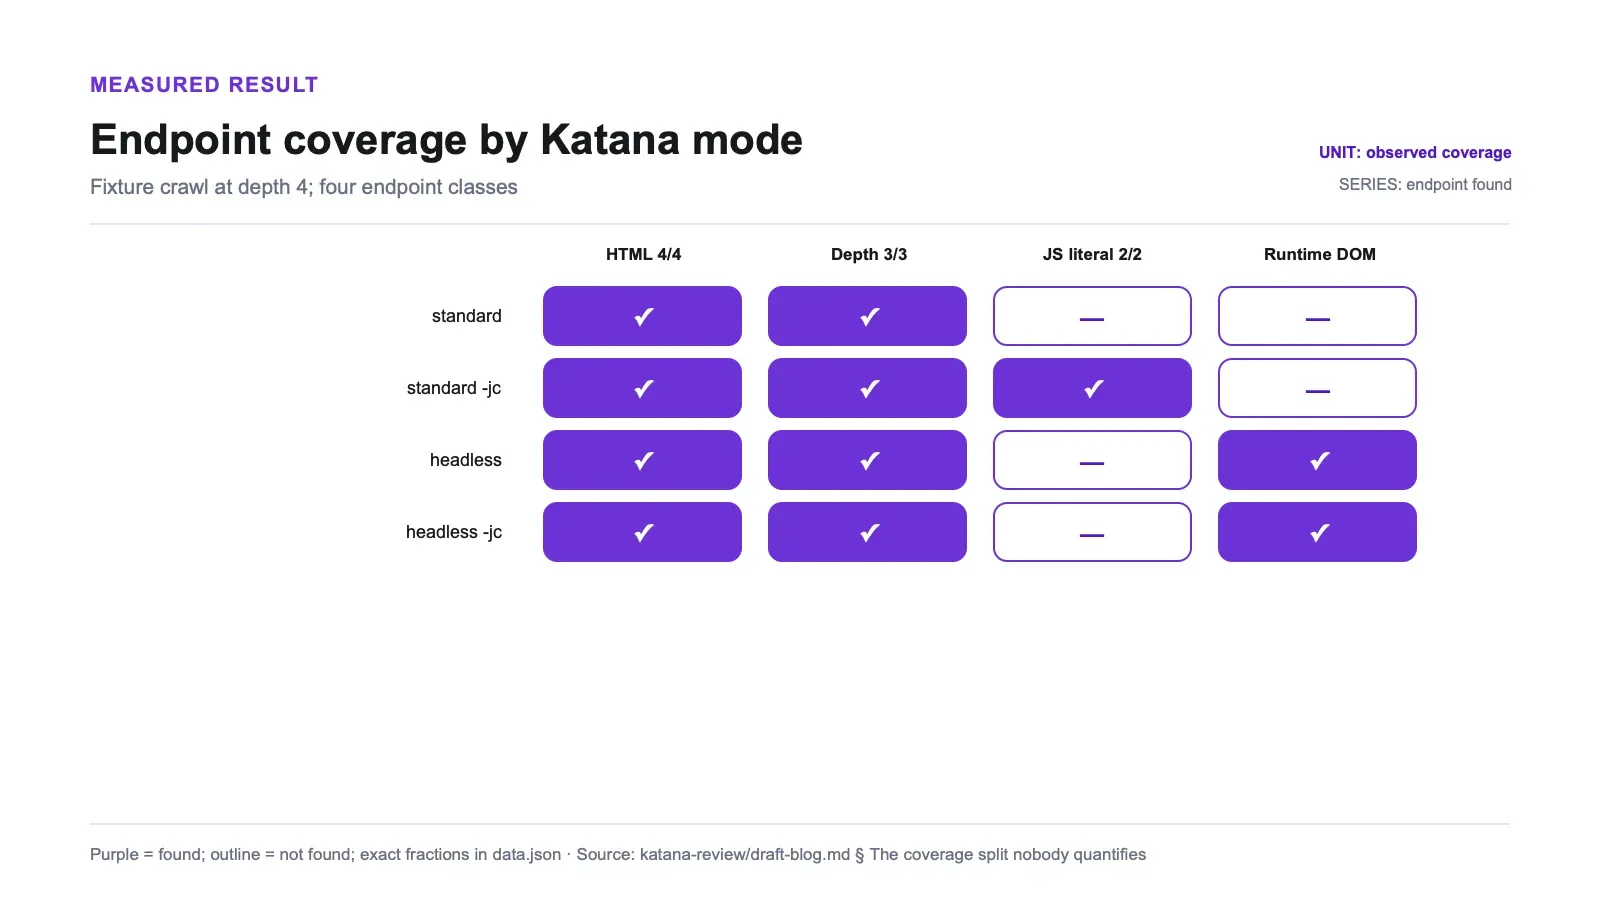
المصفوفة، وضعًا بوضع وفئةً بفئة، عند -d 4:
| الوضع | روابط HTML (A) | سلسلة العمق (A) | سلاسل ملفات JS (B) | runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | لم يُعثر عليها |
standard -jc | 4/4 | 3/3 | 2/2 | لم يُعثر عليها |
-headless | 4/4 | 3/3 | 0/2 | عُثر عليها |
-headless -jc | 4/4 | 3/3 | 0/2 | عُثر عليها |
اقرأ العمودين الأخيرين معًا كزوج، وستظهر المشكلة فورًا. لم تُعثر الفئة B إلا في تكوين واحد بالضبط: الوضع القياسي مع -jc. ولم تُعثر الفئة C إلا في تكوينين اثنين: كلا تشغيلتَي headless. لا يوجد صف واحد يصيب في العمودين معًا. المصفوفة الكاملة موجودة في discovery-summary.json، حيث يقرأ الحقل المحسوب headless_jc_covers_both القيمة false.
النتيجة العملية أن مقولة "استخدم headless فقط للحصول على تغطية أفضل" كانت ناقصة في هذا الاختبار. لم يُضِف headless الفئة B فوق نتيجة standard؛ بل استرجع الفئة C بينما فاتته الفئة B. تغطية جميع الفئات المزروعة في هذا الاختبار احتاجت إلى عمليتَي زحف ودمج بينهما:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
صف -headless -jc هو الذي أتمنى أكثر من غيره الحصول على إجابة رسمية بشأنه. إضافة محلِّل JavaScript إلى تشغيلة headless لم تسترجع شيئًا إضافيًا — ظلت النتيجة 0/2 على الفئة B في كل تشغيلة، بما فيها إعادة تنفيذ جديدة. أنا أُبلغ عن السلوك، لا أدّعي أنني تتبعت الآلية الداخلية؛ لم أفحص الجزء الداخلي من katana لمعرفة سبب توقف مسار المتصفح عن المساهمة بسلاسل ملفات JS. اعتبرها ملاحظة قابلة لإعادة الإنتاج، وقضية جيدة تُفتح على GitHub، لا تشخيصًا نهائيًا. (يستحق الذكر بالمناسبة: أُنجز تركيب -hl -jc بنظافة برمز عودة 0 على الإصدار v1.6.1 على macOS ARM، وهو ما لم يكن صحيحًا دائمًا في السابق.)
تصف الوثائق الرسمية الوضع headless بأنه يمنح تغطية أفضل، وهذا صحيح هنا بالنسبة للفئة المُنشأة أثناء التشغيل. لكن الإرشادات التي راجعتها لم توضّح هذا الانقسام بين السلاسل المصدرية وruntime-DOM، فاعتبر هذه المصفوفة سببًا لاختبار المسارين معًا على فئات نقاط النهاية الخاصة بك، لا تصنيفًا شاملاً عامًا.
تكلفة headless من حيث الوقت الفعلي
ثلاث تشغيلات متتالية لكل وضع على جهاز خامل نسبيًا:
| الوضع | p50 | الأدنى–الأقصى | المتوسط |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
أي نسبة 5.1x، بنطاقات لا تكاد تتقاطع — أبطأ تشغيلة لي في الوضع القياسي (13.17 ثانية) كانت أسرع من أسرع تشغيلة headless (66.78 ثانية) بأكثر من 53 ثانية (cost-summary.json). هذا ليس ضجيج قياس.
تنويه واحد بخصوص تلك الثواني الـ13: بيئة الاختبار تتضمن عمدًا مسار 500 ورابطًا معطّلاً، والوضع القياسي ينتظر ذيل إعادة المحاولة الافتراضي -timeout 10 في كليهما. لم أضبط المهلة لتحسين مظهر الوضع السريع، وهذا يعني أن تشغيلة قياسية مضبوطة بعناية كانت ستوسّع الفارق على الأرجح لا أن تضيّقه.
هذه النسبة إشارة قدرة محلية، لا تنبؤ إنتاجي. تتفاوت الأهداف الفعلية في زمن الاستجابة والأعطال وعبء السكربتات والجدولة، بينما تتضمن هذه البيئة ذيل مهلة افتراضي. استخدم فارق الـ5.1x المقاس لتقرّر ما إذا كان headless يستحق ميزانية ومجموعة أهداف منفصلة، ثم اختبر تلك الخطة على مضيفين ممثّلين ومصرّح لك باختبارهم.
النطاق صمد، لكن أحد الخيارات لم يفعل شيئًا بصمت
استخدم اختبار النطاق خادمين: الرئيسي على 127.0.0.1، وثانٍ يمكن الوصول إليه عبر localhost على منفذ مختلف، يقدّم مسارًا موجودًا فقط هناك. فأي إصابة على ذلك المسار هي دليل على أن المضيف الخارج عن النطاق جُلب فعليًا، لا أنه ظهر في المخرجات فقط.
| الإعداد | هل جُلب المضيف الخارج عن النطاق؟ | الإصابات على الخادم الثاني |
|---|---|---|
الافتراضي (-fs rdn) | لا | 0 |
-fs fqdn | لا | 0 |
-cs localhost | لا | 0 |
| `-fs '(127.0.0.1 | localhost)'` | نعم |
انضباط النطاق خبر جيد: بقيت katana ضمن حدودها افتراضيًا، واحتاج توسيع النطاق إلى فعل صريح. هذا هو السلوك الافتراضي الصحيح لأداة تُوجَّه نحو بنية تحتية تخص أطرافًا أخرى.
الصف اللافت هو -cs localhost. لم يوسّع الزحف نحو المضيف الثاني — بل أصدر أيضًا صفر روابط على الإطلاق. ولأن -cs يصفّي داخل نطاق الحقل (field scope)، وكان نطاق الحقل لا يزال المضيف الرئيسي، لم يطابق التعبير النمطي شيئًا فعاد الزحف بمجموعة فارغة بدل خطأ. إن سبق لك أن كتبت تعبيرًا نمطيًا لنطاق الزحف يسمّي مضيفًا أردت تضمينه ثم حدّقت في ملف مخرجات فارغ، فهذه هي الآلية بالضبط (scope-summary.json). لإضافة مضيف، اضبط -fs. ولتضييق النطاق داخل مضيفات تملكها بالفعل، استخدم -cs/-cos.
الاستئناف أخشن مما يوحي به الخيار
يصف README الخيار بالعبارة -resume string resume scan using resume.cfg، وهو ما يوحي بملف يُترك في مجلد العمل. لكن الأمر ليس كذلك. على جهازي كُتبت نقطة التحقق في ~/.config/katana/resume-<xid>.cfg — وهذا قياس فعلي لا شيء مقروء من صفحة توثيق، لأن التوثيق لا يذكر مسارًا أصلاً.
المفاجأة الأهم كانت في محتوى الملف. احتوى الملف على خريطة InFlightUrls تضم شيئًا واحدًا بالضبط: رابط البذرة (seed URL). لا مجموعة الروابط المزارة، ولا الحدود الأمامية (frontier). إليك ما حدث حين قاطعتُ عملية زحف بإشارة SIGINT بعد ثلاث ثوانٍ ثم استأنفتها:
| التشغيلة | مسارات فريدة |
|---|---|
| الزحف الأساسي الكامل | 11 |
| ما جُلب قبل المقاطعة | 10 |
| ما أعادت تشغيلة الاستئناف جلبه | جميع الـ11، بما فيها كل الـ10 التي كانت قد اكتملت |
وصل الاستئناف إلى نفس مجموعة نقاط النهاية النهائية، فلا شيء معطَّل هنا. لكن دقة نقطة التحقق هي لكل بذرة إدخال، لا لكل رابط — فمرشِّح إزالة التكرار الموجود في الذاكرة لا يُحفظ أبدًا، فاستئناف زحف ببذرة واحدة يعيد زحف تلك البذرة من الصفر (resume-summary.json). إن أعطيت katana قائمة من 500 مضيف، يُفترض أن يوفّر لك الاستئناف المضيفات التي اكتملت بالكامل؛ هذا السلوك متعدد البذور يُستنتج من طريقة تخزين الحالة، لكنني قِست فقط حالة البذرة الواحدة. إن كنت غارقًا في موقع واحد ضخم، فالاستئناف يمنحك الصحة لا الوقت.
الملفات المعروفة: طُلبت ثم أُسقطت
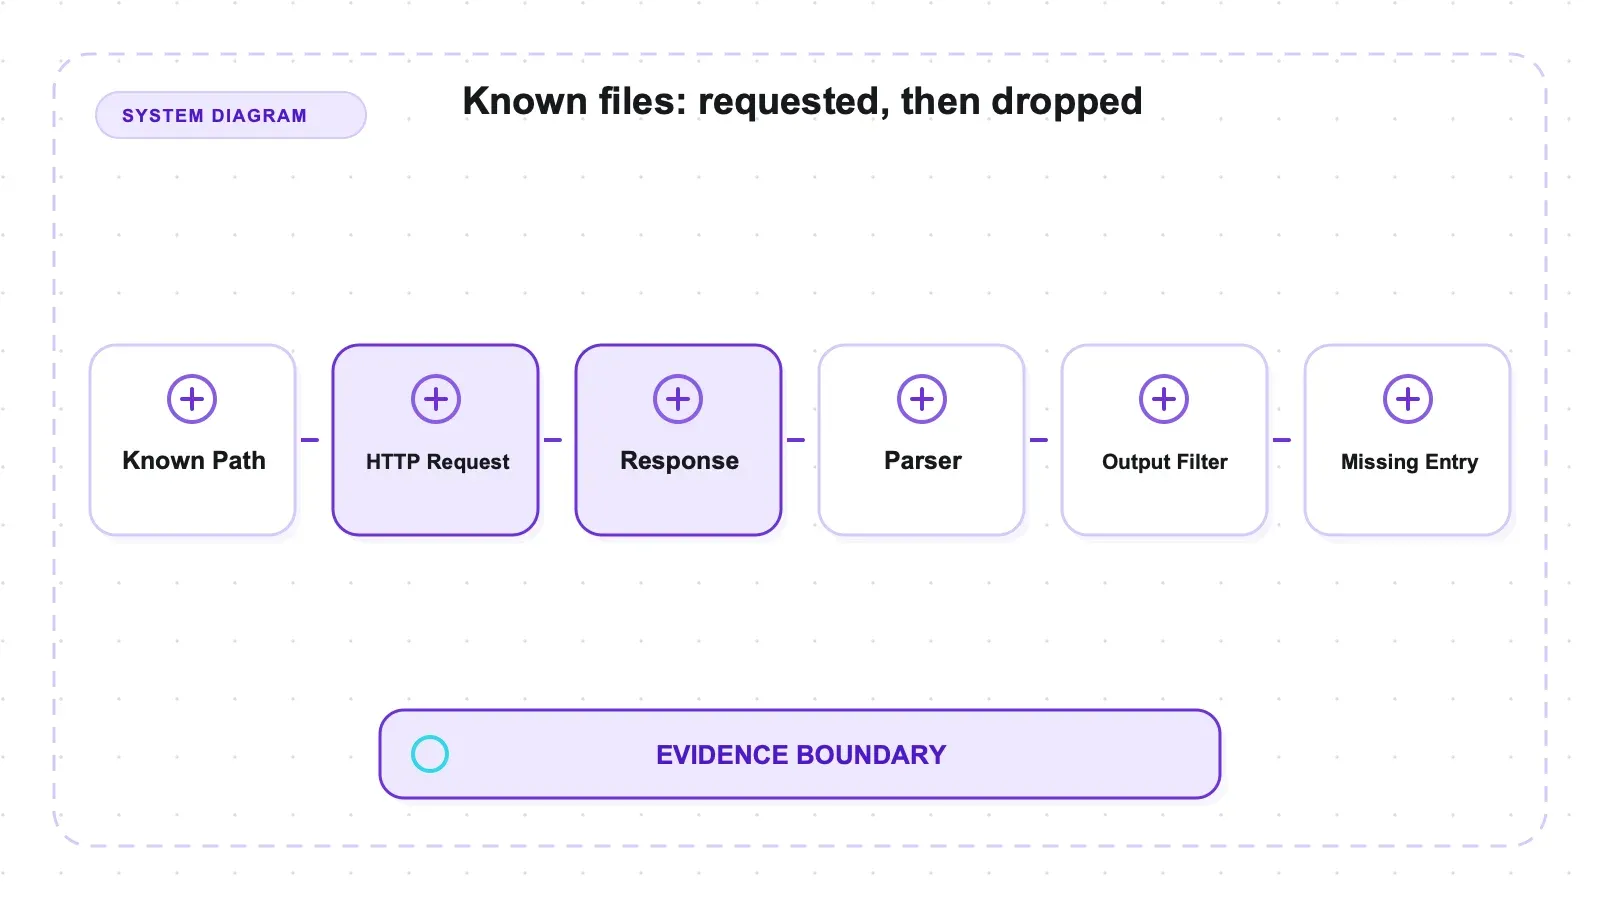
طلب -kf all -d 3 الملفَين فعليًا — ظهر robots.txt وsitemap.xml في سجل زيارات الخادم — ثم استرجع 0 من أصل 2 من نقاط النهاية المدرجة داخل عناصر <loc> في ذلك الملف. الاسترجاع 0.0.
قبل أن أصف ذلك بأنه قصور في الأداة، حاولتُ اعتباره خطأً مني. كل تنويعة جرّبتها استرجعت النتيجة نفسها:
| التنويعة المجرَّبة | نقاط النهاية المسترجعة من <loc> في sitemap |
|---|---|
-kf all | 0/2، استرجاع 0.0 |
-kf sitemapxml | 0/2، استرجاع 0.0 |
-kf robotstxt | 0/2، استرجاع 0.0 |
| عمق 3 | 0/2، استرجاع 0.0 |
| عمق 4 | 0/2، استرجاع 0.0 |
| عمق 5 | 0/2، استرجاع 0.0 |
مع إضافة -jc | 0/2، استرجاع 0.0 |
بذر مباشر عند /sitemap.xml | 0/2، استرجاع 0.0 |
المتطلب الموثَّق — استخدام -kf والذهاب بعمق ثلاثة على الأقل — تحقّق في كل مرة. هذه ليست قصة خيار مفقود.
الخلاصة العملية تأتي أولاً: على بيئة الاختبار هذه المحدَّدة بعنوان IP، لا تفترض أن مجرد طلب الملفات المعروفة يعني أن روابط <loc> انضمت إلى الزحف. تحقّق من الاسترجاع فعليًا، أو استخرج تلك الروابط وابذرها بنفسك.
مسار الكود في v1.6.1 يتّسق مع هذه الملاحظة، لكنني لم أفحصه أثناء التشغيل. في sitemapxml.go من v1.6.1، تبني الدالة NewNavigationRequestURLFromResponse طلبات تنقّل من <loc> انطلاقًا من استجابة دون أن يكون RootHostname معبَّأً. يصل الطلب بعدها إلى ValidateScope؛ وفي scope.go من v1.6.1، يقارن فرع عنوان IP الحرفي مضيف الرابط بذلك الجذر الفارغ، وقد يرفضه. أخذ الأمر المخصّص -fs '(127.0.0.1|localhost)' فرع نطاق مختلفًا في اختبار نطاق منفصل، لذا فهو استنتاج متوقَّع من الكود المصدري، لا حلاً مُختبرًا فعليًا لمشكلة -kf. أعاق محاولة تأكيد ذلك انقطاعٌ متقطّع في عميل الملفات المعروفة على هذا الجهاز؛ لذا تبقى النتيجة المُبلَّغ عنها 0/2.
ما سأفعله فعليًا في الإنتاج، إلى أن يؤكّد أحدهم سلوك هذا الخيار: أجلب sitemap بنفسي، وأستخرج روابط <loc>، وأسلّمها إلى katana كقائمة بذور. سطران من الشل، بلا أي تحقّق من النطاق مشارك في الأمر.
شيء واحد سار تمامًا كما هو معلَن ويستحق جملة: مسار الـ500 والرابط المعطَّل جُلبا، وسُجِّلا، وتم تجاوزهما. أنهت كل تشغيلة بلا متصفح بعملية برمز عودة 0. الزاحف الذي يموت عند أول استجابة سيئة عديم الفائدة في بيئة غير مراقَبة، وkatana لا تفعل ذلك.
فحص تغطية خاص بالهدف قبل النشر
مصفوفة هذه البيئة أكثر فائدة كقالب لاختبار أهدافك المصرَّح لك بها. عرّف فئات نقاط النهاية قبل تشغيل Katana: الروابط العادية، والسلاسل الحرفية داخل سكربتات مرتبطة، والمسارات التي لا تُنشأ إلا بعد التنفيذ، وإدخالات الملفات المعروفة — أربع فئات بداية معقولة. احتفظ بعيّنة حقيقة أرضية صغيرة لكل فئة. بدون تلك القائمة المسبقة، قد يبدو ملف مخرجات أكبر وكأنه تغطية أفضل حتى وإن اختفت فئة كاملة.
شغّل المسارين بلا متصفح ومع headless كقياسين منفصلين أولاً. احفظ الأوامر الدقيقة، وإصدار Katana، وإصدار المتصفح، ورموز العودة، والمخرجات. طبّع مجموعات نقاط النهاية وقارنها بالفرق (diff) لا بعدد الأسطر. إن لم يضف -jc القياسي شيئًا فريدًا على عيّنتك، فقد تكفي سياسة headless فقط؛ وإن تباعدت المجموعتان كما حدث هنا، أبقِ التشغيلتين منفصلتين وادمجهما بعد الجمع. لا تفترض أن إضافة الخيارين معًا في أمر واحد تساوي الاتحاد، حتى يثبت الفرق الخاص بهدفك ذلك.
تحقّق من النطاق بدليل خارج مخرجات Katana. ضع رابط طُعم (canary) على مضيف يُفترض أن يبقى مستبعدًا، وافحص سجل طلبات ذلك الخادم. اختبر أيضًا مضيفًا ثانيًا مقصودًا إن كان يُفترض بالزحف أن يتوسّع. أنتجت تشغيلة -cs localhost هنا مخرجات فارغة لأن تصفية نطاق المحتوى لم توسّع نطاق الحقل؛ بينما نجح الأمر المخصّص -fs '(127.0.0.1|localhost)' في الوصول إلى الخادم الثاني. تسجيل التعبير النمطي الدقيق مهم لأن تغييرًا بحرف واحد قد يغيّر التعبير نفسه لا مجرد شكله.
اختبر المقاطعة والملفات المعروفة بمعزل عن استرجاع الاكتشاف. بالنسبة للاستئناف، قاطع بذرة ممثِّلة بعد عدة صفحات، واحفظ مسار نقطة التحقق المُنشأة، وعُدّ كم رابطًا مكتملًا أُعيد جلبه. أما -kf، فتأكّد من أن robots وsitemap طُلبا فعليًا وأن روابط <loc> المزروعة جُدولت فعليًا. هذان ادعاءان مختلفان. في هذه البيئة طُلبت الملفات بينما غابت نقطتا نهاية sitemap، فاحتجت إلى سجلات الطلبات ومخرجات نقاط النهاية معًا لرؤية الحدّ الفاصل.
أخيرًا، أنشئ خط أساس محلي للتكلفة باستخدام تشغيلات متتالية على جهاز خامل نسبيًا، ثم كرّرها على مضيفين ممثّلين. احتفظ بالأدنى والأقصى والوسيط لا بمعامل واحد فقط. الرقم 5.1x هنا يتضمن سلوك الفشل والمهلة الخاص بهذه البيئة؛ فهو يخبرك أن headless يستحق ميزانية منفصلة، لا كم من الوقت سيستغرقه جرد إنتاجي فعلي.
الإيجابيات والسلبيات
الإيجابيات:
- استرجاع كامل على HTML العادي في كل وضع — 4/4 روابط وسلسلة العمق الكاملة 3/3، بلا أي إعداد إضافي.
-jcيعمل فعليًا بلا متصفح: استرجاع 2/2 نقطتَي نهاية من سلاسل حرفية داخل ملف JS مرتبط، بلا أي تكلفة متصفح.-headlessهو الوحيد الذي عثر على نقطة نهاية مُجمَّعة أثناء التشغيل — فئة غير مرئية للتحليل المصدري بحكم طبيعتها.- افتراضيات النطاق متحفّظة. لم يُجلب المضيف الخارج عن النطاق أبدًا في الوضع الافتراضي أو
-fs fqdnأو-cs. - ملف تنفيذي واحد بلغة Go، ترخيص MIT، نسخ جاهزة للتحميل وصورة Docker، إدخال/إخراج ملائم لخطوط المعالجة.
- متين عند الفشل: استجابات 500 والروابط المعطَّلة لا توقف الزحف.
السلبيات:
- لم يغطِّ أي استدعاء واحد نقاط نهاية ملفات JS وruntime-DOM معًا. التغطية الكاملة تحتاج تشغيلتين ودمجًا.
- لم يُضف
-jcشيئًا تحت-headless— 0/2 على الفئة B في كل تشغيلة headless. - تكلفة headless 5.1 أضعاف الوقت الفعلي (66.82 ثانية مقابل 13.08 ثانية عند p50، مع نطاقات لا تتقاطع).
- يعيد
-resumeزحف الصفحات المكتملة داخل البذرة نفسها. يستعيد مجموعة نقاط النهاية، لا وقتك المستغرَق. - طلبت الملفات المعروفة robots.txt وsitemap.xml لكنها استرجعت 0/2 من نقاط نهاية
<loc>في sitemap مقابل هدف بعنوان IP. - يفترض headless بصمت وجود Chromium على الجهاز؛ قصة "ملف تنفيذي واحد" تتوقف عند المتصفح.
- اكتشاف فقط. لا استخراج منظّم، ولا تحويل محتوى، ولا مخطط حقول.
غير مُختبر، وبالتالي خارج ما تغطيه أي من هذه الأرقام: -jsluice، واختبار مخصّص لحد العمق عند -d 1/-d 2، والاستئناف متعدد البذور، وملء النماذج التلقائي، وأي موقع إنتاجي حقيقي كثيف JavaScript أو محمي. كل الأرقام من جهاز واحد (macOS arm64) مقابل بيئة اختبار محلية.
لمن تناسب، ومن يجب أن يتجاوزها
إن كانت مهمتك إنتاج جرد لنقاط نهاية بنية تحتية مصرَّح لك بلمسها، فإن katana تملك الشكل الصحيح لخط المعالجة: توصيل STDIN/STDOUT، وملف تنفيذي قابل للتوزيع، وأوضاع بلا متصفح وأخرى مدعومة بمتصفح. الدمج بمرحلتين كان ضروريًا لفئات هذه البيئة المزروعة؛ أما هل تحتاج أهدافك كلا المرحلتين فهذا شيء يجب إثباته من صفحات ممثّلة فعليًا.
تجاوزها إن كنت تريد بيانات لا عناوين. لن تمنحك katana أبدًا جدول منتجات؛ بل تمنحك الروابط التي قد تعيش فيها المنتجات، وأداة أخرى تتولى الاستخراج. تجاوزها أيضًا إن كنت تحتاج أمرًا واحدًا مكتملاً — الدمج بمرحلتين مقبول داخل خط معالجة ومزعج في سطر أوامر فوري. وإن كان جردك يعتمد على نقاط نهاية <loc> في sitemap بينما تستهدف عناوين IP، تحقّق ممّا تحصل عليه فعليًا قبل أن تثق بالمخرجات، لأن ذلك المسار لم يُعِد شيئًا في بيئة اختباري.
البدائل، وحدود الاستخراج
Katana مجانية ومرخّصة بموجب MIT وقابلة للاستضافة الذاتية. تُبقي الاكتشاف واختيار الوضع ونشر المتصفح ودمج النتائج كلها في جانبك من الحدّ.
ضمن المصادر المفتوحة، المقارنات المفيدة تكون حسب المهمة لا اللغة. Colly هو الخيار الآخر بلغة Go، لكنه مكتبة تُترجَم مع دوال ردّ نداء (callbacks) خاصة بك، ولا تعرض JavaScript إطلاقًا. Crawl4AI يشغّل متصفحًا حقيقيًا وينتج Markdown لخطوط معالجة LLM، وهذا مخرَج مختلف تمامًا. إن كنت تقارن بين عدة أدوات معًا، فإن استعراضنا لأدوات الزحف مفتوحة المصدر يعرض الفئات جنبًا إلى جنب.
إفصاح: Thunderbit هو منتج الناشر، ولم يُختبر ضمن بيئة Katana هذه. يقع في فئة الاستخراج المُدار في اتجاه مصب مختلف، إذ يحوّل الصفحات إلى نص أو سجلات منظّمة بدل حصر سطح نقاط نهاية هدف مصرَّح به. قد يستخدم سير عمل واحد كلتا الفئتين معًا، لكن هذه المراجعة تقدّم أدلة على سلوك اكتشاف Katana فقط.
جرّب Thunderbit لاستخراج بيانات الويب
الحكم النهائي
استخدم katana حين يكون المُخرَج المطلوب قائمة نقاط نهاية لأهداف مصرَّح لك بزحفها وتستطيع التحقق من تغطية الأوضاع مقابل تلك الأهداف. في هذه البيئة، استرجع الوضع القياسي مع -jc السلاسل الحرفية المزروعة داخل ملفات JavaScript، بينما استرجع headless نقطة نهاية runtime-DOM؛ ولم تسترجع أوضاع Katana بلا متصفح المختبَرة ذلك المسار أثناء التشغيل. كما أبقى النطاق الافتراضي المضيف الثاني بمنأى عن الجلب، واستمرت التشغيلات بلا متصفح بعد الـ500 والرابط المعطَّل.
التحفّظات تشغيلية بطبيعتها: قد يلزم دمج بمرحلتين لفئات نقاط نهاية مختلطة، واستغرق headless نحو خمسة أضعاف الوقت الفعلي محليًا، وأعاد الاستئناف بذرة واحدة زحف مسارات مكتملة، وكان استرجاع الملفات المعروفة 0/2 مقابل الهدف بعنوان IP. هذه نتائج خاصة بالإصدار v1.6.1 وبهذه البيئة، لا ضمانات لكل موقع. لكنها كافية لتحديد الفحوصات التي يجب أن يكرّرها أي تقييم إنتاجي.
جرّب Thunderbit لاستخراج بيانات الويب Get Started Free
الأسئلة الشائعة
أين تحفظ katana ملف الاستئناف، وهل الاستئناف يتخطّى الصفحات التي زحفتُها بالفعل؟
وصلت نقطة التحقق إلى ~/.config/katana/resume-<xid>.cfg، لا إلى resume.cfg في مجلد العمل كما يوحي نص المساعدة للخيار. ولا، لا يتخطّى الصفحات المكتملة: يخزّن الملف روابط البذور قيد التنفيذ فقط، فأعاد استئناف زحف ببذرة واحدة جلب كل المسارات الـ11 الأساسية، بما فيها الـ10 المكتملة مسبقًا. تحصل على نفس مجموعة نقاط النهاية النهائية، لكن دون توفير الوقت.
لماذا طلب -kf all ملف sitemap.xml لديّ لكنه لم يزحف الروابط بداخله؟
مقابل هدف بعنوان IP، تتّسق النتيجة مع حدّ في التحقق من النطاق أكثر من كونها خطأً في الخيار. في كود v1.6.1، يبني محلِّل sitemap في Katana كل طلب من <loc> دون حمل اسم المضيف الجذري معه، وقد يرفض فحص النطاق الخاص بعناوين IP الحرفية ذلك الرابط لاحقًا؛ لم أفحص التشغيلة لتأكيد هذه الآلية. ثبتت النتيجة عند استرجاع 0 عبر كل خيار وعمق وتنويعة بذر جرّبتها. تعبير نمطي مخصّص لـ-fs يأخذ فرع تحقق مختلفًا وهو الحل الذي يتوقّعه الكود المصدري — لكنني لم أستطع تأكيده مقابل -kf على جهازي، فاعتبره غير مُختبر. استخراج روابط <loc> بنفسك وبذر katana بها هو النهج الذي أثق به اليوم.
ما الذي يجب أن أحفظه عند الإبلاغ عن اختبار تغطية لـ Katana؟
سجّل إصدار Katana والأمر الدقيق، بما في ذلك تعبير -fs حرفًا بحرف؛ وحدّد فئات نقاط النهاية قبل التشغيل؛ واحتفظ بسجلات الوصول من جانب الخادم إلى جانب مخرجات stdout؛ وافصل السلوك المقيس عن الفرضيات المبنية على الكود المصدري. بالنسبة لتشغيلات headless، سجّل إصدار المتصفح أيضًا — وهو ما لم أفعله في هذا الاختبار، مما يحدّ من قابلية إعادة الإنتاج.
هل يجب أن أستخدم -jc أم -headless أم كليهما؟
اختر بناءً على فئات نقاط النهاية التي تحتاجها. في هذه البيئة، عثر standard مع -jc على سلاسل مخزَّنة داخل ملف JavaScript، بينما عثر headless على نقطة النهاية المُدرَجة في runtime DOM. لم يغطِّ أي وضع الفئتين وحده، لذا كانت تشغيلة بمرحلتين متبوعة بإزالة التكرار الخيار الأكثر دفاعًا عنه للأهداف المختلطة.
هل يوقف رابط واحد فاشل عملية الزحف بأكملها؟ لم يحدث ذلك في هذا التشغيل المضبوط. استمرت katana بعد استجابة 500 ورابط معطَّل وأعادت المسارات الأخرى القابلة للوصول. هذا ليس بديلاً عن محاسبة الأخطاء في بيئة الإنتاج: احتفظ بسجلات الطلبات الفاشلة وحدّد معدل فشل مقبولًا، حتى لا يُخلط بين زحف ناجح جزئيًا وتغطية كاملة.




