
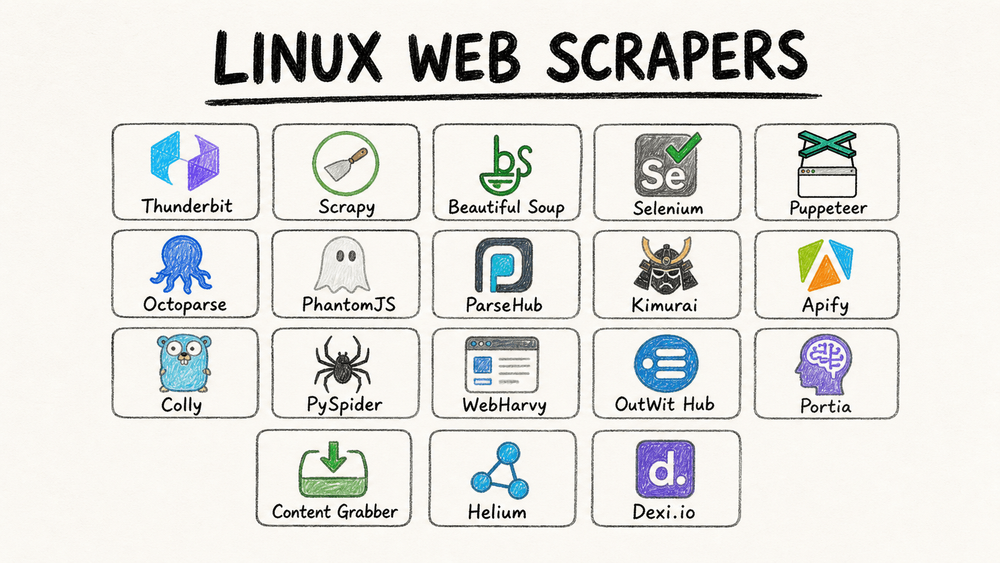
الويب مليء بالبيانات، ولنكن واقعيين: لا أحد عنده وقت ينسخ ويلصق آلاف قوائم المنتجات أو صفحات أسعار المنافسين يدويًا. إذا كنت تعمل على Linux — مثل ما أفعل أنا في أغلب أعمال الأتمتة والتطوير — فأنت تعرف أصلًا أن هذه المنصة تعتبر قوة حقيقية للفرق التي تعتمد على البيانات. في الواقع، أنظمة عائلة Unix تشغّل 91.9% من المواقع التي نعرف نظام تشغيلها، ويأتي Linux في المقدمة بين أنظمة هذه العائلة بفارق واضح. لكن المشكلة هي: العثور على أداة استخراج بيانات ويب مناسبة على Linux وتتماشى فعلًا مع طريقة عملك — سواء كنت مستخدم أعمال غير تقني أو مطور محترف — قد يبدو مثل البحث عن إبرة في كومة قش.
لذلك جمعتُ لك هذا الدليل المتعمق حول أفضل 18 أداة لاستخراج بيانات الويب على Linux لعام 2026. من الحلول المدعومة بالذكاء الاصطناعي والتي لا تحتاج إلى كتابة كود مثل Thunderbit (نعم، الأداة التي بنيناها أنا وفريقي) إلى أطر العمل الكلاسيكية للمطورين مثل Scrapy وBeautiful Soup، ستجد هنا اختصارًا عمليًا لاختيار أفضل أداة Web Scraper لـ Linux حسب احتياجاتك — من دون وجع رأس التجربة والخطأ.
لماذا تهم أدوات استخراج بيانات الويب على Linux للمستخدمين في الأعمال
تخلّص من النسخ واللصق قبل ما تختار الأداة Thunderbit يعمل داخل Chrome على جهاز Linux لديك — من دون إعدادات معقدة أو تعريفات، فقط جدول مرتب بنقرة واحدة. Get Started Free
خلّينا نكون صريحين: جمع البيانات يدويًا يضرب الإنتاجية في مقتل. الدراسات تشير إلى أن الفرق التي تعتمد على النسخ واللصق تهدر ساعات كل أسبوع، وترتكب معدل خطأ يقارب 5% — وهذا يعني أخطاء مكلفة وفرصًا تضيع (Thunderbit Blog). وبفضل الثبات والأمان والمرونة التي يوفرها Linux، فهو الخيار المفضل لتشغيل أدوات الاستخراج التي لازم تشتغل على مدار الساعة — سواء على سطح المكتب أو الخادم أو السحابة.
أشهر حالات الاستخدام التجارية لأدوات استخراج بيانات الويب على Linux:
- توليد العملاء المحتملين: فرق المبيعات تستخرج البيانات من الأدلة، ووسائل التواصل الاجتماعي، ومواقع المراجعات للحصول على جهات اتصال جديدة بدلًا من الشغل اليدوي المتعب (Thunderbit Blog).
- مراقبة الأسعار: فرق التجارة الإلكترونية تجمع أسعار المنافسين وبيانات المخزون تلقائيًا حتى تبقى التسعيرة محدثة ودقيقة.
- تحليل المنافسين: فرق التسويق والعمليات تتابع إطلاق المنتجات، والتقييمات، وكلمات SEO المفتاحية — من غير ما تشتغل “في الظلام”.
- ذكاء السوق: المحللون يجمعون الأخبار والمنتديات وبيانات الشبكات الاجتماعية لرصد الاتجاهات في الوقت الحقيقي.
- أتمتة سير العمل: بعض الأدوات، خصوصًا المدعومة بالذكاء الاصطناعي، يمكنها أتمتة مهام الويب مثل تعبئة النماذج أو التنقل داخل لوحات التحكم مباشرة من جهاز Linux.
والأجمل من هذا كله؟ أداة استخراج بيانات الويب المناسبة على Linux يمكنها تمكين المستخدمين غير التقنيين — وليس المبرمجين فقط — من الوصول إلى بيانات الويب واستثمارها لاتخاذ قرارات أسرع وأذكى.
كيف اخترنا أفضل أداة Web Scraper لـ Linux
ليست كل الأدوات بنفس المستوى، خصوصًا على Linux. وهذه هي المعايير التي اعتمدتُها:
- التوافق مع Linux: كل أداة هنا تعمل بشكل أصلي على Linux، أو عبر المتصفح، أو من خلال حل بسيط مثل Wine أو الوصول السحابي.
- سهولة الاستخدام: من أوامر الذكاء الاصطناعي باللغة الطبيعية إلى الواجهات المرئية بالنقر والسحب، ركزت على الأدوات التي تعطي غير المبرمجين نتائج سريعة — من دون تجاهل المستخدمين المحترفين الذين يريدون تحكمًا كاملًا.
- قوة الاستخراج: هل تتعامل مع المحتوى الديناميكي، والصفحات متعددة النتائج، والصفحات الفرعية، وأنواع البيانات المختلفة؟ وهل تصمد أمام أساليب الحماية ضد الاستخراج؟
- القابلية للتوسع والأتمتة: الجدولة، والاستخراج السحابي، والزحف الموزع — كلها ضرورية للمشاريع الجادة.
- التكامل والتصدير: CSV، Excel، Google Sheets، APIs — إذا ما قدرت تطلع البيانات بسهولة، فما الفائدة؟
- التسعير والترخيص: مجاني، مفتوح المصدر، أو مدفوع — هناك خيار يناسب كل ميزانية، من المؤسسين الفرديين إلى فرق المؤسسات.
- المجتمع والدعم: قاعدة مستخدمين نشطة، ووثائق جيدة، ودعم سريع الاستجابة يصنع فرقًا كبيرًا عند مواجهة أي مشكلة.
كما أضفتُ أيضًا آراء المستخدمين الحقيقية، والمراجعات المتخصصة، وتجربتي العملية مع هذه الأدوات. فلنبدأ بالقائمة.
1. Thunderbit
 Thunderbit هو خياري الأول للمستخدمين في الأعمال الذين يريدون أداة Web Scraper لـ Linux سهلة فعلًا. وبصفته إضافة Chrome مدعومة بالذكاء الاصطناعي، فهو يعمل بسلاسة على Linux (فقط افتح Chrome أو Chromium)، ويتيح لك استخراج البيانات من أي موقع بنقرة واحدة.
ما الذي يميز Thunderbit؟
- أوامر باللغة الطبيعية: فقط صف ما تريد (“استخرج جميع أسماء المنتجات والأسعار من هذه الصفحة”)، وذكاء Thunderbit الاصطناعي يتولى الباقي.
- اقتراح الحقول بالذكاء الاصطناعي: بنقرة واحدة، يمسح Thunderbit الصفحة ويقترح الأعمدة وأنواع البيانات — من غير ما تختار الحقول يدويًا.
- استخراج الصفحات الفرعية والصفحات المتعددة: تحتاج تفاصيل أكثر؟ يمكن لـ Thunderbit زيارة كل صفحة فرعية (مثل صفحات تفاصيل المنتج) وإثراء جدولك تلقائيًا.
- استخراج محلي أو سحابي: استخرج حتى 50 صفحة دفعة واحدة في السحابة، أو استخدم وضع المتصفح للمواقع التي تتطلب تسجيل الدخول.
- تصدير فوري: تصدير بنقرة واحدة إلى Excel أو Google Sheets أو Airtable أو Notion أو CSV أو JSON — مجانًا دائمًا.
- أدوات إضافية: استخراج البريد الإلكتروني وأرقام الهاتف والصور بنقرة واحدة. كما أن ميزة AI Autofill يمكنها أتمتة إدخال النماذج.
التسعير: باقة مجانية (6 صفحات شهريًا)، وتبدأ الخطط المدفوعة من 15 دولارًا شهريًا مقابل 500 صف (Thunderbit Pricing). يحب المستخدمون أنه “لا يحتاج إلى منحنى تعلم” وأنه “يحوّل ساعات العمل إلى دقائق” (Product Hunt Reviews). بالنسبة للمهام الضخمة، قد تحتاج إلى تقسيمها إلى تشغيلات أصغر، لكن في معظم حالات الاستخدام التجارية فهو يوفر وقتًا هائلًا.
التوافق مع Linux: 100%. فقط شغّل Chrome/Chromium على سطح مكتب Linux أو على الخادم.
الأفضل لـ: المستخدمين غير التقنيين في المبيعات والتسويق والعمليات الذين يريدون أسرع وأسهل إعداد.
جرّب Thunderbit مجانًا على Linux يعمل داخل Chrome على أي سطح مكتب Linux — من دون حزم تُبنى، ولا تعريفات تُثبَّت، واستخراج بنقرة واحدة. Get Started Free
2. Scrapy
 Scrapy هو المعيار الذهبي لمطوري Python الذين يريدون أداة Web Scraper مرنة وقابلة للتوسع على Linux. إنه مفتوح المصدر، شديد السرعة (زحف غير متزامن)، ويمكنه التعامل مع كل شيء من عمليات استخراج بسيطة إلى زحف موزع ضخم.
الميزات الأساسية:
- زحف غير متزامن وعالي السرعة — مثالي لاستخراج آلاف الصفحات.
- قابل للتوسعة بدرجة كبيرة: إضافات للـ proxies، وCAPTCHAs، وغير ذلك.
- يتكامل مع منظومة Python للبيانات: إخراج إلى JSON أو CSV أو قواعد البيانات أو pandas.
- يتعامل مع الكوكيز والجلسات وتنظيم المعدل تلقائيًا.
التسعير: مجاني ومفتوح المصدر بالكامل.
التوافق مع Linux: أصلي (يثبَّت عبر pip). ويعمل جيدًا على الخوادم والحاويات.
الأفضل لـ: المطورين الذين يبنون أدوات استخراج مخصصة وعلى نطاق واسع.
ملاحظة: هناك منحنى تعلم لغير المبرمجين، لكن إذا كنت تعرف Python فسيكون Scrapy من الصعب التغلب عليه.
3. Beautiful Soup
 Beautiful Soup هي مكتبة Python خفيفة لـ تحليل HTML وXML. وهي الخيار المفضل للاستخراج السريع والبسيط أو لتنظيف صفحات الويب الفوضوية.
الميزات الأساسية:
- واجهة بسيطة ومفهومة — ممتازة للمبتدئين.
- تعمل بشكل ممتاز مع requests لجلب الصفحات.
- تتعامل بمرونة مع HTML المكسور.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: 100% (Python خالص).
الأفضل لـ: المطورين وعلماء البيانات الذين ينفذون مهام استخراج أو تحليل صغيرة إلى متوسطة.
القيود: لا تتعامل مع JavaScript أو المحتوى الديناميكي — ويمكن دمجها مع Selenium أو Puppeteer عند الحاجة.
4. Selenium
 Selenium هو الإطار الكلاسيكي لأتمتة المتصفح. يتيح لك التحكم في Chrome أو Firefox أو متصفحات أخرى لاستخراج البيانات من المواقع الديناميكية الثقيلة بـ JavaScript.
الميزات الأساسية:
- يؤتمت المتصفحات الحقيقية — يمكنه تسجيل الدخول، والنقر، والتمرير، والتفاعل مثل الإنسان تمامًا.
- يدعم Python وJava وC# وغيرها.
- وضع Headless للتشغيل على خوادم Linux.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: دعم كامل (فقط ثبّت تعريف المتصفح المناسب).
الأفضل لـ: مهندسي QA، ومطوري الاستخراج، وكل من يحتاج إلى محاكاة سلوك المستخدم.
ملاحظة: يستهلك موارد أكثر وأبطأ من أدوات الاستخراج المعتمدة فقط على HTTP، لكنه أحيانًا يكون الطريقة الوحيدة للحصول على البيانات المطلوبة.
5. Puppeteer
 Puppeteer هي مكتبة Node.js من Google لـ التحكم في Chrome/Chromium بوضع headless. تشبه Selenium، لكنها تأتي بواجهة JavaScript حديثة وتكامل عميق مع خصائص Chrome.
الميزات الأساسية:
- ينفذ JavaScript، ويتعامل مع المحتوى الديناميكي، ويلتقط لقطات الشاشة.
- سريع ومستقر وسهل الاستخدام لمطوري Node.js.
- يعترض طلبات الشبكة ويحظر الموارد غير المرغوبة.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: يثبّت Chromium تلقائيًا؛ ويعمل بوضع headless افتراضيًا.
الأفضل لـ: المطورين الذين يجرون استخراجًا من تطبيقات ويب حديثة أو مواقع الصفحة الواحدة.
6. Octoparse
 Octoparse هو Web Scraper بلا كود بواجهة سحب وإفلات وقوالب جاهزة كثيرة. ورغم أن تطبيق سطح المكتب يعمل على Windows وMac فقط، يمكن لمستخدمي Linux الوصول إلى المنصة السحابية عبر المتصفح أو تشغيل تطبيق Windows باستخدام Wine.
الميزات الأساسية:
- أكثر من 100 قالب استخراج جاهز لمواقع مثل Amazon وeBay وZillow وغيرها.
- مصمم مرئي لسير العمل — انقر وحدد لبناء الأداة.
- استخراج سحابي وجدولة — دع خوادم Octoparse تتولى الشغل الثقيل.
- تصدير إلى Excel وCSV وJSON وقواعد البيانات.
التسعير: باقة مجانية (10 مهام، وحوالي 50 ألف صف شهريًا). تبدأ الخطط المدفوعة من 69 دولارًا شهريًا لخطة Standard (بالفوترة السنوية)؛ أما Professional فهي 249 دولارًا شهريًا. (Octoparse Pricing)
التوافق مع Linux: وصول سحابي/ويب؛ وتطبيق سطح المكتب عبر Wine.
الأفضل لـ: غير المبرمجين الذين يحتاجون بيانات التجارة الإلكترونية أو الأسواق بسرعة.
7. PhantomJS
 PhantomJS هو متصفح WebKit بوضع headless كان يومًا ما الخيار المفضل للأتمتة الخفيفة للمتصفح. وهو اليوم متوقف رسميًا، لكنه ما زال يعمل على Linux لبعض المهام القديمة أو البسيطة.
الميزات الأساسية:
- يمكن برمجته باستخدام JavaScript.
- يتعامل مع قدر متوسط من JavaScript ويلتقط الصور/PDF.
- لا يحتاج إلى واجهة رسومية.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: ملف تنفيذي أصلي.
الأفضل لـ: المشاريع القديمة أو البيئات التي لا يمكن فيها تثبيت Chrome.
تنبيه: تم إيقافه رسميًا في 2017 وتوقف تطويره في مارس 2018؛ وآخر إصدار كان v2.1.1. لا توجد تحديثات أمنية، ولا محرك JavaScript حديث، ولا يعمل جيدًا مع معظم المواقع الحالية. لأي مشروع جديد، استخدم Puppeteer أو Playwright بدلًا منه. ووجوده هنا فقط لأنه ما زال يظهر في بعض منظومات الاستخراج القديمة على Linux التي قد ترثها.
8. ParseHub
 ParseHub هو Web Scraper مرئي متعدد المنصات مع تطبيق أصلي على Linux. وهو خيار رائع لغير المبرمجين الذين يريدون استخراج بيانات من مواقع معقدة وديناميكية.
الميزات الأساسية:
- واجهة بالنقر والإشارة — اختر العناصر وابنِ سير العمل بصريًا.
- يتعامل مع المحتوى الديناميكي والخرائط والتمرير اللانهائي وغير ذلك.
- تنفيذ سحابي وجدولة.
- تصدير إلى CSV أو JSON أو عبر API.
التسعير: خطة مجانية (5 مشاريع)، وخطط مدفوعة تبدأ من 189 دولارًا شهريًا.
التوافق مع Linux: تطبيق أصلي لـ Linux وWindows وMac.
الأفضل لـ: المحللين والمستخدمين شبه التقنيين الذين يريدون التحكم من دون كتابة كود.
9. Kimurai
 Kimurai هو إطار عمل Ruby لاستخراج بيانات الويب يدعم Linux بشكل أصلي. يشبه Scrapy، لكنه موجّه لمطوري Ruby.
الميزات الأساسية:
- دعم متعدد للمتصفحات: Headless Chrome وFirefox وPhantomJS أو HTTP العادي.
- معالجة غير متزامنة لتزامن عالٍ.
- DSL نظيف بلغة Ruby لكتابة spiders.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: 100% (Ruby).
الأفضل لـ: مطوري Ruby أو فرق Rails التي تحتاج استخراجًا مخصصًا وعالي التوازي.
10. Apify
 Apify هي منصة سحابية لاستخراج بيانات الويب مع SDKs مفتوحة المصدر وسوق مليء بـ “actors” جاهزة. يمكنك تشغيل أدوات الاستخراج على جهاز Linux لديك أو في السحابة.
الميزات الأساسية:
- SDKs لـ Node.js وPython وغيرهما.
- سوق لأدوات استخراج جاهزة.
- تنفيذ سحابي وجدولة وتكامل عبر API.
التسعير: باقة مجانية، وتسعير حسب الاستخدام في السحابة.
التوافق مع Linux: يعمل CLI/SDK على Linux؛ والمنصة السحابية متاحة عبر المتصفح.
الأفضل لـ: المطورين الذين يريدون مزيجًا من البرمجة المخصصة والبنية التحتية السحابية الجاهزة.
11. Colly
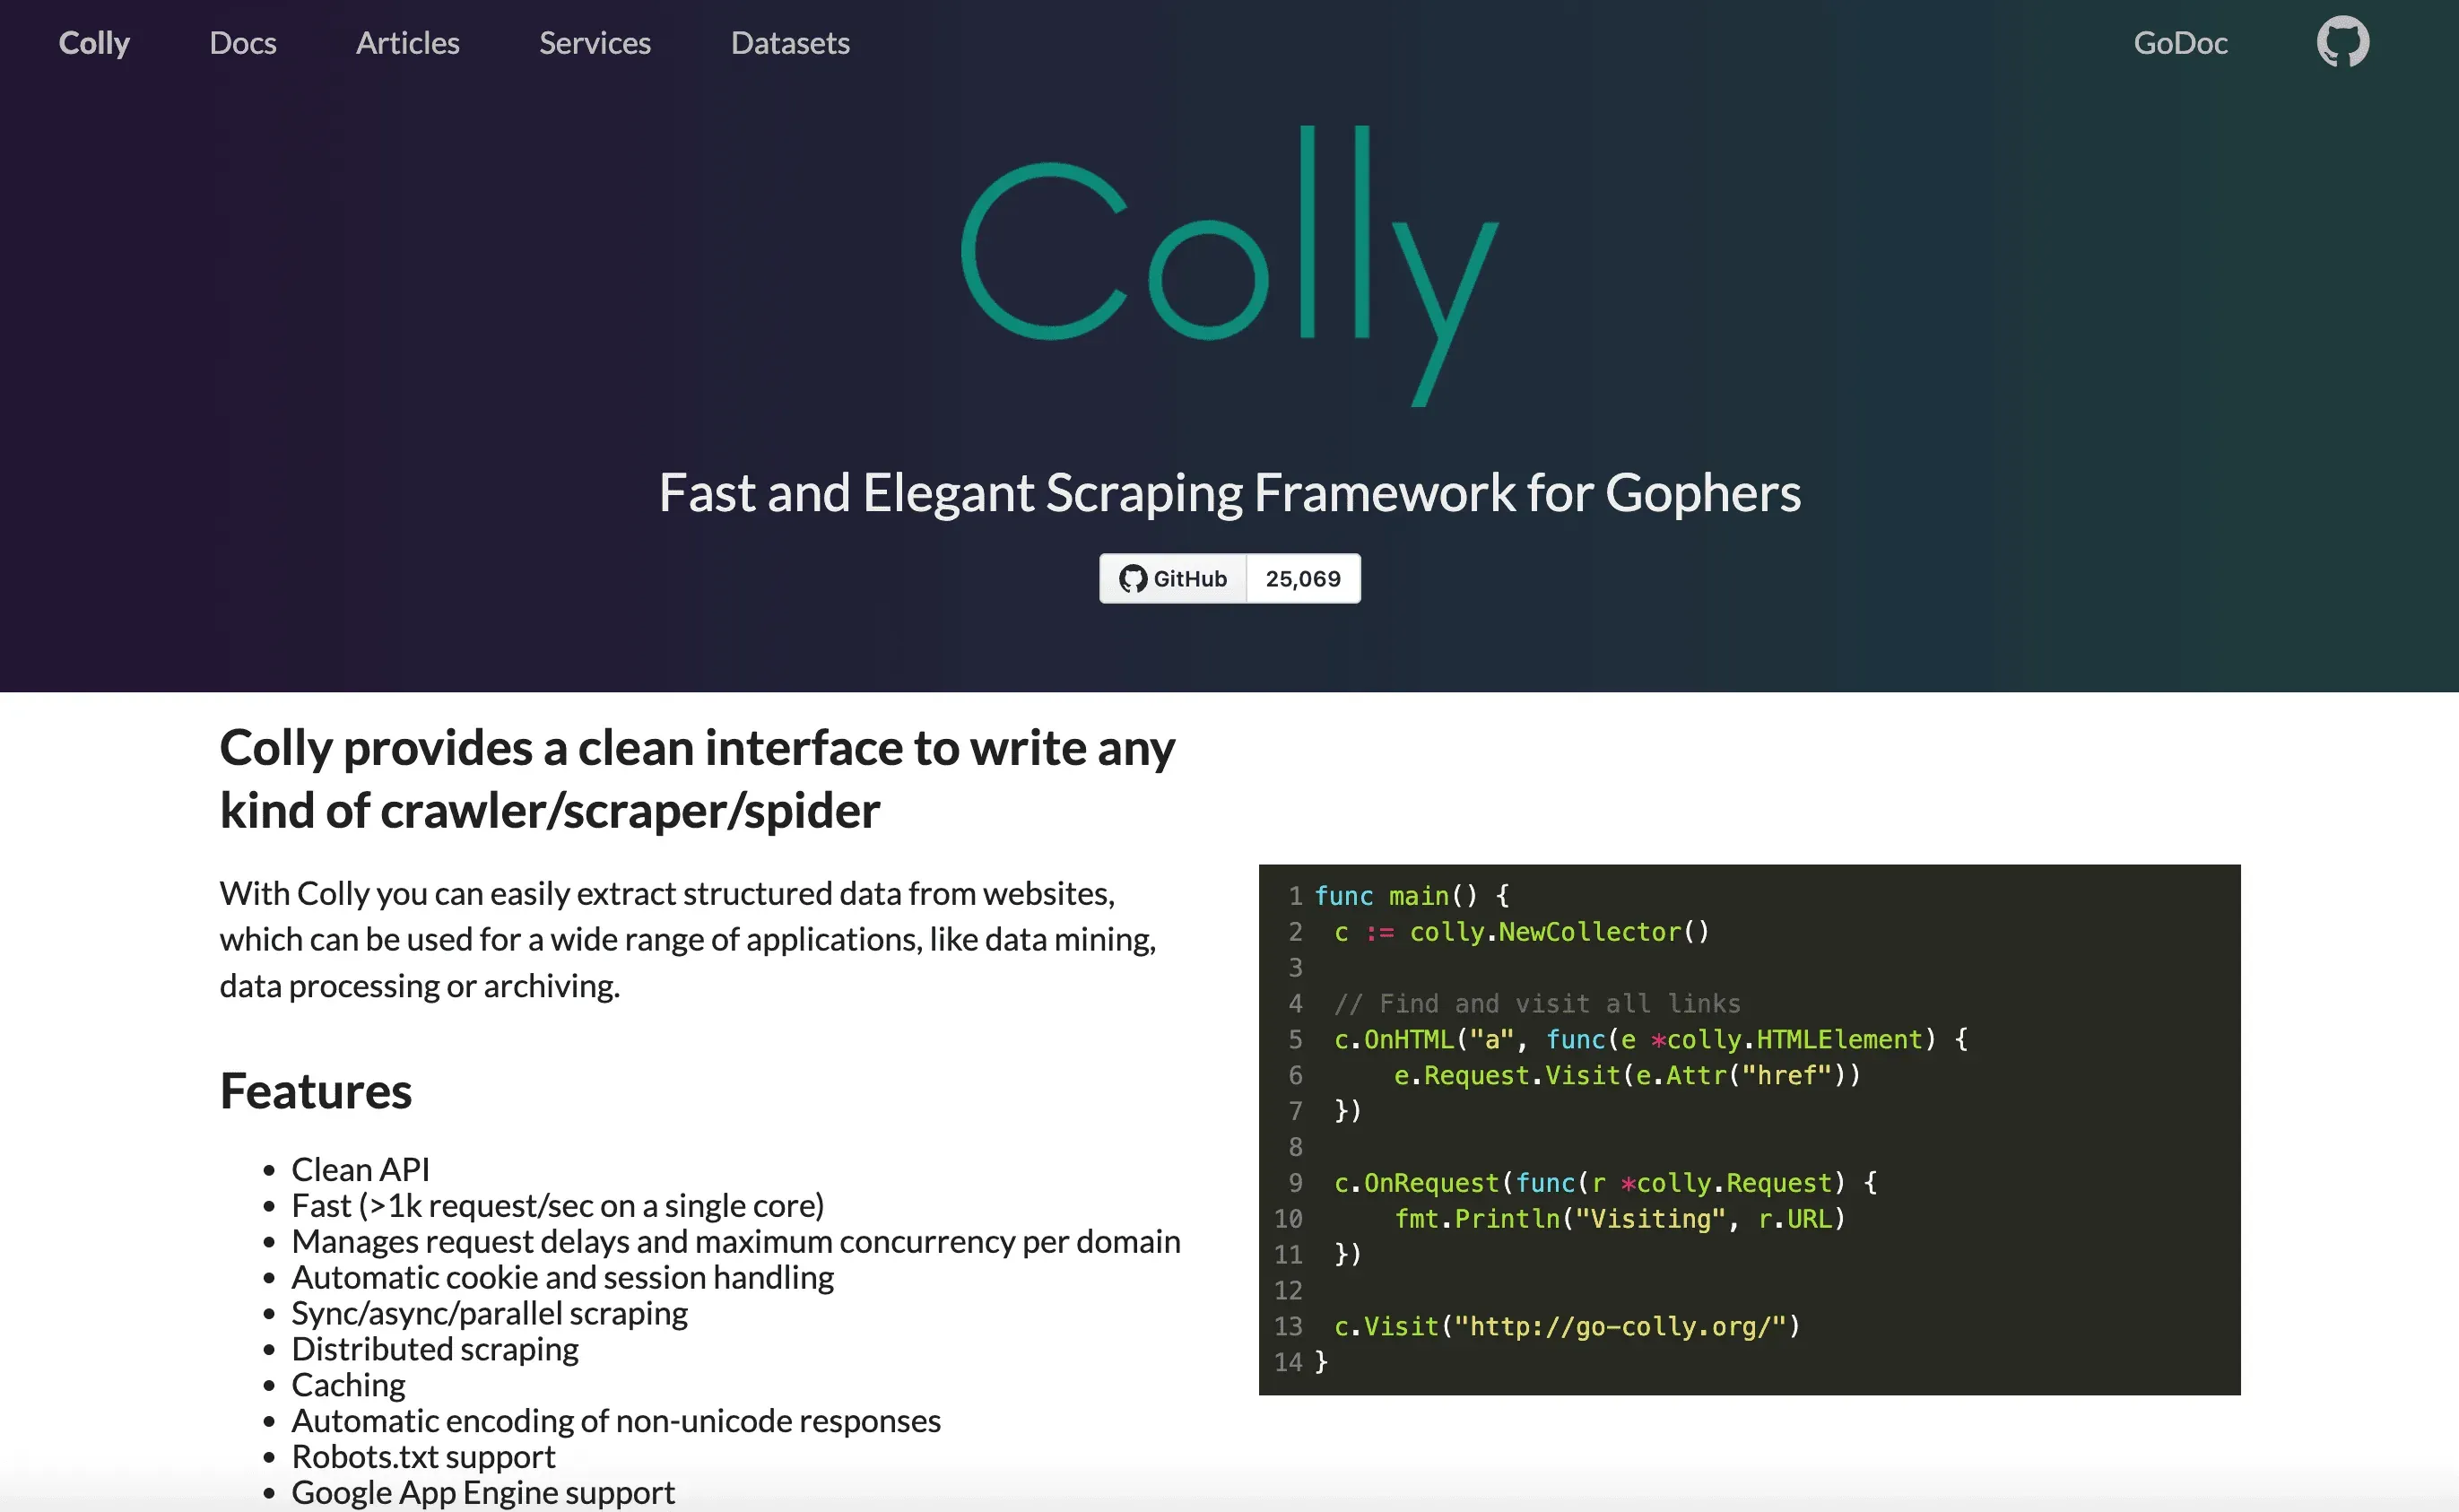 Colly هو إطار عمل لاستخراج بيانات الويب مبني على Go ومصمم للسرعة والكفاءة. إذا كنت مطور Go، فهذه هي أداتك.
الميزات الأساسية:
- استخراج سريع جدًا ومتوازي — أكثر من 1000 طلب/ثانية على نواة واحدة.
- زحف مهذب (يحترم robots.txt)، وإدارة للجلسات والكوكيز.
- استهلاك منخفض للذاكرة.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: ملفات Go أصلية.
الأفضل لـ: مطوري Go الذين يحتاجون استخراجًا عالي الأداء.
12. PySpider
 PySpider هو نظام زحف ويب بـ Python مع واجهة ويب — يمكنك إدارة عمليات الزحف وجدولتها ومراقبتها من المتصفح. ومن المهم التنبيه مبكرًا إلى أن المستودع تم تصنيفه كأرشيف عام على GitHub، والمؤلف الأصلي لم يعد يصدر إصدارات جديدة، لذا فالوضع الحالي هو ما تحصل عليه. إذا كنت تحتاج فقط إلى نموذج الواجهة/لوحة التحكم على Linux، فلا يزال يعمل؛ أما إذا كان الاعتماد عليه طويل الأمد، فاعتبره حلاً قديمًا.
الميزات الأساسية:
- واجهة ويب للبرمجة والمراقبة.
- زحف موزع، وجدولة، وإعادة محاولات.
- يتكامل مع قواعد البيانات وقوائم الرسائل.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: مصمم للنشر على Linux.
الأفضل لـ: الفرق التي لا تمانع في عمل fork وصيانة ذاتية لواجهة ويب لمشاريع متعددة (ولا تتوقع إصلاحات من المصدر).
13. WebHarvy
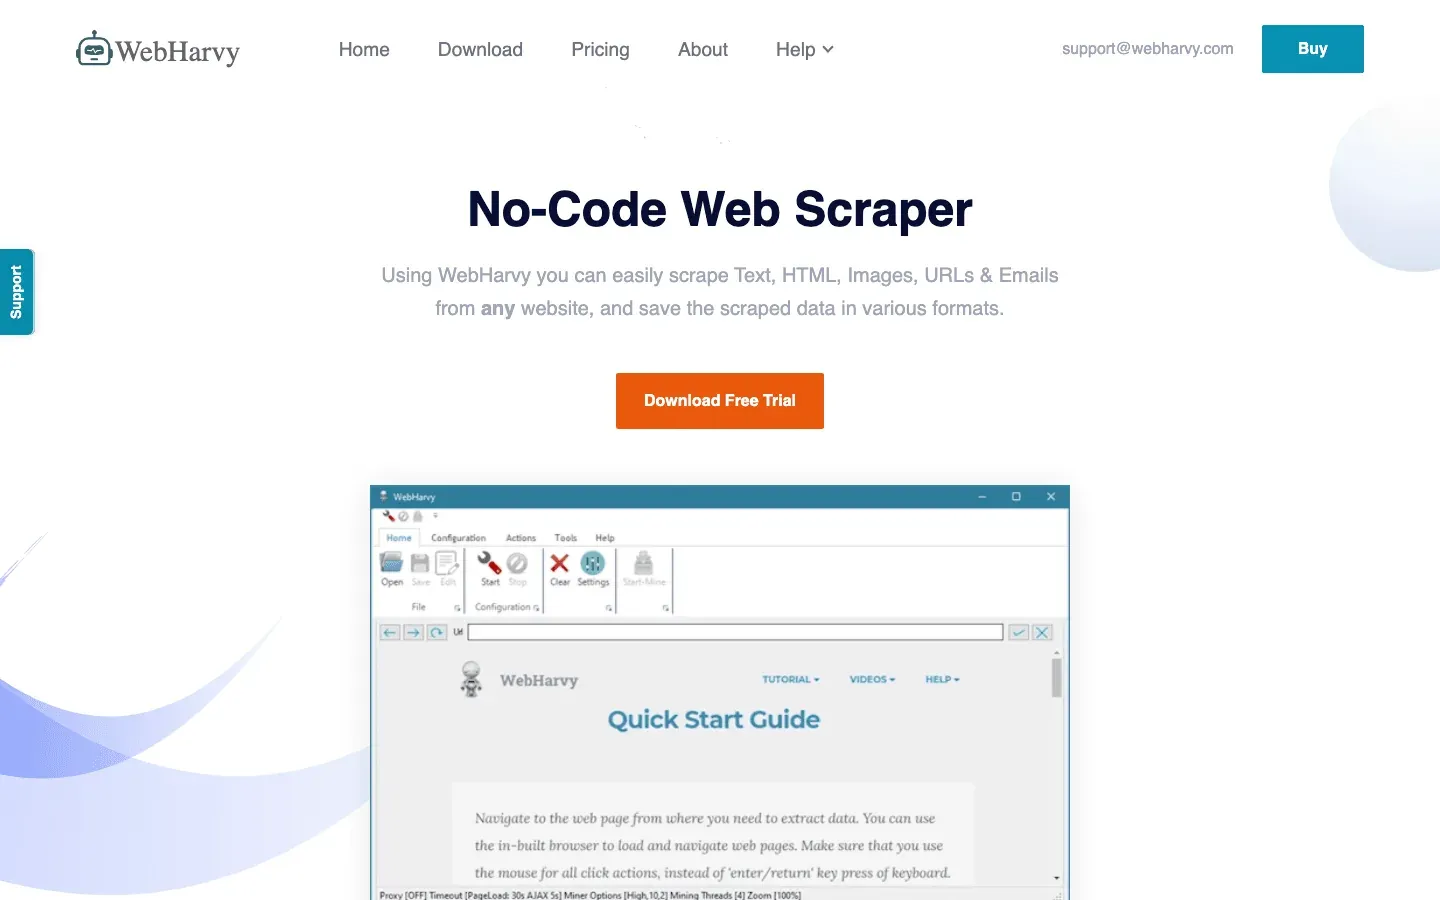 WebHarvy هو Web Scraper مرئي بالنقر والإشارة مخصص لـ Windows، لكن يمكن لمستخدمي Linux تشغيله عبر Wine. ويشتهر بقدرته على اكتشاف الأنماط ونموذج الشراء لمرة واحدة.
الميزات الأساسية:
- تصفح وانقر لتحديد البيانات — من دون كود.
- اكتشاف تلقائي لأنماط القوائم.
- تصدير إلى CSV وJSON وXML وSQL.
التسعير: ترخيص لمرة واحدة بحوالي 129 دولارًا.
التوافق مع Linux: يعمل عبر Wine أو VM.
الأفضل لـ: المبتدئين أو المحترفين المستقلين الذين يريدون أداة مرئية وسريعة.
14. OutWit Hub
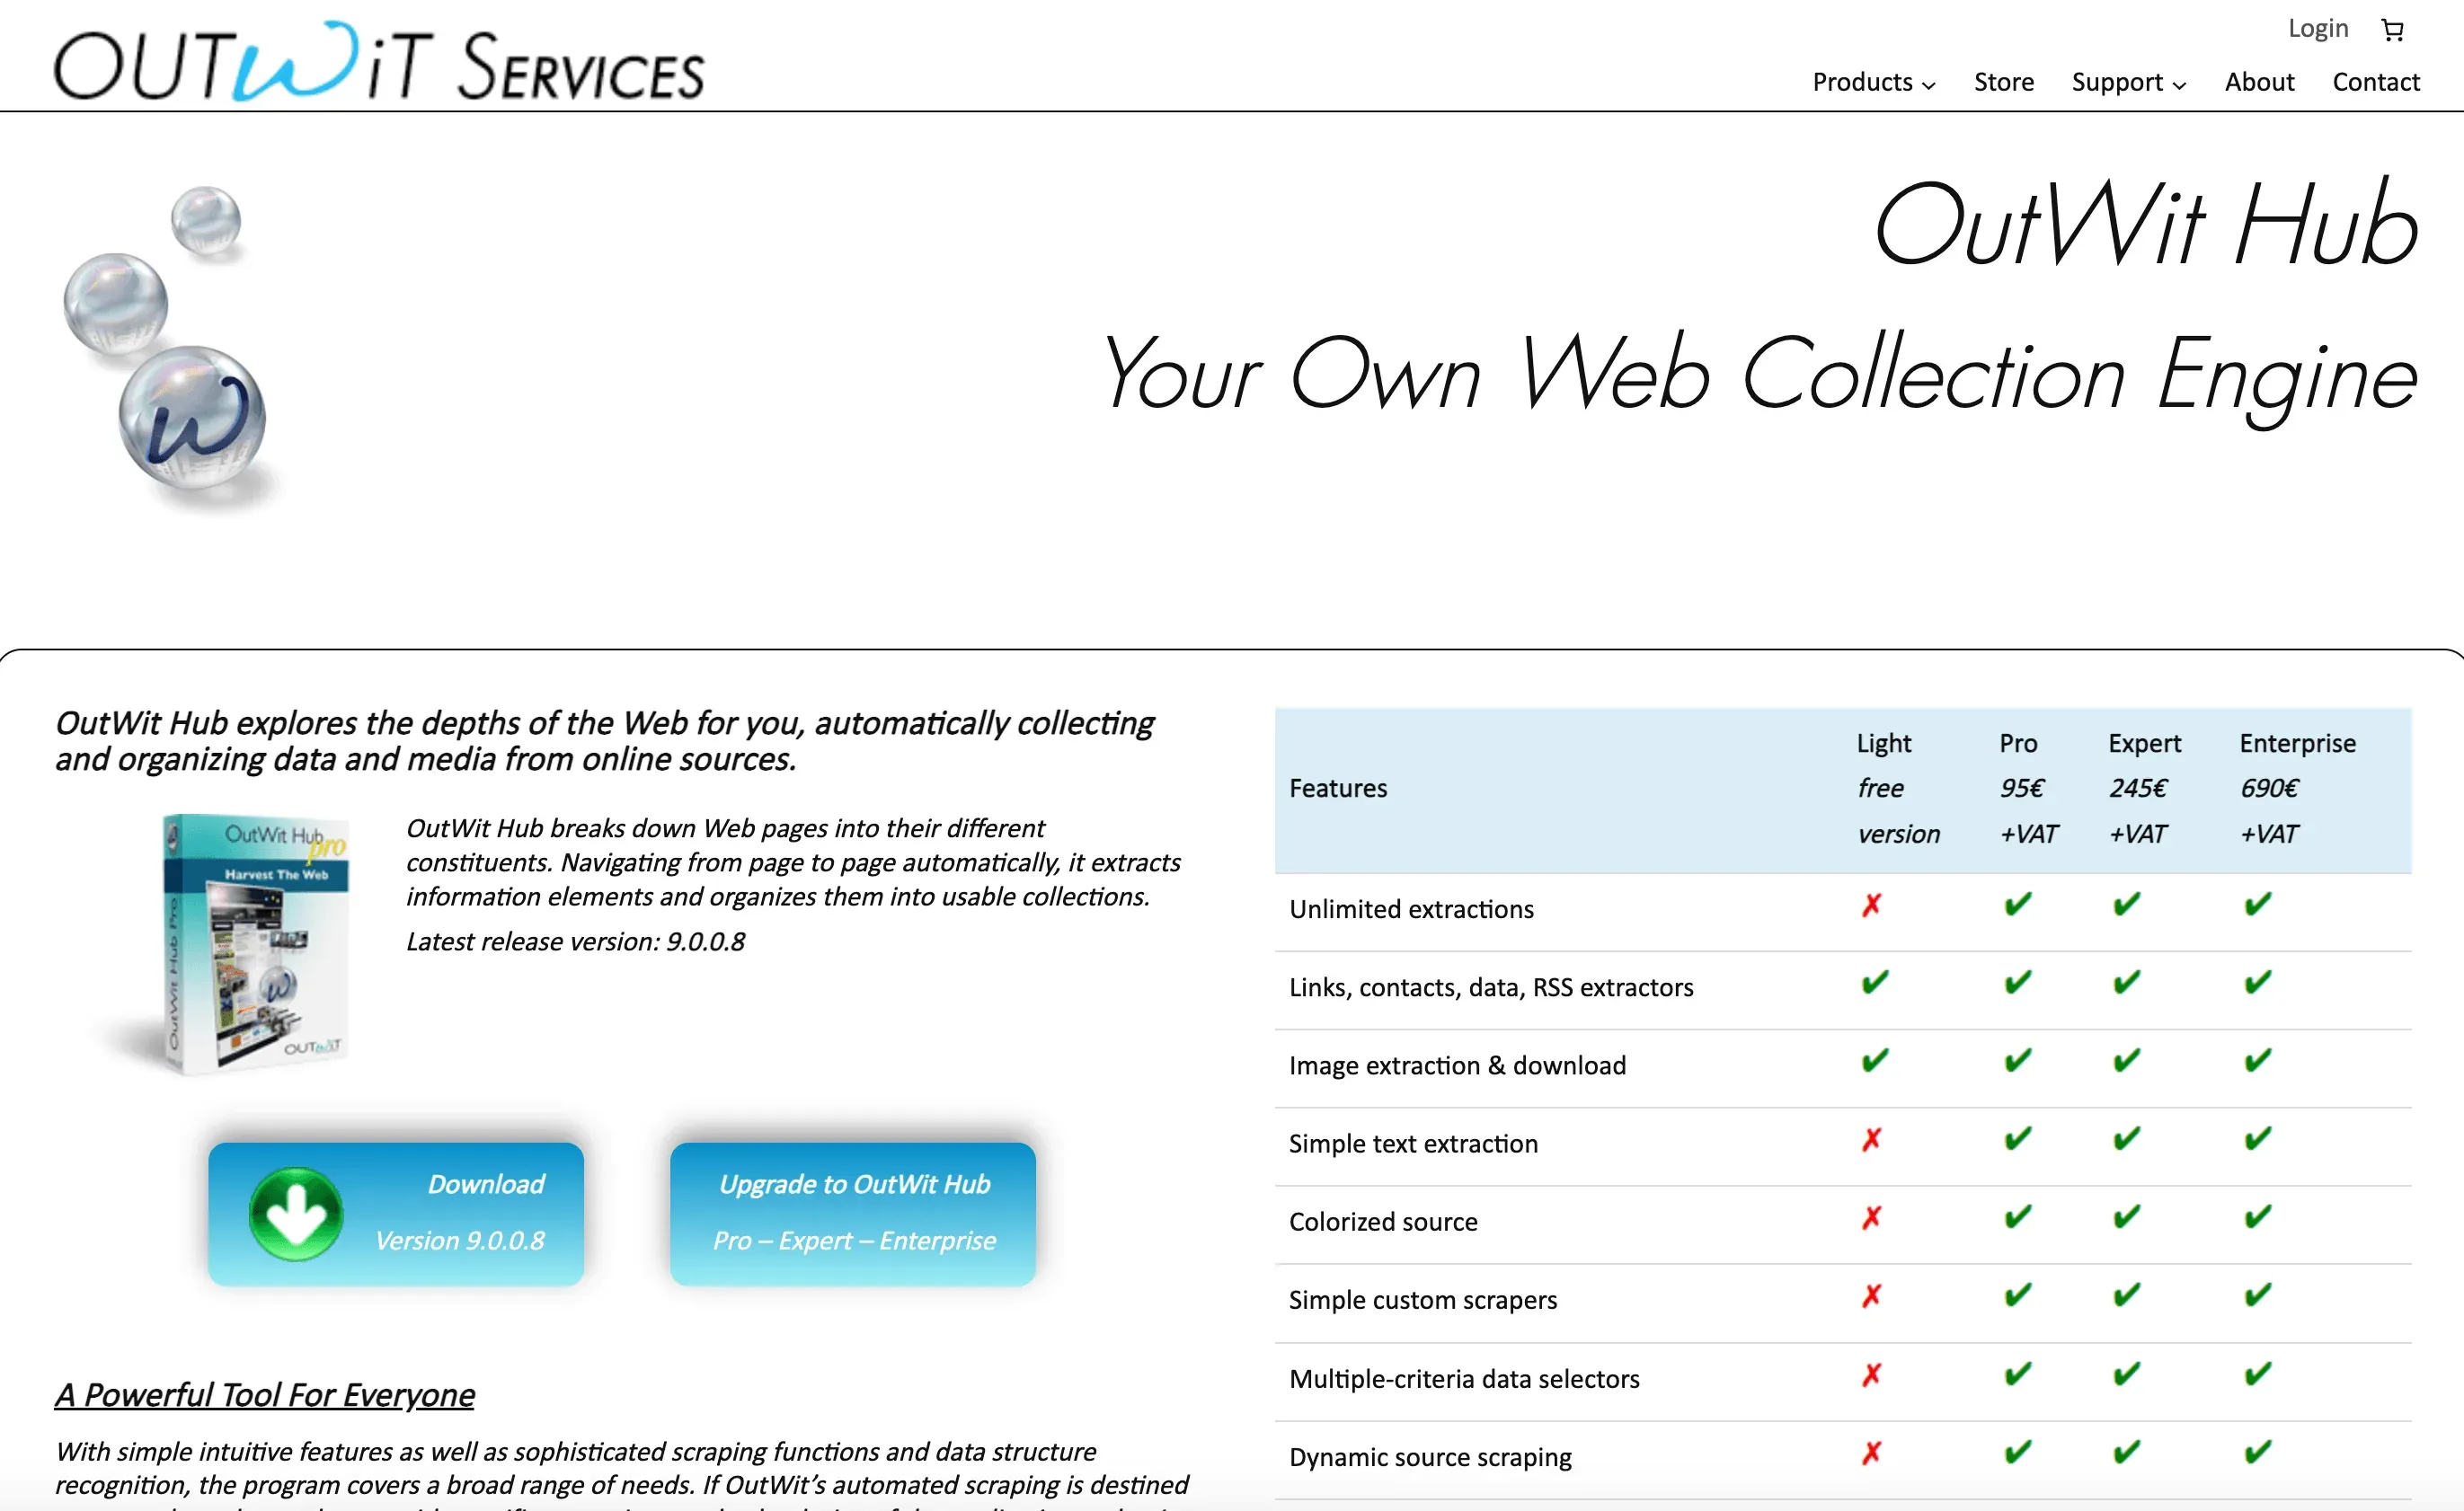 OutWit Hub هو تطبيق واجهة رسومية أصلي لـ Linux لاستخراج بيانات الويب. يتعرف تلقائيًا على أنماط البيانات ويقدم قدرات قوية للاستخراج والأتمتة.
الميزات الأساسية:
- يتعرف تلقائيًا على الروابط والصور والجداول والبريد الإلكتروني وغير ذلك.
- محرر سكربتات لاستخراج مخصص.
- أتمتة عبر الماكرو والجدولة.
التسعير: نسخة مجانية (محدودة)؛ وترخيص Pro مدفوع — راجع متجر المورّد لمعرفة السعر الحالي.
التوافق مع Linux: تطبيق أصلي لـ Linux وWindows وMac.
الأفضل لـ: غير المبرمجين ذوي الميول التقنية الذين يريدون أداة سطح مكتب بواجهة رسومية.
15. Portia
 Portia هو Web Scraper مرئي مفتوح المصدر من Scrapinghub. يعمل في المتصفح ويتيح لك وضع تعليقات على الصفحات لتدريب أدوات الاستخراج — لكن تنبيه مهم: المستودع لم يشهد تطورًا حقيقيًا منذ أكثر من عام، لذا فهو يدخل منطقة “استخدمه على مسؤوليتك”. إذا أردت الفكرة المرئية مع تطوير نشط خلفها، فـ ParseHub أو Thunderbit خيارات أنظف.
الميزات الأساسية:
- واجهة قائمة على المتصفح للاستخراج المرئي.
- يتكامل مع Scrapy للمشاريع المخصصة.
- مفتوح المصدر وقابل للتوسعة.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: يعتمد على المتصفح؛ ويعمل على أي نظام تشغيل.
الأفضل لـ: المستخدمين الذين يريدون استخراجًا مرئيًا مفتوح المصدر مع تكامل Scrapy.
16. Sequentum Enterprise (formerly Content Grabber)
 Sequentum Enterprise هو أداة استخراج مرئية بمستوى مؤسسي مخصصة لـ Windows، لكن يمكن تشغيلها على Linux عبر Wine أو المحاكاة الافتراضية.
الميزات الأساسية:
- محرر مرئي مع برمجة C# لمنطق متقدم.
- إدارة متعددة للوكلاء وجدولة.
- يتكامل مع قواعد البيانات وواجهات API وغير ذلك.
التسعير: ترخيص مؤسسي بسعر يتم تحديده حسب النشر.
التوافق مع Linux: عبر Wine أو VM.
الأفضل لـ: الوكالات والفرق الكبيرة التي تدير العديد من مشاريع الاستخراج.
17. Helium
 Helium هي مكتبة Python تبسط أتمتة Selenium. صُممت لتجعل برمجة المتصفح أقرب إلى السلوك البشري.
الميزات الأساسية:
- أوامر بديهية مثل
click("Login")أوwrite("email"). - تؤتمت Chrome وFirefox.
- ممتازة للبرمجة السريعة ومهام الأتمتة.
التسعير: مجاني ومفتوح المصدر.
التوافق مع Linux: يعمل على Linux (مبني على Selenium).
الأفضل لـ: مستخدمي Python الذين يجدون Selenium ثقيلًا أو معقدًا.
18. Dexi.io
 Dexi.io هي منصة سحابية لاستخراج البيانات والأتمتة. يمكن الوصول إليها عبر المتصفح، لذا يمكن لمستخدمي Linux استخدامها من دون أي تثبيت.
الميزات الأساسية:
- مصمم مرئي لسير العمل لاستخراج البيانات والأتمتة.
- الجدولة، وتحويل البيانات، وتكامل API.
- قابلية توسع ودعم بمستوى المؤسسات.
التسعير: تُباع حاليًا تحت Mozenda: تجربة مجانية لمدة 14 يومًا، وخطة Pilot بسعر 500 دولار شهريًا، وخطط مؤسسية حسب العرض.
التوافق مع Linux: تطبيق ويب — يعمل على أي نظام تشغيل.
الأفضل لـ: المحترفين والمؤسسات التي تحتاج إلى استخراج بيانات ويب متكامل وقابل للتوسع.
جدول مقارنة سريع: أدوات استخراج بيانات الويب على Linux في لمحة
| الأداة | النوع / أبرز الميزات | الأنسب لـ | التسعير | التوافق مع Linux |
|---|---|---|---|---|
| Thunderbit | إضافة Chrome مدعومة بالذكاء الاصطناعي، بنقرة واحدة، صفحات فرعية، سحابي/محلي | المستخدمون التجاريون غير التقنيين | مجاني، تبدأ من 15$/شهر | ✔ Chrome على Linux |
| Scrapy | إطار Python، غير متزامن، CLI، قابل للتوسعة بدرجة كبيرة | المطورون، الاستخراج المخصص واسع النطاق | مجاني | ✔ أصلي |
| Beautiful Soup | مكتبة Python، تحليل بسيط لـ HTML/XML | المطورون، علماء البيانات، المهام الصغيرة | مجاني | ✔ أصلي |
| Selenium | أتمتة متصفح، مواقع ثقيلة بـ JS | QA، المطورون، المحتوى الديناميكي | مجاني | ✔ أصلي |
| Puppeteer | Node.js، Chrome headless، عرض JavaScript | مطورو Node، تطبيقات الويب الحديثة | مجاني | ✔ أصلي |
| Octoparse | بلا كود، سحب وإفلات، قوالب سحابية | غير المبرمجين، التجارة الإلكترونية | مجاني، تبدأ من 69$/شهر | ◐ سحابي/Wine |
| PhantomJS | WebKit headless، JavaScript قابل للبرمجة | الأنظمة القديمة، الخفيف، من دون Chrome | مجاني | ✔ أصلي |
| ParseHub | مرئي، متعدد المنصات، بالنقر والإشارة | المحللون، المستخدمون شبه التقنيين | مجاني، تبدأ من 189$/شهر | ✔ أصلي |
| Kimurai | إطار Ruby، متصفح متعدد، غير متزامن | مطوري Ruby، التوازي العالي | مجاني | ✔ أصلي |
| Apify | منصة سحابية، SDKs، سوق | المطورون، المزيج بين الكود والسحابة | باقة مجانية، حسب الاستخدام | ✔ أصلي/سحابي |
| Colly | إطار Go، سريع، متوازي | مطوري Go، الأداء العالي | مجاني | ✔ أصلي |
| PySpider | Python، واجهة ويب، جدولة، موزع | الفرق، مشاريع متعددة | مجاني | ✔ أصلي |
| WebHarvy | مرئي، اكتشاف الأنماط، ترخيص لمرة واحدة | المبتدئون، المحترفون المستقلون | حوالي 129$ مرة واحدة | ◐ Wine/VM |
| OutWit Hub | واجهة رسومية أصلية، يكتشف البيانات تلقائيًا، برمجة | غير المبرمجين، واجهة سطح مكتب | مجاني؛ Pro مدفوع (راجع البائع) | ✔ أصلي |
| Portia | مفتوح المصدر، مرئي، يعتمد على المتصفح | مفتوح المصدر، تكامل Scrapy | مجاني | ✔ عبر المتصفح |
| Sequentum Enterprise | مؤسسي، مرئي، برمجة، متعدد الوكلاء | الوكالات، الفرق الكبيرة | $$$، حسب العرض | ◐ Wine/VM |
| Helium | Python، Selenium مبسط، واجهة بديهية | مستخدمو Python، أتمتة سريعة | مجاني | ✔ أصلي |
| Dexi.io | سحابي، سير عمل مرئي، جدولة، API | المؤسسات، الأتمتة القابلة للتوسع | يبدأ من 500$/شهر (عبر Mozenda) | ✔ عبر المتصفح |
كيف تختار أداة Web Scraper المناسبة لـ Linux: أهم الاعتبارات
لست متأكدًا من الباقة التي تحتاجها؟ ابدأ بالحل الأسهل إذا كنت لا تريد صيانة المحددات يدويًا، دع الذكاء الاصطناعي يستنتج الحقول لك — بنقرة واحدة، ثم صدّر إلى Sheets أو Excel أو Airtable أو Notion. Get Started Free
اختيار الأداة المناسبة يعتمد على مطابقة احتياجاتك مع مستوى مهارتك:
- مستوى المهارة التقنية: غير المبرمجين ينبغي أن يميلوا إلى Thunderbit أو ParseHub أو Octoparse أو OutWit Hub. أما المطورون فيمكنهم الاستفادة من قوة أكبر مع Scrapy أو Puppeteer أو Colly أو Kimurai.
- تعقيد البيانات: للصفحات الثابتة، تكون Beautiful Soup أو Colly سريعتين وبسيطتين. أما المواقع الديناميكية الثقيلة بـ JavaScript، فستحتاج إلى Selenium أو Puppeteer أو أداة مرئية تدعم JavaScript.
- الحجم والتكرار: للمهام لمرة واحدة، تكفي الأدوات بلا كود أو الأدوات السحابية. أما الزحف المجدول واسع النطاق، فاختر Scrapy أو PySpider أو Apify.
- احتياجات التكامل: هل تحتاج إلى التصدير إلى Excel أو Sheets أو قاعدة بيانات؟ تأكد من أن الأداة تدعم سير عملك.
- الميزانية: تتوفر خيارات مجانية ومفتوحة المصدر بكثرة للمبرمجين. أما المستخدمون التجاريون، فيمكنهم الاعتماد على Thunderbit وParseHub كنقاط دخول مناسبة، بينما قد تستثمر الفرق المؤسسية في Dexi.io أو Sequentum Enterprise.
- الدعم والمجتمع: الأدوات مفتوحة المصدر تملك مجتمعات كبيرة؛ أما الأدوات التجارية فتوفر دعمًا مخصصًا.
نصيحة احترافية: لا تتردد في الجمع بين الأدوات. استخدم Thunderbit للنمذجة الأولية واكتشاف أنماط البيانات، ثم انتقل إلى Scrapy عندما تحتاج إلى الزحف على مستوى الإنتاج. أو استخدم Selenium لتسجيل الدخول والحصول على ملفات الجلسة، ثم سلّم المهمة إلى Colly أو Scrapy لاستخراج عالي السرعة.
الخلاصة: اعثر على أفضل أداة لاستخراج بيانات الويب على Linux لعام 2026
مستخدمو Linux أمامهم خيارات كثيرة في 2026. سواء كنت تريد أداة بلا كود مدعومة بالذكاء الاصطناعي تعطيك النتائج في دقائق مثل Thunderbit، أو إطارًا قويًا للمطورين مثل Scrapy وColly، أو منصة بمستوى المؤسسات مثل Dexi.io، فهناك Web Scraper لـ Linux يناسب احتياجاتك وطريقة عملك.
أهم النقاط المستخلصة:
- Linux هو العمود الفقري للبنية التحتية الحديثة للبيانات — ومعظم أدوات الاستخراج الكبيرة تعمل عليه بشكل أصلي أو عبر المتصفح.
- أدوات الذكاء الاصطناعي والأدوات بلا كود تجعل استخراج بيانات الويب متاحًا أيضًا لفرق الأعمال.
- أطر العمل الخاصة بالمطورين ما زالت تتفوق في المرونة والسرعة والتوسع.
- جرّب قبل الشراء — فمعظم الأدوات تقدم خططًا مجانية أو تجارب.
هل أنت مستعد للبدء؟ حمّل Thunderbit أو تصفح Thunderbit Blog لمزيد من الأدلة حول استخراج بيانات الويب، والأتمتة، والنمو المعتمد على البيانات.
اكتشف أداة Thunderbit المدعومة بالذكاء الاصطناعي لاستخراج بيانات الويب تخلّ عن السكربتات ومهام cron — دع الذكاء الاصطناعي يقرأ الصفحة ويسلّمك جدولًا بنقرة واحدة. Get Started Free
الأسئلة الشائعة
1. ما أسهل أداة لاستخراج بيانات الويب على Linux إذا كنت لا أعرف البرمجة؟
Thunderbit هو الخيار الأول للمستخدمين غير التقنيين. يعمل كإضافة Chrome على Linux، ويستخدم الذكاء الاصطناعي لأتمتة كل شيء، ويتيح لك استخراج البيانات بنقرة واحدة فقط.
2. أي أداة Linux Web Scraper هي الأفضل للمشاريع المخصصة واسعة النطاق؟
Scrapy هو الخيار المفضل للمطورين. إنه سريع، وقابل للتوسع، وقابل للتخصيص بدرجة عالية — ومثالي لعمليات الزحف الكبيرة والمتكررة.
3. هل يمكنني استخراج مواقع ثقيلة بـ JavaScript أو ديناميكية على Linux؟
نعم! استخدم Selenium أو Puppeteer للتحكم في متصفحات حقيقية واستخراج المحتوى الديناميكي. كما أن الأدوات المرئية مثل ParseHub وThunderbit تدعم المواقع الديناميكية أيضًا.
4. هل توجد أدوات مجانية لاستخراج بيانات الويب على Linux للاستخدام التجاري؟
أكيد. Scrapy وBeautiful Soup وSelenium وColly وPySpider وKimurai كلها مجانية ومفتوحة المصدر. كما أن Thunderbit وParseHub يقدمان خططًا مجانية للمهام الصغيرة.
5. كيف أختار بين أدوات Linux بلا كود والأدوات المعتمدة على الكود؟
إذا كنت تريد السرعة والبساطة، فاختر بلا كود (Thunderbit أو ParseHub أو Octoparse). وإذا كنت تحتاج إلى المرونة أو الأتمتة أو التكامل مع أنظمة أخرى، فالأدوات المعتمدة على الكود مثل Scrapy وPuppeteer وColly هي الخيار الأفضل.
استمتع بالاستخراج — ولتكن مشاريعك المعتمدة على Linux أكثر سلاسة من تثبيت Ubuntu جديد تمامًا. وإذا أردت المزيد من نصائح استخراج البيانات من الويب، فراجع Thunderbit Blog أو اشترك في قناتنا على YouTube للحصول على شروحات عملية.
جرّب AI Web Scraper لـ Linux Get Started Free
اعرف المزيد



