
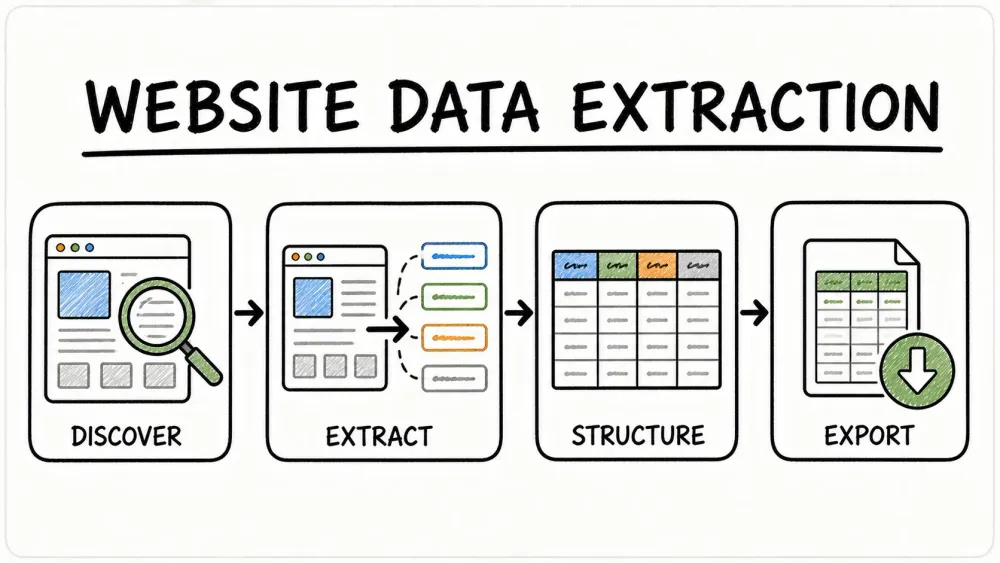
الويب مليان معلومات، لكن كيف تحوّل هذا الكمّ الهائل إلى بيانات قابلة للاستخدام في الأعمال؟ هنا يكمن التحدي الحقيقي — ومعه الفرصة أيضًا. خلال سنوات عملي في بناء برمجيات SaaS وأدوات الأتمتة، شاهدت كيف انتقل العالم من القرارات المبنية على الحدس إلى كل شيء قائم على البيانات. وما عاد الموضوع مقتصرًا على الشركات العملاقة؛ حتى الفرق الصغيرة اليوم تسارع إلى استخراج البيانات من الموقع الإلكتروني لدعم المبيعات والتسويق والتسعير وتحركات المنتج. لكن مع ازدياد الويب تعقيدًا وديناميكية، صار الحصول على بيانات نظيفة ومتوافقة ومفيدة منه لعبة مختلفة تمامًا.
خلّنا نخلي الموضوع عملي: سأشرح لك ليه يُعد استخراج البيانات من المواقع أمرًا مهمًا جدًا للأعمال الحديثة، وأكبر العقبات اللي بتواجهك، وأفضل الممارسات — بما فيها دروس تعلمناها بالطريقة الصعبة داخل فريق Thunderbit — عشان تنفذه صح: بشكل قانوني، بكفاءة، وعلى نطاق واسع. سواء كنت تتعامل مع محتوى غير منظم، أو قلق من GDPR، أو بس تبي تتوقف عن النسخ واللصق في جداول البيانات، فهذا الدليل لك.
لماذا يُعد استخراج البيانات من المواقع مهمًا للأعمال الحديثة
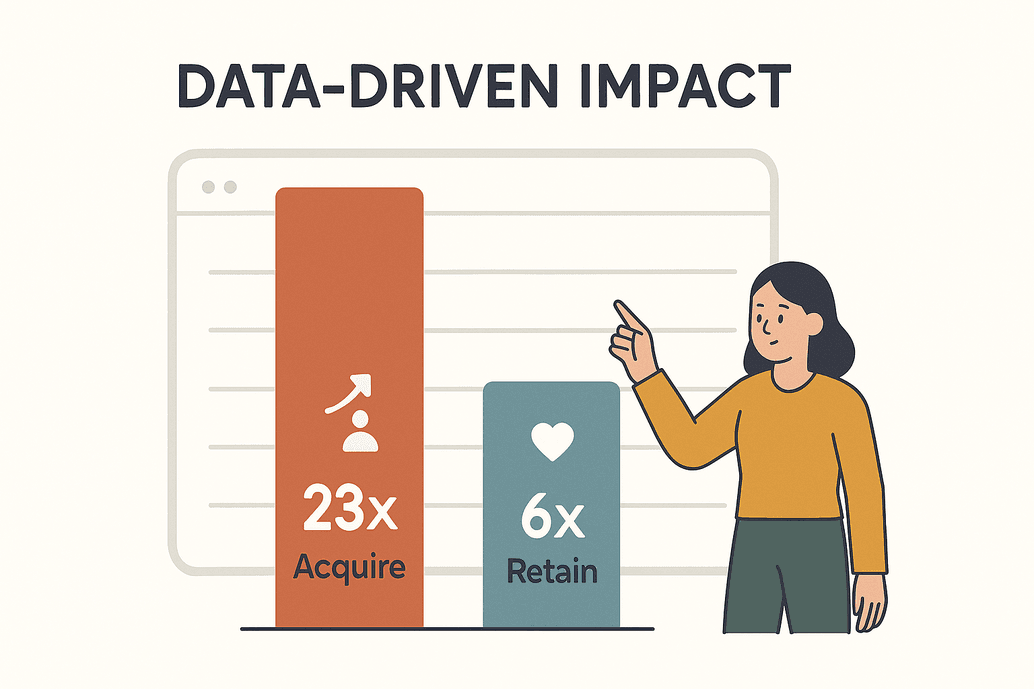 البيانات مو مجرد كلمة رائجة؛ هي شريان الحياة للأعمال التنافسية اليوم. ووفقًا لاستطلاع McKinsey، فإن المؤسسات القائمة على البيانات أكثر احتمالًا بـ 23 مرة لاكتساب العملاء و6 مرات للاحتفاظ بهم. وهذا مو مجرد إنجاز جميل، بل مسألة بقاء. وبحلول عام 2025، ستقوم الشركات باستخراج مليارات الصفحات يوميًا لتغذية التحليلات ونماذج الذكاء الاصطناعي واتخاذ القرار في الوقت الفعلي (kanhasoft.com).
طيب كيف يبان هذا على أرض الواقع؟ هنا بعض السيناريوهات اللي أشوفها كل أسبوع:
| التطبيق التجاري | الوصف والفوائد | مثال/إحصائية |
|---|---|---|
| مراقبة الأسعار | تتبع أسعار المنافسين والمخزون والعروض الترويجية لحظة بلحظة، ثم تعديل استراتيجيتك للبقاء في الصدارة. | أكثر من 80% من كبار تجار التجزئة عبر الإنترنت يستخرجون أسعار المنافسين يوميًا (kanhasoft.com). |
| توليد العملاء المحتملين | استخراج الدلائل أو وسائل التواصل الاجتماعي أو مواقع المراجعات للحصول على عملاء محتملين جدد ومعلومات اتصال. | الاستخراج الآلي للبيانات يملأ أنظمة CRM أسرع بكثير من البحث اليدوي. |
| تحليل اتجاهات السوق | تجميع المراجعات والمنتديات والأخبار لاكتشاف الاتجاهات أو تغيّر المزاج العام مبكرًا. | 26% من أنشطة الاستخراج تتركز على وسائل التواصل الاجتماعي للحصول على رؤى حول الاتجاهات (blog.apify.com). |
| تجميع المحتوى | جمع الأخبار أو قوائم المنتجات أو الفعاليات من عدة مواقع لتسهيل الوصول إليها. | فرق الإعلام تنظم خلاصات محتوى لجمهورها. |
| بيانات المنتجات والبحث | جمع تفاصيل المنتجات والمراجعات أو بيانات البحث لأغراض التحليل والتطوير. | 67% من مستشاري الاستثمار يستخدمون بيانات ويب بديلة (scrap.io). |
| بيانات تدريب الذكاء الاصطناعي | سحب كميات ضخمة من النصوص أو الصور أو السجلات لتدريب نماذج الذكاء الاصطناعي. | نحو 70% من النماذج الكبيرة للذكاء الاصطناعي تعتمد على بيانات ويب مستخرجة (kanhasoft.com). |
إذا ما كنت تستخرج البيانات من المواقع، فأنت مو بس تتأخر — أنت فعليًا تصير غير مرئي في سوقك. شفت فرق تجارة إلكترونية تضاعف عائد الاستثمار ثلاث مرات خلال ستة أشهر بمجرد أتمتة استخراج أسعار المنافسين (kanhasoft.com). الخلاصة: بيانات الويب أصل استراتيجي، واستخراجها بكفاءة صار من أساسيات النجاح.
أبرز التحديات عند استخراج البيانات من أي موقع
طبعًا، الأمور مو دائمًا وردية ومليانة CSV. الويب مكان فوضوي، واستخراج البيانات من المواقع يجي معه تحديات حقيقية:
- البيانات غير المنظمة: حوالي 80% من بيانات الإنترنت غير منظمة — مدفونة داخل HTML غير مرتب، أو موزعة على صفحات متعددة، أو مخفية خلف عناصر تفاعلية. وتحويل هذا كله إلى جدول نظيف مو سهل أبدًا (scrapingapi.ai).
- تغير المواقع باستمرار: المواقع تحدث واجهاتها طول الوقت. شفت أدوات استخراج تتعطل 15 مرة في شهر واحد فقط لأن موقعًا مستهدفًا غيّر تصميمه (scrap.io).
- الحجم والنطاق: الشركات تحتاج استخراج البيانات من مئات أو آلاف الصفحات — وغالبًا وفق جدول زمني. والنسخ واللصق اليدوي ما يقدر يلحق.
- وسائل الحماية من الاستخراج: CAPTCHA، وحدود الطلبات، وصفحات تسجيل الدخول… المواقع صارت أذكى في منع الروبوتات. أكثر من ثلث حركة الويب الآن تأتي من بوتات (scrap.io)، وتقنيات مكافحة البوتات تتطور بسرعة.
- الأخطاء اليدوية: النسخ واللصق البشري بطيء ومعرّض للخطأ. مجرد محدد CSS غلط ممكن يجيب لك بيانات خاطئة — أو ما يجيب شيء أصلًا.
الطرق التقليدية ما عادت قابلة للتوسع. لهذا السبب كثير من الفرق تتجه إلى حلول أذكى وأتمتة أكثر، ولهذا أنا متفائل جدًا بأدوات الذكاء الاصطناعي.
أفضل الممارسات القانونية والامتثال والأمان لاستخراج بيانات المواقع
خلّنا نكون واضحين: مجرد أنك تقدر تستخرج البيانات من موقع ما يعني أنك لازم تسوي هذا — على الأقل مو بدون تفكير بالجانب القانوني والأخلاقي. هذا اللي لازم تعرفه كل شركة:
- البيانات العامة مقابل الخاصة: استخراج المعلومات المتاحة للعامة قانوني عمومًا في كثير من الأماكن. لكن أي شيء خلف تسجيل دخول؟ هذا خط أحمر. تجاوز المصادقة ممنوع (xbyte.io).
- شروط الاستخدام: لازم تراجع دائمًا شروط استخدام الموقع. إذا كان الاستخراج محظورًا، قد تواجه دعاوى قضائية أو حظرًا. وإذا كنت محتارًا، اطلب إذنًا أو استخدم واجهات API الرسمية.
- قوانين الخصوصية (GDPR، CCPA): إذا كنت تجمع بيانات شخصية، فأنت بحاجة إلى أساس قانوني (مثل المصلحة المشروعة)، مع تقليل ما تجمعه إلى الحد الأدنى، والاستعداد لحذف البيانات عند الطلب. عدم الالتزام قد يعني غرامات ضخمة (xbyte.io).
- احترام robots.txt: مو ملزم قانونيًا، لكنه تصرف مهني جيد. التزم بقواعد مهلة الزحف ولا ترهق الخوادم.
- أمان البيانات: تعامل مع البيانات المستخرجة على أنها حساسة. خزّنها بشكل آمن، وقيّد الوصول إليها، ونظفها قبل الاستخدام.
قائمة التحقق للامتثال:
| الاعتبار | أفضل ممارسة |
|---|---|
| الوصول القانوني | استخرج البيانات العامة فقط؛ لا تتجاوز تسجيل الدخول أبدًا (xbyte.io). |
| شروط الاستخدام | راجع شروط الموقع واحترمها؛ واستخدم واجهات API إذا كان الاستخراج محظورًا. |
| البيانات الشخصية | تجنبها إن أمكن؛ وإن لزم الأمر فقلّلها والتزم بـ GDPR/CCPA. |
| robots.txt وتأخير الزحف | التزم بقواعد الموقع؛ وخفّض معدل الطلبات. |
| أمان البيانات | شفّر البيانات، وقيّد الوصول إليها، واحذفها عند عدم الحاجة. |
رفع الكفاءة: كيف يعزز الذكاء الاصطناعي استخراج بيانات المواقع
وهنا يبدأ الجزء المثير. الذكاء الاصطناعي غيّر قواعد اللعبة تمامًا في استخراج البيانات من المواقع. بدل ما تتعامل مع المحددات أو تكتب سكربتات هشة، صار بإمكانك الآن استخدام أدوات مدعومة بالذكاء الاصطناعي “تقرأ” الصفحة وتفهم وش لازم تستخرج — وغالبًا بنقرات قليلة فقط.
وش يعني هذا عمليًا؟
- إعداد بسيط جدًا: أدوات الاستخراج المعتمدة على الذكاء الاصطناعي مثل Thunderbit تقدر تكتشف الحقول تلقائيًا. فقط اضغط «استخراج بنقرة واحدة» وستقترح الأداة الأعمدة المناسبة — بلا برمجة ولا تجارب متكررة.
- القدرة على التكيّف: أدوات الاستخراج الذكية تتعرف على الأنماط، مو على التخطيطات الثابتة فقط. إذا تغيّر الموقع، غالبًا الذكاء الاصطناعي يتكيف تلقائيًا. وهذا يعني صيانة أقل ومواقف طوارئ أقل في منتصف الليل.
- الدقة: الذكاء الاصطناعي يقدر يفلتر الضوضاء، ويشيل التكرارات، وحتى ينظف البيانات الفوضوية أثناء الاستخراج. وبعض الفرق تذكر معدلات دقة توصل إلى 99.5% مع أدوات الاستخراج المبنية على الذكاء الاصطناعي (scrapingapi.ai).
- المحتوى الديناميكي: أدوات الاستخراج الذكية تقدر تتعامل مع المواقع الثقيلة بـ JavaScript، والتمرير اللانهائي، وحتى استخراج النصوص من الصور أو ملفات PDF.
- المعالجة الفورية: تحتاج ترجمة البيانات أو تصنيفها أو تلخيصها أثناء الاستخراج؟ الذكاء الاصطناعي يقدر يسوي هذا في نفس المرور.
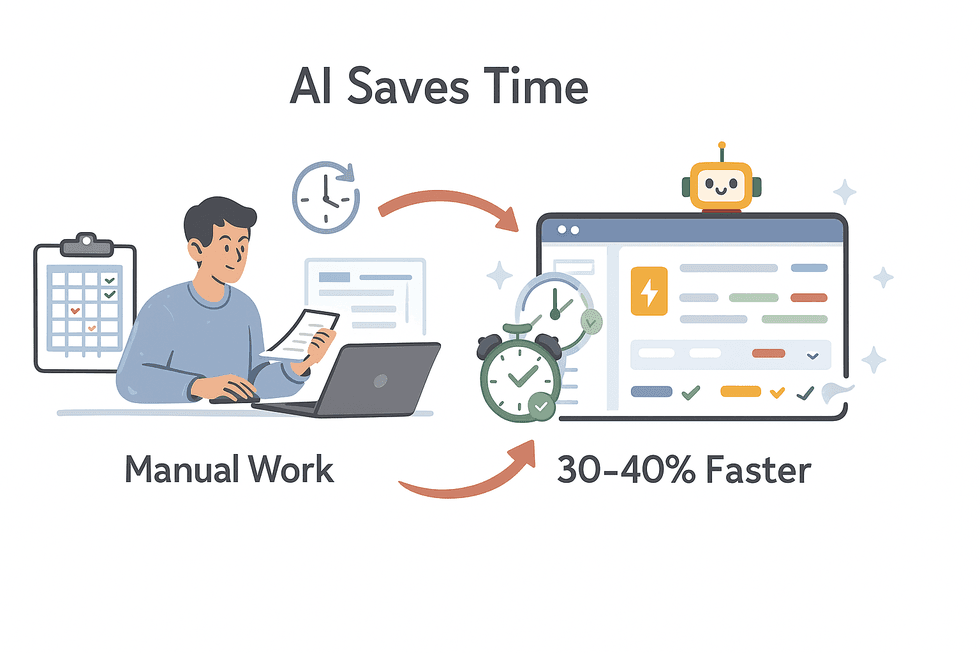 شفت فرق توفر 30–40% من وقتها في استخراج البيانات بمجرد الانتقال إلى أدوات مدعومة بالذكاء الاصطناعي (scrapingapi.ai). وهذا مو مجرد تحسن في الإنتاجية — هذا أفضلية تنافسية.
استخرج البيانات من أي موقع باستخدام الذكاء الاصطناعي قارئ Thunderbit الذكي للمواقع يفهم أي صفحة بنفسه ويحدد الحقول المطلوب استخراجها، خطوة بخطوة وبنقرة واحدة. Get Started Free
Thunderbit مصمم عشان يخلي الاستخراج سهلًا ودقيقًا ومتاحًا للجميع — حتى اللي ما كتب سطر برمجة واحد. (ونعم، أمي تقدر تستخدمه. ما زالت تتعلم Netflix، لكن هذا موضوع ثاني.)
Thunderbit Agentic Web Scraper: الميزات الأساسية لمستخدمي الأعمال
خلّني أتكلم شوي عن اللي بنيناه في Thunderbit (أكيد لي الحق، صح؟). Thunderbit مصمم لمستخدمي الأعمال — فرق المبيعات والعمليات والتسويق والعقارات — اللي يهمهم النتيجة أكثر من الصداع. هذا اللي يميّزه:
- استخراج بنقرة واحدة: اضغط مرة واحدة، وذكاء Thunderbit يمسح الصفحة ويقترح الأعمدة ويجهز الأداة لك. ما عاد فيه لعب بالمحددات.
- استخراج بنقرتين: بعد ضبط الحقول، اضغط «Scrape» وراح تحصل على جدول نظيف — بلا برمجة وبلا إعدادات معقدة.
- استخراج الصفحات الفرعية: تحتاج تفاصيل أكثر؟ Thunderbit يزور كل صفحة فرعية تلقائيًا (مثل صفحات المنتجات أو الملفات الشخصية) ويغني جدولك بمعلومات إضافية.
- قوالب جاهزة: للمواقع الشائعة مثل Amazon وZillow وInstagram وShopify وغيرها، اختر قالب وابدأ مباشرة — بدون أي إعداد.
- تصدير إلى أي مكان: تصدير مجاني إلى Excel أو Google Sheets أو Airtable أو Notion أو CSV. بلا رسوم مخفية.
- الاستخراج المجدول: أتمتة عمليات الاستخراج المتكررة — فقط حدّد الفاصل الزمني («كل يوم إثنين الساعة 8 صباحًا») وThunderbit يتولى الباقي.
- استخراج سحابي أو عبر المتصفح: استخدم خوادم Thunderbit السحابية للسرعة، أو متصفحك الخاص للمواقع التي تتطلب تسجيل دخول.
- دعم متعدد اللغات: استخرج البيانات بـ 34 لغة، بما فيها الإنجليزية والإسبانية والصينية وغيرها.
جرّب Thunderbit Agentic Web Scraper مجانًا الخطة المجانية تغطي 6 صفحات شهريًا، وما تحتاج بطاقة ائتمان — طريقة ممتازة لتختبر الاستخراج على موقعك المستهدف. Get Started Free
الأتمتة والتوسع: استخدام الجدولة وأدوات التكامل لاستخراج البيانات
الاستخراج اليدوي صار من الماضي. القيمة الحقيقية تظهر لما تؤتمت عملية استخراج البيانات وتدخلها في سير عملك:
- الاستخراج المجدول: اضبط Thunderbit ليشتغل يوميًا أو أسبوعيًا أو بأي وتيرة تناسبك. مثالي لمراقبة الأسعار أو توليد العملاء المحتملين أو تجميع الأخبار.
- التكامل المباشر: صدّر البيانات المستخرجة مباشرة إلى Google Sheets أو Excel أو Airtable أو Notion. ما عاد فيه تنزيل ملفات ثم إعادة رفعها.
- تكامل مع CRM والتحليلات: مرّر البيانات إلى CRM أو أدوات BI عشان تحصل على لوحات تحكم فورية وتنبيهات أو تواصل آلي.
مثال: سير عمل آلي لمراقبة الأسعار
- أعد Thunderbit على صفحة منتج لأحد المنافسين.
- استخدم «استخراج بنقرة واحدة» لالتقاط اسم المنتج والسعر والرابط.
- جدولة الاستخراج كل صباح الساعة 7.
- صدّر النتائج إلى Google Sheets المرتبط بلوحة تحكم.
- يراجع مدير التسعير التغيرات ويعدّل الاستراتيجية قبل ما يصحى المنافس.
مع الأتمتة، أنت مو بس تصير أسرع — أنت تبقى محدَّثًا دائمًا.
أفضل الممارسات للتعامل مع البيانات غير المنظمة عند استخراجها من المواقع
خلنا نكون واقعيين: أغلب بيانات الويب مو مرتبة ونظيفة. هي غير منظمة، وغير متسقة، وأحيانًا غريبة جدًا. هذا اللي يساعدك تخليها أكثر انتظامًا:
- خل الذكاء الاصطناعي يحدد البنية: استخدم «استخراج بنقرة واحدة» أو قالب لفرض النظام — الذكاء الاصطناعي يحدد الأعمدة وأنواع البيانات، وبعدها تقدر تعدل إذا احتجت.
- مطالبات الذكاء الاصطناعي على مستوى الحقل: Thunderbit يتيح لك إضافة تعليمات مخصصة لكل حقل. تبي تصنيف المنتجات، أو تنسيق أرقام الهاتف، أو ترجمة الأوصاف؟ فقط قل للذكاء الاصطناعي وش تبي.
- استفد من NLP: للمراجعات أو التعليقات أو المقالات، استخدم ميزات معالجة اللغة الطبيعية المدمجة لتلخيصها أو تحليل المشاعر أو استخراج الكلمات المفتاحية.
- توحيد البيانات: نظف التنسيقات — مثل التواريخ والأسعار وأرقام الهاتف — أثناء الاستخراج، مو بعده. الاتساق مهم جدًا.
- إزالة التكرارات والتحقق: احذف البيانات المكررة وافحص النتائج بشكل عشوائي للتأكد من الدقة. إذا لاحظت شيء غير صحيح، عدّل المطالبات أو الإعدادات.
مطالبات الذكاء الاصطناعي على مستوى الحقل: تخصيص استخراج البيانات للحصول على نتائج أفضل
هذي من أكثر الأشياء اللي أحبها. باستخدام مطالبات الذكاء الاصطناعي لكل حقل، تقدر:
- التصنيف والوسم: «صنّف هذا المنتج ضمن الإلكترونيات أو الأثاث أو الملابس بناءً على وصفه.»
- فرض التنسيقات: «أخرج التاريخ بصيغة YYYY-MM-DD.» «استخرج السعر الرقمي فقط.»
- الترجمة أثناء الاستخراج: «ترجم وصف المنتج إلى الإنجليزية.»
- تنظيف الضوضاء: «استخرج السيرة الذاتية للمستخدم مع تجاهل روابط “اقرأ المزيد” أو الإعلانات.»
- دمج الحقول: «ادمج سطور العنوان في حقل واحد.»
الأمر كأنه عندك محلل مبتدئ مدمج داخل أداة الاستخراج — محلل ما يشتكي أبدًا من استراحة القهوة.
ضمان جودة البيانات واتساقها في استخراج بيانات المواقع
استخراج البيانات الجيد ما ينتهي عند زر «تصدير». هذه هي الطريقة اللي تحافظ فيها على بياناتك نظيفة وموثوقة:
- فحوصات التحقق: استخدم فحص النطاقات، والحقول المطلوبة، والمفاتيح الفريدة لاكتشاف الأخطاء.
- مراجعة عينات: راجع عينة من البيانات المستخرجة يدويًا مقابل الموقع الأصلي — خصوصًا بعد الإعداد أو إذا تغيّر الموقع.
- معالجة الأخطاء: سجّل حالات الفشل واضبط تنبيهات للشذوذات، مثل الانخفاض المفاجئ في عدد الصفوف.
- تنظيف مستمر: استخدم أدوات الجداول أو السكربتات لإزالة المسافات الزائدة وإصلاح الترميز وتوحيد النصوص.
- ثبات البنية: حافظ على أسماء الحقول وتنسيقاتها ثابتة مع الوقت. ووثّق التغييرات حتى ما يضيع فريقك.
الثقة في بياناتك هي الأساس. شوية عناية بالبداية توفر عليك كثير من المتاعب لاحقًا.
شاهد كيف يقارن Thunderbit اكتشف وين يناسب Thunderbit نهجه القائم على الاستخراج بنقرة واحدة والذكاء الاصطناعي بين أدوات استخراج الويب الأخرى في السوق. Get Started Free
مقارنة أدوات الاستخراج: ما الذي تبحث عنه عند اختيار الحل المناسب
مو كل أدوات استخراج الويب متساوية. هذا اللي لازم تنتبه له:
| الأداة | نقاط القوة | اعتبارات |
|---|---|---|
| Thunderbit | الأسهل لغير التقنيين؛ اكتشاف الحقول بالذكاء الاصطناعي؛ استخراج الصفحات الفرعية؛ قوالب جاهزة؛ تصدير مجاني؛ خطط بأسعار مناسبة (Thunderbit Blog). | غير مخصص للمشاريع الضخمة جدًا المعتمدة على المطورين؛ يستخدم نظام أرصدة. |
| Browse AI | بدون برمجة، جيد لمراقبة التغييرات؛ تكامل مع Google Sheets؛ استخراج بالجملة. | خطط البداية أعلى سعرًا؛ وقد يستغرق الإعداد وقتًا. |
| Octoparse | قوي ويتعامل مع المواقع الديناميكية؛ ميزات متقدمة للمستخدمين التقنيين. | منحنى تعلّم حاد؛ وأسعاره أعلى. |
| Web Scraper (webscraper.io) | مجاني للمشروعات الصغيرة؛ إعداد بصري؛ مجتمع قوي. | قد يكون الإعداد اليدوي مربكًا؛ ودعم الذكاء الاصطناعي محدود. |
| Diffbot | مدعوم بالذكاء الاصطناعي، يحلل الصفحات غير المنظمة عبر API؛ ممتاز للمطورين. | مكلف، يعتمد على API، وغير مناسب لغير التقنيين. |
نصيحتي: إذا كنت مستخدمًا في الأعمال وتبي نتائج سريعة ودقيقة، فإن Thunderbit خيار ممتاز. أما إذا كنت مستخدمًا متقدمًا أو مطورًا، فقد تستحق Octoparse أو Diffbot التعقيد الإضافي. جرّب دائمًا النسخة المجانية أو الفترة التجريبية قبل الالتزام.
الخلاصة: تحويل أفضل ممارسات استخراج بيانات المواقع إلى واقع
أصبح استخراج البيانات من المواقع اليوم مو ميزة إضافية، بل ضرورة لأي شركة تريد تبقى تنافسية. وهذا أهم اللي أتمنى تطلع فيه:
- القيمة: بيانات الويب تدعم قرارات أذكى وأسرع. لا تتركها على الطاولة.
- تجاوز التحديات: استخدم أدوات مدعومة بالذكاء الاصطناعي للتعامل مع البيانات غير المنظمة والحجم الكبير وتغير المواقع.
- التزم بالقانون: احترم قوانين الخصوصية وقواعد المواقع وأمان البيانات.
- أتمتة العمل: جدولة الاستخراج ودمجه في سير العمل اليومي.
- الجودة أولًا: تحقّق من بياناتك ونظفها وراقبها باستمرار للحفاظ على الثقة.
هل أنت مستعد تشوف قد إيش الموضوع سهل؟ حمّل إضافة Thunderbit لمتصفح Chrome وجرّبها في مشروع بياناتك القادم. وإذا تبي تتعمق أكثر، شوف مدونة Thunderbit لمزيد من الأدلة والنصائح والأمثلة الواقعية.
استخراجًا موفقًا — ولتكن بياناتك دائمًا منظمة ومتوافقة وجاهزة للتنفيذ.
ابدأ استخراج البيانات مع Thunderbit ثبّت إضافة Thunderbit المجانية لمتصفح Chrome وابدأ استخراج البيانات المنظمة من أي صفحة بنقرة واحدة. Get Started Free
الأسئلة الشائعة
1. هل من القانوني استخراج البيانات من أي موقع؟
عمومًا، استخراج البيانات المتاحة للعامة قانوني في كثير من الولايات القضائية، لكن لازم تتجنب تجاوز تسجيل الدخول أو آليات الأمان. راجع دائمًا شروط استخدام الموقع والتزم بقوانين الخصوصية مثل GDPR وCCPA (xbyte.io).
2. كيف يحسن الذكاء الاصطناعي عملية استخراج البيانات من المواقع؟
يمكن لأدوات مدعومة بالذكاء الاصطناعي مثل Thunderbit اكتشاف الحقول تلقائيًا، والتكيف مع تغيّر التخطيطات، وتنظيف البيانات وتنسيقها، وحتى التعامل مع المحتوى الديناميكي أو الترجمة — وكل هذا مع إعداد بسيط جدًا ودقة عالية (scrapingapi.ai).
3. ما أفضل الممارسات للتعامل مع البيانات غير المنظمة؟
حدد بنية البيانات مسبقًا، واستخدم مطالبات الذكاء الاصطناعي على مستوى الحقل لتوجيه الاستخراج، ووحّد التنسيقات أثناء العمل، وتحقق من النتائج. أدوات مثل Thunderbit تجعل تصنيف البيانات وتنسيقها ووسمها أثناء التشغيل أمرًا سهلًا.
4. كيف أقدر أؤتمت وأوسع استخراج البيانات من المواقع؟
استخدم ميزات الجدولة لتشغيل عمليات الاستخراج على فترات منتظمة، وادمج المخرجات مباشرة في أدوات مثل Google Sheets أو Airtable أو CRM الخاص بك. الأتمتة تضمن بقاء بياناتك حديثة وتقلل الجهد اليدوي.
5. كيف أضمن جودة البيانات المستخرجة واتساقها؟
طبّق فحوصات التحقق، وراجع العينات بانتظام، وتعامل مع الأخطاء بسلاسة، وحافظ على ثبات البنية مع الوقت. التحسين المستمر والمراقبة هما المفتاح للحفاظ على بيانات موثوقة.
هل تريد تشوف هذه الممارسات في الواقع؟ جرّب الخطة المجانية من Thunderbit واكتشف مدى سهولة وأمان وقابلية التوسع في استخراج بيانات الويب.
جرّب Web Scraper الذكي Get Started Free
اعرف المزيد




