
Shopify 目前已为全球超过 460 万家在线商店提供支持。对于电商从业者来说,你大概率也曾花上一个下午,甚至整个周末,琢磨竞争对手在卖什么、卖多少钱,以及库存周转有多快。我自己就经历过——而且我也吃过亏:并不是所有爬虫工具都一样好用,尤其当 Shopify 的反爬机制和大量 JS 渲染主题介入时,差异会特别明显。
在 Thunderbit 过去几个月的测试、拆解和对比中,我们实测了 9 款最热门的 Shopify 爬虫工具。现在,我想帮你省下这些折腾。本文会从免费浏览器扩展到企业级平台逐一介绍,并坦诚说明每款工具真正能做什么、又有哪些短板。无论你是独立代发货卖家、电商运营负责人,还是正在搭建数据管道的开发者,这里都能找到适合你的方案。
为什么要抓取 Shopify 店铺?谁真的需要?
抓取 Shopify 早就不只是开发者的兴趣爱好,而是成千上万电商团队每天都在用的工作流。以下这些人群最能从中受益:
| 应用场景 | 受益人群 | 你能获得什么 |
|---|---|---|
| 竞品商品调研 | 销售团队、品牌经理 | 商品目录、价格、新品上架 |
| 价格与库存监控 | 电商运营、定价分析师 | 每日/每周价格变化、库存水平 |
| 代发货选品 | 代发货卖家、创业者 | 热门产品、爆款、供应商数据 |
| 商品目录搭建与迁移 | 代理公司、平台招商卖家 | 可直接导入的结构化商品数据 |
| 市场分析与趋势洞察 | 研究员、分析师 | 品类价格、商品组合变化 |
如果你需要根据 Shopify 店铺里的变化做决策——不管是自己的店还是竞品店——就必须有一种稳定可靠的方式把这些数据提取出来。如今,全球近一半互联网流量都来自机器人,你选择的工具比以往任何时候都更重要。
一款优秀的 Shopify 爬虫,强在哪里?
我用 9 个维度评估了每款工具。市面上大多数对比文章只看 3 到 5 个指标,所以我这次把范围拉得更完整。下面是我的评估标准,以及每项指标为什么重要:
- 工具类型: Chrome 扩展、桌面应用、API 还是代码库——这决定了谁能真正上手。
- Shopify 专属能力: 这款工具是否能原生识别 Shopify 的数据结构,比如
products.json、集合页和变体? - 可提取的数据字段: 能否抓取标题、价格、变体、SKU、描述、图片、供应商、标签和库存?
- 导出格式: CSV、JSON、Excel、Google Sheets、Airtable、Notion——数据最终能去哪里?
- 免费额度 / 定价: 0 元能做什么?这点非常关键——很多论坛帖子都能看到用户拒绝为基础抓取功能付费。
- 定时 / 自动化: 能否设置周期性抓取,用于持续监控?
- 反爬处理: 这款工具如何应对 Shopify 的限流和拦截?
- 上手难度: 从安装到第一次成功抓取要多久?无需代码还是必须写代码?
- 子页面 / 详情页抓取: 工具能否自动访问单个商品页,补充变体、描述和全部图片,让列表数据更完整?
如果一款工具不能抓子页面,那你就会错过 Shopify 店铺里一半有价值的数据。这也是大多数“最佳工具”榜单经常忽略的空缺。
products.json 这个捷径,以及它失效时怎么办
如果你混过一阵 Shopify 抓取论坛,大概率见过有人提到在店铺 URL 后面拼上 /products.json。这确实是个小技巧:很多 Shopify 店铺都会开放一个产品数据的 JSON 接口,你可以分页抓取商品标题、价格、图片等信息,甚至都不需要用爬虫。
但现实是:有些 Shopify 店铺会屏蔽或关闭 products.json。这种情况通常出现在店主调整隐私设置、使用 headless/Hydrogen 前端,或者部署了自定义配置时。多个 Reddit 讨论和 Shopify 社区帖子都证实,这对依赖该接口的用户来说,确实是个常见障碍。
下面给你一个快速判断思路:
/products.json可用? 那就先用它做快速批量导出,再用像 Thunderbit 这样的爬虫补充更多字段(变体、完整描述、全部图片)。/products.json被屏蔽? 直接用浏览器式 AI 爬虫(Thunderbit、Octoparse),读取页面渲染后的内容,不依赖 API。- 需要持续监控? 不管接口是否可用,都建议用定时爬虫。例如 Thunderbit 的定时爬虫,可以按你自己设定的自然语言规则自动运行。
这类问题往往没有竞品文章会老实讲清楚。JSON 接口在能用时很好用,但你必须准备一个失效时的备选方案。
9 款最佳 Shopify 爬虫一览
下面是总览对比表。我尽量把它做成你能找到的最完整 Shopify 爬虫对比之一——大多数文章最多只写 3 到 5 个维度。
| 工具 | 类型 | Shopify 专属能力 | 核心数据字段 | 导出格式 | 免费额度 | 定时任务 | 反爬 / JS | 上手难度 | 子页面抓取 |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome 扩展 + API | ✅ 模板 | 标题、价格、变体、SKU、描述、图片、供应商、标签 | Excel、Sheets、Airtable、Notion、CSV、JSON | 每月 6 页免费 | ✅ 自然语言 | 云端 + 浏览器抓取 | 非常简单(2 次点击) | ✅ |
| Octoparse | 桌面端 + 云端 | ✅ 教程支持 | 标题、价格、描述、图片、尺寸、评论 | Excel、CSV、JSON、XML、数据库、Sheets、S3 | 免费方案(受限) | ✅ 云端 | IP 轮换、验证码、代理 | 中等(可视化编辑器) | ✅ |
| Instant Data Scraper | Chrome 扩展 | ❌ 通用型 | 标题、价格、链接、可见文本 | CSV、Excel | 完全免费 | ❌ | 仅本地浏览器 | 非常简单 | ❌ |
| ScrapingBee | API | ❌ 通用型 | 任意字段(自定义选择器) | JSON、HTML、Markdown、文本 | 1,000 免费额度 | ❌(需外部触发) | 无头浏览器、代理 | 较难(需写代码) | ❌(需自定义代码) |
| Bright Data | 企业级平台 | ✅ Shopify 爬虫 + MCP | 完整目录、价格、图片、评论、库存 | JSON、CSV、NDJSON、S3、Snowflake | 每月 5,000 免费额度 | ✅ Cron / 平台任务 | Web Unlocker、代理、验证码 | 较难(企业级配置) | ✅ |
| Koala Inspector | Chrome 扩展 | ✅ Shopify 情报分析 | 主题、应用、爆款、价格、广告 | 浏览器内查看(导出有限) | 免费层 | ❌ | 不适用(偏情报分析,不是爬虫) | 非常简单 | ❌ |
| Parsehub | 桌面应用 | ❌ 通用型 | 标题、价格、图片、描述(可配置) | JSON、Excel、Sheets、API | 5 个免费项目 | ✅ 付费方案支持 | IP 轮换 | 中等(可视化) | ✅(工作流) |
| Data Miner | Chrome 扩展 | ❌ 通用型 | 标题、价格、链接、可见文本 | CSV、Google Sheets | 免费(页数有限) | ❌ | 仅本地浏览器 | 简单 | ❌ |
| Apify | 云端平台 | ✅ Shopify Actor | 标题、价格、变体、SKU、描述、图片、供应商、标签、库存 | JSON、CSV、Excel、API、数据库 | 免费层 | ✅ 仪表板 | 云端、代理 | 中等(Actor 配置) | ✅ |
一句话总结:
- Thunderbit: 非技术用户从 Shopify 页面到表格最快的路径。
- Octoparse: 想要可视化控制、又不想写代码的用户,最适合它。
- Instant Data Scraper: 零成本、零配置,适合快速抓一把数据。
- ScrapingBee: 开发者做自定义 Shopify 抓取逻辑的最佳 API。
- Bright Data: 面向大规模目录的企业级基础设施最佳选择。
- Koala Inspector: 最适合做 Shopify 店铺情报分析(应用、主题、广告)。
- Parsehub: 带 IP 轮换功能的最佳免费桌面爬虫。
- Data Miner: 适合在浏览器里抓结构化表格数据。
- Apify: 拥有专门 Shopify 抓取 Actor 的最佳云平台。
1. Thunderbit —— 2 次点击就能用的 AI Shopify 爬虫
 Thunderbit 是我们团队自己做的工具,所以我先把这一点讲明白。但我也会尽量客观说明它能做什么、不能做什么——因为我觉得产品本身已经很有说服力。
使用 AI 抓取 Shopify 店铺数据 Get Started Free
Thunderbit 是一款 Chrome 扩展,可以用 AI 自动识别任意 Shopify 列表页的数据字段。你不需要写选择器、不需要配置工作流,也不用碰一行代码。整个流程只要两步:打开 Shopify 集合页,点击“AI Suggest Fields”,检查列名,然后点“Scrape”。AI 会直接读取页面上可见的内容——所以即使店铺关闭了 products.json,Thunderbit 依然可以正常工作。
Shopify 专属优势:
- 提供专门的 Shopify 模板,可抓价格、商品详情和目录数据
- 在
products.json被屏蔽时,仍可抓取渲染后的页面 - 支持子页面抓取,可补全变体、描述和图片
- 可导出到 Excel、Google Sheets、Airtable、Notion、CSV 和 JSON
2. Octoparse —— 最强可视化工作流构建器
 Octoparse 是一款桌面端和云端抓取平台,提供可视化的点选式工作流构建器。对于 Shopify 场景来说,如果你希望对选择器和分页逻辑有更多控制,但又不想写代码,它的表现会很好。
它可以处理商品列表、详情页和定时任务,不过配置过程比 Thunderbit 更重。如果你喜欢手动设置抓取步骤,它会是个不错的选择。
3. Instant Data Scraper —— 最适合免费快速抓取
 Instant Data Scraper 是一款简单的 Chrome 扩展,专门用来提取网页中可见的表格和列表。它完全免费,几乎不需要任何配置。
缺点也很明显:它是通用型工具,不懂 Shopify,也不支持子页面抓取;如果页面结构复杂,或者数据藏在 JS 交互后面,它的帮助就比较有限了。
4. ScrapingBee —— 最适合开发者的 API
 ScrapingBee 是面向开发者设计的网页抓取 API。它可以处理浏览器渲染、代理和反爬绕过,你可以用自定义代码来提取 Shopify 数据。
如果你希望完全掌控抓取流程,并且愿意自己写逻辑,它是个不错的选择。但它不是无代码工具,对非技术用户来说,也不是最快上手的方案。
5. Bright Data —— 最适合企业级规模化基础设施
 Bright Data 是一套企业级抓取平台,具备强大的代理基础设施、验证码处理能力,以及专门的 Shopify 爬虫。它面向需要高可靠性和合规能力的大规模业务场景。
如果你的团队要抓取超大商品目录,或者需要把数据管道接入 Snowflake 之类的系统,Bright Data 值得关注。代价是复杂度和成本都更高。
6. Koala Inspector —— 最适合店铺情报分析
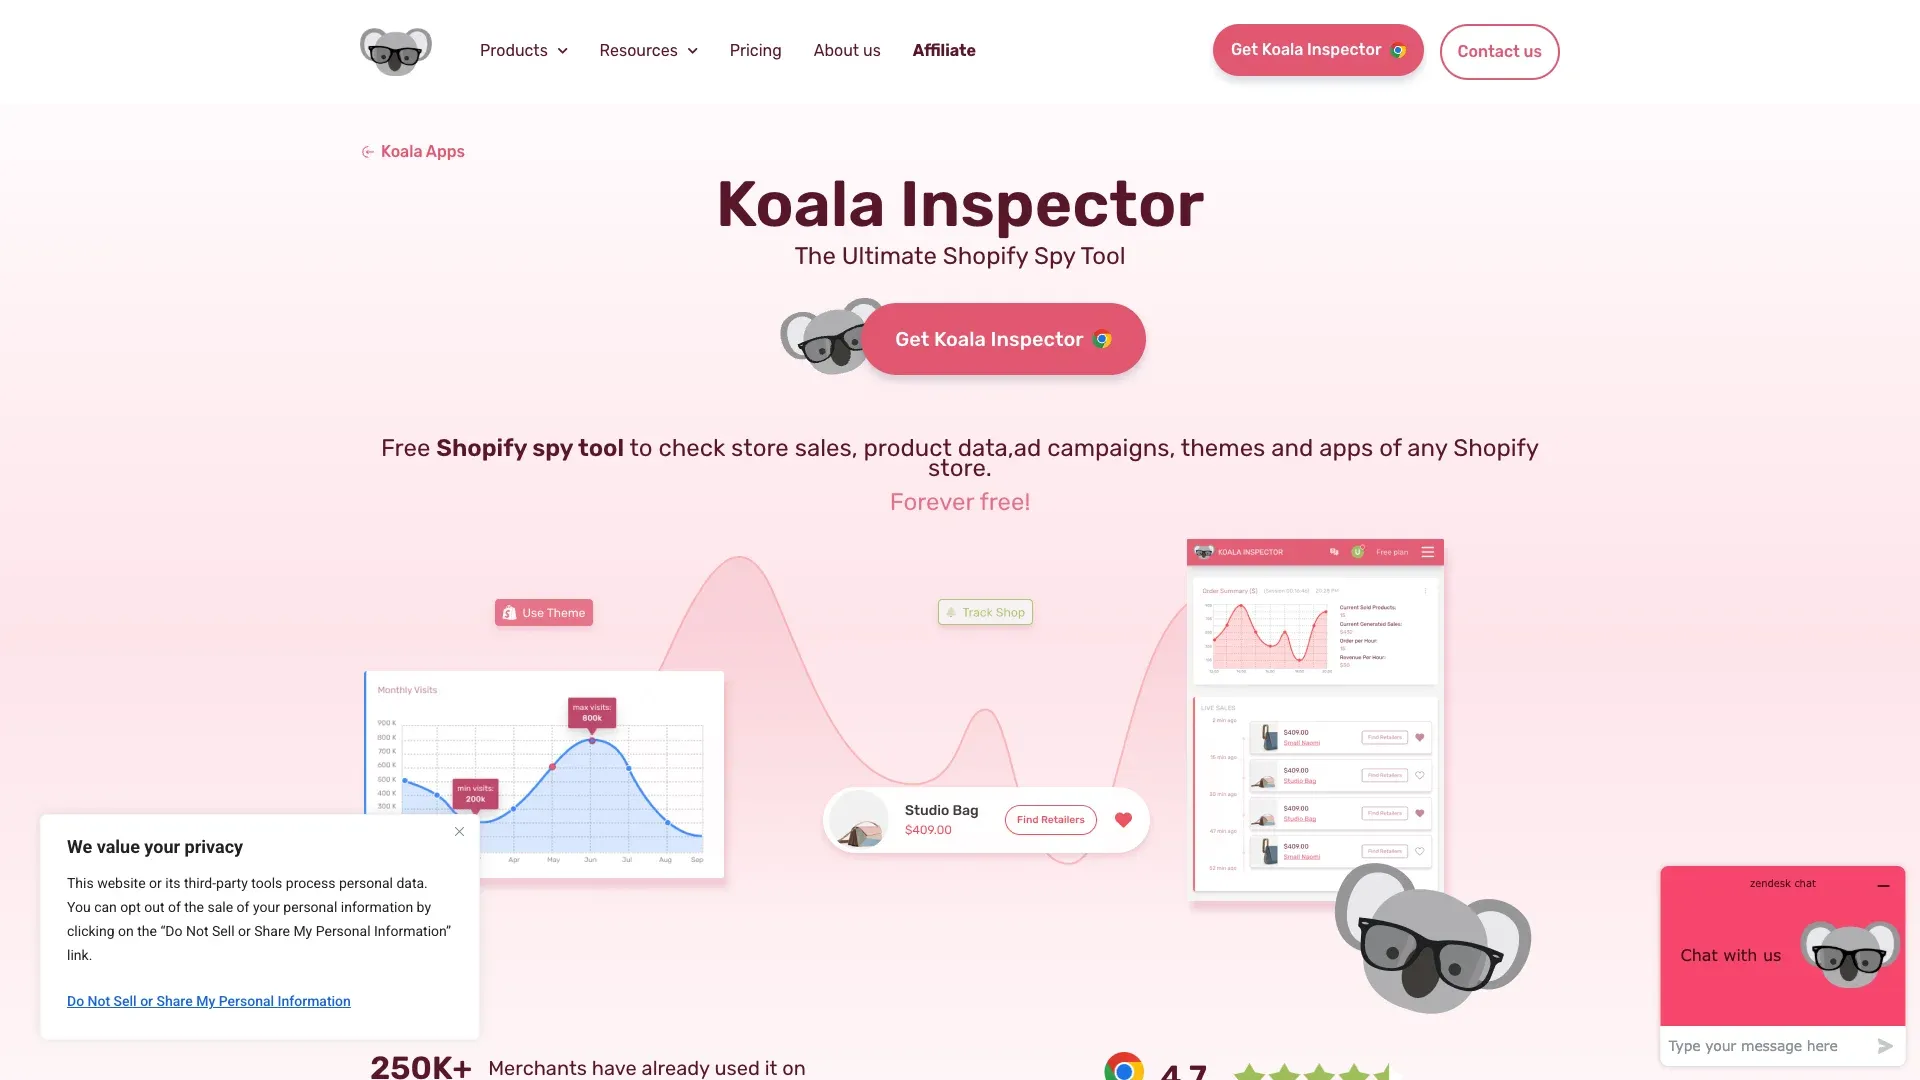 Koala Inspector 与其说是爬虫,不如说更像 Shopify 情报分析工具。它适合用来识别主题、应用、爆款、广告和店铺级别的情报。
如果你的目标是竞品调研,而不是导出干净的结构化商品数据,它会很有帮助。但如果你要做规模化、结构化抓取,它并不是最合适的工具。
7. Parsehub —— 带 IP 轮换的最佳免费桌面爬虫
 Parsehub 是一款可视化桌面爬虫,能够处理复杂网站和部分动态交互。付费方案支持 IP 轮换,并提供子页面和分页工作流。
它比普通浏览器扩展更灵活,但设置时间更长,学习曲线也更陡。
8. Data Miner —— 最适合浏览器里的表格提取
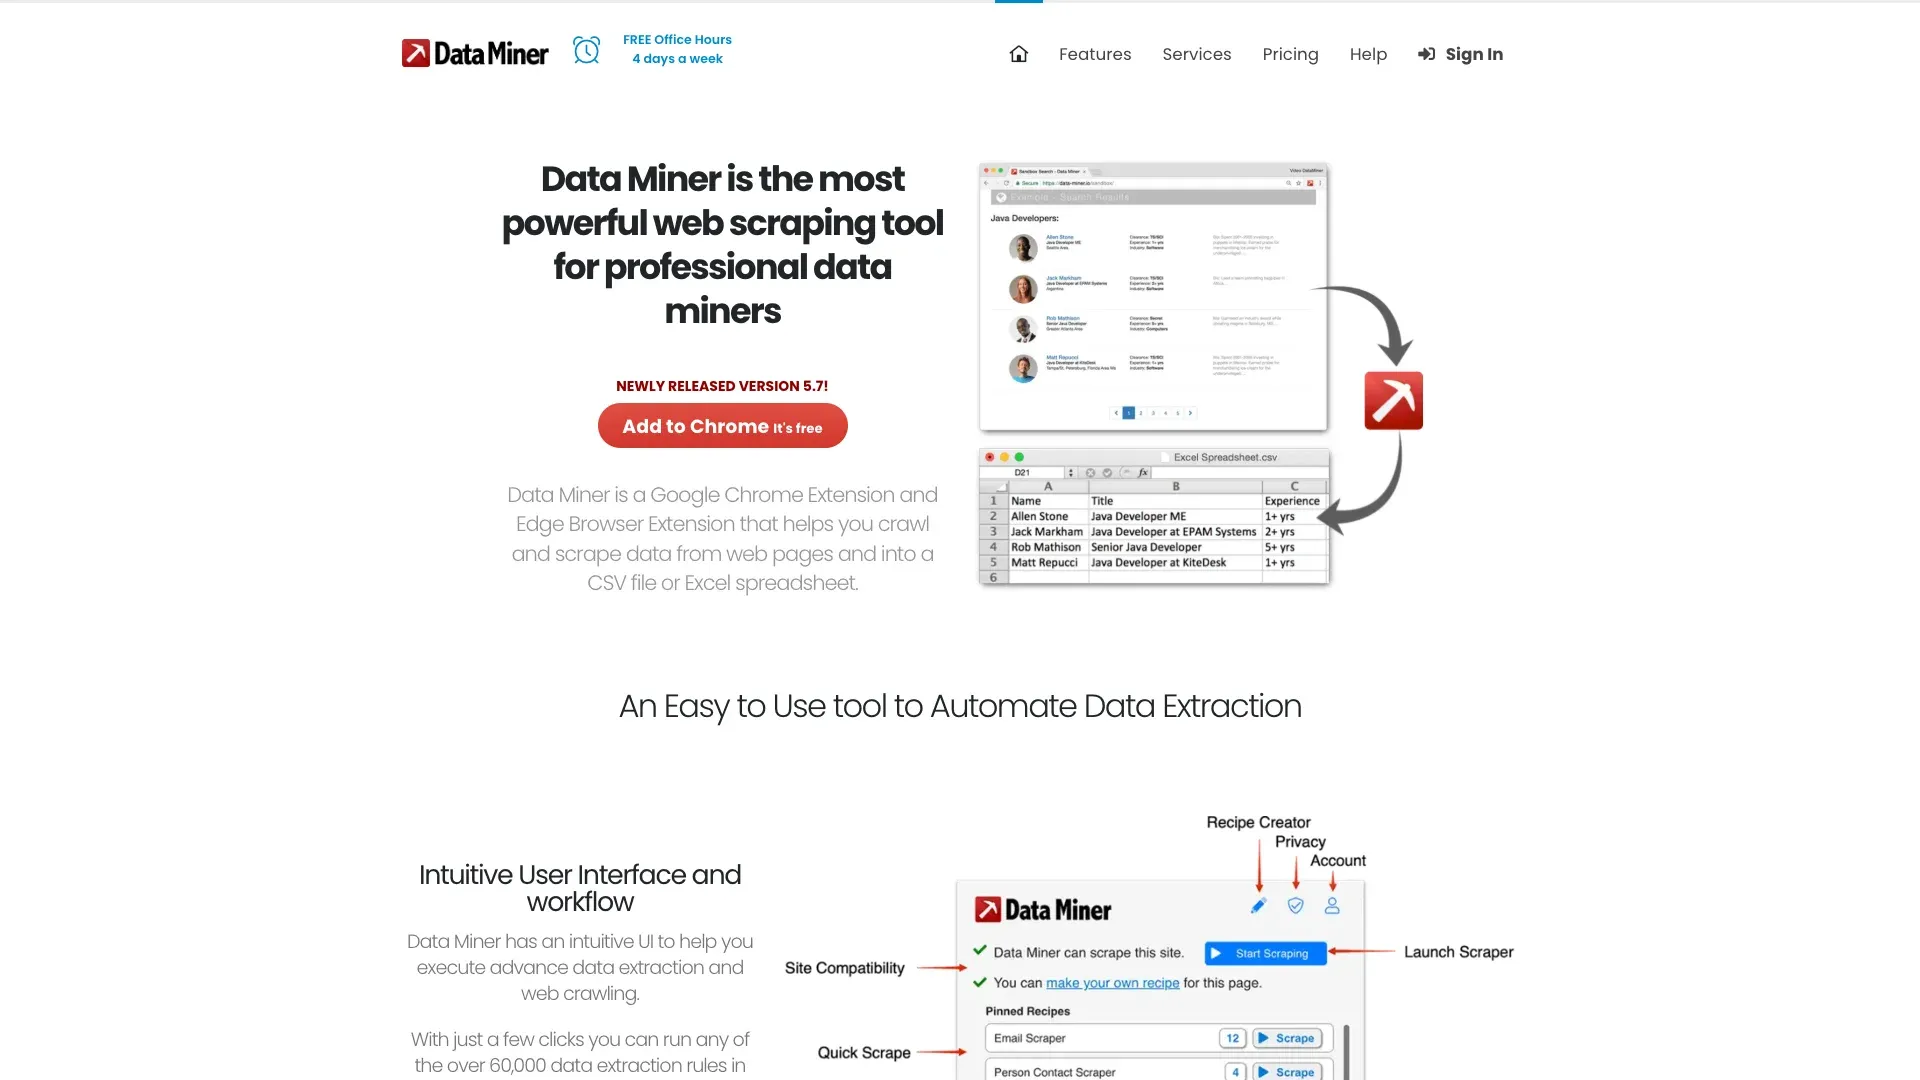 Data Miner 是一款 Chrome 扩展,专注于把可见数据抓取到表格中。对于内容已经以表格或整齐列表形式呈现的简单 Shopify 页面,它非常方便。
和 Instant Data Scraper 一样,它并不专门识别 Shopify,因此更适合结构简单的页面,而不是复杂店铺前台。
9. Apify —— 带 Shopify Actor 的最佳云端平台
 Apify 提供云端抓取平台,并内置专门的 Shopify actor。它支持结构化输出、定时任务,以及与下游工具的集成。
如果你的团队希望使用托管式抓取,并且可以接受基于 actor 的配置方式,Apify 是个稳妥的选择。它比浏览器扩展更技术化,但又不像自己搭整套基础设施那样重。
最终结论:你该选哪款 Shopify 爬虫?
如果你想要最快、最简单、同时又足够灵活的 Shopify 抓取方式,Thunderbit 对大多数非技术用户来说都是最佳选择。它能处理渲染后的页面,支持子页面补全,而且设置极其简单。
如果你更喜欢手动配置的可视化构建器,Octoparse 是个不错的替代方案。如果你需要开发者级别的控制,可以看看 ScrapingBee 或 Apify。如果你的场景是企业级大规模工作流,Bright Data 更突出。而如果你只是想快速免费抓一份数据,Instant Data Scraper 也够用。
如果你是在对比 Shopify 监控、商品调研或目录提取工具,建议先从那个最容易上手、但又能覆盖子页面和定时任务的方案开始——因为真正的价值,往往就藏在这里。
立即试用 Thunderbit 抓取 Shopify 数据 Get Started Free
了解更多



