
Yellow Pages có một sức hút rất riêng, gần như vượt thời gian. Nhiều thập kỷ sau khi cuốn danh bạ điện thoại cuối cùng được đặt trước cửa nhà bố mẹ tôi, phiên bản số của nó vẫn là “mỏ vàng” cho các đội sales và marketing. Nhưng điểm đáng chú ý là: dù dữ liệu phong phú hơn bao giờ hết, việc thu thập và khai thác nó lại phức tạp hơn rất nhiều. Tôi đã thấy quá nhiều đội nhóm lãng phí hàng giờ chỉ để copy-paste thông tin doanh nghiệp, rồi cuối cùng vẫn có những bảng tính lộn xộn và bỏ lỡ cơ hội. Đó là lý do tôi luôn tin vào việc dùng các công cụ thông minh—như Thunderbit—để biến dữ liệu Yellow Pages thành lợi thế cạnh tranh thực sự.
Hãy thử Thunderbit Yellow Pages Scraper Gói miễn phí bao gồm 6 trang mỗi tháng, không cần thẻ tín dụng — đủ để bạn thử trích xuất Yellow Pages trước khi mở rộng quy mô. Get Started Free
Trong hướng dẫn này, tôi sẽ phân tích vì sao scraping Yellow Pages vẫn là một công cụ không thể thiếu cho lead generation hiện đại, cách xác định rõ nhu cầu dữ liệu của bạn, và các best practice (kèm một vài mẹo thực chiến) để lấy được dữ liệu sạch và hữu ích nhất. Dù bạn là chuyên viên sales dày dạn kinh nghiệm hay chỉ đơn giản là đã chán nhập liệu thủ công, hãy cùng tìm hiểu cách tối đa hóa hiệu suất—và kết quả—với một Yellow Pages Scraper.
Yellow Pages là gì? Khai thác giá trị dữ liệu của nó cho Sales & Marketing
Yellow Pages không chỉ là tàn dư của thời kỳ analog—đây là một trong những danh bạ doanh nghiệp lớn và toàn diện nhất thế giới, nay đã hoàn toàn số hóa và còn liên quan hơn bao giờ hết. Các nền tảng Yellow Pages số như YP.com, Yell và PagesJaunes, cộng lại đang liệt kê hàng triệu doanh nghiệp trên toàn cầu, bao phủ gần như mọi ngành nghề bạn có thể nghĩ đến.
Điều khiến Yellow Pages trở nên giá trị nằm ở độ sâu và độ rộng của thông tin: tên doanh nghiệp, số điện thoại, email, địa chỉ thực tế, website, ngành nghề, giờ hoạt động, thậm chí cả đánh giá của khách hàng. Với đội sales và marketing, đây là một kho dữ liệu quý giá cho:
- Tạo lead: Tìm các doanh nghiệp đang hoạt động, đã được xác minh trong thị trường mục tiêu.
- Nghiên cứu thị trường: Phân tích đối thủ, phát hiện mức độ bão hòa, hoặc tìm ra các ngách còn bỏ ngỏ.
- Nhắm mục tiêu theo địa phương: Khoanh vùng theo thành phố, bang hoặc mã ZIP để triển khai chiến dịch siêu địa phương.
- Tiếp cận B2B: Xây dựng danh sách tùy chỉnh cho cold call, email marketing hoặc gửi thư trực tiếp.
Và khác với các danh sách scrape ngẫu nhiên, dữ liệu Yellow Pages thường cập nhật hơn và tập trung vào các doanh nghiệp thực sự đang hoạt động, sẵn sàng phản hồi yêu cầu (BrowserAct). Điều đó đồng nghĩa với việc giảm lãng phí công sức và tăng tỷ lệ phản hồi.
Xác định rõ nhu cầu dữ liệu trước khi dùng Yellow Pages Scraper
Trước khi mở công cụ Yellow Pages Scraper yêu thích của bạn, hãy dành một phút để làm rõ chính xác thứ mình cần. Tin tôi đi, bước này sẽ giúp bạn tránh bị nhấn chìm trong đống dữ liệu không liên quan về sau.
Xác định tiêu chí mục tiêu
Hãy tự hỏi:
- Bạn đang nhắm tới ngành hoặc nhóm doanh nghiệp nào? (ví dụ: nhà hàng, nha sĩ, sửa chữa ô tô)
- Khu vực địa lý nào quan trọng? (thành phố, bang, mã ZIP, hoặc thậm chí cả quốc gia)
- Quy mô doanh nghiệp nào là phù hợp? (một số thư mục có số nhân viên hoặc số năm hoạt động)
- Có từ khóa hay chuyên môn cụ thể nào bạn quan tâm không? (ví dụ: “vegan bakery”, “solar installer”)
Khi thu hẹp phạm vi, bạn sẽ tránh được sai lầm kinh điển là thu thập hàng nghìn contact mà mình không bao giờ dùng tới. Chất lượng luôn quan trọng hơn số lượng.
Các trường dữ liệu phổ biến nên trích xuất
Phần lớn đội sales và marketing thường cần:
- Tên doanh nghiệp
- Số điện thoại
- Email (nếu có)
- Địa chỉ thực tế (đường, thành phố, bang, mã ZIP)
- URL website
- Danh mục/loại hình doanh nghiệp
- Mô tả hoặc chuyên môn
- Giờ hoạt động
- Xếp hạng hoặc đánh giá
Việc đặt mục tiêu rõ ràng cho các trường cần lấy sẽ giúp bạn cấu hình scraper với độ chính xác tối đa (Octoparse).
Chọn bộ lọc phù hợp cho Yellow Pages Scraper
Các trang Yellow Pages thường có khả năng tìm kiếm và lọc rất mạnh. Hãy tận dụng chúng! Ví dụ:
- Ngành + địa điểm: “Plumbers” tại “San Diego, CA”
- Từ khóa + danh mục: “Vegan” trong “Restaurants”
- Quy mô doanh nghiệp: Lọc theo “small business” hoặc “enterprise” (nếu có)
Bộ lọc càng cụ thể, kết quả càng sát nhu cầu—và bạn càng ít phải dọn dẹp dữ liệu về sau (Apify).
Trích xuất dữ liệu Yellow Pages bằng AI Chỉ với một cú nhấp chuột, bạn có thể lấy lead doanh nghiệp từ Yellow Pages bằng AI web scraper của Thunderbit. Get Started Free
Khi tận dụng các bộ lọc này, bạn đảm bảo dữ liệu vừa đúng nhu cầu vừa dễ quản lý, tạo nền tảng cho quá trình scraping hiệu quả và ra insight có thể hành động.
Xử lý các trang Yellow Pages phức tạp: cách trích xuất hiệu quả
Đây là lúc mọi thứ trở nên khó hơn. Các website Yellow Pages được thiết kế cho người dùng duyệt thủ công, chứ không phải để trích xuất dữ liệu hàng loạt. Bạn sẽ gặp phải:
- Danh sách nhiều trang: Hàng trăm kết quả trải dài qua hàng chục trang.
- Nội dung động: Danh sách tải thêm khi bạn cuộn hoặc bấm “next.”
- Chi tiết lồng sâu: Thông tin quan trọng như email hoặc mô tả có thể nằm trong trang chi tiết của từng doanh nghiệp.
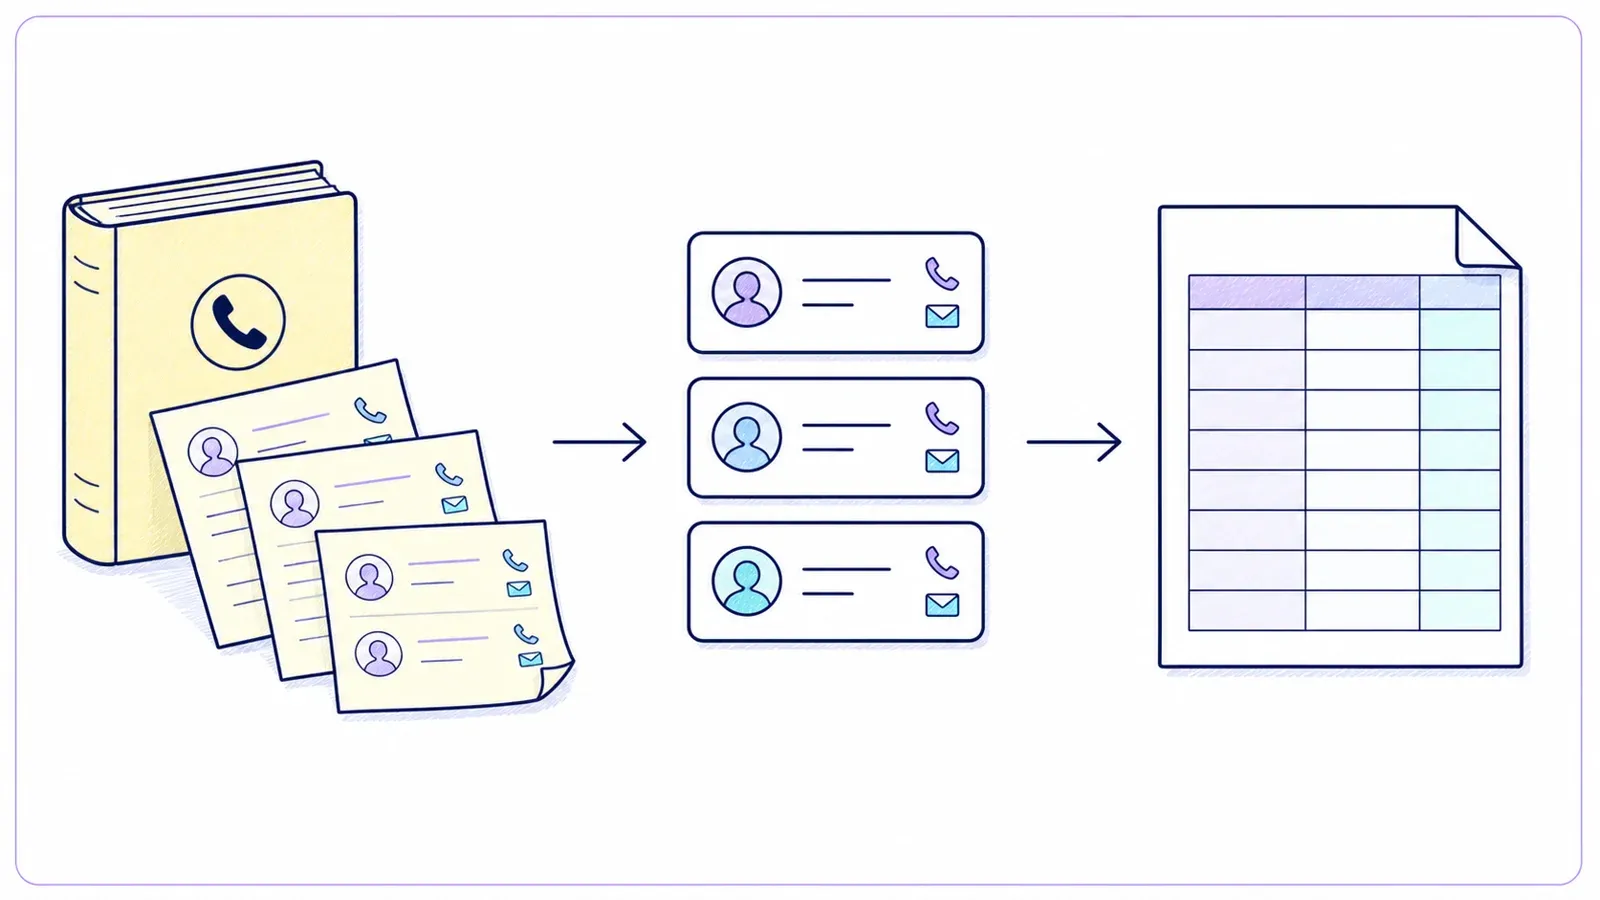 Làm thủ công ư? Quên đi. Có thể mất 3–5 giờ chỉ để thu thập 100 contact bằng tay—và với một đội sales điển hình, mỗi giờ trôi qua tương đương $2,500 chi phí cơ hội bị mất.
Đó là lý do tôi thích các công cụ hiện đại chạy bằng AI như Thunderbit, được xây dựng để xử lý trực diện những thách thức này.
Tận dụng “One Click Extract” để trích xuất dữ liệu thông minh hơn
Với Thunderbit, bạn không cần là nhà khoa học dữ liệu vẫn có thể có kết quả tốt. Chỉ cần mở Chrome extension, vào trang kết quả tìm kiếm Yellow Pages của bạn và nhấp “One Click Extract.” AI của Thunderbit sẽ quét trang và tự động nhận diện những cột phù hợp nhất—như “Business Name,” “Phone,” “Address,” “Website,” và nhiều hơn nữa (Thunderbit Yellow Pages Scraper).
Lợi ích:
- Không cần code hay thiết lập thủ công
- AI tự thích ứng khi bố cục thay đổi (không còn template bị hỏng mỗi khi website cập nhật)
- Người không chuyên kỹ thuật cũng có thể bắt đầu trong vài phút
Bạn có thể tinh chỉnh các trường được gợi ý, thêm cột tùy chỉnh, hoặc thậm chí dùng prompt AI để trích xuất và gắn nhãn dữ liệu đúng theo cách mình muốn.
Dùng “Subpage Scraping” để lấy thông tin doanh nghiệp chuyên sâu
Nhiều listing Yellow Pages chỉ hiển thị thông tin cơ bản ở trang đầu. “Mỏ vàng” thật sự—email, tiểu sử chi tiết, chuyên môn—thường nằm ở trang chi tiết của từng doanh nghiệp. Tính năng “Subpage Scraping” của Thunderbit cho phép bạn tự động truy cập mọi subpage và bổ sung dữ liệu cho bảng chính (Thunderbit Yellow Pages Scraper).
Ví dụ, sau khi scrape danh sách nhà hàng, bạn có thể dùng subpage scraping để lấy thêm:
- Tên chủ sở hữu hoặc quản lý
- Email trực tiếp
- Liên kết mạng xã hội
- Điểm nổi bật của menu hoặc chuyên môn
Đây là một thay đổi lớn khi bạn muốn xây dựng danh sách lead giàu thông tin và có thể hành động hơn—mà không phải tốn hàng giờ click thủ công.
Các bước quan trọng trong xử lý dữ liệu: làm sạch, định dạng và tích hợp
Scraping mới chỉ là bước đầu. Để thật sự sử dụng được dữ liệu (và tránh những lỗi đáng xấu hổ), bạn cần làm sạch, định dạng và sắp xếp lại trước khi đưa vào CRM hay các công cụ outreach.
Làm sạch và khử trùng lặp
- Xóa bản ghi trùng: Ngay cả scraper tốt nhất cũng có thể lấy cùng một doanh nghiệp hai lần nếu nó xuất hiện ở nhiều danh mục.
- Loại bỏ các mục thiếu dữ liệu: Xóa những dòng thiếu thông tin quan trọng như số điện thoại hoặc email, trừ khi bạn định bổ sung sau.
- Kiểm tra email và số điện thoại: Dùng công cụ tích hợp hoặc validator bên ngoài để phát hiện lỗi gõ và lỗi định dạng (Perfect Data Entry).
Tự động định dạng và gắn thẻ dữ liệu với Thunderbit
AI của Thunderbit có thể tự động:
- Chuẩn hóa số điện thoại (ví dụ: định dạng E.164 để tương thích với CRM)
- Tách và định dạng địa chỉ thành các trường riêng (đường, thành phố, bang, mã ZIP)
- Gắn tag và phân loại lead theo từ khóa, vị trí hoặc loại hình doanh nghiệp
- Dịch hoặc tóm tắt mô tả để phân khúc dễ hơn
Điều này giúp bạn dễ dàng chia nhóm danh sách, giao lead cho đúng nhân viên phụ trách, hoặc kích hoạt các workflow tự động.
Biến Yellow Pages thành danh sách lead Chỉ một cú nhấp để đưa tên doanh nghiệp, số điện thoại, địa chỉ và danh mục vào bảng sạch sẽ — Email và Phone Extractor miễn phí và không tốn credit. Get Started Free
Chuẩn bị dữ liệu để nhập vào CRM
- Map trường dữ liệu: Đảm bảo các cột đã scrape khớp với trường bắt buộc của CRM (ví dụ: “Business Name” → “Account Name”).
- Xuất đúng định dạng: Thunderbit cho phép xuất trực tiếp sang Google Sheets, Airtable, Notion, CSV hoặc Excel.
- Kiểm tra với một lô nhỏ: Hãy import thử một mẫu để phát hiện lỗi mapping hoặc định dạng trước khi tải toàn bộ danh sách.
Năm mẹo đã được kiểm chứng để tăng hiệu suất Yellow Pages scraping
Muốn scrape thông minh hơn, không phải vất vả hơn? Đây là 5 mẹo hàng đầu của tôi:
| Mẹo | Mô tả |
|---|---|
| 1. Lên lịch scraping vào giờ thấp điểm | Nhiều website sẽ giới hạn hoặc chặn scraper trong giờ làm việc. Thunderbit cho phép bạn đặt lịch chạy qua đêm hoặc vào cuối tuần để kết quả mượt hơn và nhanh hơn. |
| 2. Dùng xoay IP hoặc chế độ ẩn danh | Tránh bị chặn bằng cách đổi IP hoặc chạy trình duyệt ở chế độ riêng tư. Với tác vụ khối lượng lớn, hãy cân nhắc dùng VPN hoặc dịch vụ proxy (ScrapingBee). |
| 3. Giới hạn tốc độ request | Thiết lập scraper mô phỏng tốc độ duyệt web của người thật—gửi request quá nhanh có thể kích hoạt cơ chế chống bot. |
| 4. Thường xuyên cập nhật template scraping | Dù dùng AI, bạn vẫn nên kiểm tra lại sau những lần website thay đổi lớn. AI của Thunderbit tự thích ứng, nhưng xem nhanh một lượt thì không bao giờ thừa. |
| 5. Theo dõi và xác thực dữ liệu đã scrape | Kiểm tra mẫu ngẫu nhiên để đảm bảo độ chính xác, đặc biệt sau các phiên chạy dài hoặc tác vụ lớn. Dùng tính năng xem trước và xác thực của Thunderbit để phát hiện vấn đề sớm (Perfect Data Entry). |
Lập lịch và tự động hóa các tác vụ Yellow Pages Scraper
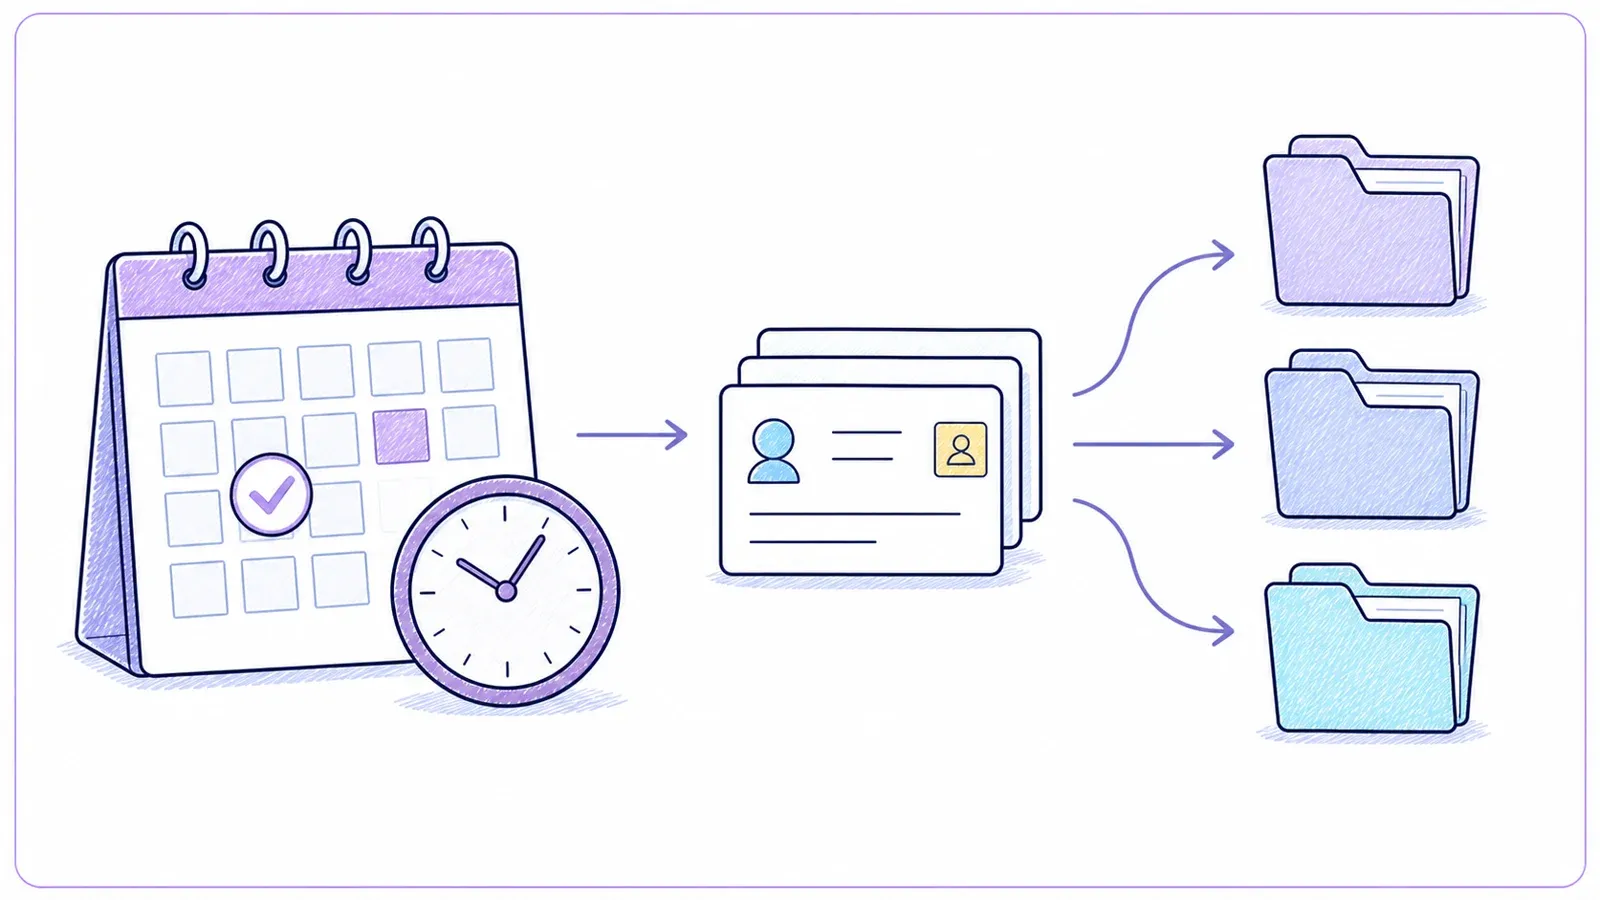 Tính năng lập lịch của Thunderbit là “cứu tinh” cho các đội cần lead mới thường xuyên. Chỉ cần đặt tần suất mong muốn (hàng ngày, hàng tuần, hàng tháng), Thunderbit sẽ tự động scrape và cập nhật dữ liệu của bạn—không cần thao tác thủ công. Điều này rất phù hợp cho:
- Đội sales: Luôn có contact mới nhất để tiếp cận.
- Vận hành ecommerce: Theo dõi cửa hàng mới mở hoặc listing của đối thủ.
- Agency: Luôn giữ danh sách lead của khách hàng được cập nhật mà không tốn công.
Tích hợp kết quả Yellow Pages Scraper vào quy trình sales
Khi dữ liệu đã sạch và được định dạng xong, đã đến lúc đưa nó vào vận hành. Thunderbit hỗ trợ xuất trực tiếp sang các công cụ phổ biến mà đội sales và marketing đang dùng:
- Google Sheets: Phù hợp cho cộng tác và phân tích nhanh.
- Airtable: Phù hợp cho workflow kiểu cơ sở dữ liệu nâng cao.
- Notion: Phù hợp cho quản lý dự án và CRM tích hợp.
- CSV/Excel: Phù hợp để import hàng loạt vào Salesforce, HubSpot, Zoho hoặc CRM bạn đang dùng.
Mẹo chuyên nghiệp: Luôn kiểm tra lại mapping trường và chạy import thử để tránh ghi đè hoặc gán nhãn sai dữ liệu.
Xem cách web scraping kiểu agent hoạt động AI của Thunderbit đọc trang danh bạ doanh nghiệp như một người thật và trích xuất lead chỉ bằng một cú nhấp, không cần CSS selector. Get Started Free
Khi tích hợp trực tiếp dữ liệu Yellow Pages vào workflow của bạn, bạn có thể tăng tốc outreach, cải thiện khả năng nhắm mục tiêu và tạo ra kết quả tốt hơn cho cả đội.
Những sai lầm phổ biến cần tránh khi dùng Yellow Pages Scraper
Ngay cả công cụ tốt nhất cũng không thể cứu bạn khỏi vài lỗi kinh điển. Đây là những điều cần lưu ý:
- Scrape dữ liệu không liên quan: Không thiết lập bộ lọc rõ ràng sẽ làm danh sách bị phình to và thiếu trọng tâm.
- Không dọn bản trùng: Contact trùng lặp vừa tốn thời gian vừa khiến khách hàng khó chịu.
- Bỏ qua yếu tố pháp lý: Luôn kiểm tra điều khoản sử dụng của Yellow Pages và luật bảo mật dữ liệu tại địa phương trước khi scraping (Apify).
- Tải quá nặng lên website: Gửi quá nhiều request trong thời gian ngắn có thể khiến bạn bị chặn—hãy tiết chế.
- Bỏ qua bước xác thực dữ liệu: Đừng mặc định rằng dữ liệu scrape ra đã hoàn hảo. Luôn rà soát và làm sạch trước khi import.
Các tính năng tích hợp sẵn của Thunderbit—như One Click Extract, khử trùng lặp và xác thực khi xuất dữ liệu—giúp bạn tránh phần lớn những rắc rối này ngay từ đầu.
Kết luận: Những điểm mấu chốt để tối đa hóa hiệu suất Yellow Pages Scraper
Scraping Yellow Pages vẫn là một trong những cách hiệu quả nhất để xây dựng danh sách lead chất lượng cao, đúng mục tiêu cho sales và marketing. Nhưng để thật sự tối ưu hiệu suất (và tránh các sai lầm kinh điển), bạn cần:
- Làm rõ mục tiêu dữ liệu và bộ lọc trước khi bắt đầu
- Tận dụng các tính năng nâng cao như One Click Extract và subpage scraping
- Làm sạch, định dạng và gắn thẻ dữ liệu để dễ tích hợp vào CRM
- Tự động hóa và lên lịch scraping để dữ liệu luôn mới
- Theo dõi, xác thực và tuân thủ ở mọi bước
Với Thunderbit’s Yellow Pages Scraper, bạn có thể đi từ hàng giờ nhập liệu thủ công đến một danh sách lead sạch và sẵn sàng hành động chỉ bằng một cú nhấp. Đây là công cụ mà tôi ước mình đã có từ nhiều năm trước—và hiện tại nó đang giúp hàng nghìn đội nhóm trên toàn cầu làm việc thông minh hơn, không phải vất vả hơn.
Tải tiện ích Thunderbit Chrome Extension Cài đặt tiện ích Chrome miễn phí và bắt đầu scraping Yellow Pages listings chỉ với một cú nhấp. Get Started Free
Sẵn sàng tự mình trải nghiệm chưa? Hãy tải Chrome Extension của Thunderbit và bắt đầu xây dựng danh sách lead chuyển đổi cao tiếp theo ngay hôm nay. Và nếu bạn muốn tìm hiểu sâu hơn về best practice của web scraping, hãy xem Thunderbit Blog để đọc thêm các hướng dẫn và mẹo hữu ích.
Bắt đầu scraping Yellow Pages bằng AI Get Started Free
Câu hỏi thường gặp
1. Có hợp pháp khi scrape dữ liệu từ Yellow Pages không?
Việc trích xuất dữ liệu từ các danh bạ doanh nghiệp công khai nhìn chung là hợp pháp cho mục đích kinh doanh, nhưng bạn luôn nên kiểm tra điều khoản sử dụng của website cụ thể và tuân thủ luật bảo mật dữ liệu tại địa phương. Tránh scrape dữ liệu cá nhân hoặc dùng dữ liệu scrape được để spam.
2. Cách tốt nhất để tránh bị chặn khi scrape Yellow Pages là gì?
Hãy lên lịch scraping vào giờ thấp điểm, dùng chế độ ẩn danh hoặc xoay IP, và giới hạn tốc độ request để mô phỏng hành vi duyệt web của người thật. Các tùy chọn lập lịch và browser scraping của Thunderbit giúp giảm thiểu rủi ro bị chặn.
3. Nên trích xuất những trường nào từ Yellow Pages cho sales lead?
Hãy tập trung vào tên doanh nghiệp, số điện thoại, email, địa chỉ, website, danh mục doanh nghiệp và các thông tin chuyên biệt phù hợp với chiến dịch của bạn. Dùng “One Click Extract” của Thunderbit để tự động nhận diện những cột hữu ích nhất.
4. Làm sao để nhập dữ liệu Yellow Pages đã scrape vào CRM?
Xuất dữ liệu từ Thunderbit sang CSV, Excel, Google Sheets, Airtable hoặc Notion. Map các trường theo yêu cầu của CRM và luôn test với một lô nhỏ trước khi nhập toàn bộ danh sách.
5. Làm sao để giữ danh sách lead Yellow Pages luôn cập nhật?
Sử dụng tính năng lập lịch của Thunderbit để tự động chạy scraping định kỳ. Nhờ đó danh sách của bạn luôn mới và phù hợp—rất lý tưởng cho outreach liên tục và theo dõi thị trường.
Chúc bạn scraping thật hiệu quả—và mong rằng danh sách lead của bạn sẽ luôn sạch, mới và đầy cơ hội.



