
Thu thập dữ liệu Facebook vẫn đáng làm trong năm 2026, nhưng chỉ khi bạn chọn đúng mô hình thu thập. Pew Research Center cho biết ngày 20/11/2025 rằng 71% người trưởng thành tại Mỹ dùng Facebook, và Meta công bố ngày 29/04/2026 rằng hệ sinh thái ứng dụng của họ đạt 3,56 tỷ người dùng hoạt động hằng ngày trong tháng 3/2026. Quy mô đó khiến Facebook vẫn cực kỳ hữu ích để theo dõi Marketplace, nghiên cứu các trang công khai, tạo lead và bám sát đối thủ. Cái khó không nằm ở chuyện tìm ra use case. Cái khó là lấy được dữ liệu sạch mà không dính login wall, nội dung tải động, chặn tạm thời hay những thiết lập scraping rất dễ gãy.
Danh sách rút gọn hằng năm này được làm ra để giúp bạn quyết nhanh hơn. Tôi đã rà lại trang sản phẩm chính thức, tài liệu và tín hiệu giá vào tháng 8/2026, rồi chỉ giữ lại những công cụ thật sự còn hợp với người dùng doanh nghiệp. Nếu bạn cần hạ tầng ở quy mô API, Bright Data, Apify và Nimble by Nimbleway nên nằm ở nhóm đầu danh sách. Nếu công việc của bạn còn bao gồm tự động hóa trên cloud hoặc các bước xử lý tiếp theo sau khi thu thập, PhantomBuster rất đáng để xem kỹ hơn.
Gợi Ý Nhanh Theo Nhu Cầu
- Cần một hướng chính thức cho tài sản bạn quản lý? Hãy bắt đầu với bộ công cụ quản trị và API được Meta phê duyệt.
- Cần một API chuyên về dữ liệu công khai? Hãy đánh giá Bright Data hoặc Apify dựa trên đúng mục tiêu và phạm vi sử dụng được phép.
- Cần một lớp hạ tầng dữ liệu web tổng quát? Hãy thử Nimble hoặc ScrapingBot bằng một proof of concept có giới hạn.
- Cần một quy trình trực quan cho nguồn không thuộc Meta nhưng được phép khai thác? Octoparse có thể hợp với quy trình do analyst vận hành.
Vì Sao Thu Thập Dữ Liệu Facebook Vẫn Khó Trong 2026
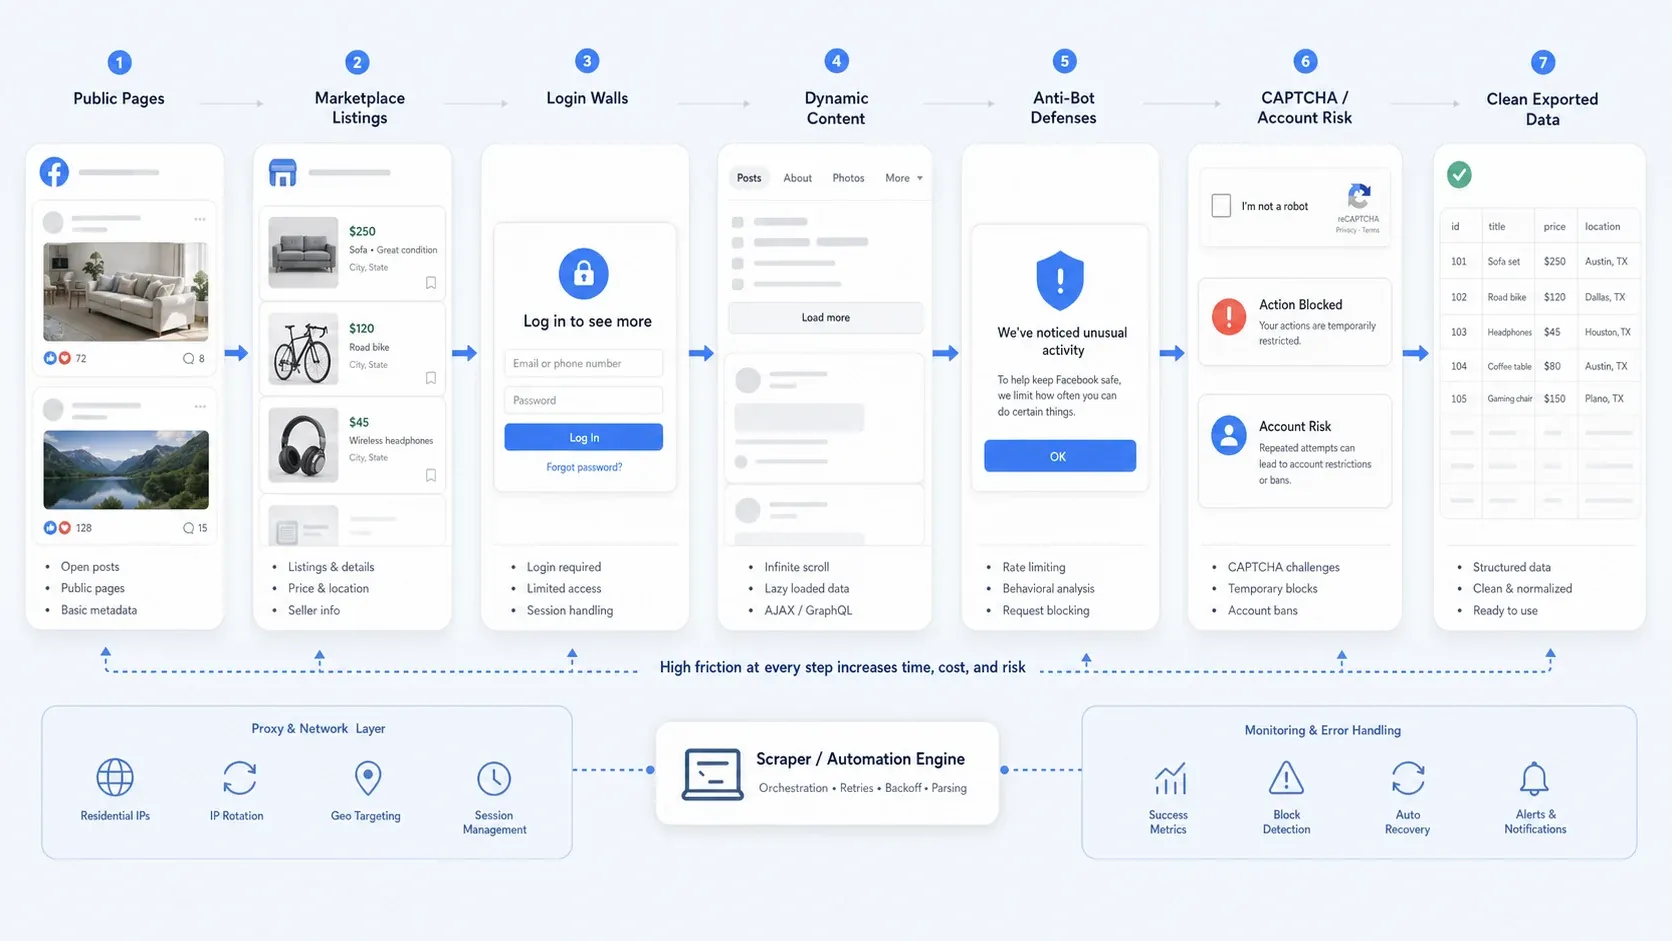
Thu thập dữ liệu Facebook hiếm khi chỉ là chuyện chọn đúng selector. Thực tế, phần lớn đội nhóm đều sẽ gặp một hoặc nhiều vấn đề sau:
- Truy cập công khai không đầy đủ: Có những trang vẫn mở, nhưng các luồng khác lại đẩy bạn sang đăng nhập mới xem thêm chi tiết.
- Nội dung động: Giao diện Marketplace, chuỗi bình luận dài và nội dung trên trang thường tải theo từng đợt.
- Cơ chế chống bot: Giới hạn tần suất, kiểm tra hành vi, CAPTCHA và chặn tạm thời có thể làm hỏng các automation đơn giản.
- Rủi ro vận hành: Thu thập qua tài khoản đăng nhập luôn rủi ro hơn khai thác trang công khai, nhất là khi bạn quan tâm đến an toàn tài khoản và khả năng chạy ổn định lâu dài.
Cách Tôi Đánh Giá Các Công Cụ Này
Tôi tối ưu trang này để chọn shortlist, không phải để nhồi thêm tính năng. Các công cụ bên dưới được so sánh theo:
- Độ khớp với quy trình: Sản phẩm có thật sự hợp với các tác vụ thu thập Facebook và Marketplace mà đội ngũ đang làm không?
- Mức độ dễ dùng: Người không chuyên kỹ thuật hoặc team nhỏ có thể tạo ra kết quả hữu ích nhanh đến đâu?
- Quy mô và độ tin cậy: Công cụ có còn ổn khi bạn không chỉ làm một lần scrape?
- Khả năng xử lý anti-bot và session: Sản phẩm giúp giảm bớt gánh nặng hạ tầng đến mức nào?
- Chất lượng đầu ra: Có thể đưa dữ liệu có cấu trúc vào CSV, Sheets hoặc hệ thống downstream mà không phải dọn dẹp quá nhiều không?
- Tín hiệu giá: Sản phẩm có dễ đánh giá về mặt chi phí hay không, hay bắt bạn đi qua quy trình enterprise khá nặng?
- Tư thế tuân thủ: Công cụ có định vị rõ cho việc thu thập dữ liệu công khai và sử dụng có trách nhiệm không?
Bạn Cần Loại Facebook Scraper Nào?
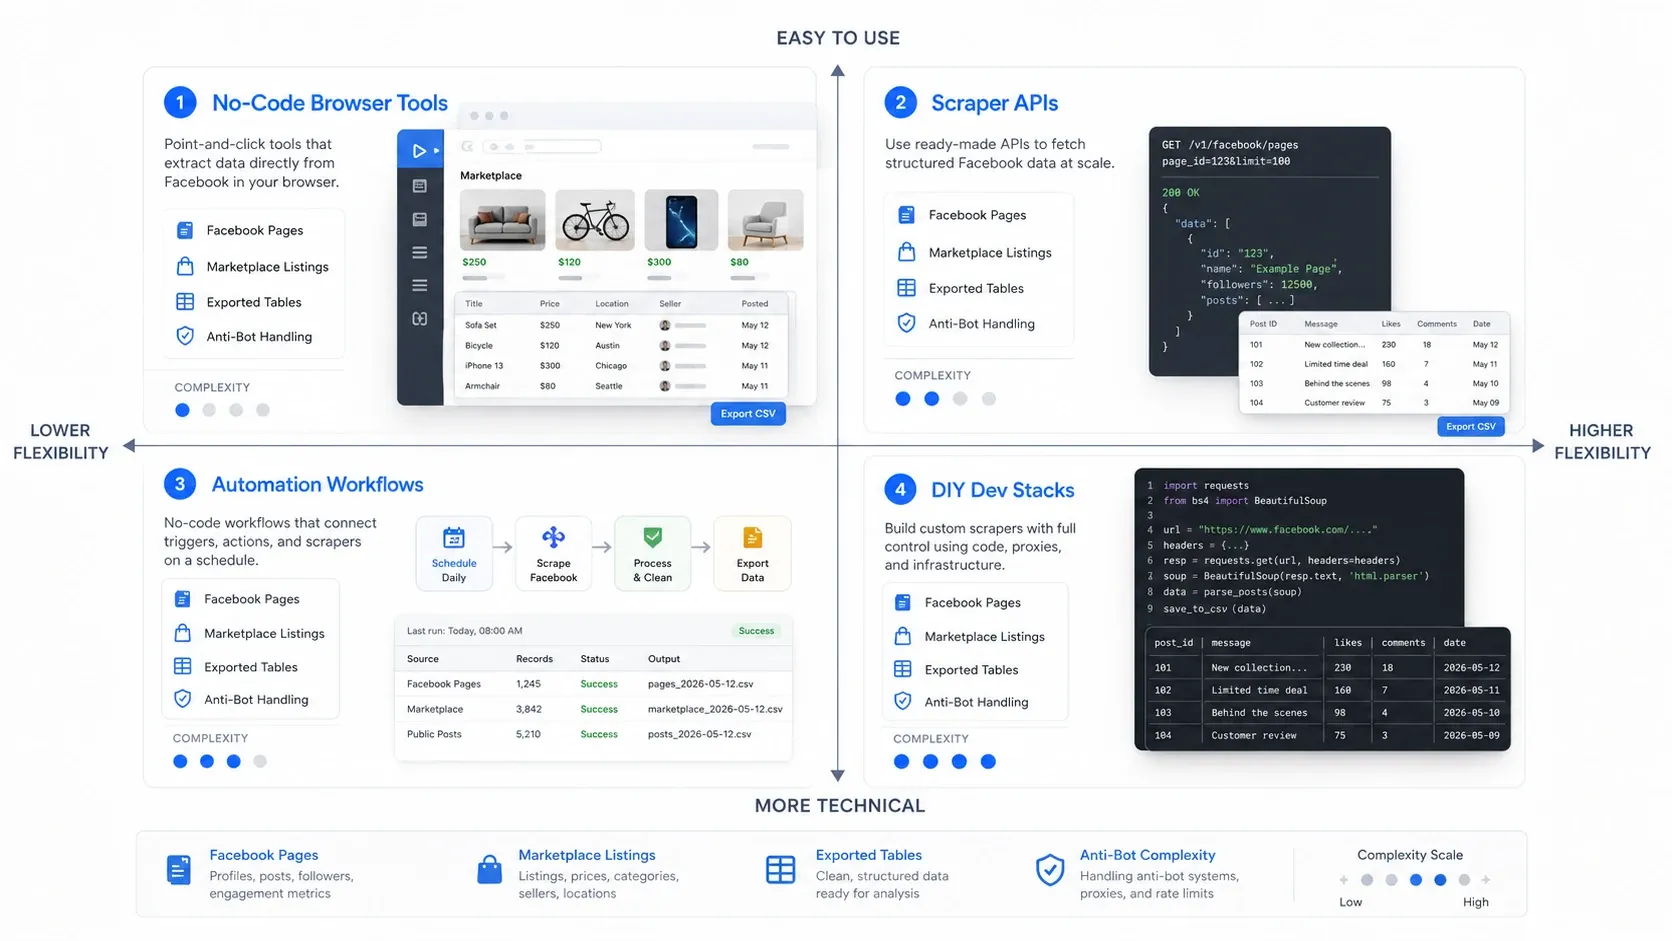
Cách nhanh nhất để chọn đúng là chọn đúng nhóm công cụ ngay từ đầu. Các công cụ thu thập Facebook thường rơi vào bốn mô hình vận hành:
- Công cụ không cần code trên trình duyệt: Hợp khi bạn muốn trích xuất nhanh từ trang đang mở ngay trước mắt.
- Scraper API: Hợp khi bạn cần thu thập ổn định, lặp lại và ở khối lượng lớn hơn.
- Quy trình tự động hóa: Hợp khi scraping chỉ là một bước trong toàn bộ quy trình go-to-market rộng hơn.
- Bộ công cụ dev tự xây: Hợp khi team cần kiểm soát tối đa và sẵn sàng tự gánh phần bảo trì.
Bảng So Sánh
| Công cụ | Phù hợp nhất | Mô hình vận hành |
|---|---|---|
| Bright Data | Quy trình API dữ liệu công khai được quản lý | Lớp API chuyên biệt và lớp phân phối dữ liệu |
| Apify | Tác vụ Page hoặc Profile có thể lặp lại | Actor trên cloud và xuất dataset |
| Nimble | Đánh giá bởi team kỹ thuật | API web công khai tổng quát |
| ScrapingBot | Thử nghiệm cần render | API scraping tổng quát |
| PhantomBuster | Quy trình GTM dùng tài khoản chủ sở hữu | Tự động hóa prospecting |
| Octoparse | Tác vụ trực quan do analyst vận hành | Quy trình trực quan không cần code |
1. Bright Data
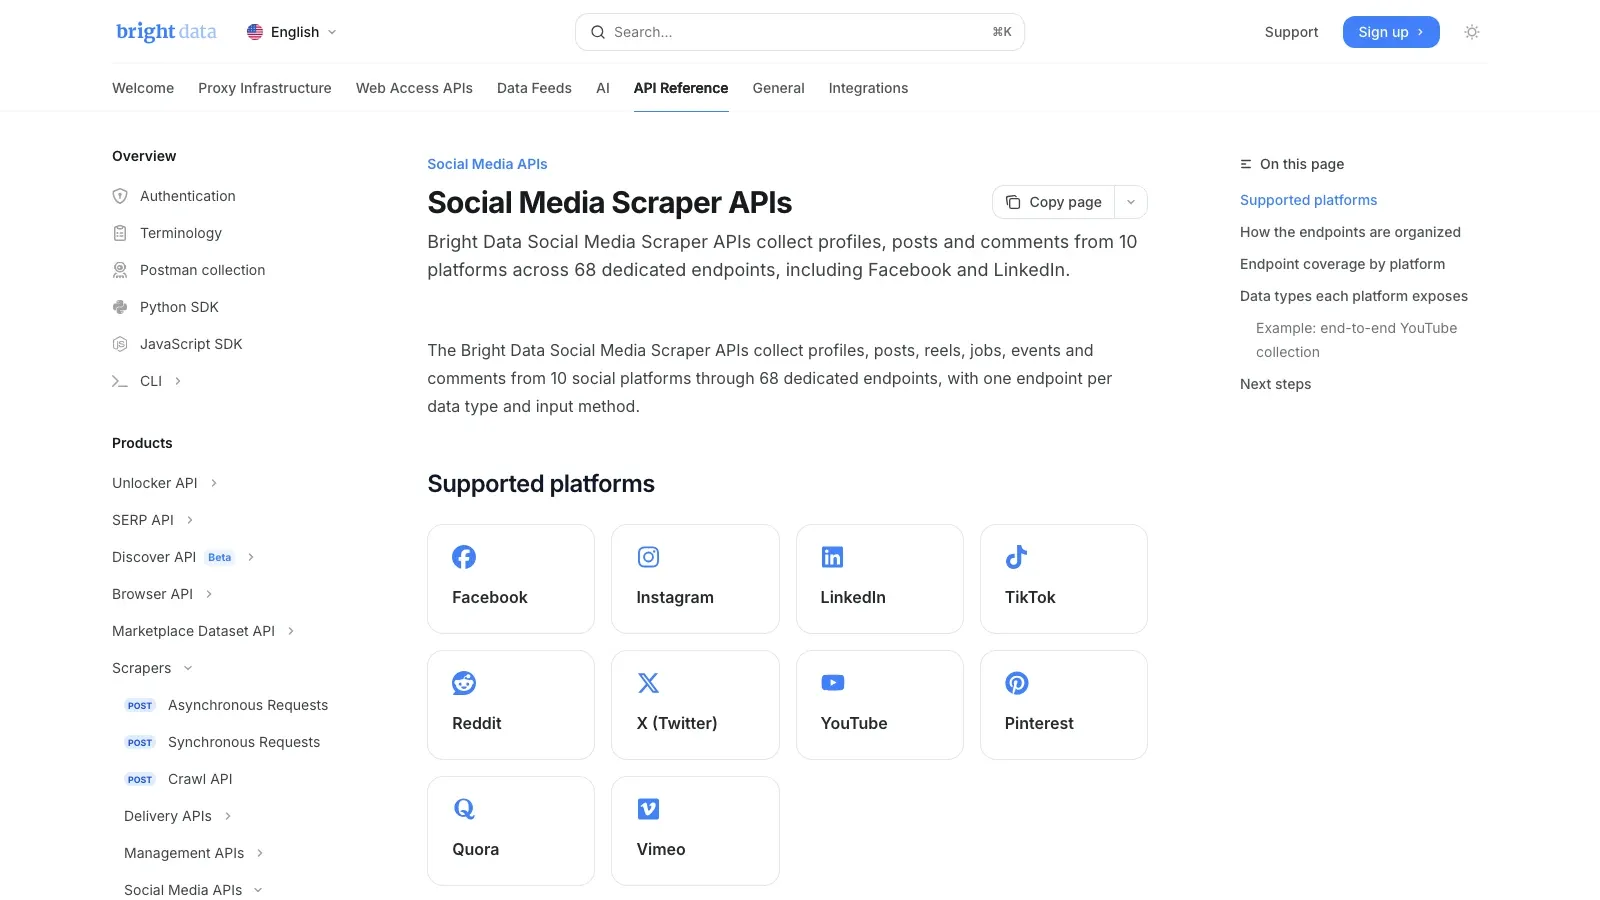
Bright Data là lựa chọn ưu tiên nếu bạn cần hạ tầng trước hết. Tài liệu chính thức của Bright Data cho biết Social Media Scraper APIs của họ bao phủ 10 nền tảng và 68 endpoint chuyên dụng, bao gồm Facebook. Nếu công việc của bạn là thu thập dữ liệu công khai ở quy mô lớn, một stack API được quản lý như thế này thường thực tế hơn nhiều so với việc cố mở rộng một tiện ích trình duyệt hoặc scraper tự viết.
Vì sao công cụ này xứng đáng có mặt trong shortlist:
- Các endpoint scraping mạng xã hội chuyên biệt
- Quản lý phần mở khóa và trích xuất dữ liệu
- Cung cấp đầu ra có cấu trúc cho các data pipeline
- Phù hợp hơn với các tác vụ giám sát và phân tích cần độ tin cậy cao
Phù hợp nhất cho: analyst, team dữ liệu, dự án giám sát quy mô lớn và bộ dữ liệu mạng xã hội công khai ở quy mô lớn.
Tín hiệu giá: Giá thay đổi theo sản phẩm và khối lượng sử dụng. Hãy kiểm tra bảng giá hiện tại của Bright Data.
2. Apify
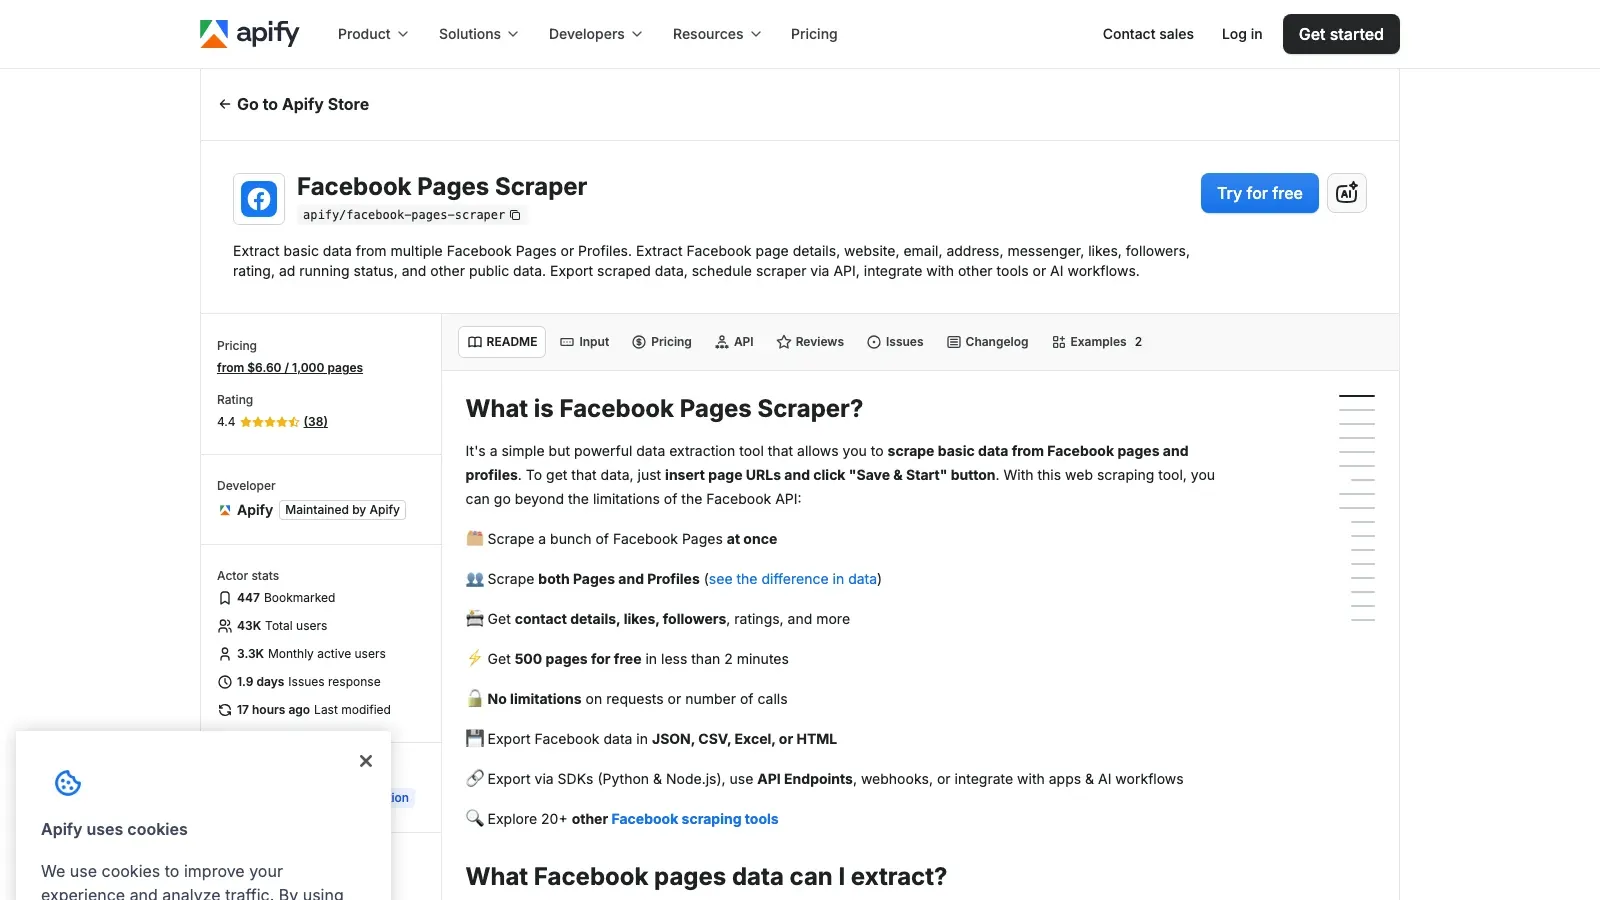
Apify vẫn rất đáng chú ý vì nó tạo ra điểm cân bằng khá tốt giữa template có sẵn và khả năng tùy biến sâu. Facebook Pages Scraper actor của họ là một điểm khởi đầu hữu ích, trong khi nền tảng Apify rộng hơn cung cấp chạy cloud, lên lịch, API và không gian để mở rộng quy trình khi nhu cầu ngày càng phức tạp.
Vì sao công cụ này có mặt trong danh sách:
- Actor Facebook có sẵn
- Chạy trên cloud và có thể lên lịch định kỳ
- Xuất dữ liệu linh hoạt và có API
- Dễ mở rộng hơn so với workflow trình duyệt no-code thuần túy
Phù hợp nhất cho: marketer thiên về kỹ thuật, agency, team vận hành và các tác vụ thu thập lặp lại trên nhiều website.
Tín hiệu giá: Gói nền tảng là trả phí và việc sử dụng actor được tính riêng theo mức dùng. Xem bảng giá Apify.
3. Nimble by Nimbleway
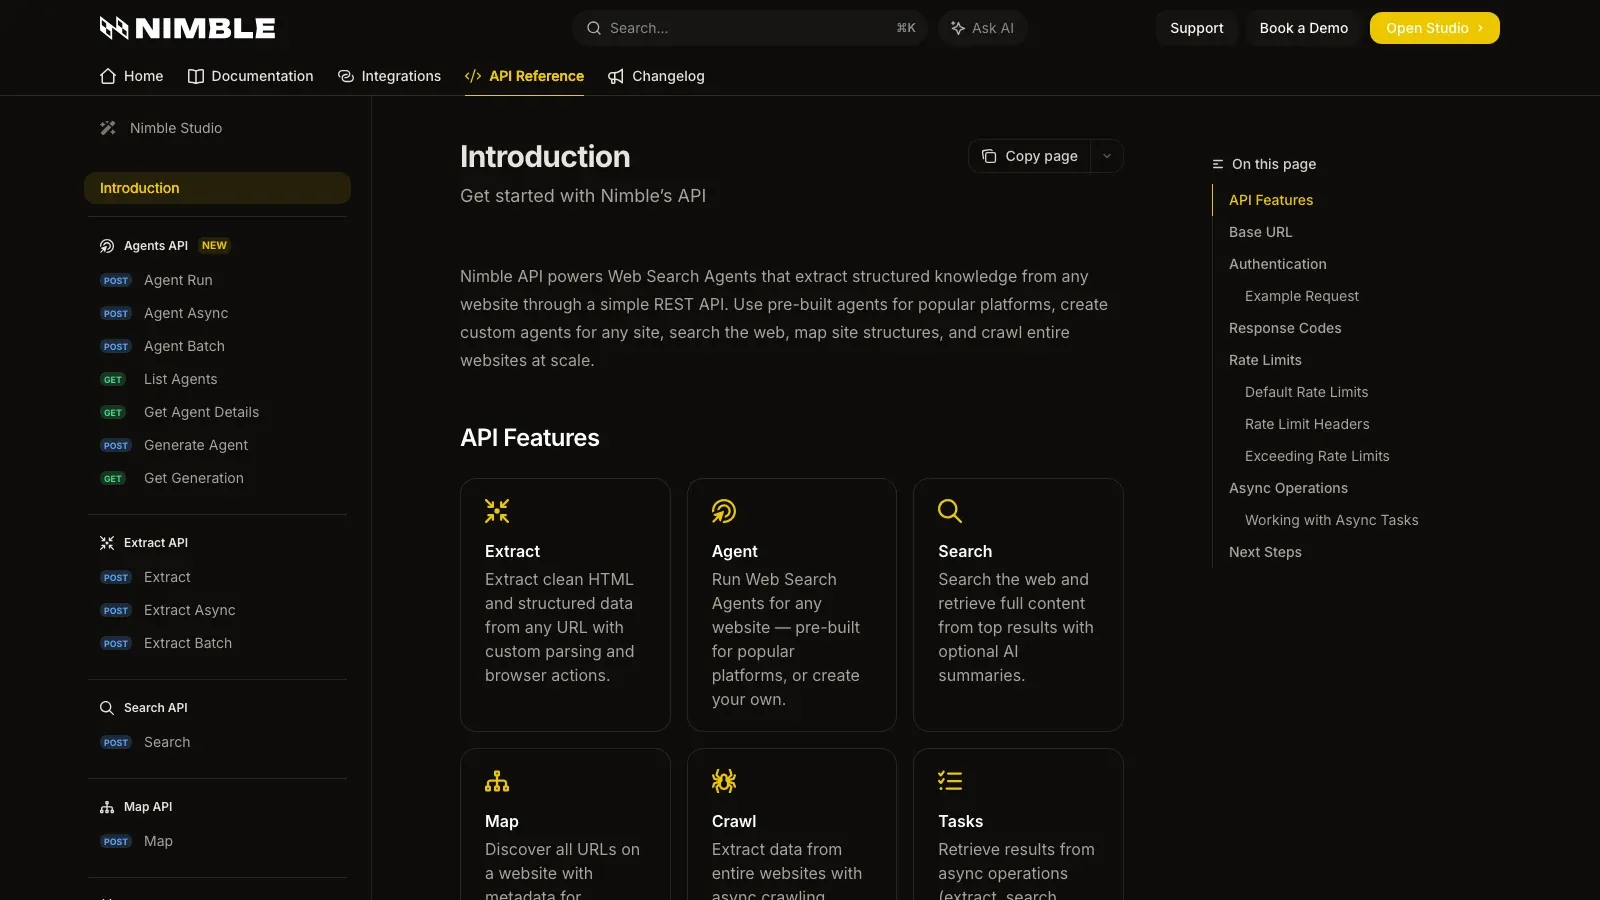
Nimble by Nimbleway là lựa chọn ưu tiên API-first cho các đội muốn chỉ cần gửi URL rồi để nền tảng xử lý truy cập, render và trả dữ liệu. Nimble định vị Web Scraper API của họ như một giải pháp thu thập dữ liệu web công khai end-to-end, nên rất hữu ích khi scraping Facebook chỉ là một phần trong toàn bộ stack dữ liệu rộng hơn.
Vì sao đáng để đánh giá:
- Quy trình API theo kiểu URL-first
- Giảm gánh nặng bảo trì scraper cho team kỹ thuật
- Phù hợp với việc trích xuất dữ liệu web công khai bền vững
- Hữu ích khi dữ liệu scrape được đổ vào sản phẩm nội bộ hoặc dashboard
Phù hợp nhất cho: team dẫn dắt bởi kỹ thuật, pipeline dữ liệu sản phẩm và tổ chức muốn lớp trừu tượng hạ tầng thay vì các công cụ đơn lẻ.
Tín hiệu giá: Nimble không nhấn mạnh giá self-serve công khai trên các trang API chính, vì vậy nhiều khả năng là mô hình bán hàng trực tiếp; hãy xác nhận trực tiếp với Nimble by Nimbleway.
4. ScrapingBot
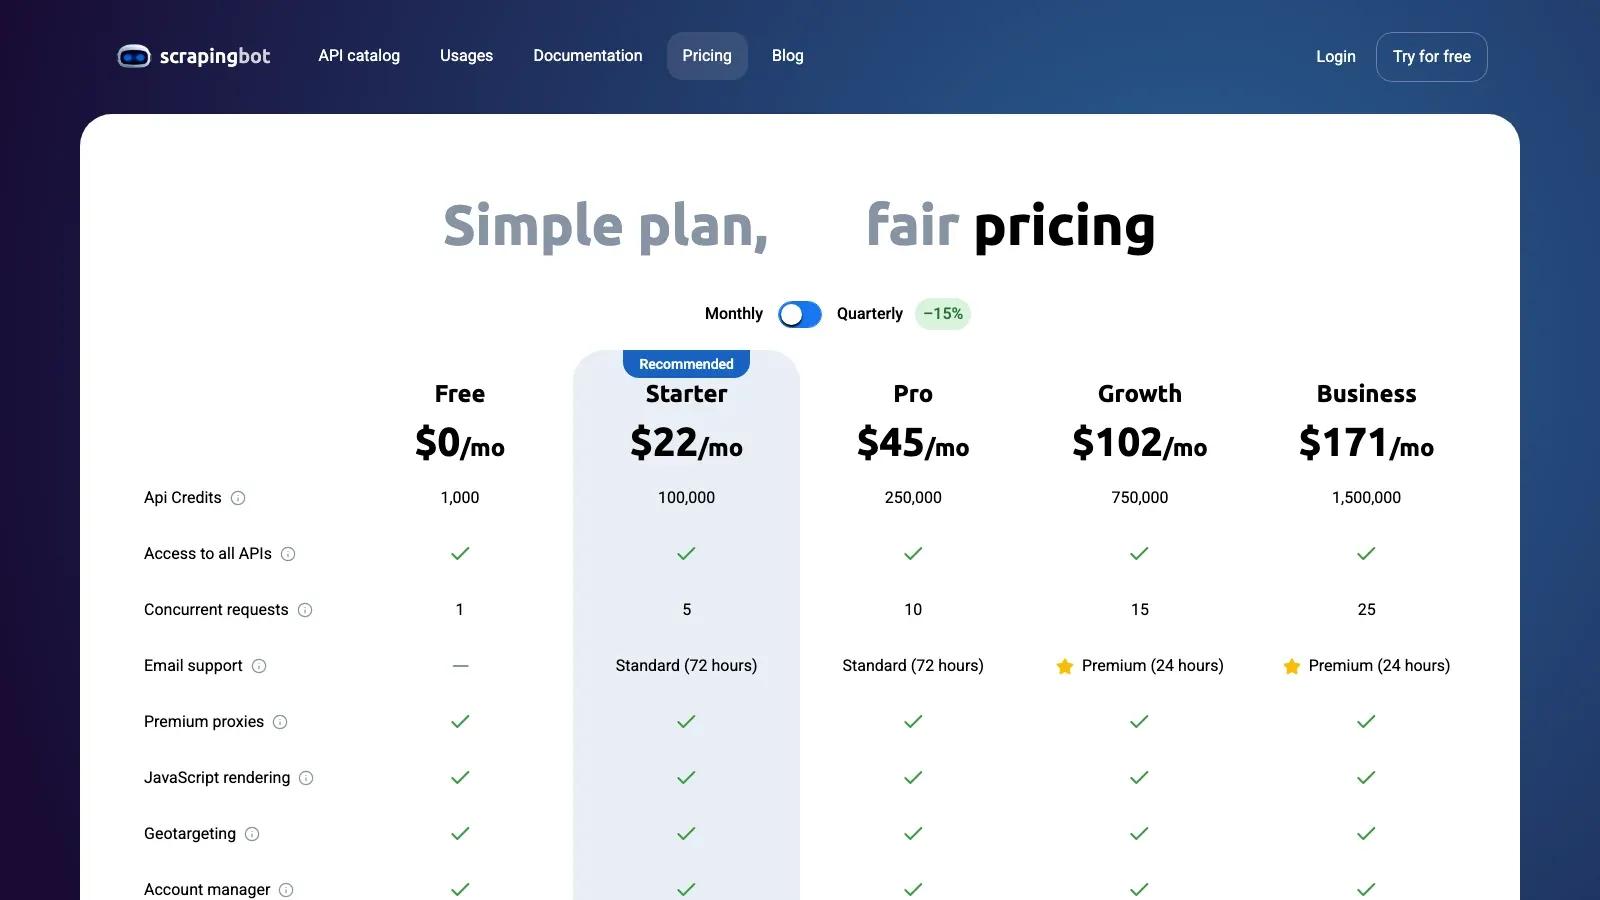
ScrapingBot là lựa chọn API thân thiện với ngân sách trong danh sách này. Đây không phải nền tảng chuyên sâu nhất cho Facebook, nhưng vẫn hợp lý cho các tác vụ dữ liệu công khai quy mô nhỏ khi bạn cần API, hỗ trợ render và mức giá khởi điểm thấp hơn hạ tầng scraping enterprise.
Phù hợp trong các trường hợp:
- Scraping công khai đơn giản qua API
- Mức giá đầu vào thấp hơn
- Bao gồm render và xử lý proxy
- Tốt hơn cho prototype và các lần kéo dữ liệu định kỳ nhẹ so với chương trình intelligence lớn
Phù hợp nhất cho: startup, doanh nghiệp nhỏ và developer đang thử nghiệm các use case thu thập trang công khai nhẹ hơn.
Tín hiệu giá: Có gói miễn phí; trang giá công khai hiện tại bắt đầu từ khoảng 22 USD/tháng.
5. PhantomBuster
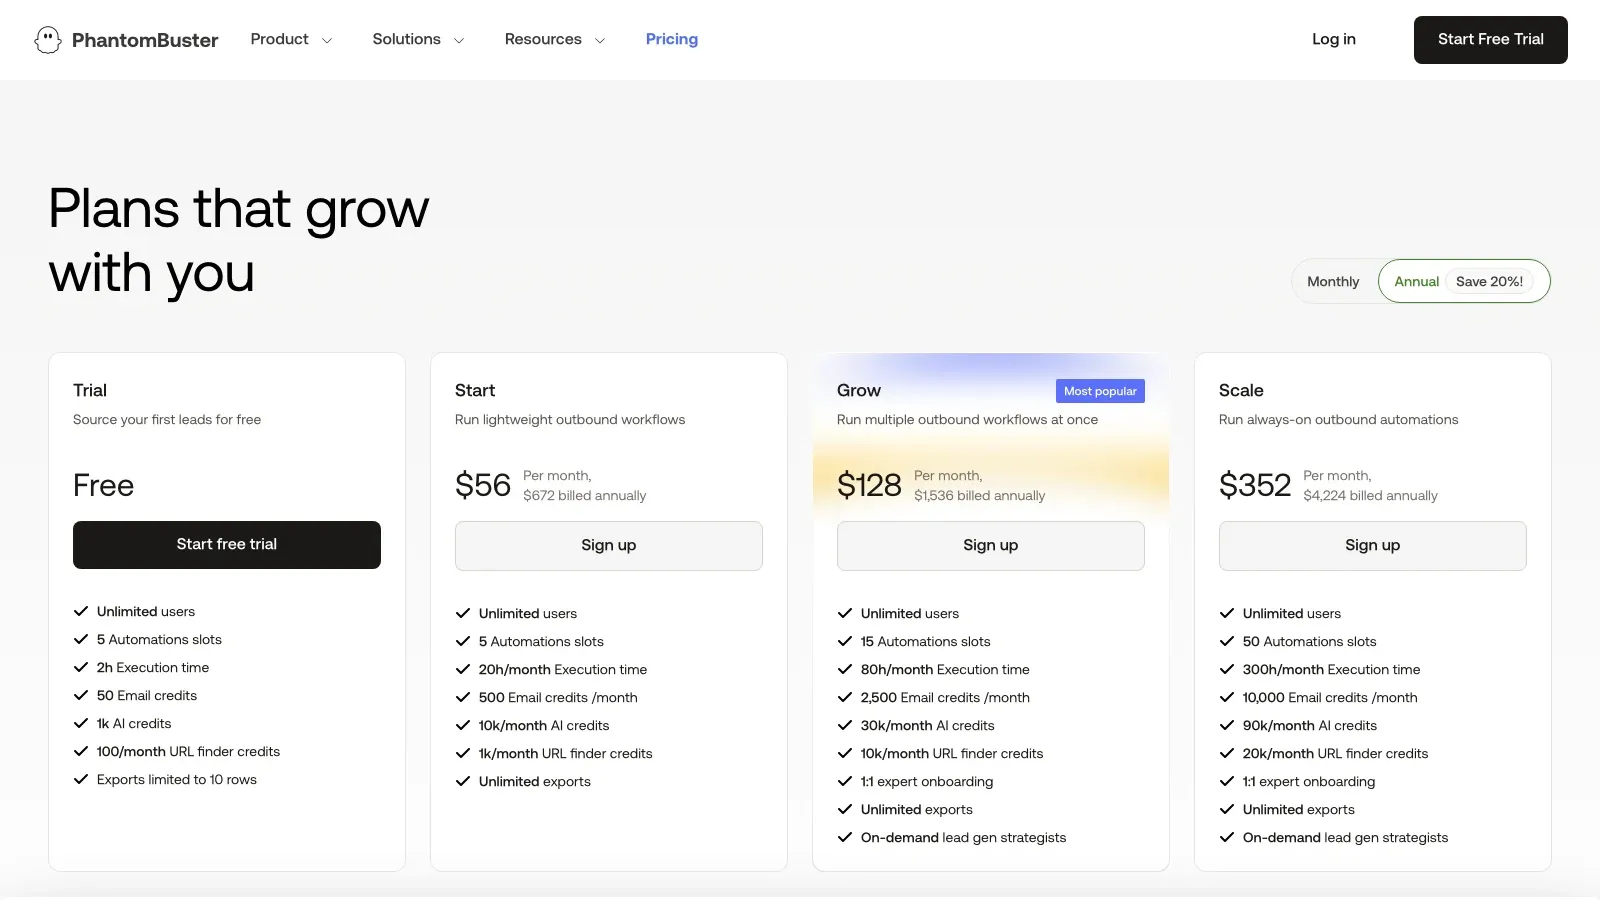
PhantomBuster không tập trung nhiều vào hạ tầng scraping thô mà tập trung vào điều xảy ra sau khi thu thập. Nếu use case của bạn là “thu thập dữ liệu rồi kích hoạt outreach, enrichment hoặc hành động follow-up”, PhantomBuster thường hữu ích hơn một bộ extractor đơn thuần vì nó được thiết kế xoay quanh tự động hóa trên cloud và workflow thao tác bằng trình duyệt.
Vì sao các team vẫn đưa nó vào shortlist:
- Quy trình tự động hóa chạy trên cloud
- Hữu ích cho lead generation và vận hành GTM
- Phù hợp hơn khi scraping chỉ là một bước trong quy trình lớn hơn
- Thiết thực cho người vận hành quan tâm đến hành động, không chỉ xuất dữ liệu
Phù hợp nhất cho: đội GTM, growth, recruiter và những người vận hành chuỗi từ thu thập sang hành động downstream.
Tín hiệu giá: Có bản dùng thử miễn phí; gói trả phí trên trang giá hiện tại bắt đầu từ khoảng 56 USD/tháng.
6. Octoparse
Octoparse vẫn là một trong những công cụ scraping no-code trực quan tốt hơn cho người dùng muốn workflow lặp lại và chạy cloud theo lịch. Nó cho người không chuyên kỹ thuật mức kiểm soát rõ ràng hơn về cách logic trích xuất được xây dựng và lặp lại, đổi lại là cần setup nhiều hơn so với một workflow nhẹ dùng một lần.
Vì sao công cụ này vẫn còn phù hợp:
- Trình tạo workflow trực quan kiểu point-and-click
- Trích xuất trên cloud và lên lịch
- Tốt cho các tác vụ có cấu trúc và lặp lại
- Phù hợp hơn với analyst muốn tính lặp lại mà không cần code
Phù hợp nhất cho: analyst không chuyên kỹ thuật, team vận hành SMB và các tác vụ thu thập lặp lại với logic workflow rõ ràng hơn.
Tín hiệu giá: Trang giá công khai của Octoparse liệt kê các gói trả phí từ khoảng 69 USD/tháng cho gói Standard, thanh toán theo năm.
Shortlist Theo Từng Nhóm Đội
- Workflow ưu tiên API: Bright Data hoặc Apify
- Đánh giá web công khai do team kỹ thuật sở hữu: Nimble hoặc ScrapingBot
- Workflow prospecting dùng tài khoản chủ sở hữu: PhantomBuster
- Workflow trực quan, có thể chỉnh sửa: Octoparse
Trước khi chọn bất kỳ phương án nào, hãy thử đúng loại trang và đúng các trường mà team bạn được phép sử dụng. Mức độ hiển thị trên Facebook khác nhau giữa Pages, Profiles, Marketplace, Groups, địa điểm và trạng thái tài khoản.
Kết Luận
Đường đi đúng phụ thuộc vào dữ liệu, mô hình truy cập và mức độ trách nhiệm của team trong việc xác minh. Với những tài sản bạn quản lý, hãy bắt đầu bằng công cụ chính thức của Meta và các API được phê duyệt. Với hoạt động nghiên cứu ngoài phạm vi đó, chỉ chọn nhà cung cấp hoặc nguồn sau khi đã xác nhận loại trang, phạm vi sử dụng được phép, nghĩa vụ về quyền riêng tư và hành vi sản phẩm hiện tại.
Câu Hỏi Thường Gặp
Người dùng không chuyên kỹ thuật nên cân nhắc hướng nào trước?
Với tài sản do tổ chức của bạn quản lý, hãy bắt đầu bằng các công cụ quản trị và phân tích của chính Meta. Với nhu cầu nghiên cứu rộng hơn, hãy xác định một nguồn được phép mà bạn có thể đánh giá workflow và quyền dữ liệu của nó.
Phương án nào phù hợp nhất cho tích hợp phần mềm hoặc data pipeline?
Hãy đánh giá một API chuyên cho Facebook như Bright Data, một nền tảng dựa trên actor như Apify, hoặc một API web công khai tổng quát thông qua một bài test có giới hạn trên đúng mục tiêu.
Các công cụ này có thể vượt qua giới hạn truy cập của Facebook không?
Không. Đừng dùng bất kỳ công cụ nào để vượt qua cơ chế kiểm soát của nền tảng, login wall hoặc các biện pháp bảo vệ quyền riêng tư.




