
MarkItDown thường bị xếp chung với các web scraper, nhưng gọi vậy là không chuẩn. Công cụ này không có crawler, không có engine JavaScript, và cũng không tự đi lấy một URL rồi lọc bỏ phần nội dung thừa. Thay vào đó, nó nhận những dữ liệu bạn đã có sẵn — một file PDF, tài liệu Word, bảng tính, bộ slide — rồi chuyển hết sang Markdown để mô hình ngôn ngữ đọc được.
Tôi đã dành vài tuần để chạy Microsoft MarkItDown trên nhiều tài liệu thực tế bằng một chiếc Mac duy nhất, chấm từng bảng theo một manifest tôi viết trước khi test, và đo thời gian cho mọi lần chuyển đổi. Tóm lại: với đầu vào sạch, nó nhanh và khá chính xác, nhưng gói cài lại âm thầm kéo theo một runtime machine learning 73 MB mà bạn chẳng hề yêu cầu; còn bảng biểu thì có thể hỏng theo kiểu vẫn qua được bài kiểm tra “văn bản còn không?”, nhưng lại trượt bài kiểm tra “dữ liệu có nằm đúng cột không?”. Dưới đây là bức tranh đầy đủ, kèm số liệu.
MarkItDown thực chất là gì
MarkItDown là một tiện ích Python của Microsoft, dùng để chuyển file và tài liệu Office sang Markdown tối ưu cho LLM. Bạn có thể đưa vào PDF, .docx, .xlsx, .pptx, ảnh, file HTML, hoặc một số định dạng khác, và nó sẽ trả lại Markdown. Công cụ này có ba cách dùng: CLI (markitdown file.pdf -o out.md, hoặc nhận dữ liệu từ stdin), Python API (MarkItDown().convert(...)), và một MCP server tùy chọn cho workflow của agent.
Điểm quan trọng nhất cần hiểu là những gì nó không làm, vì README cũng không quảng cáo như vậy và tôi đã kiểm chứng trong lúc test: không crawl, không render JS, không lần theo link, không xử lý phân trang, và cũng không trích xuất phần nội dung chính theo kiểu readability. Đây là bộ chuyển đổi toàn bộ tài liệu. Bạn đưa bytes vào; nó chuẩn hóa chúng. Sự khác biệt này quyết định công cụ có nên nằm trong stack của bạn hay không, nên tôi sẽ quay lại điểm này nhiều lần.
Bản thân repo này là một “ông lớn” nếu nhìn theo chỉ số GitHub — 165.282 sao và 11.790 fork tính đến giữa tháng 7/2026, giấy phép MIT, với bản phát hành mới nhất (v0.1.6) ra ngày 2026-05-26. Tuy vậy, con số sao đó chủ yếu phản ánh sự hào hứng chung với công cụ cho LLM từ một repo thuộc Microsoft, chứ không phải là chỉ dấu cho độ trưởng thành của phần lõi chuyển đổi. Hiện cũng có 833 issue đang mở, và vài trong số đó là những thứ bạn nên biết trước khi cài.
HTML sang Markdown: nhanh, đầy đủ, nhưng giữ nguyên cả phần thừa
Vì phần còn lại của loạt bài đánh giá scraper của tôi đều dùng chung bốn fixture web, tôi đã đưa cho MarkItDown đúng các file HTML cục bộ đó — không phải để chấm nó như một scraper, mà để xem khả năng chuyển HTML sang Markdown của nó tốt đến đâu. Với những trang được đánh dấu cấu trúc tốt, kết quả thực sự rất ổn.
Cả bốn trang đều chuyển đổi chỉ với bản cài lõi, không cần thêm gì khác, và mọi probe nội dung chính đều được giữ lại. Bài Wikipedia “Web scraping” (226 KB) cho ra cây heading gần như y nguyên — một h1, bảy h2, mười hai h3, khớp với cấu trúc section thật của bài — và 418 link được giữ dưới dạng [text](url) chuẩn. Bảng thống kê hockey 25×9 ở trang Scrape This Site forms được chuyển thành một bảng pipe GFM gọn gàng gồm 27 dòng (header + separator + 26 dòng dữ liệu), kể cả các ô trống. Tốc độ cũng rất ổn: median từ 48 ms với trang quotes nhỏ cho tới 352 ms với trang Wikipedia 226 KB.
Nhưng có một điểm cần lưu ý, và đây là lựa chọn thiết kế chứ không phải lỗi. MarkItDown không loại bỏ boilerplate. Nó chuyển toàn bộ <body>, nên phần chrome của site cũng đi theo — và lượng “rác” này tăng theo độ nặng của giao diện trang.
| Trang | Số ký tự đầu ra | Heading (h1/h2/h3) | Link | Dòng chrome của site |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
Ở trang chủ Books gần như không có chrome, chỉ 0,6% số dòng đầu ra là phần giao diện. Còn với Wikipedia, con số là 12,4% — 42 trong số 338 dòng không rỗng là các thứ như “jump to content”, “toggle the table of contents”, “22 languages”, “retrieved from”, footer cookie và license. Những banner bảo trì của Wikipedia kiểu “This article needs additional citations” còn được render trung thực thành bảng pipe hai cột, và đó là lý do một trang không hề có bảng dữ liệu thật lại sinh ra chín dòng bảng.
Không có gì trong số đó là MarkItDown làm sai. Đây là bộ chuyển đổi toàn tài liệu, không phải công cụ trích xuất nội dung theo readability: chuyển HTML sang Markdown một cách trung thực là một việc khác với lấy riêng nội dung bài viết sạch sẽ. Trafilatura và các công cụ kiểu Firecrawl hướng đến việc trả về chỉ phần nội dung chính; còn MarkItDown trả về cả trang. Bên trong, _html_converter.py chỉ loại <script> và <style>, rồi đưa toàn bộ body cho thư viện markdownify — không có heuristic nào để xác định nội dung chính. Nếu bạn chỉ cần bài viết, đây là tầng sai.
Sân nhà của nó: PDF, DOCX, XLSX, PPTX
Tài liệu mới là thứ MarkItDown được sinh ra để xử lý. Tôi đã chạy nó trên các file công khai thực tế — một bài arXiv có text layer, whitepaper của Bitcoin, một PDF scan chỉ có ảnh mà tôi tự render để không còn text, và các file DOCX/XLSX/PPTX từ chính bộ test của MarkItDown (được gắn UUID để phát hiện mất nội dung âm thầm).
| Tài liệu | Dữ liệu vào | Số ký tự đầu ra | Probe | Thời gian median | Ghi chú |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF có text layer) | 2.2 MB | 40,174 | 7/7 | 3.7 s (warm) | title, "Transformer", "BLEU", "References" đều có |
| Bitcoin whitepaper (PDF 9 trang) | 184 KB | 22,485 | 6/6 | 1.4 s | có "Satoshi Nakamoto", "proof-of-work", "Conclusion" |
| PDF scan (không có text layer) | 89 KB | 0 | 0/4 | 15 ms | đầu ra rỗng, không lỗi, không OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | heading + bảng GFM; UUID nhúng vẫn còn |
| DOCX có công thức | 15 KB | 240 | — | 101 ms | Office Math được giữ dưới dạng LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | mỗi sheet → ## SheetName + bảng GFM |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | có marker số slide, bảng, chart → bảng |
Khả năng giữ lại text trên PDF có text layer là rất tốt — 7/7 probe đã đăng ký trước trên bài arXiv “Attention Is All You Need”, 6/6 trên Bitcoin whitepaper — và không file Office nào làm mất một sentinel UUID nào, nên không có mất nội dung âm thầm trên các fixture regression của chính maintainers. Một điểm cộng nhỏ nhưng đáng giá: đường xử lý DOCX (qua mammoth) giữ được Office Math dưới dạng LaTeX, chuyển equations.docx thành math thực sự với $$...$$. Nếu bạn đang đưa các tài liệu Word nặng công thức vào LLM, đây là một điểm mạnh cụ thể mà tôi không thấy được ghi chú rõ ở nơi khác.
Có hai phát hiện trên “sân nhà” này đáng được chú ý riêng, vì đây là những chỗ dễ làm bạn vấp nhất.
PDF scan biến mất hoàn toàn
Nếu đưa cho MarkItDown một PDF chỉ có ảnh, không có text layer, nó sẽ trả về chuỗi rỗng. Không ký tự nào, không exception, không cảnh báo — chuyển trong khoảng 15 ms vì thực ra không có gì để trích xuất. Đường xử lý PDF của MarkItDown chỉ làm text extraction (dùng pdfminer và pdfplumber bên dưới), và bản core cũng như mọi pip extra đều không có OCR.
Điều này rất quan trọng khi xử lý hàng loạt. Một developer đổ cả thư mục PDF vào, trong đó có file scan, sẽ nhận được kết quả rỗng một cách im lặng cho các file đó mà không có tín hiệu nào báo rằng chúng đã bị bỏ qua. Tôi đã kiểm tra để chắc chắn fixture không hỏng bằng cách chạy extract_text của pdfminer trực tiếp lên đó — kết quả vẫn là không có text layer, xác nhận đúng — nên đầu ra rỗng là hành vi thật của MarkItDown với một file scan thật. Điều này tái hiện một khoảng trống OCR fallback đã tồn tại lâu năm (#1268). Đường được tài liệu hóa là Azure Document Intelligence backend tùy chọn hoặc plugin; cả hai đều không nằm trong bản cài mặc định.
PDF ra dạng text phẳng, không có cấu trúc
Trên cả hai file PDF có text layer, MarkItDown không tạo ra bất kỳ Markdown heading marker nào. PDF vốn không chứa semantic heading tags, và MarkItDown cũng không suy luận chúng từ kích thước font, nên mọi dòng đều rơi xuống mức body. Text được giữ khá tốt; cấu trúc thì phẳng lì.
Đây không chỉ là kết quả của riêng tôi. Các benchmark công khai từ bên thứ ba chấm điểm khả năng giữ heading hierarchy của MarkItDown cho PDF vào khoảng 0.0 và độ trung thực của bảng vào khoảng 0.27, thấp hơn nhiều so với 0.88 của Docling dựa trên TableFormer (xem so sánh MarkItDown vs Docling vs Marker và benchmark READoc). Fixture của tôi cho ra cùng xu hướng đó, và đó là một điểm mạnh về mặt bằng chứng: số liệu của tôi khớp với nguồn ngoài. Đổi lại, các benchmark đó cũng cho thấy MarkItDown chạy nhanh hơn Docling khoảng 100 lần, điều này khớp với việc tôi thấy nó tốn vài giây thay vì vài phút trên những tài liệu mà công cụ dùng layout model phải xử lý rất lâu. Kết luận là: MarkItDown cho bạn PDF text sạch và nhanh; nó không cho bạn cấu trúc của PDF. Nếu heading và bảng phải được giữ nguyên, bạn cần một công cụ lớp layout như Docling hoặc Marker.
Bảng biểu: nội dung luôn còn, nhưng cấu trúc thì không phải lúc nào cũng vậy
Bảng là nơi hai câu hỏi “văn bản còn không?” và “dữ liệu còn dùng được không?” tách hẳn nhau ra, nên tôi dựng một ma trận 13 trường hợp — mỗi case một <table>, chấm theo manifest viết sẵn trước khi chạy — để xem chính xác kiểu nào ổn và kiểu nào hỏng.
Kết luận chính: MarkItDown không làm mất nội dung bảng. Cả 13 trường hợp đều giữ 100% token đã đăng ký trước. Nhưng độ trung thực về cấu trúc lại chia thành ba nhóm. Bảy trong mười ba trường hợp cho ra một lưới GFM chuẩn chỉnh (bảng thường, header-colspan, bảng rộng 24 cột, bảng không header, ô trống, block-in-cell, và bảng Arabic viết từ phải sang trái). Bốn trường hợp bị méo vì Markdown không có khái niệm ô được gộp, nên rowspan, colspan và nguồn đầu vào lỗi sẽ sinh ra các dòng ngắn. Và hai trường hợp thì hỏng hẳn.
Hai lỗi này đáng nêu đích danh. Một bảng lồng trong bảng khác (một <table> nằm trong <td>) bị dẹt ra như nội tuyến, kéo cả pipe và dòng separator của nó vào ô cha và tạo ra một dòng “14 cột” rác. Và ký tự | xuất hiện nguyên văn trong ô không được escape — text a | b biến thành hai cột, x || y thành ba cột — nên một bảng hai cột có thể sinh ra các dòng với hai, ba và bốn cột, khiến bất kỳ Markdown parser nào phía sau cũng đọc sai ranh giới. Điều thú vị là dấu * và backtick trong ô lại được escape; chỉ có pipe là không. Nguyên nhân gốc là đường HTML của MarkItDown dùng cách xử lý bảng mặc định của markdownify, còn subclass tùy biến của nó chỉ override link, image và heading chứ không đụng đến ô bảng. Lỗi escape pipe này cùng họ với một issue mở cho bộ chuyển CSV (#2019), nhưng bản fix đó không ảnh hưởng đến đường HTML mà tôi đã test.
Một phát hiện tinh vi hơn — và cũng là thứ tôi muốn một data engineer nhất định phải thấy — là rowspan. Case t03 không chỉ bị méo mà còn lệch cột một cách âm thầm. Nhãn rowspan=2 (“Fruit”) chỉ được in một lần, còn dòng bên dưới trở thành một dòng ngắn hai cột (| Banana | 8 |), nên “Banana” lại nằm dưới cột Group thay vì Item. Tất cả token đều còn đó. Nhưng nếu một consumer ngây thơ chỉ đọc cột thứ hai, nó sẽ lấy nhầm dữ liệu. Đây chính là kiểu bug vượt qua kiểm tra “văn bản còn không?” nhưng âm thầm làm hỏng cả dataset.
Bản thân hạn chế về span đã là một ràng buộc thiết kế được ghi nhận từ trước (#1211, #1248) — một lưới GFM phẳng thực sự không thể biểu diễn span hay bảng lồng nhau, nên converter chấp nhận đánh đổi cấu trúc để lấy độ đầy đủ nội dung. Trong đó cũng có vài hành vi tốt: bảng không có header sẽ được tạo một hàng header trống (để dữ liệu không bị lỡ đẩy lên làm header), ô trống được giữ nguyên, và <caption> vẫn sống sót như một dòng text nằm phía trên bảng.
Cài đặt và khởi động: cái “thuế” mà một tiện ích nhẹ nhàng không hề cảnh báo trước
Không có gì làm tôi bất ngờ hơn phần này, và đây cũng là chỗ cách quảng bá “tiện ích Python nhẹ” của MarkItDown hơi quá tay một cách kín đáo.
Trước hết, đừng chạy pip install 'markitdown[all]'. Trên Python 3.14, lệnh này âm thầm lùi về markitdown 0.0.2 — một bản phát hành cách đây hai năm — và tôi đã tái hiện trực tiếp trong một venv sạch. Khi pin phiên bản, lý do hiện ra rất rõ: pip install 'markitdown[all]==0.1.6' báo lỗi vì extra [all] ghim youtube-transcript-api~=1.0.0, trong khi trên PyPI hiện tại, mọi bản trong dải đó đều bị giới hạn cho Python <3.14, còn các bản tương thích với 3.14 thì lại nằm ngoài pin. Vì vậy resolver buộc phải lùi hết về bản phát hành cuối cùng mà nó còn thỏa được dependency. Điều này trùng với một issue upstream đang mở (#2179). Cách khắc phục khá thẳng: pin version rồi cài từng extra riêng lẻ: pip install 'markitdown==0.1.6', sau đó pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Mỗi lệnh đó đều resolve ổn; chỉ gói [all] là có pin “độc”. (Bẫy này còn phụ thuộc phiên bản Python — trên Python 3.13 trở xuống, rào chắn có thể không đụng tới, nên [all] có thể resolve khác.)
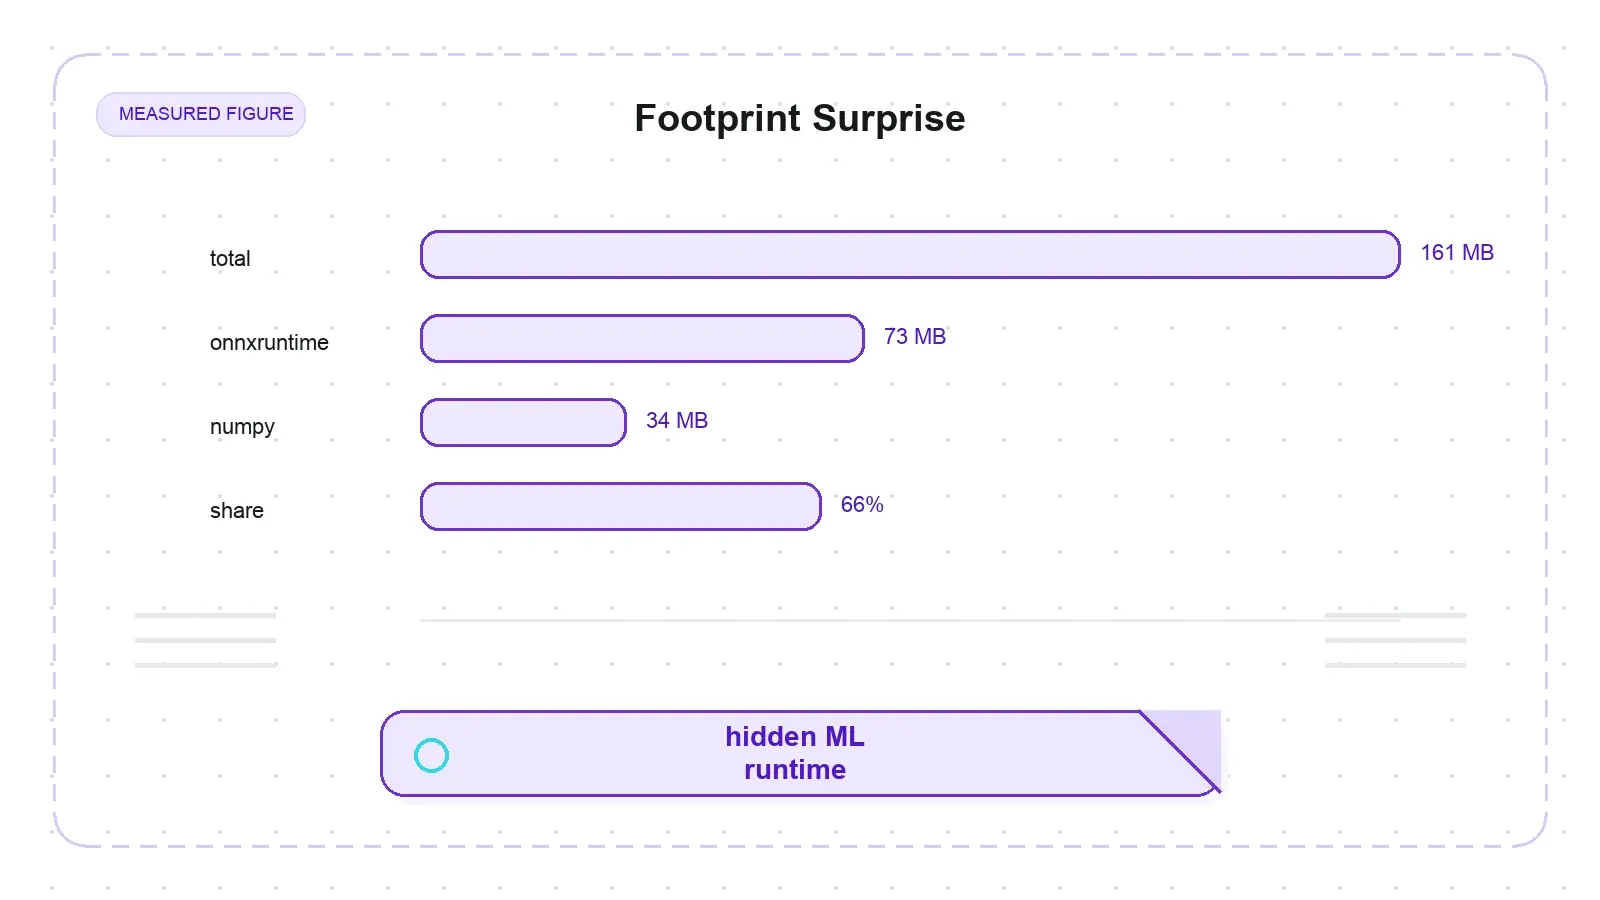
Thứ hai là footprint. Bản cài core nặng 161 MB (một venv trống 13 MB cộng thêm 148 MB). Trong đó, onnxruntime (73 MB) và numpy (34 MB) cộng lại đã chiếm 107 MB — tức 66% toàn bộ footprint core — và cả hai được kéo vào chỉ bởi một dependency cứng: magika, bộ phát hiện loại file ML của Google. Nghĩa là một bộ chuyển văn bản lại mang theo sẵn một ONNX inference runtime 73 MB ngay từ bản cài cơ bản, trước khi bạn thêm bất kỳ extra tài liệu nào. Khi thêm các document extras, venv phình lên 310 MB. So với stack headless browser thì vẫn nhẹ hơn nhiều, nhưng nếu bạn nghĩ đây là một tiện ích “pip install là xong”, thì hãy biết rằng một ONNX runtime đang đi kèm.
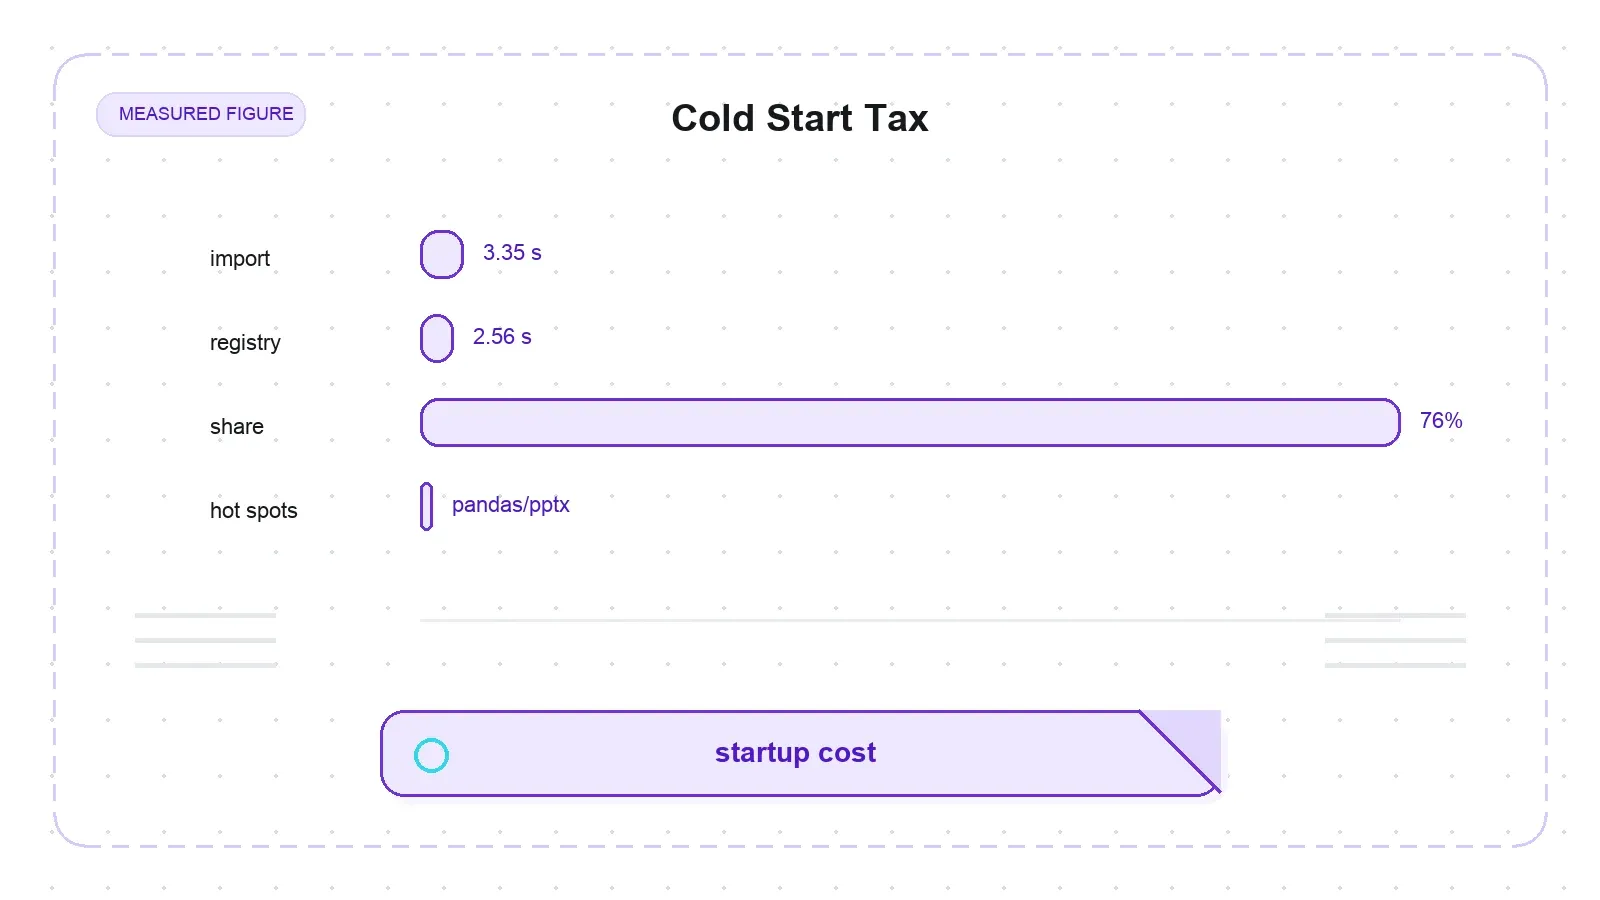
Thứ ba — và đây là phát hiện duy nhất trong cả bộ thử nghiệm của tôi vượt qua mọi kiểm tra tính mới lạ mà tôi chạy — ngay cả sau khi cài sạch, import markitdown vẫn mất khoảng 3,35 giây trên máy này. Phần lớn chi phí nằm ở thời điểm import: markitdown._markitdown chủ động import toàn bộ registry của converter (cộng dồn 2,56 s, chiếm 76% tổng thời gian), kéo theo pandas (1,21 s, qua converter XLSX), python-pptx (427 ms), magika (354 ms) và requests (270 ms) — bất kể bạn có định chuyển những định dạng đó hay không. Với dịch vụ chạy lâu, chi phí này bị khấu hao và gần như không đáng kể. Nhưng với một lần chạy CLI hoặc cold start trên serverless, đây là một khoản thuế theo tiến trình khá thực, và cái nhãn “tiện ích nhẹ” không khiến người ta đoán ra điều đó. (Lưu ý công bằng: đây là một lần đo duy nhất, được xem như một quan sát đơn lẻ chứ không phải phân phối từ nhiều lần chạy.)
Khả năng ở quy mô lớn: không sập, nhưng PDF cần CPU và spreadsheet cần RAM
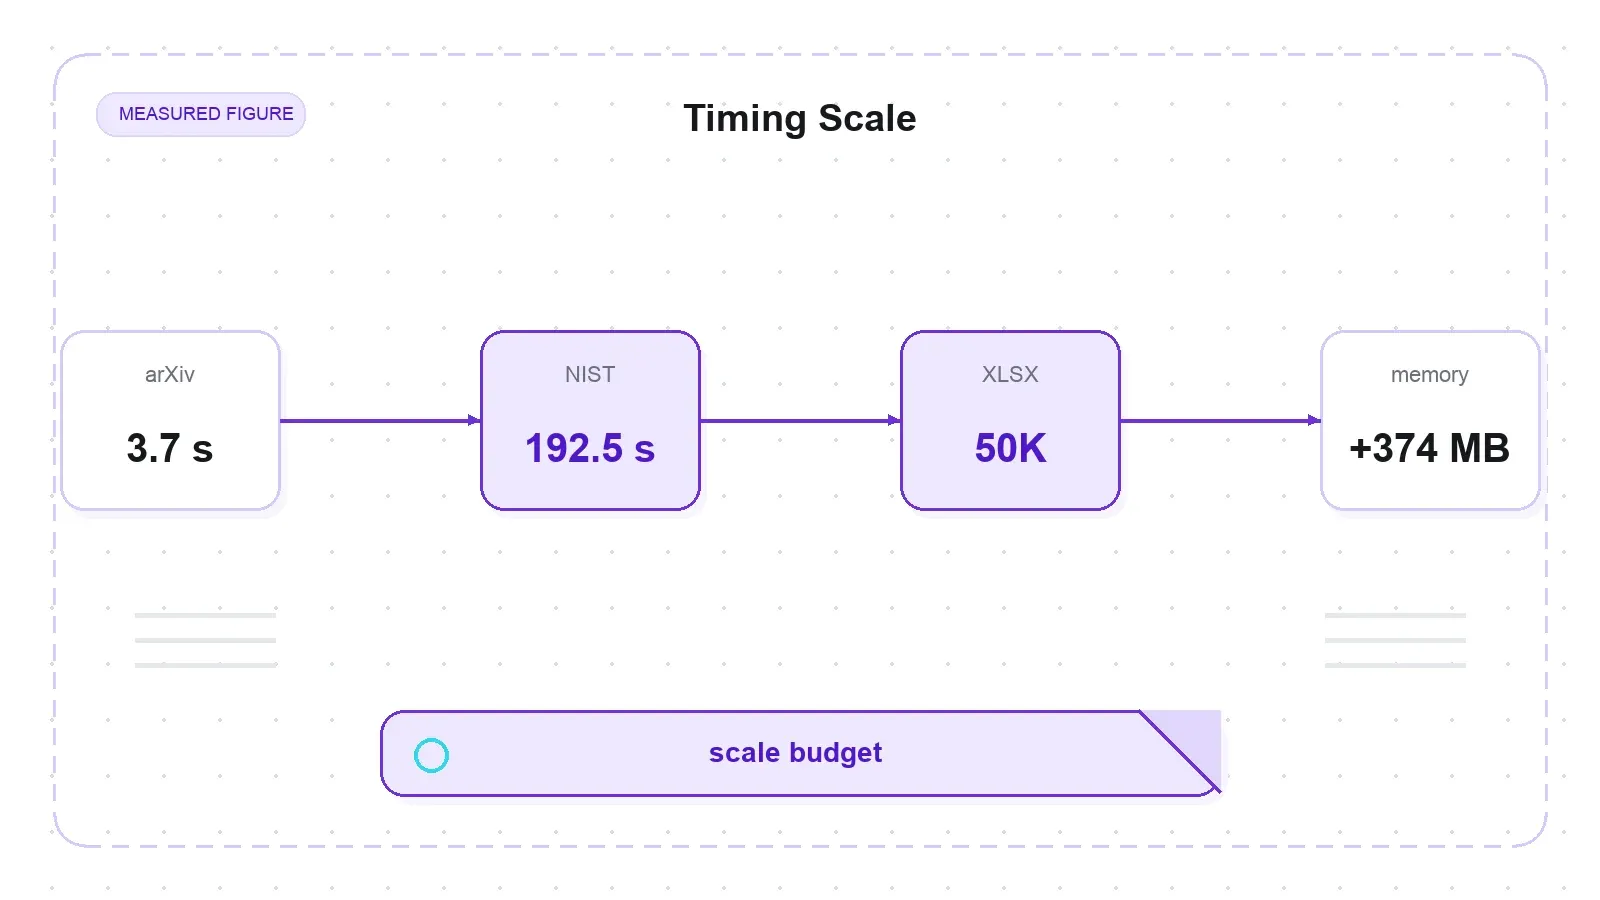
Tôi đẩy bốn chủ thể lớn qua, mỗi lần trong một process riêng để đỉnh RAM không bị ảnh hưởng bởi lần chạy trước. Không có gì bị crash. Nhưng profile chi phí thì khá lệch.
| Chủ thể | Dữ liệu vào | Số ký tự đầu ra | Thời gian median | Đỉnh RSS Δ |
|---|---|---|---|---|
| NIST SP 800-53r5 (PDF 492 trang) | 6.07 MB | 1,625,365 | 192.5 s | +40 MB |
| XLSX 50,000 hàng × 8 cột | 2.1 MB | 3,722,955 | 62.1 s | +374 MB |
| arXiv 1706.03762 (~15 trang PDF) | 2.2 MB | 40,174 | 12.6 s | +25 MB |
| XLSX 200 hàng × 64 cột | 46 KB | 120,129 | 2.9 s | +22 MB |
Bản NIST PDF 492 trang mất median 192,5 giây — khoảng 3,2 phút, hay 0,39 s/trang — vì pdfplumber chạy phát hiện form dựa trên vị trí từ ở mỗi trang. Peak RSS chỉ tăng +40 MB, nên đây là bài toán bị giới hạn bởi CPU chứ không phải RAM. Ngay cả PDF arXiv 15 trang cũng mất 12,6 giây trong process riêng, chậm hơn khoảng 3,4 lần so với 3,7 giây mà cùng file đó thể hiện khi chạy warm trong bộ tài liệu của tôi. Khoảng cách đó là chi phí của process lạnh, và nó xác nhận rằng công việc theo từng trang là yếu tố chi phối, không phải kích thước byte thô. Nếu bạn cần một con số có thể chuyển giao cho riêng PDF đó, hãy dùng 12,6 giây từ process riêng.
Đường xử lý spreadsheet thì ngược lại, nút thắt chuyển sang RAM. Một file XLSX 2,1 MB, 50.000 hàng đã phình lên +374 MB RSS đỉnh (và 3,7 triệu ký tự đầu ra) vì converter tải cả sheet vào bộ nhớ rồi dựng một chuỗi Markdown khổng lồ. Nên lời khuyên thực tế rất thẳng: PDF lớn thì dự trù hàng phút CPU; spreadsheet lớn thì dự trù hàng trăm MB RAM. Đây là số đo trên một máy duy nhất, macOS arm64 và Python 3.14, nên hằng số theo từng trang và từng hàng là đặc thù nền tảng — nhưng hình thái chung (PDF chậm và ngốn CPU, XLSX ngốn bộ nhớ, không sập) là điều có thể mang đi nơi khác.
Thunderbit phù hợp ở đâu — và không phù hợp ở đâu
Dùng thử Thunderbit để trích xuất dữ liệu web
Đây là phần so sánh rất dễ bị nói quá, nên tôi sẽ đặt ranh giới thật cẩn thận. MarkItDown và Thunderbit giải quyết những vấn đề liên quan nhau, chứ không phải cùng một vấn đề.
MarkItDown chuyển đổi các file bạn đã có. Thunderbit lấy trang web trước đã. Endpoint /distill của Thunderbit biến một trang web đang sống thành Markdown sạch, sẵn sàng cho LLM — xử lý luôn việc render JS, chống bot, và nội dung động mà MarkItDown không có cơ chế để làm — còn endpoint /extract trả về JSON có cấu trúc khớp schema, chứ không chỉ Markdown thô. Với developer, các chức năng đó được cung cấp qua API (POST /distill / POST /extract), MCP server, và CLI (npx @thunderbit/thunderbit-cli) chạy trên cùng một AI engine, cũng chính là engine đứng sau extension có hơn 100.000 người dùng.
Vì vậy, chúng chỉ trùng nhau ở đúng một điểm — cả hai đều có thể xuất “Markdown sẵn cho LLM” — nhưng miền đầu vào hoàn toàn khác: Thunderbit distill nhận URL trên web công khai, còn MarkItDown nhận file cục bộ. Chúng không thể thay thế trực tiếp cho nhau, và tôi cũng không định nói như vậy. Một stack thực tế sẽ dùng cả hai: crawl và lấy dữ liệu web bằng Thunderbit (hoặc dịch vụ kiểu Firecrawl), rồi chuẩn hóa các tài liệu local hỗn hợp mà bạn cũng đang có — PDF, slide, spreadsheet — bằng MarkItDown. Một bên lo mạng; bên kia lo ngăn kéo file.
Ưu và nhược điểm
Ưu điểm
- Giữ đầy đủ nội dung body trên HTML sạch (4/4 trang), heading tree và link được bảo toàn trung thực
- Giữ text từ PDF/DOCX rất tốt (arXiv 7/7 probe, Bitcoin 6/6) và không mất nội dung âm thầm trên fixture Office của chính maintainer
- Office Math được giữ dưới dạng LaTeX — một điểm cộng khá đặc thù nhưng rất đáng giá
- Không hề crash ở bất kỳ quy mô nào tôi thử, từ PDF 492 trang đến XLSX 50.000 hàng
- Cách gọi rất đơn giản: CLI,
convert(), pipe stdin, và MCP server tùy chọn - Giấy phép MIT, Microsoft duy trì tích cực, issue tracker phản hồi tốt
Nhược điểm
- Giữ cả boilerplate — lên tới 12,4% dòng chrome trên Wikipedia; không phải công cụ trích xuất bài viết
- Bảng bị vỡ khi có span, bảng lồng, và pipe trong ô (2/13 hỏng, 4/13 bị méo), rowspan còn có thể làm lệch dữ liệu một cách âm thầm
- PDF scan/ảnh chỉ cho ra đầu ra rỗng, không OCR, không báo lỗi
- Đầu ra PDF không có cấu trúc heading nào (khớp với benchmark công khai)
- Bản cài core 161 MB kèm theo ONNX runtime 73 MB; cold import khoảng 3,35 s
- Extra
[all]âm thầm lùi về bản 0.0.2 cách đây hai năm trên Python 3.14
Ai nên dùng, và ai không nên dùng
Hãy dùng MarkItDown nếu bạn đang chuẩn hóa một đống tài liệu local lẫn lộn — Word, Excel, PowerPoint, PDF có text layer — sang Markdown cho pipeline LLM, và bạn quan tâm nhiều hơn đến việc giữ đủ text hơn là giữ nguyên cấu trúc. Là bước chuyển đổi cuối trong batch job, để đưa text sạch vào model, nó nhanh, khá trung thực và miễn phí.
Hãy bỏ qua nó, hoặc dùng kèm công cụ khác, nếu công việc của bạn thuộc một trong các trường hợp sau: bạn chỉ cần phần nội dung chính từ trang web (dùng công cụ readability hoặc kiểu Firecrawl); bạn cần heading và bảng của PDF phải còn nguyên vẹn (đó là sân của Docling hoặc Marker); hoặc đầu vào của bạn có tài liệu scan cần OCR (bạn sẽ cần Azure backend hoặc một công cụ khác hoàn toàn). Và nếu bạn tưởng mình đang đi mua một scraper — thứ có thể fetch và crawl — thì đây hoàn toàn không phải vậy.
Điểm chấm tạm thời tôi chạy trên một rubric kiểu scraper là 60/100, và điểm thấp đó thực ra xuất phát từ việc chấm một converter bằng bài test của một crawler. Trên đúng sân nhà của nó, điểm fidelity text của MarkItDown rất cao; điểm yếu nằm ở cấu trúc (bảng, heading PDF) và packaging (footprint, import, bẫy [all]), chứ không nằm ở chất lượng text. Nếu đánh giá nó đúng với bản chất — một file-to-Markdown converter — thì đây là một công cụ tốt, được duy trì nghiêm túc, chỉ có vài cạnh sắc bạn cần biết trước khi đưa vào production.
Câu hỏi thường gặp
MarkItDown có phải web scraper không?
Không. Nó không có crawler, không render JavaScript, không lần theo link, và không phân trang. Nó chuyển đổi các file và tài liệu bạn đã có sẵn — PDF, DOCX, XLSX, PPTX, ảnh, HTML — sang Markdown. Nếu bạn cần lấy và crawl các trang web đang hoạt động, bạn nên dùng một công cụ scrape như Thunderbit hoặc Firecrawl; còn MarkItDown là bước phía sau, chuyển file đã lấy hoặc file cục bộ thành Markdown sạch.
Vì sao pip install markitdown[all] lại cài bản cũ?
Trên Python 3.14, extra [all] ghim youtube-transcript-api~=1.0.0, trong khi mọi bản trong dải đó đều chỉ hỗ trợ Python dưới 3.14. Resolver không thể thỏa pin này, nên nó âm thầm lùi về markitdown 0.0.2, một bản phát hành cách đây hai năm. Cách sửa là pin version rồi cài từng extra riêng: pip install 'markitdown==0.1.6', sau đó thêm 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Vấn đề này đang được theo dõi tại issue #2179.
MarkItDown có OCR cho PDF scan không?
Không có trong bản cài mặc định. Đường xử lý PDF của nó chỉ làm text extraction, nên PDF chỉ có ảnh và không có text layer sẽ trả về chuỗi rỗng — không lỗi, không cảnh báo. OCR cần Azure Document Intelligence backend tùy chọn hoặc plugin, và cả hai đều không có sẵn theo mặc định. Đây là một khoảng trống đã được theo dõi lâu dài (issue #1268).
MarkItDown xử lý bảng biểu tốt đến đâu?
Về nội dung thì rất tốt — trong bài test 13 trường hợp của tôi, nó giữ 100% nội dung bảng ở mọi case. Về cấu trúc thì còn tùy hình dạng: bảng đơn giản, bảng rộng, bảng không header và bảng có ô trống đều ra lưới GFM sạch sẽ; nhưng rowspan và colspan thì dễ bị méo (rowspan còn có thể làm lệch dữ liệu sang cột sai một cách âm thầm), bảng lồng bị dẹt thành các dòng rác, và ký tự pipe nguyên văn trong ô không được escape. Định dạng bảng phẳng của Markdown đơn giản là không thể biểu diễn span hay nesting.
MarkItDown có đủ nhanh cho tài liệu lớn không?
Nó không bị crash trên file lớn, nhưng bạn cần dự trù tài nguyên theo loại file. Một PDF 492 trang mất khoảng 3,2 phút (xấp xỉ 0,39 s/trang) vì nó phát hiện form theo từng trang, và đây là bài toán CPU-bound. Một spreadsheet 50.000 hàng hoàn tất trong khoảng một phút nhưng dùng thêm +374 MB RAM vì nó dựng cả một chuỗi Markdown lớn trong bộ nhớ. Với PDF lớn, hãy tính bằng phút CPU; với spreadsheet lớn, hãy tính bằng hàng trăm MB RAM.
Dùng thử Thunderbit để trích xuất dữ liệu web Get Started Free




