
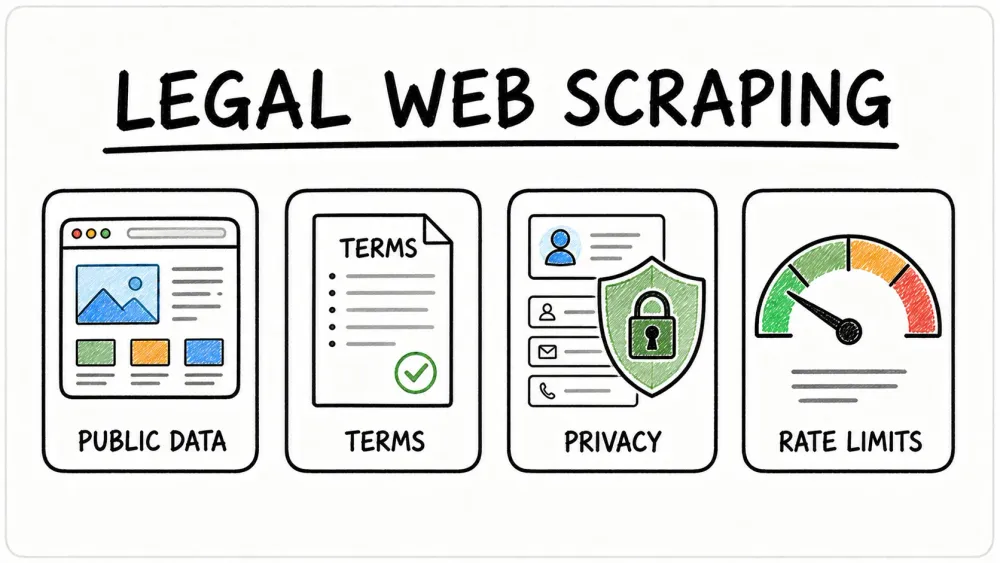
“có hợp pháp khi thu thập dữ liệu từ website không?”—đó gần như là câu hỏi trị giá triệu đô mà tôi nghe từ các đội sales, vận hành và marketing hầu như mỗi tuần. Khi web scraping giờ đây đang hỗ trợ đủ kiểu việc, từ tạo lead đến phân tích đối thủ, thì chuyện ai cũng muốn có một câu trả lời thật rõ ràng là quá dễ hiểu. Nhưng thực tế thì sao? Bức tranh pháp lý vẫn mờ mịt y như một tách cà phê để qua đêm. Chỉ cần nhìn loạt tiêu đề tin tức là đủ thấy: tòa này nói lấy dữ liệu công khai là bình thường, trong khi tòa khác lại cảnh báo về “khai thác dữ liệu trái phép.” Không khó hiểu khi nhiều team cảm thấy lo mình sẽ đi quá giới hạn.
Điều đáng chú ý là hiện nay hơn hai phần ba tổ chức đã dùng web scraping cho phân tích và các dự án AI, và có tới 78% doanh nghiệp thương mại điện tử dựa vào nó để phân tích giá. Nhưng với những vụ kiện đình đám như LinkedIn vs. hiQ Labs, mức độ rủi ro chưa bao giờ cao như bây giờ. Vậy làm sao tận dụng giá trị của dữ liệu web mà không tự đẩy mình vào rắc rối pháp lý? Hãy cùng bóc tách các khung pháp lý, checklist tuân thủ và những best practice mà người dùng doanh nghiệp cần nắm. Và vâng, tôi cũng sẽ chỉ cho bạn cách Thunderbit đang giúp việc scraping đúng chuẩn dễ hơn rất nhiều.
Hiểu Bối Cảnh Pháp Lý: Có Hợp Pháp Khi Thu Thập Dữ Liệu Từ Website Không?
Thử Web Scraper Tuân Thủ của Thunderbit agentic web scraper của Thunderbit tự đọc các trang công khai và trích xuất dữ liệu chỉ với một cú nhấp, được xây dựng cho các team đặt nặng tuân thủ. Get Started Free
Đi thẳng vào vấn đề: tính hợp pháp của web scraping phụ thuộc vào dữ liệu bạn lấy, cách bạn lấy và nơi bạn hoạt động. Không có một đạo luật toàn cầu nào nói thẳng rằng “scraping là hợp pháp” hay “scraping là bất hợp pháp.” Thay vào đó, bạn sẽ phải xử lý một mớ quy định chắp vá—gồm luật chống hack, quy định bảo vệ dữ liệu cá nhân, bản quyền và cả điều khoản sử dụng của website (Thunderbit Blog).
Đây là những yếu tố lớn quyết định dự án scraping của bạn có đi đúng luật hay không:
- Dữ liệu công khai hay riêng tư: Thu thập dữ liệu mở cho mọi người xem (không cần đăng nhập, không có tường phí) thường an toàn hơn. Nếu bạn cố truy cập nội dung phía sau đăng nhập, khả năng cao là bạn đã bước vào vùng rủi ro pháp lý.
- Loại dữ liệu: Dữ liệu cá nhân (như tên, email, hồ sơ mạng xã hội) và nội dung có bản quyền (bài viết, hình ảnh) rủi ro hơn nhiều so với dữ kiện khách quan (giá, thông số sản phẩm, danh bạ doanh nghiệp).
- Mục đích sử dụng: Dùng dữ liệu đã thu thập cho nội bộ (phân tích, nghiên cứu) ít rủi ro hơn nhiều so với việc đăng lại hoặc bán lại.
- Tuân thủ quy tắc website: Vi phạm điều khoản sử dụng của trang hoặc bỏ qua robots.txt có thể khiến bạn gặp rắc rối—ngay cả khi dữ liệu đó là công khai.
- Cách tiếp cận kỹ thuật: Scraping với tốc độ giống người dùng thật và không vượt qua cơ chế bảo vệ (như CAPTCHA hay chặn IP) sẽ an toàn hơn.
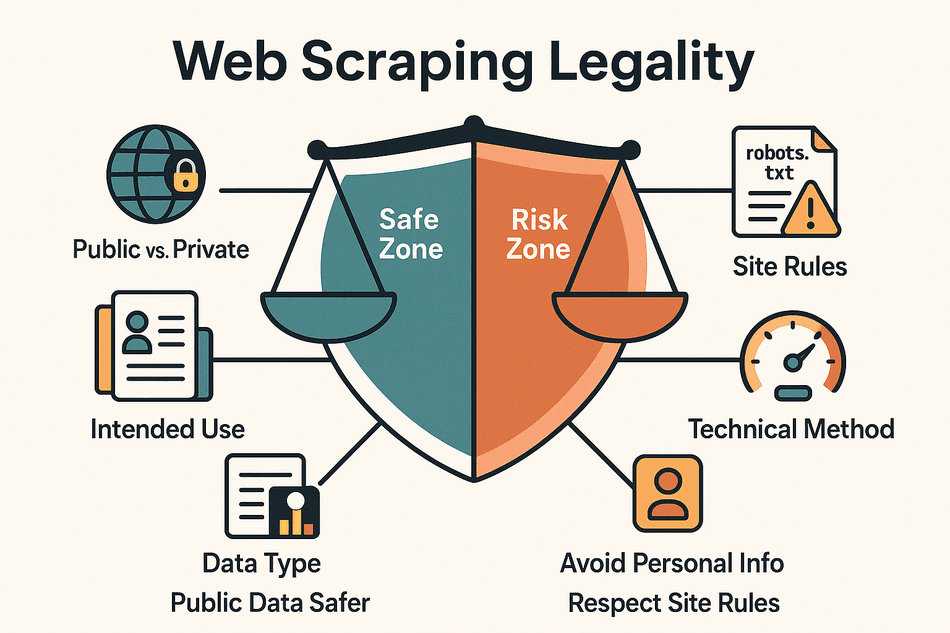
 Tóm lại: thu thập dữ liệu công khai, không mang tính cá nhân để dùng nội bộ thường được chấp nhận ở nhiều khu vực, nhưng vẫn có những ngoại lệ quan trọng—đặc biệt liên quan đến quyền riêng tư, bản quyền và mức độ “mạnh tay” khi scraping (Thunderbit Blog).
Khung Pháp Lý Của Data Scraping: Tổng Quan Các Quy Định Lớn Trên Thế Giới
 Hãy điểm nhanh qua các khung pháp lý chính về web scraping trên thế giới:
Hoa Kỳ: CFAA, Bản Quyền và Hợp Đồng
- Computer Fraud and Abuse Act (CFAA): Đây là luật chống hack, cấm truy cập hệ thống máy tính “không được phép.” Tuy nhiên, tòa án đã làm rõ rằng scraping các website công khai không vi phạm CFAA, vì không có yêu cầu “ủy quyền” nào cần vượt qua (California Lawyers Association).
- Vụ án tiêu biểu: Trong hiQ Labs v. LinkedIn, Tòa Phúc thẩm Khu vực 9 phán quyết rằng việc scraping hồ sơ LinkedIn công khai không vi phạm CFAA. Tuy vậy, LinkedIn vẫn có thể kiện vì vi phạm hợp đồng (vi phạm điều khoản sử dụng) hoặc xâm phạm bản quyền.
- Rủi ro khác: Nếu bạn scrape quá “gắt” (như bot trong vụ eBay v. Bidder’s Edge với 100,000 yêu cầu/ngày), bạn có thể phải chịu trách nhiệm về “trespass to chattels”—hiểu đơn giản là gây cản trở cho máy chủ của người khác (Wikipedia).
Liên minh Châu Âu: GDPR và Quyền Cơ Sở Dữ Liệu
- GDPR: Quy định Bảo vệ Dữ liệu Chung của EU áp dụng cả với dữ liệu cá nhân công khai. Nếu bạn thu thập bất kỳ thông tin nào có thể nhận diện một cá nhân, bạn cần có cơ sở pháp lý (như sự đồng ý hoặc lợi ích hợp pháp) và phải tuân thủ các quy tắc nghiêm ngặt về quyền riêng tư.
- Chỉ thị về Cơ sở dữ liệu: EU cũng bảo vệ cơ sở dữ liệu như một tổng thể. Việc thu thập “một phần đáng kể” của một cơ sở dữ liệu có cấu trúc (ví dụ toàn bộ tin đăng từ một website bất động sản) có thể vi phạm quyền đối với cơ sở dữ liệu—dù từng dữ kiện riêng lẻ không được bảo hộ bản quyền (Thunderbit Blog).
Vương quốc Anh: UK GDPR và Đạo Luật Bảo Vệ Dữ Liệu
- UK GDPR: Sau Brexit, quy định của Anh nhìn chung tương đồng với EU. Scraping dữ liệu công khai, không phải dữ liệu cá nhân thường ổn, nhưng việc thu thập dữ liệu cá nhân bị kiểm soát chặt.
- Computer Misuse Act: Tương tự CFAA, luật này có thể xem việc truy cập trái phép là hành vi phạm tội.
Trung Quốc: PIPL và Luật An Ninh Dữ Liệu
- Personal Information Protection Law (PIPL): Yêu cầu có sự đồng ý khi thu thập dữ liệu cá nhân. Scraping website Trung Quốc để lấy thông tin cá nhân mà không được phép là điều tuyệt đối nên tránh.
- Data Security Law: Được dùng để xử lý các hành vi scraping gây hại cho chủ dữ liệu hoặc tạo ra cạnh tranh không công bằng.
Các Khu Vực Khác
- Canada, Australia, APAC: Phần lớn đều có luật chống hack và quy định về quyền riêng tư tương tự EU/UK. Hãy luôn kiểm tra luật địa phương trước khi scrape.
Điểm mấu chốt: Lựa chọn an toàn nhất là chỉ thu thập dữ liệu công khai, không mang tính cá nhân để dùng nội bộ, và luôn kiểm tra quy định tại khu vực của bạn (Thunderbit Blog).
Checklist Tuân Thủ: Làm Sao Để Đảm Bảo Data Scraping Hợp Pháp?
Trước khi bắt đầu scraping, hãy chạy qua checklist tuân thủ này:
- Đọc Điều Khoản Dịch Vụ của Website: Nếu ToS ghi “không được scraping,” hãy cân nhắc dừng lại hoặc xin phép trước (Thunderbit Blog).
- Chỉ Bám vào Dữ Liệu Công Khai: Đừng lấy nội dung phía sau đăng nhập hay tường phí nếu bạn không có quyền truy cập rõ ràng.
- Kiểm Tra robots.txt: Truy cập
site.com/robots.txtđể xem bot có bị chặn ở phần nào không. Dù không phải ràng buộc pháp lý tuyệt đối, việc tôn trọng nó là phép lịch sự cần thiết. - Tránh Dữ Liệu Cá Nhân: Đừng scrape tên, email hay PII khác nếu bạn chưa có cơ sở pháp lý và kế hoạch bảo vệ quyền riêng tư.
- Không Sao Chép Nội Dung Sáng Tạo: Hãy tập trung vào dữ kiện và điểm dữ liệu. Việc đăng lại bài viết, hình ảnh hoặc các đoạn nội dung lớn có thể kích hoạt khiếu nại bản quyền.
- Dùng API Chính Thức Khi Có: Nếu website có API, hãy dùng nó—vừa an toàn hơn vừa ổn định hơn.
- Scrape Nhẹ Tay: Đừng làm quá tải máy chủ. Hãy scrape với tốc độ gần giống con người và tránh vượt qua các lớp bảo vệ kỹ thuật.
- Ghi Lại Quy Trình: Lưu hồ sơ về bạn đã scrape gì, khi nào và vì sao. Việc này sẽ rất hữu ích nếu sau này phát sinh câu hỏi.
- Sẵn Sàng Dừng Lại: Nếu nhận được thư yêu cầu ngừng (cease-and-desist), hãy dừng scraping ngay và đánh giá lại.
Thực Hành Scraping Tuân Thủ Của Thunderbit: Làm Cho Việc Trích Xuất Dữ Liệu An Toàn Và Đáng Tin Cậy Hơn
Khi chúng tôi xây dựng Thunderbit, yếu tố tuân thủ luôn được đặt lên hàng đầu. Đây là cách Thunderbit giúp bạn đi đúng luật:
- Scraping Dựa Trên Trình Duyệt: Thunderbit chỉ lấy dữ liệu bạn nhìn thấy trong trình duyệt—không gọi API ẩn, không “lách” đăng nhập. Nếu bạn không thấy nội dung đó, Thunderbit cũng không thể scrape nó (Thunderbit Blog).
- Cảnh Báo Tích Hợp: Nếu bạn cố scrape một website có chính sách chống scraping nghiêm ngặt, Thunderbit sẽ bật cảnh báo. Cảm giác như có một chuyên gia tuân thủ đang đứng ngay cạnh bạn.
- Trích Xuất Chỉ Với Một Cú Nhấp: AI của Thunderbit quét trang và đề xuất những trường dữ liệu liên quan nhất—giúp bạn tránh vô tình thu thập dữ liệu nhạy cảm hoặc không cần thiết (Thunderbit Blog).
- Tốc Độ Giống Con Người: Dù scrape cục bộ hay trên cloud, Thunderbit đều điều chỉnh nhịp độ để tránh gây quá tải máy chủ.
- Không Lưu Dữ Liệu Trên Máy Chủ Của Chúng Tôi: Dữ liệu bạn scrape được chuyển thẳng cho bạn—Thunderbit không giữ bản sao, điều này rất có lợi cho việc tuân thủ quyền riêng tư.
- Xuất Dữ Liệu Thân Thiện Với Tuân Thủ: Xuất trực tiếp sang Google Sheets, Excel, Airtable hoặc Notion—rất phù hợp cho mục đích nội bộ.
- Xử Lý Trang Con & Phân Trang: Thunderbit điều hướng website như một người dùng thật, bấm qua các trang và trang con mà không cố “ép” endpoint.
- Lên Lịch Scraping Có Kiểm Soát: Thiết lập lịch scrape theo khoảng thời gian hợp lý, tránh việc dồn dập mỗi phút một lần.
- Hỗ Trợ Đa Ngôn Ngữ: Giao diện Thunderbit hiện có 55 ngôn ngữ trên Chrome Web Store, nên các cảnh báo tuân thủ và gợi ý trường dữ liệu vẫn dễ đọc với các team không dùng tiếng Anh (Chrome Web Store listing).
Tóm lại, Thunderbit “đưa tuân thủ vào ngay trong sản phẩm,” để bạn được dẫn dắt cách scrape có trách nhiệm—ngay cả khi bạn không phải chuyên gia pháp lý (Thunderbit Blog).
Thử Thunderbit để Scraping Tuân Thủ Cài tiện ích Chrome miễn phí của Thunderbit và trích xuất dữ liệu từ bất kỳ trang công khai nào chỉ với một cú nhấp. Get Started Free
Data Scraping So Với Data Reuse: Ranh Giới Pháp Lý Nằm Ở Đâu?
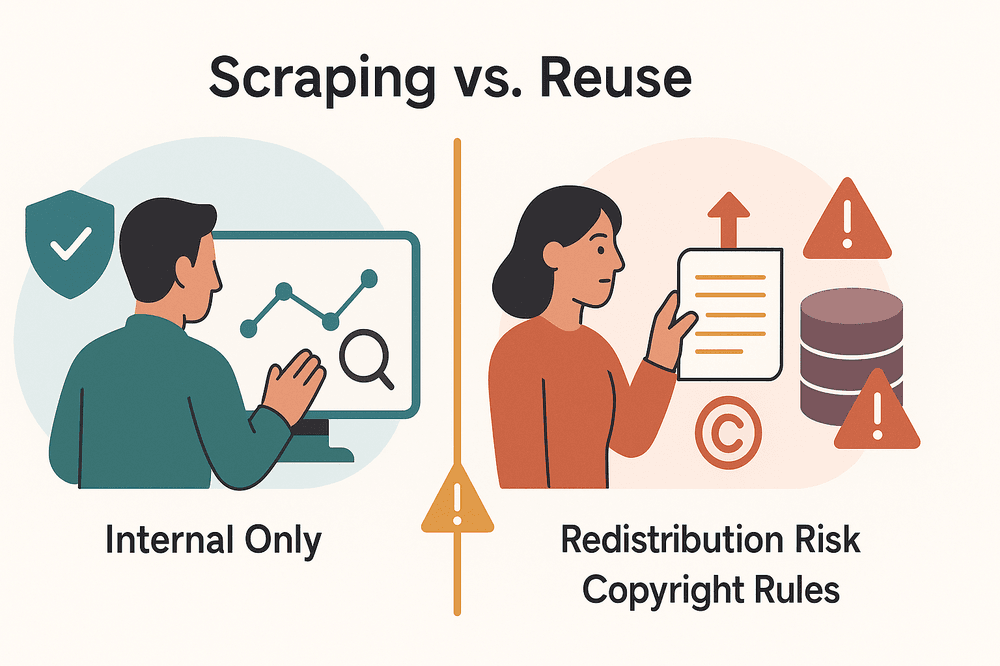 Thu thập dữ liệu cho nội bộ là một chuyện, còn đăng lại, bán lại hay tái sử dụng nó theo cách khác lại là chuyện khác. Đây là lúc ranh giới pháp lý trở nên sắc nét hơn:
- Dùng nội bộ: Thu thập dữ liệu công khai cho phân tích nội bộ (như lead bán hàng hay theo dõi giá) thường an toàn—miễn là bạn không scrape dữ liệu cá nhân hoặc vi phạm luật riêng tư.
- Phân phối lại hoặc bán lại: Đăng lại dữ liệu đã scrape (trên website, trong sản phẩm, hoặc đem bán) có thể dẫn tới khiếu nại về bản quyền, quyền cơ sở dữ liệu hoặc vi phạm hợp đồng.
- Bản quyền & Quyền cơ sở dữ liệu: Ở Mỹ, dữ kiện không được bảo hộ bản quyền, nhưng cách chọn lọc hoặc sắp xếp dữ liệu có thể được bảo vệ. Ở EU/UK, việc lấy “một phần đáng kể” của cơ sở dữ liệu có thể vi phạm quyền cơ sở dữ liệu dạng sui generis.
- Fair Use: Luật Mỹ trong một số trường hợp cho phép “fair use” (như bình luận hoặc phân tích), nhưng chỉ sao chép và dán nguyên khối nội dung gần như không bao giờ được xem là fair use.
- Ghi nguồn: Nếu dùng dữ liệu đã scrape ở nơi công khai, hãy luôn dẫn nguồn—nhưng lưu ý rằng ghi nguồn không tự động khiến hành vi đó hợp pháp nếu bạn đang vi phạm quyền khác.
- Đừng bán dữ liệu thô: Bán nguyên bộ dữ liệu scrape chưa chỉnh sửa là đặc biệt rủi ro. Hãy dùng dữ liệu để tạo ra insight, chứ không phải biến chính dữ liệu đó thành sản phẩm.
Mẹo nhỏ: Hãy dùng dữ liệu scrape cho phân tích nội bộ và ra quyết định. Nếu cần chia sẻ ra ngoài, hãy tổng hợp hoặc chuyển đổi nó, và luôn kiểm tra xem bạn có cần xin phép không (Thunderbit Blog).
Case Study Trong Ngành: Làm Sao Giảm Thiểu Rủi Ro Pháp Lý
Hãy xem một vài vụ việc thực tế—vì không gì dạy về tuân thủ tốt hơn việc nhìn vào những sai lầm của người khác:
LinkedIn vs. hiQ Labs
- Chuyện gì đã xảy ra: hiQ Labs scrape các hồ sơ LinkedIn công khai để xây dựng phân tích về tỷ lệ nghỉ việc của nhân viên. LinkedIn cố chặn họ, nhưng tòa án phán rằng việc scrape dữ liệu công khai không vi phạm CFAA.
- Bài học: Scraping dữ liệu công khai có cơ sở pháp lý tại Mỹ, nhưng bạn vẫn phải chú ý đến điều khoản sử dụng và các khiếu nại về quyền riêng tư (California Lawyers Association).
eBay vs. Bidder’s Edge
- Chuyện gì đã xảy ra: Bidder’s Edge scrape dữ liệu đấu giá của eBay một cách rất mạnh tay (100,000 yêu cầu/ngày), vi phạm điều khoản và robots.txt của eBay. Tòa án ra lệnh cấm vì hành vi “trespass to chattels.”
- Bài học: Ngay cả scraping dữ liệu công khai cũng có thể bất hợp pháp nếu làm quá mức hoặc vi phạm quy tắc rõ ràng của website (Wikipedia).
Facebook (Meta) vs. Power Ventures
- Chuyện gì đã xảy ra: Power Ventures scrape dữ liệu Facebook với sự đồng ý của người dùng, nhưng sau khi Facebook thu hồi quyền truy cập và chặn IP của họ, Power Ventures vẫn tiếp tục scrape. Tòa án xác định đây là “truy cập trái phép.”
- Bài học: Nếu chủ website yêu cầu bạn dừng scraping, bạn phải dừng—nếu không, bạn có thể vi phạm luật chống hack.
Những Câu Chuyện Thành Công Về Tuân Thủ
Nhiều website so sánh giá ở EU hoạt động hợp pháp bằng cách chỉ thu thập dữ liệu mang tính khách quan, tôn trọng quyền từ chối và không scrape toàn bộ cơ sở dữ liệu. Việc không bị kiện cho thấy bám sát dữ liệu công khai, không mang tính cá nhân và tuân thủ quy tắc website là cách làm hiệu quả.
Thunderbit Giúp Như Thế Nào
Cảnh báo tích hợp, giới hạn tốc độ và cách tiếp cận dựa trên trình duyệt của Thunderbit có thể giúp ngăn chặn nhiều sai sót pháp lý kiểu này—bằng cách báo cho người dùng biết website nào có rủi ro và mặc định áp dụng cách scraping lịch sự.
Self-Checklist Tuân Thủ Khi Data Scraping Trong Bối Cảnh Doanh Nghiệp
Đây là checklist tự đánh giá thực tế cho dự án scraping tiếp theo của bạn:
- Dữ liệu có công khai không? (Không cần đăng nhập)
- Điều khoản website nói gì? (Có điều khoản chống scraping không?)
- Bạn đã kiểm tra robots.txt chưa? (Khu vực mục tiêu có bị cấm không?)
- Bạn có đang scrape dữ liệu cá nhân không? (Nếu có, bạn đã có kế hoạch bảo vệ quyền riêng tư chưa?)
- Bạn có scrape một phần lớn của website không? (Tránh lấy cả cơ sở dữ liệu)
- Mục đích của bạn là gì? (Dùng nội bộ = an toàn hơn; tái sử dụng công khai = rủi ro cao hơn)
- Bạn có scrape nhẹ tay không? (Tốc độ giống người dùng thật, không vượt qua rào cản kỹ thuật)
- Bạn đã kiểm tra API chưa? (Nếu có, hãy dùng nó)
- Bạn có sẵn sàng dừng lại nếu được yêu cầu không? (Hãy có phương án cho thư cease-and-desist)
- Bạn sẽ lưu trữ và bảo vệ dữ liệu như thế nào? (Giới hạn quyền truy cập, bảo vệ quyền riêng tư)
- Bạn có ghi lại quy trình không? (Lưu hồ sơ để phục vụ tuân thủ)
Nếu bạn trả lời “không” hoặc chưa chắc chắn ở bất kỳ mục nào, hãy tạm dừng và làm rõ trước khi đi tiếp (Thunderbit Blog).
Quy Trình Mẫu Cho Việc Data Scraping Tuân Thủ Dành Cho Người Dùng Thunderbit
 Hãy cùng đi qua một workflow Thunderbit điển hình, thân thiện với tuân thủ:
- Kiểm tra trước khi scrape: Xem robots.txt và điều khoản sử dụng của website. Không có ngôn ngữ chống scraping? Vậy là có thể bắt đầu.
- Mở Thunderbit: Truy cập trang mục tiêu và khởi chạy Thunderbit Chrome Extension.
- Trích xuất chỉ với một cú nhấp: Để AI của Thunderbit đề xuất các trường dữ liệu phù hợp, không nhạy cảm. Kiểm tra kỹ để chắc rằng không có dữ liệu cá nhân nào được đưa vào, trừ khi bạn có cơ sở pháp lý.
- Tùy chỉnh trường dữ liệu: Điều chỉnh cột và kiểu dữ liệu nếu cần—chỉ thu thập những gì bạn thực sự cần.
- Scrape: Nhấn “Scrape.” Thunderbit sẽ trích xuất dữ liệu với nhịp độ giống người dùng thật, tôn trọng cấu trúc website.
- Scrape trang con: Nếu cần, dùng tính năng subpage của Thunderbit để bổ sung dữ liệu—nhưng vẫn chỉ áp dụng cho thông tin công khai.
- Xuất dữ liệu: Đẩy dữ liệu thẳng sang Google Sheets, Excel, Airtable hoặc Notion để phân tích nội bộ.
- Lên lịch (tuỳ chọn): Thiết lập lịch scrape với khoảng cách hợp lý—không bao giờ quá dày.
- Ghi chép: Lưu lại bạn đã scrape gì, khi nào và vì sao.
Giao diện của Thunderbit sẽ nhắc bạn ở từng bước nếu có yếu tố cần tuân thủ—để bạn không bao giờ phải làm việc trong trạng thái “mò mẫm”.
Tìm Hiểu Thêm Về Các Tính Năng Tuân Thủ Của Thunderbit Gói miễn phí bao gồm 6 trang mỗi tháng, không cần thẻ tín dụng — một cách rủi ro thấp để thử trích xuất trên các trang công khai. Get Started Free
Kết Luận & Khuyến Nghị Chính: Khai Thác Giá Trị Dữ Liệu An Toàn Và Đúng Chuẩn
Web scraping là một công cụ rất mạnh cho tăng trưởng doanh nghiệp—nhưng không phải là cuộc chơi không luật lệ. Bức tranh pháp lý khá phức tạp, nhưng các nguyên tắc cốt lõi lại khá rõ:
- Hãy scrape dữ liệu công khai, không mang tính cá nhân cho mục đích nội bộ bất cứ khi nào có thể.
- Luôn kiểm tra điều khoản website, robots.txt và các quy định liên quan trước khi bắt đầu.
- Tránh thu thập dữ liệu cá nhân hoặc nội dung sáng tạo nếu bạn chưa có cơ sở pháp lý và kế hoạch bảo vệ quyền riêng tư.
- Dùng các công cụ ưu tiên tuân thủ như Thunderbit để dẫn dắt workflow và giảm rủi ro.
- Ghi chép quy trình và sẵn sàng dừng lại nếu được yêu cầu.
Khi biến tuân thủ thành thói quen, bạn có thể khai thác giá trị của dữ liệu web mà không phải lo rắc rối pháp lý. Và nếu bạn muốn thấy việc scraping đúng chuẩn dễ đến mức nào, hãy thử Thunderbit. Đội pháp lý của bạn (và chính bạn trong tương lai) sẽ biết ơn bạn.
Để tìm hiểu sâu hơn về web scraping, tuân thủ và tự động hóa, hãy xem Thunderbit Blog.
Thử Agentic Web Scraper để Trích Xuất Dữ Liệu Tuân Thủ Get Started Free
Câu Hỏi Thường Gặp
1. Có hợp pháp khi thu thập dữ liệu từ bất kỳ website nào không?
Không phải lúc nào cũng vậy. Thu thập dữ liệu công khai, không mang tính cá nhân để dùng nội bộ thường hợp pháp ở nhiều khu vực, nhưng scraping dữ liệu cá nhân, nội dung có bản quyền hoặc dữ liệu phía sau đăng nhập có thể rất rủi ro, thậm chí bất hợp pháp. Luôn kiểm tra điều khoản của website và luật địa phương trước khi scrape (Thunderbit Blog).
2. Khác nhau giữa scraping và tái sử dụng dữ liệu là gì?
Scraping là hành động thu thập dữ liệu; tái sử dụng là xuất bản, bán hoặc phân phối dữ liệu đó theo cách khác. Dùng nội bộ an toàn hơn nhiều. Việc đăng lại hoặc bán dữ liệu đã scrape có thể dẫn tới khiếu nại về bản quyền, quyền cơ sở dữ liệu hoặc vi phạm hợp đồng (Thunderbit Blog).
3. Thunderbit giúp đảm bảo tuân thủ như thế nào?
Thunderbit chỉ lấy những gì hiển thị trên trình duyệt, cảnh báo bạn về các website có rủi ro, gợi ý trường dữ liệu liên quan (không nhạy cảm), và điều chỉnh nhịp yêu cầu để không làm quá tải máy chủ. Công cụ này cũng không lưu dữ liệu của bạn, và các tùy chọn xuất dữ liệu được thiết kế cho mục đích sử dụng nội bộ (Thunderbit Blog).
4. Tôi nên làm gì nếu nhận được thư yêu cầu ngừng?
Hãy dừng scraping ngay và xem xét lại dự án. Tiếp tục sau khi đã có yêu cầu ngừng trực tiếp có thể biến vùng xám pháp lý thành vi phạm rõ ràng các luật chống hack hoặc điều khoản hợp đồng (Thunderbit Blog).
5. Tôi có thể scrape dữ liệu cá nhân nếu nó công khai không?
Không, nếu không có cơ sở pháp lý phù hợp. Các luật về quyền riêng tư như GDPR và CCPA vẫn áp dụng với dữ liệu cá nhân công khai. Bạn sẽ cần sự đồng ý hoặc một cơ sở lợi ích hợp pháp đủ mạnh, đồng thời phải xử lý dữ liệu một cách có trách nhiệm (Thunderbit Blog).
Hướng dẫn này chỉ nhằm mục đích cung cấp thông tin và không cấu thành tư vấn pháp lý. Với các dự án phức tạp hoặc có rủi ro cao, hãy tham khảo luật sư đủ năng lực, am hiểu về dữ liệu và luật bảo mật tại khu vực của bạn.
Đọc Thêm




