
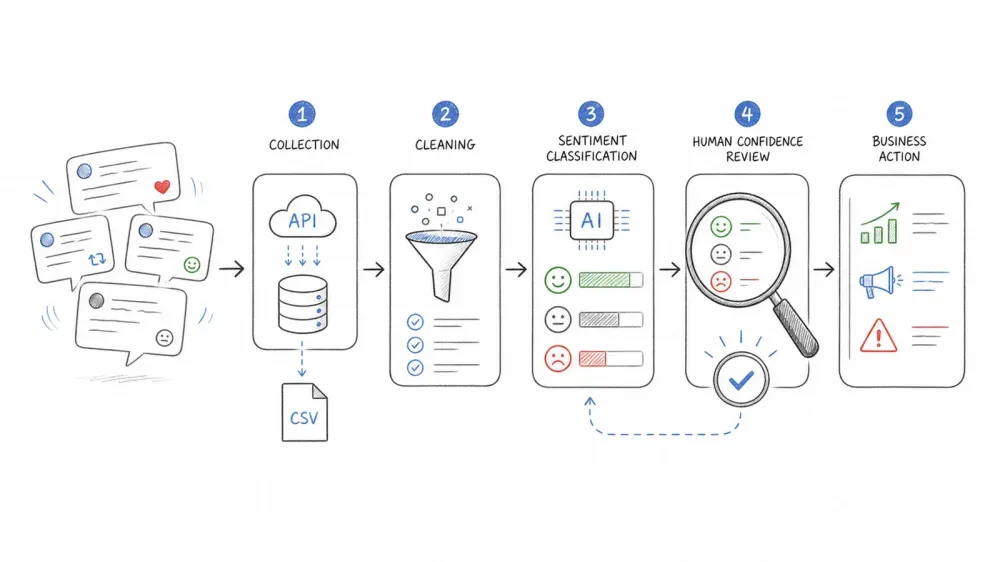
Mở một bảng tính với 300 bài đăng thô là bạn sẽ thấy ngay vấn đề: sao chép, dán, đọc, nheo mắt, đoán, lặp lại — và cuối cùng bạn vẫn có thể không biết chính xác người dùng đang thích hay ghét màn ra mắt mà bạn đang theo dõi.
Chính kiểu bế tắc đó là lý do phân tích cảm xúc ra đời. Nhưng có một vấn đề: phần lớn các bài hướng dẫn về chủ đề này vẫn dừng ở năm 2022. Chúng giả định rằng còn có quyền truy cập API miễn phí, đề xuất những mô hình bị “nghẹn” trước sự mỉa mai và emoji, và bỏ qua các bước tiền xử lý vốn mới là thứ quyết định kết quả của bạn có đáng tin hay không. Tôi đã dành rất nhiều thời gian trong thế giới SaaS và tự động hóa (bao gồm cả việc xây dựng Thunderbit), và đã chứng kiến bức tranh phân tích cảm xúc thay đổi mạnh mẽ. Cách tiếp cận trung thực, cập nhật cần bao gồm cả quy trình bằng Python lẫn no-code, với phương pháp thu thập dữ liệu và mô hình phản ánh đúng thực tế của năm 2026.
Phân tích cảm xúc Twitter/X là gì?
Phân tích cảm xúc Twitter/X là quá trình tự động phân loại các bài đăng trên X thành tích cực, tiêu cực hoặc trung tính dựa trên nội dung chữ, emoji và ngữ cảnh. Có thể hiểu đơn giản đây là việc dạy cho máy cách đọc một tweet và trả lời: “Người này đang vui, đang bực, hay nằm đâu đó ở giữa?”
Tuy nhiên, phân tích cảm xúc khác với social listening nói chung. Social listening tập trung vào việc theo dõi mọi người đang bàn về điều gì — chủ đề, xu hướng, mức độ thảo luận. Còn phân tích cảm xúc là lớp chấm điểm và phân loại nằm bên trên: nó cho biết họ cảm thấy thế nào về điều họ đang nói. Khái niệm này có gốc rễ từ ngôn ngữ học tính toán và nghiên cứu khai phá quan điểm đã tồn tại hàng chục năm, nhưng chỉ vài năm gần đây mới thực sự trở thành công cụ phổ biến trong kinh doanh.
Có một số mức phân loại thường gặp:
- Nhị phân: Tích cực hoặc tiêu cực (đơn giản nhất nhưng mất nhiều sắc thái)
- Ba mức: Tích cực, trung tính hoặc tiêu cực (phổ biến nhất)
- Chi tiết hơn: Rất tích cực → rất tiêu cực (hữu ích cho nghiên cứu và theo dõi thương hiệu chuyên sâu)
Ngoài ra còn có những tác vụ liên quan nhưng khác nhau, như nhận diện cảm xúc (tức giận, buồn, vui), phát hiện lập trường (ủng hộ hay phản đối một quan điểm), phân tích cảm xúc theo khía cạnh (người dùng nghĩ gì về giá so với chất lượng), và phát hiện mỉa mai/châm biếm. TweetEval benchmark xem đây là các tác vụ riêng biệt, và điều đó hoàn toàn có lý: một điểm cảm xúc duy nhất không thể trả lời mọi câu hỏi kinh doanh. Nếu bạn đang theo dõi một đợt ra mắt sản phẩm, có lẽ bạn sẽ muốn phân tích cảm xúc theo khía cạnh (“thích camera, ghét pin”). Nếu bạn đang giám sát một khủng hoảng, bạn cần cảm xúc và khối lượng thảo luận, chứ không chỉ là tính tích cực/tiêu cực.
Vì sao phân tích cảm xúc Twitter/X quan trọng với doanh nghiệp?
X được xây dựng quanh các cuộc trò chuyện theo thời gian thực, nên phản ứng với sự kiện ra mắt, chương trình trực tiếp và tin nóng có thể tăng vọt rất nhanh. Với doanh nghiệp, tốc độ đó chính là giá trị cốt lõi. Phân tích cảm xúc biến dòng văn bản phi cấu trúc thành dữ liệu có cấu trúc để đội ngũ có thể xem xét và hành động.
Các trường hợp sử dụng phổ biến thường gồm:
| Trường hợp sử dụng | Nhóm phụ trách | Kết quả kinh doanh |
|---|---|---|
| Theo dõi danh tiếng thương hiệu | PR, Marketing | Phát hiện làn sóng tiêu cực trước khi nó bùng lên |
| Phản hồi từ lần ra mắt sản phẩm | Product, Marketing | Biết điều gì hiệu quả và điều gì chưa hiệu quả theo thời gian thực |
| So sánh với đối thủ | Chiến lược, Marketing | Đối chiếu mức độ cảm nhận thương hiệu với đối thủ trong cùng khung thời gian |
| Phát hiện khủng hoảng | PR, Vận hành | Kích hoạt rà soát thủ công khi lượng tiêu cực tăng đột biến |
| Hiệu quả chiến dịch | Marketing | Đo sự thay đổi cảm xúc theo nội dung sáng tạo, kênh hoặc thời điểm |
| Cảm xúc thị trường/chứng khoán | Tài chính, Nghiên cứu | Theo dõi tâm lý công chúng quanh báo cáo lợi nhuận, sự kiện hoặc chính sách |
| Nghiên cứu chính trị và chính sách | Nghiên cứu, Chính phủ | Đánh giá ý kiến công chúng ở quy mô lớn |
Để cụ thể hơn: bản tóm tắt Super Bowl 2026 của X ghi nhận 16 triệu bài đăng từ 4 triệu tác giả, 5 tỷ lượt hiển thị và 605 triệu lượt xem video quanh một sự kiện duy nhất — với một nửa cuộc thảo luận diễn ra theo thời gian thực. Ở quy mô đó, đọc thủ công là bất khả thi và chấm điểm cảm xúc tự động trở nên thiết yếu.
Và vấn đề không chỉ nằm ở số lượng. Phương pháp BrandRanx của X kết hợp volume, mức độ tương tác và cảm xúc — cho thấy sentiment hiệu quả nhất khi đi cùng các tín hiệu khác, chứ không nên dùng đơn lẻ.
Kết luận ngắn gọn: nếu đội ngũ của bạn đưa ra quyết định dựa trên nhận thức công chúng — về sản phẩm, thương hiệu, chiến dịch hay khủng hoảng — thì phân tích cảm xúc trên dữ liệu X là một trong những vòng phản hồi nhanh nhất hiện có.
Thực tế API X năm 2026: Lấy dữ liệu tweet thế nào cho đúng?
Đây là chỗ mà phần lớn hướng dẫn bị “vỡ”. Nếu bạn từng làm theo một bài dùng Tweepy, dán code vào rồi gặp paywall hoặc lỗi khó hiểu, bạn không hề đơn độc. Các gói Free / Basic / Pro cũ đã không còn nữa. API của X hiện chuyển sang mô hình trả theo mức sử dụng với credit nạp trước, tính phí theo từng endpoint và có theo dõi sử dụng theo thời gian thực.
So sánh thẳng thắn giữa các cách thu thập dữ liệu hiện tại:
| Phương pháp | Chi phí (2026) | Quy mô | Trình độ | Ghi chú |
|---|---|---|---|---|
| X API v2 (trả theo mức dùng) | $0.005/lượt đọc Post | Tối đa 2 triệu lượt đọc Post/tháng (self-serve) | Trung cấp (Python) | Chính thức, có thể tái lập, tuân thủ |
| Full-Archive Search | $0.005 cho mỗi Post trả về; $0.010 cho mỗi yêu cầu đếm full-archive | Trở về đến tháng 3/2006 | Trung cấp–Nâng cao | Dành cho gói pay-per-use và Enterprise |
| Filtered Stream | Tính phí lượt đọc Post khi được phân phối | Thời gian thực, liên tục | Trung cấp–Nâng cao | Phù hợp nhất cho thu thập trực tiếp |
| Bộ dữ liệu có sẵn (Kaggle, Sentiment140) | $0 | Tĩnh, chỉ dùng cho lịch sử | Người mới | Học tập rất tốt, nhưng không phù hợp để phân tích trực tiếp |
| snscrape, Twint, Twikit, v.v. | $0 | Không ổn định / hay hỏng | Nâng cao | snscrape không còn hoạt động với tìm kiếm X từ năm 2023; Twint đã lưu trữ; Twikit dùng phương thức không chính thức |
| Kho lưu trữ X của chính bạn | $0 | Chỉ bài đăng của bạn | Người mới | Hữu ích cho phân tích cá nhân |
Một vài điểm cần biết:
- Các gói Free/Basic/Pro cũ đã biến mất. Đừng làm theo bất kỳ hướng dẫn nào còn xem chúng là hiện tại.
- snscrape không còn dùng được cho X. Người bảo trì đã xác nhận từ năm 2024 rằng việc cào tìm kiếm Twitter không còn hoạt động. Twint đã được lưu trữ. Twikit dùng scraping và cookie không chính thức — có hoạt động không đồng nghĩa với được phép.
- Điều khoản của X cấm scraping bằng trình duyệt nếu không có sự đồng ý bằng văn bản trước. Nghĩa là Selenium, Playwright và các tiện ích mở rộng trình duyệt không phải là cách thay thế tuân thủ cho API X.
X API v2: Bạn thực sự nhận được gì?
Một lượt đọc Post tiêu chuẩn có giá $0.005 cho mỗi Post được trả về. Lượt đọc user là $0.010 mỗi lần. Vì vậy, 10.000 lượt đọc Post duy nhất sẽ vào khoảng $50, chưa tính các chi phí tài nguyên khác. Mức self-serve tối đa là 2 triệu lượt đọc Post mỗi tháng. Mức giá có thể thay đổi — hãy luôn kiểm tra Developer Console.
Với công việc sentiment, bạn cần nhiều hơn id và text. Một schema tối thiểu hữu ích nên bao gồm created_at, lang, author_id, conversation_id, referenced_tweets, entities, context_annotations và public_metrics. Hãy lưu response gốc và một bản ghi bất biến của truy vấn, endpoint, khung giờ UTC và pagination token. Nếu không có những thứ đó, tập dữ liệu của bạn sẽ không thể tái lập.
Một điểm mới nữa: đợt chuyển đổi search-index ngày 4/5/2026 của X đã làm thay đổi corpus quan sát được. Tìm kiếm REST bằng từ khóa không còn trả về repost, trong khi Filtered Stream thì không đổi. Nếu bạn so sánh kết quả trước và sau thời điểm đó, có thể bạn đang đếm trên những quần thể khác nhau.
Bộ dữ liệu có sẵn: Tốt cho học tập, không phải cho phân tích trực tiếp
Sentiment140 (1,6 triệu tweet, gán nhãn theo distant supervision) và nhiều bộ dữ liệu Kaggle khác đều miễn phí và rất hữu ích cho học tập, benchmark. Nhưng Sentiment140 được thu thập từ năm 2009. Phần sentiment của TweetEval dùng dữ liệu SemEval giai đoạn 2013–2016. Chúng không thể chứng minh mô hình của bạn hoạt động tốt với ngôn ngữ, tiếng lóng hay sự kiện của năm 2026.
Lưu ý về Thunderbit và dữ liệu X
Tôi muốn nói rõ, vì chính chúng tôi đã xây dựng Thunderbit: Thunderbit là công cụ web scraping và tự động hóa bằng AI, hoạt động trên nhiều website tương thích. Nhưng điều khoản hiện tại của X cấm scraping bằng trình duyệt nếu không có sự đồng ý. Vì vậy, tôi sẽ không giới thiệu Thunderbit như một cách lách chi phí hay quyền truy cập API của X — như vậy sẽ gây hiểu nhầm. Với dữ liệu X, hãy dùng API chính thức, nhà cung cấp được ủy quyền, hoặc kho lưu trữ tài khoản của chính bạn. Thunderbit phù hợp ở bước phía sau trong quy trình sentiment: tổ chức, gắn nhãn và xuất dữ liệu bạn đã thu thập qua con đường được phép. Phần đó tôi sẽ nói kỹ hơn ở bên dưới.
Chọn mô hình sentiment phù hợp: VADER vs. TextBlob vs. RoBERTa
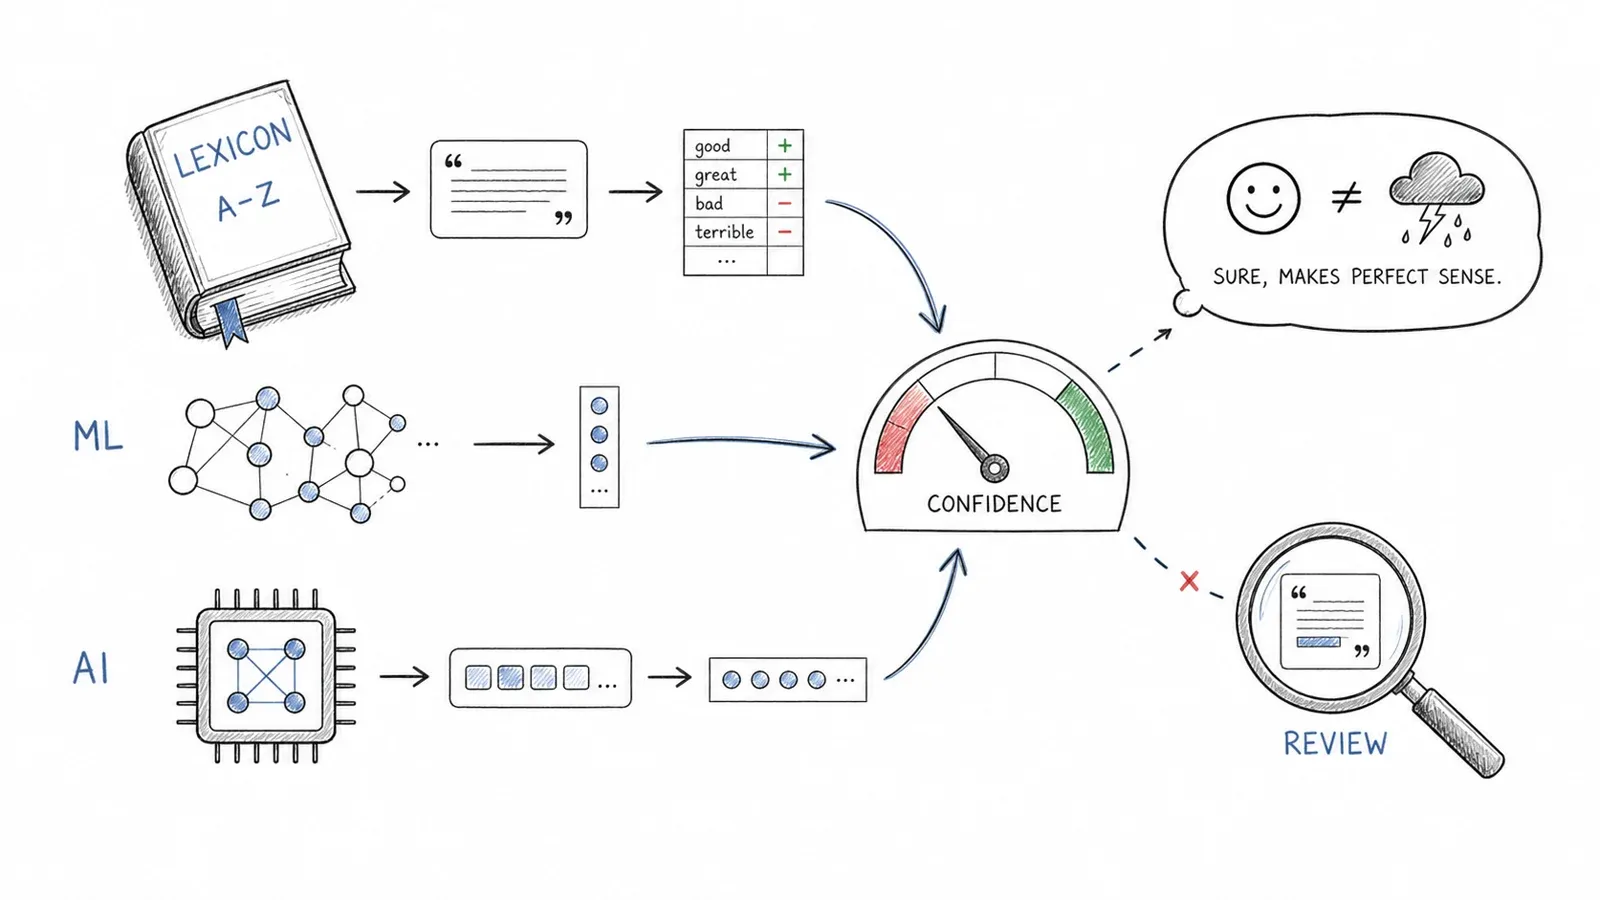
Mô hình bạn chọn quan trọng hơn nhiều so với những gì đa số bài hướng dẫn thừa nhận. Và khoảng trống lớn nhất ở các hướng dẫn cạnh tranh là gần như không ai nói về các mô hình transformer đã được fine-tune trên tweet — trong khi đây lại là nơi chứa những baseline mạnh nhất hiện nay.
Dưới đây là so sánh trực tiếp. Tôi cố ý không đưa các con số F1 “chung cho mọi trường hợp” vào bảng, vì điểm số thay đổi theo bộ dữ liệu, cách chia, định nghĩa nhãn, giai đoạn thời gian và metric. Thay vào đó, tôi sẽ mô tả hiệu năng tương đối và chỉ bạn đến các benchmark để tự kiểm chứng.
| Mô hình / Thư viện | Cách tiếp cận | Xử lý mỉa mai tốt không? | Xử lý tiếng lóng/emoji tốt không? | Độ chính xác tương đối với tweet | Độ phức tạp thiết lập |
|---|---|---|---|---|---|
| VADER (NLTK) | Từ điển luật | Yếu | Có hỗ trợ một phần emoji | Thấp nhất | Rất thấp |
| TextBlob | Dựa trên pattern | Yếu | Không | Thấp hơn | Rất thấp |
| Naive Bayes / Logistic Regression (TF-IDF) | ML cổ điển | Không | Không | Trung bình | Trung bình |
| CardiffNLP RoBERTa | Transformer (fine-tune trên tweet) | Tốt hơn (nhưng không hoàn hảo) | Có | Cao nhất trong nhóm này | Trung bình (HuggingFace pipeline) |
VADER: Nhanh, đơn giản nhưng có giới hạn
VADER là phương pháp từ điển dựa trên luật, được tạo ra cho văn bản xã hội. Nó nhanh, dễ hiểu, không cần dữ liệu huấn luyện, và xử lý được một phần emoji cùng emoticon. Nó tính đến phủ định, từ tăng giảm mức độ, dấu câu và viết hoa. Nếu bạn cần một baseline nhanh gọn, hoặc khi tính toán và tính minh bạch là quan trọng, VADER rất hữu ích. Điểm yếu của nó là: mỉa mai, tiếng lóng, nghĩa phụ thuộc ngữ cảnh, và mọi thứ đòi hỏi hiểu biết vượt ra ngoài từng từ đơn lẻ. Ngưỡng điểm compound mặc định của nó (≥0.05 = tích cực, ≤-0.05 = tiêu cực) chỉ là mặc định, không phải ngưỡng kinh doanh phổ quát — hãy tinh chỉnh trên tập kiểm định của riêng bạn.
TextBlob: Còn đơn giản hơn, cũng giới hạn hơn
TextBlob là một baseline giáo dục rất nhỏ gọn. PatternAnalyzer mặc định của nó không được huấn luyện trên kiểu văn bản như tweet. Nó hữu ích cho thử nghiệm NLP đầu tiên, nhưng không phù hợp để phân tích tweet trong môi trường sản xuất.
ML cổ điển: Naive Bayes, Logistic Regression, SVM
Một pipeline TF-IDF theo từ và ký tự kết hợp với logistic regression hoặc LinearSVC vẫn là một baseline có giám sát rất đáng giá. Nó rẻ, dễ hiểu và thường cho thấy transformer có thật sự mang lại đủ giá trị để bù cho độ phức tạp hay không. Quy tắc quan trọng: chỉ fit vectorizer sau khi đã chia train/validation để tránh rò rỉ từ vựng và IDF.
Những mô hình này vượt trội hơn cách tiếp cận dựa trên luật trên các bộ dữ liệu gán nhãn lớn, nhưng vẫn bỏ sót ngữ cảnh, mỉa mai và tiếng lóng.



