
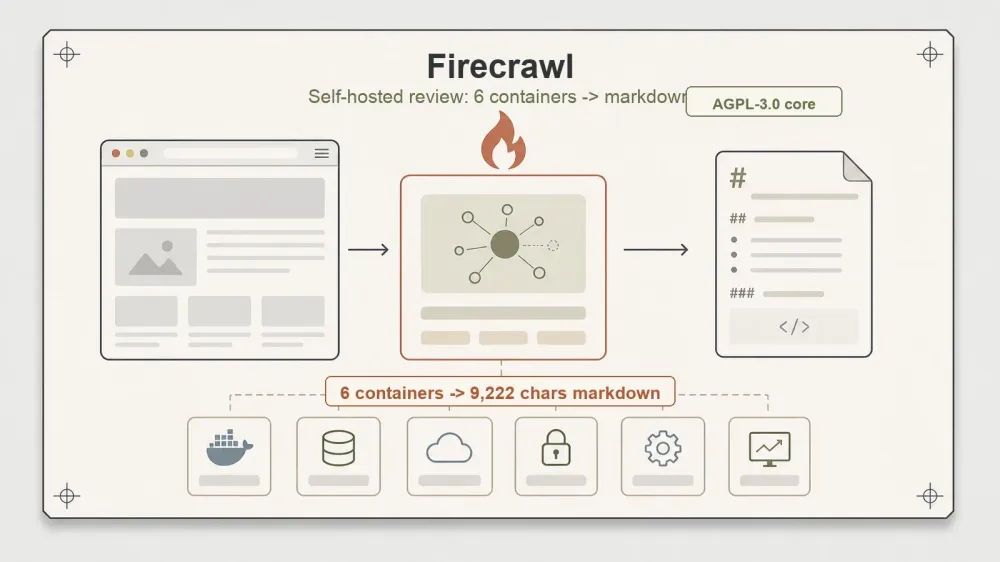
Hầu hết mọi người thường nghĩ Firecrawl là một thư viện scraping – kiểu công cụ mà bạn chỉ cần pip install, viết vài dòng code là xong. Nhưng thực tế không phải vậy, và việc hiểu rõ sự khác biệt này cực kỳ quan trọng trước khi bạn bắt đầu gõ bất kỳ lệnh nào. Firecrawl tự host không phải là một thư viện để bạn import; nó là một dịch vụ mà bạn phải tự vận hành, và để triển khai nó, bạn cần chạy sáu container Docker giao tiếp với nhau.
Tôi đã thử chạy stack tự host này trên máy Mac (arm64, Docker qua colima) mà không cần dùng đến khóa đám mây. Tôi trỏ điểm cuối /v1/scrape của nó vào một vài trang web demo thân thiện với scraping và quan sát kết quả. Tóm lại: lời hứa cốt lõi đã được thực hiện – một trang web được đưa vào, và một file Markdown sạch sẽ, sẵn sàng cho LLM được xuất ra – nhưng việc thiết lập lại là công đoạn nặng nề nhất so với bất kỳ công cụ nào tôi từng thử nghiệm trong nghiên cứu này. Đây chỉ là một cái nhìn sơ bộ, chưa phải là đánh giá cuối cùng, và tôi sẽ nói rõ những gì tôi đã và chưa thử nghiệm.
Firecrawl là một Dịch vụ, không phải một Thư viện
Đây là điều đầu tiên bạn cần thay đổi trong cách suy nghĩ. Các công cụ scraping mà hầu hết các nhà phát triển sử dụng là thư viện: bạn thêm một dependency, gọi một hàm, và nhận lại HTML hoặc dữ liệu đã được phân tích cú pháp trong quy trình của riêng bạn. Firecrawl tự host lại là một kiểu khác. Nó là một nền tảng đang chạy với API riêng, và bạn giao tiếp với nó qua HTTP.
Vị trí chính thức của nó là "API để tìm kiếm, scraping và tương tác với web ở quy mô lớn," và sản phẩm thực tế đúng là như vậy – các trang web được đưa vào, và Markdown sạch hoặc dữ liệu có cấu trúc được xuất ra. Khi bạn tự host, bạn không liên kết với Firecrawl. Bạn đang khởi động một stack docker compose và truy cập một điểm cuối, giống như cách bạn truy cập bất kỳ microservice nội bộ nào.
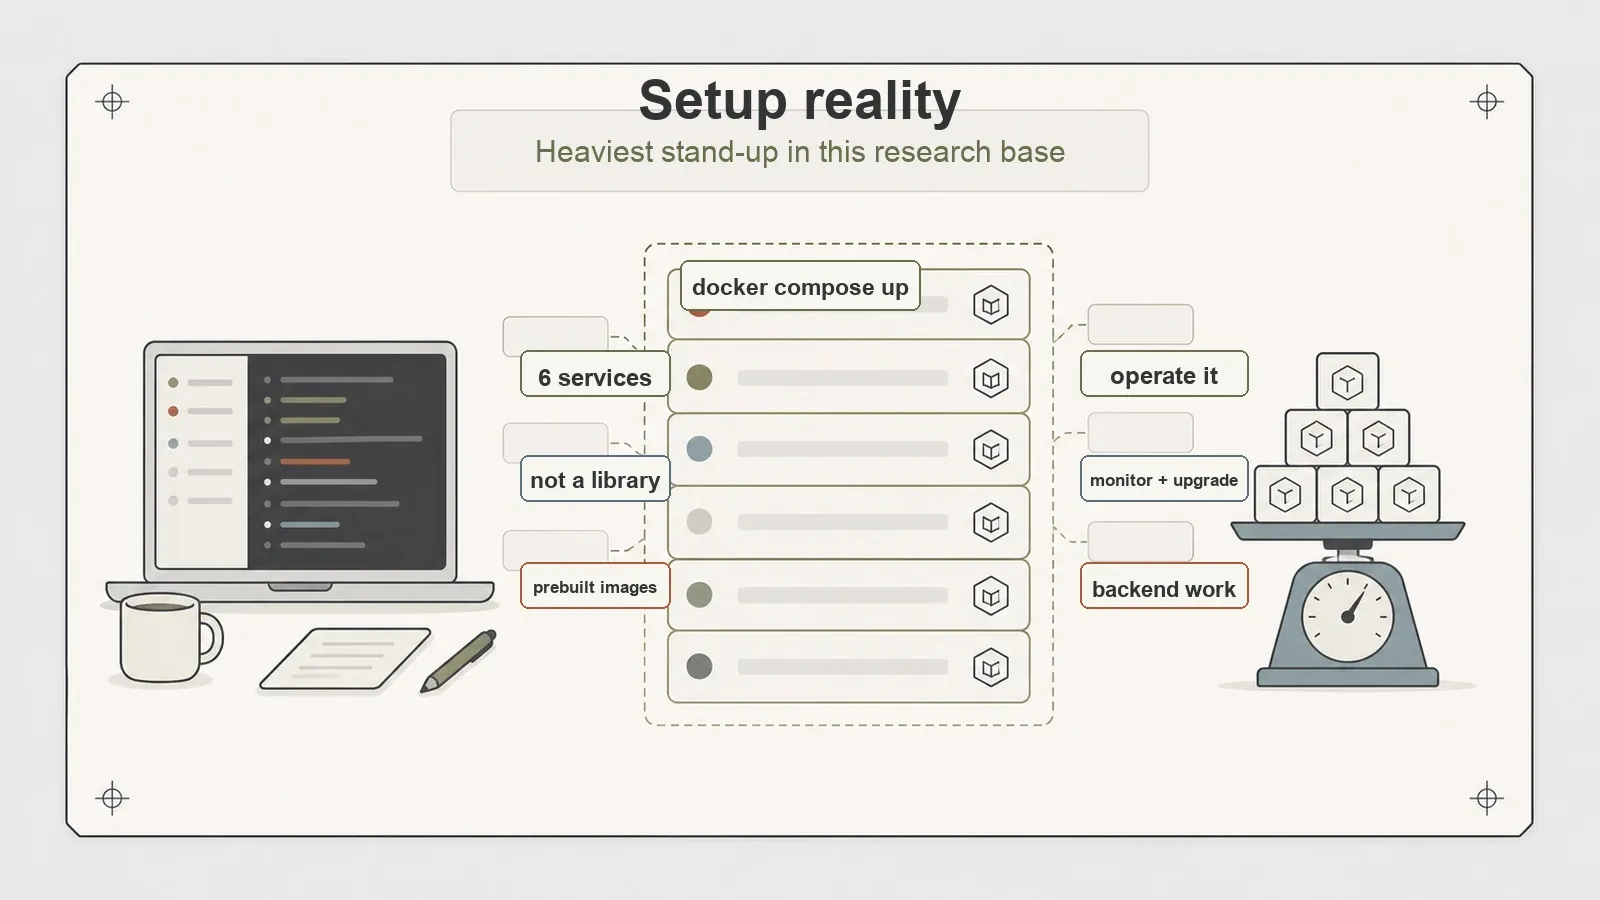
Stack tôi đã chạy bao gồm sáu dịch vụ:
- api — giao diện HTTP mà bạn thực sự gọi
- playwright-service — một trình duyệt không giao diện người dùng để hiển thị JavaScript
- redis — hàng đợi và bộ nhớ đệm
- rabbitmq — bộ môi giới tin nhắn
- nuq-postgres — một phiên bản Postgres để lưu trữ trạng thái công việc
- foundationdb — lưu trữ khóa-giá trị phân tán
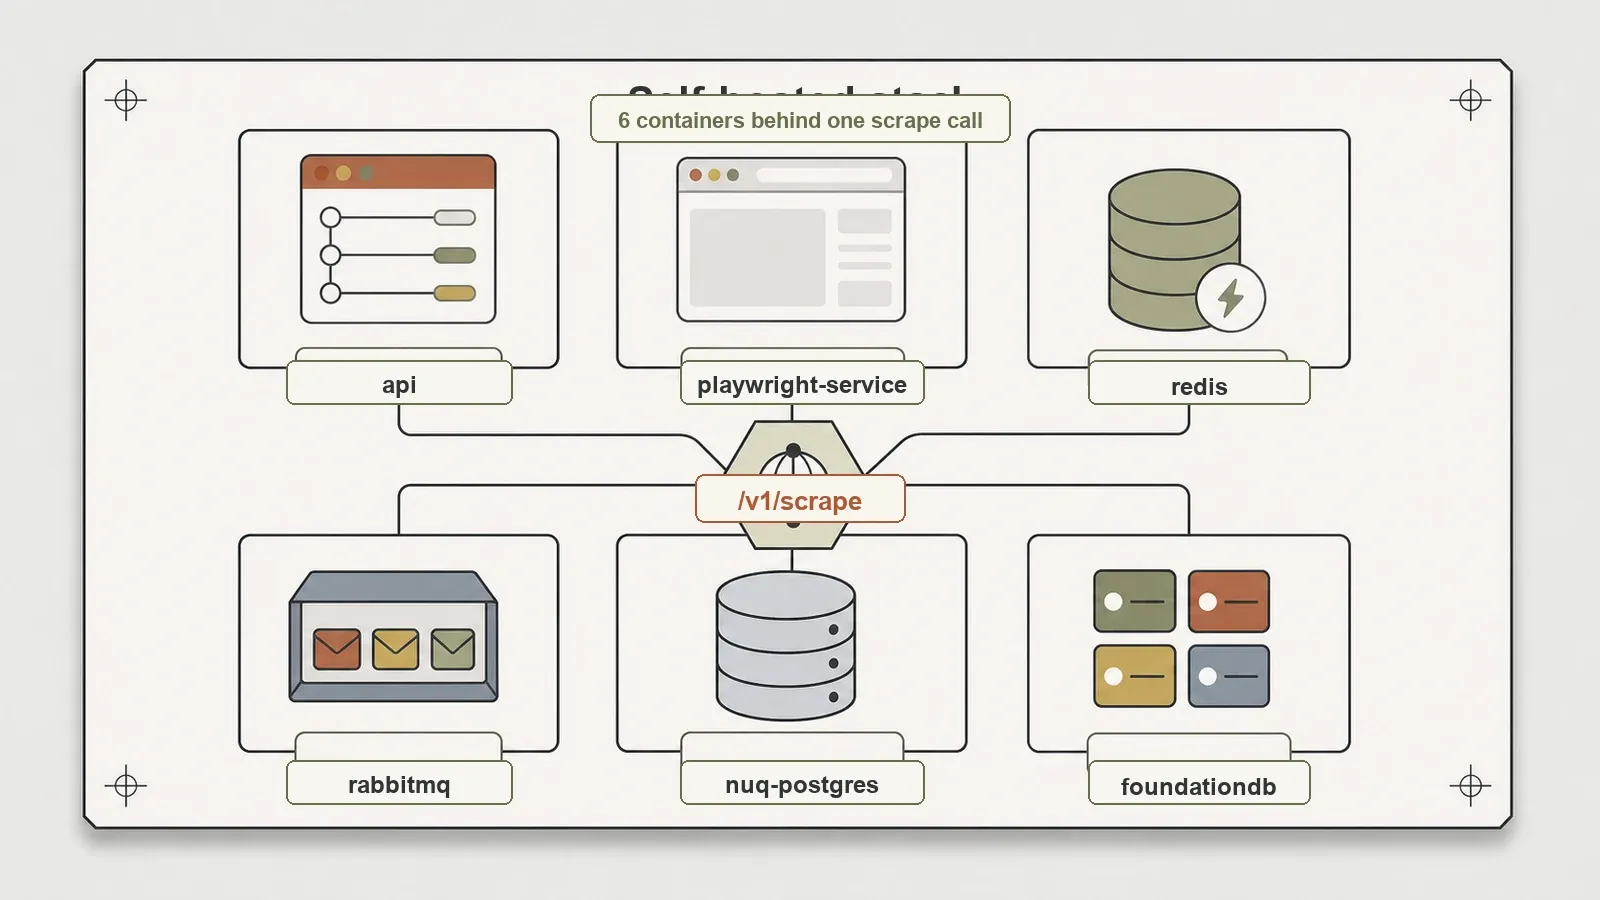
Đây thực sự là một backend hoàn chỉnh, không phải một script hỗ trợ đơn thuần. Redis, RabbitMQ, Postgres và FoundationDB đều là những cơ sở hạ tầng cấp công nghiệp theo đúng nghĩa của chúng. Lợi ích là Firecrawl xử lý các phần phức tạp của scraping – xếp hàng, hiển thị, thử lại – đằng sau một lệnh gọi API. Cái giá phải trả là bạn phải tự vận hành sáu container đó. Hãy nhớ sự đánh đổi này; nó là điểm mấu chốt xuyên suốt bài đánh giá này.
Để tham khảo, tôi đã thử nghiệm với các SDK firecrawl-py 4.32.0 và firecrawl-js 4.30.0, kéo hình ảnh ghcr.io/firecrawl/firecrawl:latest được xây dựng sẵn chính thức vào ngày 09-07-2026. Kho lưu trữ có khoảng 148 nghìn lượt sao tính đến ngày đó (coi đó là siêu dữ liệu, không phải điểm chất lượng), theo giấy phép AGPL-3.0 – một chi tiết tôi sẽ quay lại, vì nó thay đổi cách tính toán cho mục đích thương mại.
Thử nghiệm cốt lõi: Một trang trở thành Markdown sạch
Toàn bộ lý do Firecrawl tồn tại là để biến một trang web thành Markdown mà một LLM thực sự có thể đọc được. Vì vậy, đó là điều đầu tiên tôi kiểm tra.
Tôi đã trỏ /v1/scrape vào books.toscrape.com, một danh mục tĩnh được xây dựng đặc biệt để thực hành scraping. Kết quả: 9.222 ký tự Markdown sạch, sẵn sàng cho LLM, với tiêu đề trang All products | Books to Scrape được phân tích cú pháp chính xác. Không phải HTML thô được đổ vào một chuỗi – mà là Markdown có cấu trúc, với các tiêu đề, liên kết và tham chiếu hình ảnh còn nguyên vẹn. Đây là loại đầu ra mà bạn có thể thả thẳng vào một đường dẫn truy xuất hoặc đưa vào một mô hình mà không cần qua bước làm sạch thứ hai.
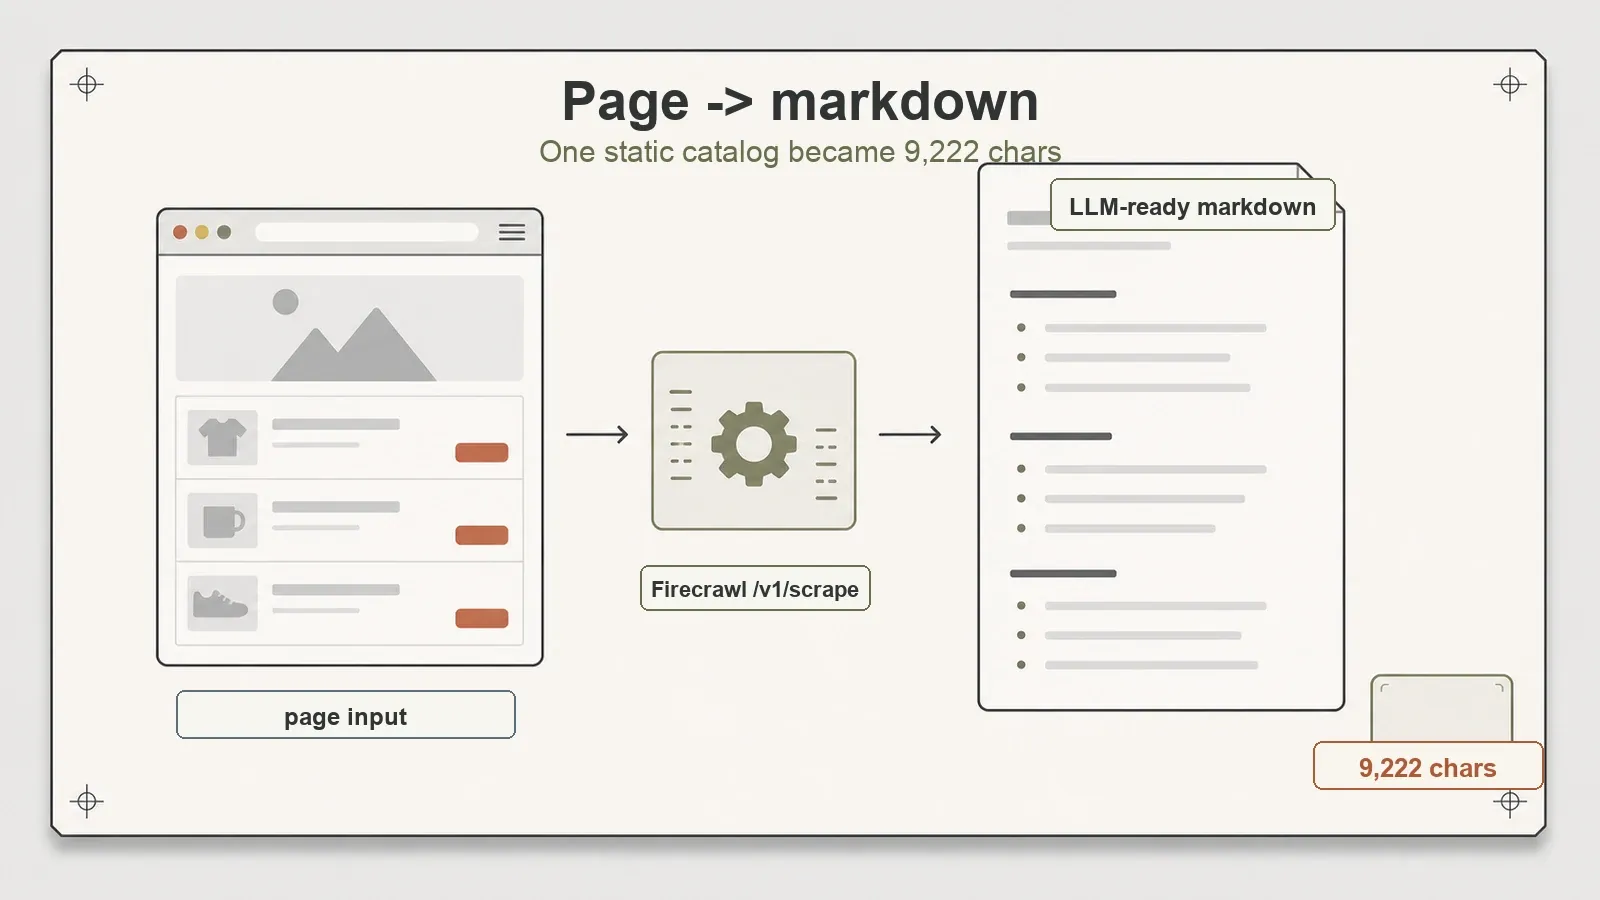
Đây là điểm mạnh nổi bật của Firecrawl, và phiên bản tự host đã thực hiện điều đó mà không gặp vấn đề gì. Nếu công việc của bạn là "cung cấp cho tôi nội dung dễ đọc của trang này dưới dạng Markdown," một trang tĩnh đã được trả về đúng như quảng cáo. Đó là một tính năng thực sự hữu ích, và đó là lý do tại sao công cụ này có được sự quan tâm như vậy.
Cần phải chính xác về phạm vi: Tôi đã sử dụng đường dẫn /v1/scrape cho một trang duy nhất. Tôi không thử nghiệm /v1/crawl, trình thu thập dữ liệu đa trang đi qua toàn bộ một trang web. Đó là một khả năng riêng biệt với các chế độ lỗi riêng, và tôi sẽ không khẳng định nó hoạt động khi tôi chưa chạy nó.
Các trang JavaScript: Trình duyệt đi kèm xứng đáng với container của nó
Một trang tĩnh là trường hợp dễ dàng. Câu hỏi khó hơn đối với bất kỳ scraper nào là điều gì xảy ra khi nội dung chỉ xuất hiện sau khi JavaScript chạy – điều mà trên web hiện đại, xảy ra hầu hết thời gian.
Đây là lúc container playwright-service không còn là chi phí phụ mà trở thành điểm mấu chốt. Tôi đã trỏ scraper vào quotes.toscrape.com/js/, một phiên bản của trang web demo hiển thị các trích dẫn của nó ở phía máy khách. Nếu Firecrawl chỉ tìm nạp HTML thô, các trích dẫn sẽ không có ở đó – chúng không tồn tại cho đến khi trình duyệt thực thi script của trang.
Kết quả scrape trả về 1.574 ký tự Markdown, và trích dẫn của Einstein có trong đó. Trích dẫn đó là nội dung sau JavaScript: sự hiện diện của nó là bằng chứng cho thấy playwright-service thực sự đã hiển thị trang trong một công cụ trình duyệt thực trước khi trích xuất văn bản, thay vì lấy vỏ rỗng trước khi hiển thị.
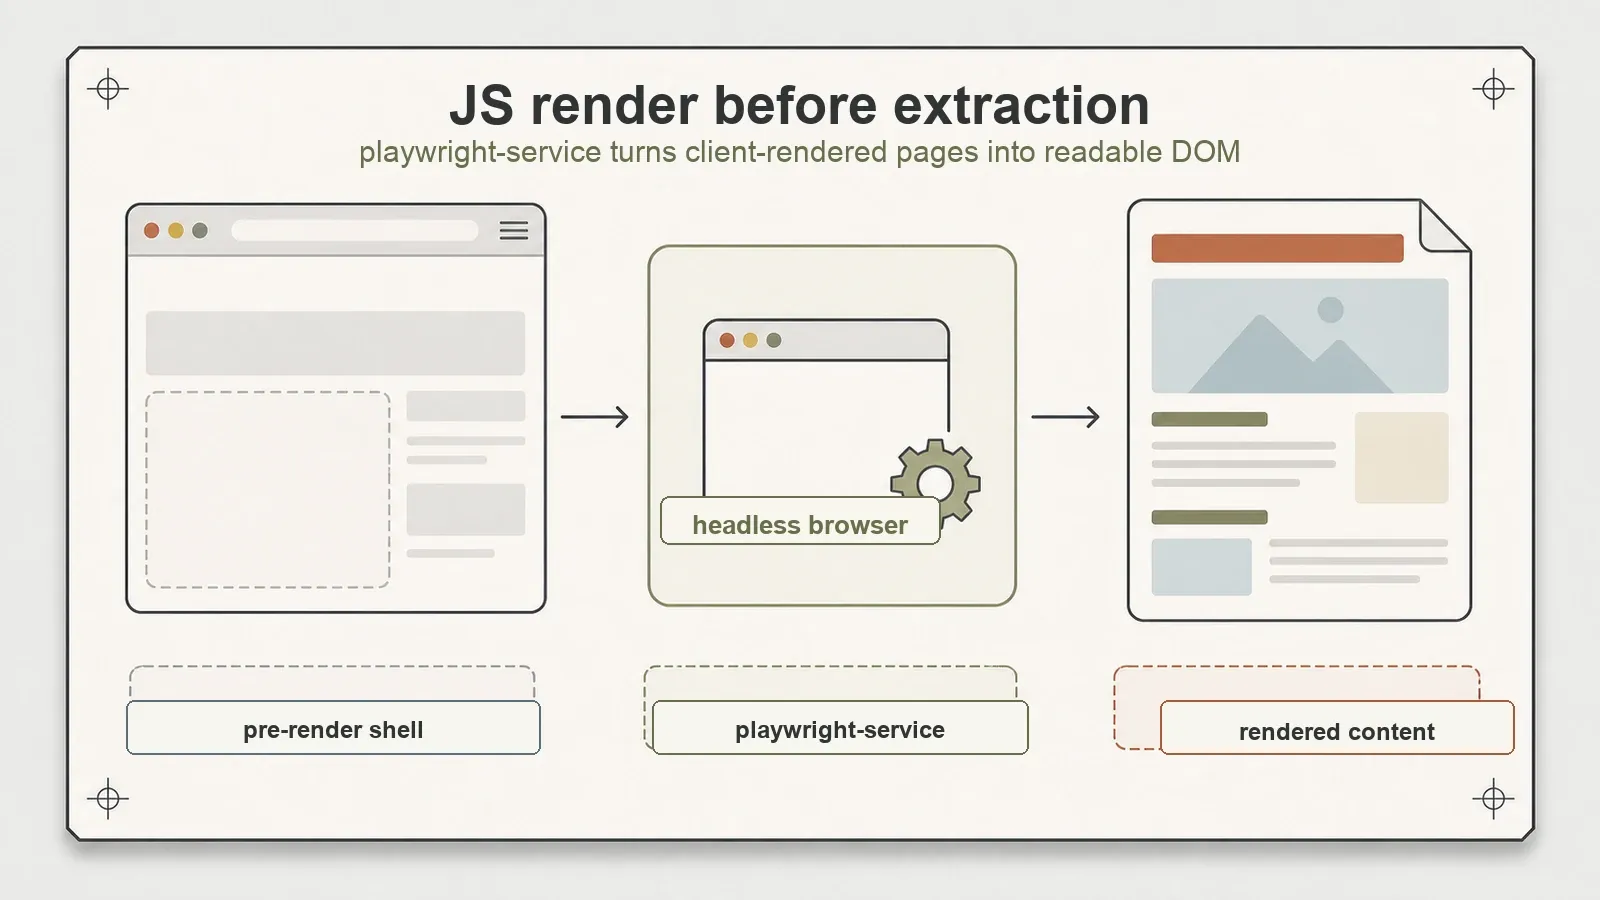
Vì vậy, một trong sáu container là một trình duyệt không giao diện người dùng, và nó thực hiện công việc mà bạn mong đợi. Đó là lý do cụ thể cho kiến trúc nặng hơn: bạn không chỉ trả tiền cho các container, bạn còn trả tiền cho khả năng hiển thị các trang nặng JS mà không cần tự mình thiết lập tự động hóa trình duyệt. Đối với nhiều mục tiêu thực tế, đó là sự khác biệt giữa đầu ra có thể sử dụng và các div trống.
Khi mục tiêu bị lỗi: Lỗi có cấu trúc, không bị treo
Các scraper dành một lượng thời gian đáng ngạc nhiên để nhắm vào những thứ không hoạt động – máy chủ chết, URL bị lỗi chính tả, máy chủ bị treo. Cách một công cụ thất bại cũng nói lên nhiều điều như cách nó thành công.
Tôi đã cố tình cung cấp cho API một máy chủ không hợp lệ. Nó trả về một HTTP 500 có cấu trúc và tiếp tục chạy – không có dấu vết ngăn xếp nào bị nôn ra cho máy khách, không có container nào bị đổ, không có quy trình nào bị treo. Lỗi được trả về dưới dạng một phản hồi sạch mà người gọi có thể phân nhánh.
Đó là hành vi nhàm chán, chính xác mà bạn muốn từ một thứ bạn sẽ đưa vào một đường dẫn. Một scraper bị lỗi khi gặp mục tiêu xấu là một scraper mà bạn không thể tự động hóa. Cái này đã trả về một lỗi mà bạn có thể bắt và tiếp tục. Tôi chỉ thử nghiệm một trường hợp lỗi duy nhất, vì vậy hãy đọc điều này là "đã xử lý đúng một lỗi mà tôi đã ném vào nó," không phải là một cuộc kiểm tra khả năng phục hồi toàn diện – nhưng một điểm dữ liệu là kết quả đúng.
Thực tế thiết lập: Nặng nề nhất trong cơ sở
Bây giờ là phần mà không ai chụp ảnh màn hình để đăng lên Twitter khi ra mắt. Firecrawl tự host, không hề phóng đại, là công cụ có thiết lập phức tạp nhất trong cơ sở nghiên cứu này – và tôi đã thiết lập rất nhiều công cụ.
Sáu container là chi phí cơ bản. Nhưng tôi cũng gặp hai trở ngại trên đường đi, và tôi muốn nói rõ lỗi của ai – hóa ra không phải của Firecrawl.
Trở ngại thứ nhất: bản dựng từ nguồn. Việc xây dựng các hình ảnh từ nguồn đã thất bại bên trong VM colima của tôi do lỗi snapshotter containerd. Đó là một tương tác không ổn định đã biết giữa bản dựng và lớp lưu trữ của colima – một sự cố cơ sở hạ tầng trong môi trường của tôi, không phải lỗi trong Firecrawl. Tệp compose ghi lại một giải pháp thay thế: sử dụng các hình ảnh ghcr.io/firecrawl/* được xây dựng sẵn chính thức thay vì xây dựng cục bộ. Tôi đã chuyển sang sử dụng chúng, và toàn bộ stack đã hoạt động trơn tru. Nếu bạn đang sử dụng một daemon Docker tiêu chuẩn thay vì colima, bạn có thể không bao giờ thấy điều này; tôi coi đây là một cảnh báo về môi trường, và việc xác thực bản dựng của người đóng góp trên một daemon sạch nằm trong danh sách các khoảng trống của tôi.
Trở ngại thứ hai: bảo vệ SSRF. Các lần scrape đầu tiên của tôi bị chặn bởi IP riêng / bảo vệ SSRF của Firecrawl. Tại sao? Mạng của colima ánh xạ các tên máy chủ công khai tới các địa chỉ 198.18.x.x, nằm trong một dải dành riêng mà Firecrawl xử lý chính xác là riêng tư – vì vậy lớp bảo mật của nó đã thực hiện công việc của mình và từ chối tìm nạp những gì trông giống như một mục tiêu nội bộ. Để khắc phục điều này chỉ để kiểm tra cục bộ, tôi đã đặt ALLOW_LOCAL_WEBHOOKS=true.
Cờ đó được sao chép vào sản xuất và gây ra sự cố, vì vậy hãy chính xác về nó là gì: bảo vệ SSRF là một tính năng, không phải là một trở ngại. Đó là điều ngăn chặn một dịch vụ scraping bị lừa truy cập mạng nội bộ của bạn. Tôi đã tắt nó vì một sự kỳ lạ của DNS của colima đã khiến các mục tiêu công khai hợp pháp của tôi trông riêng tư bên trong VM. Đừng tắt bảo vệ SSRF trong một triển khai thực tế. Nếu bạn ghi nhớ một ghi chú vận hành từ bài đánh giá này, hãy ghi nhớ điều đó.
Hai trở ngại này, nói một cách thẳng thắn, là những hiện vật của việc chạy Docker thông qua colima trên máy tính xách tay – không phải lỗi trong phần mềm. Mặt khác, trọng lượng thiết lập tự nó là có thật và đó là thiết kế của Firecrawl. Đây không phải là công cụ bạn sử dụng khi bạn muốn một script cục bộ nhanh chóng; đó là công cụ bạn thiết lập khi bạn muốn một dịch vụ scraping có khả năng hiển thị và bạn sẵn sàng chạy cơ sở hạ tầng cho nó.
Những gì tôi chưa thử nghiệm, và những gì nó không làm
Đây là những gì tôi chưa đề cập, và những gì công cụ này không cung cấp cho bạn.
Phiên bản tự host không có Fire-engine. Sản phẩm đám mây của Firecrawl bao gồm Fire-engine, lớp chống chặn độc quyền của nó để vượt qua các biện pháp phòng thủ bot. Theo tài liệu SELF_HOST.md của dự án, các phiên bản tự host không có nó. Vì vậy, nếu bạn đang hình dung Firecrawl tự host có thể xuyên thủng các hệ thống chống bot mạnh mẽ ngay từ đầu, hãy điều chỉnh lại hình ảnh – khả năng đó nằm ở tầng đám mây, và nó không phải là một phần của những gì tôi đã chạy.
API đám mây chưa được thử nghiệm ở đây. Tôi không có khóa đám mây, vì vậy mọi thứ ở trên chỉ là stack tự host. Dịch vụ đám mây được quản lý – với Fire-engine, khả năng mở rộng được host và các tính năng AI – là một sản phẩm khác, và tôi sẽ không mô tả hiệu suất của nó từ bên ngoài. Coi bất kỳ tuyên bố nào về đám mây là ngoài phạm vi của bài đánh giá này.
Các tính năng AI cần một khóa. Định dạng đầu ra có cấu trúc json và điểm cuối /extract dựa vào một LLM, điều đó có nghĩa là cần có khóa OpenAI hoặc kết nối Ollama. Điều đó đưa lựa chọn mô hình vào danh sách vật liệu: trước khi cam kết thiết lập, hãy so sánh giá API hiện tại của các nhà cung cấp mà bạn có thể sử dụng. Tôi không sử dụng các đường dẫn đó, vì vậy /extract và đầu ra json có cấu trúc cũng nằm trong cột chưa được thử nghiệm.
Proxy là một cảnh báo, không phải là tiêu đề. Firecrawl hỗ trợ cấu hình proxy, nhưng tôi cố tình liệt kê nó như một ghi chú chân trang – đó là một nút bạn có thể bật, không phải là lý do để chọn công cụ, và phiên bản tự host vẫn thiếu lớp chống chặn của đám mây bất kể.
AGPL-3.0 là một quyết định tuân thủ thực sự. Điều này xứng đáng có một phần riêng.
Giấy phép: Đọc AGPL-3.0 trước khi bạn triển khai
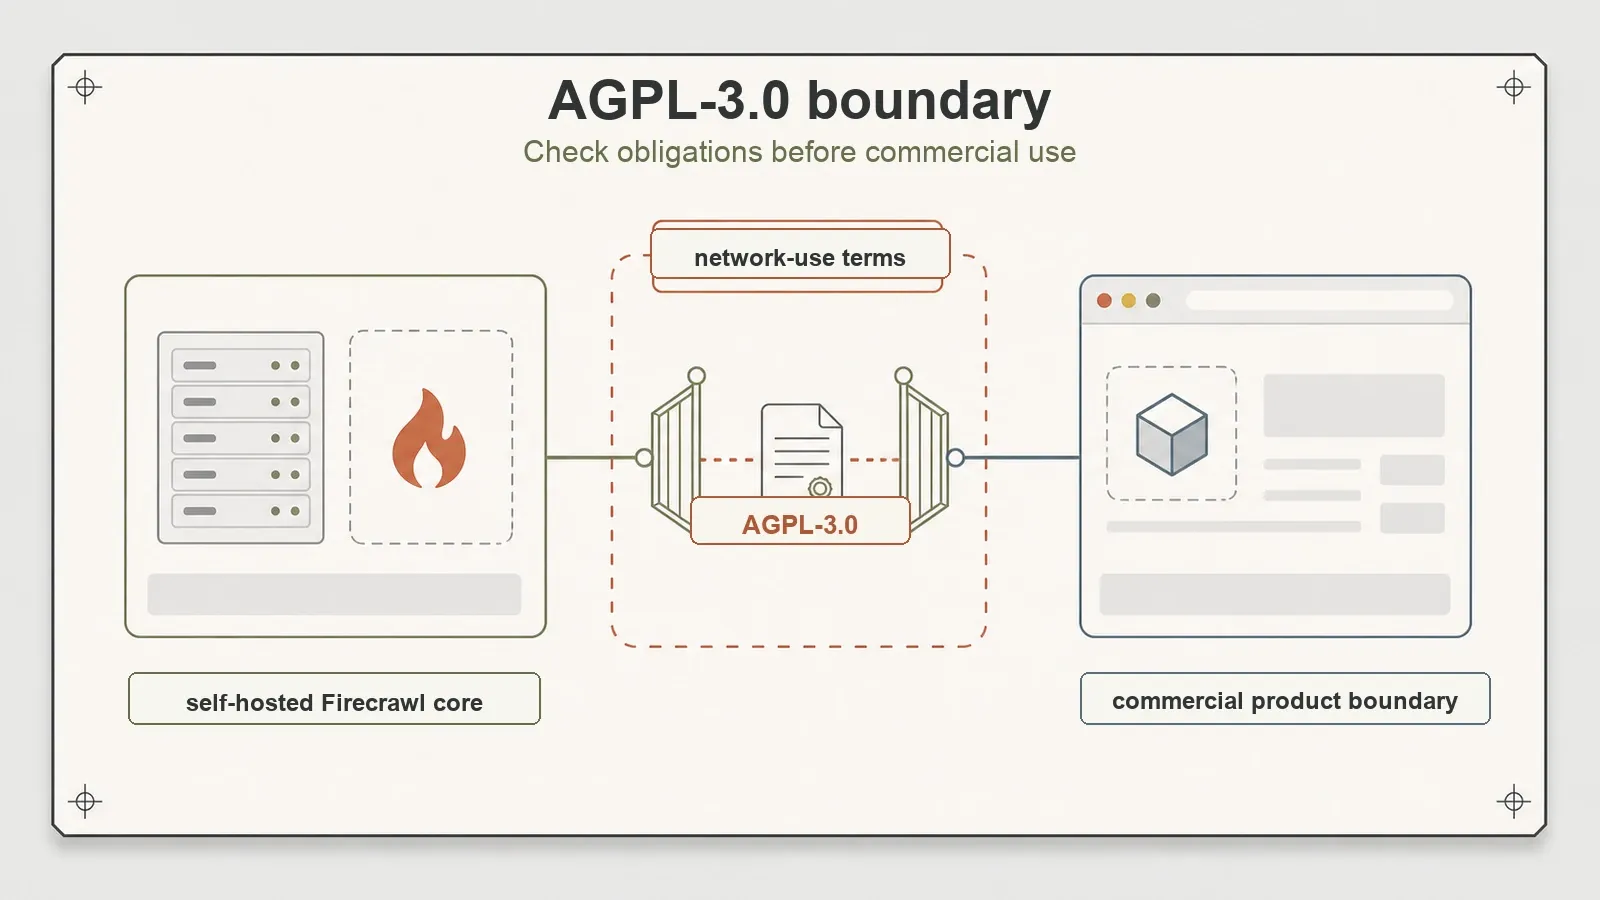
Firecrawl được cấp phép theo AGPL-3.0. Đó không phải là một dòng bỏ qua ở cuối README – đó là bản quyền mạnh mẽ với điều khoản sử dụng mạng, và nó có thể ảnh hưởng trực tiếp đến việc bạn có thể xây dựng một sản phẩm thương mại dựa trên một phiên bản tự host hay không.
Tóm lại: các nghĩa vụ GPL tiêu chuẩn kích hoạt khi phân phối. AGPL đi xa hơn – điều khoản sử dụng mạng có nghĩa là việc cung cấp chức năng của phần mềm cho người dùng qua mạng có thể được coi là loại sử dụng mang theo các nghĩa vụ về tính khả dụng của mã nguồn. Nếu bạn đang nhúng Firecrawl tự host vào một dịch vụ mà khách hàng của bạn truy cập qua internet, điều khoản đó nằm trong phạm vi rõ ràng, và "chúng tôi chưa bao giờ triển khai một tệp nhị phân" không phải là lối thoát mà mọi người vẫn nghĩ.
Tôi không phải luật sư của bạn, và việc giải thích giấy phép phụ thuộc vào cách bạn triển khai chính xác. Nhưng đối với bất kỳ khuyến nghị thương mại nào, AGPL-3.0 là một yếu tố cân nhắc hàng đầu, không phải là chữ in nhỏ. Hãy liên hệ với người chịu trách nhiệm về cấp phép tại công ty của bạn trước khi bạn xây dựng dựa trên nó. Việc gắn cờ này không phải là một lời chỉ trích Firecrawl – rất nhiều công cụ tuyệt vời là AGPL – đó chỉ là một sự thật bạn cần biết sớm.
Vị trí của Thunderbit trong hệ sinh thái phát triển
Thử Thunderbit để trích xuất dữ liệu web
Nếu mục tiêu thực sự của bạn là "trang → Markdown sẵn sàng cho LLM" hoặc "trang → dữ liệu có cấu trúc," và bạn không muốn chịu gánh nặng vận hành sáu container cùng với vấn đề AGPL, thì đó chính là khoảng trống mà stack dành cho nhà phát triển của Thunderbit được xây dựng để lấp đầy. Cùng một công cụ AI đằng sau hơn 100.000 người dùng tiện ích mở rộng của chúng tôi, được cung cấp theo ba cách cho công việc kỹ thuật – với cơ sở hạ tầng được giữ ở phía chúng tôi.
- Open API (REST).
POST /distillbiến một trang thành Markdown sạch, sẵn sàng cho LLM;POST /extracttrả về dữ liệu có cấu trúc theo JSON Schema mà bạn định nghĩa. Hiển thị JS, xử lý chống bot và nội dung động được xử lý ở phía máy chủ – bạn không cần chạy container trình duyệt. Một cờrenderMode(none/basic/full) kiểm soát mức độ hiển thị, và các điểm cuối hàng loạt xử lý tối đa 100 URL để chắt lọc. - Máy chủ MCP. Một máy chủ Model Context Protocol chính thức, để một tác nhân AI bên trong Claude hoặc Cursor có thể scrape giữa tác vụ:
thunderbit_suggest_fieldsđể lập kế hoạch trích xuất (miễn phí),thunderbit_distillcho Markdown,thunderbit_extractcho dữ liệu có cấu trúc. Tác nhân quyết định khi nào lấy dữ liệu mà không cần rời khỏi môi trường của nó. - CLI.
npx -y @thunderbit/thunderbit-clichạy các scrape từ terminal, script, CI hoặc cron – không có trình duyệt, không có stack để giám sát. Chuyển nó thẳng vào các công cụ khác:thunderbit distill "$URL" -f markdown | claude -p "summarise".
Sự tương phản với Firecrawl tự host là rõ ràng. Firecrawl tự host cung cấp cho bạn toàn quyền kiểm soát và toàn quyền sở hữu vận hành: sáu container, trọng lượng thiết lập, các điều khoản AGPL và không có Fire-engine để chống chặn. API/MCP/CLI của Thunderbit đánh đổi quyền kiểm soát đó lấy một công cụ được host trả về JSON có cấu trúc khớp với schema – không chỉ Markdown thô – với các container, lớp chống bot và các nghĩa vụ bản quyền được loại bỏ khỏi bạn. Các công cụ khác nhau cho các mức độ mong muốn về cơ sở hạ tầng khác nhau.
Đây là sự đánh đổi trong một cái nhìn:
| Yếu tố cân nhắc | Firecrawl tự host | Thunderbit dev stack (API · MCP · CLI) |
|---|---|---|
| Hình thức triển khai | Dịch vụ bạn vận hành (6 container) | API được host mà bạn gọi |
| Để bắt đầu | docker compose khởi động một stack 6 dịch vụ | Khóa API, sau đó gửi yêu cầu |
| Hiển thị JS | playwright-service đi kèm (bạn tự chạy) | Phía máy chủ, cờ renderMode |
| Đầu ra có cấu trúc | Cần khóa LLM (/extract, json) | POST /extract với JSON Schema |
| Lớp chống bot | Không có trong phiên bản tự host (Fire-engine chỉ có trên đám mây) | Được xử lý phía máy chủ |
| Giấy phép | AGPL-3.0 (bản quyền sử dụng mạng) | API thương mại, không có bản quyền đối với mã của bạn |
| Tốt nhất khi | Bạn muốn toàn quyền kiểm soát và sẽ chạy cơ sở hạ tầng | Bạn muốn Markdown/dữ liệu có cấu trúc mà không cần vận hành |
Không có cái nào là "tốt hơn" một cách phổ quát. Nếu việc chạy nền tảng là điểm mấu chốt đối với bạn – toàn quyền kiểm soát dữ liệu, không phụ thuộc bên ngoài và AGPL phù hợp với tình huống của bạn – Firecrawl tự host là một lựa chọn có khả năng, được duy trì tích cực. Nếu bạn muốn gọi API và bỏ qua cuộc sống sáu container, đó là lý do để chọn stack của Thunderbit.
Ai thực sự nên tự host Firecrawl
Loại bỏ sự cường điệu và bức tranh đủ rõ ràng để phân loại theo nhu cầu.
Hãy tự host Firecrawl nếu bạn muốn toàn quyền kiểm soát cơ sở hạ tầng scraping của mình, bạn cảm thấy thoải mái khi vận hành Redis / RabbitMQ / Postgres / FoundationDB trong sản xuất, nhu cầu hiển thị của bạn biện minh cho container playwright-service, và AGPL-3.0 phù hợp với cách bạn triển khai. Khả năng cốt lõi là có thật: tôi đã nhận được Markdown sạch, có cấu trúc, sẵn sàng cho LLM từ cả trang tĩnh và trang được hiển thị bằng JS, và toàn bộ stack chạy trên các hình ảnh được xây dựng sẵn.
Hãy tìm nơi khác nếu bạn muốn một script cục bộ nhanh chóng (đây là thiết lập nặng nề nhất trong cơ sở, chấm hết), bạn cần chống chặn cấp độ đám mây mà không cần tự vận hành (phiên bản tự host không có Fire-engine), hoặc điều khoản sử dụng mạng AGPL xung đột với kế hoạch thương mại của bạn. Đối với trường hợp "Tôi chỉ cần Markdown hoặc dữ liệu có cấu trúc từ một URL, không cần vận hành," một API được host như /distill và /extract của Thunderbit bao gồm cùng một phạm vi mà không cần các container.
Đánh giá sơ bộ của tôi: cốt lõi mạnh mẽ, cam kết vận hành nặng nề và giấy phép bạn phải làm rõ trước khi xây dựng thương mại. Nó xứng đáng có vị trí của mình cho các nhóm muốn sở hữu toàn bộ đường dẫn – và nó đòi hỏi rất nhiều từ những người khác. Tôi sẽ xem xét lại điều này sau khi tôi đã chạy /v1/crawl, sử dụng /extract với khóa LLM và xác thực bản dựng từ nguồn trên một daemon không phải colima; đó là những câu hỏi mở giữa điều này và một phán quyết cuối cùng.
Thử Thunderbit để trích xuất dữ liệu web Get Started Free
Câu hỏi thường gặp
Firecrawl tự host có giống với phiên bản đám mây không?
Không. Phiên bản tự host cung cấp cho bạn công cụ scrape-to-Markdown cốt lõi và hiển thị JavaScript thông qua playwright-service đi kèm, nhưng nó không bao gồm Fire-engine, lớp chống chặn độc quyền của sản phẩm đám mây. Các tính năng AI như điểm cuối /extract và đầu ra json cũng yêu cầu khóa LLM của riêng bạn (OpenAI hoặc Ollama). Trong bài đánh giá này, tôi chỉ thử nghiệm stack tự host; API đám mây nằm ngoài phạm vi.
Firecrawl tự host thực sự cần bao nhiêu container? Sáu: api, playwright-service, redis, rabbitmq, nuq-postgres và foundationdb. Đó là một stack dịch vụ hoàn chỉnh, không phải một tệp nhị phân duy nhất – đó là lý do tại sao nó là thiết lập nặng nề nhất so với bất kỳ công cụ nào trong cơ sở nghiên cứu này. Hãy lên kế hoạch cho chi phí vận hành của việc chạy cơ sở hạ tầng bộ môi giới tin nhắn, bộ nhớ đệm và cơ sở dữ liệu, không chỉ một script.
Firecrawl có thể xử lý các trang nặng JavaScript khi tự host không? Có, trong thử nghiệm của tôi. playwright-service đi kèm hiển thị các trang trong một công cụ trình duyệt thực trước khi trích xuất. Tôi đã xác nhận điều này trên quotes.toscrape.com/js/, nơi trích dẫn của Einstein – nội dung chỉ tồn tại sau khi JavaScript chạy – xuất hiện trong Markdown được trả về. Khả năng hiển thị đó chính là lý do tại sao một trong sáu container là một trình duyệt không giao diện người dùng.
Giấy phép AGPL-3.0 có ảnh hưởng đến việc sử dụng thương mại không? Có thể, và bạn nên coi đó là một câu hỏi hàng đầu. AGPL-3.0 là bản quyền mạnh mẽ với điều khoản sử dụng mạng, có nghĩa là việc cung cấp chức năng của phần mềm cho người dùng qua mạng có thể mang theo các nghĩa vụ về tính khả dụng của mã nguồn – ngay cả khi bạn không bao giờ phân phối một tệp nhị nhật. Nếu bạn có kế hoạch xây dựng một sản phẩm thương mại trên một phiên bản tự host, hãy nói chuyện với người chịu trách nhiệm về cấp phép tại công ty của bạn trước khi bạn cam kết. Bài đánh giá này gắn cờ giấy phép; nó không phải là lời khuyên pháp lý.
Sự khác biệt giữa Firecrawl và các công cụ dành cho nhà phát triển của Thunderbit là gì?
Firecrawl tự host là một dịch vụ bạn vận hành – sáu container bạn tự chạy, với các điều khoản AGPL-3.0 và không có lớp chống chặn tích hợp. Stack dành cho nhà phát triển của Thunderbit (Open API, máy chủ MCP, CLI) là một công cụ được host mà bạn gọi: POST /distill cho Markdown, POST /extract cho dữ liệu có cấu trúc JSON-Schema, với hiển thị JS và xử lý chống bot ở phía máy chủ và không có nghĩa vụ bản quyền đối với mã của riêng bạn. Firecrawl phù hợp với các nhóm muốn toàn quyền kiểm soát cơ sở hạ tầng; Thunderbit phù hợp với những người muốn có đầu ra mà không cần gánh nặng vận hành.




